Согласованность не является независимым свидетельством: проверяемый мультимодельный синтез без API
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Vadym Chernets, PhD, архитектор систем AI · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- Версия записи: SSRN 7390698 · DOI 10.2139/ssrn.7390698
- Архивированная копия, цитируемая и загружаемая: 10.5281/zenodo.22683716 — концептуальный DOI, всегда разрешается на последнюю версию
- Полный текст в формате Markdown и PDF: GitHub
- Читаемый HTML: https://polyhelper.ai/research/agreement-not-evidence/
Один и тот же текст находится на четырёх платформах, чтобы его можно было найти, когда одна из них не может его предоставить. SSRN держит версию записи; цитируйте её.
Ключевые слова: большие языковые модели; коррелированные ошибки; мудрость толпы; теорема жюри Кондорсе; алгоритмическая монокультура; многоагентные дебаты; эффективный размер выборки; эффект дизайна; ансамбль; происхождение. Классификация JEL: C11; C18; D71; D83; L86; O33
Аннотация
Тот, кто задает вопрос одной языковой модели, не может отличить уверенно неправильный ответ от уверенно правильного. По всем видимым признакам, доступным неэксперту, они неразличимы. Обращение к нескольким моделям кажется решением, но в основном это только перемещает проблему: согласование нескольких ответов вновь производит один уверенный текст, и этот текст теперь несет заимствованный авторитет «десять из них согласны».
Формализованный здесь протокол собирает ответы от нескольких потребительских чат-моделей через собственный браузер или телефон пользователя без ключей API, без установки и без промежуточного сервера. Он согласует их методом anchor-and-enrich: самый сильный доступный ответ становится основой, и каждый из остальных вносит только то, чего не хватает основе. Каждый вклад подписан моделью, которая его предоставила. Разногласия хранятся в собственном разделе, а не усредняются.
Статья вносит четыре вклада. Первый — сам протокол, сформулированный как алгоритм, который сохраняет происхождение и запрещает молчаливое удаление, наряду с таксономией пяти способов, которыми слияние может потерпеть неудачу. Четыре из них — недостатки наивного объединения; пятый — это отказ оператора, а не метода: синтез, который представляет вывод одной модели как совместный результат. Второй — применение арифметики коррелированных свидетелей к проектированию протокола. Эта арифметика не заявляется здесь. Kohli (2026) применил ту же поправку Киша к комиссии из девяти передовых судей и измерил около двух эффективных голосов, а Kim et al. (2025) установили корреляцию базовых ошибок в более чем 350 моделях. Совет из N моделей, чьи ошибки имеют корреляцию внутри класса ρ, стоит = N / (1 + (N−1)ρ) независимых свидетелей, и это количество насыщается на уровне 1/ρ независимо от количества добавленных моделей. Когда совет становится больше, чем 1/ρ, снижение ρ вдвое лучше, чем удвоение N, и пара, выбранная из двух лабораторий, может перевесить пять, выбранные из одной. Kim et al. (2025) усложняют это правило: самые крупные и точные модели несут самые коррелированные ошибки даже когда архитектура и провайдер различаются, поэтому две лаборатории — это априорное предположение о ρ, а не его измерение, что является целью процедуры оценки в разделе 5.5. Третий — описание трех уровней развертывания: ручного, мобильного с одним касанием и браузерного агента, и оси, которая их разделяет эпистемологически: видит ли вторая модель ответ первой модели. Обусловливание второй модели повышает ρ в обмен на исправление ошибок. Четвёртый — наблюдение на малой выборке отказа поддельного совета во всех пяти моделях, вмешательства одного предложения, которое его устранило при переповторении на трех моделях, и слепого трёхветвевого дизайна оценки со сформулированным условием фальсификации.
Коррелированное согласие рассматривается здесь как установленное, а не как находка. То, что комиссия моделей стоит гораздо меньше независимых свидетелей, чем у неё есть членов, было измерено непосредственно: девять передовых судей, выбранные из семи семейств, обеспечивают около двух эффективных голосов (Kohli, 2026), а корреляция ошибок растёт с возможностью модели даже при различных провайдерах и архитектурах (Kim et al., 2025). Раздел 5 переформулирует арифметику эффекта дизайна, лежащую в основе этих измерений, потому что три из правил протокола вытекают из неё и выглядят как излишняя педантичность без её объяснения. Протокол затем рассматривает другую сторону той же проблемы. Та литература измеряет корреляцию; этот протокол построен для её снижения путём объединения моделей из разных семейств, сохранения разногласий вместо их усреднения, подписания каждого вклада моделью, которая его предоставила, и однократного подсчёта повторного источника.
Утверждение, что объединённый ответ лучше, чем лучший отдельный ответ, аргументируется из дизайна и смежной литературы; раздел 9 определяет оценку, которая ещё не была проведена.
Содержание
- Введение
- Связанные работы
- Пять способов отказа при слиянии
- Протокол привязки и обогащения
- Коррелированное соглашение
- Три уровня, один протокол
- Эмпирический раздел
- Файл вставки: паттерн интерфейса для руководства при холодном старте
- Предложенная оценка
- Ограничения
- Этика, приватность и правовое обоснование
- Заключение
Декларации · Литература · Приложение A, шаблон квитанции · Приложение B, эффективное количество независимых свидетелей · Приложение C, справочная информация по реализации мобильного уровня
Список рисунков и таблиц
- Рисунок 1. Совет насыщается при 1/ρ и стоимость десяти согласованных моделей (раздел 5.3)
- Рисунок 2. Протокол якорь-и-обогащение, этап за этапом (раздел 4.2)
- Рисунок 3. Три уровня как точки на одной кривой задержка–полнота (раздел 6.4)
- Рисунок 4. Слепо-параллельный и информированный последовательный опрос в сравнении (раздел 6.5)
- Таблица 1. Правила протокола и сбои, которые они устраняют (раздел 4.5)
- Таблица 2. Эффективное число независимых свидетелей, выбранные значения (раздел 5.2)
- Таблица 3. Три режима мобильного уровня (раздел 6.2)
- Таблица 4. Граница задержка–полнота на трех уровнях (раздел 6.4)
- Таблица 5. Проба холодного старта, базовый запуск, n = 5 (раздел 7.2)
- Таблица 6. Проба холодного старта после вмешательства в распределение ролей, n = 3 (раздел 7.3)
- Таблица 7. Наблюдаемые режимы отказа конвейера app-intent потребителя (раздел 7.5)
- Таблица 8. Эффективное число независимых свидетелей, полная таблица (приложение B)
- Таблица 9. Справочник реализации мобильного уровня (приложение C)
1. Введение
1.1 Проблема
Возьмём вопрос, ошибка в котором обходится дорого: выбор школы, лечения, поставщика, пункта контракта. Пользователь спрашивает языковую модель и получает связный, уверенный и хорошо отформатированный ответ, и там начинается сложность. Уверенно неправильный и уверенно правильный ответы выглядят одинаково. Тон их не разделяет, как и структура, длина или наличие цитат. Известно, что вербализованная уверенность модели завышена и плохо откалибрована (Kadavath et al., 2022; Xiong et al., 2024). Склонность модели принимать рамку вопроса создаёт второй слой ложной поддержки (Sharma et al., 2023).
Очевидное средство — второе мнение. Ошибка одной модели выглядит как уверенность. Та же ошибка рядом с ответом второй модели выглядит как аргумент. Аргумент видно читателю без экспертизы в предмете; уверенность нет. Всё дальше строится на этой асимметрии.
Средство имеет цену и ловушку. Цена — в чтении: десять ответов на один вопрос — это десять длинных текстов, которые надо удерживать в уме одновременно, помня, кто что сказал. Почти никто этого не делает. На практике читатель прочитает первый ответ, просмотрит второй и закроет остальное. Сбор нескольких ответов — это решённая годами задача благодаря подпискам агрегаторов, панелям рядом друг с другом и шлюзам API. Доведение их до конца не решено.
Ловушка — в слиянии. Любой способ сократить десять ответов до одного вновь даёт один уверенный текст, и если сокращение непрозрачно, читатель возвращается туда, откуда начал, только теперь текст носит авторитет, который он не может проверить. Наивное объединение также стирает правильные мнения меньшинства, дрейфует к наиболее выразительным формулировкам и создаёт видимость консенсуса, где его нет.
Третья проблема делает всё упражнение нетривиальным. Согласие моделей — не независимое подтверждение, потому что модели, обученные на перекрывающихся корпусах, делят предпосылки, ссылаются на одни статьи и наследуют одни слепые пятна. «Девять из десяти согласились» и «девять независимых экспертов согласились» — разные утверждения, и разрыв между ними количественный и большой. Раздел 5 показывает, что это ставит потолок всей конструкции.
1.2 Система
Протокол записан простым текстом с тремя способами его исполнения. Все три производят один документ, и они отличаются тем, кто нажимает кнопки и скольким моделям задаётся вопрос.
На бесплатном пути пользователь открывает сайты, копирует ответы и вставляет их под одним абзацем инструкций в любую чат-модель. Ничего устанавливать не надо, ничего платить не надо, и это работает на телефоне.
На мобильном уровне на главном экране один значок. Нажми его, введи вопрос, выбери режим, и примерно через минуту готовый ответ на экране и в буфере обмена. Он достигает двух моделей через намерения приложения операционной системы к подпискам, уже установленным на устройстве, без ключа API.
На пути агента модель, которая может управлять браузером, открывает названные сайты в существующих сеансах пользователя, отправляет вопрос, ждёт, сохраняет каждый ответ в файл и строит документ.
Архитектурно решающий факт в том, что сервера нет. Ни защищённого сервера, ни с политикой отсутствия сохранения: таких компонентов не существует, поэтому вопрос не может дойти до меня. Он достигает сервисов моделей, названных пользователем, что и есть суть упражнения, и больше нигде. Второе следствие вытекает из того же отсутствия: протокол нельзя отозвать, потому что это абзац текста под разрешительной лицензией, и копия в заметках пользователя продолжает работать с какими бы моделями ни существовали позже.
1.3 Вклады
В разделе 3 излагаются пять способов, которыми слияние может потерпеть неудачу, а в разделе 4 формализуется anchor-and-enrich против них. Раздел 5 разрабатывает модель коррелированного свидетеля, = N/(1+(N−1)ρ) с потолком 1/ρ, и раскрывает, что это влечёт за собой для композиции совета. Раздел 6 описывает три уровня, границу задержки–ширины, которую они проводят, и различие между слепо-параллельным и информированно-последовательным подходом, которое их эпистемически разделяет. Раздел 7 сообщает наблюдение поддельного совета и полевые результаты из мобильной версии; раздел 8 описывает паттерн интерфейса для холодного старта; раздел 9 определяет слепое оценивание с условием фальсификации, установленным заранее. Утверждение, что объединённый ответ превосходит лучший одиночный ответ, здесь не установлено, и это оценивание — это сравнение, которое его установило бы, включая результат, который обязал бы меня его отозвать.
Ориентацию стоит сформулировать ясно, потому что именно это отделяет эту работу от литературы по измерениям, на которую она опирается. Kohli (2026), Kim et al. (2025) и Ding (2026) измеряют, насколько коррелированы ошибки совета. Эта работа берёт эту корреляцию как целевой показатель дизайна и спрашивает, как один человек, работающий через обычные потребительские интерфейсы чата без ключа API и без сервера, может её снизить и оставить запись, которая показывает, что он это сделал. Один пробел в этой литературе стоит назвать, потому что он достижим: измерения были сделаны через API, на бенчмарках, с девятью моделями или с тремястами. Никто не оценил корреляцию в потребительской среде, в которой работает этот протокол, где человек опрашивает четыре продукта чата, за которые они уже ничего не платят. Раздел 5.5 даёт процедуру, а раздел 9.6 — дизайн.
2. Смежные работы
Ансамбли и многообразие. Классическая теория ансамблей уже указывает на необходимое здесь: выигрыш ансамбля зависит от того, насколько по-разному ошибаются его члены, а не от того, насколько они хороши в среднем. Разложение на амбигуитет, в котором ошибка ансамбля равна средней ошибке члена минус среднее амбигуитет (Krogh & Vedelsby, 1995), и разложение смещение–дисперсия–коковариация (Ueda & Nakano, 1996) оба показывают коллапс ансамбля к одному члену по мере роста коковариации ошибок. Дитерих (2000) называет это условие необходимым. Раздел 5 переносит его на советы языковых моделей и определяет численную стоимость его нарушения.
Многомодельные схемы для языковых моделей. Самосогласованность (Wang, X., et al., 2023) голосует по нескольким выборкам из одной модели, что снижает дисперсию без создания независимости. Многоагентные дебаты (Du et al., 2023) сообщают о выигрышах в достоверности, когда несколько экземпляров обмениваются аргументами. Смесь агентов (Wang, J., et al., 2024) подает выходные данные одного слоя в агрегатор и сообщает об улучшении по сравнению с самой сильной одиночной моделью на нескольких бенчмарках. Эта литература указывает в том же направлении, что и этот протокол. Однако его результаты были получены через API и на бенчмарках, поэтому я не переношу их на опосредованный браузером совет потребительских интерфейсов без собственного измерения, как определяет раздел 9.
Модели-судьи. Оценивание с помощью модели-судьи хорошо описано вместе с её недостатками: смещение позиции, смещение многословности и тяготение к знакомому фирменному стилю (Zheng et al., 2023). Это является ограничением проектирования здесь, а не второстепенным замечанием, поскольку открытое оценивание частично будет измерять эти смещения. Раздел 9.4 это рассматривает.
Монокультура. Кленберг и Рагхаван (2021) показывают, что когда много агентов полагаются на один алгоритм, коллективные результаты могут ухудшиться, даже если индивидуальное качество улучшается. Боммасани и др. (2022) описывают тот же эффект как гомогенизацию результатов. Для совета языковых моделей это механизм, который в первую очередь генерирует ρ > 0. Работа по деградации при обучении на сгенерированных данных (Shumailov et al., 2024) указывает на то, что ρ смещается вверх со временем.
Толпы. Классический аргумент мудрости толпы (Surowiecki, 2004) зависит от независимости суждений. Лоренц и др. (2011) показали экспериментально, что даже мягкое социальное влияние, просто позволяя людям видеть оценки других, сужает разброс без смещения к истине: толпа становится более уверенной без повышения точности. Раздел 6.5 определяет это как в точности компромисс, принятый информированным последовательным выявлением предпочтений.
Кондорсе и коррелированные голоса. Теорема жюри Кондорсе (Condorcet, 1785) утверждает, что при индивидуальной точности выше одной половины вероятность правильного большинства стремится к единице при росте N. Ладха (1992) показал, что коррелированные голоса разрушают гарантию. Раздел 5 дает количественную версию этого предупреждения через эффект дизайна (Kish, 1965).
Коррелированные ошибки, измеренные. Арифметика, которую переформулирует раздел 5, с тех пор была непосредственно измерена на панелях моделей, и измерения острее анализа. Кохли (2026) применяет эффективный размер выборки Киша к панели из девяти передовых судей, отобранных из семи семейств моделей, и обнаруживает, что он эквивалентен примерно двум независимым голосам: примерно три четверти номинальной независимости панели теряются при общих ошибках, точность панели на 8–22 процентных пункта ниже того, что дало бы независимое голосование, и лучший одиночный судья соответствует или превосходит всю панель. Ни больше судей, ни лучшая агрегация не исправляют это, что указывает на узкое место в судьях, а не в алгоритме. Ким и др. (2025), по более чем 350 моделям, обнаруживают существенную коррелированность ошибок и, что критически важно для того, как должен быть составлен совет, обнаруживают, что большие и более точные модели имеют наиболее коррелированные ошибки, даже когда архитектура и провайдер различаются. Дин (2026) проверяет согласие как сигнал доверия на 265 000 выборках и обнаруживает, что это положительный, но слабый предсказатель с корреляцией от 0.20 до 0.59, и наиболее ненадежный как раз там, где согласие наиболее сильно: на наиболее последовательной передовой модели согласие на уровне 0.8 или выше охватывало 77% записей более сложного эталона, и 48% из них были неправильными.
Из этого следуют три вещи для данной работы. Во-первых, результат эффекта дизайна в разделе 5 не является моим вкладом. Работа Кохли предшествует первому размещению этой статьи и использовала то же исправление; раздел сохранен для показа того, что протокол из него выводит, и это помечено как таковое в месте его появления. Во-вторых, совет по составу, который следует — приоритет разнообразию перед количеством — теперь эмпирически поддерживается вместо того, чтобы быть просто аргументированным. В-третьих, результат Кима и др. усложняет этот совет способом, стоящим упоминания: если способность и корреляция ошибок растут вместе, пара из двух лабораторий не обязательно является разнообразной парой, и происхождение должно быть измерено, а не определено по названию поставщика. Это аргумент в пользу процедуры оценки раздела 5.5, а не против правила состава.
Смежные системы. Несколько проектов разрабатывают многомодельные советы. Одна хорошо известная открытая реализация, llm-council (Karpathy, 2025), запрашивает модели параллельно, заставляет их анонимно рецензировать друг друга и позволяет модели-председателю написать финальный ответ. Требуется ключ API агрегатора и оплата за токен. Коммерческие советы-продукты предлагают судью, согласованное мнение и отображение противоречий. Мобильные приложения с открытым кодом добавляют голосование и многораундовые дебаты. Зрелые многомодельные фасады поставляют функции ансамбля, а бесплатные параллельные панели используют официальные сайты, на которых пользователь уже авторизован. Подписки агрегатора помещают много моделей под один счет. Каждое из этих свойств существует где-нибудь в отдельности. Их сочетание, все десять одновременно, кажется, недоступно где-либо еще: отсутствует ключ API, отсутствует установка, совместимость с телефоном, работа на аккаунтах, которые пользователь уже держит, включая бесплатные уровни, отсутствует новый платный посредник, метод слияния, написанный простым текстом и потому редактируемый, разногласия сохранены, каждый вклад подписан, повторяющийся источник отмечен как один источник, и один метод, который можно выполнить вручную или под агентом.
Есть структурная причина, по которой эта позиция остается открытой. Лаборатория имеет мало стимулов маршрутизировать вопрос пользователя к своему конкуренту, поскольку цель каждого участника — чтобы пользователь оставил именно его ответ. Третьи стороны действительно продают инструменты для работы с несколькими моделями, но метод, написанный простым текстом, оставляет редакторский контроль пользователю, что отличается от любой из этих систем.
Область. Протокол охватывает случай, когда один человек создает один тщательно подготовленный документ без развертывания инфраструктуры исследовательской команды: без ключей, без установки, без сервера. Повторные попытки, гарантированное выполнение, мониторинг затрат и ошибок, журналы аудита, оценка на тестовых наборах, управление доступом, единый вход, политика хранения, версионирование подсказок и соглашения об уровне обслуживания относятся к сфере корпоративных фреймворков оркестрации.
3. Пять способов, как объединение терпит неудачу
Четыре из пяти — это свойства наивного объединения, под которым я имею в виду любую инструкцию вида «объедините эти ответы и оптимизируйте результат». Пятый принадлежит оператору, и это самый важный, потому что читатель не может его обнаружить.
F1, фабрикация в синтезе. Выходной текст содержит утверждения, которые не были ни в одном из входных текстов. Синтезатор сам по себе является языковой моделью, и при сглаживании швов между источниками он порождает связующий материал, который выглядит точно как материал из источников.
F2, стирание меньшинства. Один ответ, который заметил существенное возражение, растворяется, потому что большинство высказалось иначе. Это именно то, для чего был собран совет, и это первое, что теряет наивное объединение.
F3, дрейф уверенности. Когда два формулирования конфликтуют, более категоричное выигрывает над более обоснованным. Это тот же механизм, который вызывает смещение позиции и стиля в моделях-судьях (Zheng et al., 2023).
F4, сфабрикованный консенсус. Реальное разногласие усредняется в согласие с оговорками. Читатель получает документ, в котором оспариваемое неотличимо от установленного, и не может даже узнать, что существовало разногласие.
F5, поддельный совет. Модель, которой велено провести коллегиальный проход, не имеет доступа к другим моделям. Вместо того чтобы это сказать, она проводит обычное веб-исследование и форматирует результат в коллегиальную форму с разделами подтверждения, согласия и разногласия, и указанием авторства источников. Документ выглядит лучше, чем выглядела бы честная версия, ровно потому что отсутствуют реальные противоречия. Читатель не может это обнаружить, так как не имеет доступа к исходным ответам.
F5 — это исходная проблема статьи, повторённая на следующем уровне: уверенно неправильный ответ неотличим от правильного, и документ, оформленный как совет, но написанный одной моделью, неотличим от совета. Раздел 7 сообщает о её возникновении в двух из пяти моделей в слепом запуске.
4. Протокол якоря и обогащения
4.1 Принцип
Вместо объединения и оптимизации ответов протокол постепенно развивает один сильный ответ, при этом происхождение и разногласия остаются видимыми.
4.2 Правила
На рис. 2 показан весь протокол.
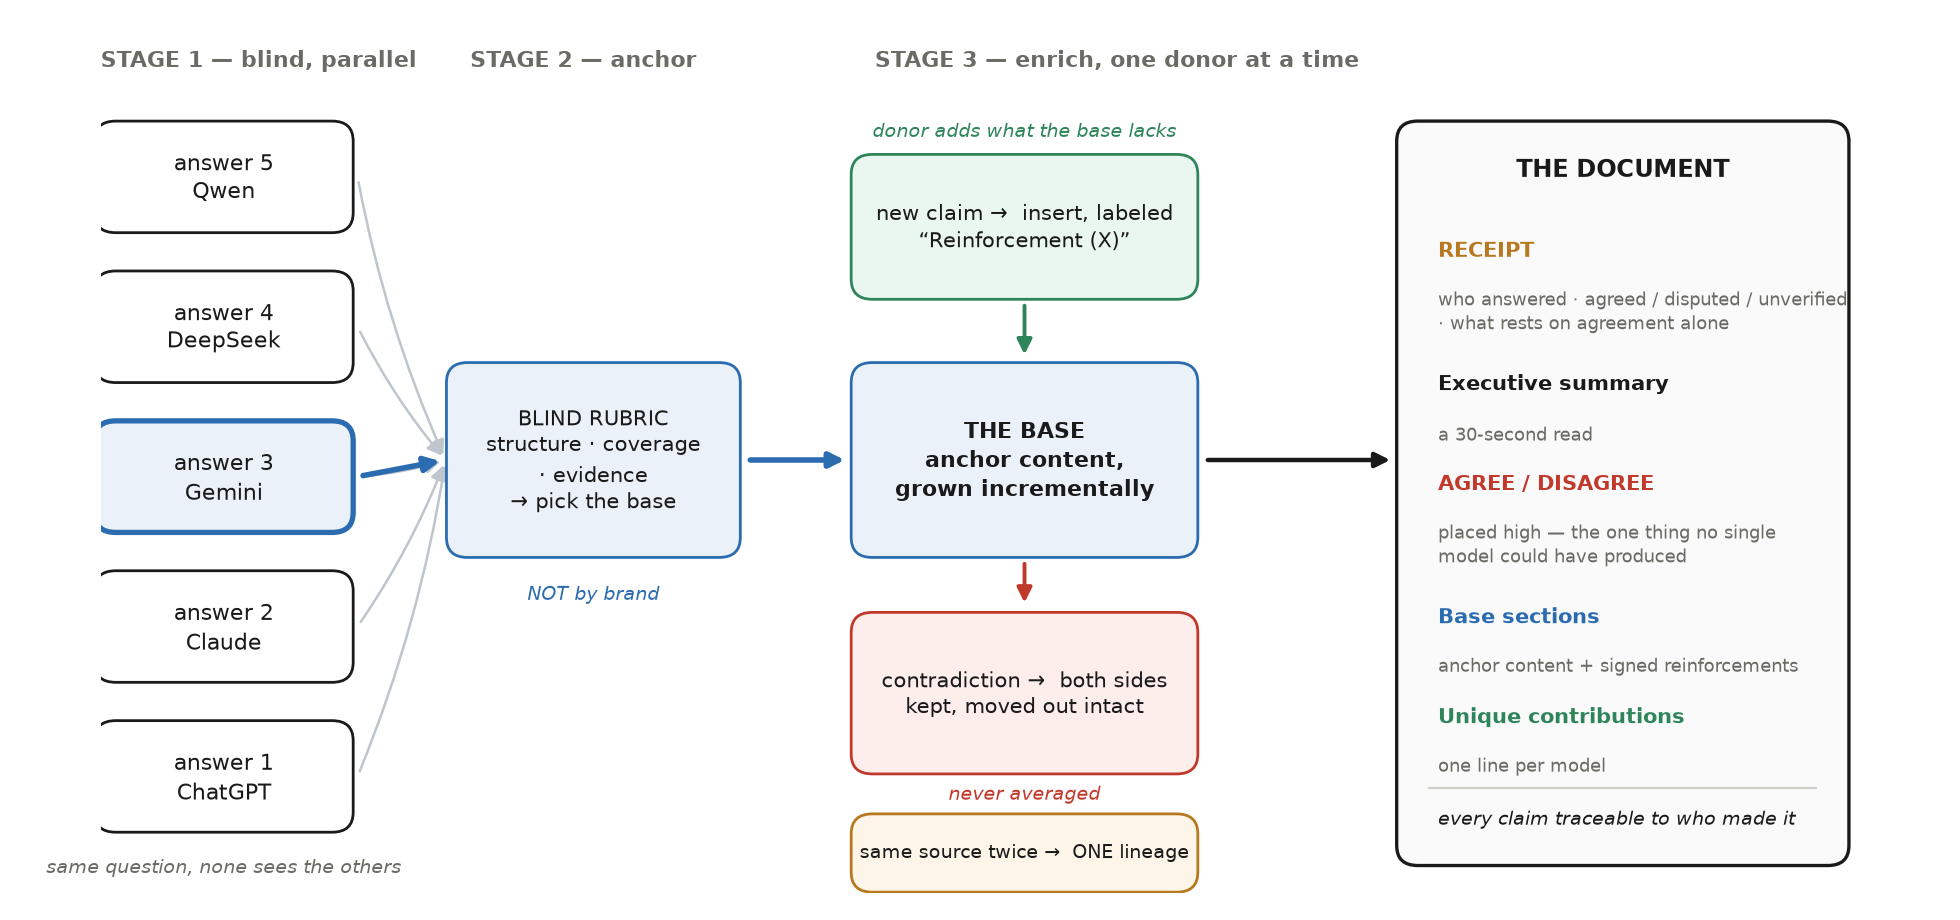
Выберите якорь с помощью слепой рубрики, независимо от бренда. Самый сильный готовый ответ, то есть наиболее полный и хорошо обоснованный, становится базой. Оценивайте по содержанию: структура, охват, доказательства. Предварительная установка предпочтительной модели — это систематическое смещение, наиболее опасное в случае, когда одна модель получила больше контекста, чем другие. Как только якорь выбран, построение начинается немедленно. На опоздавшие ответы не ждут.
Обогащайте одного донора за раз. Из каждого оставшегося ответа берите только то, чего не хватает базе, или что усиливает то, что там уже есть: прецедент, цифру, аналог, угол зрения, ссылку на первоисточник. Вставляйте это в соответствующий раздел с меткой Усиление (название модели).
Сохраняйте происхождение. Каждый вклад несет метку своего донора. Происхождение модели отличается от происхождения доказательства, и когда доступна ссылка на оригинальный источник, она также передается, а не только атрибуция.
Корректируйте открыто. Содержание базы, как правило, сохраняется. Если донор исправляет ошибку в якоре, внесите исправление и оставьте однострочное примечание о том, что изменилось и почему. Сохранять известную ошибку якоря, следуя правилу против изменения базы, хуже, чем ее исправлять. Основное правило состоит в том, что информация не теряется молча, а не в том, что база неизменяема.
Выявляйте разногласия. Отдельный раздел отделяет согласие от разногласий. Противоречивые утверждения никогда не усредняются в промежуточную позицию.
Помечайте связанные доказательства. Несколько моделей, ссылающихся на одну и ту же статью, представляют одну доказательственную линию, а не несколько независимых подтверждений. Это же правило применяется на уровне композиции. Если согласные модели были построены компаниями одного типа или в одной юрисдикции, и разделение проходит по этой линии, укажите на это.
Признавайте уникальные вклады, по одной строке на модель.
Добавляйте собственное мнение оркестратора в виде финального раздела, если пользователь это просил.
Выявите ключевые факты. Определите два или три факта, на которых фактически основана рекомендация, обычно это числа, и отметьте каждый как имеющий проверяемый источник или основанный только на согласии моделей. Если они согласуются по какому-либо числу, а никто из них не указывает его источник, это предупреждение, а не подтверждение.
4.3 Алгоритм
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
Сбор и синтез происходят одновременно. Якорь становится основой как только он поступит, и каждый последующий ответ включается по мере его получения. Быстрые поставщики отвечают за одну-две минуты, в то время как режимы глубокого исследования занимают пять-двадцать пять минут, поэтому сериализация двух фаз превратила бы прогон в получасовой блок без всякой пользы.
4.4 Форма результата
Порядок разделов — часть протокола, а не представления.
Квитанция находится в начале: кто ответил, кто нет и почему, в чём согласие и разногласие и что не проверено, где доказательства коррелируют, и примерно сколько времени и квоты стоил прогон. Затем тридцатисекундное резюме для руководства, затем оглавление.
Согласие и разногласие идут сразу после резюме: это единственный компонент, который ни одна отдельная модель не могла бы создать, и причина для применения этого метода вообще. Поместьте в конце, под удобным консенсусом, и полезный документ начинает читаться как очевидный, и затем его перестают читать.
После этого идут базовые разделы, каждый состоящий из якорного контента плюс подписанные подкрепления; список того, что каждая модель внесла уникально; и, где пользователь об этом просил, собственный взгляд оркестратора.
4.5 Правила и устраняемые ими отказы
Таблица 1. Правила протокола и устраняемые ими отказы
| Правило | Устраняемый отказ |
|---|---|
| Якорь по рубрике, не по бренду | Систематическое смещение в сторону предпочитаемой модели |
| Доноры добавляют только отсутствующее | F1: основание не переписывается, поэтому генерируется меньше стыков |
| Происхождение каждого вклада | F1 и аудитируемость: читатель может проверить вместо доверия |
| Исправление с пояснительной строкой | Закрепление ошибки в якоре |
| Разногласие в отдельной секции, размещённое высоко | F2, F4 |
| Общее доказательственное происхождение помечено | Ложная независимость (раздел 5) |
| Опорные факты отмечены как источниковые или только согласованные | Согласие, рассматриваемое как доказательство |
| Не-прогоны никогда не представляются как прогоны | F5 |
Это архитектурный аргумент, и раздел 9 определяет, что его протестирует.
4.6 Проработанный пример
Протокол такого вида легче оценить по его результатам, чем по его описанию. Ниже приводится отрывок из реального прогона свободного пути от 31 августа 2026 года: один вопрос, заданный в четырёх отдельных сеансах четырём потребительским моделям чата, а затем объединённый по указанным выше правилам. Имена доноров появляются здесь, в отличие от раздела 7, потому что происхождение — это свойство, которое демонстрируется, и анонимный пример не демонстрировал бы ничего.
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
В этом отрывке четыре элемента показывают работу протокола, а не его описание. Разногласие о четвёртой копии приводится в полноте, с обеими сторонами и с различными причинами обеих моделей, вместо разрешения в удобное резюме «три или четыре в зависимости от вашей готовности к риску», которое скрыло бы, какой аспект может быть интересен читателю. Аргумент о облачном хранилище указывает имя модели, которая его предоставила, поэтому читатель, не доверяющий этой модели, может игнорировать эту строку и никакую другую. Заключительное примечание — это правило 6 в действии: одна модель предоставила единственные числовые данные в документе, и слияние отметило их как один источник, вместо того чтобы позволить их присутствию в четырёхмодельном документе читаться как согласие.
Четвёртое — это то, чего нет в отрывке: это предшествует правилу 9, поэтому его основные факты не разделены между авторитетными источниками и только консенсусом, и он воспроизведён в таком виде, в каком вышел, потому что пример, отредактированный для соответствия правилам, которые он иллюстрирует, уже не был бы доказательством их работы.
5. Коррелированное согласие
Примечание о приоритете. Арифметика в этом разделе не является новой и не претендует на вклад. Kohli (2026) применил ту же коррекцию Kish к панели из девяти авангардных судей и измерил примерно два эффективных голоса за три месяца до того, как эта статья была впервые размещена, а Kim et al. (2025) установили корреляцию ошибок, которая движет её на более чем 350 моделях. Раздел сохранён по трём причинам: три правила протокола выведены из него, читатель, который не видел арифметику, будет воспринимать эти правила как скрупулёзность, а не как необходимость, и процедура оценки в разделе 5.5 — это то, что протоколу нужно в условиях, которые никто не измерял. Там, где эта литература измеряет корреляцию, этот протокол пытается её снизить.
Если десять моделей согласны, то утверждение, вероятно, верно в конце концов. Это самое сильное интуитивное возражение против раздела 4, и оно слабее, чем кажется; выяснение того, насколько оно слабее, также превращает правила 6 и 9 из хорошей практики в арифметику.
5.1 Постановка
Пусть N моделей ответят на одно бинарное утверждение, и пусть e_i ∈ {0,1} указывает на ошибку модели i. При независимости, с индивидуальной точностью p > 1/2, согласие между N моделями — это свидетельство, которое растёт экспоненциально с N. Это содержание теоремы Condorcet (Condorcet, 1785).
Модели, обученные на перекрывающихся корпусах, наследуют общие фреймы, цитируют те же вторичные источники и разделяют слепые пятна своего времени, поэтому их ошибки коррелированы. Суд находится в той же позиции с десятью свидетелями, которые все смотрели одну видеозапись с камеры наблюдения: десять показаний, одно наблюдение, и количество свидетелей ничего не говорит о том, сколько было независимо увидено. Этому разрыву можно дать число, и остаток этого раздела это делает. Определим внутриклассовую корреляцию ошибок как
5.2 Эффективное количество свидетелей
Совет коррелированных моделей структурно является кластерной выборкой. N наблюдений внутри одного кластера с внутриклассовой корреляцией ρ не несут N единиц информации, и стандартная коррекция — это эффект дизайна (Kish, 1965):
что дает эффективный размер выборки
Таким образом, совет из N моделей, чьи ошибки коррелируют на ρ, стоит столько же, сколько независимых свидетелей. Таблица 2 приводит выбранные значения, а Таблица 8 в Приложении B приводит полный диапазон.
Таблица 2. Эффективное количество независимых свидетелей, , для выбранных N и ρ
| ρ (вниз) / N (вправо) | 2 | 3 | 5 | 10 | 20 | предел N→∞ |
|---|---|---|---|---|---|---|
| 0 (независимые) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 Потолок
Крайний правый столбец — это основной результат этого раздела. При N → ∞,
Совет имеет потолок, и это не зависит от количества спрошенных моделей. Панель (a) Рисунка 1 показывает насыщение напрямую. При ρ = 0.5 совет из тысячи моделей стоит двух независимых свидетелей, а при ρ = 0.7 — менее полутора. Добавление одиннадцатой модели к десяти при ρ = 0.3 даёт примерно 0.05 свидетеля. Переход от ρ = 0.3 к ρ = 0.15 с теми же пятью моделями даёт примерно 0.85.
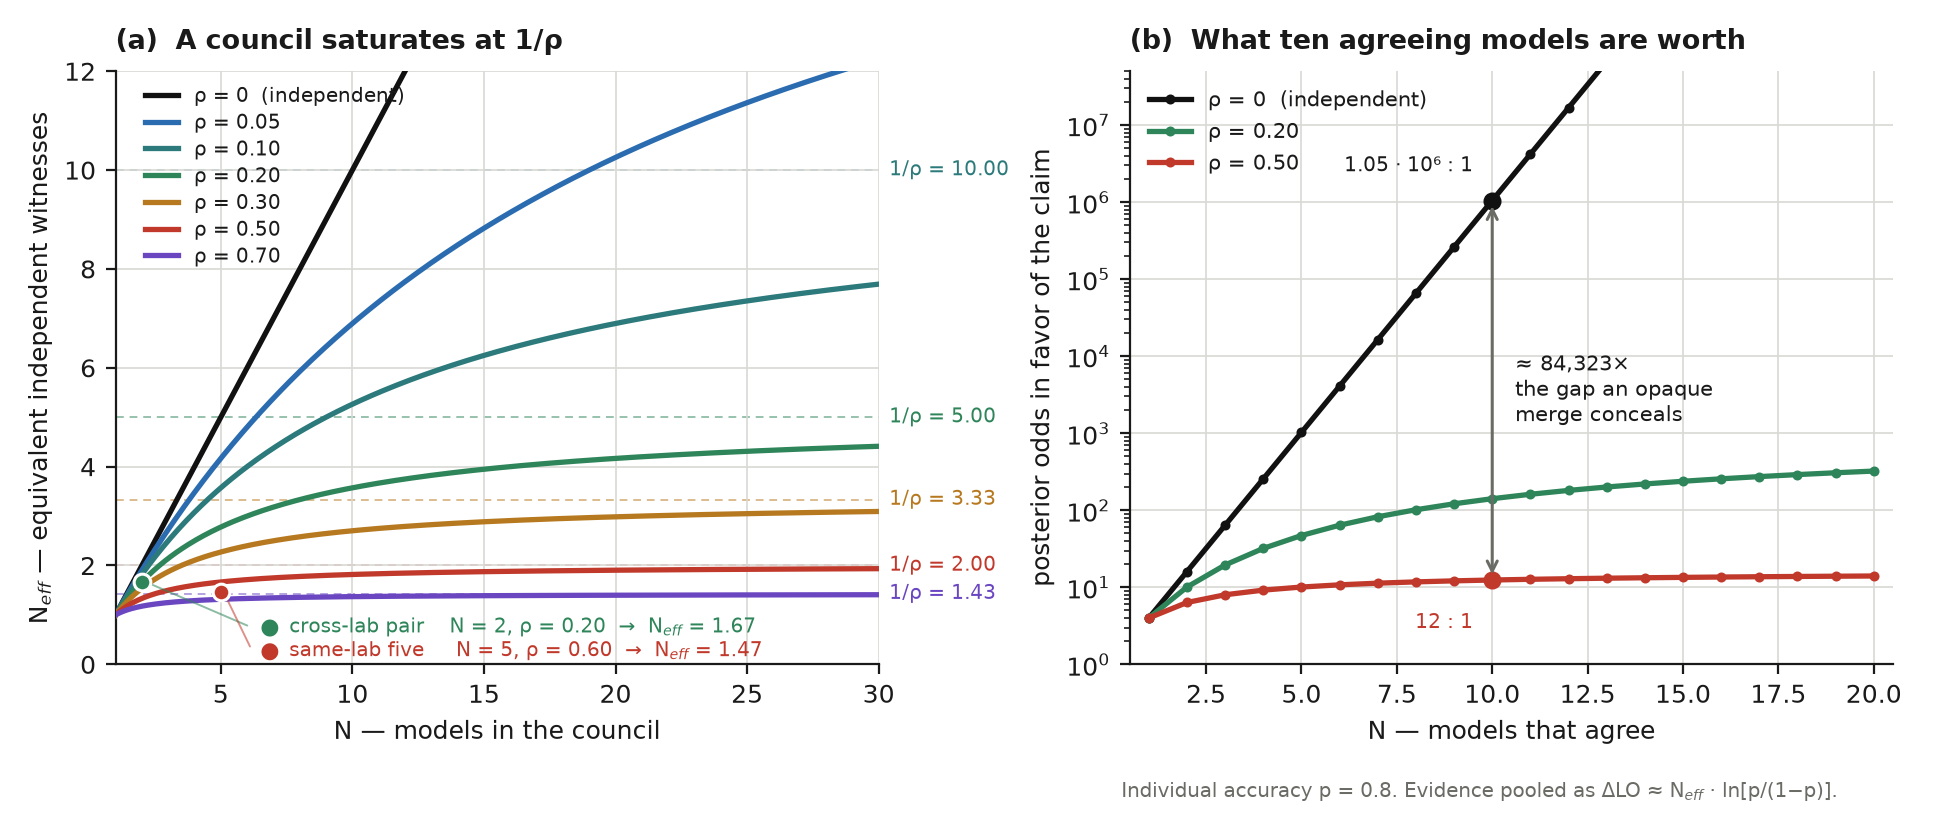
Рисунок 1 — Совет насыщается при 1/ρ. (a) Neff в зависимости от размера совета N для нескольких значений корреляции внутриклассовой ошибки ρ. Каждая кривая насыщается на уровне потолка 1/ρ, показанная пунктирной асимптотой; пара из разных лабораторий при ρ = 0.20 перевешивает пятёрку из одной лаборатории при ρ = 0.60. (b) Тот же результат как апостериорные коэффициенты вероятности (иллюстративный суррогат в соответствии с приближением, указанным в разделе 5.4), с индивидуальной точностью p = 0.8 и объединённым доказательством как ΔLO ≈ Neff · ln[p/(1−p)]. Десять независимых согласованных моделей дают коэффициент около миллиона к одному; десять моделей, коррелированных при ρ = 0.5, дают двенадцать к одному.
Практическое следствие противоречит интуиции, что нужно просто использовать больше моделей. Когда совет больше, чем 1/ρ, уменьшение ρ вдвое лучше, чем удвоение N. Это следствие столь же характерно для Kohli (2026), как и для всех прочих, и его комиссия иллюстрирует эту арифметику, наблюдаемую на практике: девять судей, эквивалентные примерно двум эффективным голосам, соответствуют ρ ≈ 0.44. Уменьшение ρ вдвое лучше, чем удвоение N, и оба сравнения ниже относятся к разделу 6.
Две модели из разных лабораторий при ρ ≈ 0.2 дают ≈ 1.67, в то время как пять из одной лаборатории или линии при ρ ≈ 0.6 дают 5/(1 + 4·0.6) ≈ 1.47, поэтому пара из разных лабораторий имеет больший вес, чем пятёрка.
Увеличение числа моделей также демонстрирует резкий убывающий эффект, тогда как увеличение разнообразия — нет. Движение вдоль строки таблицы 2 быстро насыщается, в то время как движение вверх по столбцу не имеет предела.
Это является аналитическим основанием для составления совета равномерно по различным линиям вместо максимизации количества. Пять моделей, которые согласуются, потому что читают один и тот же корпус, являются более слабым доказательством, чем три, которые действительно расходятся.
5.4 В логарифмических шансах
Если независимый свидетель с точностью p вносит логарифмические шансы
то согласие между N коррелированными моделями даёт примерно
вместо N · L. Это обычный способ обработки коррелированных наблюдений в метаанализе, используемый здесь как приближение: он рассматривает скорректированное с учётом эффекта дизайна количество как число независимых свидетелей, хотя сам эффект дизайна этого не устанавливает. На панели (b) рисунка 1 показано это графически. При p = 0.8, так что L ≈ 1.386 натов:
- десять независимых свидетелей дают ΔLO ≈ 13.86 натов и апостериорные коэффициенты вероятности около 1.05·10⁶ : 1;
- десять моделей при ρ = 0.5, так что ≈ 1.82, дают ΔLO ≈ 2.52 ната и апостериорные коэффициенты вероятности около 12 : 1.
Это отношение составляет примерно 8.4·10⁴. Этот множитель — то, что непрозрачное объединение передаёт читателю в качестве незаслуженной уверенности, и поэтому существует расчёт и почему отмечаются несущие факты. Документ должен объяснить, составляют ли коэффициенты согласия перед читателем 10⁶ : 1 или 12 : 1, потому что на странице они выглядят одинаково.
5.5 Предположения и оценка
Модель проста, и её предположения соответственно строги. Она основана на следующем.
ρ рассматривается как единообразная во всех парах. На практике она имеет блочную структуру, так как модели из одной лаборатории коррелируют более сильно друг с другом, чем с моделями из других мест. Попарное усреднение было бы лучше, а блочная структура ещё лучше. При блочной структуре однородная формула даёт оптимистический и истинный потолок находится ниже, чем показано в таблицах.
ρ также рассматривается как постоянная во всех вопросах, тогда как она явно зависит от предметной области. На узкотематическую тему с одним доступным источником она приближается к единице. На вопрос с богатой многоязычной литературой она намного ниже.
Утверждения рассматриваются как бинарные, в то время как реальные ответы — это проза, и сведение прозы к сравнимым бинарным утверждениям является зашумленной операцией сама по себе. Точность p рассматривается как единообразная во всех моделях, чего она не является.
ρ, тем не менее, измеряема. Учитывая Q помеченных бинарных утверждений с известным истинным значением и результирующей матрицей ошибок e_iq для i = 1…N и q = 1…Q, внутриклассовая корреляция следует обычным путём дисперсионного анализа как отношение средней попарной ковариации ошибок к средней дисперсии ошибок:
Оценка ρ отдельно внутри и между лабораториями даёт числовую оценку стоимости монокультуры (Kleinberg & Raghavan, 2021; Bommasani et al., 2022). Наблюдение за его дрейфом в ходе последовательных поколений моделей даёт то же самое для стоимости обучения на сгенерированных данных (Shumailov et al., 2024).
5.6 Как это меняет протокол
Если формула признана верной, правила 5 и 6 из раздела 4, а также отчётность о составе, которую подразумевает правило 6, перестают быть надлежащей практикой и становятся необходимыми.
Обозначение общего источника, правило 6, — это локальное измерение ρ на уровне отдельного утверждения. Пять цитирований одной статьи означают ρ ≈ 1 для этого утверждения, поэтому ≈ 1.
Отчётность о связи между согласующимися моделями — это то же самое измерение на уровне состава.
Сохранение разногласия, правило 5, — единственное свидетельство того, что ρ менее единицы, которое читатель когда-либо получает. Расхождение демонстрирует, что корреляция неполная, и оно информативно независимо от того, какая сторона окажется правой. Разногласие — это измерительный инструмент, а не препятствие, которое нужно устранить. Совет, который всегда согласен, не говорит читателю ничего о мире, только то, что ρ ≈ 1 и что совет был излишним.
6. Три уровня, один протокол
Протокол работает на трёх уровнях, которые представляют собой три точки на кривой доступа, а не три версии или воронку. Один пользователь может использовать все три в течение недели для разных вопросов.
6.1 Уровень 0, бесплатный путь
Пользователь открывает сайты, задаёт вопрос, копирует каждый ответ и вставляет их под подсказку объединения в любую модель чата. Без затрат, без установки, любое устройство с браузером, включая телефон, и совет размером с набор учётных записей, в которые вошёл пользователь. Задержка составляет десять—пятнадцать минут, большую часть которых занимает ожидание, и больше при режимах глубокого исследования.
Этот уровень является эталонной реализацией в строгом смысле. Это единственный, где пользователь имеет каждый исходный ответ, что делает его единственным, где верность объединения можно оценить непосредственно.
6.2 Уровень 1, мобильный уровень
Одна иконка на главном экране и одна запись в библиотеке ярлыков. Коснитесь, введите вопрос, выберите режим из меню, и примерно через минуту готовый ответ появится на экране и в буфере обмена. Голосовой запуск работает.
Механизм — это ни браузер, ни API. Он связывает собственные интенты приложений операционной системы поставщиков с приложениями и подписками, уже установленными на устройстве. Стоимость выражена в сообщениях подписки, а не в токенах, что делает дизайн режима решением по распределению ресурсов, а не делом вкуса. Альтернативная мобильная платформа имеет эквивалент через автоматизацию на основе интентов.
Таблица 3 описывает три режима. Это равные параллельные функции, а не этапы конвейера: один режим выполняется за вызов.
Таблица 3. Три режима мобильного уровня
| Режим | Цепь | Сообщения | Использование |
|---|---|---|---|
| Опрос | Обе модели отвечают независимо; ответы показаны рядом | 1 + 1 | Прямое видение расхождения |
| Критика | Модель A отвечает; модель B проверяет в качестве второго эксперта и выдаёт улучшенный окончательный ответ | 1 + 1 | Повседневное значение по умолчанию: проверенный ответ стоимостью в два сообщения |
| Синтез | Обе отвечают вслепую; дополнительный вызов рассеивает и объединяет, отмечая расхождения | 1 + 2 | Важные вопросы |
Режим критики вкратце назывался председателем. Три режима — это равные параллельные функции, и критика — это рецензирование коллегами: один эксперт отвечает, второй проверяет. Роль председателя уже существует в Синтезе в качестве арбитра, и называть рецензирование коллегами названием агрегирования было бы неправильным описанием того, что делает этот режим.
На телефоне охват — это не дешёвое благо, что определяет N = 2 здесь. Каждый вызов использует сообщение из той же квоты, что и обычное использование, приложения выходят на передний план последовательно, и пользователь стоит и ждёт. Раздел 5.3 показывает, насколько ценна пара: две модели происходят из разных лабораторий, выбор, минимизирующий ρ, доступный при N = 2, и при тех иллюстративных корреляциях пара между лабораториями при ρ ≈ 0,2 превосходит пять из одного семейства при ρ ≈ 0,6, поэтому большая часть того, для чего предназначен совет, сохраняется при одном касании и одной минуте.
6.3 Уровень 2, путь агента
Модель, которая может управлять браузером, открывает названные сайты в сеансе браузера, в который вошёл пользователь, отправляет вопрос, ждёт, сохраняет каждый ответ в файл и создаёт документ. Совет расширяется до десяти или более, доступны режимы глубокого исследования, и датированная папка с каждым исходником остаётся после запуска. Стоимость — небольшая ежемесячная подписка на агента плюс любые платные уровни, которые уже есть у пользователя. Задержка составляет пять—тридцать минут.
Этот уровень даёт пользователю то, что выходит за рамки одного случая использования, а именно модель, которая действует на его компьютере вместо того, чтобы описывать действия. Разница между моделью, которая отвечает, и моделью, которая действует, больше, чем разница между одной моделью и десятью.
6.4 Граница задержки–охвата
Таблица 4. Граница задержки–охвата на трёх уровнях. Подсчёт эффективных свидетелей предполагает ρ = 0,2
| Уровень 0, бесплатный | Уровень 1, мобильный | Уровень 2, агент | |
|---|---|---|---|
| Кто нажимает | пользователь | операционная система | агент браузера |
| Размер совета N | неограниченный | 2 | до ~10 |
| при ρ = 0,2 | до ~4–5 | 1,67 | ~3,6 |
| Время до ответа | 10–15 мин | ~1 мин | 5–30 мин |
| Предельная стоимость | нулевая | сообщения подписки | подписка на агента |
| Установка | нет | один подписанный ярлык | приложение агента |
| Режимы глубокого исследования | да, вручную | нет | да |
| Видны исходные ответы | да | только режим опроса | да, сохранены в файлы |
| Устройство | любое | телефон | компьютер |
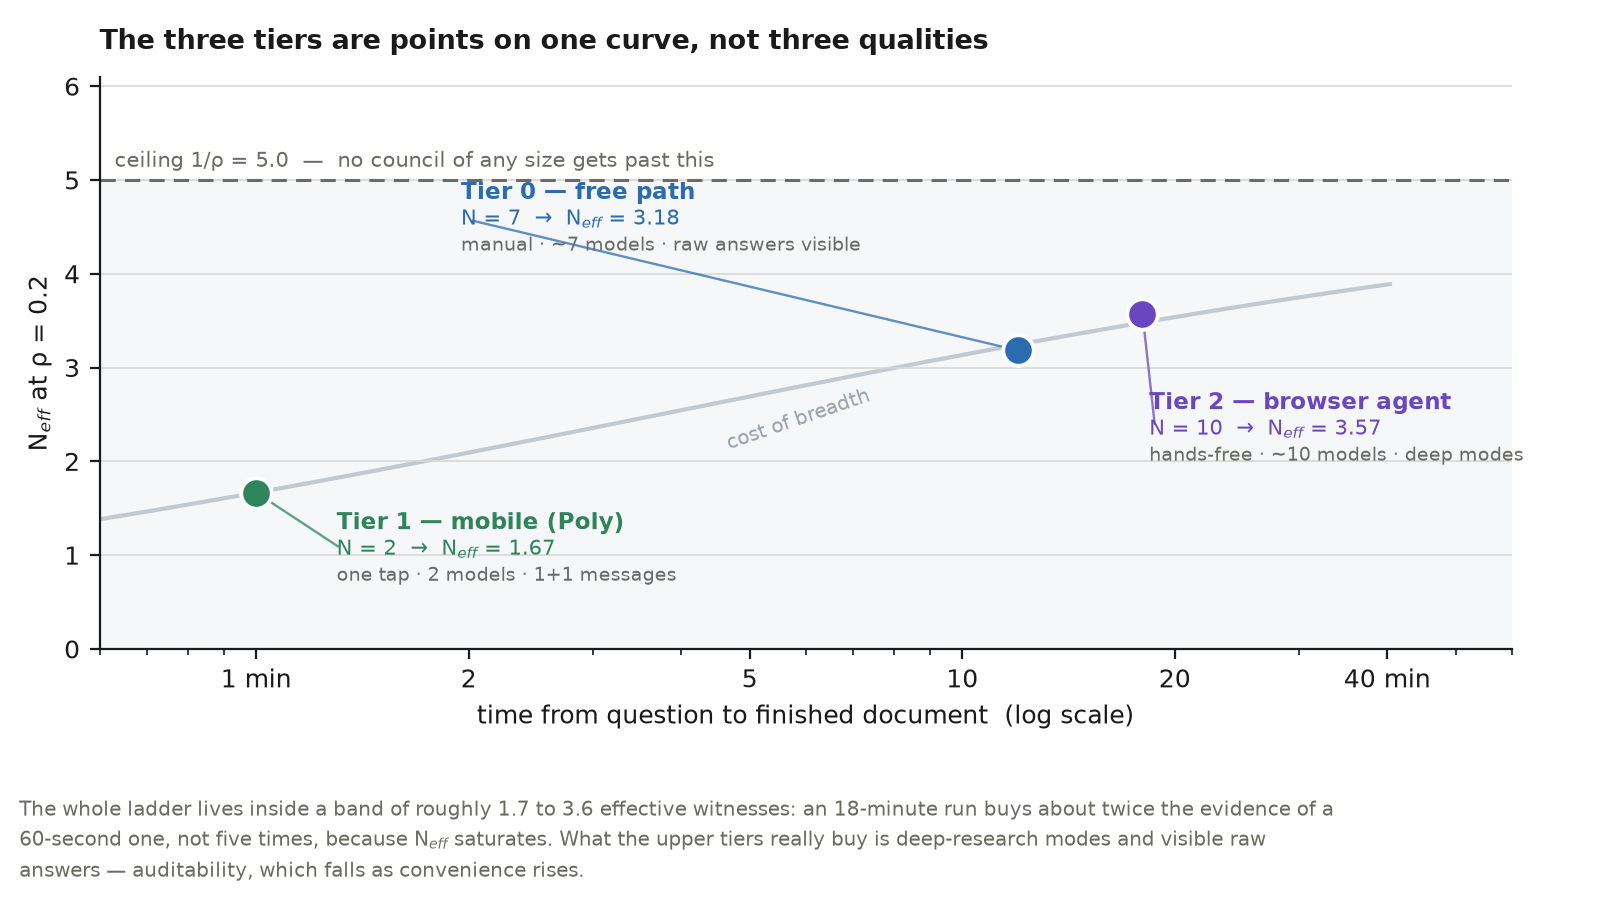
Рисунок 3 — Граница задержки–охвата. Три уровня отложены по времени до готового документа с вычисленным при ρ = 0,2 Neff. Поскольку Neff насыщается при 1/ρ, два автоматизированных уровня находятся в полосе примерно от 1,7 до 3,6 эффективных свидетелей: восемнадцатиминутный запуск даёт примерно в два раза больше доказательств, чем шестидесятисекундный, а не в пять раз. Дополнительно верхние уровни дают режимы глубокого исследования и видимые исходные ответы.
Два наблюдения следуют из раздела 5, а не из инженерии.
Уровни упорядочены по стоимости широты охвата, а не по качеству. Уровень 1 находится в точке кривой, где ответ приходит в пределах времени внимания человека, стоящего в магазине. Разрыв между уровнями с точки зрения доказательств намного меньше, чем разрыв в количестве моделей, потому что насыщается при 1/ρ, и именно это делает лестницу связной вместо набора компромиссов.
Проверяемость снижается вдоль лестницы в направлении, противоположном удобству. На Уровне 0 пользователь имеет все необработанные ответы. На Уровне 2 агент записывает их в файлы, поэтому они существуют, но редко открываются. На Уровне 1 их раскрывает только режим Poll, поскольку Critique и Synthesis возвращают готовый текст. Мобильный уровень слабее в этом отношении и воспроизводит проблему, которой открывается статья: чем удобнее уровень, тем больше пользователь полагается на доверие вместо проверки. Сохранение маркеров расхождения в выводе Synthesis — это не просто презентационное изящество. Это оставшаяся проверяемость уровня.
6.5 Слепопараллельное и информированно-последовательное извлечение
Мобильный уровень вынес на свет ось, которую другие уровни оставляли неявной, и это самый важный вопрос проектирования в системе. Видит ли вторая модель ответ первой модели? На Рис. 4 представлены оба варианта с описанием того, что каждый приносит и какой ценой.
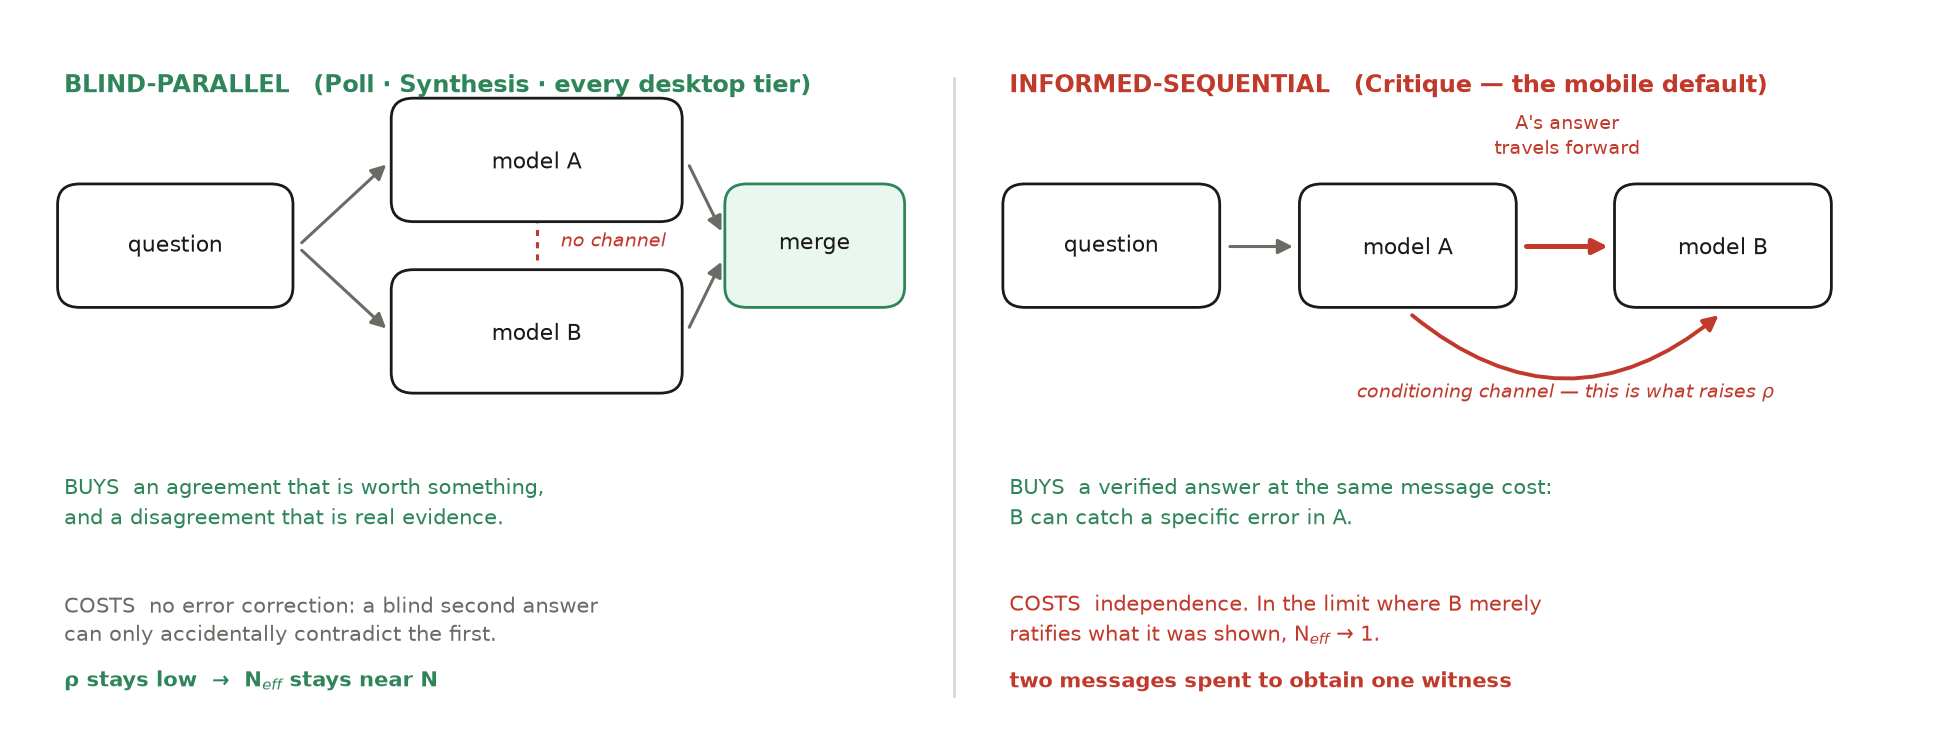
Рис. 4 — Слепопараллельное и информированно-последовательное извлечение. Сравнение двух режимов. При слепопараллельном извлечении нет канала между моделями, поэтому согласие имеет доказательственный вес, а несогласие является реальным доказательством, но коррекция ошибок не происходит. При информированно-последовательном извлечении первый ответ вводится в подсказку второй модели: вторая может исправить конкретную ошибку, но канал обусловленности повышает ρ, и в пределе, когда она подтверждает показанное, Neff приближается к одному.
Poll и Synthesis — это слепопараллельные процессы. Обе модели отвечают на исходный вопрос, и ни одна не видела другую. Независимость здесь архитектурная, а не предусмотренная инструкциями: каждый вызов app-intent открывает новую сессию без памяти, и каждая подсказка самодостаточна, содержа вопрос и любые предыдущие ответы. Не существует канала, через который одна модель могла бы влиять на другую.
Critique — это информированно-последовательный процесс. Вторая модель получает вопрос вместе с ответом первой модели и получает инструкцию проверить его на фактические ошибки, добавить пропущенное и выдать один улучшенный финальный ответ.
На первый взгляд информированный подход выглядит так, как будто он просто доминирует над слепым: вторая модель делает всё, что делает слепая вторая модель, и проверяет первый ответ также, при той же стоимости. Это впечатление обманчиво, потому что два подхода приносят разные выгоды, и информированный платит независимостью.
Информированно-последовательное извлечение приносит коррекцию ошибок. Вторая модель, которая может видеть ответ первой, может уловить конкретную ошибку в нём, тогда как слепой второй ответ может только случайно ему противоречить. Это механизм, стоящий за результатами многоагентных дебатов (Du et al., 2023), и это то, что делает Critique повседневным стандартом: при той же двухсообщаемой стоимости, что и Poll, он возвращает проверенный ответ вместо двух непроверенных.
Это платит за это независимостью, то есть ρ. Обусловливание второго ответа первым — это социальное влияние, которое Lorenz et al. (2011) обнаружили, сужает разброс в толпе, не приближая её к истине. Критик, закреплённый якорем, согласен с показанным ему ответом чаще, чем это делал бы независимый коллега, поэтому полученное согласие стоит меньше, чем кажется. Граница легко формулируется и неудобна: в пределе, где критик подтверждает показанное, → 1, и процесс потратил два сообщения для получения одного свидетеля.
Это то место, где Раздел 5 становится советом, который пользователь может применить. Информированно-последовательное извлечение — это правильный выбор для проверки ответа, а слепопараллельное извлечение требуется, если вопрос в том, существует ли расхождение вообще. Расхождение, которое появляется после того, как вторая модель прочитала первую, является доказательством, тогда как расхождение, которое не проявляется, не является доказательством согласия, потому что канал, который бы его произвел, был закрыт.
Synthesis — это отдельный режим, а не более тщательная версия Critique. Synthesis не более тщателен. Он слепой, что является другим свойством, и это единственный мобильный режим, чьё согласие имеет какой-либо доказательственный вес. Его дополнительное сообщение обеспечивает арбитра, но его ценность проистекает из того, что два арбитрируемых ответа никогда не встречались.
Уровни 0 и 2 по конструкции слепопараллельны, поскольку каждая модель получает исходный вопрос в собственной сессии, а слияние anchor-and-enrich происходит впоследствии. Anchor-and-enrich лучше всего понимается как информированный этап, размещённый после полностью слепого. Такое упорядочивание обеспечивает коррекцию ошибок без потери независимости, но вместо этого платит задержкой. Мобильный уровень не может себе позволить такое упорядочивание в режиме по умолчанию, поэтому компромисс становится видимым там и больше нигде.
6.6 Почему не API
Выбор транспорта определяет, кто может использовать систему, поэтому это не деталь.
API обеспечивает воспроизводимость, а именно известную версию модели, температуру и seed; программную надёжность; отсутствие вопросов об условиях обслуживания; и низкую стоимость при масштабировании. Браузер и app intents предоставляют отсутствие установки, отсутствие ключей, отсутствие дополнительных биллинговых отношений, совместимость с телефоном, работу на бесплатных уровнях, доступ к режимам глубокого исследования, которые часто не имеют API-эквивалента, и использование подписок, которые пользователь уже оплачивает.
Протокол занимает второе место. Тому, кто располагает ключами API и уверен в терминале, лучше подойдёт совет на основе API, такой как llm-council Карпатого (Karpathy, 2025). Целевая аудитория здесь — те, для кого вторая подписка — существенные затраты, или те, кто не может установить ПО на используемую машину, или те, кто имеет доступ в интернет только через мобильный телефон. Для этих пользователей это, вероятно, первая доступная реализация идеи, поскольку она не требует ключей, установки и второго платежа, а доступность — причина того, что система — текстовый файл, а не продукт.
Цена этого — невоспроизводимость, и она высока. Версия модели, стоящая за веб-интерфейсом или потребительским приложением, неизвестна и меняется без уведомления. Температуру нельзя контролировать, системная подсказка сервиса скрыта, и персонализация учётной записи влияет на ответ. Запуск не может быть точно повторён ни в следующем месяце, ни на другой машине. Это приемлемо для личного инструмента принятия решений и неприемлемо для научного измерения. Раздел 9 соответственно требует, чтобы необработанные ответы архивировались и выводы формулировались как утверждения о протоколе, а не как утверждения о моделях.
6.7 Безопасность
Свободный путь не добавляет специфичной для автоматизации поверхности атак, поскольку пользователь непосредственно работает с сайтами, хотя обычные риски браузера и самих учётных записей остаются. Далее рассматривается путь агента.
Основной риск — косвенная инъекция подсказки (OWASP, 2025). Каждый собранный ответ — недоверенный ввод, поскольку выход модели может содержать инструкции, адресованные оркестратору. Фильтрация строк — не защита: она повреждает законный контент и ничего не гарантирует.
Конструктивный ответ — ограничение полномочий. Собранный текст рассматривается как цитируемые данные и никогда не как команды. Если модель выше по цепочке выпускает блок вызова инструмента или воспроизводит введённую инструкцию, оркестратор объединяет его как цитату и ничего не выполняет.
В соответствии с подходом правила двух (Meta, 2025), агент становится опасным, когда обладает всеми тремя: обработкой недоверенного ввода, доступом к конфиденциальным данным или системам и способностью изменять внешнее состояние или общаться извне. Описанный здесь агент обладает первыми двумя и держит третий настолько узким, насколько возможно. Его единственное действие, покидающее машину пользователя, — отправка вопроса пользователя на названные пользователем сайты; то, что он пишет, — назначенные файлы вывода на этой машине. Он не покупает, не публикует, не удаляет, не изменяет параметры, не вводит учётные данные и не проходит проверки вызов-ответ. Что более важно, ничто, что он читает, не может стать новым внешним действием: ни один собранный ответ не может вызвать новый шаг или новое направление. Недоверенный ввод и внешнее действие разделены: единственное внешнее общение — это собственный вопрос пользователя, отправленный до прочтения любого собранного ответа. Отравленный вышестоящий ответ, таким образом, не может распространяться, и реальный наихудший случай в документе — неправильная строка, которую помогают выловить метки происхождения; риски уровня сеанса решаются операционными правилами ниже.
Это согласуется с литературой по изоляции возможностей (Debenedetti et al., 2025) и объясняет, почему эксплуатация агентов с нулевым кликом, такие как EchoLeak (CVE-2025-32711; MITRE, 2025), успешны в других местах: там все три возможности связаны друг с другом.
Операционные правила состоят в видимом окне браузера вместо безголового, в сеансе, в который пользователь вошёл в отдельном профиле браузера, без сохранения или ввода учётных данных и без прохождения проверок вызов-ответ, подделки отпечатков пальцев, ротации прокси и совместного использования нескольких учётных записей. Недавние версии браузера игнорируют флаги удалённой отладки на профиле по умолчанию как защиту от кража cookie через протокол, поэтому автоматизация должна использовать отдельный каталог профиля. Отдельный каталог — это неудобство, но также более безопасная компоновка. Инструмент, претендующий на бесшумное подключение к повседневному сеансу браузера пользователя, заслуживает подозрения.
Это сводится к ограничению на уровне подсказки плюс преднамеренно небольшая поверхность инструмента, а не техническая песочница. Это уменьшает радиус поражения. Это не доказывает, что радиус равен нулю.
Поверхность угроз мобильного уровня иная и меньше. Вызовы проходят через опубликованные поставщиком системные намерения вместо управляемого браузера, устройство должно быть разблокировано с приложениями, входящими в передний план по очереди, и ничего не работает в фоновом режиме. Это кнопка, которую нажимает пользователь, а не запланированная автоматизация. Опасение относительно инъекции подсказки остаётся актуальным в критике и синтезе, где выход одной модели входит в подсказку другой модели, и это обрабатывается одинаково: собранный ответ — это цитируемый материал, и получающая модель не имеет доступных ей действий.
7. Эмпирическая часть
7.1 Тест холодного старта
Первый шаг пользователя — передать систему модели. Если эта модель отказывает или возвращает то, что только напоминает результат, пользователь уходит и никогда об этом не сообщает. Этот момент измеряет тест холодного старта, и его невозможно автоматизировать, поскольку требуется свежий сеанс, который никогда не сталкивался с проблемой.
Промпт выходит без подсказок, без фреймирования и без дальнейшего развития:
Запустите метод из этого репозитория для вопроса: Каковы три самых больших риска недостаточного потребления воды? Делайте то, что метод говорит вам делать.
Есть три окружения. В A агент находится в клоне с намеренно отключённым управлением браузером. B — обычный сеанс чата, в который вставлена только документация первой страницы, и в C агент имеет работающее управление браузером.
Оценивается только первый ответ по шести бинарным критериям. Это ограничение составляет методологическую основу теста, поскольку то, что модель говорит после исправления, не представляет опыт, который был бы у незнакомца.
- Проверила ли она инструменты, доступные в этом сеансе, вместо рассуждений о том, какой тип модели она есть?
- Избежала ли она простого отказа без следующего шага в том же сообщении?
- Когда что-то отсутствовало, назвала ли она конкретный отсутствующий компонент вместо категории ограничения?
- Предложила ли она ручной путь в том же ответе, не спросив дважды?
- Мог ли пользователь сразу же действовать на основе ответа?
- Когда она не собирала ответы от отдельных моделей, сказала ли она об этом перед тем как что-либо показать?
Критерий 6 был написан после базовой серии и перевешивает остальные пять. Ответ, который читается как совет, но пришёл от одной модели, провалит тест полностью, независимо от того, насколько хорошо он выполнен, и он будет хорошо выполнен.
7.2 Базовая серия
Каждой из пяти моделей была дана документация и обычный вопрос без подсказок. Ни у одной не было управления браузером, поэтому серия измеряла только одно: как модель сообщает об невозможности запустить метод. Таблица 5 отражает результаты. Модели там идентифицируются по лаборатории, а не по названию продукта, поскольку речь идёт о режиме отказа, общем для нескольких из них, а не о рейтинге.
Таблица 5. Тест холодного старта, базовая серия. Пять моделей, управление браузером отсутствует, оценен первый ответ
| Модель | Разработчик | Результат |
|---|---|---|
| Model G | Laboratory 1 | Пройден. Проверила свои инструменты, назвала отсутствующий компонент, заявила, что никуда не отправляла вопрос, попросила два необходимых выбора и заранее предупредила, что представление одной модели не будет результатом метода. |
| Model S | Laboratory 2 | Пройден с объявленной подстановкой. Использовала веб-источники вместо ответов моделей и сказала об этом в этих словах, включая то, что это был меньший и по-другому составленный совет, чем предусмотрено методом. |
| Model H | Laboratory 2 | Пройден. Ничего не подставляла. Передала промпт и попросила ответы обратно. |
| Model C | Laboratory 3 | Не пройден. Веб-исследование, написанное в собственной терминологии метода, без оговорок. |
| Model K | Laboratory 4 | Не пройден. Полностью готовый документ правильной структуры, сохранённый под именем выходного файла метода, поступивший со веб-страниц вместо моделей, без оговорок. |
Две из пяти создали документ, который пользователь мог бы отправить как совет из десяти. Это F5, наблюдаемое.
7.3 Вмешательство и повторное выполнение
Вмешательство было одним предложением назначения роли, которое говорило модели, что она оператор этого запуска и должна прочитать файл инструкций агента. Оно было помещено на первый экран документации и в отдельный файл, адресованный моделям. Таблица 6 отражает повторное выполнение в окружении B.
Таблица 6. Тест холодного старта в окружении B после вмешательства назначения роли. Критерии пронумерованы как в разделе 7.1; (web) отмечает серии, выполненные через веб-интерфейсы поставщиков, и C′ — модель лаборатории 3 в этом случае
| Модель | 1 | 2 | 3 | 4 | 5 | 6 | Вердикт |
|---|---|---|---|---|---|---|---|
| Model C′ (web), Laboratory 3 | yes | yes | yes | yes | yes | yes | ПРОЙДЕН |
| Model P (web), Laboratory 5 | yes | yes | yes | yes | yes | yes | ПРОЙДЕН |
| Model K (web), Laboratory 4 | yes | yes | yes | yes | yes | yes | ПРОЙДЕН |
Последняя строка особенно поучительна. Модель, которая в базовой серии создала немаркированное веб-резюме под именем выходного файла метода, на этот раз восстановила промпт слияния из документации и передала его пользователю. Затем она напечатала своё веб-исследование под явным заголовком, отмечающим его как фоновое исследование, а не результат совета, добавив, что оно там только для контекста.
Проверка затем установила, что прохождение теста было измерено относительно более длинного черновика абзаца, который модели цитировали, и что как только абзац был сокращён, более ранний результат больше ничего не доказывал о текущем тексте. Окружение B было повторно запущено с сокращённой версией, которая прошла все шесть критериев. Модель конкретно назвала отсутствующую связь и закончила, сказав, что она не создала результат метода, поскольку независимые ответы не были собраны.
Этот эпизод является находкой сам по себе. Пройденный тест становится недействительным, когда тестируемый текст изменяется, и перенос старого прохождения на новый черновик — это удобная и распространённая форма самообмана.
7.4 Интерпретация
Наблюдение устанавливает, что F5 реально, что оно происходит в моделях из разных лабораторий, и что оно чувствительно к назначению роли, недорогому текстовому вмешательству. Это согласуется с общей находкой, что модели принимают любую рамку, предусмотренную их контекстом (Sharma et al., 2023), и здесь это свойство работает в пользу правильности.
Это не устанавливает частоту. С n = 5 и n = 3, без повторений и с оценкой автора, это демонстрирует, что режим отказа существует и не говорит ничего о его частоте. Все базовые запуски не имели контроля браузера, поэтому то, что было измерено, — это правдивое сообщение об невозможности, а не умение выполнять метод. Прохождение не является одобрением какой-либо модели в качестве координатора; дизайн это не поддерживает. Раздел 10 определяет граничные условия.
Контрольные списки такого рода несут структурный риск. Текст редактируется до тех пор, пока не пройдёт, а затем контрольный список прекращает что-либо измерять. Две охраны держат его измеряющим что-то. Критерий оправдывает редактирование только там, где можно сказать, что пострадал бы реальный пользователь, и критерий добавляется только после того, как живой запуск произвёл соответствующий отказ, никогда потому, что это звучало правдоподобно. Оба верны для шести критериев здесь.
7.5 Полевые наблюдения из мобильной сборки
Построение и сертификация мобильного уровня на физическом устройстве выявили другой класс находок. Это системные доказательства, а не эпистемические доказательства, и документирует поверхность отказа, специфичную для конвейеров приложений с намерением потребителей, которые ломаются способами, которыми конвейеры API не ломаются.
Уровень был сертифицирован полностью с арифметическими дымовыми тестами, выбранными потому, что цифры сохраняются в любой раскладке клавиатуры. Critique вернула правильную сумму вместе с явным утверждением, что ответ первой модели не содержал ошибок, и Poll вернула ответы обеих моделей рядом в согласии. Время отклика от касания до результата составляет около пятидесяти-шестидесяти секунд. Таблица 7 записывает, что сломалось.
Таблица 7. Наблюдаемые режимы отказа конвейера приложения потребителя с причинами и решениями
| Симптом | Причина | Решение |
|---|---|---|
| Намерение первого поставщика сообщает о том, что пользователь вышел из системы, хотя приложение вошло | Известный дефект, повторяющийся после периодов простоя | Откройте приложение один раз и повторите. Вот почему менее надежный поставщик вызывается первым: его отказ ничего не стоит |
| Второй поставщик сообщает, что модель недоступна | Управление доступом к модели со стороны учетной записи на бесплатном уровне; намерение не раскрывает параметр модели | Установите нужную модель по умолчанию внутри приложения; цепь не может выбрать ее |
| Запуск заканчивается молча без ошибки | Наложение запущенного ярлыка отключается касанием устройства | Не трогайте устройство во время запуска; повторите |
| Цепь останавливается на карточке промежуточного ответа | Параметр show-on-run по умолчанию включен | Отключите его во время сборки |
| Длинные ответы обрезаны | Ограничения выхода на уровне намерения | Попросите компактный ответ; качество оценки не снижается измеримо |
Три из них обобщаются за пределы этой системы.
Упорядочите цепь по степени хрупкости. Наименее надежный поставщик идет первым, так что его отказ ничего не стоит, и более надежный получает роли, которые не должны быть потеряны, а именно арбитр и финализатор.
Предположите, что нет памяти. Каждый вызов открывает новый сеанс, поэтому каждый запрос должен быть самодостаточным и содержать вопрос и любые предыдущие ответы в себе. Слепая параллельная независимость поэтому архитектурна, а не предписана, как утверждает Раздел 6.5.
Больше всего опасайтесь молчаливых отказов. Два запуска, которые выглядели завершенными по истечении времени, на самом деле были прерваны пользователем, который поднял устройство. Приписание их программному обеспечению создало бы исправление для несуществующего дефекта.
8. Файл вставки: паттерн интерфейса для руководства при холодном старте
Это отдельный результат интерфейса, который выходит за пределы этой системы.
Файл вставки — это обычный текстовый файл, который пользователь целиком вставляет в облачную модель чата, и эта модель затем проводит его через то, что он иначе не смог бы начать. Ситуация встречается достаточно часто. Кому-то дали папку, ссылку или инструмент, и он не может начать работу. Всё, к чему обычно обращается индустрия в таких случаях — будь то целевая страница, бот адаптации, специальный помощник или приложение — требует от пользователя перейти в новое место, тогда как файл вставки использует уже открытый у них интерфейс.
Это не то же самое, что файлы, которые агент читает самостоятельно и которые адресованы программе, уже имеющей доступ к файлам. Файл вставки адресован сеансу чата в облаке кого-то другого, который не может видеть диск пользователя и никогда не сможет.
Четыре инварианта
Имя файла — это первая инструкция, написанная письмом читателя. Это предложение, а не обычное имя файла документации: один файл на язык, все присутствуют, все отсортированы вместе под общим префиксом. Пользователь не выбирает из списка. Они узнают свою письменную систему и игнорируют остальное, как кто-то пропускает незнакомые строки на многоязычном знаке. Это ничего не стоит и убирает шаг, на котором кто-то должен читать язык, который он может не знать, чтобы найти файл, написанный на том, который он знает.
Файл раскрывает, что модель не может делать, и запрещает претендовать на противоположное. В первом разделе: вы — сеанс чата в облаке, вы не на компьютере пользователя, вы не можете открывать его файлы или запускать что-либо, никогда не утверждайте, что вы смотрели. Характерный отказ этого паттерна, F5 в другой форме, — это уверенный и правдоподобный рассказ о папке, которую модель никогда не видела. Это невидимо пользователю, потому что хорошо сформированный ответ и правильный неразличимы для того, кто не может проверить.
Полнота обнаружима. Манифест разделов в начале и маркер конца файла на последней строке. Инструкции говорят модели найти маркер перед тем, как что-либо сказать; если маркер или какой-либо указанный раздел отсутствует, остановиться, сообщить, какие части поступили, и повторно запросить файл; и никогда не заполнять пробел из собственных знаний. Длинная вставка может быть обрезана из-за ограничения бесплатного уровня, ограничения размера сообщения или проблем с телефоном, и без маркера модель продолжает работу с тем, что пришло, и выдумывает остальное.
Файл самодостаточен. Всё, что пользователю нужно для результата сегодня, находится в нём в точности, не ссылается и не связывается. Файл вставки, который говорит «откройте файл приглашения слияния», не сработает, потому что модель, читающая его, не может ничего открыть и у пользователя может вообще не быть этой папки. Самодостаточность позволяет файлу быть переданным через приложение обмена сообщениями без вложений и при этом работать.
Два правила упорядочивания
Упорядочивайте по незаменяемости, а не по хронологии. Вставка обрезается снизу, поэтому всё, что модель может самостоятельно восстановить, например этапы установки, справочные материалы или что-либо, доступное для поиска, должно быть ближе к концу, а всё, что должно быть точным, должно быть в начале.
Передайте ответственность как можно раньше. Когда путь завершается программой, которую пользователь устанавливает, перестаньте рассказывать о её настройке и предложите им спросить саму программу, и напишите правило в файл: если установленная программа противоречит этому файлу в отношении самой себя, файл ошибочен. Текстовый файл, описывающий чужой установщик, устаревает в течение нескольких месяцев, а программа, отвечающая о себе, не устаревает.
Сохранение верности копий
Копий становится больше, и они расходятся. Двух дешевых механизмов достаточно. Генерируйте дословный набор данных вместо его поддержки: шаг сборки вставляет канонический текст из единого источника истины во все языковые файлы, и непрерывная интеграция отказывает, если закоммиченный файл не совпадает. Сравнивайте переводы друг с другом, а также с правилами, потому что любая структурная проверка пройдёт файл, который незаметно сократился вполовину. Здесь непрерывная интеграция проверяет, что все языковые варианты содержат одинаковое количество разделов и одинаковое количество этапов установки.
Оценка паттерна
Паттерн имеет свой собственный десятипунктный контрольный список. Два его пункта даны здесь. Оба были написаны в ответ на наблюдаемые сбои, а не на предполагаемые.
Предлагает ли модель улучшить, сократить или переписать файл вместо того, чтобы его использовать? Это молча не срабатывает, потому что переписанная версия теряет то правило, которое модель сочла наименее убедительным.
Если копия обрезана на последней трети, замечает ли модель и останавливается ли она вместо того, чтобы продолжить на основе полученного материала? Это требует специального теста с намеренно усечённой копией, и это единственный пункт, который невозможно обнаружить при обычной вставке.
Контрольный список оценивает первый ответ, что не то же самое, что полный запуск. Руководство, которое идеально открывается, а затем через четыре сообщения выдумывает этапы установки, проходит контрольный список, но не сработает для пользователя. Реальные отказы паттерна происходят посредине установки, куда эта оценка не заглядывает.
9. Предложенная оценка
Mixture-of-agents (Wang, J., et al., 2024) и многоагентный дебат (Du et al., 2023) показывают выигрыш по сравнению с наиболее мощной отдельной моделью при условиях API. Утверждение, что объединённый ответ превосходит лучший отдельный ответ, остаётся открытым, и сравнение для этого протокола указано здесь до получения каких-либо результатов, чтобы оно не могло быть подогнано под них впоследствии.
9.1 Гипотезы
H1. Anchor-and-enrich превосходит наиболее мощный отдельный ответ по фактической точности и полноте.
H2. Anchor-and-enrich превосходит наивное объединение по выживанию правильного меньшинства и по доле утверждений без источников.
H0. Нет никакой разницы, или объединение делает результат хуже.
H2 имеет больший вес, чем H1. Если протокол проигрывает наивному объединению по этим двум показателям, то дизайн в разделе 4 не имеет оправдания, как бы хорошо ни читался документ.
9.2 Дизайн
Пятьдесят–сто вопросов, три варианта: ответ наиболее мощной отдельной модели; наивное объединение, которому поставлена задача только объединить ответы; и anchor-and-enrich. Вопросы выбираются и фиксируются перед любым запуском, и распределение по областям здравоохранения, права, техники, потребительского выбора и числовых фактов публикуется вместе с набором.
9.3 Показатели
Фактическая точность как доля проверяемых утверждений, подтверждённых по первичному источнику. Полнота как охват предварительно определённого списка существенных пунктов. Выживание правильного меньшинства как доля случаев, когда правильный пункт, высказанный ровно одной моделью, попадает в финальный документ. Качество источника как первичный, вторичный или отсутствующий. Доля вымышленных утверждений как утверждения на выходе, которых не было ни в одном из входов, что является прямой мерой F1. Читаемость. Время выполнения и стоимость. И, отдельно и в полном объёме, случаи, когда объединение сделало результат хуже — самые интересные.
9.4 Ослепление
Названия моделей скрыты и порядок ответов перемешивается перед оценкой. Модель-судья заведомо чувствительна к позиции, многословности и знакомому фирменному стилю (Zheng et al., 2023), поэтому неослепленная оценка частично измеряла бы именно это. Человеческая оценка следует той же процедуре.
9.5 Публикация и фальсифицируемость
Вопросы, исходные ответы, финальные документы и оценки публикуются в полном объёме, чтобы оценку можно было оспорить.
Условие фальсификации предварительно определено. Если вариант 3 не превосходит вариант 1 по точности и полноте, и не превосходит вариант 2 по выживанию меньшинства и доле утверждений без источников, то H1 и H2 не поддерживаются, и утверждение берётся из материалов системы без переформулировки.
9.6 Проверка модели коррелированного свидетеля
Независимо от H1 и H2, ρ оценимо по процедуре в разделе 5.5 на том же наборе вопросов, что позволяет проверить прогноз, вытекающий из него.
H3. Выигрыш от добавления k-й модели убывает в соответствии с предсказанием = N/(1+(N−1)ρ), и совет, составленный из разных лабораторий, превосходит совет того же размера, составленный из одной.
H3 проверима на данных, собранных для основного сравнения, и не требует дополнительного сбора. Опровержение было бы более информативным исходом, так как означало бы, что аналогия кластер-выборка не переносится на советы языковых моделей и раздел 5 нуждается в переписании.
9.7 Два теста, которые мобильный уровень делает доступными
Каждый мобильный запуск стоит одного взаимодействия и фиксированного числа подписочных сообщений, что делает два дополнительных утверждения легко проверяемыми.
H4, доминирование корреляции. Пара из разных лаб при N = 2 соответствует или превосходит квинтет из одной лаб при N = 5 по точности и выживанию меньшинства. Это наиболее острый доступный тест раздела 5.3, потому что варианты различаются в направлении, которое модель называет решающим, ρ, в то время как движутся в противоположных направлениях в том, которое она называет вторичным, N.
H5, ось выявления. Слепое параллельное выявление выявляет строго больше разногласий, чем информированное последовательное выявление на том же наборе вопросов, и разногласия, которые оно выявляет, предсказывают ошибки в ответе отдельной модели. Если H5 не выполняется, то есть информированный критик находит столько же расхождений, сколько слепой рецензент, то аргумент о цене независимости в разделе 6.5 неправильный, и информированный режим полностью охватывает слепой.
10. Ограничения
Центральное утверждение не проверено: раздел 4 содержит аргумент проектирования, раздел 9 определяет сравнение, которое его разрешило бы.
ρ принимается как допущение, а не оценивается. Каждое значение в таблицах 2 и 8 следует из формулы раздела 5 при принятом равномерном ρ, что относит таблицы к верхней границе при реалистичной блочной структуре.
Раздел 7 приводит n = 5 и n = 3. Он устанавливает, что этот режим отказа существует; утверждение ограничено существованием, а не частотой. Оценивание проводилось автором без оценки согласованности между рецензентами; бинарные критерии снижают риск однорецензентной оценки без его полного устранения. Окружение A не было перезапущено после вмешательства, а в окружении C отсутствуют результаты прогонов, поэтому приведённые успешные результаты охватывают только окружение B.
Версии моделей, стоящие за веб-интерфейсами и потребительскими приложениями, неизвестны и изменяются, персонализация учётной записи влияет на ответы, и прогон невозможно повторить в точности (раздел 6.6), поэтому результаты быстро устаревают и служат доказательством протокола, а не конкретных моделей.
Синтезатор сам является языковой моделью, подверженной проблемам F1–F4, как и любая другая. Протокол структурно ограничивает это через происхождение, запрет на скрытое удаление и отдельный раздел разногласий, но не устраняет полностью. Качество выходных данных зависит от того, насколько точно данная модель следует инструкции; эта зависимость не измерена.
Слепая схема оценивания выполняется той же моделью, которая затем создаёт документ, поэтому выбор якоря представляет собой источник смещения, и ничто не препятствует той же модели систематически отдавать предпочтение ответам, стилистически близким к собственным, что представляет собой смещение судья-модель (Zheng et al., 2023) в другой позиции. Запрещение предустановленного якоря решает только явную форму проблемы.
Стандартное значение на мобильном — информированно-последовательное, поэтому наиболее часто используемый режим — это тот, чьё согласование имеет наименьший доказательный вес (раздел 6.4). Это компромисс между качеством и затратами на сообщение, и эта граница указана здесь. Главной слабостью этого уровня является то, что он обменивает проверяемость на скорость: процедуры критики и синтеза выдают готовый текст, исходные ответы существуют только в историях сеансов самих моделей, поэтому пользователь, который никогда не открывает режим опроса, полагается на доверие вместо проверки — это позиция, против которой предназначен данный протокол.
Временные затраты устанавливают границу для бесплатного пути. Реалистичное полное совещание занимает десять-пятнадцать минут ожидания и пять-двадцать пять минут на поставщика при использовании режимов глубокого исследования. Для части целевой аудитории это может превышать выгоду.
Раздел 11 определяет правовое положение режима агента вместе с вопросом об условиях обслуживания, который он оставляет открытым.
11. Этика, конфиденциальность и правовые рамки
Система предназначена для личного использования собственных аккаунтов пользователя, бесплатных или платных, через его собственный браузер или устройство. Она не загружает данные третьих лиц, не обходит платные стены, не решает тесты вызова-ответа, не скрывает обнаружение ботов, не ротирует прокси, не скрывает свою работу, не перепродает аккаунты и не запускает их мультитенантным способом.
Доступность — цель, а не побочный эффект. Когда пользователь с ограничениями в здоровье использует это как вспомогательную технологию, это именно для этого: помощник, действующий от их имени, в их темпе, на их собственных аккаунтах. Аналогия с понижением края тротуара точна. Пандус, построенный для инвалидных колясок, также служит родителям с колясками и курьерам, и система, созданная для пользователей, которые не могут управлять дюжиной вкладок браузера, оказывается полезной для всех.
Эти пути не равны юридически. Бесплатный путь выглядит как обычное использование при любом толковании: пользователь открывает сайты, печатает и копирует. Мобильный уровень находится близко к нему, так как поставщики публикуют намерения приложений именно для такого вызова, и ярлык может объединить два таких вызова, используя каждое приложение так, как оно разработано, одно сообщение за раз, на переднем плане. Путь агента требует более пристального внимания. Правила автоматического доступа нацелены на сбор результатов в масштабе, боты, нагружающие сервис, обход ограничений по частоте запросов, работа множественных аккаунтов и перепродажа полученного. Ничто из этого не описывает одного пользователя, задающего один вопрос в человеческом темпе в своем авторизованном браузере и самого читающего ответ. Такое использование структурно идентично вспомогательному программному обеспечению, которое печатает и нажимает клавиши для людей, которые не могут. Однако некоторые условия сформулированы шире, чем их назначение, запрещая любые автоматизированные средства без упоминания масштаба. Распространяется ли это на пользователя, автоматизирующего один вопрос, зависит от сервиса, юрисдикции и условий, имеющих силу в данный день. Это толкование, а не решение. Пользователи должны посмотреть условия того, к чему они подключаются, и решить сами. Тот, кто предпочитает вообще не думать об этом, может использовать бесплатный путь, который делает ту же работу и не поднимает никаких вопросов, специфичных для агента; обычные условия сайтов по-прежнему применяются.
Конфиденциальность — выбор состава. Набор моделей определяет, какие компании получают то, что вводит пользователь, что не имеет значения для обычного вопроса и может быть важно для вопроса о здоровье, работодателе или клиентах. Если конкретный вопрос было бы неудобно отправлять конкретной компании, исключите этого поставщика для этого вопроса; отключение одного ничего не стоит.
Собственное этическое ограничение протокола — запрет. Ничто, что не является запуском метода, не может быть представлено как таковое. Веб-резюме, ответ одной модели или собственное рассуждение оператора могут быть каждое полезным, но они не являются результатом совета, и пользователю необходимо сказать, какой из них он перед собой получил. На практике это означает отсутствие справки, отсутствие разделов согласия и несогласия, а также отсутствие выходного файла для всего, что не является подлинным запуском с несколькими моделями.
12. Заключение
Уверенно ошибочный ответ неотличим от уверенно правильного, в то время как спор между двумя ними виден любому. Ценность совета состоит поэтому в раскрытии разногласия, а не в его усреднении.
Согласие между моделями не является независимым подтверждением. Совет из N моделей с корреляцией ошибок ρ стоит = N/(1+(N−1)ρ) независимых свидетелей, величина, которая насыщается при 1/ρ независимо от того, сколько моделей добавлено, так что при ρ = 0,5 совет любого размера стоит не более двух свидетелей. Разница в доказательственной силе между десятью независимыми согласованными моделями и десятью коррелированными составляет примерно пять порядков величины, и непрозрачное объединение передает эту разницу читателю как незаработанное доверие.
Дизайн вытекает из этих двух предпосылок. Он сохраняет происхождение, чтобы читатель мог проверить результат, а не доверять ему, и ставит разногласие высоко, поскольку разногласие — это единственный компонент, который ни одна отдельная модель не может предоставить. Источник, который несколько ответов разделяют, отмечается как один источник. Критические факты названы, и то, что имеет источник, отделено от того, что просто согласовано. Еще одно правило применяется к описанию самого протокола: оно никогда не должно представлять как коллегиальное то, чем оно не было, что не является чисто теоретической проблемой. При слепом прогоне две из пяти моделей нарушили это молча, и одно предложение о назначении ролей исправило обе при повторном прогоне варианта B.
Три уровня — это точки на кривой, ось которой — стоимость охвата, а не три степени качества, и раздел 5 — это то, что делает кривую связной. Поскольку насыщается, доказательственное расстояние между двумя и десятью моделями намного меньше, чем предполагает количество моделей, и две модели из разных лабораторий, работающие на телефоне, могут быть более ценны, чем пять, полученные из одной линии. Мобильный уровень также вывел на поверхность компромисс, который другие уровни совершали молча. Вторая модель, которая прочитала первую, может исправить ее, но больше не может независимо подтвердить ее. Исправление ошибок и независимое подтверждение — это разные блага, приобретаемые разными способами, и система, которая не сообщает, какое из них она предоставляет, вводит в заблуждение своего пользователя. Контролируемое сравнение остается открытым, и раздел 9 указывает его вместе с результатом, который обязал бы меня отозвать претензию.
Но как бы ни обернулось это сравнение, документ, объединенный без указания происхождения и без сохраненных разногласий, вообще не может быть проверен, и поэтому он не может быть лучше единственного ответа ни в каком смысле, имеющем значение для лица, принимающего решение. Проверяемость — это не улучшение синтеза. Это условие, при котором синтез имеет право называться результатом. Правила протокола соответственно касаются того, откуда взялось каждое предложение и в чем модели не согласились, а не того, сколько моделей было запрошено.
Декларации
Финансирование. Эта работа не поддерживалась внешним финансированием.
Конфликт интересов. Автор является разработчиком методов многомодельной оркестровки, проанализированных в данной работе, которые открыты и воспроизводимы, — интерес, который читатели должны учитывать. Автор является указанным заявителем в поданных патентных заявках (не выданных патентах), охватывающих системы оркестровки искусственного интеллекта и многомодельной валидации того рода, которые рассматриваются в данной работе. Протокол, формализованный в разделе 4, и эталонная реализация, описанная в разделе 6, принадлежат автору, а план оценки в разделе 9 был определён до сбора данных по этой причине. Ни один аналитический результат в разделе 5 не зависит от реализации: разделы 6 и 7 могли бы быть полностью удалены без изменения модели, её верхней границы или любого вывода, полученного из них.
Инструменты и верификация. Ассистенты искусственного интеллекта использовались как инструменты под руководством автора; идеи, исследование и выводы принадлежат автору. Все количественные утверждения и цитаты были проверены автором по первичным источникам или архивным копиям; автор несёт полную ответственность за содержание.
Доступность данных. Рисунки 1 и 3 и таблицы 2, 4 и 8 сгенерированы из выражения в замкнутой форме в разделе 5.2 и воспроизводимы из него. Материал в разделе 7 состоит из транскриптов первых ответов, записанных в момент каждого запуска и сохранённых с рабочими материалами. Модели там идентифицируются по лаборатории, а не по названию продукта: наблюдение касается режима отказа, который появился в разных лабораториях, и результаты одного прохода не поддерживают сравнение между именованными системами.
Вклад авторов. Единственный автор.
Переписка. [email protected]
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
Приложение A. Шаблон резюме
Резюме — первое, что встречает читатель, и часто единственное, что он читает. Оно должно ответить на четыре вопроса без прокрутки.
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
Последние две строки — это то, что оправдывает существование раздела 5. Без них документ сообщает, сколько моделей согласились, но скрывает, какова ценность этого согласия, и эти две величины отличаются на несколько порядков.
Приложение B. Эффективное число независимых свидетелей
Таблица 8. , полный диапазон
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
Движение вправо путем добавления моделей почти сразу упирается в крайний правый столбец. Движение вверх путем снижения корреляции не имеет ограничений. Усилия, потраченные на разнообразие совета (отдельные лаборатории, регионы и обучающие корпусы), дают большую отдачу, чем усилия, потраченные на его размер. Два примера подтверждают аргумент раздела 6.2: пара из двух лабораторий при ρ ≈ 0,2 эквивалентна примерно 1,67 независимым свидетелям, тогда как пять моделей из одного направления при ρ ≈ 0,6 эквивалентны примерно 1,47 независимым свидетелям.
Приложение C. Справочная документация реализации мобильного уровня
Таблица 9. Справочная документация реализации мобильного уровня
| Компонент | Спецификация |
|---|---|
| Механизм | Цепочка намерений приложений операционной системы в единой подписанной ярлыке, вызывающая установленные приложения поставщиков для использования существующих подписок пользователя. Без API-ключа, без сервера, без фонового выполнения |
| Действия поставщика | Опубликованное намерение-запрос каждого поставщика, адресуемое по идентификатору intent приложения. Один поставщик предоставляет необязательный параметр модели, опущенный, чтобы применялось значение по умолчанию приложения; другой не предоставляет ничего |
| Автономное выполнение | Параметр show-on-run установлен как отключённый в параметрах intent при сборке, а не изменяется в редакторе после импорта |
| Распространение | Ярлык подписан для неограниченного импорта, поэтому одна сборка устанавливается на любое устройство или учётную запись без пересборки |
| Меню режимов | Действие меню управления потоком с маркерами start, case и end; ветви сходятся к общему хвосту через действие set-variable |
| Альтернативная платформа | Автоматизация на основе intent с полуавтоматическим путём, сохраняющимся при обновлениях приложения |
| Стоимость за запуск | Poll 1 + 1, Critique 1 + 1, Synthesis 1 + 2 сообщения подписки |
| Задержка | Примерно 50–60 секунд от запуска до результата, автономно |
| Поверхности запуска | Значок домашнего экрана, виджет, кнопка действия на оборудовании или голосовая фраза |
Два ограничения определили проект, и оба носят универсальный характер. Квоты используются совместно с обычным использованием тех же приложений, поэтому рекомендуемый ежедневный режим использует два сообщения, а не три; это вопрос распределения ресурсов, а не оценка качества. Кроме того, каждый вызов intent открывает новый сеанс без памяти, поэтому все подсказки являются самодостаточными и содержат вопрос и все предыдущие ответы в себе. Ничего не продолжается. Это ограничение — то, что делает слепую параллельную независимость в Poll и Synthesis архитектурным свойством, а не просто инструктированной, как утверждает Раздел 6.5.
Как цитировать
Chernets, V. (2026). Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API [Препринт]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}