Театр верификации: измеренные режимы отказа панелей верификации ИИ
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Vadym Chernets, Независимый исследователь · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
Принято как постер на семинаре NeurIPS 2026 «Who Verifies the Agents? Toward Reliable Agent Development» (неархивный). Архивная копия: 10.5281/zenodo.23197641. PDF: verification-theater.pdf. Рисунки и таблицы ниже преобразованы из исходного кода LaTeX; PDF является авторитетным.
Аннотация
Верификация несколькими агентами становится механизмом доверия по умолчанию: ответ считается надёжным, потому что независимые модели пришли к согласию. Используя предварительно зарегистрированный слепой сбор данных при temperature-zero, в котором шестнадцать моделей (девять поставщиков переднего края, семь локальных открытых весов) ответили на одни и те же 1,500 вопросов о фактах (плюс раздел из 750 вопросов с множественным выбором и раздел исследовательского диалога), мы измеряем, когда панельная верификация перестаёт работать, продолжая выглядеть рабочей — состояние, которое мы называем театром верификации. Мы сообщаем о четырёх режимах отказа. Во-первых, инверсия сложности: подъём сертификации независимого согласия — 2.7–4.6 на трёх более лёгких квинтилях вопросов — падает до 0.82 на втором по сложности квинтиле и до нуля на самом сложном, где дублированные ответы были правильными в 0 из 342 случаев (13 ожидаемых при независимости). Переслоение с исключением панели (сложность ранжирована 13 моделями вне панели) устраняет объединённую инверсию (78/354 правильно, подъём 2.36) тогда как нуль сохраняется для кросс-блоковой панели (0/116); мы сообщаем оба кодирования совместно на протяжении: на вопросы, которые развёрнутая популяция считает самыми сложными, согласие функционирует как сертификация ошибок. Во-вторых, ограниченные пространства ответов: при множественном выборе (локальный уровень) панели единогласно сертифицировали неправильный ответ на 4.0–7.9% вопросов в сравнении с 1.5–4.6% на открытых ответах того же уровня и 0.3–4.9% на открытых ответах переднего края. В-третьих, метки, используемые как суррогаты для независимости, эмпирически не работают: геополитический блок не предсказывает корреляцию ошибок (средняя внутриблоковая 0.285 против кросс-блоковой 0.274, разница ), и модель рассуждений, дистиллированная из того же основания, что и её партнёр по панели, была среди наименее коррелированных измеренных пар (; 14-я из 15 пар локального США/КНР-блока, 20-я из всех 21 локальной пары). В-четвёртых, конформизм: верификатор, который слепо не согласился с ответом, одобрил тот же ответ в 38.5% случаев, когда ему показали его как ответ коллеги; контроль с обратной подсказкой показывает, что эти переходы отслеживают наличие уверенного предложения, а не его истинность (38.9% в сторону неправильного против 34.7% в сторону правильного; точный тест МакНемара ). Мы утверждаем, что эти режимы имеют общий экономический корень, и выводим дисциплину измерения, которая отделяет верификацию от её театра.
Введение: проблема театра
Панели моделей ИИ, проверяющие друг друга, развёртываются как доверительная инфраструктура, и согласие между ними всё чаще рассматривается как доказательство. Исследования безопасности давно имеют название для механизмов, которые создают эстетику защиты без её содержания (Schneier, 2003); мы спрашиваем, опираясь на измерения, а не метафоры, когда проверка панелью заслуживает это название. Ключевой результат — инверсия: ценность сертификации согласия сконцентрирована на простых вопросах и исчезает — или переворачивается — именно там, где верификация важна всего больше. Мы рассматриваем это не как одну аномалию, а как один из четырёх различных режимов, в которых панель верификаторов сохраняет видимость проверки, теряя её содержание, и связываем эти четыре с общей экономической причиной и общим решением.
Конкретно, данная работа вносит: (C1) измерение сертификационного прироста, стратифицированное по сложности, показывающее, что ценность сертификации независимого согласия сконцентрирована на простых вопросах и при использовании меры сложности по населению инвертируется на самом сложном квинтиле (0 из 342 воспроизведённых правильных ответов; при панельно-независимой сложности объединённая инверсия исчезает, а нуль сохраняется для кросс-блоковой панели, 0/116) — обе кодировки сообщаются вместе на всём протяжении; (C2) доказательства того, что ограниченные (множественный выбор) пространства ответов подталкивают ошибку единогласной сертификации к 4,0–7,9%, значительно выше диапазона открытой формы 0,3–4,9%; (C3) два предварительно зарегистрированных нулевых результата, показывающих, что метки, регулярно используемые как прокси независимости — геополитический блок и происхождение модели — не предсказывают корреляцию ошибок, поэтому независимость должна измеряться попарно как -матрица, а не предполагаться из бренда или происхождения; и (C4) измерение конформности с контролем обратного запроса, демонстрирующее, что верификаторы в режиме диалога отслеживают наличие уверенного предложения, а не его истинность. Протокол слепого сбора и конструкт доверия полностью изложены в сопровождающей статье и здесь резюмируются только в той мере, в какой это требуется для измерений; всё, что сообщается как результат в этой статье (C1–C4), измеряется здесь и не переизлагается из неё. Из этого мы выводим (C5) дисциплину измерения — опубликованные для каждого класса задач -матрицы, утверждения о сертификации, стратифицированные по сложности, слепое первичное получение и эскалация в жёстком режиме — которая операционально разделяет верификацию от её театра.
Предшествующие работы и постановка задачи
Отказоустойчивый консенсус (BFT) предполагает независимые сбои—предположение, которое мы проверяем и находим необоснованным. Литература о парадоксе консенсуса уже называет ошибку, стабилизированную согласием, в однородных роях (Shehata and Li, 2026). zkML проверяет, что вычисление выполнялось, а не что его ответ верен—дополняющий, а не конкурирующий подход. Дилемма Проверяющего предоставляет анализ стимулов; (Raji et al., 2022) освещают задачу выбора аудитора; (Du et al., 2024), (Farquhar et al., 2024) и (Ding, 2026) предоставляют литературу по сигналам согласия, которую эта статья нагружает тестами. Сама конструкция доверия была введена в сопутствующей статье (Chernets, 2026); эта статья отображает, где механизм проверки конструкции дает сбой, продолжая казаться работающим. Работы по вычислениям во время тестирования приходят к дополняющему выводу с конструктивной стороны: ансамбли проверяющих с разнообразными аспектами превосходят любого отдельного проверяющего (Lifshitz et al., 2025), панель небольших судей, составленная из непересекающихся семейств, превосходит одного большого судью с затратами в доле стоимости (Verga et al., 2024), и систематическая переоценка многоагентного дебата определяет гетерогенность модели как единственное надежное улучшение (Zhang et al., 2025); направление дебатов показывает, как структурированный состязательный аргумент помогает более слабым судьям достичь более верных ответов (Khan et al., 2024). Рецензируемые доказательства уже документируют существенную корреляцию ошибок между провайдерами—наибольшую именно среди наиболее точных моделей, даже в разных архитектурах и у разных провайдеров (Kim et al., 2025)—что самостоятельно мотивирует измерение зависимости, а не ее вывод из меток. Та литература отбирает панели по разнообразию; эта статья измеряет, какова стоимость выбираемого свойства—и каковы молчаливые издержки его отсутствия—при проверке.
Данные и измерение
Одна предварительно зарегистрированная слепая выборка (протокол заморожен публично перед подтверждающим сбором данных; публичная регистрация по адресу https://osf.io/4y9dv): шестнадцать моделей предварительно зарегистрированная случайная подвыборка из 1500 элементов из 4326 элементов SimpleQA (фиксированное начальное значение, выбранная перед любым сбором; CSV подвыборки с её SHA-256, прикреплённой к замороженной регистрации) при нулевой температуре с указанной уверенностью 0–100 (13 446 чистых граничных ответов; 8802 ответа локального уровня); ветка TruthfulQA MC1 из 750 элементов на локальном уровне, полученная из замороженной копии файла официального репозитория (790 элементов, идентичная по байтам каноническому CSV) конструктором, предварительно зарегистрированным, требующим как минимум двух различных неправильных вариантов на элемент (фиксированное начальное значение перемешивания; 695 элементов полностью ответили все семь моделей); исследовательская ветка активного диалога против слепого. SimpleQA собирается в состязательном режиме против граничной модели, с одним неоспоримым ответом на вопрос (Wei et al., 2024): слой hard поэтому исследует подлинные границы параметрического знания, и оценка сводится к эквивалентности золотому стандарту. TruthfulQA обеспечивает ветку ограниченного пространства ответов (Lin et al., 2022). Панели представляют собой аналитические комбинации одной слепой выборки; весь повторный анализ детерминирован (кодирование на основе эквивалентности строк с отказами и нулевым перекрытием, считаемыми несогласованностью; неопределённые пары, представляемые в скобках). Сложность операционализируется наблюдательно как средняя точность 16 моделей на вопрос, разделённая на ранговые квинтили из 300 вопросов. Одна и та же сырая выборка лежит в основе сопутствующей статьи (Chernets, 2026), которая сообщает объединённые коэффициенты сертификации и краткие резюме анализов, подробно описанных здесь; стратифицированная по сложности лестница подъёма, набор тестов устойчивости, -матрица и разложения соответствия появляются только в этой статье, и каждое оставшееся перекрытие отмечено перекрёстными ссылками в тексте.
Оценка в открытой форме двухэтапная: детерминированный проход на основе эквивалентности строк (26,8% граничных оценок) плюс обнаружение отказов (6,6%), при этом оставшиеся 66,5% оценивались LLM-грейдером; проверка человеком согласилась с грейдером на 98% случайной выборки (). Поскольку две трети оценок производятся моделью, все основные результаты сопровождаются анализом чувствительности к ошибкам грейдера путём переделения выборки (10% вердиктов, оценённых моделью, инвертировались, 200 переделений с фиксированными начальными значениями; Раздел 4 и Приложение A).
Режим отказа I: инверсия сложности
Три предварительно определённые фронтальные панели представляют собой аналитические трёхмодельные комбинации единого слепого набора: US-bloc (Anthropic, OpenAI, Google), CN-bloc (DeepSeek, Alibaba, Moonshot) и cross-bloc (Anthropic, DeepSeek, Mistral); ответ считается воспроизведённым, когда по крайней мере один из двух партнёров основного по панели независимо создал эквивалентный ответ согласно замороженному детерминированному кодированию раздела 3, и поднятие равно . Объединённые по трём панелям, вероятность того, что воспроизведённый ответ правилен, возрастает от 0.0% (0/342, CI 0.0–1.1) в самом сложном квинтиле через 12.8%, 57.5% и 81.0% до 95.1% в самом лёгком; соответствующее поднятие над невоспроизведёнными ответами составляет 0.00 / 0.82 / 2.68 / 3.09 / 4.56. На самых сложных 20% вопросов каждое наблюдаемое согласие подтвердило неправильный ответ, и на следующем квинтиле точечная оценка помещает согласие ниже паритета с несогласием (0.82, CI [0.51, 1.21]); нулевой результат самого сложного квинтиля воспроизводится в каждой панели отдельно (US 0.00–4.25, CN 0.00–9.76, cross-bloc 0.00–4.04); субпаритет Q2 сохраняется в панелях CN и cross-bloc, в то время как поднятие Q2 панели US составляет 1.20. Большая часть объединённого поднятия сертификации переносится лёгкими вопросами, поэтому нестратифицированное утверждение о поднятии переоценивает то, что верификация доставляет там, где это необходимо. Нулевое значение Q1 измеряется по отношению к живой базовой ставке, а не к нижнему пределу: невоспроизведённые ответы Q1 верны в 3.9% случаев (89/2286), поэтому независимость предсказывает правильных воспроизведённых ответов—наблюдаемый 0 (верхний предел 1.1%) находится значительно ниже базовой ставки самого слоя. Эталон независимости здесь консервативен, а не либерален: нулевая гипотеза, сохраняющая полностью измеренную структуру межмодельной корреляции—одна общая перестановка меток корректности по вопросам слоя, структура репликации заморожена (2,000 перестановок)—ожидает 11.7–12.4 правильных воспроизведённых ответа и никогда не дала наблюдаемый 0 (; минимум 3); введение измеренного попарного в аналитическую двумерную нулевую гипотезу повышает ожидание далее, потому что положительно коррелированные ошибки подразумевают положительно коррелированные правильные ответы. То, что заполняет слой, само по себе информативно: 342 ячейки охватывают 106 вопросов—обычные узкие фактоиды (медиана 17 слов), не двусмысленные формулировки, и модели редко воздерживаются от ответа на них (0.5 из 9 ответов на вопрос). Их неправильные ответы группируются: на 70.8% этих вопросов по крайней мере три из девяти фронтальных моделей дали один и тот же неправильный ответ, и на 67.4% вопросов, воспроизведённых несколькими панелями, независимо составленные панели подтвердили идентичное неправильное согласие—типично ответ о известном соседе, вытесняющий правильный, но менее выдающийся объект. Ручное экспертное судейство всех 106 золотых меток обнаружило 2 спорные и 0 явно неправильные; признавая один явно защитимый ответ панели и два частично защитимых, количество самого сложного квинтиля переходит с 0/342 на максимум 13/342 (3.8%), поэтому вывод о близости к нулю сохраняется при смягчении от буквального нуля (одна отмеченная метка: избрание в Royal Academy 2010 года оценено по названию почести, которую академия не присуждает). Это утверждение напрямую проверяемо: оно предсказывает Q1 поднятие при любой репликации, стратифицированной по собственной точности используемой популяции (при стратификации, независимой от панели, предсказание является нулевым результатом кросс-блока, а не объединённым поднятием). Нуль также не является артефактом оценки: независимый второй оценщик из другого поставщика, отличного от всех панелей и оригинального оценщика (нулевая температура, идентичный замороженный подсказ эквивалентности к золотому), переоценил все 342 Q1 воспроизведённых решения и согласился со всеми 342 из 342 (исправления на правильный 0/342, верхний предел 1.1%); синтетическое переключение 10% помеченных моделью меток также оставляет долю подтвержденной ошибки на уровне или выше 86.5% в каждой повторной выборке (приложение).
Переслоение с исключением панели.
Поскольку члены панели влияют на индекс сложности совокупности, самый сложный квинтиль отчасти зависит от собственной неудачи панели. При переслоении только по 13 непанельным моделям повторно воспроизведённые ответы на самом сложном квинтиле верны в 78/354 случаях (22.0%, объединённый подъём 2.36, выше 33/354 ожидаемого при независимости), и нулевой результат сохраняется только для кросс-блоковой панели (0/116; 0/88 на слое, где все 13 непанельных моделей терпят неудачу). Сохраняющийся нулевой результат сам по себе характеризуется: базовая доля слоя составляет 31/778 = 3.98% (Wilson 2.8–5.6%), что даёт ожидание при независимости 4.6 верных из 116; нулевая гипотеза, сохраняющая корреляцию (2,000 перестановок), дает , 95% диапазон и —значительно ниже нулевой гипотезы, хотя и достижимо в её рамках. Таким образом, указанная выше инверсия является утверждением о том, где верификация даёт сбой по сравнению с тем, что развёрнутая совокупность считает сложным, а не по сравнению со сложностью, независимой от панели. В качестве второй проверки чувствительности мы переизвели рейтинг при полностью независимой от меток кодировке репликации (детерминированное сравнение строк слепых ответов только, без обращения к метке правильности): результат Q1 по существу неизменен (2/344 повторно воспроизведённых ответа верны, 0.6% [0.2–2.1]; подъём 0.15) и подъёмы ниже 1 на двух самых сложных квинтилях сохраняются, в то время как подъём верхнего квинтиля ослабевает (с 4.56 на 2.33), потому что чистое сопоставление строк упускает поверхностные варианты одного и того же правильного ответа; результаты по вопросам с множественным выбором не затронуты, так как согласие там кодируется буквой ответа и по построению независимо от меток.
Три проверки надёжности подтверждают эту инверсию. (i) Бутстреп на уровне вопросов (2,000 инициализированных повторных выборок в пределах квинтиля) даёт 95% доверительные интервалы для пяти подъёмов [0.00, 0.00], [0.51, 1.21], [2.32, 3.09], [2.84, 3.35] и [4.16, 5.03]: интервалы сложного режима полностью исключают интервалы лёгкого режима. (ii) Чувствительность к ошибкам оценивания: инвертирование 10% вердиктов, выставленных моделью (200 инициализированных повторных выборок; 97.1% из 342 повторно воспроизведённых ответов из самого сложного квинтиля оцениваются моделью и поэтому поддаются инвертированию) оставляет долю подтвёрждённых ошибок самого сложного квинтиля на уровне 86.5% или выше в каждой повторной выборке, сохраняет подъём Q1 ниже 1 в 92% повторных выборок (медиана 0.82) и никогда не приводит подъёмы Q1–Q2 близко к подъёмам Q3–Q5, которые остаются выше 2 во всех 200 повторных выборках. (iii) Местный уровень из семи моделей воспроизводит контраст сложное–лёгкое с независимыми моделями и панелями немонотонно (Q3 ): подъёмы 0.00 / 0.94 / 0.00 / 1.89 / 4.37 по тем же квинтилям, с 0 из 166 повторно воспроизведённых ответов верных на самом сложном квинтиле; этот уровень оценивается большой языковой моделью на 94.8% и охватывается тем же ресэмплингом для чувствительности к оценивающему, что и в (ii).
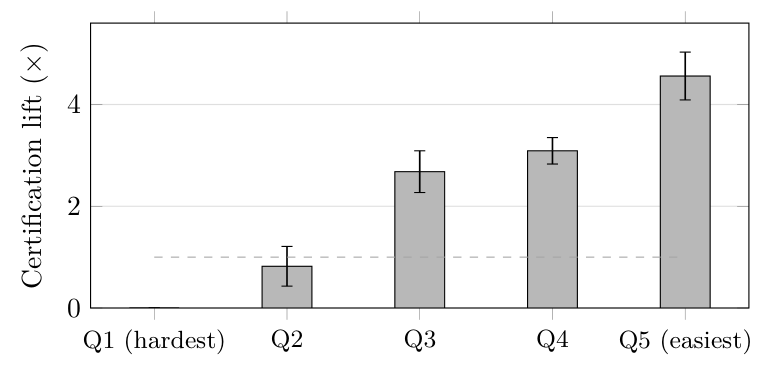 Подъём сертификации по квинтилю сложности, объединённый по трём граничным панелям, с 95-процентными доверительными интервалами на уровне вопроса (2,000 инициализированных повторных выборок; Приложение A.1). Пунктирная линия обозначает подъём = 1, паритет с невоспроизведёнными ответами: два самых сложных квинтиля находятся на уровне или ниже него по точечной оценке (Q1 0.00×—измеренный нуль, а не пропущенные данные; Q2 0.82×, его доверительный интервал пересекает паритет), три самых лёгких хорошо выше него.
Режим отказа II: ограниченные пространства ответов
В задачах с множественным выбором четыре предварительно определённые панели локального уровня единогласно выбрали неправильный вариант ответа в 4,0–7,9% из 695 полностью отвеченных вопросов (по панелям: 4,0, 5,9, 6,6, 7,9), в сравнении с детерминированным диапазоном 0,3–4,9% для уверенных единогласных неправильных ответов в открытой форме на передовом уровне. Пересчёт того же метрика сертификации на собственные открытые ответы локального уровня (8 802 оценённых ответа SimpleQA) устраняет смешивание уровня и формата: те же локальные панели удостоверяют единогласные уверенные ошибки только в 1,5–4,6% открытых элементов под строгим детерминированным кодированием (до 9,8% включая неопределённый диапазон), что совместимо с передовым диапазоном открытой формы — паттерн, соответствующий ограниченному пространству ответов, а не уровню модели, как определяющему фактору сертификации ошибок; однако остаётся одно смешивание: группа с множественным выбором и группы с открытой формой — это разные наборы вопросов (TruthfulQA MC1 против SimpleQA), поэтому здесь формат и набор вопросов не разделены, и причинная форма утверждения решается только заменой формата на одних и тех же вопросах, которую мы не провели.1 Бутстреп по панелям устанавливает доверительные интервалы для разности, где достаточна мощность: сертифицированная ошибка консенсуса (МВ минус открытая форма) составляет п.п. [2,9, 6,8] (пилотное), п.п. [3,9, 8,1] (US-local), и п.п. [2,6, 6,3] (cross-bloc), каждое исключая ноль; панель CN-local, чья ячейка открытой формы основана на наборе из 87 элементов сноски, не разрешает это. Меню преобразует рассеянные ошибки в общие: когда пространство ответов невелико, похожие модели приземляются на один и тот же отвлекающий вариант и единогласие панели становится усилителем ошибок. Эти показатели невозможно объяснить независимыми ошибками: когда каждый член независимо ошибается со своей предельной вероятностью и ошибки распределяются по неправильным вариантам (), ожидаемый показатель единогласного выбора одного неправильного варианта составляет 0,49–0,92% по четырём панелям — наблюдаемые 4,0–7,9% представляют избыток в 4,9–13,5 раз выше базовой вероятности независимости. Следствие проектирования, сформулированное как проверяемое правило: любой интерфейс, который предоставляет агентам фиксированный набор вариантов, должен ожидать значительно более высокую сертифицированную ошибку консенсуса, чем запрос ответов в открытой форме на том же содержании.
Требование указанной уверенности от всех трёх панелистов едва сказывается на эффекте: диапазон сертифицированной ошибки консенсуса сдвигается с 4,0–7,9% на 4,0–7,2% (по панелям 4,0, 5,2, 6,0, 7,2), т.е. почти все единогласные неправильные ответы также являются уверенными. Отказ также не ограничивается определённой тематической нишей: в десяти категориях TruthfulQA с минимум 20 элементами объединённая сертифицированная ошибка консенсуса составляет 1,0% (Теории заговора) до 8,6% (Экономика), с Правом, Здоровьем и Социологией между ними (Приложение A).
Сценарий отказа III: метки независимости не предсказывают независимость
Для 36 пар ведущих поставщиков (1 448 общих вопросов) попарная корреляция ошибок охватывает 0,123–0,395, и этот диапазон не организован используемыми людьми метками: пары с наибольшей и наименьшей корреляцией обе находятся внутри блока (googlexai 0,395 vs. googleopenai 0,123), средние значения внутри блока и между блоками различаются на , и пара происхождения с одинаковым базовым основанием занимает 14-е место из 15 пар, образованных шестью локальными моделями блока США/КНР на 695 полностью отвеченных вопросах с множественным выбором (; седьмая локальная модель относится к блоку ЕС и находится вне предварительно зарегистрированного дизайна блока/происхождения — её включение даёт 21 пару, из которых пара происхождения занимает 20-е место). Оба предварительно зарегистрированных нулевых результата (блок, происхождение) сохраняются при переанализе; остаётся предсказательным сама измеренная корреляция. Практическое правило: независимость — это величина для каждой пары и для каждого класса задач, подлежащая измерению (матрица ), а не выводимая из бренда, флага или генеалогического дерева — создание панели по меткам — это гипотеза, а не проверка. Попарное измеряет эмпирическую зависимость ошибок, а не полную статистическую независимость: низкое не исключает зависимость более высокого порядка в панелях из трёх или более элементов — ещё одна причина рассматривать независимость как измеренную, обусловленную задачей величину, а не предполагаемое свойство.
Точный тест перестановок на всех 630 назначений меток блоков девяти поставщикам не обнаруживает никаких признаков эффекта блока: наблюдаемая разница между внутри- и межблоком превышена или совпадает в 132 из 630 переназначений (односторонний ; кластеризованный бутстрэп 95% доверительный интервал для разницы ). Тест ограничивает утверждение — малые эффекты блока не исключены — и практический вывод остаётся верным: метка не несёт сигнала, пригодного для использования вместо измерения для каждой пары. Поскольку ограничена сверху, когда базовые уровни ошибок пары различаются, мы повторили анализ на основе нормализованного по маргиналам соотношения : оба предварительно зарегистрированных нулевых результата сохраняются (разница блока , перестановка ; пара происхождения остаётся 14-й из 15), разброс сохраняется (0,278–0,821 для пар ведущих поставщиков), и экстремумы перемещаются на две между-блоковые пары (anthropicmoonshot 0,821, mistralopenai 0,278) — при любой метрике ни одна метка не организует разброс. Расширение матрицы на все шестнадцать моделей: на 81 вопрос, отвеченный каждой моделью, попарное охватывает до (120 пар; средние значения блока: ведущий–ведущий 0,320, локальный–локальный 0,350, ведущий–локальный 0,210) — разброс порядка величины, который ни одна классификация меток в наших данных не предсказывает (Рисунок 2). При 81 общем элементе отдельные оценки ячеек имеют широкие интервалы; результат — сам разброс, а не какая-либо отдельная ячейка.
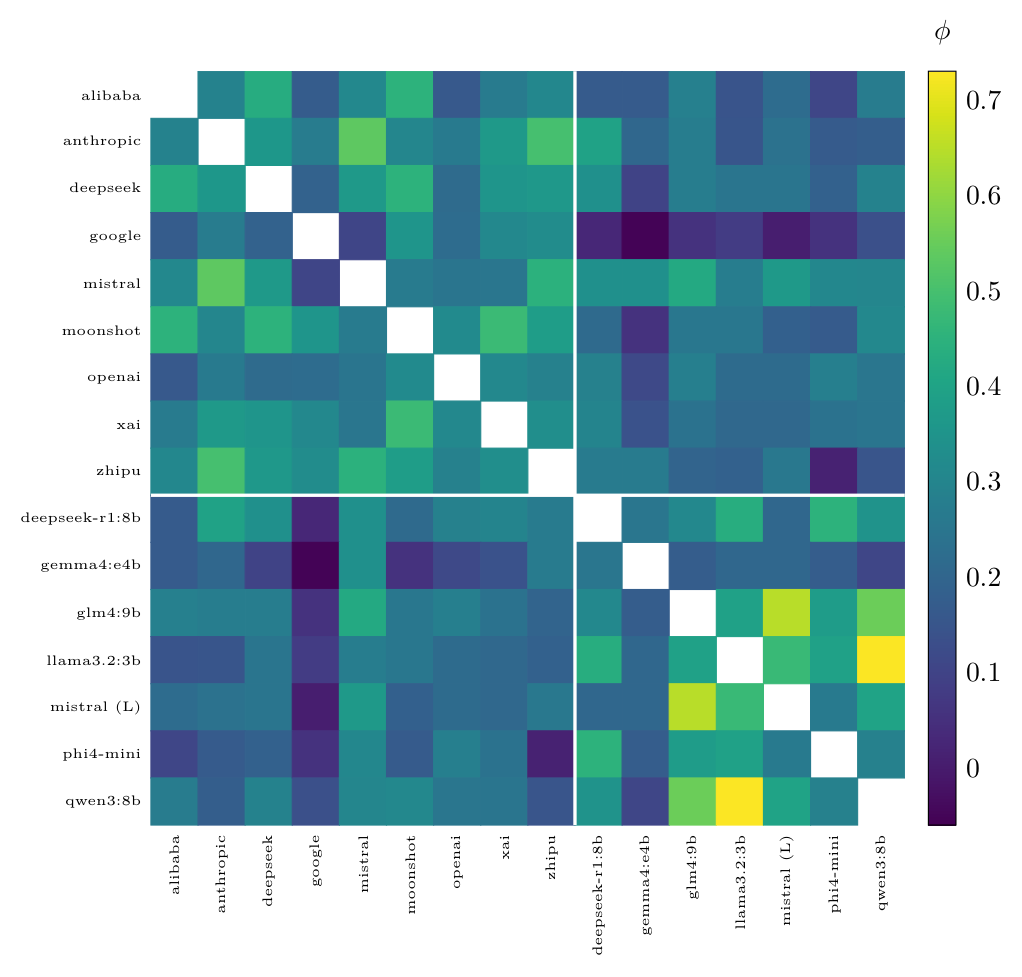 Попарная корреляция ошибок (ϕ) среди всех шестнадцати моделей по 81 вопросу, на который ответила каждая модель (девять ведущих поставщиков, затем семь локальных моделей с открытыми весами; разделение на ведущие/локальные обозначено белыми линиями). Каждая внедиагональная ячейка представляет одну из 120 уникальных пар; диагональ (само-корреляция = 1.0) намеренно оставлена пустой, чтобы не сжимать цветовую шкалу. ϕ колеблется от −0.05 до 0.73 (среднее 0.27): разброс на порядок величины в корреляции ошибок любых двух верификаторов, которую не предсказывают никакие блоки или метки происхождения в наших данных. Значения выводятся детерминированно с помощью emit_phi_matrix.py (переиспользуя analysis_week1.py сек. W5); ни одно не вводилось вручную.
Режим отказа IV: верификация, которая капитулирует (исследовательская)
Когда проверяющему, который вслепую не согласился, показывали такой же ответ, как предложение коллеги, он капитулировал в 38,5% случаев (168/436); когда он вслепую выдал правильный ответ, он отказался от него в пользу неправильного в 30,9% случаев (46/149), при этом показатели отказа по поставщикам варьировались от 13,1% до 51,6% (капитуляция по поставщикам на полном подмножестве вслепую несогласных варьируется от 20,4–58,1%).
Могли ли эти смены позиции отражать рациональное обновление убеждений, а не конформизм? Контроль с обратным подсказом опровергает это. На локальной панели из шести моделей мы повторили парную процедуру с перевёрнутым направлением предъявления: проверяющему, который вслепую не согласился, для одного и того же набора вопросов показывали либо уверенно неправильный ответ (прямая ветвь), либо эталонный ответ (обратная ветвь). Обе ветви идентичны по подсказу — один общий шаблон («Предложенный ответ: …»), показываемый ответ отличается только содержанием, без указания значения уверенности или источника — таким образом, контраст изолирует истинностное значение показываемого ответа. Если бы проверяющие обновляли убеждения на основе доказательств, то воздействие правильного ответа должно было бы сдвинуть их больше; однако обе ветви дали примерно одинаковый показатель смены позиции — 38,9% в сторону неправильного ответа, 34,7% в сторону правильного — и внутрипарное сравнение идёт вразрез с историей обновления убеждений: из 174 несогласованных пар проверяющий отказался от своей слепой позиции в пользу неправильного ответа в 104 случаях и в пользу правильного в 70 (точный тест МакНемара ). На уровне модели обе ветви были неразличимы (склонность к смене позиции 89,9% против 89,9% для наиболее уступчивого проверяющего, 1,5% против 1,5% для наименее уступчивого): то, что вызывает согласие, — это наличие уверенного предложения, а не его правильность — панельное верификационное проявление натренированного на предпочтения угодничества (Sharma et al., 2024). Асимметрия также не зависит от наиболее уступчивого проверяющего: исключив его, остаётся 835 парных элементов с несогласованными подсчётами 94 против 60 (точное ). Два дополнительных разложения подтверждают эту интерпретацию (Приложение A): каждая зафиксированная смена позиции в обеих ветвях сопровождалась заявленной уверенностью после предъявления (0 смен позиции ниже этого порога, ), а в прямой ветви проверяющие, которые вслепую дали правильный ответ, отказались от правильного ответа в 40,8% случаев (20/49), отражая граничный результат. Контроль проводился на локальном уровне (см. Ограничения). Прозаическое резюме этого контроля также появляется в дополняющей работе (Chernets, 2026); разложение по моделям, разделение по шлюзу уверенности и анализ отказа от правильного слепого ответа приводятся только здесь.
Это обосновывает утверждение о дизайне: когда целью является измерение независимого несогласия, элицитация должна быть сначала вслепую — панель, которая совещается перед тем, как взять на себя позиции, не измеряет своё несогласие, она его стирает.
Обсуждение: экономика театра (предположение, не свидетельство)
Этот раздел является обсуждением, а не свидетельством: он не содержит новых измерений, и ничто в нём не должно рассматриваться как равное четырём измеренным режимам выше. Тем не менее четыре режима могут сохраняться потому, что ни одна сторона не получает оплату за их замечание: потребители не могут оценить качество проверки, платформы получают оплату за доверие, а не за сомнение, и для каждого верификатора самая дешёвая стратегия — согласиться. Добавьте проблему отбора аудитора (независимость — это свойство того, кто выбирает проверяющих) и прецедент ссылочной фермы (любой сигнал согласия, несущий коммерческий вес, стимулирует фарминг), и театр является равновесием, а не случайностью — предположение, которое мотивируют, но не проверяют измерения. Учёт стимулов дополняет, а не исключает инженерную инерцию и отсутствие стандартов измерения; он выделяется, потому что это фальсифицируемый компонент. Этот раздел выдвигает фальсифицируемые рыночные предсказания, а не нормативные утверждения — например, непроверенные панели должны со временем сходиться к минимально разнообразным составам, потому что коррелированные панели дешевле и в большей степени согласны.
От театра к измерению
Решение — это дисциплина, а не компонент: (1) опубликовать измеренную панелью -матрицу по классам задач, а не её список брендов (одного слепого набора данных на класс задач достаточно — ϕ-матрица из 16 моделей в этой статье получена из единого прохода на 1 500 элементов); (2) разделить каждое заявление об аттестации по сложности и отдельно сообщить прирост в сложном режиме (сложность операционализирована по классам задач на основе набора калибровки, а не по элементам при выводе); (3) всегда начинать со слепого сбора — схема commit-reveal проверки панели, которая переупорядочивает сбор данных, а не добавляет вычисления, поскольку слепые ответы параллелизуемы; (4) рассматривать самый сложный режим как триггер эскалации — в вопросах, где измеренный панелью прирост , согласие должно направляться к человеку или к воздержанию, никогда к аттестации. Каждое правило сформулировано так, чтобы развёрнутая система могла быть проверена против него.
В качестве отработанного примера применим рецепт к собственной передовой панели этой статьи. Правило (1): её независимость сообщается как измеренная -матрица раздела 6 (диапазон 0.123–0.395), а не список поставщиков — что скрыло бы, что наиболее коррелированная пара находится внутри блока (googlexai). Правило (2): её прирост аттестации сообщается расслоённым (таблица 1), с приростом в сложном режиме ( на Q1, на Q2) указаны отдельно, а не объединены в один сводный итоговый показатель. Правило (3): каждый ответ здесь был получен слепо перед созданием какой-либо панели, что именно делает направление соответствия (раздел 7) измеримым, а не смешанным. Правило (4): поскольку измеренный панелью прирост на двух наиболее сложных квинтилях, проверенное развёртывание той же панели маршрутизировало бы эти вопросы к воздержанию или человеческому рассмотрению, никогда к консенсусной аттестации. Дисциплина, таким образом, не гипотетична: это протокол, в соответствии с которым были получены собственные результаты этой статьи.
Ограничения
Одна семья бенчмарков на уровень (SimpleQA open-form frontier; TruthfulQA MC local), поэтому границы режима зависят от бенчмарка; каждый поставщик frontier представлен одной моделью budget/mid-tier, поэтому утверждения о способностях поставщика не делаются. Стратификация сложности основана на наблюдении (постфактум на базе предварительно зарегистрированной коллекции) и присвоение квинтилей использует данные из оцениваемых моделей. Ветвь проверки конформности исследовательская и скромная по ; её управление с обратным промптом использовало локальные модели, поэтому перенос на frontier-панели осуществляется по аналогии, а не по прямому измерению. Примерно две трети оценок открытой формы выдаёт грейдер LLM (выборочная проверка человеком 98% согласия; перепроверка всех 342 реплицированных вердиктов из самой сложной квинтили по семействам согласилась 342/342; анализ чувствительности переаттестацией в приложении). Оба бенчмарка общедоступны, поэтому утечку тренировочного набора исключить нельзя; на SimpleQA её направление благоприятствует запомненным-правильным ответам, что сужает слой сложных примеров и делает результаты в сложном режиме консервативными; на TruthfulQA открытый корпус содержит сами ложные представления, поэтому направление там неоднозначно — альтернативное прочтение уже ограничено оговоркой о формате и содержании раздела 5. Никакого причинного утверждения о том, почему согласие нарушается на сложных вопросах не делается—кандидаты механизма (общие приоры, общие слепые пятна, общие данные обучения) названы, но не разделены.
Заключение
Согласие является доказательством только после того, как измерены независимость и компетентность, и это измерение дешёво—весь повторный анализ выполняется здесь за секунды на стандартном оборудовании из открытых необработанных файлов. До тех пор пока панели не будут поставляться со своими -матрицами и стратифицированными подъёмами, «проверено консенсусом» следует читать так, как инженеры безопасности научились читать проверку сумки.
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
Приложение о воспроизводимости
Весь повторный анализ детерминирован при наличии необработанных оценённых файлов JSONL и двух скриптов с фиксированным начальным значением (базовый скрипт, воспроизводящий каждое основное число, и дополнение первой недели, создающее таблицы начальной выборки, чувствительности и декомпозиции ниже); полный пересчёт занимает менее 15 секунд на стандартном оборудовании без GPU, сети или вызовов модели. Замороженная предварительная регистрация и пакет репликации (публичная регистрация OSF): https://osf.io/4y9dv.
Доверительные интервалы начальной выборки для лестницы поднятия
Повторная выборка на уровне вопроса внутри квинтиля, 2000 выборок с начальным значением, объединённые по трём пограничным панелям.
| Квинтиль | Wilson 95% | Boot 95% | Поднятие | Поднятие boot 95% | |
|---|---|---|---|---|---|
| Q1 (самый сложный) | 0/342 = 0.0% | [0.0, 1.1] | [0.0, 0.0] | 0.00 | [0.00, 0.00] |
| Q2 | 46/359 = 12.8% | [9.7, 16.7] | [8.2, 18.2] | 0.82 | [0.51, 1.21] |
| Q3 | 272/473 = 57.5% | [53.0, 61.9] | [50.7, 64.6] | 2.68 | [2.32, 3.09] |
| Q4 | 732/904 = 81.0% | [78.3, 83.4] | [76.6, 85.1] | 3.09 | [2.84, 3.35] |
| Q5 (самый лёгкий) | 1700/1788 = 95.1% | [94.0, 96.0] | [93.4, 96.6] | 4.56 | [4.16, 5.03] |
Поднятие сертификации по квинтилям сложности с доверительными интервалами Wilson и bootstrap 95% (проценты для , коэффициенты для поднятия). При исключении панели из учёта сложности (ранжировано по 13 моделям без панели) объединённая ячейка Q1 составляет 78/354 (22.0%, поднятие 2.36), ноль сохраняется для кросс-блоковой панели (0/116); Раздел 4. Базовые показатели по квинтилям: 3.9 / 15.6 / 21.5 / 26.2 / 20.8% ( = 2286 / 2308 / 2209 / 1778 / 912).
Чувствительность к ошибкам оценивающего
Переворот 10% из 8948 пограничных вердиктов, оценённых моделью (200 повторных выборок с начальным значением; кодирование согласия и назначение квинтиля заморожены при исходном детерминированном кодировании протокола, так что движутся только метки правильности): ячейка самого сложного квинтиля «сертифицировано правильно» возрастает с 0/342 до медианы 33/342 (9.6%; диапазон 95% 23–46), поэтому доля сертифицированной ошибки согласия Q1 остаётся на уровне или выше 86.5% при каждой повторной выборке; поднятие Q1 остаётся ниже 1 в 92% повторных выборок (медиана 0.82, диапазон 95% 0.56–1.08), тогда как поднятия Q3–Q5 никогда не падают ниже 2 (медианы 2.17 / 2.51 / 3.42). Из 342 повторённых ответов Q1 332 (97.1%) оценены моделью и поэтому переворачиваются в этом упражнении. Помимо синтетических переворотов, аудит между семействами переоценил все 342 повторённых вердикта Q1 независимым вторым оценивающим (семейство поставщика вне каждой панели и вне семейства исходного оценивающего; температура 0; замороженный идентичный на уровне байтов запрос): согласие 342/342 (перевороты на правильные 0/342, верхняя граница Wilson 1.1%), равномерно по оценённым моделью (332) и кодированным строками/отказом (10) ячейкам. Поскольку 342 ячейки охватывают 106 уникальных вопросов, консервативное кластерное прочтение рассматривает вопросы как единицу: 0/106 даёт верхнюю границу Wilson 3.4%; нулевая перестановка на уровне вопроса раздела 4 уже работает на уровне кластера.
Контроль обратного запроса: разложение по моделям
Шесть локальных моделей, 2 399 валидных парных наблюдений; переключение = верификатор отказывается от своего слепого ответа в пользу показанного.
| Верификатор | Прямой (к неверному) | Обратный (к верному) | Разница |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | pp |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | pp |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | pp |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | pp |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | pp |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | pp |
| Объединённые | 477/1226 = 38.9% | 407/1173 = 34.7% | pp |
Коэффициенты переключений по верификаторам и вариантам. Ни одна модель не переключается чаще в пользу верного ответа, чем в пользу ошибочного. Парный пересчёт: 1 028 элементов, присутствующих в обоих вариантах (296 переключились в обоих, 558 ни в одном); несогласованные пары 104 (только неверный) против 70 (только верный), точный биномиальный McNemar (асимптотический ). Все 884 зарегистрированных переключения имеют указанную пост-воздействующую уверенность ; коэффициент переключений ниже этого порога составляет 0/547.
Ошибка сертифицированного консенсуса MC по категориям TruthfulQA
Объединено по четырём предварительно определённым локальным панелям (события на элемент-панель; категории с не менее чем 20 элементами): Экономика 8,6%, Художественная литература 6,2%, Паранормальное 6,0%, Право 5,9%, Суеверия 5,7%, Стереотипы 5,4%, Социология 4,9%, Здоровье 4,9%, Неправильные представления 2,6%, Заговоры 1,0%. Коэффициенты для каждой панели со всеми тремя членами на уровне уверенности : 4,0% (CN-local), 5,2% (cross-bloc), 6,0% (pilot), 7,2% (US-local).
Верхняя граница 4,6% основывается на одной локальной панели, которая разделяет только 87 элементов с 98 оцениваемыми ответами модели рассуждения; исключив её, строгий локальный диапазон открытой формы составляет 1,5–1,8%.↩︎
Как цитировать
Chernets, V. (2026). Verification Theater: Measured Failure Modes of AI Verifier Panels [Paper presentation]. NeurIPS 2026 Workshop: Who Verifies the Agents?. Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}