Запитайте кілька ШІ одночасно та побачте, де вони не згодні
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Коли ви запитуєте ШІ одне питання, ви отримуєте одну впевнену відповідь і немає простого способу дізнатися, чи вона правильна. Запитання другої та третьої ШІ допомагає, але лише якщо ви можете побачити, де їхні відповіді розходяться, і лише якщо ви знаєте, наскільки варта їхня згода насправді. After Chat — це невеликий набір безплатних скриптів Python з відкритим кодом, який ставить одне питання кільком ШІ одночасно і робить обидва: показує, хто що сказав, і визначає, наскільки варта їхня згода. Він запускається на вашому комп'ютері через ШІ-інструменти, на які ви вже увійшли, без API ключів і без додаткової підписки, і самим скриптам потрібно лише Python.
Один AI недостатньо, і чотири AI не чотири
Моделі AI від різних компаній навчаються по-різному, тому вони не завжди роблять одні й ті ж помилки. Тому люди копіюють одне питання у ChatGPT, Claude, Gemini та Grok і порівнюють відповіді вручну. Однак їхні помилки перекриваються більше, ніж здається. Дослідження 2025 року понад 350 мовних моделей показало, що коли обидві моделі неправильні, вони часто дають одну й ту ж неправильну відповідь: на одному наборі даних рейтингу 60% часу. Отже, коли чотири AI дають однакову відповідь, у вас менше чотирьох незалежних підтверджень. Справжня цінність запитання у кількох полягає в розбіжності: пункт, який підняв лише один з них, або одне й те ж твердження з різними числами в ньому.
Реальний приклад
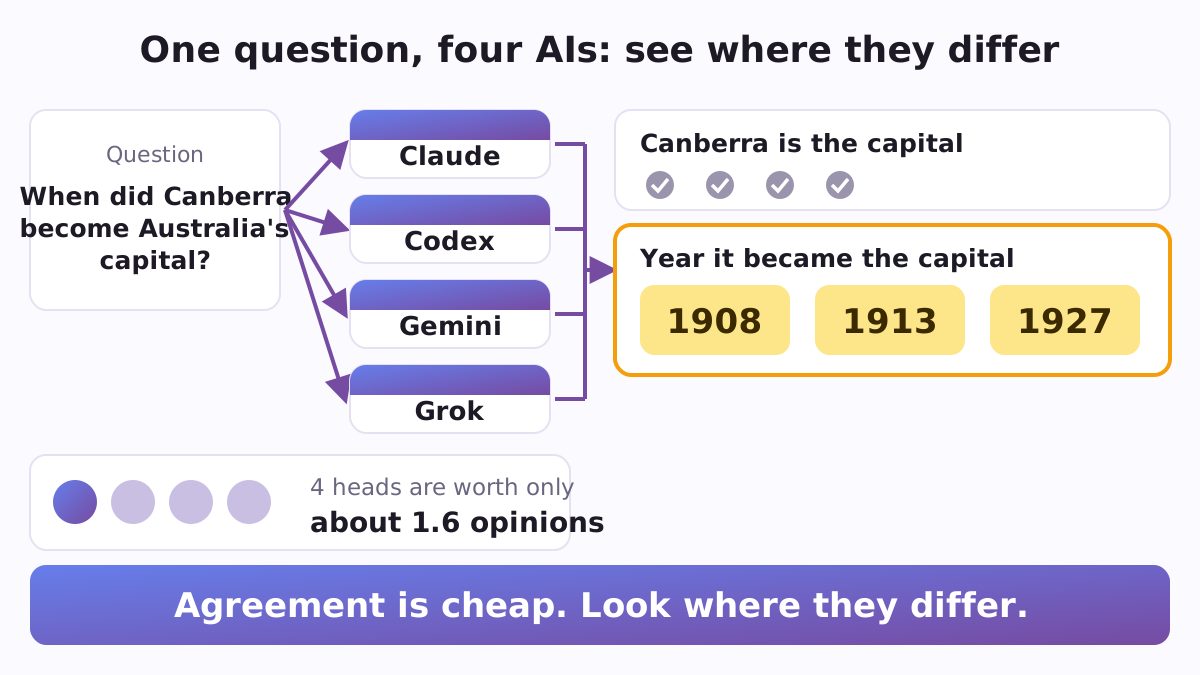
На 21 вересня 2026 року автор поставив одне питання чотирьом інструментам AI командного рядка: «В одному реченні: яка столиця Австралії і в якому році вона стала столицею?» Всі чотири відповіли протягом 25 секунд, і всі чотири назвали Канберру. Щодо року вони розділилися трьома способами: 1908, 1913 і 1927. Кожен рік можна обґрунтувати: сайт було обрано у 1908 році, місто було названо у 1913 році, і Парламент переїхав туди у 1927 році. Якби їх запитали окремо, Codex дав би 1927, а Grok 1913, кожен як простий факт. Один біля одного відповіді показали відразу, що питання має три чесні відповіді, і вказали на точне місце, яке потрібно перевірити.
Що всередині
- Запитати їх усіх одночасно (
fanout.py). Спочатку вона надсилає кожному AI-інструменту зі свого списку швидке тестове запитання та пропускає будь-який інструмент, який не встановлений або не відповідає. Потім вона ставить ваше запитання всім активним одночасно, у межах одного часового ліміту на вашу вибір, і передає кожну відповідь у свій власний файл. Якщо інструмент ще пише, коли час закінчується, написане ним до цього моменту зберігається та позначається як часткове, а не видаляється. Кожен AI починає у власній порожній папці, а не в папці, з якої ви запустили команду, тому він працює лише з вашого запитання. Довге запитання, наприклад сторінку тексту, яку ви хочете, щоб усі перевірили, вміщують у файл з--question-file. - Подивитися, хто що сказав (
provenance.py). Вона розбиває кожну відповідь на короткі твердження, групує твердження, які сформульовані однаково, і виводить одну таблицю: кожне твердження та який AI його створив. Під таблицею наведено два найважливіших списки: твердження, зроблені лише одним AI (щось, що пропустили інші, або помилка того одного), та твердження, де AI дають різні числа, відсотки або дати. Вона читає будь-яку папку текстових файлів, тому ви також можете вставити відповіді з веб-сайтів чату у файли, по одному на AI, і порівняти їх. - Оцінити цінність узгодження (
neff.py). Дайте їй кілька запитань з відомими відповідями, позначеними як правильні або неправильні для кожного AI, і вона вимірює, як часто ваші AI помиляються разом. З цього вона розраховує, скільки незалежних думок вони насправді варті. У вбудованому прикладі чотири AI, чиї помилки перекриваються, варті приблизно 1,6 незалежної думки, і жодна кількість таких AI ніколи не буде варта більше ніж 2,1. - Друга думка всередині Claude Code (
second-opinion/SKILL.md). Готова до використання навичка: скопіюйте папку в~/.claude/skills/, і Claude Code може запитати AI від іншої компанії те саме запитання, показати цю відповідь саме як вона надійшла, і додати коротку таблицю того, де вони згідні, де розходяться та що згадує лише один з них. Вона ніколи не змішує їх в один впевнений текст і трактує відповідь іншого AI як матеріал для порівняння, а ніколи не як інструкції для виконання. - Безпечні налаштування для AI-агентів (
safety/). Готовий приклад налаштувань дозволів Claude Code (settings.json), який запускає кожний сеанс у режимі плану, заборонює команди якrm -rf,sudo,curlтаgit push, утримує файли.envта папкуsecretsнедоступними для читання, і запитує передrm,mvта веб-вибірками. Налаштування для Codex дозволяють йому писати лише всередині своєї робочої папки, з відключеною мережею, і змушують його запитати перед виходом за ці межі. 14-пунктний контрольний список охоплює звички навколо них: робити в копії, спочатку запитати план, зберегти скасування, знати, як зупинити довгу роботу. - Інструменти для дослідників (
crossings.py,crossings.schema.json,jsonl_log.py). Формат записів зі строгою перевіркою для досліджень того, як люди переходять від спілкування з AI до дозволу агентам AI виконувати реальну роботу. Встановлення додатка не рахується як його використання, завершений крок потребує чогось, що агент насправді створив, і коли хтось припиняє, запис зберігає його власні слова. Крихітний логер записує кожне рішення, наприклад відмовлений план або взяту другу думку, як один рядок JSON з позначкою часу.
Чому це побудовано таким чином
Багато інструментів "LLM council" завершуються однією об'єднаною відповіддю. Популярний інструмент llm-council від Andrej Karpathy, наприклад, відправляє ваше запитання моделям через OpenRouter, сервіс API, для якого ви купуєте кредити, і дозволяє моделі "chairman" написати остаточну відповідь. After Chat проходить через інструменти командного рядка, які ви вже використовуєте з власними обліковими записами, і навмисне зупиняється перед об'єднанням: ви отримуєте таблицю того, хто що сказав, а судження залишається за вами. Кожен скрипт використовує лише стандартну бібліотеку Python і поміщається в один короткий файл (найдовший налічує менше 200 рядків), тому ви можете точно прочитати, що він робить, і змінити його.
Як почати
Скрипти запускаються будь-де, де працює Python 3; у Windows запустіть fanout.py всередині WSL. Пряме порівняння використовує два або більше AI-інструментів командного рядка, залогінених у ваші облікові записи. Вбудований список включає Claude Code (claude), OpenAI Codex (codex), Google Antigravity CLI (agy, яка прийшла на зміну Gemini CLI для персональних облікових записів Google 18 червня 2026) та xAI Grok Build (grok). Команда кожного інструменту займає один рядок у малому файлі JSON, переданому з --tools, тому додавання іншого інструменту або дотримання прапорця, що змінився в новій версії, займає хвилину. Немає інструменту командного рядка? Вставте відповіді з будь-якого веб-сайту чату AI у файли .txt, по одному на AI, та запустіть provenance.py на цій папці: ім'я кожного файлу стає стовпцем таблиці.
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
28 тестів запускаються за допомогою python3 -m unittest tests/test_patterns.py. Код, його тести та параметри безпеки розташовані на github.com/vadimchernets/after-chat.
Звідки це походить
After Chat — це супровідний код статті After Chat: The Three Transitions Between Non-Programmers and Agentic AI Vadym Chernets (вересень 2026, SSRN 7520019, DOI 10.2139/ssrn.7520019). Стаття досліджує, чому так мало людей перейшли від спілкування зі штучним інтелектом до того, щоб дозволити агентам AI працювати на них, та як вимірити цей перехід. Код розповсюджується під ліцензією MIT і архівований на Zenodo (DOI 10.5281/zenodo.22944451). З цих самих закономірностей виникли два готових плагіни Claude Code: Sidecall звертається до AI-інструментів командного рядка на вашому комп'ютері, а Roundcall звертається до сайтів AI-чату через ваш власний браузер.
Переглянути after-chat на GitHub
Vadym Chernets також розробляє Poly A1, додаток, у якому штучні інтелекти різних компаній перевіряють роботу один одного.