O que 7 Downloads Significam? Cegueira Métrica e o Início Frio da Atenção Acadêmica Após o Término das Classificações do SSRN
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Vadym Chernets, PhD, arquiteto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- Versão de registro: SSRN 7296358 · DOI 10.2139/ssrn.7296358
- Cópia arquivada, citável e baixável: 10.5281/zenodo.22166896 — concept DOI, sempre resolve para a versão mais recente
- Texto completo em Markdown e PDF: GitHub
- HTML legível: https://polyhelper.ai/research/download-metrics/
O mesmo texto está em quatro superfícies para que possa ser alcançado quando uma delas não puder servi-lo. SSRN detém a versão de registro; cite-a.
O que 7 Downloads Significam?
Cegueira Métrica e o Início Frio da Atenção Acadêmica Após o Término das Classificações do SSRN
Tipo de manuscrito: Síntese crítica, framework metodológico e agenda empírica pronta para pré-registro
Versão: setembro de 2026
Autor: Vadym Chernets, PhD1
Afiliação: Arquiteto de sistemas de IA
Resumo
Em 15 de julho de 2026, a Social Science Research Network (SSRN) descontinuou suas Classificações públicas, as tabelas de classificação de artigos, autores e instituições que há muito forneciam o único marco comparativo amplamente acessível da plataforma, enquanto as contagens de downloads e estatísticas de citação permaneceram em artigos e perfis de autores individuais (SSRN Blog, 15 de julho de 2026). O resultado foi um evento de medição assimétrico: os autores mantiveram os números e perderam a norma. Os contadores do SSRN não se tornaram sem sentido; tornaram-se ilegíveis. Cada contagem de downloads se tornou um número sem escala.
Este artigo argumenta que a pergunta "O que 7 downloads significam?" é cientificamente mal-formulada até que a classe de referência de um artigo seja especificada. Uma contagem cumulativa bruta de uso não pode ser interpretada sem idade do artigo, campo, coorte de postagem, exposição de distribuição e visibilidade prévia do autor. O problema é mais agudo para novos artigos e autores de baixa visibilidade, cuja atenção inicial é moldada menos pelo interesse acadêmico do que pela arquitetura da plataforma, distribuição de alerta de email, indexação de pesquisa, prestígio do autor e dinâmica de cauda pesada da atenção. Nomeamos esta condição o início frio da atenção acadêmica. O requisito não é novo: normalizar contagens por campo, idade e tipo de documento é prática estabelecida há muito tempo em bibliometria de citações, e a pergunta paralela para dados de uso já estava sendo colocada uma década e meia atrás (Kurtz & Bollen, 2010). Indicadores bibliométricos desse tipo assumem um banco de dados em que campo, idade e tipo são conhecidos e o indicador é calculado em nome do leitor, enquanto uma plataforma de pré-impressão entrega seus autores um inteiro puro sem classe de referência, sem ferramental e (desde julho de 2026) nenhum marco comparativo. O que falta não é o método mas sua instanciação: SSRN não fornece nenhum instrumento que o aplique para um autor.
As evidências disponíveis mostram por que as médias simples enganam. No único estudo publicado recente com grande amostra externa de uma rede SSRN (2,361 artigos de trabalho de marketing), os downloads médios eram 221.3 enquanto a mediana era 87, e a média até mesmo excedeu o 75º percentil (206) (Jo & Li, 2026). As distribuições de download são quasi-lognormal com caudas superiores extremas, e dentro de uma única rede disciplinar os downloads médios diferem por aproximadamente um fator de oito entre subáreas (Whalen, 2018), portanto uma média em toda a plataforma não descreve nenhum artigo em particular; avaliar um novo artigo contra isso é calibrar contra uma ficção de agregação. Na evidência de conversão disponível, uma contagem como 7 downloads de 40 visualizações de resumo não indica falha. É um resultado de triagem com um intervalo amplo em torno dele, e deve ser lido através de alcance, conversão, idade e campo.
A partir dessa evidência, o artigo constrói um marco interpretativo para métricas SSRN pós-rankings, que separa exposição, visualização de resumo, download de texto completo e uso subsequente, e adiciona um diagnóstico de alcance por conversão que distingue invisibilidade de rejeição. No lugar de um único número de vaidade, propõe o Cold-Start Scholarly Attention Benchmark (CSAB), uma alternativa multidimensional. Um protocolo de dossiê o acompanha, sob o qual cada métrica relatada carrega sua fonte, janela de tempo, classe de referência e limitações. O artigo então apresenta uma agenda pronta para pré-registro para reconstruir a escala ausente: um painel prospectivo de novos artigos SSRN observados do dia 1 ao dia 180, quasi-experimentos usando distribuição de alerta de e-mail curada e a própria aposentadoria dos Rankings, um benchmark de percentil construído pela comunidade, e uma auditoria da visibilidade de pré-impressões em mecanismos de resposta de IA. A base de evidências combina os estudos citados com a seção transversal arquivística não representativa do Apêndice E; o artigo especifica como o benchmark ausente pode ser reconstruído, e por que nenhuma contagem de download deve circular sem seu contexto em uma plataforma que não fornece nada disso.
Palavras-chave: contagens de download; métricas de uso; normalização de campo; avaliação de pesquisa; pré-impressões; cientometria; promoção e permanência; bolsa jurídica; altmétricas; efeito de Mateus; vantagem cumulativa; economia de atenção; visualizações de resumo; periódicos predatórios; otimização de mecanismo generativo.
Classificação JEL: A14; D83; I23; O33; L86
Destaques
As contagens de download bruto SSRN não têm interpretação estável sem idade do artigo, campo, coorte de publicação, exposição de distribuição e visibilidade anterior do autor.
O pôr do sol dos Rankings de 15 de julho de 2026 removeu o único marco comparativo público da plataforma enquanto cada contador sobreviveu: os autores mantiveram os números e perderam a norma.
Na única distribuição de grande amostra publicada recentemente, os downloads são fortemente assimétricos à direita, média 221.3 vs mediana 87: o artigo "médio" é atípico por construção.
Separar alcance (visualizações de resumo) de conversão (downloads por visualização) distingue invisibilidade de rejeição: diagnósticos diferentes que justificam ações diferentes.
Os âncoras de conversão de visualizações para downloads publicadas se agrupam em uma faixa de aproximadamente 11–19%, em que 7 downloads de 40 visualizações de resumo é consistente com o intervalo como resultado de triagem: não, com base na evidência disponível, um sinal de falha.
O Cold-Start Scholarly Attention Benchmark (CSAB) relata alcance normalizado, desempenho de download, conversão, momento e validação subsequente em vez de um único número de vaidade.
Uma agenda pré-especificada e pronta para pré-registro (um painel prospectivo, dois quasi-experimentos inusitadamente oportunos criados pelas próprias reformas da plataforma, um benchmark de percentil comunitário e uma auditoria de mecanismo de resposta de IA necessária antes que a otimização de mecanismo generativo possa ser tratada como baseada em evidências) especifica como reconstruir a escala ausente.
Escopo e Disciplina de Evidência
Este artigo é uma síntese crítica, combinada com um marco metodológico e uma agenda empírica pronta para pré-registro, e os únicos dados novos que relata são a seção transversal arquivística não representativa do Apêndice E. Três classes de evidência são mantidas separadas ao longo de todo o texto, e cada número no artigo viaja com sua classe:
1. Estimativas verificadas: números publicados verificados contra sua fonte primária e citados com seu marco de amostragem e vintage, ou verificados com ressalvas declaradas onde a verificação é parcial.
2. Âncoras históricas: amostras anteriores e recursos de plataforma aposentados, retidos porque revelam estrutura distribucional, não porque permaneçam normas calibradas para 2026.
3. Saídas conceituais e propostas: predições pré-especificadas, modelos de benchmark e designs de estudo, explicitamente rotulados como tal e não contendo nenhuma descoberta sintética.
O problema de interpretabilidade, o argumento de classe de referência e a decomposição de alcance–conversão são afirmações analíticas defendidas na evidência acima. A infraestrutura que o artigo propõe é oferecida como um design para a comunidade construir e avaliar, não como uma prescrição resolvida: um registro de percentil comunitário (Seção 8.8), uma calculadora voltada para o autor e a arquitetura de orquestração da Seção 8.10. Nenhuma afirmação diagnóstica no artigo depende de ser adotada.
Em um campo que acabou de perder seu benchmark público mais utilizado, o bem público escasso é um protocolo replicável que qualquer autor, em qualquer lugar, pode executar, juntamente com uma síntese que afirma a procedência e a idade dos números existentes.
O caso de 40 visualizações de resumo e 7 downloads recorre através dessa síntese metodológica porque ilustra as questões catalogadas na Tabela 1; as conclusões repousam na evidência citada, não em nenhum painel único.
Três regras governam a síntese em si. As unidades são normalizadas para dois denominadores comuns, downloads ao longo da vida por artigo e downloads de doze meses por artigo. A ponte é realizada apenas quando a própria fonte relata a razão necessária, e a unidade nativa é mantida onde a conversão exigiria suposições que as fontes não suportam. Cada afirmação factual carrega um nível de verificação (verificado contra a fonte primária, verificado com ressalvas declaradas, ou verificação pendente) registrado nas colunas de confiança da fonte das tabelas. Quando as fontes entram em conflito, mais proeminentemente sobre a data de pôr do sol efetiva, o conflito é resolvido em favor da fonte oficial posterior e sinalizado. Cada estimativa mantém seu nível, vintage e ressalva de envelhecimento onde quer que seja reutilizada.
Uma única regra governa a inclusão de fontes: uma referência é retida quando contribui com um mecanismo distinto, resultado, fato de plataforma, aviso sobre medição ou precedente de design; a quantidade de citações não é um objetivo. Publicar e ser lido são realizações diferentes; este artigo trata do segundo, e sobre o colapso dos instrumentos para medi-lo. Uma tabela aparentemente plausível não é evidência, e em um artigo sobre números sem contexto, essa regra vincula o próprio artigo primeiro.
1. Introdução
1.1 Quarenta visualizações, sete downloads
Considere um pesquisador (em início de carreira, talvez não filiado, ou simplesmente novo na plataforma) que envia um artigo de trabalho cuidadosamente preparado para o SSRN e, algumas semanas depois, em agosto de 2026, abre o painel de estatísticas do artigo. O painel relata "40 Visualizações de Resumo" e "7 Downloads." Nesse ponto, sem conhecimento prático das estatísticas de atenção acadêmica, o autor não consegue dizer se esses números significam rejeição catastrófica pelos pares, uma linha de base estatística padrão para um texto especializado, ou o início de uma trajetória incomumente forte. O autor pergunta aos colegas: "Isso é terrível?" Ninguém consegue dizer. Nem o painel, nem a literatura acadêmica, nem a própria plataforma fornece uma resposta, e a contagem não possui uma escala de referência. A condição é cegueira métrica, a incapacidade, ao se estar diante dos próprios contadores, de distinguir fracasso de desempenho normal e de sucesso. O termo é introduzido aqui como uma construção teórica, não como uma quantidade medida. O Estudo 4 (Seção 8.6) fornece o indicador concreto (a proporção de autores que relatam nunca ter situado sua própria contagem contra qualquer parâmetro, junto com a distribuição de primeiras leituras que uma contagem baixa provoca) de modo que "cegueira métrica" nomeie algo que uma pesquisa pré-registrada pode estimar.
Uma cena complementar, relatada por autores em fóruns da comunidade e oferecida aqui como uma anedota ilustrativa, é mais marcante. Um pesquisador envia um primeiro pré-print e observa o painel ficar em zero visualizações e zero downloads, enquanto, dentro de alguns dias, a caixa de entrada entrega cinco emails de periódicos solicitando o manuscrito, todos eles predatórios. A única resposta que o recém-chegado recebe vem de periódicos predatórios. A Seção 7 desenvolve essa assimetria como um conjunto de hipóteses explícitas, e o Estudo 3 (Seção 8.6) especifica como operacionalizá-la. A cena é o equivalente vivido do vácuo informacional: a economia de atenção legítima fornece a este autor uma contagem sem um ponto de referência para compará-la, enquanto a parasita fornece adulação e nenhum leitor.
Até o verão de 2026, havia uma resposta aproximada. As Classificações públicas do SSRN (Principais Artigos, Principais Autores e tabelas de classificação institucional) permitiam que um autor situasse uma contagem dentro de uma distribuição visível. Em 15 de julho de 2026, essas classificações foram descontinuadas [149]. A descontinuação seguiu um anúncio de 12 de junho de 2026 que enquadrou a decisão com a declaração de que "a pesquisa deve falar por si mesma" [148] e um refoco estratégico anterior, anunciado em 13 de abril de 2026, dos recursos da plataforma em sua missão principal de compartilhamento de pesquisa [146]. A remoção foi assimétrica: as contagens de downloads por artigo e as estatísticas de citação "continuarão sendo registradas e exibidas em seus artigos individuais e perfil de autor" [149], enquanto a distribuição que havia dado a essas contagens uma escala desapareceu. A situação do pesquisador no painel foi assim generalizada para toda a base de usuários da plataforma: mais de 1,9 milhão de autores e 1,5 milhão de artigos [49].
Este artigo trata dessa situação, e sua tese tem duas partes. O encerramento das Classificações removeu contexto, não dados. Os contadores por artigo sobreviveram ao encerramento e ainda são exibidos; a escala comparativa através da qual esses contadores podiam ser lidos desapareceu, e é por isso que as métricas são ilegíveis e não insignificantes.
A segunda é que a pergunta "o que 7 downloads significam?" é cientificamente mal colocada até que o denominador correto e o grupo de comparação sejam especificados. Fornecer esse denominador e os instrumentos para usá-lo é a tarefa deste artigo.
1.2 Um número sem escala
O problema interpretativo parece mais simples do que é. Dez downloads após sete dias e dez downloads após noventa dias são contagens idênticas cujos significados quase certamente diferem, e diferem novamente se um artigo carrega o nome de um professor internacionalmente reconhecido em uma instituição altamente visível e o outro é a estreia de um autor iniciante. Métricas de uso acadêmico são, no entanto, apresentadas exatamente nesta forma livre de contexto, então todo número inevitavelmente se torna um teste de Rorschach: as mesmas "40 visualizações" provocam pânico em um autor e indiferença em outro, porque não há um ponto de referência compartilhado.
O valor esperado de uma contagem bruta de downloads muda com tudo que o contador não mostra: a idade do artigo, sua área, sua coorte de postagem e ambiente de calendário, sua exposição real de distribuição e a visibilidade anterior de seus autores. Cada uma dessas dependências é documentada empiricamente. Os downloads de vida útil média diferem aproximadamente por um fator de oito entre os eJournals de uma única rede disciplinar, de cerca de 438 em direito corporativo e de valores mobiliários para cerca de 53 em direito agrícola [168]. A atividade de acesso varia com o próprio calendário, caindo cerca de 11% nos fins de semana e cerca de 50% nos meses de verão em dados de acesso a periódicos [178]. Posição e exposição importam independentemente do conteúdo: artigos aparecendo na posição mais visível das listas de anúncios do arXiv obtiveram subsequentemente leitura e citações substancialmente maiores, com ganhos de citação mediana de cerca de 83% em astrofísica [72]. Ideias originadas em instituições prestigiosas se difundem mais rápida e amplamente do que ideias comparáveis de instituições menos prestigiosas [111], um padrão consistente com evidências duradouras sobre status e atenção [104][105][140][103]. No SSRN especificamente, um coautor incremental do top-50 está associado a um prêmio mensurável nas taxas de download [83]. O próprio mecanismo de distribuição da plataforma também molda o contador: autores selecionam até sete classificações, a inclusão em alertas de email baseados em tópicos curados não é garantida, e tópicos de alto volume podem enfrentar atrasos de até 45 dias [53][57]. O contador inicial de um artigo pode refletir nada mais do que se sua distribuição relevante já ocorreu.
As regras de contagem da plataforma adicionam uma segunda camada que os autores raramente veem. O SSRN filtra seus contadores, descartando atividade aparente de robô e downloads repetidos pela mesma pessoa [144][66][69]; sem tais filtros, as contagens seriam inflacionadas "por um fator de cinco ou mais" [18]. Visualizações e downloads estão vinculados por uma conversão aproximadamente estável, e Black e Caron relataram, em 2006, que "em geral, três visualizações de resumo no site SSRN resultam em um download de artigo real" [18]. Amostras posteriores colocam a conversão entre aproximadamente 11% e 19% de visualizações de resumo [139][172], com uma amostra de marketing recente com média de cerca de 24 downloads por 100 visualizações [83]. Um autor que conhece esta anatomia já pode verificar as 40 visualizações e 7 downloads do título (a Seção 5.2 realiza o cálculo, que cai dentro da faixa relatada como um resultado de triagem de intervalo amplo), mas nada na plataforma o comunica.
Nenhuma escala externa preenche a lacuna, o que torna isto uma falha de medição e não um incômodo. Para o índice h [79], existe um gênero inteiro de guias "o que é um bom X" [118][128]. Para downloads SSRN, a auditoria da Seção 2.5 não encontrou análogo em agosto de 2026 em nenhuma fonte pública. A literatura bibliométrica relata distribuições [85][139][168][83], mas nenhuma as traduz em normas voltadas para autores. Estudiosos individuais improvisaram benchmarks caseiros de seus próprios portfólios [42], e guias de bibliotecas explicam o que são os contadores sem dizer o que significam [161][50]. O número que todo autor procura não pode ser encontrado.
1.3 As apostas: carreira, ansiedade e o incentivo para inflar
O hiato é importante porque os números têm consequências. A documentação própria da SSRN descreve suas métricas como aquelas "que autores usam para fins de promoção e posse e que instituições usam em suas atividades de contratação e classificação" [52]. O uso é concreto e documentado: um destacado estudioso do direito relatou estar "classificado 13º entre 3.000 autores jurídicos em número total de downloads de todos os tempos, que a faculdade de direito considerou em várias decisões de promoção e relacionadas" [12]; guias de submissão de revisão jurídica aconselham mencionar "downloads da SSRN (se muitos)" e aparições em listas dos Dez Melhores em cartas de apresentação [95]; e instituições emitiram comunicados à imprensa sobre suas posições na SSRN até semanas antes do encerramento [101]. No nível agregado, os downloads da SSRN correlacionam-se com 0,84 com os rankings baseados em citações de cem faculdades de direito [77], uma associação de nível escolar que não desce para artigos ou autores individuais, a cautela de inferência ecológica da Seção 6.2(iii). O fato de que instituições atuem em tais medidas é uma instância de uma dinâmica bem documentada: os rankings públicos são reativos, reformulando o comportamento dos mesmos atores que pretendem descrever. O mecanismo foi estabelecido em detalhes para rankings de faculdades de direito, onde a comparabilidade e a profecia autorrealizável impulsionaram escolas a se reorganizar em torno da medida [58][132]. A SSRN reforçou a moeda diretamente, enviando periodicamente e-mails para os 30.000 principais autores (aproximadamente os 8% principais de cerca de 360.000 autores listados) para informá-los de que estavam "nos 10% principais" [161]. O "10%" é uma participação de autores listados (30.000/360.000 ≈ 8,3%), e contra a base completa de autores registrados de mais de 1,9 milhão [49], o mesmo 30.000 fica próximo aos 2% principais, então a frase descreve autores classificados e não todos os registrados. O aconselhamento de carreira, enquanto isso, avisa que métricas autopublicadas sozinhas "provavelmente não contarão para fins de promoção e posse em faculdade de direito" [33], e a literatura de avaliação mais ampla documenta tanto o quão profundamente a avaliação baseada em indicadores penetra a contratação e a posse quanto o quão mal é frequentemente projetada [110][115][153]. Os downloads em si são medidas de atenção, não medidas diretas de qualidade: o uso inicial prediz citações posteriores apenas modestamente (correlações em torno de 0,4, explicando cerca de 16% da variância em trabalhos iniciais [25], e 0,11–0,35 em estimativas posteriores [80]), e os conjuntos de artigos altamente baixados e altamente citados diferem substancialmente [108]. As instituições tratam esses números como evidência de carreira, embora não tenham escala e apenas uma conexão frouxa com impacto acadêmico, o que é um convite permanente para má interpretação em duas direções simétricas: sem uma escala, um autor pode abandonar uma linha de trabalho prematuramente com base em um contador malinterpretado, ou gastar tempo escasso e capital social promovendo um artigo cujos números nunca foram anômalos. Os Rankings, sejam quais forem seus defeitos, alimentaram exatamente essa decisão recorrente sobre se a promoção adicional de um artigo era justificada, e sua remoção deixou a escolha a ser feita sem dados (um ponto abordado na Seção 6.4).
As apostas também são emocionais: o que os autores experimentam no painel é uma forma distintiva de ansiedade de métrica, e as contagens de downloads são observadas compulsivamente. Observadores cientométricos descreveram o gênero de ferramentas de rastreamento de visibilidade automática como "tecnologias de narcisismo" já em 2012 [177], e a admissão de um destacado acadêmico jurídico de que monitorar suas contagens era "como crack para mim" (Bainbridge, 2007, conforme citado na literatura sobre comportamento de gaming da SSRN) tornou-se emblemática [44]. O mesmo programa de pesquisa estabeleceu experimentalmente o que a ansiedade produz: autores fazem download automático de seus próprios artigos para inflar contagens, e fazem isso com maior intensidade perto dos limiares de visibilidade das listas dos dez principais e sob comparação social desfavorável com pares [44]. Loops de feedback social deste tipo são uma propriedade geral dos mercados de atenção: sinais sociais iniciais amplificam desigualdade e imprevisibilidade em mercados culturais [131], sinais positivos iniciais enviesam avaliações subsequentes [112], e o sucesso gera sucesso em experimentos de campo [162]. Marcos autorrelatados nas redes sociais, tendenciosos para o alto desempenho, aguçam a comparação para todos cujo painel lê 7. A ausência de um benchmark público assim cria ansiedade, alimenta má interpretação e incentiva a inflação artificial que mina a métrica para todos. O problema é antes de medição do que de desempenho: uma métrica que é simultaneamente visível, emocionalmente carregada, relevante para a carreira e ininterpretável é uma falha genuína da infraestrutura de medição, não uma deficiência pessoal da pessoa olhando para o painel.
1.4 Quem sofre mais: a dimensão de equidade
Os custos de métricas ilegíveis não são distribuídos uniformemente. Autores com redes profissionais densas podem fazer benchmarking informalmente; autores estabelecidos carregam visibilidade prévia de um artigo para outro. A ausência de normas públicas pesa mais fortemente em pesquisadores no início de carreira, estudiosos independentes e não afiliados, autores em subcampos estreitos, autores fora das disciplinas historicamente dominantes na plataforma e autores fora de instituições de elite. A desvantagem é estrutural e não meramente informacional: a maquinaria de descoberta do SSRN roteia atenção através de séries de working papers institucionais e alertas de eJournal por assinatura [57]. Um pesquisador não afiliado pode postar, mas não pode inserir um artigo em uma série institucional de alto tráfego, e depende inteiramente da classificação por assunto para visibilidade [168][53]. Para tal autor, o canal de exposição institucional está efetivamente fechado, então o peso da descoberta recai desproporcionalmente nas camadas de busca e IA. A visibilidade de máquina, examinada na Seção 8, é portanto uma questão de equidade e não meramente uma questão técnica. O pertencimento ao campo isoladamente desloca downloads esperados várias vezes antes de qualquer julgamento de mérito entrar [168]. Efeitos de prestígio operam no momento da primeira exposição, porque uma página pública do SSRN exibe nomes de autores e afiliações ao lado do título e do resumo. A revisão duplo-cega funciona de outra forma: remover identidades de autores reduz mensuravelmente os escores dos revisores para autores prestigiosos (em um estudo de 5.027 submissões ICLR, com um efeito muito menos determinado nas decisões de aceitação) [154], e avaliações respondem a sinais de identidade experimentalmente [64]. Na base da distribuição de atenção o fenômeno é ausência ao invés de desigualdade: em dados altmétricos, a atenção social mediana da pesquisa não financiada é zero em todos os campos estudados em uma grande amostra com foco em ODS [41], e atenção em plataformas abertas adjacentes é mais desigual que a renda em economias desenvolvidas, com coeficientes de Gini acima de 0,9 [180]. Para o autor mediano, a pergunta "7 downloads é ruim?" é uma tentativa de ler o único sinal que o sistema retorna, em um jogo cujas probabilidades são estruturalmente desiguais, ao invés de uma exibição de vaidade. Qualquer estrutura interpretativa que ignore essa assimetria diagnosticará de forma sistemática e incorreta os desfavorecidos ao ler invisibilidade como rejeição. A assimetria também se projeta para o futuro: se a camada emergente de respostas de IA herdar as tendências de marca e posicionamento documentadas para otimização de motor generativo comercial [5][164], ela reproduzirá ao invés de remediar essa desigualdade. Essa perspectiva incide com mais força em pesquisadores não afiliados e em autores do Sul Global, e é uma razão pela qual a auditoria de visibilidade de máquina da Seção 8.6 pertence à agenda de equidade ao invés de curiosidades da plataforma.
1.5 A demanda documentada por interpretação
A demanda por uma escala não é hipotética. É um dos padrões mais persistentes no discurso da comunidade acadêmica, e antecede o encerramento em pelo menos uma década. A Tabela 1 resume os aglomerados recorrentes de perguntas e preocupações dos autores, com as evidências mais fortes documentadas para cada um, o atalho inseguro que cada aglomerado convida (a resposta curta que parece útil e está errada), e a seção deste artigo que a responde.
Tabela 1. A demanda por interpretação: aglomerados de dor documentados da comunidade (2005–2026)
| # | Aglomerado | O que os autores perguntam ou relatam | Evidência documentada (confiança) | Atalho inseguro | Abordado em |
|---|---|---|---|---|---|
| 1 | "Meu número é normal?" — o benchmark ausente | Se uma contagem de downloads fornecida é boa, ruim ou típica para um artigo comparável | Pergunta pública "Importance of paper download statistics," Academia StackExchange, 2016 (título e data verificados via API oficial) [3]; perguntas de usuários sobre postagem no SSRN e seu valor [126]; tópicos de fórum recorrentes perguntando quantos downloads contam como "bom" (existência do tópico confirmada; respostas individuais não verificáveis independentemente, e material de fórum é tratado em todo o texto como evidência fraca da demanda, não como dados) [B-3]; solicitação de um autor de primeira viagem por "conselho honesto" sobre um documento de trabalho recém-postado (Reddit, abril de 2026; existência verificada via arquivos de terceiros) [B-5] | Um limite de contagem bruta universal ("N downloads = bom") | Seções 3, 5–6 |
| 2 | Confusão de mecânica — visualizações versus downloads | Por que as visualizações excedem os downloads; se uma proporção baixa significa um resumo fraco | Regra histórica de 3:1 [18]; banda de conversão relatada 11–19% [139][172]; média de amostra recente ≈24% [83]; guias de biblioteca documentam a incerteza dos autores sobre o que os contadores incluem [161] | A afirmação automática de que uma proporção baixa significa que o resumo é ruim | Seções 4–5 |
| 3 | Emoção e comparação social | Verificação compulsiva; constrangimento tanto com contagens baixas quanto altas | "Como crack para mim" (Bainbridge, 2007, conforme citado em [44]); evidência experimental de auto-download próximo aos limites da lista superior sob comparação social [44] | Comparação de si mesmo com a média de toda a plataforma ou as estrelas visíveis | Seções 1, 5 |
| 4 | Evidência de carreira — o que substitui a linha de classificação em um dossiê | O que citar em materiais de posse, promoção e contratação após o encerramento | Classificação de downloads "levada em conta em várias decisões de promoção e relacionadas" [12]; e-mails de notificação dos 10% principais [161]; conselhos de carta de apresentação [95]; comunicados à imprensa institucionais [101]; descrição de uso avaliativo da plataforma [52] | Citação de uma contagem cumulativa bruta sem data, fonte ou denominador | Seção 6 (Tabela 13) |
| 5 | Spam de solicitação pós-postagem | Convites de periódicos não solicitados chegando logo após a postagem | "Todos os dias, recebo pelo menos dois desses e-mails" (Reddit r/AskAcademia, 2023; verificado via arquivo; o autor havia publicado em um periódico MDPI, não no SSRN) [127]; coleta de endereços de artigos "por exemplo, aqueles postados no SSRN" [107]; auditorias de volume de solicitação [9][84][63]; uma revisão sistemática identificando 29 estudos empíricos de spam acadêmico [61] | Inferência da identidade ou intenção dos leitores a partir de um contador agregado | Seção 7 |
| 6 | Confiança nos contadores — bots, manipulação, quedas repentinas | Se os números são reais; por que os contadores caem | "SSRN não faz absolutamente nada para validar sua precisão" (Goldman, 2005, anterior aos filtros atuais; uma atualização posterior registra que o SSRN desconta downloads repetidos da mesma fonte) [66]; filtragem de integridade de dados publicada do SSRN [144][66][69]; tráfego de robô constituindo ~74% de visualizações de resumos, mas apenas ~7% de downloads em dados antigos de RePEc [99]; grandes episódios de filtragem de bots em RePEc até 2025–2026 [129] | Tratamento do número exibido como uma contagem exata de leitores humanos únicos | Seções 4, 9 |
| 7 | Diagnósticos — "por que zero downloads?" | O que um zero ou uma estagnação significa nas primeiras semanas | Incerteza de autores pós-encerramento documentada em tópicos de comunidade (existência confirmada via arquivos de terceiros) [B-5]; páginas de suporte da plataforma descrevem as métricas mas, em agosto de 2026, não oferecem orientação interpretativa [52][50] (auditoria de pesquisa, Seção 2.5) | Tratamento de um zero pré-distribuição como rejeição | Seções 4–6 |
Nota. Apenas citações verificadas independentemente contra uma fonte ao vivo ou arquivada são reproduzidas literalmente; todo outro material da comunidade é parafraseado e marcado por seu status de confiança. A ética de citar postagens de usuários, incluindo anonimato e tratamento de conteúdo excluído, é abordada na Seção 9.
O aglomerado mais forte na Tabela 1 é a pergunta crônica "meu número é normal?", que recorre ao longo dos anos, plataformas e disciplinas. Até mesmo os insiders da plataforma não oferecem um benchmark em troca, e o sarcasmo que frequentemente responde a isso nos fóruns da comunidade sinaliza que ninguém, incluindo usuários experientes, possui a escala ausente [B-3]. Os aglomerados também estão causalmente conectados: o benchmark ausente (aglomerado 1) produz a carga emocional (aglomerado 3), que produz o incentivo de manipulação documentado em [44], que por sua vez enfraquece a confiança investigada no aglomerado 6. Restaurar a interpretabilidade aborda a cadeia em sua raiz. O framework visa não aumentar downloads, mas restaurar significado.
1.6 O que este artigo argumenta: oito posições
Estas são as posições que o artigo defende, cada uma argumentada na seção indicada.
1. Contagens brutas são ininterpretáveis sem uma classe de referência. Uma contagem cumulativa de downloads não tem significado estável sem condicionar na idade do artigo, campo, coorte de postagem, canal de distribuição e visibilidade prévia do autor [83][168][178][53]. Este é o problema da classe de referência da Seção 5, e torna "7 downloads é bom?" mal colocado como perguntado.
2. Alcance baixo e conversão baixa são diagnósticos diferentes. Um artigo que poucas pessoas encontram coloca um problema diferente do que um artigo que muitas pessoas visualizam mas poucos baixam, e justifica ação diferente. Invisibilidade não é rejeição de conteúdo. As Seções 4–5 desenvolvem essa distinção em um diagnóstico de alcance por conversão (Tabela 9), incluindo a configuração de "interesse oculto" na qual conversão forte coexiste com alcance fraco.
3. Os medidores sobreviveram; a escala comparativa não. A assimetria do encerramento (números retidos, normas removidas [149]) descreve a condição pós-Rankings exatamente, e converte um problema de interpretabilidade latente de longa data em um urgente e universal (Seção 2).
4. Um benchmark percentil é um bem público. O número que todo autor procura no Google e não encontra é uma tabela de percentil por disciplina e idade do artigo. As Seções 5 e 8 especificam como a comunidade pode construir e manter uma, agora que não pode mais ser lida da plataforma.
5. Normas calibradas exigem um painel observado a partir da postagem. A evidência publicada consiste de seções transversais envelhecidas e capturas instantâneas únicas [139][85][168][83]. O único grande estudo recente identifica explicitamente dados em painel como o próximo passo necessário [83]. Sem observação a partir do dia zero, "normas" de primeira semana e primeiro mês são extrapolações e devem ser rotuladas como tal (Seção 8).
6. Um benchmark multidimensional supera uma pontuação de vaidade única. Relatar alcance normalizado, desempenho de download, conversão, ímpeto e validação posterior separadamente (CSAB, Tabela 10) preserva informações diagnósticas que qualquer índice composto destrói (Seção 5).
7. A camada de resposta de IA está se tornando um novo guardião da atenção. A descoberta está migrando para cima na pilha, da marca do periódico para repositório para mecanismo de busca para motores de resposta de IA que sintetizam uma única resposta e citam um punhado de fontes [5][164]. Um quarto dos adultos nos EUA já usam chatbots de IA diariamente [121], enquanto a confiabilidade desses motores como canais de citação permanece contestada [82] e nenhum estudo controlado da visibilidade de pré-impressos científicos neles ainda existe [100]. A Seção 8 apresenta o protocolo de auditoria compacto; a auditoria completa é reservada para trabalho complementar.
8. Um protocolo de painel e dossiê é necessário agora. Autores e comitês não podem esperar por nova infraestrutura de dados. A Seção 6 fornece regras provisórias para ler um painel e um protocolo de evidência de sete etapas para dossiês (Tabela 13) cujo requisito principal é que cada número relatado exiba sua fonte, sua janela de tempo e suas limitações.
1.7 Contribuições
A lista abaixo expõe o que o artigo adiciona à literatura existente, na ordem em que as seções a desenvolvem.
1. Um diagnóstico. Identifica o problema de classe de referência nas métricas de uso da plataforma e nomeia o fenômeno subjacente: o cold start da atenção acadêmica. O termo é adaptado da literatura de sistemas de recomendação, onde um item cold-start carece do histórico de interação necessário para colocá-lo [133]. Neste cold start, novos artigos e novos autores entram em um sistema de difusão no qual a atenção inicial depende substancialmente da arquitetura da plataforma, distribuição e reputação anterior antes que a qualidade substantiva possa exercer sua influência total [72][111][140][83]. A afirmação central é a tese da mal-posição da Seção 1.1: a questão principal não tem resposta até que seu denominador e grupo de comparação sejam fornecidos.
2. Um mapa consolidado de benchmarks. Reúne, pela primeira vez desde o encerramento (auditoria da Seção 2.5, agosto de 2026), cada benchmark empírico verificado para downloads e visualizações de resumos do SSRN em uma única tabela (Tabela 7), com estruturas de amostragem explícitas, períodos, ressalvas sobre envelhecimento e uma classificação de confiança da fonte para cada linha. Os benchmarks são a evidência distribucional de grande amostra [83], as raspagens de lista superior quase-lognormal [85], amostras de pesquisa jurídica [139][168][171][172] e agregados de plataforma [1][49].
3. Um marco de funil de atenção com diagnósticos. Decompõe a difusão em exposição, visualização de resumo, download de texto completo e uso posterior. Em seguida, deriva a matriz de alcance por conversão (Tabela 9), que separa invisibilidade de rejeição e inclui a configuração de interesse oculto que contagens brutas sistematicamente mascaram.
4. Instrumentos de interpretação. Converte o mapa de benchmarks em uma escala de interpretação graduada (Nascente / Modesto / Sólido / Forte / Excepcional; Tabela 8), uma banda de conversão com exemplos trabalhados e o Benchmark de Atenção Acadêmica Cold-Start (CSAB; Tabela 10), um formato de relatório multidimensional normalizado por campo, idade, coorte e visibilidade anterior do autor. As bandas da escala são comparativas apenas dentro do mesmo campo e idade do artigo, já que a associação a um campo por si só muda os downloads esperados várias vezes, e cada limite é baseado em fonte ou explicitamente marcado como estimativa do autor.
5. Uma camada prática. Fornece regras para ler seu próprio painel, diagnósticos para o caso de download zero, uma tabela de ações baseada em situação (Tabela 23), uma tipologia hipotética de sinais de solicitação predatória com a ressalva de que spam de solicitação não altera os contadores nem evidencia leitura (Tabela 14), e o protocolo de dossiê de sete etapas (Tabela 13).
6. Uma agenda de pesquisa pronta para pré-registro. Especifica um painel prospectivo com observação em 1, 3, 7, 14, 30, 60, 90 e 180 dias após o envio, e dois desenhos quase-experimentais: distribuição de alerta de email cuidada como um choque de atenção intra-artigo, e o encerramento do Rankings como um experimento natural em interpretabilidade de métricas. Especifica ainda um conjunto de dados percentil construído pela comunidade como a única rota remanescente para percentis atualizados, um protocolo de auditoria de visibilidade de máquina compacto para motores de resposta de IA e um registro prespecificado, puramente descritivo, da trajetória de download própria deste artigo. Cada estudo é executável com baixo custo e dentro dos limites de acesso e ética da Seção 9, com previsões numéricas declaradas como bandas pré-especificadas em vez de descobertas.
1.8 Organização do artigo
O restante do artigo contém nove seções adicionais e cinco apêndices. A Seção 2 reconstrói o evento e seu contexto: a cronologia completa do pacote de reformas de 2026, o que permanece e o que foi removido (Tabela 2, Figura 1), e a justificativa declarada pela plataforma de realocação de recursos e reorientação. A Seção 3 apresenta as evidências de distribuição verificadas e mostra por que a média é enganosa. Abrange a lacuna média-mediana [83], a cauda quase-lognormal [85], e heterogeneidade disciplinar [168] (Figuras 2–4, Tabelas 3–5), considerando o referencial teórico do efeito Mateus e vantagem cumulativa [104][105][131][162] (dinâmicas que foram quantificadas diretamente em carreiras longitudinais e trajetórias de citação [120]), e a distinção entre medidas de atenção e medidas de qualidade [25][80][108][178]. A Seção 4 examina a mecânica dos contadores: filtragem e integridade de dados [144][66], tráfego de robô e tráfego fantasma com os contraargumentos necessários [99][106][129], arquiteturas de plataforma (Tabela 6), e higiene de metadados e versionamento. A Seção 5 apresenta o núcleo da interpretação: o argumento de classe de referência, o mapa de referência consolidado (Tabela 7), a escala de interpretação (Tabela 8), a banda de conversão, a matriz de alcance por conversão (Tabela 9), e CSAB (Tabela 10). A Seção 6 traduz o marco teórico em prática para autores e comitês de avaliação, incluindo o protocolo de dossiê (Tabela 13) e, no Apêndice A, orientação baseada em situação (Tabela 23). A Seção 7 analisa a camada parasita da economia de atenção, solicitações predatórias tratadas como sinais de visibilidade hipotéticos, com todas as alegações de tempo e prevalência declaradas como hipóteses [9][61][63][84][107]. A Seção 8 apresenta a agenda empírica pronta para pré-registro, incluindo um tratamento compacto da migração da atenção para cima na pilha até a camada de resposta de IA e suas implicações para a descoberta de preprints [5][100][82][121][164]. A Seção 9 detalha limitações, incluindo o caráter de fonte única da melhor evidência de distribuição disponível [83], o envelhecimento das amostras de 2012–2015, e a instabilidade da documentação da plataforma. A Seção 10 conclui com recomendações de política para SSRN (principalmente, bandas de percentil anônimas por disciplina e idade do artigo como substituto que restaura o contexto sem reviver a competição de tabelas de classificação) e para a comunidade de pesquisa.
2. O Evento: O Pôr do Sol das Classificações e Seu Contexto
2.1 O que eram as Classificações
Durante a maior parte do histórico do SSRN, seus contadores de uso situavam-se dentro de um aparato comparativo denso. No nível de artigo, a plataforma mantinha listas Top 10.000 por downloads de doze meses e todos os tempos, juntamente com listas de "artigos principais recentes" por eJournal calculadas em janelas móveis de sessenta dias. No nível de autor, ela mantinha uma lista Top 30.000 em todas as disciplinas e ligas disciplinares, como os Top 3.000 autores de direito, classificáveis por downloads novos, downloads totais, downloads por artigo e citações. No nível institucional, ela mantinha tabelas de liga mensais incluindo as Top 350 Escolas de Direito dos EUA e as Top 500 Escolas de Direito Internacionais [B-9, páginas de ranking histórico; todas essas URLs retornaram um erro ou uma página reservada desde 15 de julho de 2026 e podem ser citadas apenas de cópias arquivadas]. A plataforma também traduzia classificação em feedback percentual direto. Como a documentação do guia de métricas SSRN da Biblioteca de Direito Gallagher da Universidade de Washington documentou, "O SSRN envia periodicamente mensagens aos 30.000 principais autores, por downloads novos e por downloads de todos os tempos, para informá-los de que estão no top 10%". Contra a própria figura do guia de "mais de 360.000 autores," esse limite correspondia aproximadamente aos 8% principais de autores listados (30.000 de cerca de 360.000) [161, acessado em 14 de agosto de 2026], um amplo escalão superior ao invés de uma elite estreita; a Seção 1.3 observa que contra a base completa registrada os mesmos 30.000 estão mais próximos aos 2% principais. Essas listas e mensagens eram, com efeito, as únicas informações percentuais fornecidas pela plataforma e voltadas para o autor sobre downloads do SSRN jamais tornadas públicas.
O aparato comparativo não era decorativo. Black e Caron propuseram em 2006 que downloads do SSRN poderiam servir como uma medida "beta" do desempenho acadêmico de professores de direito, suplementando pesquisas de reputação e contagens de citações [18]. O mesmo volume de simpósio contém um exame crítico da proposta [45]. Institucionalmente a proposta teve sucesso: rankings de download entraram em materiais de contratação, arquivos de promoção e publicidade institucional. A própria documentação de suporte do SSRN descreve suas métricas como figuras "que autores usam para fins de promoção e titularidade e que instituições usam em suas atividades de contratação e ranking" [52, acessado em 14 de agosto de 2026]. A orientação de publicação do Legal Writing Institute aconselhou autores a mencionar "downloads do SSRN (se muitos), inclusão em listas SSRN Top Ten Downloads" em cartas de apresentação para revistas jurídicas [95]. Em junho de 2026, Stephen Bainbridge colocou a função de carreira no registro: ele foi "classificado em 13º lugar entre 3.000 autores de direito em número total de downloads de todos os tempos, que a escola de direito levou em consideração em várias decisões de promoção e afins" [12]. A própria liderança do SSRN documentou a transformação da comunicação acadêmica de direito em um pré-impresso de seu então-CEO [68]. Instituições também comercializaram as ligas: já em janeiro de 2026, Maynooth University anunciou que sua School of Law and Criminology ficou em primeiro lugar entre departamentos irlandeses na SSRN Top 500 Escolas de Direito Internacionais, citando mais de 143.500 downloads [101]. O domínio do aparato sobre o comportamento é documentado na análise dos registros do servidor SSRN por Edelman e Larkin. O estudo descobriu que o auto-download enganoso se intensificou no momento exato em que um artigo se aproximava do limite de uma lista top-ten, e identificou comparação social, ao invés de riscos de carreira apenas, como o principal motor da manipulação [44]. O mesmo estudo circulou a observação, atribuída a Bainbridge em 2007, de que monitorar a contagem de downloads de alguém era "como crack para mim" [44].
O aparato tinha uma segunda função que atraiu menos atenção. Citações e pesquisas de reputação funcionam em ciclos de vários anos; os rankings retornaram feedback em tempo quase real, e permitiram que pesquisadores em início de carreira e autores fora de instituições prestigiosas demonstrassem impacto visível diretamente, sem esperar por instrumentos de filtragem mais lentos e conservadores. Apesar de seus defeitos, as tabelas de liga eram o único dispositivo comparativo igualmente visível para cada autor na plataforma. Isso é parte da razão pela qual sua remoção muito provavelmente incide mais pesadamente, como a Seção 1.4 argumenta, nos autores que têm substitutos informais mais escassos. Nenhuma evidência distribucional direta sobre os efeitos do encerramento ainda existe, então esta é uma expectativa direcional que RQ1 (Seção 8.5) testa: bilateral, pergunta se a remoção concentrou ou dispersou atenção sem pressupor a direção.
2.2 Cronologia do Recuo de 2026
A remoção dos Rankings em 15 de julho de 2026 foi o resultado de uma sequência de decisões de plataforma iniciadas no final de 2025, resumida na Figura 1.
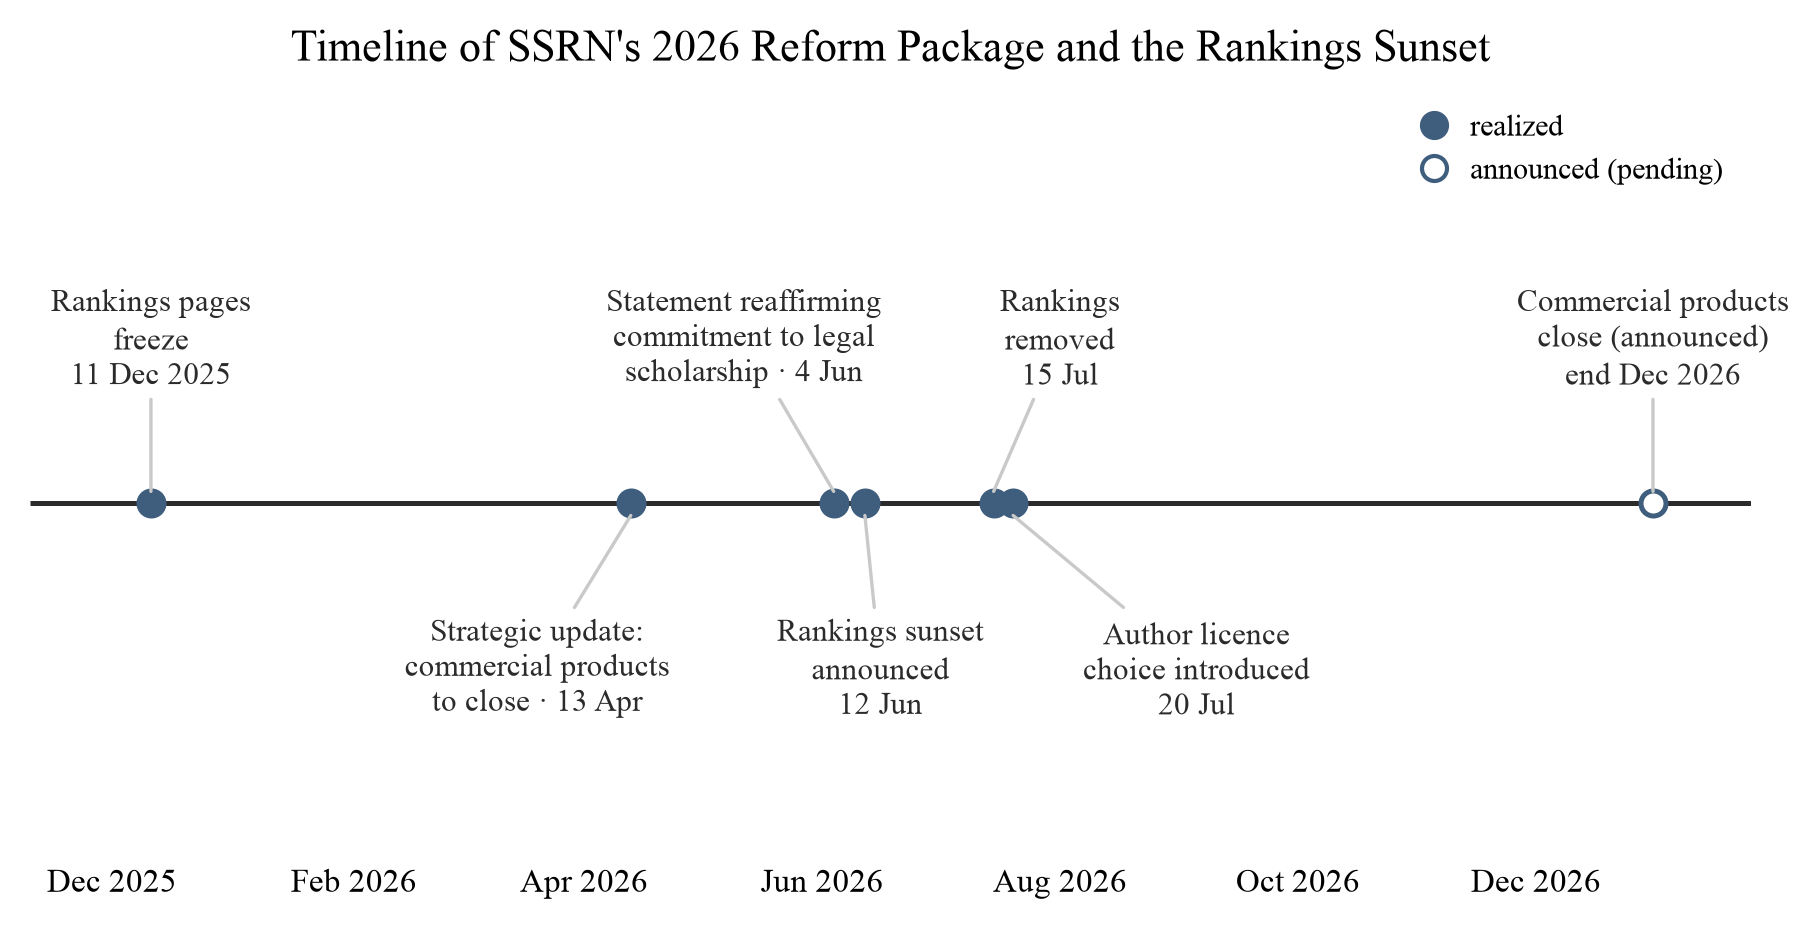
Figura 1. Linha do tempo do pacote de reforma de 2026 do SSRN. Eventos: congelamento das páginas de ranking de download do eJournal (a partir de 11 de dezembro de 2025, conforme documentado em um post do TaxProf Blog de 25 de janeiro de 2026 [B-2]); atualização estratégica anunciando o encerramento de todos os produtos comerciais até o final de 2026 (13 de abril de 2026) [146]; declaração pública reafirmando o compromisso do SSRN com a pesquisa jurídica (4 de junho de 2026) [147]; anúncio de que os Rankings seriam descontinuados "a partir de 1º de julho de 2026" (12 de junho de 2026) [148]; remoção efetiva dos Rankings (15 de julho de 2026) [149]; introdução da escolha de licença do autor (20 de julho de 2026) [150]; encerramento anunciado dos produtos comerciais restantes (final de dezembro de 2026) [146]. Fontes: [146][147][148][149][150][B-2].
A degradação começou antes de qualquer anúncio formal. Em 11 de dezembro de 2025, as páginas de ranking de download por eJournal pararam de ser atualizadas. Paul Caron havia mantido um recurso semanal "Top Five New Tax Papers" construído naqueles rankings por mais de duas décadas. Em um post de 25 de janeiro de 2026, ele documentou que os rankings fiscais haviam congelado na janela "12 Oct 2025 – 11 Dec 2025" e escreveu que "isso pode ser o fim do SSRN Top Five New Tax Papers" [B-2, citado como uma paráfrase do post de 25 de janeiro de 2026, não de qualquer anúncio do SSRN].
Em 13 de abril de 2026, SSRN publicou uma "Atualização Estratégica" anunciando um foco renovado em sua "missão central de compartilhamento de pesquisa" e o encerramento de todos os produtos comerciais (Série de Artigos de Pesquisa, Redes Patrocinadas, Assinaturas de Site, anais de conferências pagos, painéis de análise, oportunidades de emprego e anúncios, e feeds de dados) até o final de dezembro de 2026 [146]. Observadores de bibliotecas registraram a mudança em poucos dias [34], e a unidade Digital Commons da Elsevier publicou orientações de migração para instituições cujas coleções da Série de Artigos de Pesquisa estavam sendo descontinuadas [47].
O anúncio provocou controvérsia pública na academia jurídica, a comunidade mais investida na infraestrutura de ranking. Em 3–4 de junho de 2026, Bainbridge publicou uma crítica amplamente lida sob o título "The Social Science Research Network Has Jumped the Shark," seguida de um post registrando que SSRN havia respondido a seus comentários críticos com esclarecimentos sobre o cronograma dos encerramentos da série de artigos e a preservação dos eJournals de tema específico [12]. Em 4 de junho de 2026, SSRN emitiu uma declaração sobre seu "compromisso contínuo com a pesquisa jurídica," prometendo que as distribuições de eJournal e alertas de e-mail "continuariam inalteradas" [147]. Em 7 de junho de 2026, Caron respondeu a Bainbridge no TaxProf Blog sob o título "SSRN Has Not Jumped the Shark" [B-11]. A troca é um registro público conciso do que a comunidade considerava que valiam as características comparativas da plataforma na véspera de sua remoção.
Em 12 de junho de 2026, SSRN anunciou que "descontinuaria Rankings a partir de 1º de julho de 2026," afirmando que "na SSRN, sempre acreditamos que a pesquisa deve falar por si mesma" [148]. O encerramento entrou em vigor duas semanas depois do inicialmente anunciado: em 15 de julho de 2026, os rankings de artigos, autores e instituições foram removidos [149]. Cinco dias depois, em 20 de julho de 2026, uma reforma adicional introduziu a escolha de licença do autor [150]. O intervalo de duas semanas entre as datas anunciadas e reais, e a janela de um mês entre o anúncio e a execução, são em si mesmos analyticamente relevantes: criaram um período de antecipação durante o qual autores e instituições poderiam observar a mudança que se aproximava, um ponto abordado no design quase-experimental da Seção 8.
2.3 A Justificativa Oficial e Sua Evolução
A justificativa declarada para o encerramento era alocação de recursos e reorientação da plataforma. O comunicado de julho explicava que as classificações "exigem alocação significativa de recursos de produto e desenvolvimento" e enquadrava a decisão em uma reorientação para publicação mais rápida, melhor descoberta e integridade da pesquisa. Também afirmou que "as contagens de downloads e as estatísticas de citações continuarão sendo registradas e exibidas em seus artigos individuais e no perfil de autor" [149]. O comunicado deixa aberta a possibilidade de retorno de recursos comparativos: a SSRN escreveu que "pode revisitar a ideia de várias classificações" [149], portanto a remoção não deve ser descrita como permanente. O silêncio nos registros também importa: os comunicados não atribuem a decisão a gaming de métricas, manipulação, ou abuso competitivo das classificações, e narrativas que forneçam tais motivos vão além dos textos publicados [148][149].
O tom da explicação oficial evoluiu entre o comunicado e a página que substituiu as URLs de classificação. Enquanto a postagem de junho falava sobre alocação de recursos, a página substituta afirma que a "nova direção da SSRN coloca autores individuais e seu trabalho no centro de tudo o que fazemos," e que "tabelas de classificação agregadas de instituições e departamentos não se encaixam mais nesse cenário" [B-8; a página é servida atrás de restrições de acesso e essas frases são citadas de cópias de índice de pesquisa, portanto um snapshot arquivado deve acompanhar qualquer citação]. A postagem de junho apresenta o encerramento como uma decisão de custo, a página substituta como uma reorientação baseada em princípios afastando-se completamente da comparação institucional.
A SSRN não deixou os autores completamente sem uma referência oficial de contexto. Sua documentação de suporte sobre aferir o impacto de um artigo direciona os autores para os contadores de nível de artigo (visualizações de resumo e downloads) complementados por PlumX Metrics, um produto de altmétricas Elsevier que agrega sinais de citação, uso e mídia social [50, acessado em 14 de agosto de 2026]. PlumX assim se posiciona como a substituição de fato da plataforma para contexto interpretativo. É uma substituição parcial: agrega sinais adicionais para um artigo individual, mas não fornece distribuição, percentil ou comparação de coorte. Esses são os elementos que as Classificações, por mais imperfeitas que fossem, tinham fornecido. Os encerramentos não se estendem à integração da SSRN com fluxos de trabalho de periódicos: o programa First Look continua conectando a plataforma a mais de 1,200 periódicos Elsevier [48][145]. A governança comercial da plataforma também situa essas decisões de produto em um mercado editorial acadêmico altamente concentrado [94].
2.4 O Que Permanece e O Que Foi Removido
A Tabela 2 mapeia o estado pós-encerramento da plataforma, juntamente com a implicação de medição de cada elemento: o que cada recurso sobrevivente, desaparecido ou não reportado significa para quem tenta ler uma contagem. A remoção foi assimétrica. Todo contador por artigo e por perfil permanece. O aparato comparativo construído com base nesses contadores foi retirado integralmente.
Tabela 2. O que permanece e o que foi removido após o encerramento do Rankings em 15 de julho de 2026, com implicações de medição. Fontes: [147][149][161][B-8][B-9]; linhas de mecanismo de exposição: [53][57][55][144][66][69].
| Recurso | Status após 15 de julho de 2026 | Base de fonte | Implicação de medição |
|---|---|---|---|
| Contagens de downloads por artigo | Permanecem; exibidas nas páginas dos artigos | Confirmado literalmente no anúncio de encerramento [149] | O uso bruto permanece observável, mas agora não carrega sua própria classe de referência |
| Visualizações de resumo por artigo | Permanecem (não mencionadas literalmente no anúncio de encerramento, que lista "contagens de downloads e estatísticas de citação"; as visualizações continuam sendo exibidas) | [149], observação da plataforma, acessada em 14 de agosto de 2026 | O alcance permanece observável, portanto os diagnósticos de alcance–conversão por artigo (Tabela 9) permanecem computáveis |
| Estatísticas de citação (artigo e perfil de autor) | Permanecem | Confirmado literalmente [149] | O uso posterior ainda pode complementar medidas de atenção inicial |
| Perfil de autor (artigos, afiliações) | Permanece | Observação da plataforma, acessada em 14 de agosto de 2026 | A agregação no nível de portfólio permanece possível, com o mesmo denominador ausente |
| Assinaturas de eJournal e alertas de email | Permanecem | "Continuam inalteradas," declaração de 4 de junho de 2026 [147] | O canal de exposição por push persiste, portanto os contadores iniciais permanecem dependentes da arquitetura (Seção 4.4) |
| Classificações de tópico (1–7, selecionadas pelo autor) | Permanecem; orientam o roteamento de eJournal | Documentação da plataforma [53] | A classificação é uma variável de exposição potencialmente consequente |
| Distribuição de eJournal curada | Continua; inclusão "curada e direcionada, não garantida" | [53][57][147] | O status de distribuição e a data devem ser modelados como um tratamento, não como contexto |
| Atraso de distribuição em tópicos de alto volume | Continua; até 45 dias | [53] | As contagens do primeiro mês podem misturar regimes pré e pós-distribuição |
| Indexação externa (Google, Google Scholar) | Continua, no cronograma controlado pelo mecanismo de busca ("6–9 meses ou mais") | [55] | Um processo de exposição com censura de intervalo: a data de exposição é limitada, não observada |
| Filtragem de atividades suspeitas | Continua | [144][66][69] | As contagens são eventos filtrados, não leitura ou endosso verificados |
| Recuperação de artigos por respostas de IA | Não reportado pela SSRN | Não existe relatório de plataforma; Seção 8.6 | A visibilidade por máquina requer uma auditoria independente e repetida (Estudo 2) |
| Métricas PlumX nas páginas dos artigos | Permanecem; indicador oficial para avaliação de impacto | Documentação de suporte [50] | Sinais adicionais por artigo, mas sem distribuição, percentil ou comparação de coorte (Seção 2.3) |
| Listas de Artigos em Destaque (Top 10.000; recentes/todos os tempos por eJournal) | Removidas; URLs retornam um erro ou a página de encerramento | [149][B-8][B-9] | Um quadro comparativo importante — e uma possível superfície de descoberta — desapareceu |
| Listas de Autores em Destaque (Top 30.000; ligas disciplinares) | Removidas | [149][B-9] | A posição de percentil no nível do autor não é mais publicamente observável |
| Ligas no nível de instituição (Top 350 EUA / Top 500 Escolas de Direito Internacionais, etc.) | Removidas | [149][B-8][B-9] | A comparação institucional não pode mais ser computada a partir dos dados da plataforma |
| Enquadramento de percentil público (classificação de autor, posicionamento "top 10%") | Removido com a infraestrutura de rankings | [149][161] | A classe de referência deve agora ser reconstruída externamente (Seções 5, 8) |
| Emails de notificação "Top 10% de autores" | Destino não abordado nas comunicações oficiais; os emails estavam vinculados à infraestrutura de rankings | [161][149] | Um sinal de percentil utilizável em dossiê não pode mais ser assumido que chegará |
As linhas sobreviventes na Tabela 2 são exatamente os contadores brutos e a maquinaria de exposição que os alimenta: a plataforma continua produzindo números na mesma taxa de antes. As linhas removidas são exatamente o conjunto de quadros comparativos: distribuições, limites, classificações e mensagens de percentil. O evento, portanto, tem uma estrutura informacional precisa (dados retidos, classe de referência removida), e essa estrutura converte um problema latente de longa data, como ler um número SSRN, em um agudo e universal. Chamamos a propriedade da plataforma que mudou de opacidade de referência: uma propriedade graduada de uma plataforma que descreve se ela publica as estatísticas distribucionais necessárias para situar uma contagem individual (percentis, medianas, distribuições de coorte), ou apenas contadores brutos, médias e listas top-N. Em 15 de julho de 2026, SSRN passou em um único passo de transparência parcial para opacidade de referência quase completa, e o resto do artigo pode ser lido como um estudo do que essa propriedade custa a seus usuários. Opacidade, assim definida, tem pelo menos quatro dimensões: cobertura populacional (a quem as estatísticas publicadas descrevem), granularidade de classe de referência (se levam em conta campo, idade e coorte), estabilidade temporal (se as definições e janelas permanecem comparáveis ao longo do tempo), e auditabilidade (se as regras de contagem são públicas o suficiente para serem verificadas). Os quatro operam parcialmente de forma independente: as classificações podem reduzir uma forma de opacidade enquanto pioram outra se seus denominadores e regras de seleção são pouco claros. Essa independência parcial é por isso que as recomendações de plataforma da Seção 10.4 (itens 4 e 8) tratam da divulgação em si mesma e não apenas do retorno dos números comparativos. Para tornar a propriedade mensurável, cada dimensão é pontuada em uma lista de verificação ordinal explícita aplicada à interface pública e à documentação de uma plataforma: cobertura populacional (0 = apenas contagens brutas, 1 = estatísticas resumidas publicadas em toda a plataforma, 2 = estatísticas distribucionais para populações definidas); granularidade de classe de referência (0 = nenhuma, 1 = um eixo como campo, 2 = condicionamento conjunto campo × idade × coorte); estabilidade temporal (0 = definições de contagem e janelas não documentadas ou silenciosamente revisadas, 1 = documentadas, 2 = documentadas e versionadas); e auditabilidade (0 = regras de contagem não publicadas, 1 = descritas em prosa, 2 = publicadas em detalhes verificáveis). O perfil de opacidade de uma plataforma é então a quádrupla de pontuações ao invés de um único rótulo. O mesmo instrumento pontua SSRN antes e depois da retirada (movendo os valores para baixo em cobertura, granularidade e, para as listas aposentadas, granularidade de classe de referência), e isso permite que as comparações entre plataformas da Tabela 6 sejam expressas como pontuações ao invés de impressões. Uma plataforma pode exibir muitos números e permanecer quase completamente opaca. A rubrica é uma primeira operacionalização, a ser refinada e testada entre avaliadores, não um índice finalizado.
2.5 A Demanda por Interpretação
A questão que o encerramento tornou urgente vinha sendo feita muito antes. A Tabela 1 (Seção 1.5) reúne os aglomerados documentados da demanda de autores por interpretação, restrita a fontes verificadas. Material de fórum é citado lá como evidência de demanda, não de distribuições, e citações de posts de usuários são reproduzidas apenas onde o próprio post foi localizado (a ética de citar posts de fórum semi-públicos é abordada na Seção 9).
As afirmações negativas que seguem baseiam-se em uma auditoria de busca estruturada em vez de buscas casuais, assim como as afirmações paralelas nas Seções 1.2, 1.5 (Tabela 1) e 8.8. O protocolo é declarado aqui uma vez. Construímos um inventário de mais de 25 formulações de consulta em inglês, organizadas em seis aglomerados de intenção: normativo ("quantos downloads de SSRN é bom"), definitório ("o que uma contagem de download de SSRN inclui"), navegacional pós-encerramento ("rankings de SSRN desaparecidos — onde comparar"), avaliativo ("downloads de SSRN como evidência de titularidade"), diagnóstico ("por que artigo SSRN com zero downloads"), e prático ("como aumentar downloads de SSRN"). Para cada consulta, registramos quem atualmente a responde e quão bem, sendo o critério se qualquer fonte retornada oferece valores de benchmark graduados e condicionados por campo, em vez de uma descrição da métrica ou uma anedota. Como controle positivo, executamos consultas análogas para o índice h, a pontuação do ResearchGate e contagens de citações, que confiavelmente revelam o gênero guia de limiar documentado em [118][128]. As mesmas formulações de intenção para downloads de SSRN não revelaram equivalente, antes ou depois do encerramento. A lacuna estende-se às referências comunitárias mais consultadas: visões gerais em estilo de enciclopédia da plataforma descrevem o que os contadores são, mas não oferecem normas interpretativas para eles [170]. A auditoria foi conduzida em julho–agosto de 2026 usando um pipeline customizado abrangendo motores de busca de propósito geral e motores de resposta de IA para consumidor, automatizando execução de consultas e pontuação de qualidade de resposta. A lista completa de consultas está disponível do autor. O resultado é um achado negativo e é reivindicado apenas como tal: ausência de evidência no período de auditoria, nos idiomas e mecanismos cobertos, não prova de que tal recurso não possa existir.
Para métricas vizinhas, a demanda interpretativa documentada na Tabela 1 (Seção 1.5) há muito tempo é atendida por um gênero para público em massa: "qual é um bom índice h" é atendido por dezenas de guias de limiar graduados e condicionados por campo [118], e normas de citação em nível de disciplina são objeto de artigos explicativos amplamente lidos [128]. Para downloads de SSRN não existe tal gênero. Pior, o melhor guia estruturado que existia, a página da biblioteca jurídica da Universidade de Washington, continuou após 15 de julho de 2026 a descrever os rankings de Top Authors e Top Papers em tempo presente, tornando-o parcialmente enganoso justamente quando a demanda atingiu o pico [156, acessado em 14 de agosto de 2026]. O encerramento não criou o problema de interpretação; ele removeu a única resposta parcial que o ecossistema tinha, no momento em que a memória institucional das distribuições começou a decair.
3. O Que os Dados Mostram: Por Que a Média Mente
3.1 O Que os Contadores Medem e O Que Não Medem
Qualquer uso dos contadores sobreviventes pressupõe uma explicação sobre o que medem. A Tabela 3 resume o conteúdo de medição de cada métrica, suas principais confundências e o papel diagnóstico que pode legitimamente desempenhar.
Tabela 3. O que as métricas SSRN medem — e o que não medem.
| Métrica | Interpretação substantiva mais próxima | Principais confundidores | Papel diagnóstico apropriado |
|---|---|---|---|
| Visualizações de página de resumo | Alcance da página de apresentação de um artigo | Exposição em busca, posicionamento na plataforma, reputação do autor, promoção externa, título, tamanho do campo, tempo online | Exposição / alcance |
| Downloads de texto completo | Intenção de inspecionar ou usar o artigo completo | Tudo o que afeta visualizações, mais qualidade do resumo, relevância e atrito de download | Engajamento |
| Downloads por visualização de resumo | Transição condicional da exposição da página de apresentação para a aquisição de texto completo | Pequenos denominadores, comportamento repetido, fontes de tráfego heterogêneas | Conversão |
| Citações | Incorporação observável em documentos eruditos posteriores | Normas de citação do campo, atraso na publicação, cobertura de banco de dados, autocitação, efeitos de status | Uso erudito subsequente |
| Sinais Altmetric / PlumX | Engajamento online mais amplo | Composição da plataforma e comportamento do usuário | Evidência complementar de difusão |
O conteúdo da tabela pode ser comprimido em um contraste de duas equações. A leitura que o painel silenciosamente convida é Downloads = Qualidade Científica. A representação defensável é
Downloads Observados = f(Q, E, R, C, T, P, ε),
onde Q denota características relacionadas à qualidade ou relevância da pesquisa, E exposição, R reputação, C características de comunicação, T tempo e idade, P mecanismos de plataforma, e ε influências não observadas. A expressão classifica confundidores; nenhuma forma funcional ou coeficiente é especificada. A classificação expressa exatamente a dificuldade prática: o pesquisador ordinariamente observa apenas o lado esquerdo.
Duas condições de contorno se aplicam à tabela. Os contadores não são logs de tráfego bruto. O SSRN tem filtrado suas contagens desde pelo menos os anos 2000: a plataforma afirma que exclui downloads aparentemente repetidos pela mesma pessoa e downloads aparentemente de robô, usando "pistas de atividade irregular", e que downloads anônimos sob suspeita são excluídos do total do autor [144]. Black e Caron estimaram que sem tal filtragem os contadores seriam inflados "por um fator de cinco ou mais" [18]. Um download contado registra um evento de engajamento e nada sobre endosso. Os contadores medem estágios de um processo de atenção. Nenhum deles mede mérito científico, e cada um é confundido por fatores de visibilidade que operam antes de qualquer leitor avaliar o conteúdo [44][72][144]. Esses limites foram reconhecidos desde as primeiras análises bibliométricas de dados de leitura [91]. Os estágios também podem se desacoplar uns dos outros, através de dois mecanismos hipotetizados: artigos sobre tópicos de relevância política podem ser muito baixados por profissionais que leem mas não citam, enquanto artigos especializados podem receber poucos downloads ainda que sejam citados regularmente pela pequena comunidade de especialistas que os necessita. Qualquer padrão separa visibilidade do uso subsequente, que é uma razão pela qual os conjuntos de artigos muito baixados e muito citados se sobrepõem apenas parcialmente [108].
3.2 Agregados de Plataforma e a Ficção da Média
Os únicos números relevantes para distribuição que o próprio SSRN publica são os totais da plataforma, e a primeira coisa a notar sobre os dados é o que acontece quando esses totais são calculados como média. A Tabela 4 reúne as estatísticas verificadas da plataforma com suas datas de referência.
Tabela 4. Estatísticas verificadas da plataforma SSRN, com datas de referência e status de verificação.
| Quantidade | Valor | Data de referência | Fonte | Status de verificação |
|---|---|---|---|---|
| Artigos em texto completo | 1,157,048 | 18 Dec 2023 | ALL-SIS Livro Branco sobre Métodos de Citação [1] | Verificado contra o PDF publicado |
| Resumos | 1,309,385 | 18 Dec 2023 | [1] | Verificado |
| Autores | 1,479,875 | 18 Dec 2023 | [1] | Verificado |
| Downloads cumulativos | 256,678,716 | 18 Dec 2023 | [1] | Verificado |
| Downloads dos últimos 12 meses | 40,642,329 | 18 Dez 2023 | [1] | Verificado |
| Artigos em texto completo (ponto de referência anterior) | 571,040 | 6 Jul 2016 | [1] | Verificado |
| Downloads, últimos 12 meses (ponto anterior) | 12,897,685 | 6 Jul 2016 | [1] | Verificado |
| Pré-impressões / artigos; autores | "1.5+ milhão"; "1.9+ milhão" | Página de produto de 2026 | Documentação de produto Elsevier SSRN [49], acessada em 14 Ago 2026 | Verificado (figuras de marketing arredondadas) |
| Artigos; autores; downloads totais; downloads 12 meses | >1.7M; >2.4M; >344M; >54M | 1 Nov 2025 | Boilerplate de anúncio SSRN [B-6] | Ordem de magnitude corroborada; os decimais exatos (344,8M / 54,7M) requerem cópias arquivadas do anúncio antes da citação |
| Derivado: download médio ao longo da vida por artigo em texto completo | ≈222 | Base de Dez 2023 | Calculado pelo autor: 256,678,716 ÷ 1,157,048 [1] | Aritmética em figuras verificadas |
| Derivado: downloads médios por artigo por ano | ≈35 | Base de Dez 2023 | Calculado pelo autor: 40,642,329 ÷ 1,157,048 [1] | Aritmética em figuras verificadas |
As duas últimas linhas são calculadas pelo autor e identificadas como tal; SSRN não publica médias por artigo. Os totais da plataforma diferem por fonte, data e definição (texto completo vs. artigos totais), portanto as derivações por artigo são obtidas dos números de texto completo de dezembro de 2023 reconciliados [1]; o boilerplate bruto de novembro de 2025 [B-6] é retido acima apenas como dados, utilizável exclusivamente em conjunto com cópias arquivadas (p. ex., via web.archive.org), pois as páginas originais de anúncio não são mais diretamente recuperáveis.
Nos números de dezembro de 2023 reconciliados, o artigo "médio" SSRN angariou aproximadamente 222 downloads ao longo de sua vida e aproximadamente 35 no ano passado [1]. Este número derivado é o mais próximo a uma norma da plataforma que um autor pode calcular, e é sistematicamente enganoso, porque a média é uma ficção da agregação. Todo estudo empírico da distribuição de downloads SSRN encontra assimetria à direita forte: a média é puxada muito acima da mediana por uma cauda superior longa, portanto o "artigo médio" descreve quase nenhum artigo real. O resto desta seção estabelece o tamanho e as consequências dessa lacuna. Uma agregação adicional importa para calibração. Os downloads anuais da plataforma cresceram de aproximadamente 0.5 milhão em 2000 para aproximadamente 3 milhões em 2005 [18], 12.9 milhões em 2016 e 40.6 milhões até 2023 [1]. O fluxo de downloads por artigo também aumentou: os downloads anuais cresceram cerca de 3.15 vezes de 2016 a 2023 enquanto o estoque de artigos cresceu cerca de 2.03 vezes [1], elevando o fluxo por artigo em aproximadamente 55%. Um estudo mais antigo portanto subestima as contagens absolutas que um artigo comparável ganharia hoje. A direção para a qual esse viés aponta depende da comparação: um limite antigo fixo é um limite inferior nas contagens de hoje, o que o torna um indulgente, não um limite conservador quando lido como uma banda de nível absoluto de 2026. A manipulação inversa é igualmente não autorizada: um limite antigo não pode ser "envelhecido" em uma norma de 2026 multiplicando-o pelo crescimento da plataforma, porque um repositório maior muda simultaneamente o numerador, o denominador, a composição de autores, os canais de distribuição, filtragem de bots e a competição por atenção. A leitura de viés de época usada em toda parte repousa na aritmética agregada de fluxo e estoque acima, não em qualquer redimensionamento de limites antigos. A própria análise anual da plataforma confirma crescimento contínuo: mais de 250,000 novos artigos foram publicados em 2025 (aumento de 20% em relação a 2024), com mais de 53 milhões de downloads durante o ano [145].
3.3 A Média Não é o Artigo Típico: Evidência Direta
A evidência distribuicional mais recente publicada para SSRN vem de Jo e Li, que analisam 2.361 artigos da Rede de Pesquisa em Marketing da SSRN em um único recorte transversal coletado em 15 de agosto de 2025 [83]. A Tabela 5 abaixo reproduz suas estatísticas descritivas na íntegra, e o mapa de referência consolidado da Seção 5 as incorpora. Os downloads médios foram 221.346 contra uma mediana de 87: a média é aproximadamente 2,54 vezes a mediana. O percentil 95, 726, é mais de oito vezes a mediana. A média supera até mesmo o percentil 75 (206), o que coloca mais de três quartos dos artigos da amostra abaixo do "artigo médio". Um pesquisador informado de que o artigo médio nesta rede tem aproximadamente 221 downloads concluiria que um artigo com 100 downloads está substancialmente abaixo do normal, embora 100 supere amplamente a mediana publicada. A Figura 2 exibe essa estrutura diretamente.
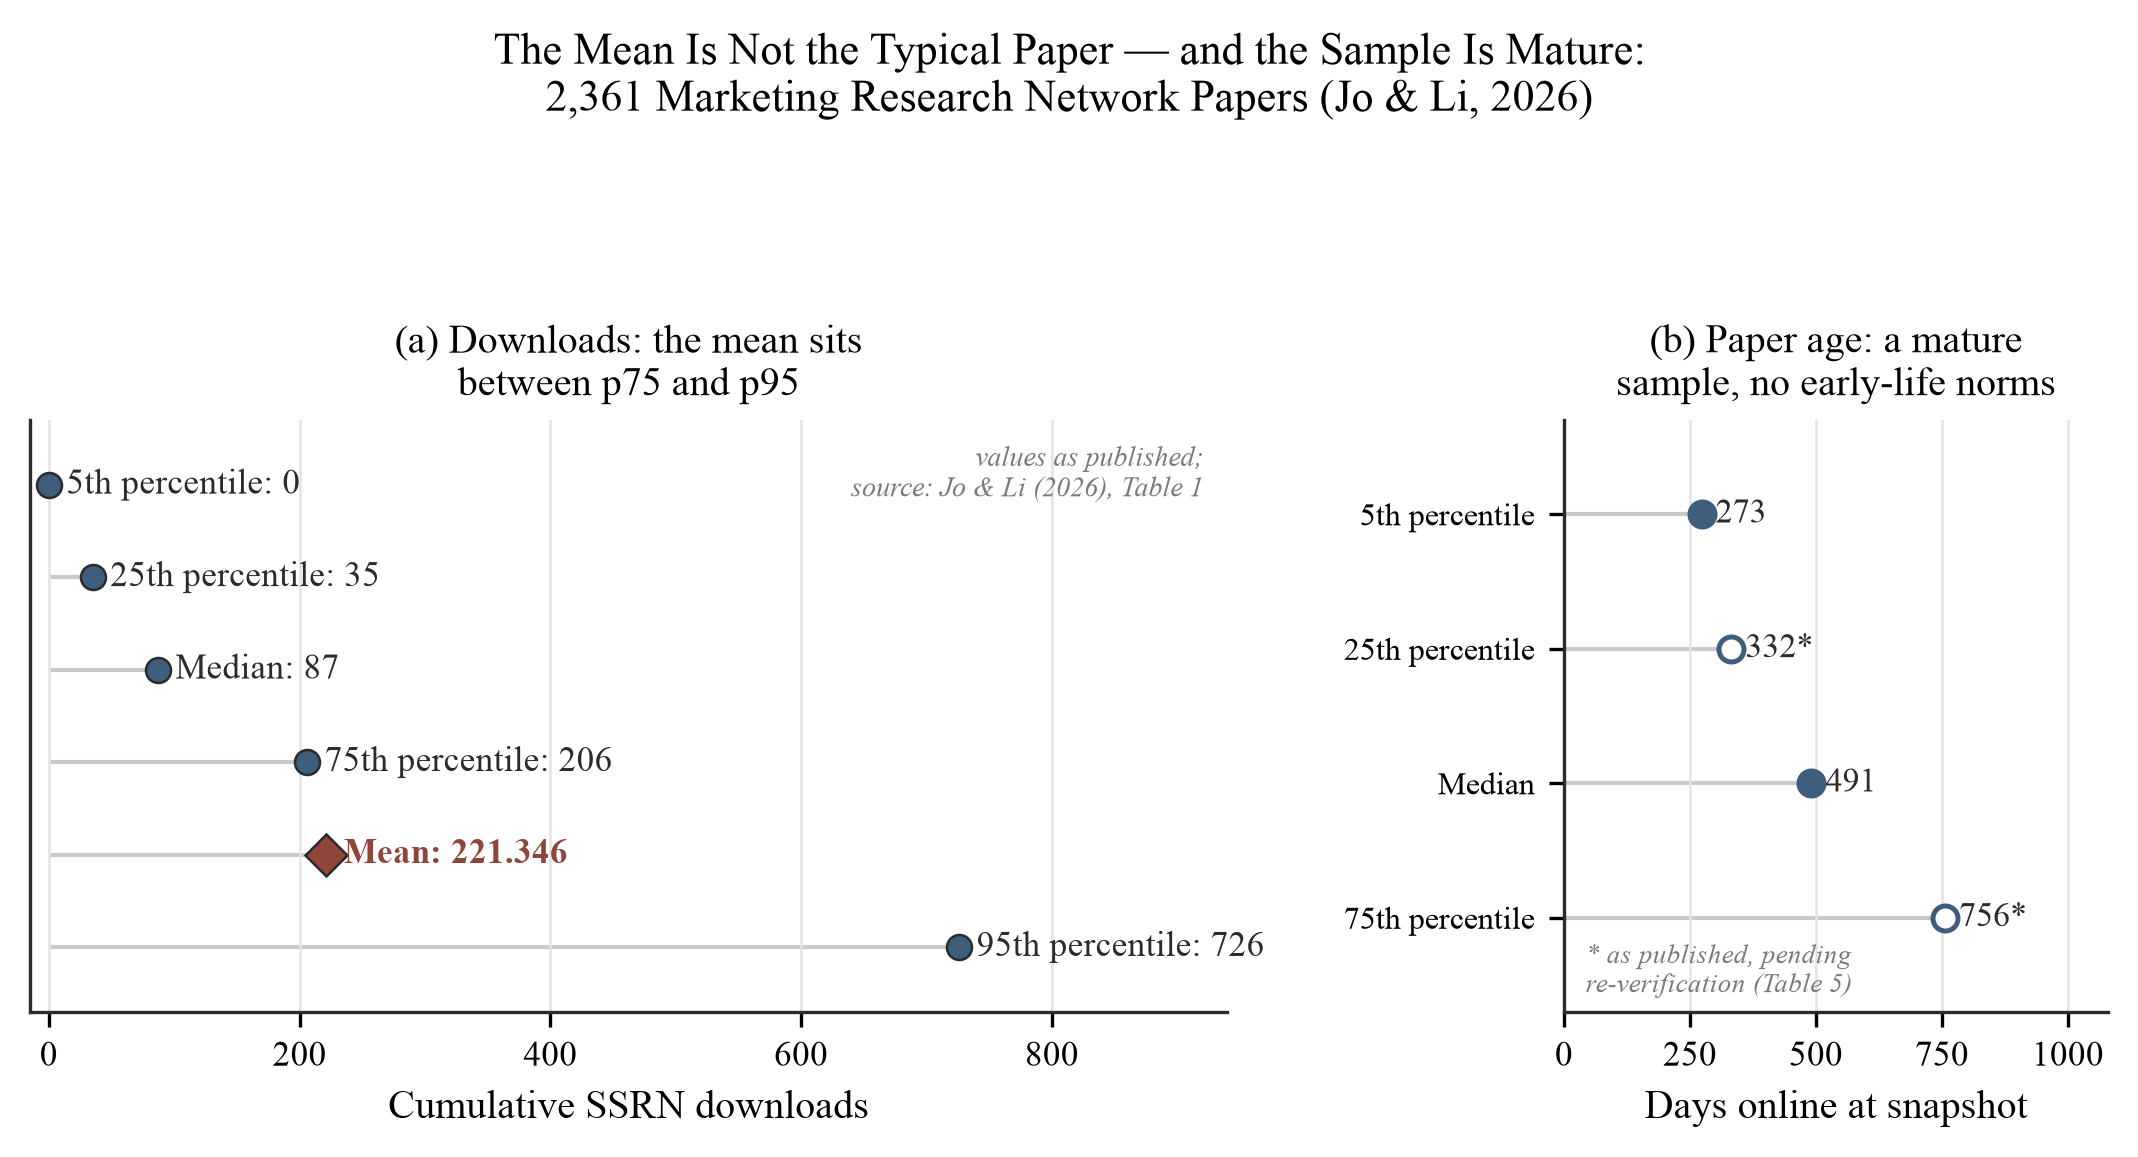
Figura 2. Estatísticas descritivas publicadas para 2.361 artigos da Rede de Pesquisa em Marketing. Painel (a): downloads — p5 = 0, p25 = 35, mediana = 87, p75 = 206, média = 221.346, p95 = 726, plotados em ordem de valor (observe que a média situa-se entre p75 e p95). Painel (b): idade do artigo na mesma amostra — percentil 5 273 dias e mediana 491 dias verificados contra a fonte; os percentis 25 (332 dias) e 75 (756 dias) reproduzidos "conforme publicado" (Tabela 5). Dois valores na Tabela 1 da fonte são sinalizados e reproduzidos "conforme publicado", mas são anomalias de tipos diferentes. O percentil 95 de visualizações de resumo (966) situa-se apenas cerca de 0,32 DP acima da média (611.973; DP 1.100,5) — praticamente impossível para uma contagem com assimetria positiva cujo p75 já é 833 — portanto é um provável erro de digitação na fonte, muito provavelmente um erro de datilografia, embora um erro de transcrição ou arredondamento não possa ser excluído, e as outras células da linha de visualizações de resumo são tratadas como potencialmente afetadas pelo mesmo erro correlacionado (sinalizado para uma consulta do autor a Jo e Li, cuja resposta ainda não está disponível). O percentil 95 de conversão (77,7, contra 27,2 em p75) é um fenômeno diferente: um artefato de razão com pequeno denominador exatamente do tipo que a Seção 5.2 prevê, não uma impossibilidade estatística. O painel de idade torna o limite interpretativo visível: estas são estatísticas de artigos maduros, e a amostra não pode fornecer normas de estágio inicial. Fonte: Jo e Li (2026), Tabela 1 [83].
A Tabela 5 reproduz as estatísticas descritivas completas do estudo, suas variáveis associadas, bem como a distribuição de downloads, porque esta é a única amostra SSRN publicada com um painel de percentis completo; várias de suas células realizam trabalho interpretativo em outras partes deste artigo. Os desvios padrão indicam a cauda pesada como um único número: um DP de 940,9 contra uma média de 221,3 para downloads. O percentil 5 de downloads é exatamente zero, então um contador zero situa-se dentro do intervalo normal até mesmo de uma amostra madura. Os percentis de conversão delimitam a banda entre estudos da Seção 5.2 de ambos os lados (p25 = 12,1, mediana = 18,9, p75 = 27,2 por 100 visualizações). Os percentis de idade (intervalo interquartil 332–756 dias) fixam a maturidade da amostra, e as linhas de autoria e embalagem fornecem as normas de covariáveis utilizadas nas Seções 6.4 e 8.3.
Tabela 5. Estatísticas descritivas completas publicadas da amostra Jo e Li (2026), "conforme publicado" (N = 2.361 artigos da Rede de Pesquisa em Marketing; snapshot de 15 de agosto de 2025). Todos os valores são reproduzidos da Tabela 1 da fonte [83]. O núcleo distribuicional — as médias, medianas e quartis de downloads e visualizações; a média e mediana de conversão; a mediana e percentil 5 de idade — foi verificado contra a tabela publicada (ver Tabela 7). As células restantes (os desvios padrão; os percentis de conversão e idade além do núcleo; as linhas de autores, páginas e comprimento do resumo) são reproduzidas "conforme publicado" e não foram re-derivadas independentemente aqui; a existência da fonte, local de publicação e autoria foram confirmadas via Crossref em 14 de agosto de 2026. Duas anomalias internas são mantidas "conforme publicado" e sinalizadas em vez de corrigidas, e não são do mesmo tipo de problema. O percentil 95 de visualizações de resumo (966) situa-se apenas cerca de 0,32 DP acima da média relatada (611.973; DP 1.100,5) — estatisticamente quase impossível para uma contagem tão enviesada e inconsistente com o p75 da linha de 833 — portanto é um provável erro de digitação na fonte; as células restantes de visualizações de resumo são sinalizadas como potencialmente afetadas por um erro correlacionado e rebaixadas para re-verificação na pendência de uma consulta do autor Jo e Li.
| Variável | Média | DP | p5 | p25 | Mediana | p75 | p95 |
|---|---|---|---|---|---|---|---|
| Downloads | 221.346 | 940.855 | 0 | 35 | 87 | 206 | 726 |
| Visualizações de resumo | 611.973 | 1.100,536 | 151 | 288 | 504 | 833 | 966 ("conforme publicado") |
| Downloads por 100 visualizações de resumo | 23.699 | 20.118 | 0 | 12.105 | 18.944 | 27.187 | 77.704 ("conforme publicado") |
| Disponibilidade no SSRN, dias | 550.210 | 230.557 | 273 | 332 | 491 | 756 | 955 |
| Número de autores | 2.578 | 1.705 | 1 | 1 | 2 | 3 | 5 |
| Número de páginas | 32.734 | 29.186 | 1 | 13 | 27 | 46 | 75 |
| Comprimento do resumo, palavras | 182.274 | 71.641 | 87 | 137 | 178 | 217 | 295 |
Três características adicionais do estudo importam para a interpretação. As visualizações de resumos mostram a mesma assimetria em um nível superior: as visualizações médias foram 611.973 contra uma mediana de 504 (p5 = 151, p25 = 288, p75 = 833; o p95 de 966 é reproduzido "conforme publicado", mas é presumivelmente um erro tipográfico de origem, apenas ≈0,32 SD acima da média e abaixo da cauda implicada por um p75 de 833, e não entra em nenhum cálculo subsequente; veja a nota da Figura 2), com uma conversão publicada de 23.699 downloads por 100 visualizações [83]. O estudo também separa alcance da conversão: no modelo de exposição de Poisson dos autores, o prestígio institucional predisse downloads, condicional às visualizações de resumos (coeficiente 0,192, e para um artigo de três autores, um autor com afiliação top-50 correspondeu a uma taxa de download estimada de 6,6% mais elevada por visualização de resumo), e esse prêmio de prestígio enfraqueceu conforme a assistência de IA em resumos aumentou (interação −0,627, p < 0,01) [83]. O SSRN agora requer divulgação do uso material de IA generativa na submissão [54][56]. Portanto, a atenção rastreia sinais de status mesmo após um leitor chegar à página do resumo, o que é evidência direta de que as contagens de download incorporam efeitos de visibilidade e reputação em vez de apenas avaliação de conteúdo. A limitação que os próprios autores apontam estabelece a agenda: um único instantâneo de uma única rede disciplinar não pode revelar caminhos temporais de atenção, e eles explicitamente identificam dados em painel como o próximo passo necessário [83], o passo abordado na Seção 8.
A amostra é uma rede em um campo, observada em uma data: esses valores não são benchmarks SSRN universais, e seu valor reside na estrutura. A proporção média/mediana de 2,54 e a proporção p95/mediana acima de 8 são assinaturas de assimetria à direita pesada que recorrem em todos os outros corpos de evidência SSRN, incluindo uma amostra de uma disciplina e década diferentes: na única amostra de tipo censo de bolsa jurídica, artigos postados na Legal Scholarship Network em 2012 e medidos dois anos depois (n = 1.107) tiveram uma mediana de 63 downloads contra uma média de 122,55, uma lacuna quase de duas vezes após apenas dois anos de exposição [139].
3.4 A Forma da Distribuição: Quase-Lognormalidade e a Cauda Longa
A anatomia em larga escala da distribuição foi estabelecida por Kakushadze, que analisou as listas públicas de topo do SSRN: 29.985 autores na lista dos Top 30.000 e os 367.478 artigos a eles anexados (uma raspagem de rankings de 2015) [85]. A constatação central é que os downloads seguem uma distribuição quase-lognormal, fortemente assimétrica com uma cauda superior longa em níveis e aproximadamente gaussiana no logaritmo (parâmetros ajustados para ln downloads por artigo: média 5,406, desvio padrão 1,016) [85]. Kakushadze extrai explicitamente o corolário prático da lognormalidade: a aritmética linear falha em tais dados. Uma aplicação direta do índice h para downloads é não informativa: as contagens de download são ordens de magnitude maiores que as contagens de citação, portanto o índice se reduz ao número de artigos. Ele propõe em vez disso um índice construído na parte inteira do logaritmo de downloads, k = ⌊ln D⌋ [85]. Para a interpretação, isso significa que as diferenças significativas nos downloads são multiplicativas, não aditivas. Esta forma não é peculiar aos downloads: a distribuição do impacto científico individual é em si aproximadamente lognormal, conforme o modelo Q de Sinatra, Wang, Deville, Song e Barabási (2016) estabeleceu em carreiras científicas [181], portanto a leitura multiplicativa que os contadores exigem é a norma para a atenção acadêmica, não um artefato do SSRN.
O mesmo conjunto de dados fornece os únicos limiares de ancoragem publicados para a distribuição superior. A entrada na lista dos Top 10.000 artigos (aproximadamente o top 1,8% do acervo de artigos em texto completo da plataforma, 571.040, julho de 2016 [1], consistente com e não acima dos números "top 1–2%" às vezes citados) exigia um mínimo de 160 downloads, com uma mediana de 805, uma média de 1.800 e um máximo de 152.242 [85]. Entre os autores do Top 30.000, os downloads totais mínimos foram 129, o total mediano de autores foi 1.626, a mediana de downloads por artigo foi 210 e o máximo, Michael C. Jensen, foi 824.762 [85]. A escassez persiste no nível do artigo mesmo dentro desta amostra de elite: dos 367.478 artigos analisados, apenas 112.793 (aproximadamente 30,7%) tinham downloads suficientes para contribuir ao índice logarítmico de seus autores [85]. A maioria dos artigos individuais dos autores mais baixados da plataforma atrai atenção modesta, e fora das listas de topo a proporção só pode ser menor. A Figura 3 visualiza a distribuição ajustada com os limiares publicados marcados.
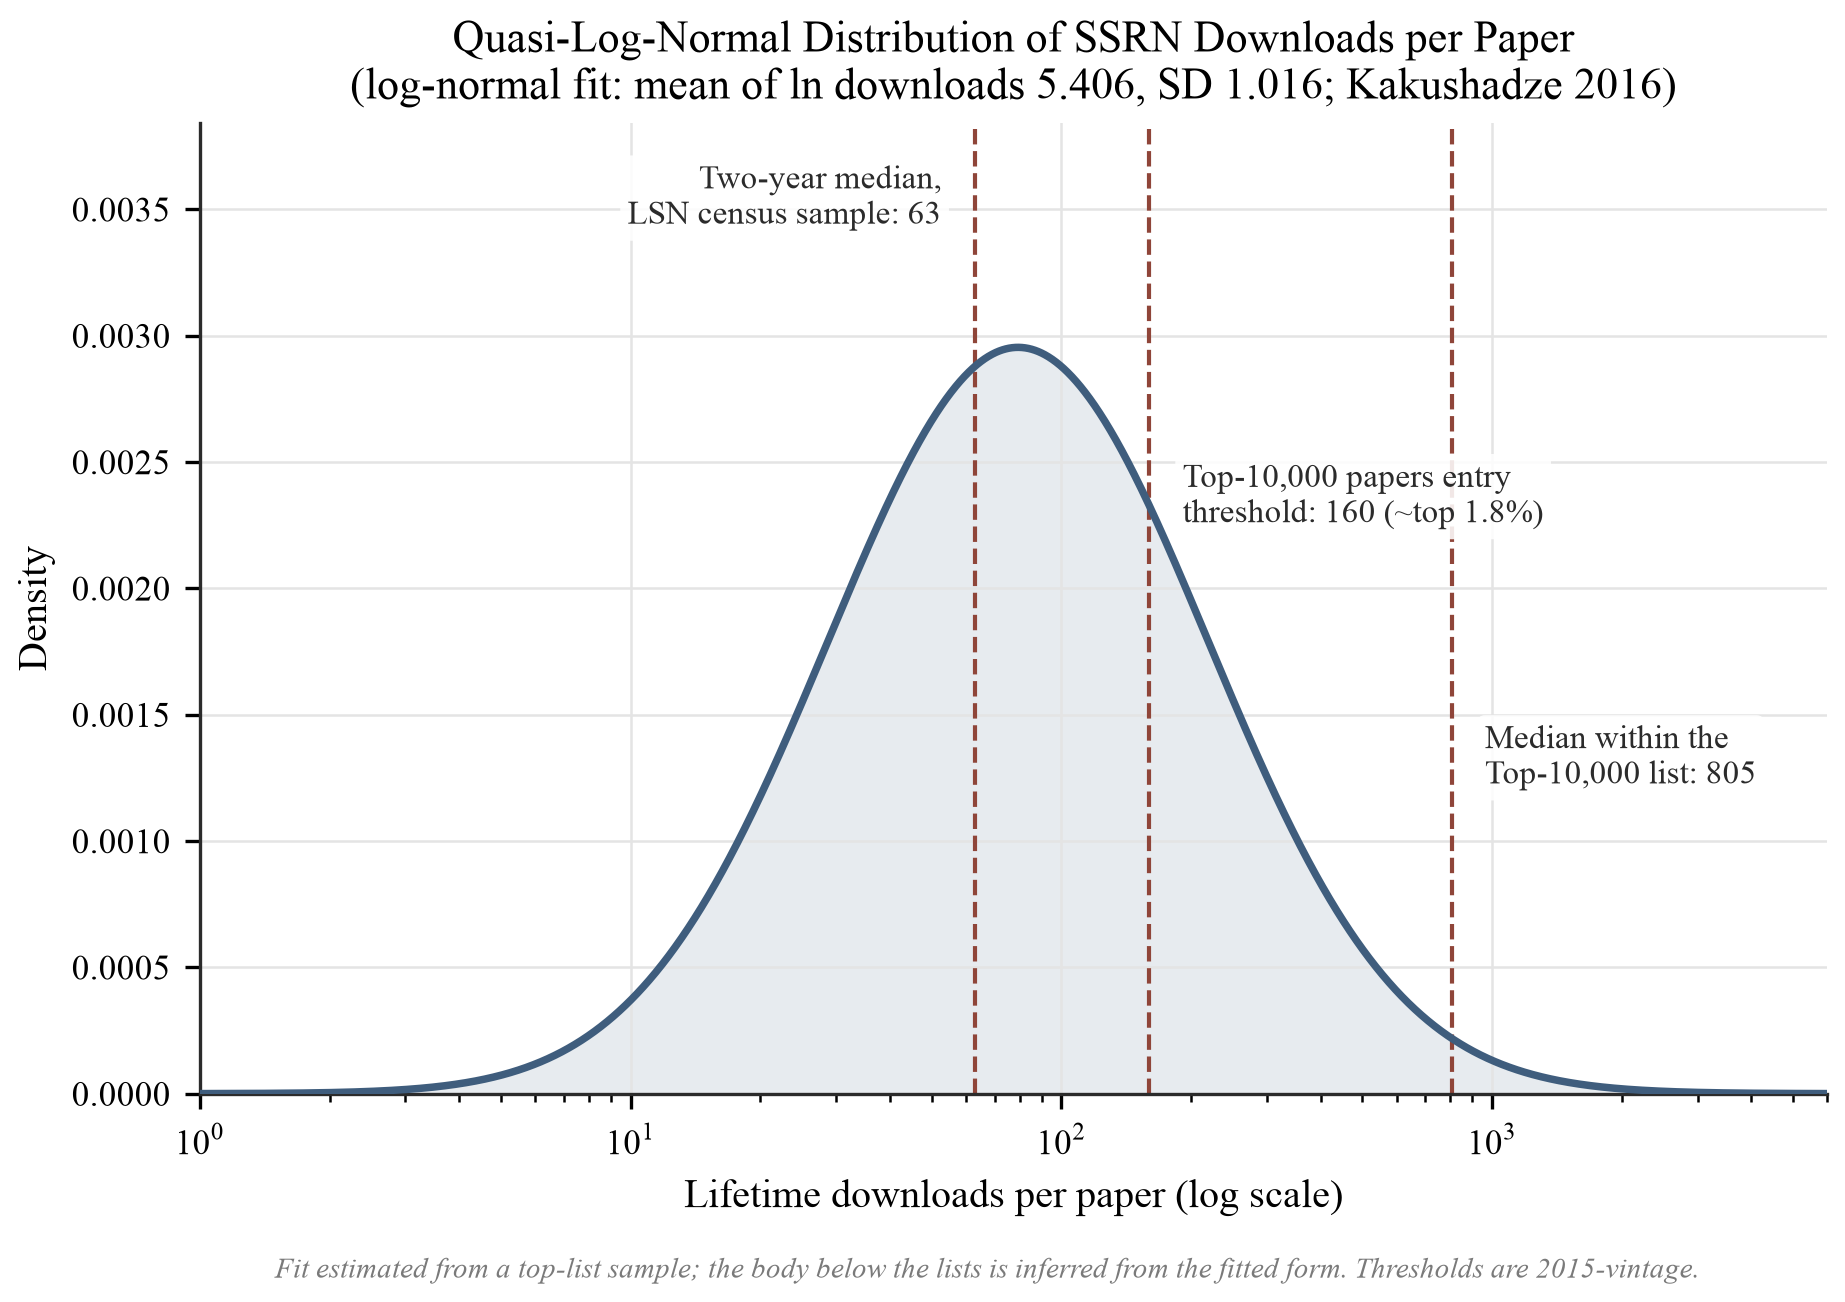
Figura 3. Densidade lognormal ajustada com os parâmetros relatados por Kakushadze (média de ln downloads 5,406, DP 1,016) [85]; a mediana ajustada, exp(5,406) ≈ 223, fica cerca de 6% acima da mediana por artigo dentro do grupo relatada de 210, um ajuste adequado mas imperfeito para a distribuição da lista de topo. Linhas tracejadas marcam a mediana de dois anos de 63 downloads da amostra de tipo censitário de bolsa jurídica [139], o limiar de entrada Top-10.000-artigos de 160 (aproximadamente o top 1,8% do acervo de artigos em texto completo da plataforma, 571.040 em julho de 2016 [1]), e a mediana dentro da lista Top 10.000 (805) [85]. O ajuste é estimado a partir de uma amostra de lista de topo — aproximadamente o decil superior de autores da plataforma — portanto o corpo da distribuição abaixo das listas é inferido da forma ajustada em vez de observado; os limiares são de 2015 (inflação desde então: Seção 5.1). Uma ressalva quantitativa é necessária para a figura porque a curva convida a leitura de sua cauda inferior: sob esta densidade ajustada as massas de cauda inferior implícitas são P(X ≤ 63) ≈ 10,7% e P(X ≤ 10) ≈ 0,1% — duas a três ordens de magnitude abaixo da participação de ≤10-download de 15–30% que o Estudo 1 (Seção 8.6) prediz para uma amostra de probabilidade de toda a plataforma. A divergência não é uma contradição mas uma medida direta do domínio do ajuste: uma densidade estimada no decil superior de autores não pode descrever a cauda inferior que nunca observou, portanto os marcadores de tipo censitário (mediana de dois anos de 63 de [139]; a entrada Top-10.000 de 160 e sua mediana de 805) são traçados como pontos de referência externos colocados sobre a curva ajustada, não como afirmações de que o ajuste as reproduz. A distância entre os marcadores e onde a curva ajustada coloca os mesmos valores é em si a evidência visual de que o corpo abaixo das listas não foi observado, e nenhuma participação de cauda inferior de toda a plataforma deve ser lida dessa curva.
Essas âncoras precisam de duas ressalvas. O quadro de amostragem é o topo da distribuição, portanto as estatísticas de Kakushadze descrevem a cauda, e a massa de artigos ordinários abaixo das listas é caracterizada apenas através da forma lognormal ajustada. A atribuição é a um único autor: o estudo é Kakushadze (2016), Journal of Informetrics [85]; uma citação incorreta recorrente adiciona um segundo autor e deve ser evitada.
Uma seção transversal arquivística independente relatada no Apêndice E observa o corpo da distribuição diretamente, em uma amostra aleatória multidisciplinar de 1.360 artigos cujos contadores anteriores à descontinuação são recuperados de arquivos públicos. Ela encontra a distribuição observada aproximadamente lognormal (assimetria de log-downloads ≈ 0,18), corroborando no corpo a forma que Kakushadze poderia ajustar apenas na cauda, e reproduz independentemente a lacuna média-mediana, a banda de conversão e o multiplicador de campo. Seu próprio viés de seleção ascendente deixa a cauda extremamente baixa sub-observada. Não obstante, reproduz a única âncora moderna de distribuição inteira na qual a síntese de outra forma se baseia: a média da reconstrução (219) coincide com a média da rede de marketing publicada de 221, portanto a forma principal também é corroborada por uma fonte de dados inteiramente separada. (Sobre recuperação de dados web históricos do Internet Archive como um método validado de ciência social, e sobre seus vieses de cobertura e frequência de rastreamento, ver Arora, Li, Youtie & Shapira, 2016, Journal of the Association for Information Science and Technology, 67(8), 1904–1915, doi:10.1002/asi.23503.)
3.5 Erro de Calibração pela Cauda Visível
A estrutura conjunta das Seções 3.2–3.4 explica um erro psicológico sistemático. O autor mais baixado no scrape de 2015 apresentava 824.762 downloads, aproximadamente 500 vezes a mediana do próprio grupo de autores principais (1.626), e quatro ordens de magnitude acima do artigo típico [85]. Sob uma lei quase-lognormal, as distâncias que importam são multiplicativas: o passo da mediana de artigos ordinários (dezenas de downloads) até o limiar de entrada da lista principal (160) é menor que o passo desse limiar até a mediana da lista principal (805), que por sua vez é ofuscado pela distância até o máximo da cauda [85][139]. Porém, os números que circulam publicamente (anúncios de marcos, perfis de "autor principal", comunicados de imprensa institucionais [101]) são extraídos quase exclusivamente da cauda visível. Os autores, portanto, calibram "bom" contra uma classe de referência localizada centenas de vezes acima da mediana, enquanto a massa da distribuição fica próxima à mediana. Uma leitura do painel de 7 downloads é então vivenciada como fracasso, mesmo quando é ordinária para a idade e o campo do artigo. A média participa do mesmo erro de forma mais branda: como a Seção 3.3 mostrou, ela fica acima do 75º percentil, então até a "média" que parece oficial é um benchmark contaminado pela cauda. Esse é o sentido em que a média mente: ela é calculada corretamente e depois confundida com um valor típico em uma distribuição que não tem valor típico.
Vários outros corpos de evidência reforçam a conclusão de que contadores brutos refletem a estrutura de visibilidade pelo menos tanto quanto o conteúdo. A atenção responde à posição: em listas de anúncios do arXiv, artigos aparecendo na posição 1 obtiveram aproximadamente 83% mais citações medianas em astro-ph, um efeito que os autores atribuem substancialmente à visibilidade em vez de auto-seleção sozinha [72]. Também responde ao atraso de indexação. O próprio SSRN observa que a indexação externa de seu conteúdo pelo Google Scholar é controlada pelos motores de busca e pode levar "6 a 9 meses ou mais" [54, acessado em 14 de agosto de 2026], portanto os contadores de um artigo jovem são gerados antes que um grande canal de descoberta tenha começado a funcionar. A atenção também flui para trás das citações para downloads: ser citado atrai leitores (entre eles os autores citados e suas próprias redes) para o artigo citador, e a análise de causalidade de Granger encontra esse caminho de citações para downloads ativo para uma parcela substancial de artigos [80][39], portanto parte de um contador reflete a posição de um artigo na rede de citação e colaboração em vez de qualquer veredicto do leitor sobre seu conteúdo. Cada um desses mecanismos molda o contador através da estrutura de visibilidade (posição, atraso de descoberta, localização na rede) em vez de através do julgamento de qualidade do leitor, e nenhum é visível no número do painel. A economia de atenção mais ampla mostra a mesma concentração de forma extrema: nas redes sociais, os coeficientes de Gini de atenção atingem 0,90–0,94, com o 1% superior das contas recebendo mais atenção que o 99% inferior combinado [180], um eco moderno do dito de Simon que uma riqueza de informação cria uma pobreza de atenção [141]. A atenção acadêmica no SSRN pertence, de forma mais branda, à mesma família de processos de difusão enviesada. O público mais à vontade no SSRN, economistas e estudiosos do direito, reconhecerá a estrutura das finanças. A análise de Bessembinder dos dados do CRSP para 1926–2016 descobriu que aproximadamente $34,8 trilhões de criação de riqueza do mercado de ações foi atribuível a menos de 4% das empresas listadas, a maioria das ações falhando em superar as Letras do Tesouro ao longo de suas vidas [16]. O paralelo é oferecido como uma ilustração, não uma prova: na riqueza como na atenção, os totais agregados são gerados por uma cauda extrema fina, e medir-se contra uma média dominada por gigantes é um erro de categoria. Nem a escassez fica confinada aos contadores de uso: na pesquisa jurídica em geral, 43% dos artigos em periódicos jurídicos em um censo de 2007 nunca foram citados, e apenas 18% da coorte de 2015–2019 atraiu uma única citação dentro de cinco anos [171].
3.6 O Multiplicador de Campo: Estrutura Disciplinar da Norma
A distribuição não é uma única distribuição: ela difere de campo para campo. A análise de Whalen de pouco menos de um quarto de milhão de artigos classificados nos 94 eJournals da Legal Scholarship Network mostra que a linha de base disciplinar varia por um fator de aproximadamente oito mesmo dentro de uma única disciplina guarda-chuva: os downloads médios por artigo ao longo da vida variaram de 438,35 em Corporate, Securities & Finance Law para 53,48 em Agricultural Law & Policy [168]. A Figura 4 exibe o gradiente.
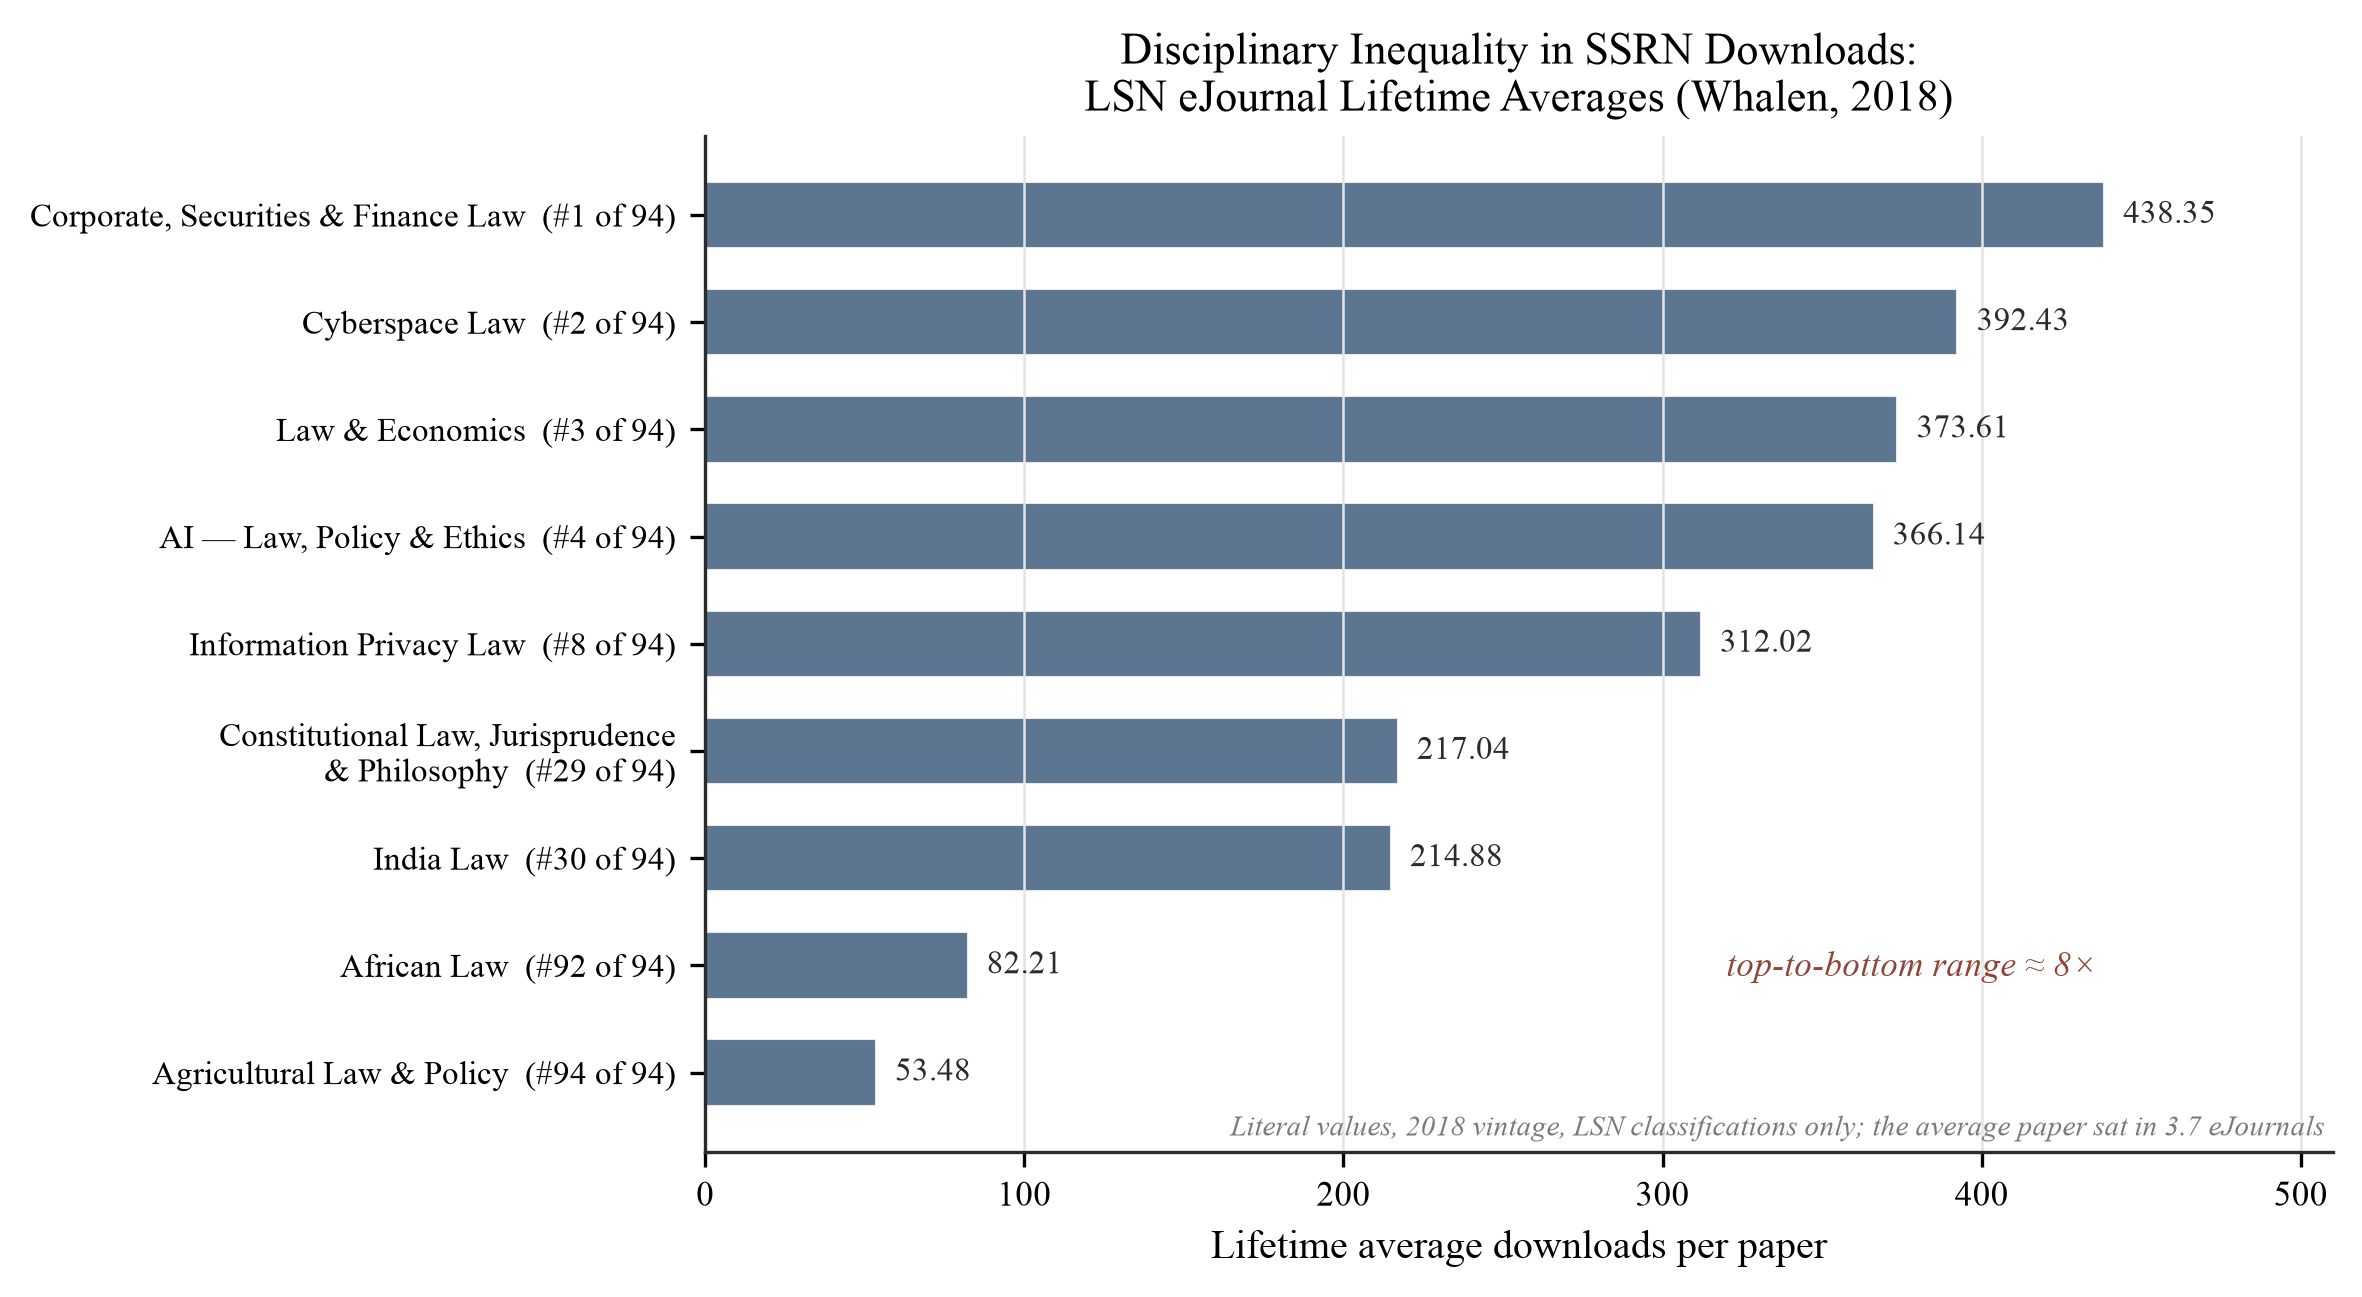
Figura 4. Downloads médios por artigo ao longo da vida para eJournals LSN selecionados, valores literais de Whalen (2018) [168]: Corporate, Securities & Finance Law 438,35 (classificação 1 de 94); Cyberspace Law 392,43 (2); Law & Economics 373,61 (3); AI – Law, Policy & Ethics 366,14 (4); Information Privacy Law 312,02 (8); Constitutional Law, Jurisprudence & Philosophy 217,04 (29); India Law 214,88 (30); African Law 82,21 (92); Agricultural Law & Policy 53,48 (94). O intervalo de topo a base é aproximadamente oito vezes maior. Os valores são de 2018 e cobrem apenas classificações LSN; o artigo médio foi atribuído a 3,7 eJournals.
O mecanismo é estrutural em vez de meritocrático: a descoberta do SSRN é baseada em classificação (os inscritos em um eJournal recebem alertas para artigos classificados nele), portanto, o público endereçável de um artigo é fixado pela base de assinantes de seu campo antes de qualquer sinal de qualidade operar. Whalen descobriu adicionalmente que artigos com mais classificações geram mais downloads e têm menor probabilidade de registrar zero downloads [168]. A estrutura do campo também molda os contadores por meio da cultura de citação: Black e Caron observaram que as razões downloads-para-citações diferem sistematicamente entre campos porque a pesquisa jurídica cita trabalhos anteriores de forma mais completa do que a economia ou finanças [18], e dentro do direito, a atenção se concentra em tópicos particulares e características do autor: na amostra do censo de 2012, tópicos de direito corporativo e internacional, autoria dos EUA e afiliação de topo 20 todos previram contagens significativamente maiores [139], determinantes ecoados em comentários contemporâneos de bibliotecas de direito [175]. Portanto, um número que é sem destaque em direito corporativo pode ser excepcional em história do direito ou direito agrícola, e qualquer benchmark ou escala (incluindo aquele construído na Seção 5) deve ser lido como relativo ao campo. Existe um precedente bem estabelecido para isto no lado da citação: Radicchi, Fortunato e Castellano (2008) mostraram que as distribuições de citações desabam em uma única curva universal apenas após a contagem de cada artigo ser redimensionada pela média de seu campo [182], o análogo da classe de referência que este artigo argumenta que as contagens de uso igualmente requerem.
Três exemplos, construídos inteiramente nas âncoras verificadas acima, tornam os riscos concretos. Uma autora em direito agrícola cujo artigo tem 60 downloads ao longo da vida está acima da média de seu eJournal de 53,48 [168], mas, calibrando contra as contagens de direito corporativo que circulam mais visivelmente, pode ler o mesmo número como fracasso. Uma autora em direito corporativo e de valores mobiliários com o mesmo 60 está muito abaixo da média desse campo de 438,35 [168]. E uma autora cujo artigo de marketing atinge a mediana de rede de 87 [83] pode subestimar um resultado que é, por construção, típico. O erro da escala ausente funciona em ambas as direções: produz desespero infundado e deixa o sucesso não reconhecido.
As Seções 3.2–3.6 estabelecem o núcleo empírico deste artigo. A distribuição de downloads do SSRN é fortemente assimétrica à direita e aproximadamente log-normal, e a média excede não apenas a mediana, mas o 75º percentil. A cauda visível se estende a 500 vezes as medianas de elite e contamina a calibração informal; os contadores incorporam efeitos de prestígio, posição, indexação e estrutura de campo que operam independentemente do conteúdo; e a linha de base disciplinar varia oito vezes dentro de um único domínio acadêmico. Uma contagem bruta de downloads lida contra a média, ou contra a cauda, é portanto ininterpretável por construção. Uma leitura defensável requer uma classe de referência: uma distribuição condicionada a campo, idade do artigo e coorte. Os Rankings, apesar de todos os seus defeitos, foram o único gesto público da plataforma em direção a tal classe de referência, e sua remoção torna a construção de uma externa (o mapa de benchmark e escala de interpretação da Seção 5) a tarefa central do restante deste artigo.
4. A Mecânica dos Contadores: Um Contador sob uma Regra
Antes que qualquer número em um painel do SSRN possa ser interpretado, é necessário estabelecer o que esse número realmente registra. O SSRN exibe duas métricas primárias de uso em nível de artigo, visualizações de resumo e downloads, junto com estatísticas de citação e indicadores PlumX [50]. Após a aposentadoria do Rankings em 15 de julho de 2026, esses contadores permaneceram em vigor: o SSRN declarou que "contagens de download e estatísticas de citação continuarão sendo registradas e exibidas em seus artigos individuais e perfil de autor" [149]. A escala comparativa desapareceu, mas os dados permaneceram. Os contadores que permanecem, no entanto, não são observações brutas da leitura humana: eles são o produto conjunto da arquitetura da plataforma, maquinaria de distribuição, tráfego não-humano e filtragem de integridade. Cada uma dessas camadas é analisada abaixo, e a Seção 5 então constrói um arcabouço de interpretação com base nelas.
4.1 O que é uma visualização e um registro de download, e o que não são
Uma visualização de resumo registra uma solicitação para a página de destino de um artigo. Um download registra a recuperação do PDF do texto completo. Ambos são eventos de engajamento; nenhum é evidência direta de leitura, compreensão, endosso ou aprovação científica. Essa distinção delimita cada afirmação feita no restante deste artigo.
Os contadores públicos do SSRN não são simples registros de solicitações HTTP. A plataforma operou filtragem de integridade de dados desde seus primeiros anos [69] e descreveu sua abordagem publicamente: downloads automatizados, downloads repetidos de si próprio, e tentativas de manipular contagens são avaliados usando "indicadores de atividade irregular," e downloads suspeitos (incluindo, em algumas circunstâncias, downloads anônimos) são excluídos dos totais apresentados ao autor [144]. Observadores independentes documentaram o mesmo comportamento anteriormente: downloads repetidos de um único endereço IP não são contabilizados no contador [66]. O contador de download é, portanto, uma estatística curada, materialmente mais robusta do que um log bruto de servidor. A filtragem remove a atividade não-humana e manipulativa mais detectável e nada mais. Um contador é sempre um contador sob uma regra e não uma unidade natural, e as regras mudam (Seção 4.3).
4.2 Tráfego não-humano e a assimetria entre visualizações e downloads
Agentes automatizados representam mais da metade de todo o tráfego da internet em medições recentes da indústria [158]. Essa cifra não pode ser transferida para os contadores do SSRN: nenhuma medição publicada da participação de bots nas visualizações de resumos ou downloads do SSRN foi identificada, e qualquer percentual específico afirmado para o SSRN seria infundado. O que pode ser estabelecido é a estrutura do problema, abordado de duas direções: os mecanismos que plausivelmente inflacionam as visualizações, e o registro de filtragem transparente de uma plataforma vizinha.
Vários mecanismos plausivelmente geram visualizações não-humanas de resumos. Rastreadores de mecanismos de busca rotineiramente indexam páginas de resumos recém-publicadas. Sistemas institucionais de segurança de email, mais proeminentemente Safe Links no Microsoft Defender for Office 365, digitalizam e fazem pré-busca de URLs contidas em mensagens de entrada, que podem registrar solicitações do lado do servidor antes que qualquer destinatário humano abra a mensagem [106]. Como o principal canal de distribuição do SSRN é email (Seção 4.4), a varredura de links de emails de anúncio é uma fonte estruturalmente plausível de visualizações fantasma. Nenhum estudo publicado mede a contribuição da pré-busca de proxy de segurança aos contadores de visualizações do SSRN, e o próprio SSRN audita suas métricas e exclui atividades irregulares das contagens de downloads [144][66][69], portanto a plataforma muito bem pode estar filtrando uma parcela substancial de tal tráfego, particularmente no lado dos downloads. A afirmação de que "a maioria das visualizações do SSRN não são humanas" aparece em discussão informal, mas nunca foi medida.
O caso transparente é RePEc. Seu serviço de registro, LogEc, publica tanto sua metodologia de filtragem quanto seu histórico de filtragem, e o registro demonstra quão severa e quão assimétrica a contaminação não-humana pode ser. Já em julho de 2007, robôs representavam aproximadamente 74% das visualizações de resumos em serviços RePEc monitorados, mas apenas cerca de 7% dos downloads [99]. O histórico de filtros lê-se como uma cronologia de uma corrida armamentista: heurísticas contra scanners de links anti-malware foram adicionadas em julho de 2010; um novo tipo de download em massa sistemático foi abordado em janeiro de 2017; filtros de mitigação de DDoS introduzidos em janeiro de 2022 removeram 54% das visualizações de resumos, mas apenas 7% dos downloads [99]. A partir de outubro de 2025, RePEc documentou um aumento de tráfego de bot movido a IA-bot mascarando-se como usuários humanos [129]. Em setembro de 2025, mais de 99,5% do tráfego bruto para IDEAS foi descartado como não-humano [129]. Após limpeza, o relatório RePEc para junho de 2026 contabilizou na ordem de 2,36 milhões de visualizações de resumos e 238 mil downloads em seus serviços [129].
A evidência de RePEc sustenta duas inferências para SSRN. A contaminação é assimétrica por construção: agentes automatizados rastreiam páginas de resumos HTML muito mais agressivamente do que executam recuperações de PDF em texto completo, portanto contadores de visualizações inflacionam muito mais do que contadores de downloads onde a filtragem é imperfeita. Essa assimetria, robôs em ~74% de visualizações, mas ~7% de downloads na medição de 2007 [99], é uma propriedade arquitetônica do tráfego de repositório e não uma peculiaridade de RePEc. As proporções específicas não são transferíveis: as regras de filtragem, modelo de distribuição e público do SSRN diferem, e SSRN não publica um registro de filtragem equivalente. A Seção 5.2 desenvolve a consequência prática, que é que as razões construídas sobre visualizações (como a taxa de conversão) devem ser lidas como limites inferiores na qualidade do engajamento humano, porque o denominador é a quantidade mais contaminada. Essa direção de limite inferior é dependente de período em vez de uma lei: mantém-se enquanto a filtragem do lado das visualizações fica atrás da filtragem do lado dos downloads, que é o regime documentado historicamente [99], mas enfraqueceria ou inverteria se os filtros de visualizações de uma plataforma alcançassem seus filtros de downloads, ou se a contaminação do lado dos downloads aumentasse mais rápido do que a do lado das visualizações (como o episódio de IA-bot de 2025–2026 aumentou ambas [129]). A direção deve ser reverificada sempre que uma plataforma revisa suas regras de contagem.
Uma consideração adicional emergiu desde que esses regimes de filtragem foram projetados. Os filtros foram construídos para remover solicitações automatizadas de uma contagem destinada a servir como proxy de atenção humana, e essa regra ainda remove ruído. O que ela já não pode fazer sem exame é tratar o restante como humano, porque três classes de solicitação automatizada agora estão onde o filtro via uma: rastreamentos que colhem texto para treinamento de modelo, rastreadores que indexam para um serviço de busca ou resposta, e buscas que um sistema faz em tempo real em nome de uma pessoa que pediu algo. Os primeiros dois permanecem ruído para uma contagem de atenção. O terceiro é um ato delegado com um humano por trás dele, já que um sistema que recupera o texto completo de um artigo para responder à pergunta de um usuário ou apoiar uma busca de literatura recebeu o conteúdo e o utilizou, embora nenhuma pessoa tenha carregado a página. Uma solicitação automatizada não é por si só evidência de que algo foi lido. O proxy enfraqueceu, não o filtro: humano contra máquina não rastreia mais com confiabilidade a distinção que este artigo precisa, que é se um evento é evidência de atenção acadêmica, humana ou delegada.
O Projeto COUNTER começou a abordar isso em seu vocabulário de relatório em vez de em seu filtro. Orientação de boas práticas sobre uso de IA, emitida em abril de 2026 e atualizada em 30 de junho de 2026 para Release 5.1.1, disponibiliza um Access_Method opcional de Agent, definido como conteúdo e metadados acessados por um sistema de IA, juntamente com tipos de métrica específicos para IA, enquanto Release 5.1.1 continua exigindo que "atividade gerada por bots e rastreadores tradicionais DEVE ser excluída de todos os relatórios COUNTER" [125]. O instrumento tem três limites que importam aqui. É uma extensão opcional, produzida apenas em relatórios que um provedor elege gerar e direcionada primeiro a sistemas de IA incorporados na própria plataforma de um provedor em vez de em rastreadores de entrada. Seus elementos "NÃO DEVEM ser incluídos em nenhuma Visualização Padrão dos Relatórios COUNTER" [125], portanto uma visualização padrão não distinguirá acesso de agente mesmo onde um provedor implementa a orientação. Se eventos de agente marcados são então removidos dos totais padrão ou carregados neles sem rótulo é uma questão de implementação sobre a qual a orientação é silenciosa. Ele também classifica acesso que foi servido e não acesso que foi recusado: a orientação afirma que "não há métricas de negação associadas especificamente com Access_Method Agent" [125]. Nada disso chega a um contador público nu em qualquer caso, já que tal contador não é um relatório COUNTER e não carrega método de acesso; o padrão é um análogo contra o qual pode ser julgado, não uma descrição dele.
A recusa também não é hipotética, e funciona a montante de qualquer regra de contagem, mas seus instrumentos diferem em natureza e não atuam como um. O robots.txt de uma plataforma solicita a agentes nomeados que não rastreiem; uma reserva de mineração de texto e dados afirma uma posição legal; os termos de uso vinculam-se contratualmente; um serviço de desafio nega a página para clientes que não conseguem completá-lo. Apenas o último desses é aplicação. Na plataforma estudada aqui, conforme recuperado em 29 August 2026, robots.txt nomeou três agentes (GPTBot, ChatGPT-User e Google-Extended) e silenciou quanto aos outros, sendo o silêncio o padrão do Robots Exclusion que rastreadores bem-comportados leem como permissão; as respostas carregavam uma reserva de mineração apontando para a política do editor, que permite mineração para fins que se enquadram no Artigo 3 da EU Digital Single Market Directive e requer uma licença caso contrário; os termos de uso reservam direitos sobre mineração de texto e dados e treinamento de IA, exceto quando um autor escolheu uma licença aberta, opção disponível apenas desde 20 July 2026 e assumindo todos os direitos reservados por padrão; e uma única solicitação não autenticada feita sem um mecanismo JavaScript recebeu um desafio gerenciado pela Cloudflare em vez da página. Um dos agentes nomeados é o buscador acionado pelo usuário e não um rastreador de treinamento: essa é a classe delegada do parágrafo anterior. Esses materiais registram restrições publicadas e uma observação de configuração. Eles não estabelecem quantas solicitações, automatizadas ou humanas, foram recusadas. As diretivas são honradas desigualmente: em uma medição em larga escala do comportamento do rastreador, alguns agentes respeitaram completamente os disallows de site inteiro enquanto honravam os disallows de nível de caminho menos de um terço do tempo, e outros ignoraram o arquivo completamente [87]. Nem os efeitos colaterais são unidirecionais, uma vez que implantações de desafio interromperam usuários humanos legítimos em outros lugares (uma biblioteca universitária registrou dois desses incidentes nos primeiros quatro meses de uso [29]).
A assimetria histórica, portanto, não pode simplesmente ser mantida. O conforto da descoberta de 2007, robôs em aproximadamente 74% das visualizações de resumo, mas cerca de 7% dos downloads [99], descansava em rastreadores que navegavam em páginas de destino e raramente obtinham texto completo. Um sistema que recupera documentos para fundamentar uma resposta não tem razão para parar no resumo, portanto o lado do download não é mais conhecido por ser a contagem mais limpa por construção. Quando o tráfego acadêmico bruto foi medido em 2025–26, a participação automatizada não foi marginal e foi encontrada dentro das contagens de download e visitas em vez de apenas em visualizações de página: uma coleção de patrimônio cultural revisou uma contagem de visitas de March 2025 de 1,000,000 para 125,000 depois que o tráfego de bot suspeito foi removido [167]; uma classificação de fornecedor de aproximadamente trinta milhões de solicitações de acesso em um repositório institucional rotulou apenas cerca de um quarto delas como humanas [98]; e um repositório respondendo a uma pesquisa de repositórios abertos atribuiu pelo menos um quarto de seus próprios downloads de bot, aproximadamente meio milhão de solicitações, a onze agentes de IA nomeados [135]. Nenhuma dessas figuras é uma medição da plataforma estudada aqui: elas são extraídas de diferentes plataformas com diferentes defesas, em vários casos ausentes, e dois dos três contam visitas ou solicitações em vez dos eventos de download que um contador público exibe. Eles estabelecem a condição anterior em vez de uma magnitude. No ambiente atual, a interpretabilidade de qualquer contagem de uso é uma função da qualidade do filtro, e quando uma plataforma não publica sua filtragem, essa qualidade não é auditada.
Dois problemas de identificação seguem, e eles se acumulam. Composição primeiro: de um contador público de vida inteira sozinho, as participações de eventos humanos, automatizados convencionais e mediados por agentes não são estimáveis, e a própria visão da plataforma pode não ser melhor, uma vez que clientes automatizados foram observados se apresentando como navegadores de desktop [167]. Na seleção, um contador não pode revelar qual parte do acesso tentado foi servida, desafiada ou excluída antes de qualquer regra de contagem ser aplicada. As políticas publicadas divulgam que tais mecanismos existem. Elas não divulgam com que frequência operam, como operaram no passado ou seu efeito na inclusão. Solicitações tentadas, solicitações desafiadas, eventos de texto completo servidos, downloads exibidos e respostas geradas a partir de um artigo recuperado são, portanto, cinco populações diferentes, e não devem ser tratadas como intercambiáveis. O que permanece não licenciado é uma magnitude ou um sinal líquido para esta plataforma. O uso acadêmico não filtrado agora é conhecido por ser inflável pelo tráfego automatizado, downloads incluídos, mas se os filtros não publicados desta plataforma, as regras de desafio e as políticas de rastreador deixam um resto mais ponderado em termos humanos, uma lacuna na descoberta mediada por agentes, ambos ou nenhum, não é medido. Nem a mistura é estável ao longo dos anos que um total de vida inteira abrange, que vai de um regime de robô pré-2024 através do aumento de extração de 2025–26 para um padrão de licença introduzido em July 2026. As consequências a jusante da questão são documentadas: sites bloqueando um rastreador de IA importante são recuperados significativamente menos frequentemente por motores de resposta de IA mesmo onde o conteúdo permanece acessível [70]. Nenhuma estimativa publicada da participação do agente existe para nenhum servidor de pré-impressão importante, uma lacuna de pesquisa em vez de evidência de um pequeno efeito, e a auditoria especificada na Seção 8 é projetada para medi-lo. Um total de vida pública é uma soma sobre uma mistura desconhecida, extraída de uma participação desconhecida do acesso tentado, sem estimador externo de nenhum dos dois e nenhuma base para tratar nenhum dos dois como estacionário.
4.3 Contadores decrescentes como eventos de medição
Contadores também podem cair ou ser reafirmados quando as regras de filtragem mudam, uma consequência adicional do registro de filtragem que nenhum painel explica. A revisão de filtro de janeiro de 2022 do RePEc removeu metade das visualizações abstratas anteriormente contadas em uma única etapa [99]. Seu episódio de bot de IA de 2025–2026 forçou mudanças metodológicas adicionais [129]. As estatísticas de download relatadas pelo fornecedor são, de forma mais geral, conhecidas por serem sensíveis a convenções de contagem: uma auditoria do lado da biblioteca descobriu que os relatórios de download de um grande editor eram aproximadamente duas vezes mais altos do que em plataformas comparáveis, com contagens "deflacionadas" em 43% da figura relatada [176]. Uma queda repentina nos contadores SSRN de um autor é, portanto, tão provável de ser um evento de medição, uma alteração de filtragem ou reafirmação no lado da plataforma, quanto um evento de leitura, e nunca deve ser lida como perda reputacional sem corroboração. O mesmo raciocínio governa qualquer uso de métricas em dossiê, onde registros datados devem ser preservados (um protocolo desenvolvido na Seção 6). Os números da plataforma podem ser revisados, e o arquivo datado do autor não pode ser revisado.
4.4 Empurramento versus puxamento: arquitetura molda a proporção
Arquitetura de distribuição é a última camada mecânica. Difere qualitativamente entre os principais repositórios e molda diretamente a relação entre visualizações e downloads. SSRN opera predominantemente em um modelo de empurramento. Na submissão, autores selecionam entre uma e sete classificações de assunto (o artigo LSN médio tinha 3,7 atribuições de eJournal [168]), e estas determinam a colocação em redes de pesquisa e elegibilidade para alertas de email de eJournal específicos de tópico. A inclusão em um alerta é "curada e direcionada, não garantida," e a distribuição em tópicos de alto volume pode levar até 45 dias [53]. Os assinantes recebem anúncios em nível de resumo por email [57]. Cada destinatário que clica em um anúncio, seja por interesse focado ou leve curiosidade, registra uma visualização de resumo. arXiv, em contraste, opera predominantemente como uma plataforma de puxamento: um repositório sem fins lucrativos cuja tráfego é impulsionado por pesquisadores visitando ativamente listagens e feeds [11][65], onde até mesmo a posição em uma lista de anúncios diária afeta mensuravelmente a leitura e as citações [72]. RePEc agrega metadados de arquivos descentralizados e aplica a filtragem pesada documentada descrita acima [99][129].
A Tabela 6 resume a comparação entre plataformas como um esquema qualitativo de governança e mecânica de descoberta. Dados comparáveis de tráfego entre plataformas não existem no registro publicado.
Tabela 6. Arquiteturas de plataforma e seu efeito mecânico em métricas de uso (esquema qualitativo).
| Recurso | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| Governança | Comercial (Elsevier, desde maio de 2016) [46] | Sem fins lucrativos (Universidade de Cornell) [11] | Rede voluntária descentralizada [99] |
| Canal de descoberta primária | Empurramento: alertas de email eJournal curados orientados por classificações selecionadas pelo autor (1–7; distribuição de até 45 dias em tópicos de alto volume) [53][57] | Puxamento: visitas orientadas por intenção a listagens e feeds; efeitos posicionais em anúncios documentados [11][72] | Agregação de arquivos distribuídos; descoberta via IDEAS/EconPapers [99] |
| Transparência de filtragem | Política descrita qualitativamente; nenhum registro de filtragem público [144] | Não publicado centralmente para métricas de uso | Metodologia totalmente documentada e histórico de revisão (LogEc) [99][129] |
| Efeito mecânico esperado na razão de visualizações : downloads | Visualizações elevadas relativas aos downloads: cliques por email registram visualizações de exposição de baixa intenção | Conversão mais alta de visitas em downloads: o tráfego é orientado por intenção | Razão significativa apenas após corte pesado de bots; contagens publicadas são pós-filtro [129] |
A arquitetura afeta a psicologia do autor, pois uma alta proporção de visualizações para downloads no SSRN é em grande parte um resultado de design: o modelo de empurramento gera exposição ampla de baixa intenção. A leitura superficial de resumos também é comportamento acadêmico legítimo (pesquisadores monitoram rotineiramente campos através de resumos sem baixar textos completos), então uma visualização que não se converte pode significar que o resumo já entregou sua carga informacional em vez de repelir o leitor. A regra prática histórica do próprio SSRN, relatada por Black e Caron, era que aproximadamente "três visualizações de resumo … resultam em um download real de artigo" [18]. Os mesmos autores observaram que sem filtros de integridade, os contadores brutos seriam inflacionados "por um fator de cinco ou mais" [18]. A Seção 5.2 coloca esses pontos de referência antigos ao lado de medições modernas.
Duas características mecânicas de como um artigo é apresentado governam a conversão juntamente com o interesse do leitor, o que torna a taxa de conversão medida em parte uma propriedade da interface em vez da pesquisa. Uma é a interface do usuário da plataforma. Se o texto completo é oferecido como uma renderização HTML inline no navegador ou apenas como um PDF para download, isso muda materialmente se um leitor interessado jamais aciona o contador de downloads, pois um leitor que consome o texto completo no navegador satisfaz a mesma intenção ao incrementar apenas visualizações. A outra é a composição do dispositivo do público. O acesso móvel reduz a recuperação de PDF de texto completo em relação ao desktop, então um artigo cujos leitores chegam predominantemente em telefones (de um link de mídia social ou de um cliente de email móvel) registrará downloads sistematicamente mais baixos e visualizações comparativamente mais altas para o mesmo interesse acadêmico. Ambos os efeitos atuam na mesma direção da inflação mecânica do denominador já estabelecida acima, e ambos são razões adicionais para ler a banda empírica da Seção 5.2 como um intervalo condicional de plataforma em vez de um limiar fixo: uma norma de conversão estimada na interface e na mistura de dispositivos de uma plataforma deve ser recalibrada em vez de transplantada quando qualquer um deles muda. A literatura de métricas de uso levanta a mesma cautela de confiabilidade sobre a comparabilidade de relatórios de download entre plataformas e convenções de contagem [176].
4.5 Efeitos colaterais previsíveis: auto-correspondências de similaridade e higiene de metadados
Duas consequências mecânicas adicionais da disponibilização de pré-prints são previsíveis, e ambas rotineiramente geram alarmes desnecessários, portanto ambas fazem parte do resto do mecanismo.
A auto-correspondência de similaridade. Quando um artigo de trabalho disponibilizado em SSRN é posteriormente submetido a um periódico, a triagem de similaridade do periódico sinalizará, no caso esperado, uma correspondência quase total com o pré-print do próprio autor. A documentação do iThenticate afirma explicitamente ambas as metades da interpretação: o software "não verifica plágio; ele verifica similaridade" e "se você vê uma correspondência de pré-print para o mesmo autor, isso não é plágio" [81]. O mecanismo também é documentado. Pré-prints registrados como Crossref Posted Content são incluídos nos bancos de dados para verificação de similaridade, portanto uma correspondência contra o próprio pré-print depositado é o sistema funcionando como projetado [36]. Correspondências podem surgir mesmo quando editores excluem fontes de pré-print, porque agregadores secundários que duplicam metadados de repositório também são rastreados [81]. A resposta do autor deve ser administrativa em vez de defensiva: identificar a fonte sinalizada para o editor responsável como o próprio pré-print datado do autor. A orientação do Crossref e iThenticate aconselha revisão editorial qualitativa em vez de limites mecânicos de pontuação de similaridade [36][81]. Nenhum limite numérico é especificado aqui, pois nenhum é endossado pelos próprios serviços de triagem. A compostura que este conselho pressupõe tem uma base documentada na política do editor: postar um artigo de trabalho em um servidor de pré-print é permitido pelas políticas de publicação anterior da maioria dos periódicos acadêmicos, embora as políticas variem e a política atual do periódico-alvo deva ser verificada; as posições de pré-print são publicamente indexadas em registros como Sherpa Romeo. As exceções salientes se concentram em medicina e campos clínicos adjacentes, onde alguns periódicos ainda restringem ou desencorajam a disponibilização anterior de pré-print. Autores nesses campos devem verificar a política de pré-print do periódico-alvo antes de postar, em vez de após a submissão.
Detecção de escrita por IA: um canal adjacente de alarme falso. Uma camada de triagem mais recente apresenta um risco estruturalmente semelhante de alarme falso. Detectores de escrita por IA produzem falsos positivos documentados, e o ônus recai desproporcionalmente sobre escritores não nativos de inglês: em uma avaliação de Stanford de sete detectores de GPT disponíveis publicamente (o estudo não incluiu Turnitin), uma média de 61,3% dos ensaios TOEFL escritos por falantes não nativos foram classificados incorretamente como gerados por IA [97]. A prática institucional registrou a preocupação. Em agosto de 2023, a Universidade de Vanderbilt desabilitou publicamente o recurso de detecção de IA de seu software de verificação de similaridade, citando sua falta de confiabilidade: a taxa de falso positivo reivindicada pelo próprio fornecedor, a ausência de qualquer metodologia de detecção publicada e o mesmo ônus desproporcional sobre escritores não nativos de inglês documentado acima [163]. A postura defensiva aqui é paralela à auto-correspondência de similaridade e é administrativa em vez de adversarial: preservar o histórico de versões do manuscrito e os registros de redação como evidência contemporânea de autoria (um argumento adicional para a higiene de controle de versão abaixo) e responder a qualquer sinalização com documentação em vez de alarme.
Controle de versão e higiene de metadados. Porque os contadores se acumulam por página de artigo, a prática de revisão afeta diretamente a integridade da métrica. SSRN suporta a disponibilização de versões revisadas na mesma página do artigo, preservando os contadores acumulados e a URL indexada, enquanto deletar um artigo e carregá-lo novamente redefine as métricas e quebra os links existentes (SSRN FAQ; uma página de suporte sujeita a revisão, acessada em 14 de agosto de 2026 [B-7]). As escolhas de classificação também têm consequências de métrica, pois determinam o roteamento de eJournal e, portanto, os principais eventos de exposição do artigo [53]. A indexação externa é executada em um relógio mais longo do que os autores esperam: SSRN afirma que a indexação do Google Scholar é controlada pelo mecanismo de busca e pode levar "6–9 meses ou mais" [55]. Os contadores iniciais de um artigo são, portanto, gerados quase inteiramente pela maquinaria de distribuição interna da plataforma, que fundamenta a interpretação de zeros iniciais na Seção 5.6.
5. Um marco de interpretação: reconstruindo a escala ausente
A pergunta "este número é bom?" é cientificamente mal-colocada até que um grupo de comparação seja especificado. Esta seção monta o registro empírico publicado no aparato comparativo ausente: um mapa de referência consolidado com confiança de fonte explícita (5.1), uma faixa de conversão empírica (5.2), uma escala de interpretação graduada (5.3), um diagnóstico de alcance–conversão bidimensional (5.4), uma especificação de referência multidimensional (5.5) e um protocolo de leitura temporal (5.6). Valores são declarados em toda parte com seus quadros de amostragem e idades. Nenhum é um percentil calibrado para a plataforma 2026, e todos devem ser lidos tendo em vista a ressalva de inflação da Seção 5.1.
5.1 Um mapa de referência consolidado
A Tabela 7 consolida toda referência publicável para métricas de uso de SSRN identificadas na auditoria da Seção 2.5, cada uma com seu marco de amostragem e uma declaração explícita de confiança da fonte. Como uma referência é usada indevidamente no momento em que é extrapolada além de seu marco, cada entrada também nomeia o papel inferencial que a fonte pode legitimamente desempenhar e a principal limitação que a delimita. A evidência é fraca: o mapa se baseia em cinco estudos com marcos distintos: uma amostra estilo censo de uma rede jurídica em 2012 [139], uma raspagem das próprias listas principais da plataforma em 2015 [85], um instantâneo transversal de rede única em 2025 [83], agregados em nível de plataforma [1], e uma decomposição de subcampo [168]. Esses marcos não são intercambiáveis: raspagens de listas principais descrevem a cauda elite, censos de rede descrevem trabalhos típicos, e agregados de plataforma não descrevem nenhum dos dois. Cada distribuição envolvida também é fortemente inclinada para a direita, portanto as médias sistematicamente excedem as medianas e descrevem trabalhos atípicos.
Tabela 7. Mapa de referência consolidado para métricas de uso de SSRN, com marcos de amostragem, confiança da fonte, papéis inferenciais permissíveis e principais limitações.
| Referência | Valor | Fonte (ano; marco de amostragem) | Confiança da fonte | Papel inferencial permissível | Principal limitação |
|---|---|---|---|---|---|
| Transferências de artigos medianas após ~2 anos na plataforma | 63 (mean 122.55) | Siems 2016 [139]; n = 1,107 artigos LSN postados em duas janelas de 2012, contadores lidos dois anos depois | Médio-alto: figuras de amostra e transferência verificadas; apenas direito; coorte de 2012 | Visão histórica da distribuição de artigos ordinários | Uma âncora de rede jurídica de dois anos, não uma norma atual em toda a plataforma |
| Visualizações de resumo de artigos medianas após ~2 anos | 369 (mean 564.62; views–downloads correlation 0.852) | Siems 2016 [139] | Médio-alto: figuras verificadas contra a Tabela 1 da fonte; apenas direito; coorte de 2012 | Visão histórica do alcance de artigos ordinários | Marco de mesma idade e disciplina única; contadores de visualizações são a quantidade mais contaminada (Seção 4.2) |
| Transferências de artigos medianas, instantâneo de rede única | 87 (mean 221.3; p25 = 35; p75 = 206; p95 = 726; median paper age 491 days) | Jo & Li 2026 [83]; N = 2,361 artigos da Marketing Research Network, instantâneo de 15 de agosto de 2025 | Alto: verificado contra a tabela publicada; observe duas anomalias de tipos diferentes relatadas "conforme publicado" — visualizações p95 = 966 é um suposto erro de digitação da fonte (≈0.32 SD acima da média; linha rebaixada para reverificação), conversão p95 = 77.7 é um artefato de razão de denominador pequeno (Seção 5.2); painel completo na Tabela 5 | Distribuição transversal recente e modelo de conversão | Uma rede, um campo, uma data; artigos maduros; sem trajetórias |
| Visualizações de resumo de artigos medianas, instantâneo de rede única | 504 (mean 611.973; p5 = 151; p25 = 288; p75 = 833; p95 = 966 "as published") | Jo & Li 2026 [83]; mesma amostra acima | Alto: verificado contra a tabela publicada; o valor p95 (966) é um suposto erro de digitação da fonte — ≈0.32 SD acima da média — reproduzido "conforme publicado" e rebaixado para reverificação aguardando consulta ao autor | Distribuição de alcance transversal recente | Marco de rede única e data única idêntica |
| Conversão de visualizações→transferências, banda empírica | 11–19% (≈ one download per 5.3–9 abstract views) | Siems 2016 [139]; Willey & Knapp 2022/23 [172]; Jo & Li 2026 [83] | Médio-alto: figuras de Siems, Willey–Knapp e Jo & Li verificadas contra as tabelas das fontes | Norma de engajamento condicional (conversão) | Poucos marcos de amostragem; o denominador é inflável por bots, portanto a conversão medida é um limite inferior enquanto visualizações permanecem o contador mais inflado (Seção 4.2) |
| Regra prática histórica em toda a plataforma | ~3 abstract views : 1 download (~33%) | Black & Caron 2006 [18], relatando a própria estatística de SSRN | Médio: verificado literalmente; datado (2006); em toda a plataforma | Anatomia métrica e história de integridade | Era inicial da plataforma; uma âncora superior, não uma norma atual |
| Limite de entrada, artigos Top-10,000 históricos | ≥160 lifetime downloads (≈ top 1.8% of the platform's full-text paper stock, 571,040 in July 2016 [1]); median within the group 805; mean 1,800; max 152,242 | Kakushadze 2016 [85]; raspagem de listas principais de SSRN, 2015; 367,478 artigos | Alto: verificado contra as tabelas publicadas; marco de lista principal; trabalho de autor único | Forma de distribuição e comportamento da cauda | Seleção de lista principal; inadequado para estimar o artigo mediano contemporâneo |
| Limite de entrada, autores Top-30,000 | 129 total downloads (minimum); median within the group 1,626 total; median 210 downloads per paper; max 824,762 | Kakushadze 2016 [85]; o grupo descrito pelas próprias cartas de SSRN como "top 10%" de autores [161] | Alto: verificado contra as tabelas publicadas | Comportamento da cauda no nível de portfólio do autor | Mesma seleção de lista principal; 2015 |
| Média vitalícia não ajustada em toda a plataforma | ~222 downloads per paper (~35 in the trailing 12 months) | Computed from platform totals as of December 2023: 256,678,716 lifetime downloads across 1,157,048 full-text papers; ALL-SIS 2024 [1] | Médio: agregado derivado; mecanicamente inflado por artigos antigos; não um padrão pessoal | Apenas para calibração agregada da escala da plataforma | Uma média ao longo de duas décadas de acumulação; descreve quase nenhum artigo real (Seção 3.3) |
| Dispersão de subcampo dentro de uma disciplina única | ~8× in mean downloads per paper (438.35 Corporate/Securities/Finance Law vs 53.48 Agricultural Law) | Whalen 2018 [168]; 94 periódicos eletrônicos LSN, ~250,000 artigos | Médio-alto: verificado a partir da fonte; 2018; médias, não medianas | Classificação e heterogeneidade de subcampo | Médias, não medianas equivalentes em idade; apenas direito; 2018 |
| Transferências iniciais → citações posteriores | r ≈ 0.39–0.43 over the first 180 days (≈16% of variance explained) | Brody, Harnad & Carr 2006 [25]; arXiv (HEP), N = 14,442 | Alto: verificado; plataforma diferente, transferibilidade assumida em vez de demonstrada | Validação preditiva posterior | Plataforma e era diferentes; correlações em nível de artigo são modestas |
| Estrutura de calendário do acesso; lag de acesso→citação | Acessos ~11% menores nos fins de semana e ~50% menores no verão; resposta de citação ≈unit-elastic ~9 meses após uma mudança no acesso | Yuret 2026 [178]; >1.500 artigos de sete periódicos acompanhados ~1 ano | Alto: DOI, venue e título verificados via Crossref (14 agosto 2026); todas as quatro figuras — mais de 1.500 artigos de sete periódicos, acessos cerca de 11% menores nos fins de semana e cerca de 50% menores no verão, e uma resposta de citação aproximadamente unit-elastic (um aumento de 10% em acessos associado a um aumento de cerca de 10% em citações) cerca de nove meses depois — verificadas textualmente contra o resumo do artigo publicado (Springer, 15 agosto 2026) | Normalização temporal e validação preditiva — a âncora de normalização de calendário por trás de CSAB | Dados de acesso de periódicos, não específicos de SSRN |
| Sensibilidade das contagens às convenções de contagem | Relatórios de download de fornecedores podem ser ~2× os de plataformas comparáveis (contagens "deflatadas" em 43% do valor informado); métricas em nível de artigo exigem verificação explícita de integridade de dados | Wood-Doughty et al. 2019 [176]; Gordon et al. 2015 [69] | Médio-alto: ambas as fontes verificadas e já citadas nas Seções 4.1–4.3 | Aviso de integridade e comparabilidade — delimita a precisão de qualquer comparação entre plataformas ou fornecedores | Não é um benchmark direto de SSRN; não existe auditoria específica de SSRN |
Três leituras estruturais do mapa seguem.
A média não é o artigo típico. Na única distribuição publicada recentemente, a média (221,3) é 2,54 vezes a mediana (87) e excede até mesmo o percentil 75 (Seção 3.3) [83]. No censo anterior de Siems, a média era aproximadamente o dobro da mediana [139]. A média em nível de plataforma de ~222 downloads ao longo da vida [1] é o parâmetro pessoal menos adequado de todos: agrega duas décadas de acumulação por artigos de todas as idades.
Cada benchmark carrega uma safra, e a direção do viés de safra depende da comparação. Os downloads anuais da plataforma cresceram de aproximadamente 0,5 milhão em 2000 e 3 milhões em 2005 [18] para 12,9 milhões em 2016 e 40,6 milhões em 2023 [1], um aumento de 3,15 vezes entre 2016 e 2023, enquanto o estoque de artigos cresceu cerca de 2,03 vezes durante a mesma janela (571.040 para 1.157.048 [1]). A Figura 5 traça essa trajetória. Como os downloads cresceram mais rápido que o estoque de artigos, o fluxo de downloads por artigo aumentou aproximadamente 55% (de cerca de 22,6 para cerca de 35,1 por artigo por ano [1]), portanto um limite fixo de 2015 agora representa uma parcela menor do que um artigo típico ganha do que fazia então. Lido como uma banda de nível absoluto para 2026, um limite antigo como a entrada da lista superior de ~160 downloads é, portanto, indulgente em vez de conservador: atender a ele é menos seletivo hoje do que em 2015, não mais. O viés é dependente de composição. Para posição de percentil sob assimetria positiva contínua, as antigas âncoras podem ainda subestimar a cauda, mas para contagens absolutas a inflação de downloads as torna suaves, portanto nenhum limite antigo deve ser citado como um "piso conservador" sem essa ressalva. Multiplicar um limite de 2015 pelo crescimento posterior da plataforma é igualmente não autorizado: composição de autores, canais de distribuição, filtragem e competição por atenção todas mudaram juntamente com o fluxo de downloads.
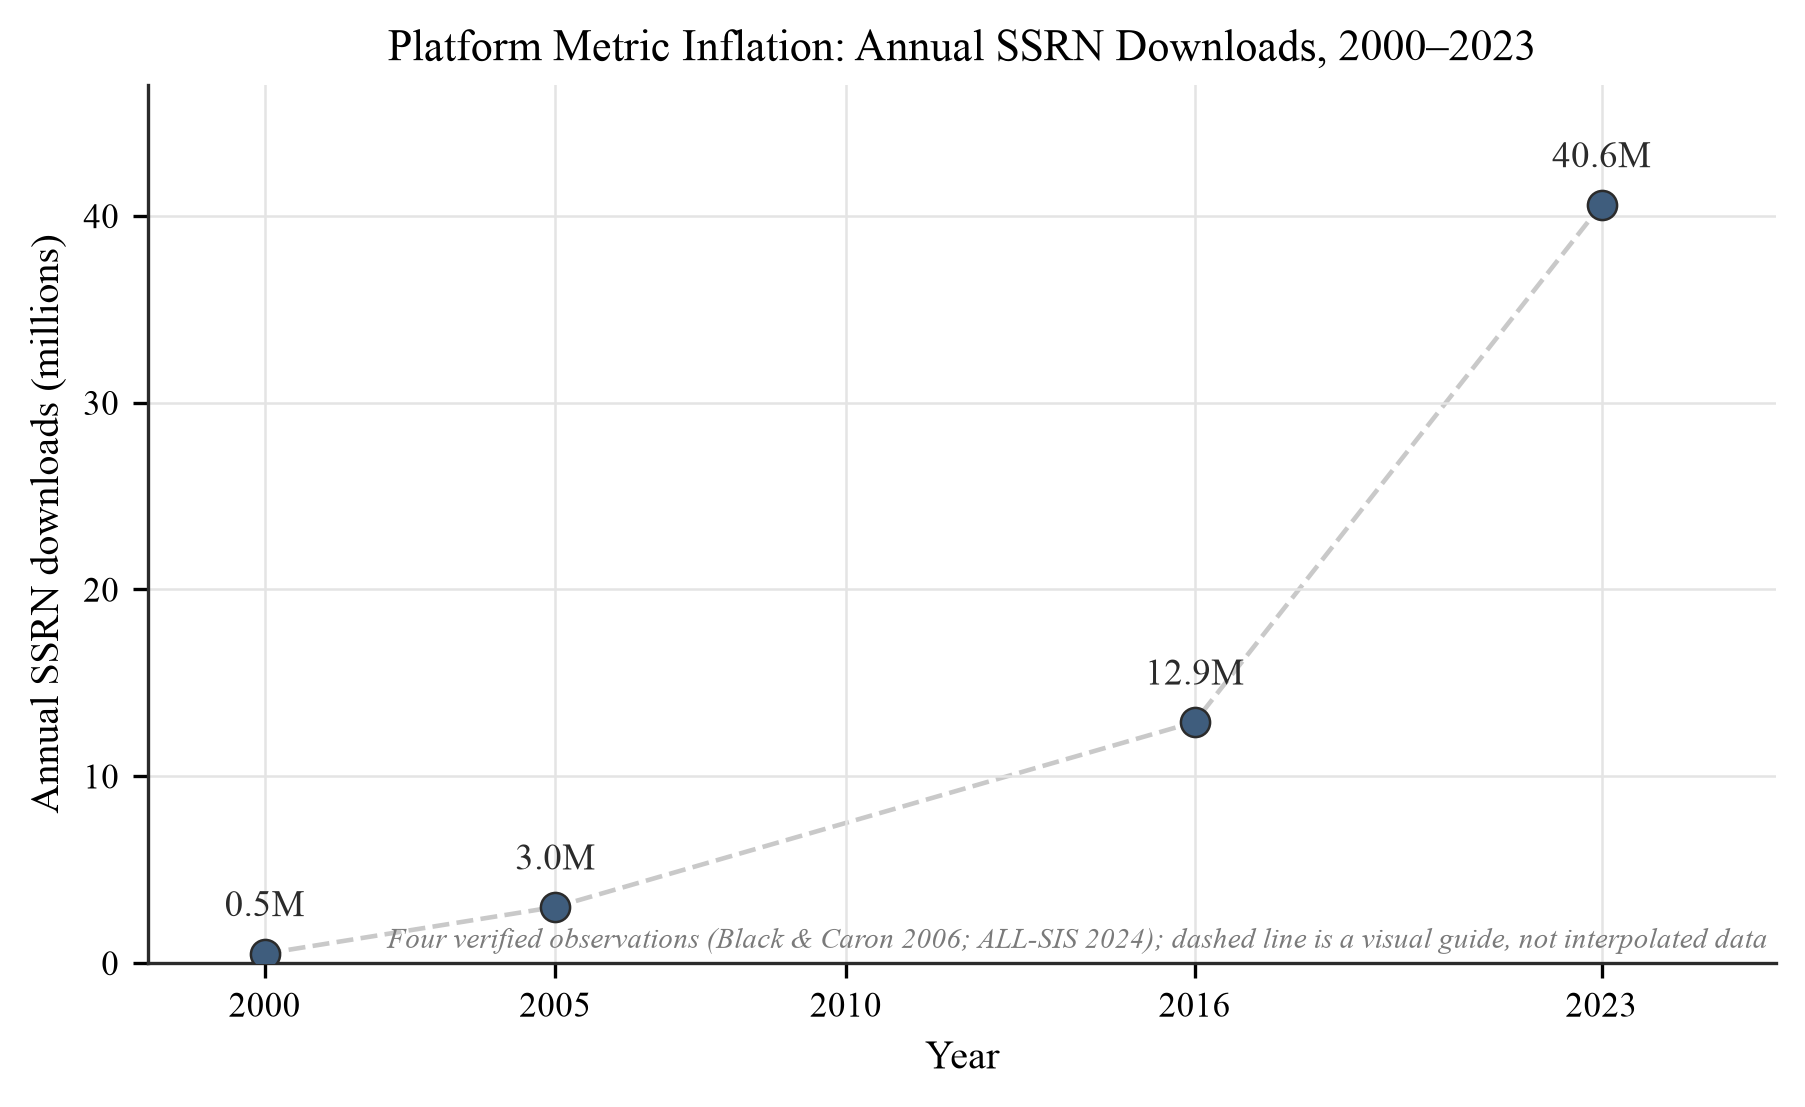
Figura 5. Inflação de métrica da plataforma, 2000–2023. Downloads anuais de SSRN: ~0,5 milhão (2000) e ~3 milhões (2005) [18]; 12,9 milhões (2016) e 40,6 milhões (2023) [1]. Como o fluxo de downloads cresceu mais rápido que o estoque de artigos (≈3,15× versus ≈2,03× de 2016 a 2023 [1]), elevando o fluxo de download por artigo aproximadamente 55%, os benchmarks absolutos estimados em amostras de 2012–2015 leem-se como bandas indulgentes em vez de conservadoras para leituras de 2026. Apenas os quatro valores de ano verificados listados aqui são traçados; nenhuma interpolação entre eles está implícita.
Nenhuma fonte de percentil atual existe. Nenhum estudo distributivo plataforma-abrangente de downloads de SSRN após 2020 foi identificado na auditoria da Seção 2.5 (o snapshot de rede única de 2025 [83], publicado em 2026, é a única amostra externa publicada recente), e após 15 julho de 2026 a própria plataforma não publica dados comparativos a partir dos quais percentis pudessem ser reconstruídos. A lacuna é uma de atualidade e especificidade de plataforma. A distribuição e desigualdade da atenção a pré-prints é uma área de pesquisa madura em outros repositórios (o perfil de citação e altmétrico de depósitos bioRxiv foi caracterizado em todo o servidor [62]), e a forma quasi-lognormal de downloads de SSRN especificamente já estava estabelecida antes de 2020 por Kakushadze [85]. O que está faltando é uma distribuição de percentil atual, específica de SSRN, pós-sunset. O mapa acima é montado a partir dos quadros disponíveis, que é o argumento para o conjunto de dados de benchmark comunitário proposto na agenda de pesquisa (Seção 8).
5.2 A banda de conversão
A razão entre downloads e visualizações de resumo é a única quantidade do painel com uma norma entre estudos razoavelmente estável, e autores a interpretam mal de forma mais consistente do que qualquer outra. Lida ingenuamente, cada visualização que não se converte conta como uma rejeição, e um autor com 40 visualizações e 7 downloads percebe uma "taxa de fracasso de 82,5%". Essa leitura está errada em fundamentos mecânicos e empíricos.
A Seção 4 estabeleceu a mecânica: o denominador (visualizações) é a quantidade mais contaminada por bots e mais inflacionada por arquitetura, já que cliques de email com modelo de push e tráfego de crawlers acumulam visualizações sem implicar intenção do leitor, enquanto o contador de download é ativamente auditado [144][99][106]. Enquanto o tráfego automatizado infla as visualizações mais do que os downloads, uma taxa de conversão medida é um limite inferior na conversão de visitantes humanos genuinamente interessados; a Seção 4.2 explica por que essa assimetria não pode mais ser assumida onde sistemas de IA recuperam texto completo, e o limite enfraquece de acordo. Empiricamente, as medidas publicadas convergem em uma banda estreita. Siems mediu uma razão mediana de downloads por visualização de 0,171 (média 0,187) no censo LSN [139]; Willey e Knapp relatam conversão de 15% entre seu grupo de artigos mais populares e 11% entre artigos com citação única [172]. O snapshot de Jo e Li produz uma mediana de 18,9 downloads por 100 visualizações de resumo [83]. A banda empírica resultante é 11–19%, ou seja, aproximadamente um download a cada 5,3–9 visualizações de resumo. A própria regra prática datada da SSRN de ~3 : 1 (~33%) [18] fica acima da banda e é melhor interpretada como uma âncora superior de época inicial em toda a plataforma, em vez de uma norma atual. Como ilustração entre domínios (as populações e intenções diferem categoricamente), uma taxa de navegação para commit neste intervalo seria considerada alta em software de consumo, onde os benchmarks típicos de conversão freemium de gratuito para pago se agrupam em dígitos baixos [10]. A comparação é apenas ilustrativa e reinterpreta a intuição de que "7 em 40" sinaliza desinteresse. A Figura 6 traça as estimativas.
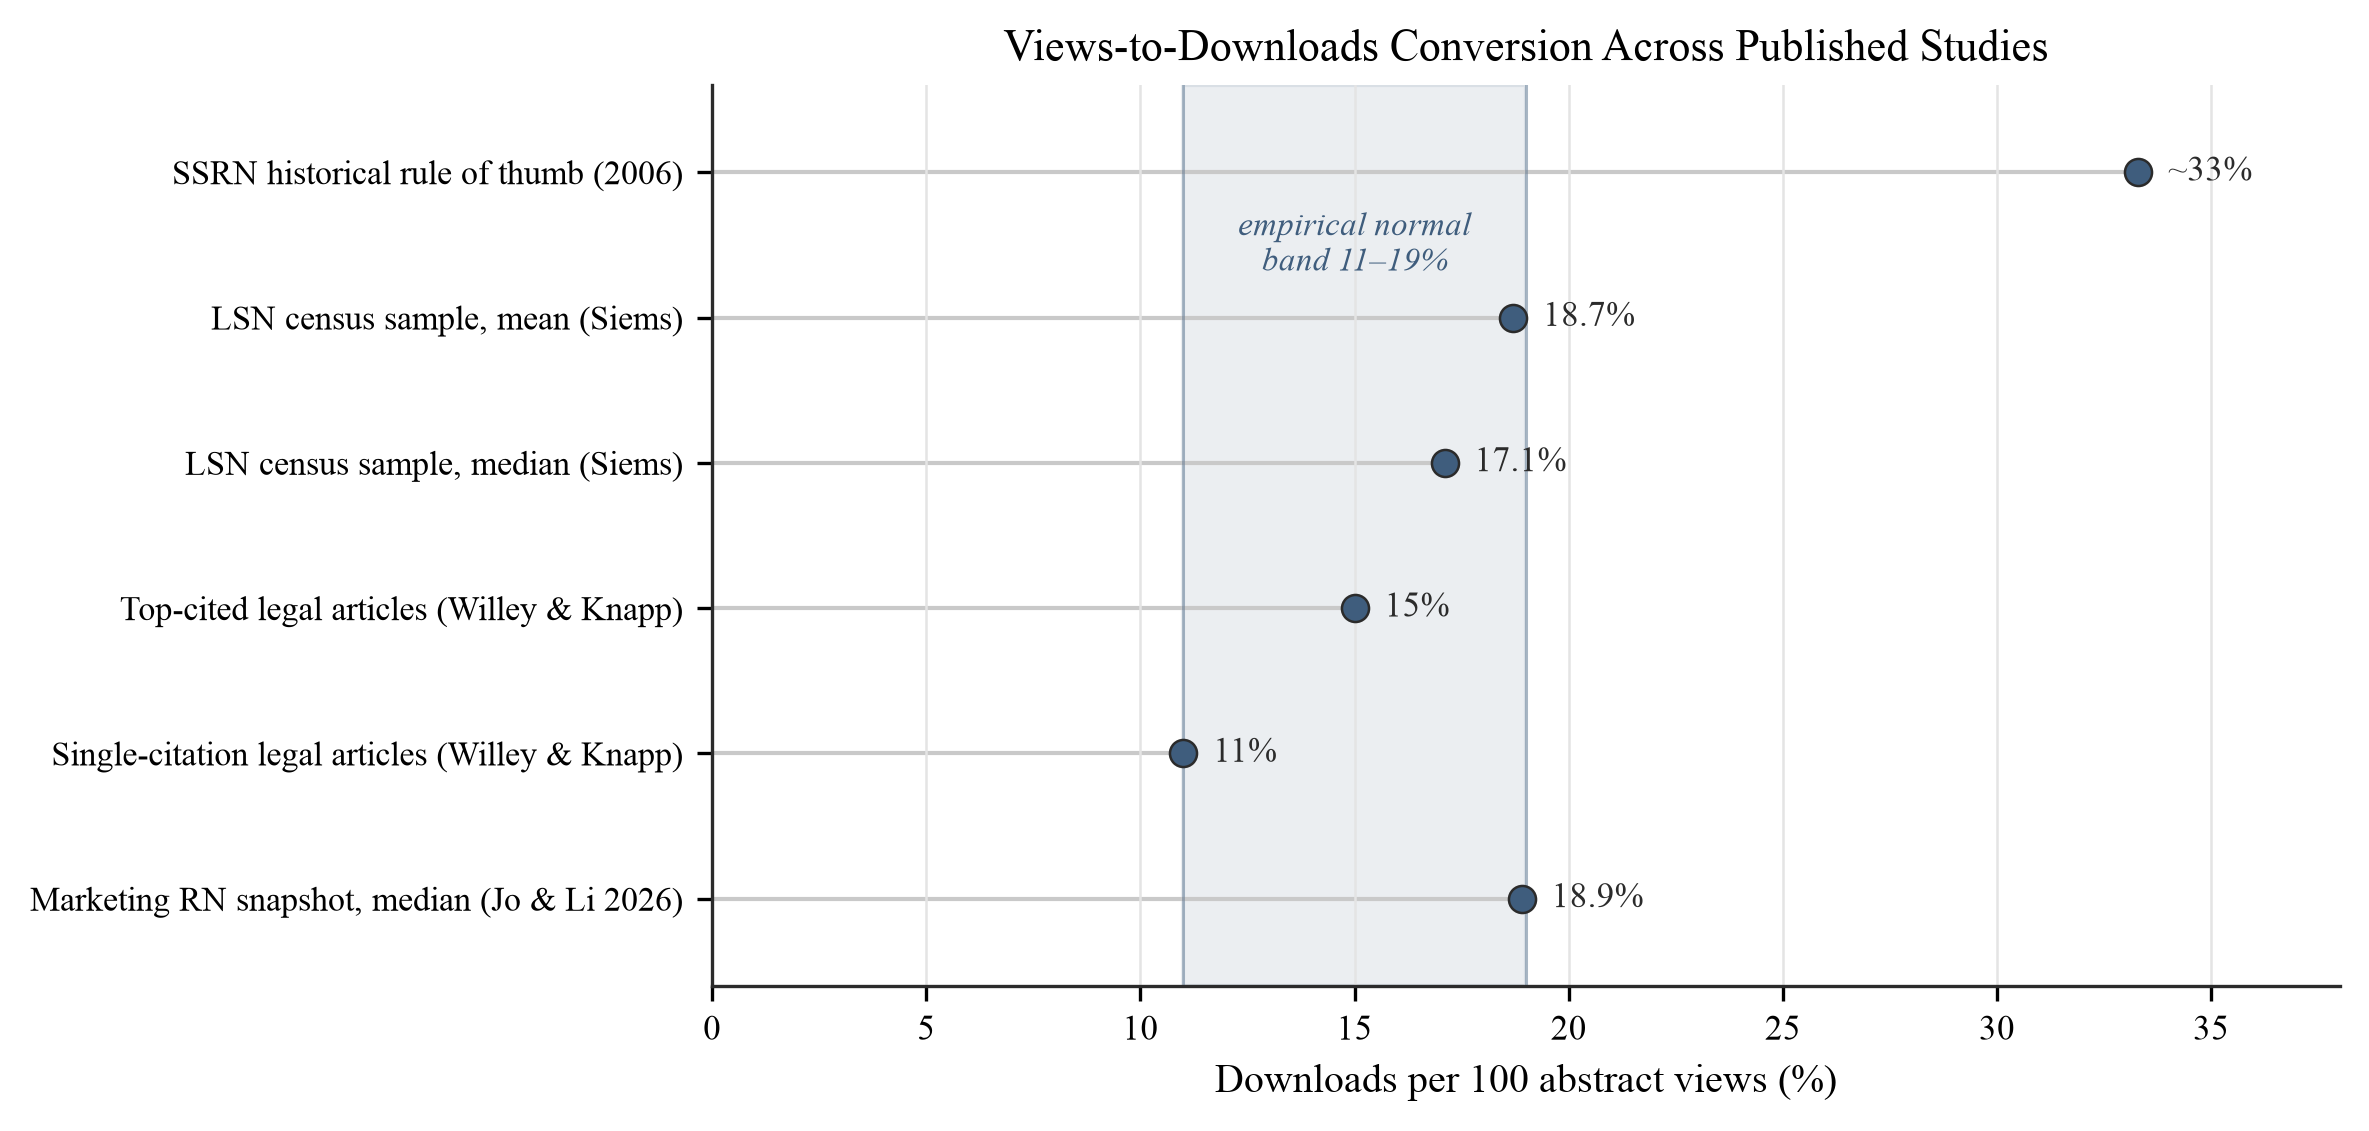
Figura 6. Conversão de visualizações para downloads em estudos. Estimativas de conversão em todo o registro publicado: regra prática histórica da SSRN de ~33% (conforme relatado em 2006) [18]; média de censo LSN 18,7% e mediana 17,1% [139]; 15% entre artigos legais mais citados e 11% entre artigos com citação única [172]; mediana de 18,9 downloads por 100 visualizações de resumo no snapshot da Marketing Research Network de 2025 [83]. A banda sombreada marca o intervalo normal empírico de 11–19% — um envelope de estimativas heterogêneas (medianas de toda a rede ao lado de figuras de subamostra selecionadas por citação cujo tipo de estatística a fonte deixa não especificado); a média da amostra de Jo e Li (23,7 por 100) fica acima dela. Todos os valores são conforme publicado nas fontes citadas; nenhuma nova estimativa é apresentada.
Os membros da banda são estatísticas diferentes de amostras diferentes, portanto é o envelope de estimativas de ponto heterogêneas. As figuras de Siems (17,1%) e Jo e Li (18,9%) são medianas de amostras de toda a rede, enquanto os 15% e 11% de Willey e Knapp são relatados para subamostra selecionadas por citação (artigos legais mais citados versus com citação única), cujo tipo de estatística a fonte não especifica e cuja seleção é a razão pela qual a borda inferior da banda fica onde está. A borda superior é ainda mais suave: a conversão média na amostra de Jo e Li, 23,7 downloads por 100 visualizações [83], fica acima da banda, e diverge nitidamente da razão das médias agregadas dessa amostra (221.346 ÷ 611.973 = 36,2 por 100). Que uma razão de médias de 36,2 fique tão acima de uma média de razões de 23,7 é em si mesmo diagnóstico. Porque a razão de médias é algebricamente a média ponderada por visualizações das taxas de conversão por artigo, seu excesso sobre a média de razões não ponderadas implica uma covariância positiva entre alcance e conversão: artigos com visualizações mais altas se convertem em taxas um tanto maiores, não menores. A leitura é conservadora: a inflação de denominador pequeno impulsionaria a média de razões não ponderadas para cima, funcionando contra essa ordem, portanto observar a razão de médias acima dela de qualquer forma torna a conclusão de dependência positiva mais robusta, não menos.
A banda fornece o exemplo trabalhado central deste artigo. Nas âncoras publicadas, um artigo com 40 visualizações de resumo seria esperado render aproximadamente 4–8 downloads. Os "7 downloads" do título, em 40 visualizações, é uma conversão de 17,5%, uma estimativa de ponto que fica dentro da banda, mas carrega ampla incerteza neste denominador. O intervalo exato de Clopper–Pearson de 95% em 7 de 40 vai de cerca de 7,3% a cerca de 32,8%, percorrendo a banda dos dois lados: com apenas 40 visualizações, a estimativa não pode ser resolvida à largura da banda, portanto a leitura é um resultado de triagem, não uma classificação. Duas coisas limitam ainda mais o exemplo. O denominador é pequeno (a instabilidade observada abaixo), e a comparação não é alinhada por idade: 40 visualizações no dia 20 aproximadamente é uma leitura de ciclo de vida inicial, enquanto as medianas de âncora vêm de amostras maduras (Siems em dois anos [139], Jo e Li na idade mediana de artigo de 491 dias [83]), e as Posições 1 e 5 e a Seção 5.6 argumentam que a exposição de ciclo de vida inicial é um regime diferente, portanto o eixo de idade não está alinhado. A leitura defensável é portanto que 17,5% é consistente com a banda entre estudos como um resultado de triagem, não um percentil de população preciso, e não "confortavelmente dentro" dela. O distresse que tal figura causa reflete a ausência de uma escala em vez da ausência de leitura. A época e o escopo das âncoras subjacentes são expostos na Seção 9.
Denominadores pequenos tornam a razão instável. Um artigo com duas visualizações e um download tem uma conversão nominal de 50%, mas essa estimativa não merece mais confiança do que uma construída em 500 visualizações; para qualquer benchmarking público, a contração empírica de Bayes em direção à taxa de classe de referência deveria impedir que denominadores pequenos produzissem pontuações extremas (Seções 8.3 e 8.8). A banda também funciona como um diagnóstico em ambas as direções. Conversão muito abaixo da banda, em um denominador não trivial, geralmente indica uma incompatibilidade título–resumo–texto: leitores chegam, leem o resumo e saem, um problema de comunicação acionável (reescreva o título e o resumo), não um veredito sobre a pesquisa. Conversão muito acima da banda sinaliza tráfego que a navegação de resumo não explica (cobertura de mídia, adoção em disciplina ou circulação viral) e deveria provocar uma verificação de onde as visualizações se originam. Nenhum desvio, por si só, estabelece nada sobre a qualidade da pesquisa. Uma qualificação adicional é uma hipótese em vez de uma descoberta. A conversão pode variar sistematicamente entre campos como uma propriedade do estilo de leitura do público em vez de artigos individuais: campos grandes podem exibir comportamento de "window-shopping", com muitas visitas de resumo e poucos downloads, enquanto pequenas comunidades altamente engajadas convertem em taxas mais altas. A banda acima é estimada a partir de poucas amostras para resolver isto, então o Estudo 1 (Seção 8.6) inclui conversão estratificada por campo entre seus resultados.
Um diagnóstico, nunca um alvo: a restrição anti-gaming. A banda de conversão é poderosa porque pode ser lida como uma norma, e esse poder carrega um risco. A Lei de Goodhart sustenta que uma medida adotada como alvo deixa de ser uma boa medida [67], um princípio paralelo à Lei de Campbell sobre a corrupção de indicadores sociais utilizados para tomada de decisão [27]. Se a banda de 11–19%, ou qualquer componente do marco de benchmarking da Seção 5.5, fosse adotada como um limiar de promoção ("artigos devem estar dentro da banda de conversão para contar"), a razão imediatamente se tornaria um objeto de otimização em vez de observação. O ataque é concreto e barato: porque o denominador é a quantidade mais manipulável (Seção 4.2), uma inflação coordenada de visualizações de resumo em proporção fixa aos downloads manteria a razão dentro da banda e tornaria um sinal engenheirado estatisticamente indistinguível da conversão orgânica. A resposta do marco é uma questão de definição. A banda de conversão, o diagnóstico alcance–conversão (Seção 5.4) e os componentes CSAB (Seção 5.5) são um vetor diagnóstico, nunca um alvo, e nenhum componente pode ser lido como um critério de promoção. A maquinaria que resiste ao gaming é construída no design: a banda é declarada como um limite inferior porque seu denominador é inflável por bot, portanto a leitura é conservadora contra a inflação por construção; o protocolo de anomalia da Seção 8.3 é sinalizar, não deletar, portanto um pico engenheirado é preservado e tornado visível em vez de silenciosamente absorvido; e a filtragem de integridade da Seção 4.1 já seleciona a atividade coordenada mais detectável. Lida como diagnóstico, a banda expõe o gaming como uma assinatura fora de banda ou internamente inconsistente; lida como alvo, convidaria exatamente a coordenação que deveria detectar. Essa posição alinha o marco com o consenso estabelecido de reforma da avaliação de pesquisa: a Declaração de São Francisco sobre Avaliação de Pesquisa (DORA), que rejeita proxies de número único e marca de revista a favor de avaliação sobre o próprio conteúdo da pesquisa [8], e o Manifesto de Leiden, cujos princípios advertem contra exatamente essa substituição de um indicador fácil pelo julgamento de especialista [78].
Downloads não têm rastro de auditoria pública: uma razão adicional para ler a banda como um piso. Uma assimetria estrutural entre citações e downloads agudiza a preocupação com gaming. Uma citação deixa um rastro público, inspecionável: o documento citado existe, pode ser encontrado e pode ser verificado, portanto a manipulação de citações é em princípio auditável por qualquer terceira parte. Um contador de downloads não deixa tal rastro público. É uma contagem privada nos servidores da plataforma, sem registro externo de quais solicitações foram contadas, filtradas ou reformuladas, o que a deixa singularmente exposta a gaming encoberto que nenhum observador externo pode reconstruir após o fato. Essa exposição é uma razão independente, além da contaminação de bot do denominador, para tratar a taxa de conversão medida como um limite inferior e não uma estimativa pontual (sujeita à ressalva da Seção 4.2 sobre recuperação por IA), e sempre emparelhar o contador com o protocolo de anomalia e a filtragem de integridade documentada de que o marco depende (Seção 4.1). A ausência de um rastro de auditoria não é uma razão para desconfiar do contador; é uma razão para lê-lo conservadoramente e insistir na disciplina sinalizar-não-deletar que mantém uma leitura manipulada detectável (Seção 8.3).
A banda é uma meta de calibração, não uma constante. Uma consequência segue para como a figura de 11–19%, e cada limiar CSAB, deveria ser citada: são quantidades a serem calibradas por campo e por plataforma (Seções 4.4, 5.5). O mecanismo para essa calibração já foi especificado: o Estudo 1 estratificado por campo (Seção 8.6) é projetado para entregar as distribuições de conversão e download por campo que o marco requer e é construído para consumir. Até que o Estudo 1 seja relatado, a seção cruzada de arquivo do Apêndice E fornece uma estimativa resolvida por campo. Em catorze campos contendo pelo menos vinte artigos, a conversão mediana varia de 0.134 em Energia para 0.195 em Ciência da Computação, uma variação de cerca de 1,5 vezes, e mantendo a idade do artigo fixa varia de 0.134 para 0.224, cerca de 1,7 vezes. Levando em conta a variação de campo de três a cinco vezes nos próprios downloads, conversão é a mais portátil das duas quantidades, o que a torna utilizável como um diagnóstico. Idade é a dimensão que não sobrevive: em cada campo grande o suficiente para testar, conversão diminui conforme os artigos envelhecem, com coeficientes de Spearman de −0.14 a −0.41 em oito campos contendo pelo menos quarenta artigos. Uma banda de conversão citada sem uma idade do artigo está fazendo menos trabalho do que aparenta.
5.3 A escala de interpretação graduada
Os autores do Post-Rankings notoriamente carecem de uma escala graduada, no formato estabelecido dos guias de interpretação do h-index [118], que converte contadores brutos em bandas em linguagem simples. As seções 5.1–5.2 fornecem os ingredientes para isso. A Tabela 8 apresenta a escala proposta para quatro quantidades: downloads de vida útil em nível de artigo, downloads do primeiro mês, conversão de visualizações para downloads e total de downloads em nível de autor.
Tabela 8. Escala de interpretação proposta para métricas SSRN. As bandas sintetizam evidências de 2012–2015 [139][85][18][172]; porque o fluxo de downloads por artigo aumentou desde então (Seção 5.1), seus limiares absolutos são melhor lidos como leniente em vez de bandas conservadoras para 2026, e em qualquer caso como uma aproximação. A coluna do primeiro mês não é um degrau calibrado da escala, mas uma previsão pré-registrada com grande incerteza, a ser testada pelo painel prospectivo do Estudo 1 (Seção 8.6); suas células não devem ser lidas como limiares ou degraus de promoção (veja o texto). O limite Forte/Excepcional em 10.000 é uma estimativa provisória do autor: nenhuma fonte publicada identificada na auditoria da Seção 2.5 vincula 10.000 downloads a um percentil. A banda Nascente não introduz novos números: seu teto é a âncora de mediana bienal existente de 63 [139]. Os limites das bandas são definidos em números redondos e mantidos com aproximadamente uma banda inteira de largura: o teto de precisão estabelecido pela literatura de integridade (Seções 3.1, 4.1–4.3) torna as gradações mais finas espuriosamente precisas, portanto a aspereza das bandas é intencional. A coluna de parecer em linguagem simples descreve a downloads escala apenas e não se transfere para a coluna de conversão: uma conversão mediana de 18,9% é ordinária em vez de \"Sólido\", e um p75 de 27,2% não é \"Forte\". Os limites de downloads ao longo da vida são não sobrepostos por construção (Nascente abaixo de 63, Modesto 63–159, Sólido 160 e acima); onde a tabela imprime um ponto final compartilhado entre as linhas superiores — 800 entre Sólido e Forte, e os cutoffs correspondentes de conversão e nível de autor — o intervalo é meio-aberto, com cada valor compartilhado pertencendo à banda superior. Os dois valores de limite de vida útil são extraídos de classes de referência incomensuráveis: 63 é uma mediana de janela bienal para um censo de bolsa jurídica de uma única disciplina [139], enquanto 160 é um limiar de entrada de vida útil para toda a lista de topo da plataforma [85]. Portanto, eles se encontram em relógios diferentes (uma idade de artigo de dois anos fixa em relação ao acúmulo vitalício ilimitado) e descrevem populações diferentes (um campo em relação a todos os campos), portanto combiná-los em uma única escala absoluta é uma combinação de classes de referência com idades, campos e regras de seleção diferentes — uma limitação que os percentis específicos de campo e idade do Estudo 1 foram projetados para eliminar. Um limite estrutural desses âncoras merece ênfase: porque os pontos de referência disponíveis se agrupam na mediana bienal (63 [139]) e na cauda superior da plataforma, quatro das cinco bandas verbais — Modesto, Sólido, Forte e Excepcional — descrevem artigos na mediana ou acima dela, portanto a escala é densa acima da mediana e discrimina apenas fracamente na faixa ampla de percentil 50–98 em que a maioria dos artigos realmente cai. Essa compressão é uma consequência direta de ancorar em evidências de cauda superior; resolver o ordinário do meramente acima da mediana aguarda os percentis específicos de campo e idade do Estudo 1. A escala é ilustrativa, não normativa: nenhum limite de banda deve entrar em uma decisão de estabilidade, contratação ou promoção como um limite de aprovação/reprovação até que o painel prospectivo do Estudo 1 (Seção 8.6) tenha calibrado percentis específicos de campo e idade para substituir essas âncoras absolutas desatualizadas.
| Banda | Artigo: downloads ao longo da vida | Artigo: downloads do primeiro mês (extrapolado) | Conversão (downloads / visualizações) | Autor: total de downloads | Parecer em linguagem simples |
|---|---|---|---|---|---|
| Nascente | Abaixo da mediana bienal de 63 [139] | — (sem âncora separada; veja texto) | — (denominador típicamente muito pequeno; Seção 5.2) | — | Muito cedo, ou abaixo da mediana do campo — a norma estatística para artigos jovens e de nicho; diagnostique a exposição primeiro (Seções 5.4, 5.6), não qualidade |
| Modesto | 63–159 | <15 | <11% | <~130 | Típico da plataforma; a banda mediana |
| Sólido | 160–800 | 15–50 | 11–19% | ~130–1,600 | Em ou além da entrada histórica da lista de topo |
| Forte | 800–10,000 | 50–250 | 19–30% | 1,600–10,000 | Típico das listas de topo históricas |
| Excepcional | >10,000 (estimativa provisória do autor) | >250 | >30% | >10,000 (estimativa provisória do autor) | Além do intervalo documentado de circulação acadêmica ordinária |
Cada âncora interior está vinculada a um limite publicado. A banda Nascent cobre a região abaixo da mediana LSN de dois anos de 63 [139]. Essa região é populosa, não anômala: as bandas pré-especificadas do Estudo 1 (Seção 8.6) antecipam que uma parcela substancial dos artigos da plataforma, da ordem de 15–30% sob a banda de previsão declarada, tem dez ou menos downloads ao longo da vida, portanto uma escala cuja banda mais baixa começasse perto da mediana deixaria os artigos mais numerosos da plataforma, incluindo este artigo como protagonista, completamente fora da escala. O veredicto Nascent não é avaliativo. Abaixo da mediana do campo, e especialmente com idade jovem do artigo, o contador não autoriza nenhum julgamento de qualidade, e o primeiro passo diagnóstico é a exposição (Seções 5.4 e 5.6) em vez do conteúdo. A banda Modest está ancorada na mediana LSN de dois anos de 63 [139]. "Modest" é a banda mediana: tipicidade não é falha. O limite Modest/Solid (~160 downloads ao longo da vida) é o ponto de entrada Kakushadze para os artigos Top-10.000 de todos os tempos, aproximadamente o topo 1,8% do acervo de artigos em texto completo da plataforma (571,040, julho de 2016 [1]) [85]. Operacionalmente, um artigo "Solid" é um artigo da lista superior. O limite Solid/Strong (~800) é a mediana dentro desse grupo de elite (805) [85]: separa artigos que meramente entram na elite histórica de artigos típicos dela. Na escala de portfólio, a coluna de nível de autor espelha essa lógica: o grupo que as próprias notificações da SSRN descrevem como os 10% principais de autores [161] tinha um mínimo de entrada de 129 downloads totais e uma mediana interna de 1,626 [85]. Como toda âncora de nível de autor é extraída dessa lista classificada, a coluna de autor descreve a cauda superior da distribuição de autores em vez do autor típico. Um autor abaixo do limite ~130 não é meramente "Modest": esse autor fica completamente fora do grupo historicamente classificado, portanto as bandas inferiores da coluna lêem-se como "abaixo da elite histórica", não como uma posição calibrada entre todos os autores. Esta é a mesma ancoragem de cauda superior que comprime a escala de nível de artigo; as âncoras da coluna de autor aguardam os percentis de nível de portfólio do Estudo 1. A coluna de conversão é a banda entre estudos da Seção 5.2. O limite Strong/Exceptional em 10.000 não carrega nenhuma âncora de percentil publicada e é retido como um horizonte de ordem de magnitude.
A coluna do primeiro mês tem um status diferente. É uma previsão pré-registrada, uma previsão falsificável com ampla incerteza que o Estudo 1 (Seção 8.6) é projetado para testar, e nenhuma célula do primeiro mês pode ser usada como um limite ou degrau interpretativo. Nenhum referencial direto do primeiro mês existe na literatura publicada, portanto a coluna é uma projeção em vez de uma medição, extrapolada da concentração inicial documentada de downloads (picos de atenção se agrupam nas primeiras semanas, particularmente sob cobertura externa [18][116][138]) para os limites de tempo de vida acima. Os limites específicos derivam de uma âncora publicada: na amostra da lista superior de Kakushadze, aproximadamente o topo 1,8% do acervo de artigos em texto completo da plataforma (571,040, julho de 2016 [1]), a contagem de downloads de mediana de doze meses foi 247 [85]. Um primeiro mês acima de ~250 excederia portanto a norma anual da elite histórica da plataforma, daí o limite Exceptional, enquanto 15–50 downloads do primeiro mês, se sustentados, projetam-se para o limite de entrada de ~160 de tempo de vida, daí Solid. Essas células são projeções de uma única âncora histórica e são as células mais fracas da tabela; se citadas, carregam essa derivação.
Duas ressalvas governam o uso da escala. O qualificador disciplinar não é opcional: dentro de uma única disciplina, os downloads médios por artigo diferem aproximadamente por um fator de oito entre subcampos (438.35 em Direito Corporativo/Valores Mobiliários/Finanças versus 53.48 em Direito Agrícola) [168], portanto toda declaração de banda deve levar um rótulo de campo. Essas são médias de tempo de vida e não são ajustadas pela idade do artigo, e a seção transversal do arquivo do Apêndice E mostra por que isso importa: o nível aparente de um campo se move com o perfil de idade dos artigos amostrados dele, e mantendo a idade fixa reduz a dispersão para aproximadamente três a cinco vezes. A segunda é que heurísticas alternativas de número único propostas neste espaço (índices de desempenho relativo baseados em razão (os downloads de um artigo divididos pela mediana de uma coorte correspondente), heurísticas de camada logarítmica baseadas em ⌊ln D⌋, e vereditos de cartão de pontuação verbal ("início rápido / interesse constante / início lento")) são englobadas aqui como heurísticas de autor não calibradas, porque nenhuma tem bandas numéricas validadas. A intuição logarítmica em si é sólida e vale a pena manter em palavras: sob uma distribuição quase-lognormal [85], passar de 7 para 20 downloads é uma mudança de uma unidade de log natural em visibilidade, e lê-la como a adição de 13 cliques perde isso.
A escala também explica por que autores sistematicamente julgam mal seus próprios contadores. Os números que circulam em marcos, perfis e anúncios vêm, como a Seção 3.5 documentou, de uma cauda visível centenas de múltiplos acima da mediana, enquanto a massa da distribuição fica perto da mediana LSN de 63, e sob a lei quase-lognormal as distâncias entre degraus são multiplicativas, não aditivas. A Figura 7 organiza esses valores (mediana de artigo ordinário, limites de entrada, medianas de elite, cauda) como uma escada de referência em uma escala logarítmica.
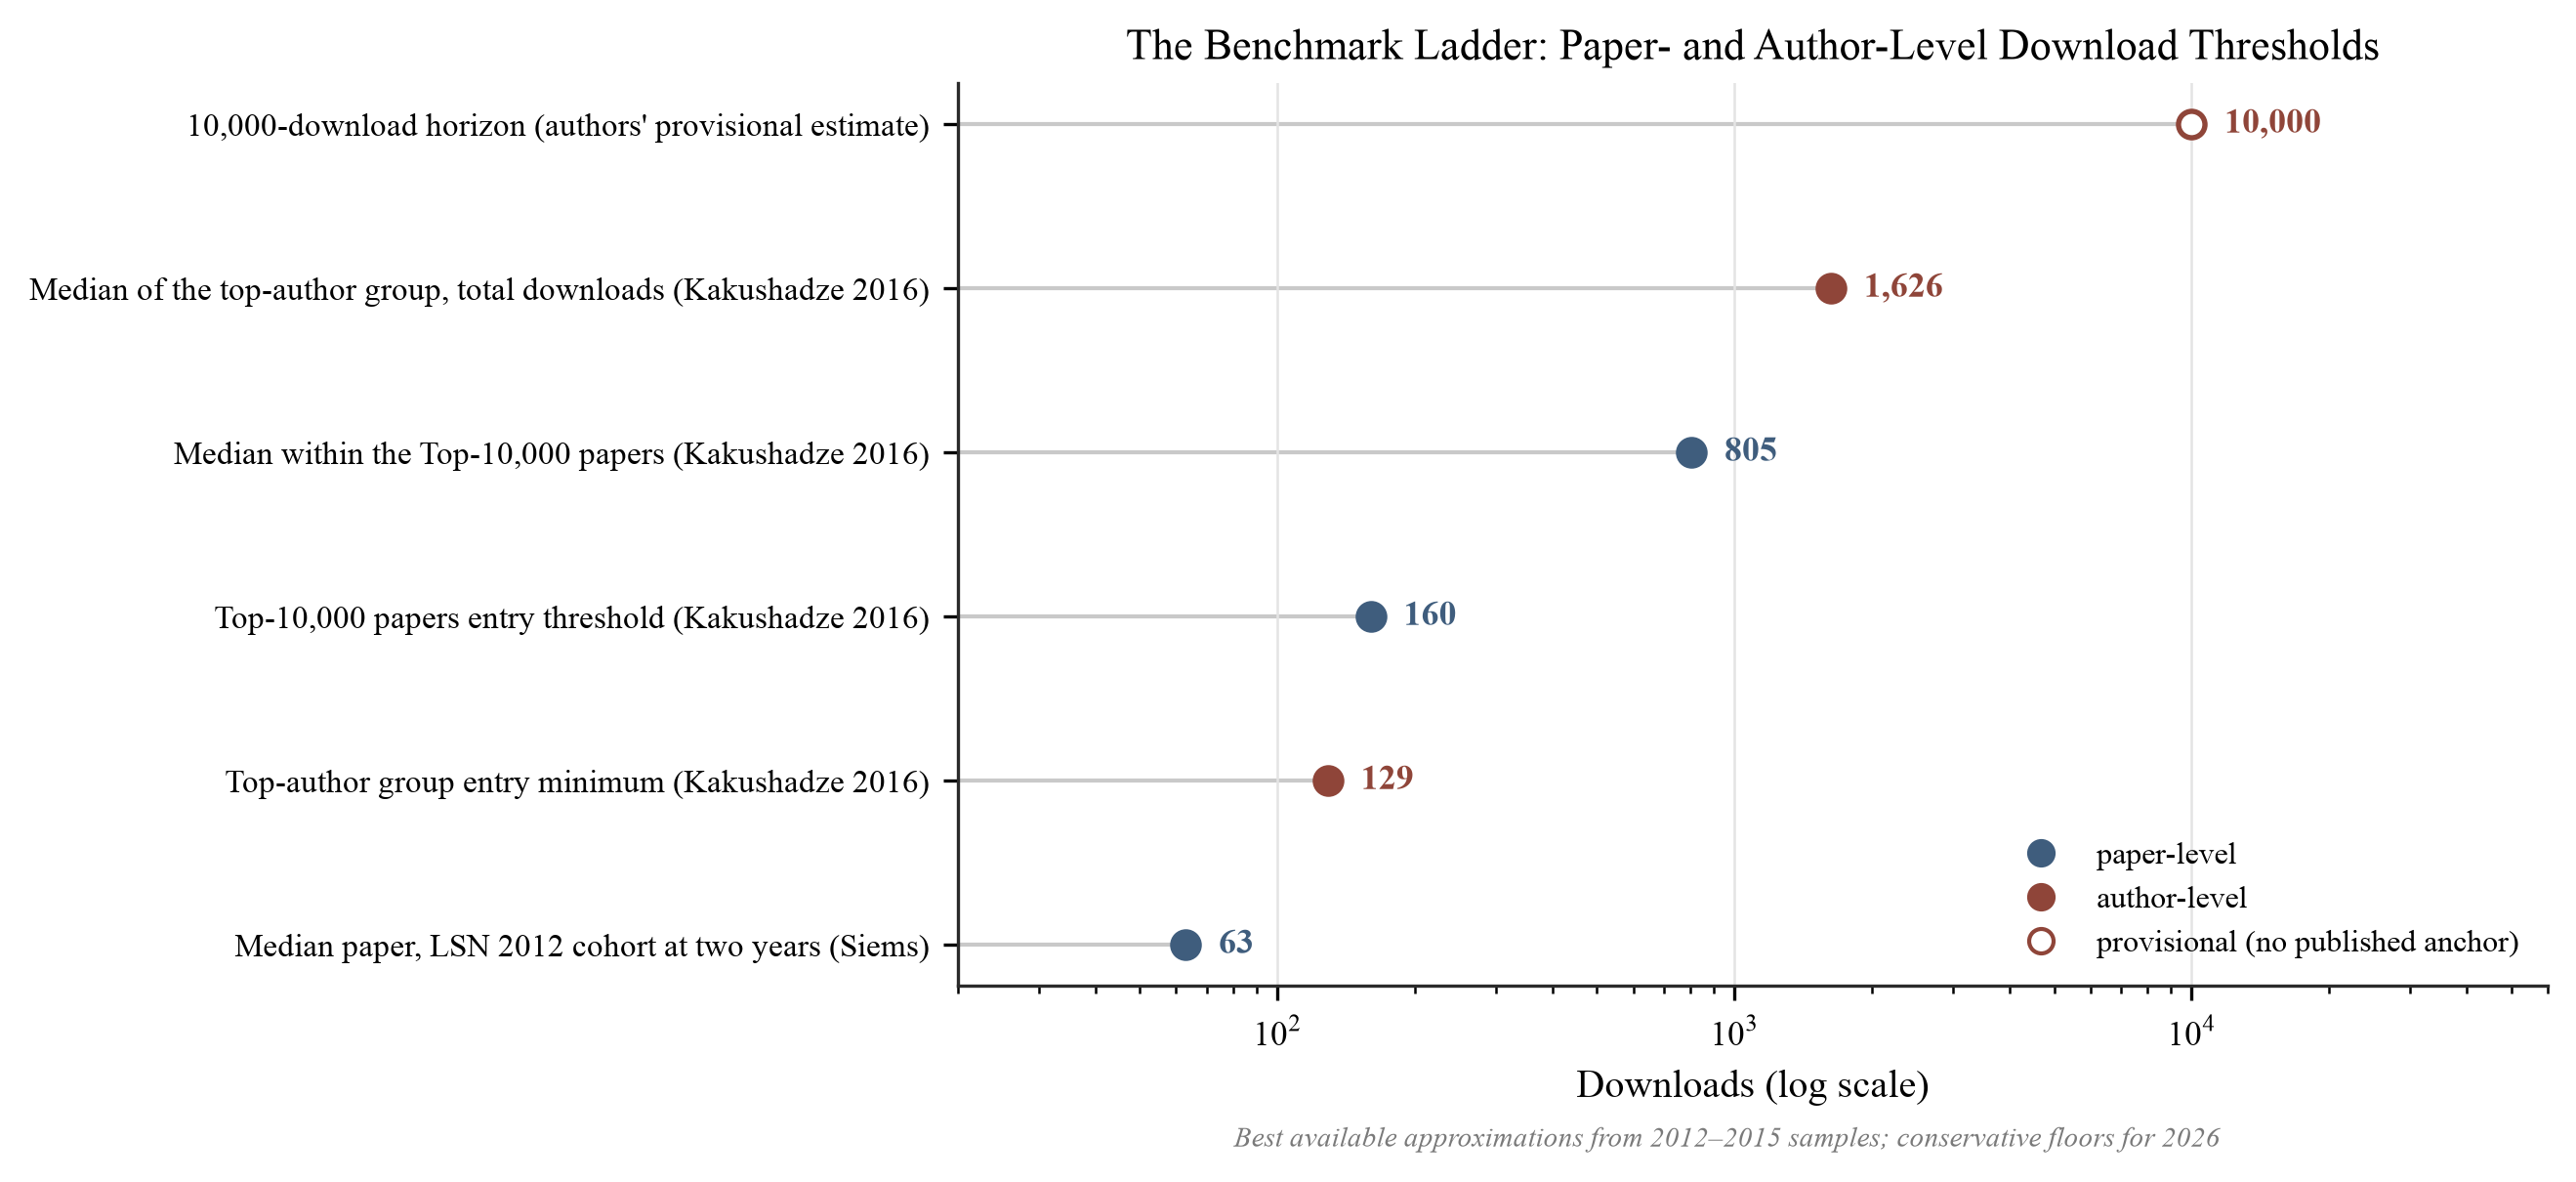
Figura 7. A escada de referência. Limites de download de nível de artigo e autor em uma escala logarítmica: mediana LSN de dois anos 63 [139]; mínimo de entrada de autor superior 129 e entrada de artigo superior ~160 [85]; mediana dentro dos artigos Top-10.000 805 [85]; mediana do grupo de autor superior 1,626 [85]; o horizonte de download de 10.000 (estimativa provisória do autor, nenhuma âncora de percentil publicada). A região abaixo da mediana de dois anos de 63 corresponde à banda Nascent da Tabela 8. Os valores são de amostras de 2012–2015 (inflação desde então: Seção 5.1).
5.4 Alcance versus conversão: um diagnóstico bidimensional
Uma contagem única, mesmo uma com bandas, não consegue distinguir entre os diferentes mecanismos que a produzem. A mecânica da Seção 4 tem uma implicação que importa mais na prática: falha de visibilidade e não-resposta de conteúdo são diagnósticos diferentes: um artigo pode ter poucos downloads porque poucos leitores o encontraram, ou porque os que o encontraram recusaram o texto completo. A Tabela 9 cruza as duas dimensões normalizadas.
Tabela 9. Matriz diagnóstica de alcance–conversão. O alcance e a conversão são avaliados como percentis dentro de uma classe de referência de artigos comparáveis (mesmo campo, coorte de postagem, idade do artigo e visibilidade anterior do autor; Seção 5.5), com a mediana da classe como limite. Nenhum ponto de corte numérico absoluto é defensável com base na evidência atual, e nenhum é fornecido. A exibição 2×2 dicotomiza cada eixo na mediana da classe para legibilidade; os percentis de alcance e conversão subjacentes são contínuos (Seção 5.4), e partições mais finas, como tercis, estão disponíveis.
| Conversão baixa | Conversão alta | |
|---|---|---|
| Alcance baixo | "Início frio" (alcance baixo, conversão baixa). O artigo não é amplamente encontrado nem frequentemente baixado após a exposição. Os dados não estabelecem se a pesquisa subjacente é fraca; apenas estabelecem que a difusão ainda não começou. | "Interesse oculto" (alcance baixo, conversão alta). Leitores que encontram o artigo respondem bem, mas muito poucos o encontram. A descoberta é o gargalo observável primário — um problema de distribuição, não de conteúdo. |
| Alcance alto | "Atenção sem absorção" (alcance alto, conversão baixa). O título, tópico ou posicionamento na plataforma parece atrair visitas, mas poucos visitantes obtêm o texto completo. Descartar um denominador contaminado antes de diagnosticar um desajuste de comunicação: alcance alto pode ser visualizações fantasma em vez de atenção genuína, porque visualizações são o contador mais poluído dos dois (Seção 4.2) — no registro transparente RePEc/LogEc, robôs representavam aproximadamente 74% das visualizações de resumo, mas apenas cerca de 7% dos downloads [99], então tráfego não filtrado não humano produz exatamente essa assinatura de alcance alto e conversão baixa. Apenas quando as visualizações inflacionadas por bots são excluídas os dados residuais justificam investigar adequação de audiência e comunicação título-resumo. | "Difusão precoce forte" (alcance alto, conversão alta). O artigo atinge uma audiência comparativamente grande e converte exposição em interesse por texto completo. |
Os quatro quadrantes são rotulados pelo padrão de difusão que os dois percentis mostram (início frio, interesse oculto, atenção sem absorção, difusão precoce forte). Os rótulos descrevem um padrão de difusão, não a pesquisa em si, e o que importa operacionalmente é a separação de mecanismos; nenhum quadrante de baixo alcance autoriza uma inferência sobre qualidade da pesquisa, um ponto que se relaciona diretamente a qualquer uso avaliativo dessas métricas. O quadrante de baixa difusão leva o nome do próprio diagnóstico deste artigo, o início frio. A matriz é praticamente valiosa porque a intervenção apropriada difere por quadrante: um candidato de interesse oculto precisa de distribuição (revisão de classificação, tempo de anúncio, visibilidade externa), enquanto atenção sem absorção requer reparo de comunicação (título e resumo) ou auditoria de tráfego. A Figura 8 apresenta o plano como um modelo.
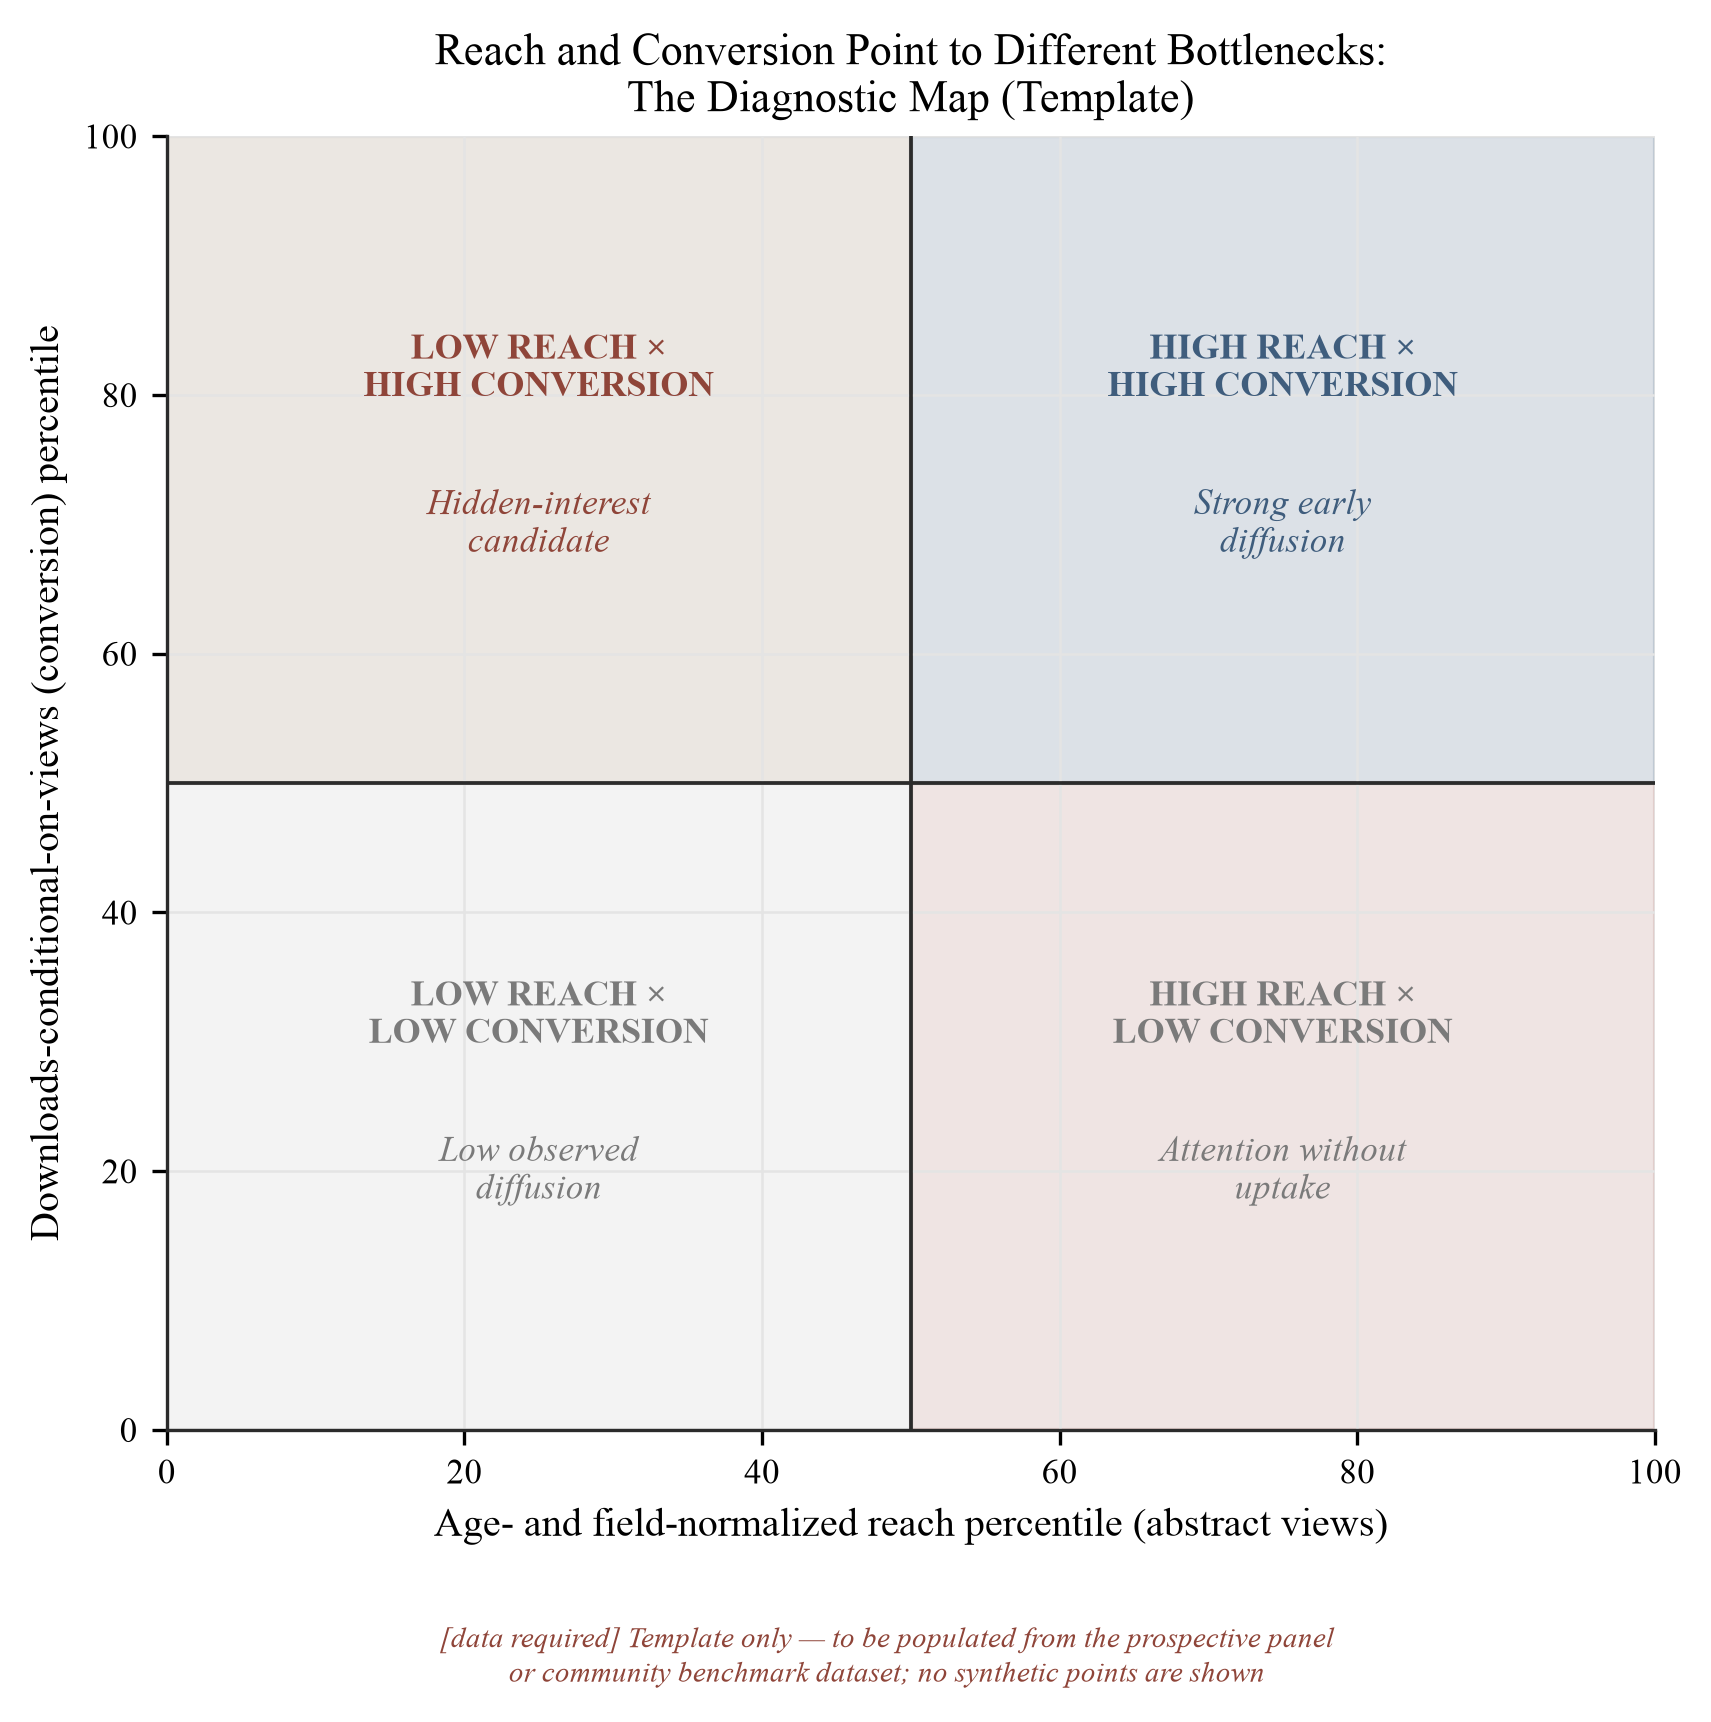
Figura 8. O mapa alcance–conversão. Modelo para posicionar artigos por percentil de visualização normalizado por idade, campo, coorte e visibilidade (alcance, horizontal) e percentil de downloads-condicional-em-visualizações (conversão, vertical), com quadrantes como na Tabela 9 (início frio, interesse oculto, atenção sem absorção, difusão precoce forte). O quadrante superior esquerdo identifica artigos com conversão acima da mediana apesar do alcance abaixo da mediana, uma classe que as contagens brutas de downloads sistematicamente subvalorizam. Nenhum valor empírico é mostrado; o mapa será preenchido a partir do painel prospectivo ou do conjunto de dados de referência da comunidade da Seção 8.
5.5 De um número de chamada a um benchmark: as dimensões do CSAB
Cada uma das subseções anteriores corrige um modo de falha do contador bruto, e o Cold-Start Scholarly Attention Benchmark (CSAB) é essa integração: um framework de relatório que substitui o número de chamada único por cinco componentes normalizados (Tabela 10). As variáveis de normalização (idade do artigo, campo, coorte de postagem e visibilidade prévia do autor) são cada uma empiricamente motivadas: as métricas cumulativas aumentam mecanicamente com a idade; as normas de campo diferem em até uma ordem de magnitude na média [168]; as condições de calendário mudam a atenção mensuravelmente (os acessos aos artigos caem ~11% nos fins de semana e ~50% nos meses de verão [178]); e um recém-chegado à plataforma não enfrenta o mesmo público inicial que um autor estabelecido [83]. Uma convenção de população tem de ser fixada antes de qualquer percentil ser calculado. Um contador cumulativo é definido sobre um estoque de artigos com sobrevivência heterogênea (artigos são ocasionalmente retirados, mesclados ou supersedidos por versões posteriores), então cada percentil do CSAB é uma declaração sobre o estoque sobrevivente na data de observação. O Estudo 1 (Seção 8.6) preespecifica a regra de inclusão (tratamento de versão, retiradas e resolução de duplicatas) em vez de deixar a população de referência implícita.
Os dois componentes centrais admitem uma definição compacta. Para o artigo i com idade τ (dias desde a postagem), no campo f, coorte de postagem c e estrato de visibilidade prévia s:
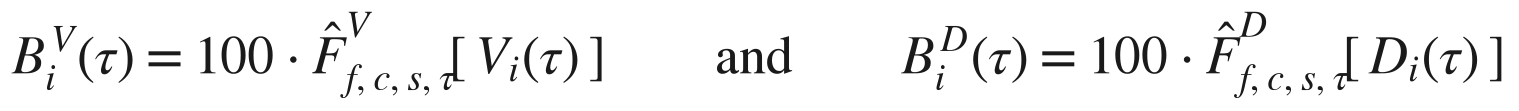
onde V_i(τ) e D_i(τ) são visualizações e downloads acumulados do resumo e F̂^V, F̂^D são as funções de distribuição empíricas desses contagens dentro da classe de referência definida por f, c, s e τ. A definição fixa o estimando, um percentil dentro de uma classe de referência declarada. Nenhum F̂ pode ser escrito hoje, porque as distribuições de referência não existem (Seção 5.1). A fórmula é a especificação que o Estudo 1 e o painel da Seção 8 são projetados para estimar, e a mesma notação é mantida através do design de validação preditiva da Seção 8.9. A normalização percentil e classe de referência é em si um método bibliométrico estabelecido: percentis são uma forma padrão de normalizar as contagens de uma publicação por campo, tipo de documento e ano de publicação [22], com procedimentos dedicados para a normalização de campo e de tempo de indicadores dominados por zeros [23], exatamente o regime que um contador de download ocupa. Normalizar métricas de uso especificamente (downloads e visualizações em vez de citações) contra uma classe de referência é igualmente uma linha de trabalho madura: a literatura de bibliometria de uso há muito tempo trata o impacto baseado em download como uma distribuição a ser condicionada às características da comunidade de usuários e ao marco de amostragem [92][19], e programas de fator de uso de periódico construíram exatamente tais indicadores de uso normalizados a partir de dados compatíveis com COUNTER [137]. A padronização da contagem de uso em si é o assunto de uma infraestrutura madura de praticante, o COUNTER Code of Practice [125]. Os indicadores de leitura normalizados por campo têm um precedente estabelecido comparável na literatura de altmetria [179]. O método é, portanto, estabelecido. A contribuição aqui é sua aplicação a downloads do SSRN e a construção de uma classe de referência estratificada por idade, campo e coorte para um ambiente pós-Rankings.
O estimando é limpo, mas três questões de operacionalização devem ser resolvidas antes de qualquer F̂ ser ajustado. A primeira é a mais consequencial, porque diz respeito ao que o benchmark é para. Condicionar a classe de referência à visibilidade prévia do autor (o estrato s) é correto quando a pergunta é diagnóstica: "como este artigo está se saindo entre artigos comparáveis de autores comparavelmente visíveis?" É exatamente errado quando a pergunta é a questão de equidade de H1–H3, porque normalizar por visibilidade prévia subtrai a lacuna recém-chegado-versus-estabelecido que o marco de equidade existe para medir. Um percentil dentro de s não pode detectar desvantagem de inicialização fria, uma vez que a desvantagem foi condicionada afastada por construção. O framework portanto separa dois usos distintos do CSAB que nunca devem ser condensados em um único número. Como um benchmark descritivo relata a posição de um autor dentro de uma classe de referência totalmente estratificada (incluindo s), o que um autor individual quer no painel. Como um estimando ajustado para H1–H3, remove a visibilidade prévia do conjunto de condicionamento e a trata em vez disso como o preditor de interesse, medindo o gradiente em vez de removê-lo. As duas respostas diferem, elas respondem perguntas diferentes, e qualquer relatório que apresente um percentil normalizado por visibilidade deve indicar qual das duas é. Uma segunda pergunta é o tamanho da amostra. Estratificar por campo × coorte × estrato de visibilidade × oito pontos de idade rapidamente esgota uma amostra de probabilidade de 3.000–5.000 artigos (Seção 8.6): a contagem de células totalmente cruzada atinge milhares, então a maioria das células é minúscula ou vazia. O encolhimento Bayes Empírico em direção a classes de referência mais amplas é nomeado por esta razão (Seções 8.3, 8.8), mas o encolhimento requer sua própria especificação: uma estrutura hierárquica mínima (campo dentro de área ampla, idade dentro de faixa etária aproximada) e uma regra mínima de células pré-especificada para estimação, abaixo da qual uma célula toma emprestado de seu pai em vez de relatar um percentil bruto. Esta regra mínima de célula do lado da estimação é distinta de, e mais rigorosa de raciocinar do que, a regra mínima de célula orientada por privacidade que governa a divulgação pública no Apêndice D; as duas servem propósitos diferentes e são especificadas separadamente. A última pergunta é impulso (Tabela 10), definido como a mudança em uma posição normalizada estimada. Uma pontuação de mudança em uma quantidade estimada propicia regressão à média: um artigo que acaba alto no dia 7 parcialmente por ruído de estimação tenderá a cair até o dia 30 por razões puramente estatísticas. O impulso portanto requer um modelo explícito da trajetória subjacente (por exemplo, um encolhimento ou estimativa Bayes Empírico da posição latente com seu erro de medição propagado) em vez de uma diferença bruta de dois snapshots percentis, e a diferença bruta é relatada, se é que, apenas como um acompanhamento descritivo da quantidade modelada.
Tabela 10. O Benchmark de Atenção Acadêmica de Inicialização Fria (CSAB): cinco dimensões em vez de um único número. Um modelo de relatório copiável em nível de sentença para estas dimensões é fornecido no Apêndice B.
| Dimensão | Métrica | Pergunta central | Interpretação |
|---|---|---|---|
| Alcance | Age/field/cohort/newcomer-normalized view percentile | Públicos relevantes encontraram o artigo? | Descobridibilidade |
| Desempenho de download | Normalized cumulative download percentile | Quantas aquisições de texto completo ocorreram em relação a artigos comparáveis? | Difusão inicial geral |
| Conversão | Downloads conditional on view opportunities (Seção 5.2) | Leitores expostos buscaram o texto completo? | Engajamento condicional |
| Momentum | Change in normalized position or interval-level attention | A difusão está se acelerando, estável ou se desvanecendo? | Trajetória temporal |
| Validação posterior | Later citation or use conditional on early metrics | A atenção inicial previu a absorção subsequente pela comunidade acadêmica? | Validade preditiva |
O framework rejeita qualquer limite bruto universal de "sucesso." O sucesso deve ser definido em relação a um propósito analítico: para descobridibilidade, um percentil de alcance elevado entre artigos da mesma idade e campo; para absorção por leitores, conversão acima da classe de referência condicional à exposição; para difusão, a distribuição conjunta dos dois; para influência científica, citações posteriores ou uso documentado. O uso inicial isolado é insuficiente para esse último propósito, já que downloads iniciais explicam apenas cerca de 16% da variância de citações posteriores [25]. Isso torna exata a interpretação do exemplo do título. Sete downloads é "bom" apenas na medida em que sete downloads coloca o artigo incomumente alto entre artigos comparáveis de outra forma no mesmo estágio de seu ciclo de vida. Um valor no dia 7 e um valor no dia 180 não podem ser avaliados no mesmo benchmark.
Quatro escolhas de design seguem o oitavo princípio do Manifesto de Leiden: que indicadores quantitativos não devem ultrapassar a força das suposições por trás deles, e que falsa precisão é em si mesma uma falha de medição [78]. O framework relata faixas, não pontuações pontuais (Tabela 8); fixa CSAB como um vetor diagnóstico em vez de um alvo (Seção 5.2); desenha suas figuras de saída, o mapa alcance–conversão (Figura 8) e o leque de benchmark (Figura 14), sem escala numérica, de modo que uma forma não possa ser confundida com um valor calibrado; e anexa um nível de verificação e vintage a cada número que usa (Tabela 7). Cada um desses retém precisão que a evidência não pode suportar, como DORA pede da avaliação de pesquisa quando rejeita proxies de número único e marca de revista para a avaliação substantiva do conteúdo de um artigo [8]. Reduzir CSAB de volta a um escore reintroduziria exatamente a falsa precisão contra a qual ambos os documentos advertem.
Para um autor, o relatório CSAB substituiria a simples linha "Downloads: 12," por algo assim: 12 downloads após 14 dias: percentil geral de download entre artigos comparáveis: 67º; percentil de alcance: 39º; percentil de conversão: 81º; interpretação: interesse condicional elevado, exposição abaixo da mediana. Cada número neste protótipo é ilustrativo, já que nenhum percentil desse tipo existe até que as distribuições de referência da Seção 8 sejam estimadas, e nenhum desses valores pode ser citado como um benchmark, mas o formato mostra o que a decomposição compra. A mesma contagem bruta que se lê como uma decepção indiferenciada se desdobra em um diagnóstico específico: leitores que encontram o artigo respondem excepcionalmente bem, mas muito poucos o encontram, portanto a intervenção indicada é distribuição, não revisão. O exemplo trabalhado é o análogo CSAB do quadrante de "interesse oculto" da Tabela 9. O Apêndice B fixa este formato como um modelo de relatório copiável cujos campos percentis permanecem em branco até que as distribuições da Seção 8 existam.
5.6 Trajetórias de leitura: exposição é um tratamento, não ruído de fundo
O componente final do framework é temporal: um artigo recém-publicado não entra em um ambiente de atenção homogêneo. Ele passa por regimes de exposição distintos (publicação → descoberta interna → distribuição por email → indexação externa → difusão em rede), e um total cumulativo reduz esses regimes em um número. Os limites dos regimes são definidos pelo mecanismo da Seção 4: a distribuição de eJournal é curada e pode levar até 45 dias em tópicos de alto volume [53], e a indexação de busca externa pode levar 6–9 meses ou mais [55].
O estado do painel mais produtor de ansiedade decorre diretamente disso: zero downloads na primeira semana é pré-distribuição normal, não rejeição. Antes de o ciclo de anúncio ter terminado, o artigo ainda não foi exposto ao seu público principal. A sequência diagnóstica para um zero inicial é administrativa: confirmar que o artigo está publicamente postado; confirmar a atribuição de eJournal; esperar o ciclo de anúncio terminar; apenas depois ler os contadores. Inversamente, contagens do primeiro mês, uma vez que a distribuição tenha ocorrido, são o indicador precursor mais antigo e mais ruidoso: downloads iniciais correlacionam-se com citações posteriores em aproximadamente r ≈ 0.4 [25], informativos mas longe de um veredicto, e picos iniciais são frequentemente eventos de exposição (cobertura de blog ou mídia) em vez de interesse durável [116][138].
Como a raspagem retrospectiva de contagens cumulativas não pode reconstruir o que um artigo tinha no dia 3 ou no dia 30, a interpretação baseada em trajetória (e a agenda de pesquisa do painel da Seção 8) requer observação desde a publicação em uma grade padronizada. A Tabela 11 especifica o cronograma mínimo. Funciona também como um modelo de auto-rastreamento para autores individuais. Uma trajetória é classificada apenas provisoriamente nas leituras de 60 e 90 dias da grade da Tabela 11 e com confiança na leitura de 180 dias, nunca no dia 7.
Tabela 11. Cronograma de observação longitudinal mínima para artigos do SSRN.
| Idade do artigo | Propósito central da observação |
|---|---|
| Dia 1 | Exposição imediata da plataforma |
| Dia 3 | Descoberta muito cedo |
| Dia 7 | Referência da primeira semana (valor esperado para a maioria dos artigos: zero ou próximo a zero, pré-distribuição) |
| Dia 14 | Estabilização inicial |
| Dia 30 | Referência do primeiro mês |
| Dia 60 | Maturação de distribuição e busca (ciclos de eJournal completos [53]) |
| Dia 90 | Difusão inicial de médio prazo |
| Dia 180 | Transição em direção à medição de impacto a jusante |
Quando viável, a observação diária nos primeiros 45 dias é preferível, porque a distribuição por email pode ocorrer em horários variáveis dentro dessa janela [53]. Leituras em nível de intervalo nesta grade convertem o painel de um veredicto estático para uma trajetória, a única forma em que métricas SSRN iniciais carregam informações defensáveis.
As Seções 4 e 5 substituem a pergunta que um autor não pode responder ("7 downloads é bom?") por quatro que o registro publicado pode sustentar: onde fica a contagem em comparação com o mapa de referência e seus períodos (5.1, 5.3); a conversão está dentro da faixa empírica (5.2); qual quadrante do plano alcance–conversão o artigo ocupa (5.4); e o que a trajetória na grade de observação mostra (5.6)? Nenhuma dessas perguntas requer os Rankings desativados, mas todas elas requerem os dados comparativos cuja coleta as seções finais deste artigo propõem.
6. Um Manual Prático para Autores
O mapa de referência da Seção 5 (Tabela 7) restaura a escala ausente, e esta seção o coloca em funcionamento para o autor que abre o painel de estatísticas após 15 de julho de 2026 e vê contagens sem contexto [148][149]. Ele tem quatro tarefas em sequência: uma rotina para observar seus próprios contadores (6.1–6.2), substitutos para o quadro comparativo que os rankings costumavam fornecer (6.3), alavancas que podem legitimamente melhorar a visibilidade (6.4), e um protocolo para converter contadores em evidência de carreira defensável (6.5–6.6). Cada âncora numérica usada aqui rastreia uma fonte publicada com um quadro de amostragem explícito e janela de tempo; a Tabela 7 as consolida. Práticas circulando na comunidade de autores que carecem de apoio de evidência são marcadas como não verificadas sempre que aparecem e são coletadas, como hipóteses candidatas para teste, no final do Apêndice A.
A Tabela 12 comprime o núcleo do manual em um protocolo de sete perguntas, feitas em ordem, cada uma emparelhada com a evidência que vale a pena preservar e a conclusão mais forte que a resposta pode legitimamente justificar. As Seções 6.1–6.2 desdobram este protocolo em rotinas e regras de leitura, e a Tabela 23 (Apêndice A) permanece como seu companheiro situacional, indexado pelos estados do painel que os autores realmente encontram.
Tabela 12. Um protocolo de autor para interpretar um contador SSRN: sete perguntas, a evidência a preservar, e a conclusão permissível. Nenhuma etapa trata um contador como um escore de qualidade; a coluna final indica o máximo que cada resposta pode sustentar.
| Etapa | Pergunta | Evidência a preservar | Conclusão permissível |
|---|---|---|---|
| 1 | Qual era a idade do artigo quando a contagem foi observada? | Screenshot ou exportação datada, mais a data de publicação | Uma observação específica de tempo, não um veredicto vitalício |
| 2 | A distribuição curada e a indexação externa ocorreram? | Aviso de distribuição e data onde disponível; status de índice de busca | Identificação do regime pré- versus pós-exposição (Seção 5.6) |
| 3 | Qual é a relação entre visualizações, downloads e conversão? | Ambos os contadores e o denominador | Um diagnóstico de alcance-versus-engajamento-condicional (Tabela 9), não um único veredicto |
| 4 | Qual é a classe de referência defensável mais estreita? | Campo, coorte, idade do artigo, status de novato, histórico de classificação | Posição relativa apenas dentro dessa classe (Seção 5.5) |
| 5 | A trajetória está mudando? | Observações repetidas nas idades fixas da Tabela 11 | Momentum ou platô, sujeito a eventos de exposição — não aceleração de "qualidade" |
| 6 | Há corroboração a jusante? | Citações, contatos significativos, publicação ou uso documentado | Evidência estratificada de adoção, não prova de qualidade |
| 7 | A afirmação pode ser reproduzida? | Fonte, data, regra de contagem, registro arquivado | Um relatório auditável, não um marco sem suporte |
6.1 Uma rotina de medição
A interpretação começa com um registro disciplinado, porque SSRN exibe apenas contagens cumulativas atuais e nenhum histórico sob o controle do autor. Seis etapas, aplicadas a partir do dia da postagem, produzem o registro mínimo que toda inferência posterior requer.
1. Registre ambos os contadores e sua razão. Anote visualizações abstratas, downloads e a razão de conversão de downloads para visualizações em intervalos fixos. A grade de observação da Tabela 11 (dias 1, 3, 7, 14, 30, 60, 90, 180) especifica o cronograma e o propósito de cada leitura. Uma captura de tela datada em cada intervalo é a única versão de registro que o autor controla, pois os contadores da plataforma podem ser reapresentados quando as regras de filtragem mudam [144][69]. O registro acumulado é um pacote de evidências versionado: a versão do manuscrito, seus metadados e classificações, capturas de painel datadas, avisos de distribuição, um log datado dos próprios eventos de promoção do autor (um tópico postado, uma palestra, um anúncio de lista de distribuição) e posteriores citações e contatos substanciais. O log de promoção é importante porque as promoções são tratamentos de exposição. Sem um registro datado de sua própria publicidade, um autor não pode distinguir um pico orgânico de um auto-gerado, e ninguém auditando a reivindicação (Seção 8.3) pode fazê-lo.
2. Normalize pelo tempo desde a postagem. Expresse o desempenho inicial como downloads por mês durante os primeiros três a seis meses em vez de uma contagem cumulativa bruta. Um artigo de três meses de idade comparado com os totais históricos de trabalhos mais antigos produz conclusões sistematicamente enganosas, porque os contadores se acumulam ao longo da vida de um artigo em uma plataforma cujo volume anual de downloads cresceu de aproximadamente 12.9 milhões em 2016 para 40.6 milhões em 2023 [1].
3. Nunca misture janelas de observação. Uma contagem semanal não pode ser comparada a uma média de doze meses, e uma contagem de 90 dias não pode ser comparada aos totais históricos. Cada comparação neste guia pareia janelas similares com similares. Violações dessa regra estavam entre os erros interpretativos mais comuns no uso pré-encerramento de estatísticas de classificação [161].
4. Situe o artigo em seu contexto disciplinar, não contra a plataforma. Os downloads médios por artigo diferiram por um fator de aproximadamente oito apenas nas eJournals da Legal Scholarship Network (438.35 em Corporate/Securities/Finance versus 53.48 em Agricultural Law, dados de 2018) [168]. Uma contagem que é insignificante em um subcampo é excepcional em outro. A classe de referência relevante é a própria eJournal ou rede temática do artigo, examinada na mesma idade do artigo.
5. Não sobre-interprete contagens únicas pequenas. A literatura de integridade coloca um teto na precisão de contadores de uso: downloads reportados pela editora podem ser o dobro dos de plataformas comparáveis [176], filtros de plataforma descartam uma grande parte do tráfego bruto [99][129][144], e sem tais filtros os próprios contadores do SSRN seriam inflados "por um fator de cinco ou mais" [18]. Pequenas diferenças entre números comparáveis portanto não contêm informação.
6. Monitore o acúmulo de longo prazo em vez de reagir a figuras iniciais. A atenção em plataformas de working papers se concentra no início [116][28] (a última descoberta deriva de dados do NBER em vez de SSRN), mas camadas de descoberta amadurecem lentamente: SSRN relata que a indexação do Google Scholar leva "6–9 meses ou mais" [55]. A leitura, além disso, decai em várias escalas de tempo simultaneamente, e leitura e citação não precisam seguir o mesmo processo temporal [91], portanto nenhuma leitura única de "meia-vida" de sua própria curva é segura. Uma trajetória pode ser classificada provisoriamente nas leituras de 60–90 dias da grade da Tabela 11 e com mais confiança em 180 dias, nunca na leitura do dia 7.
6.2 Cinco regras para ler o painel
Com esse registro em mãos, a evidência distributiva da Seção 5 se resume a cinco regras práticas para ler um painel diariamente.
(i) Compare com medianas, não com médias ou estrelas visíveis. A única amostra de estilo censitário de artigos ordinários coloca a mediana em 63 downloads e 369 visualizações de resumo após dois anos (LSN, artigos publicados em 2012) [139]. Na única amostra recente publicada, a mediana é 87 downloads, em contraste com uma média de 221,3 que fica acima até do percentil 75 (Section 3.3) [83]. Os números de referência que circulam provêm da cauda visível, cujos máximos de 2015 chegaram a centenas de milhares de downloads (Section 3.5) [85]; um autor que se calibra contra eles está se calibrando contra a cauda de uma distribuição quase-lognormal, o que garante má calibração. A média em toda a plataforma de ~222 downloads ao longo da vida por artigo calculada a partir de agregados de dezembro de 2023 [1] é tão inútil quanto uma medida pessoal.
(ii) Verifique a taxa de conversão, não apenas a contagem. Medições independentes convergem para uma faixa normal de aproximadamente 11–19% downloads por visualização de resumo: a média de 18,7% e mediana de 17,1% da amostra LSN [139], e as figuras de 15% (artigos mais citados) e 11% (artigos de citação única) dos estudos de citação jurídica [172]. A regra prática de longa data do SSRN de três visualizações por download [18] fica acima dessa faixa, em vez de dentro dela. A amostra recente do Marketing-network fica ligeiramente acima dessa faixa, com uma média de 23,7 downloads por 100 visualizações [83]. A Figura 6 plota as estimativas juntas. Execute o exemplo trabalhado central da Seção 5.2 através da regra: as 40 visualizações de resumo do título e 7 downloads convertem para 17,5%, dentro da faixa como uma estimativa pontual, mas com um intervalo de Clopper–Pearson de 95% amplo (≈7,3–32,8%). A n = 40, a leitura não é falha e não é um percentil preciso: um resultado de triagem consistente com conversão ordinária. Conversão muito abaixo da faixa é consistente com uma incompatibilidade entre o resumo e o artigo, onde leitores chegam, leem o resumo e saem. Isso é acionável, e a ação é revisar o título e o resumo. Conversão muito acima da faixa sinaliza tráfego que a navegação de resumo não explica, como links diretos de mídia ou cobertura de agregador, e deve levar a uma verificação de onde as visualizações se originam. Ambas as leituras são diagnósticos de triagem: nenhum estudo validou causalmente a inferência de baixa conversão para qualidade de resumo, e o diagnóstico deve ser registrado como uma hipótese sobre o próprio artigo de alguém.
(iii) Trate downloads do primeiro mês como o sinal de citação mais antigo e mais ruidoso. Downloads iniciais se correlacionam com citações posteriores em aproximadamente r ≈ 0,4 nos dados do arXiv, o que os próprios autores originais traduzem em apenas cerca de 16% de variância explicada [25]. O sinal mais antigo em registro é biomédico: contagens de acesso online na primeira semana após a publicação no BMJ se correlacionaram em aproximadamente 0,50 com citações acumuladas nos anos seguintes [119]. Na jurisprudência, Black e Caron relataram correlações downloads–citações em nível de artigo na ordem de 0,50, subindo para cerca de 0,55 em uma amostra de cem professores de direito juniores [18]. Em campos e horizontes diferentes, as correlações em nível de artigo variam de aproximadamente 0,1 a 0,6 [80][25], e as contagens de download do arXiv perdem significância estatística como preditores uma vez que a atenção contemporânea do Twitter é controlada [138]. No nível agregado, a associação se intensifica: 0,84 entre rankings baseados em download e baseados em citação de cem faculdades de direito [77], e R = 0,724 entre downloads de PDF de seis meses e citações posteriores na análise do próprio periódico [114]. Essas figuras agregadas não estabelecem onde qualquer artigo individual terminará, e um primeiro mês de downloads é um sinal antecipado sobre citações posteriores.
(iv) Zero downloads na primeira semana é pré-distribuição normal, não rejeição. Um artigo recém-publicado ganha atenção apenas depois que passa pela moderação, é classificado em eJournals de assunto e entra no ciclo de anúncio. A documentação própria do SSRN descreve a classificação como curada em vez de garantida, com atrasos de até 45 dias para tópicos muito carregados [53], e distribuições de eJournal e alertas de email foram explicitamente confirmados como continuando inalterados após o encerramento [147][57]. A sequência diagnóstica é: confirme que o artigo está publicado publicamente, confirme a classificação do eJournal, aguarde o ciclo de anúncio, e leia os contadores apenas após isso. A descoberta através de mecanismos de busca chega ainda mais tarde [55].
(v) Um contador em queda ou plano pode refletir filtragem, não perda de leitores. O SSRN documenta publicamente que descarta downloads aparentemente repetidos, downloads de robô e outras atividades irregulares [144][66][69]. A experiência do RePEc/LogEc mostra como essas correções podem ser grandes: em julho de 2007, robôs representavam aproximadamente 74% das visualizações de resumo, mas apenas cerca de 7% dos downloads [99], e em setembro de 2025, mais de 99,5% do tráfego bruto do IDEAS foi descartado em meio à interferência de bot de IA [129]. Uma queda súbita ou uma reafirmação, portanto, é tão provável de ser um evento de medição quanto um evento de leitura, e nunca deve ser interpretada como perda de reputação sem corroboração.
6.3 Avaliação Comparativa sem Classificações
As classificações forneceram uma estrutura comparativa. Um autor atualmente tem três substitutos para isso, ordenados do menor trabalho para o maior.
Micro-Comparações de Desempenho. O substituto mais direto é um grupo de referência que se constrói por conta própria: identifique de três a cinco trabalhos metodologicamente comparáveis de colegas em instituições comparáveis, publicados no mesmo mês, e acompanhe seus contadores públicos no mesmo cronograma da Tabela 11 que o seu. O resultado é uma linha de base percentil localizada contra exatamente a classe de referência correta, correspondida por construção para campo, idade do artigo e era da plataforma, onde as classificações aposentadas comparavam artigos de todas as idades e campos em uma única escala. É um procedimento proposto que utiliza apenas contagens públicas por artigo e deve ser registrado como tal em qualquer uso de dossiê. Também pressupõe certa familiaridade com a literatura de pares que os autores mais isolados que chegam, precisamente aqueles aos quais a condição de início frio mais afeta, podem não possuir. Para eles, a solução do lado da plataforma da Seção 10.4 (bandas percentis anônimas) é o ajuste estrutural, pois não requer nenhuma rede auto-organizada para ser usada.
Uma razão de desempenho relativo. A mesma lógica pode ser expressa como um único número: a razão entre os downloads de um artigo em uma determinada idade e os downloads medianos de uma coorte emparelhada, significando a mesma disciplina, a mesma idade do artigo e, se possível, o mesmo tipo de artigo. Uma razão de 1,0 significa exatamente visibilidade mediana para a coorte, e valores acima ou abaixo de 1,0 são lidos de acordo. O índice ordena artigos dentro de uma coorte emparelhada; as bandas percentis aguardam a distribuição de referência. As medianas publicadas a partir das quais uma linha de base de coorte poderia ser construída são antigas e estreitas (63 downloads em dois anos para bolsas de direito publicadas em 2012 [139], 87 para artigos de marketing observados em 2025 [83]), e mapear valores de razão em percentis requer a distribuição completa, não apenas a mediana. Atribuir rótulos percentis às bandas de razão sem essa distribuição produz falsa precisão. A agenda pré-registrada da Seção 8 inclui calibração das bandas; até então, a razão é um dispositivo de ordenação, não uma escala de classificação. Dois cuidados adicionais limitam o dispositivo. Ele não deve ser calculado em contagens pequenas, uma vez que a instabilidade de pequeno denominador da Seção 5.2 se aplica tanto ao numerador da razão quanto à mediana fina da coorte, e a contração empírica de Bayes (Seções 8.3, 8.8) é o ajuste apropriado sempre que tal razão é relatada publicamente. Uma razão dada não se traduz em um percentil fixo: "duas vezes a mediana da coorte" corresponde a diferentes posições de percentis em distribuições de formas diferentes, portanto, a razão ordena artigos dentro de uma coorte, mas não pode ser comparada entre coortes ou eras cujas formas de distribuição diferem.
Linguagem de Veredicto para Trajetórias. Ferramentas voltadas para a comunidade propuseram classificar a trajetória inicial de um artigo em três veredictos qualitativos (início rápido, interesse constante, início lento) como uma alternativa humanitária aos números brutos. O vocabulário vale a pena reter, pois converte uma contagem em uma declaração sobre uma trajetória, e "início lento" explicitamente não é sinônimo de fracasso. Os limites originalmente propostos para esses veredictos dependiam de comparações de janelas de tempo não correspondentes e de uma estatística "média de rede" em toda a plataforma que não existe como uma métrica pública: SSRN não oferece API pública de autoatendimento nem um endpoint de estatísticas [51], e a métrica histórica mais próxima ("Novos Downloads Por Artigo", uma estatística de classificação em nível de autor) foi descontinuada junto com as classificações ([B-9], citada com a ressalva de que as páginas históricas de classificação não estão mais acessíveis). Atribua veredictos, portanto, apenas a partir de comparações correspondidas: o grupo de micro-comparação de desempenho ou a razão mediana de coorte acima, lida não antes da marca de 60–90 dias.
Qualquer que seja o substituto utilizado, a triangulação externa o fortalece. Os dados da camada de citação do Crossref e OpenAlex [35][124] e os indicadores PlumX exibidos nas páginas SSRN [50] respondem a uma pergunta diferente, sobre o uso posterior em vez da visibilidade. Uma ferramenta de citação política como Overton estende a mesma triangulação ao alcance de política e prática mapeando onde um artigo é citado em documentos governamentais e institucionais [187], o que se adequa à base de lei, economia e política do SSRN. Essas camadas são examinadas conjuntamente com os contadores no marco CSAB da Tabela 10 e os diagnósticos alcance-conversão da Tabela 9. Os indicadores Altmetric são uma camada adicional de triangulação. Concebidos desde o início como sinais de atenção precoce [123][122], eles seguem padrões distintos de citações [74][20] e admitem normalização de campo [21]. Eles também são vulneráveis à inflação automatizada [75] e exigem interpretação orientada pela teoria em vez de leitura pelo valor nominal [76].
6.4 Melhorando a visibilidade legítima
Antes do pôr do sol, os Rankings forneceram feedback bruto mas real para uma decisão autoral recorrente: se a promoção adicional de um artigo valia o esforço (Seção 1.3). Após o pôr do sol, essa decisão tem de ser tomada a partir das alavancas e diagnósticos aqui reunidos. A literatura de determinantes identifica um pequeno conjunto de alavancas sob o controle do autor e consistentes com as regras da plataforma. Cada uma age sobre a visibilidade, não sobre a qualidade, e nenhuma muda o conteúdo do artigo. Disseminação rápida e feedback precoce estão entre os objetivos reconhecidos do depósito de preprints na literatura metodológica sobre preprints [24], e um manual para visibilidade legítima utiliza essa função declarada.
Embalagem. Na amostra do LSN, características do título, comprimento do resumo e saliência do tópico foram significativamente associados à atenção, com a ressalva do próprio autor de que essas variáveis podem ser proxies para qualidade não observável [139]. Nos estudos de citação legal, artigos no primeiro decil tinham mais palavras-chave e resumos mais longos do que artigos no último decil [172] (as contagens específicas aguardam verificação em relação ao original). A página do resumo é a superfície de conversão em que a regra (ii) opera, então quando a conversão fica persistentemente abaixo da faixa, o título e o resumo são as primeiras coisas a revisar. Qualquer revisão desse tipo visa o alinhamento entre promessa e conteúdo, não tráfego indiscriminado: reescrever um resumo já claro para maximizar cliques pode danificar sua precisão e, ao atrair visitantes inadequados, pode afastar a conversão da faixa em vez de aproximá-la.
Classificação. Artigos classificados em mais eJournals tiveram média de mais downloads e menos resultados de zero downloads na análise do LSN de 2018 [168]. A SSRN permite de uma a sete classificações por artigo e realiza curadoria de sua inclusão [53]. Um refinamento popular da comunidade, não verificado porque nenhum estudo compara estratégias de classificação, limita as classificações a três, escolhidas como uma de núcleo, uma ampla e uma interdisciplinar; esse conselho pertence entre as hipóteses testáveis do Apêndice A.
Distribuição e atenção externa. O alerta de email eJournal permanece como o principal canal de push da plataforma e continua após o pôr do sol [147][57][152]. Fora da plataforma, cobertura de blog produziu picos de download precoces agudos no único teste empírico da questão [116], posição visível na lista aumentou a leitura e citações nos estudos posicionais do arXiv [72], e participação em conferência foi associada a downloads adicionais de 17–26 por artigo em um estudo quase-experimental construído em torno de uma reunião de ciência política cancelada ([B-4], citado com a ressalva de que o cenário é APSA 2012, não uma amostra SSRN-economics). Guias práticos coletam ferramentas de distribuição adicionais para pesquisa jurídica [169]. O caso para disseminação aberta precoce é independentemente estabelecido: um ensaio randomizado de acesso aberto encontrou mais downloads, embora nenhum ganho de citação de curto prazo [37], enquanto estudos de coorte e de campo relatam vantagens de citação de aproximadamente 10% até duas vezes [59][86][17][93], incluindo +53% para revisões de direito americano [40], e uma auditoria de citações legais descobriu que 87% dos artigos mais citados estavam disponíveis na SSRN versus 44–46% de artigos pouco citados, com 95% do grupo mais citado postado na SSRN em ou antes de seu ano de publicação [172]. Depósito de preprint está associado com citações mais altas e downloads de site do editor mais baixos no arXiv [38], e downloads do bioRxiv correlacionam com resultados de periódico [62]. No censo de todos os preprints do bioRxiv, contagens de downloads correlacionam com o fator de impacto do periódico no qual um preprint é publicado posteriormente (Kendall τb = 0,59), uma associação cuja direção de causalidade é desconhecida [2]. Camadas de descoberta de máquina (motores de busca e motores de resposta generativa) são tratadas separadamente no quadro de auditoria da Seção 8 e na agenda de auditoria de recursos da Tabela 20 [5][164].
Higiene de versionamento. Revisões enviadas para a mesma página da SSRN preservam os contadores acumulados e a URL estável, enquanto deletar e re-postar reseta as métricas para zero ([B-7], citado com a ressalva de que a redação da página de suporte muda ao longo do tempo e deve ser re-verificada no envio). A afirmação adicional da comunidade de que uma revisão menor no dia 3 ativa re-anúncio e uma "segunda onda" de atenção é não documentada e fica entre as práticas não verificadas no Apêndice A. A identidade precisa do mesmo cuidado. Vincular um iD ORCID verificado ao perfil do autor da SSRN mantém os artigos e seus contadores anexados à pessoa correta em vez de a um homônimo, e é uma proteção de baixo custo contra o problema de desambiguação de autor que o design de painel da Seção 8.3 deve resolver estatisticamente ([B-7], mesma ressalva de re-verificação).
O que não fazer. Auto-download e manipulação relacionada estão documentados nos próprios logs de servidor da SSRN, intensificados perto de limites de lista superior, e foram impulsionados por comparação social [44]. Os filtros de fraude da plataforma são públicos [144][69], e comitês de avaliação cientes dessa história desconsideram reivindicações não apoiadas. Então a literatura sobre gaming carrega um aviso prático ao lado do de integridade: contadores manipulados são detectáveis e dispendiosos em reputação. A Figura 9 ilustra a assinatura temporal em questão em dados simulados. A atenção orgânica se acumula como um pico inicial com uma cauda longa, enquanto manipulação produz picos concentrados exatamente do tipo que filtros de integridade são projetados para flagrar [144][69].
Figura 9. Acumulação orgânica versus um pico de manipulação. Uma trajetória de download orgânico suave contrastada com um pico de um único dia abrupto característico de auto-download, motivando o aviso de manipulação da Seção 6.4 e a discussão de integridade da Seção 4 [44][69][144]. Todos os dados mostrados são simulados; não existe um dataset empírico de detecção de anomalias para a SSRN.
6.5 Convertendo contadores em evidência de carreira: o protocolo de dossiê
Antes do encerramento, a evidência baseada em classificação do SSRN era um componente de dossiê padronizado. A classificação pública de um autor era inserida diretamente em arquivos de promoção: "classificado em 13º lugar entre 3.000 autores jurídicos no número total de downloads de todos os tempos, que a faculdade de direito levou em conta em várias decisões de promoção e relacionadas" [12]. Guias de cartas de apresentação recomendavam citar contagens de downloads e aparições em listas Top Ten [95], orientação de praticantes simultaneamente advertia que trabalho auto-publicado "provavelmente não será levado em conta para fins de promoção e tenure da faculdade de direito" [33], e a documentação própria da plataforma descrevia suas métricas como dados "que os autores usam para fins de promoção e tenure e que as instituições usam em suas atividades de contratação e classificação" [52]. Cada um desses artefatos pressupunha um marco comparativo público que não existe mais [149]. O uso avaliativo dos contadores foi contestado desde sua primeira proposta: o argumento de Black e Caron de 2006 para downloads como uma medida "beta" de desempenho acadêmico [18] foi respondido no mesmo volume de simpósio pela crítica de Eisenberg sobre o que os rankings baseados em SSRN podem validamente medir [45]. Um dossiê que cita downloads herda esse debate não resolvido. A Tabela 13 apresenta um protocolo de sete etapas para reconstruir evidência defensável do que permanece, e seu requisito governante, aplicado na terceira e quarta colunas, é que cada número citado em um dossiê deve acompanhar sua fonte, sua janela de tempo e suas limitações. Uma alegação que se cristaliza em precisão sem fonte é pior do que não fazer alegação alguma.
Tabela 13. Protocolo de evidência pós-encerramento para métricas de SSRN em dossiês de tenure, promoção e contratação. Cada etapa nomeia a ação, a base de evidência com sua janela de tempo, a limitação que deve ser divulgada junto a qualquer número, o antipadrão a evitar, e a conclusão mais forte que a etapa pode fundamentar.
| Etapa | Ação | Base probatória (fonte; janela de tempo) | Limitações a divulgar | Evitar | Conclusão permissível |
|---|---|---|---|---|---|
| 1. Preservar | Arquive capturas de tela com data de cada painel de estatísticas do artigo e do perfil do autor nos intervalos da Tabela 11 e antes de qualquer envio; reúna-as, com avisos de distribuição e um registro datado dos eventos de promoção do próprio autor, no pacote de evidência versionado da Seção 6.1. | Os contadores por artigo sobrevivem ao encerramento ([148][149]; 2026). Os contadores podem ser reafirmados quando as regras de filtragem mudam ([144][69]; documentado desde 2018). | Um arquivo pessoal datado é a única versão de registro sob o controle do autor; os números da plataforma são revisáveis e nenhum histórico público existe. | "O artigo tem X downloads" — citado sem data ou denominador. | Um registro datado e auditável do que a plataforma exibiu — uma observação específica do momento, não um veredito vitalício. |
| 2. Traduzir | Converter contagens em linguagem de faixas usando a Tabela 8 (por exemplo, "downloads ao longo da vida acima do limiar de entrada de ~160 da lista Top-10.000 de artigos de 2015, ou seja, aproximadamente os 1,8% principais do acervo de artigos em texto completo da plataforma, 571.040 em julho de 2016 [1], naquele momento"), sempre nomeando fonte, amostra e ano; o modelo CSAB do Apêndice B fornece o formato no nível da sentença, com seus campos de percentis deixados em branco até que um painel de referência exista. | Limiares no nível do artigo: entrada ≥160, mediana intragrupo 805 (extração da lista principal; 2015) [85]. Nível do autor: mínimo de entrada 129 downloads totais, mediana intragrupo 1.626 (mesma extração) [85]. Âncoras de artigo típico: mediana 63 em dois anos (LSN; 2012→2014) [139]; mediana 87 (Marketing network; instantâneo 2025) [83]. | Todos os limiares derivam de amostras de 2012–2015 (inflação desde então [1]: Seção 5.1); o quadro de 2015 cobre apenas listas principais; as duas âncoras medianas são de uma única disciplina. A linguagem de faixas não deve ser reformulada como um percentil calibrado. | Rótulos universais como "excelente" pendurados em um limiar bruto antigo. | Posicionamento relativo dentro da amostra, campo e ano nomeados — nada mais amplo. |
| 3. Triangular | Emparelhe contadores SSRN com evidência de citação independente: Google Scholar, HeinOnline para direito, RePEc para economia, Crossref/OpenAlex como camadas de citação abertas, PlumX conforme exibido em SSRN. | As classificações de download SSRN e citação HeinOnline no nível escolar correlacionam-se a 0,84 (100 faculdades de direito dos EUA; 2019) [77]; as correlações de download–citação no nível do artigo funcionam em ~0,1–0,6 dependendo do campo e do horizonte [80][25]; infraestrutura de citação aberta [35][124]; PlumX [50]. | A figura de 0,84 é uma correlação no nível escolar e não desce para nenhum artigo ou autor individual (cautela de inferência ecológica, Seção 6.2(iii)); downloads medem demanda, não leitura ou endosso; as correlações no nível do artigo são modestas, e os conjuntos muito descarregados e muito citados se sobrepõem apenas parcialmente [108]. Evidência de citação convergente, não apenas o contador, sustenta a afirmação de impacto. | Equacionar um download com endosso ou correção. | Evidência em camadas de adoção, não prova de qualidade. |
| 4. Normalizar por campo | Declare o quadro disciplinar explicitamente (por exemplo, "dentro da literatura de direito corporativo, onde as médias de eJournal diferem aproximadamente por um fator de oito entre os subcampos legais"). | Médias de subcampo 438,35 vs. 53,48 downloads/artigo (LSN eJournals; 2018) [168]; as razões de downloads para citações são elas próprias estruturadas por campo [18]. | A estimativa de dispersão é apenas de direito e datada de 2018; a transferência interdisciplinar de qualquer limiar requer cautela, e a linguagem de percentis sem um qualificador de campo é ininterpretável. | Comparar um artigo novo com um total cumulativo de vários anos, ou transplantar um limiar entre campos. | Uma comparação qualificada por campo e idade — nunca uma nota universal. |
| 5. Complementar | Cite repositórios institucionais e outros canais de distribuição junto com SSRN. | Os contadores SSRN não dizem nada sobre downloads do mesmo artigo de outros serviços [161]; as reformas de 2026 fizeram da série baseada em repositório o caminho de migração para distribuição institucional [47][146]. | O contador de nenhuma plataforma única mede a circulação total de um artigo; a afirmação do dossiê é sobre o artigo, não sobre um contador. | Apresentar o contador de uma plataforma como a circulação total do artigo. | Uma reivindicação sobre a circulação do artigo, com o contador de cada canal nomeado separadamente. |
| 6. Integridade | Enuncie a regra de contagem da plataforma junto com qualquer contagem citada e mantenha o arquivo datado que documenta o número conforme exibido. | Filtragem e reformulação são comportamentos documentados da plataforma ([144][69][66]; em andamento); as estatísticas de download informadas pelo fornecedor dependem de convenções de contagem ([69][176]; 2015–2019). | Contadores são estimativas filtradas e revisáveis; nenhum histórico de reformulação pública existe, portanto o arquivo datado do autor é o único registro estável. | Tratar contadores como números exatos de leitores humanos únicos. | Uma estimativa filtrada sob uma regra declarada em uma data declarada — não um censo de leitores. |
| 7. Avaliação de especialistas | Apresente cada linha de métrica como contexto para avaliação qualitativa da contribuição e rigor do trabalho, nunca como seu substituto. | Métricas medem estágios de difusão, não validade (Seções 3.1, 5.5); conjuntos altamente baixados e altamente citados se sobrepõem apenas parcialmente [108]. | Nenhuma métrica de uso, normalizada ou bruta, avalia se a pesquisa está correta ou é importante. | Substituição de métrica por julgamento entre pares. | Evidência contextual acompanhando revisão de especialistas — a reivindicação de qualidade repousa na revisão, não no número. |
A coluna Evitar coleta os anti-padrões do protocolo. Dois avisos delimitam o protocolo como um todo. Um download registra demanda passiva em vez de leitura, endosso ou qualidade, e as contagens respondem à dinâmica de publicidade (cobertura de blog, títulos salientes, ondas temáticas) tanto quanto à pesquisa [116][139][138]. Comitês que conhecem o registro de manipulação [44] desconsiderarão números não suportados, e os ingredientes que sobrevivem a essa desconsideração são exatamente os que o protocolo exige: capturas de tela datadas, linguagem de banda com fontes anexadas, qualificadores de campo e triangulação.
6.6 O corolário da solicitação
A postagem tem um efeito colateral documentado que nenhum painel de controle reporta: convites não solicitados de periódicos e conferências predatórias, produzidos pela coleta de nomes, afiliações e títulos de artigos de plataformas de preprints [107][159]. O volume é substancial em auditorias adjacentes, onde estudos especializados documentam fluxos de convites variando de dezenas por acadêmico a cada quinze dias a milhares por grupo de especialidade por mês (Seção 7.2) [9][84][63]. O primeiro contato com um periódico predatório é um e-mail não solicitado em cerca de 41% dos casos pesquisados [32]. A Seção 7 e a Tabela 14 analisam o fenômeno. Para o guia prático, as consequências se reduzem a quatro instruções. Espere por solicitações como uma consequência padrão da visibilidade e nunca interprete seu volume como reconhecimento acadêmico: os remetentes visam a visibilidade mecanicamente, não o mérito seletivamente [159][63]. Direcione a correspondência através de um endereço dedicado para que a coleta não contamine a caixa de entrada principal; um refinamento amplamente repetido, ocultando o endereço de e-mail do perfil pelas primeiras duas semanas após a postagem, é uma prática não verificada (Apêndice A). Nunca pague, porque o modelo de negócio é a taxa, com custos de processamento de artigos em veículos predatórios auditados variando de $25 a $1.800 [136]. O dinheiro é a menor aposta: os mesmos comitês de avaliação que analisam os dossiês (Seção 6.5) também leem as bibliografias e um veículo predatório conhecido em uma lista de publicações impõe um custo reputacional que perdura mais do que qualquer taxa. Verifique qualquer veículo convidador contra um serviço de triagem mantido, como Cabells Predatory Reports ([B-1]; a lista de Beall não foi atualizada desde janeiro de 2017 e não deve ser usada como uma fonte ativa) e contra as listas de verificação de Think. Check. Submit. O mecanismo de coleta também fornece uma triagem qualitativa: um periódico que envia um convite por e-mail dentro de dias após a postagem de um preprint, antes que qualquer leitor pudesse plausavelmente ter lido, é extremamente improvável que seja legítimo. Essa é uma heurística; nenhum estudo mediu sua incidência [63].
6.7 Escopo do manual
As âncoras do manual datam de 2012 a 2015 e são fortemente focadas em aspectos legais e de marketing [139][85][83][1]. O fluxo de downloads por artigo aumentou desde então (Seção 5.1). Dados percentilares estratificados por campo, recentes, ainda não existem; sua coleta, pela plataforma ou pela comunidade, é objeto das Seções 8 e 10. O manual reduz leituras errôneas e não mede qualidade. Quatro regras tornam seu uso mecânico: comparar casos pareados, manter a janela de observação constante, anexar uma fonte a cada número e rotular uma hipótese como uma hipótese.
7. A Camada Parasitária de Atenção: Visibilidade e Solicitação Predatória
O marco interpretativo desenvolvido até agora trata a atenção como um único funil que vai da exposição à visualização do resumo, ao download e ao uso subsequente. A experiência vivenciada de publicar um preprint, porém, frequentemente inclui um segundo fluxo de "atenção" que chega por um canal completamente diferente: convites por email não solicitados de periódicos, conferências e serviços editoriais de legitimidade questionável [14][61][117][142]. A seguir vem uma descrição conceitual desse segundo fluxo, juntamente com as evidências de auditoria para sua escala documentada.
7.1 Um Modelo de Atenção de Duas Camadas
O ambiente pós-publicação é tratado aqui como uma economia de atenção de duas camadas (Figura 10). A Camada 1 é o funil legítimo descrito nas Seções 4 e 6: distribuição de eJournal, visualizações de resumos, downloads e uso acadêmico eventual. A Camada 2 é uma camada parasitária, um ecossistema de editoras predatórias e provedores de serviços que se alimentam da mesma infraestrutura pública (títulos, resumos, nomes dos autores e afiliações) e visam converter autores em clientes pagantes, não para ler seus trabalhos. A literatura de solicitação-auditoria documenta o ciclo de vida. Metadados de pré-impressão públicos (títulos SSRN, resumos, nomes dos autores e afiliações) são colhidos [107][159], convites miméticos que espelham chamadas legítimas de artigos são enviados [61][63], e autores que se envolvem são convertidos em clientes pagantes. O motor econômico também está documentado: taxas de processamento de artigos em periódicos supostamente predatórios chegam em média a cerca de $178, com uma faixa relatada de $25–$1.800 [136].
A assimetria entre as duas camadas é importante para a interpretação. A Camada 1 requer que um leitor humano note, abra e avalie o artigo, enquanto a Camada 2 requer apenas que os metadados do artigo se tornem legíveis por máquina. Uma pré-impressão pode, portanto, em princípio, ser totalmente processada pela camada parasitária enquanto permanece efetivamente não lida na legítima. Essa é a situação dos artigos com quase zero downloads da plataforma, os "artigos fantasma", que máquinas processam e humanos efetivamente não leem.
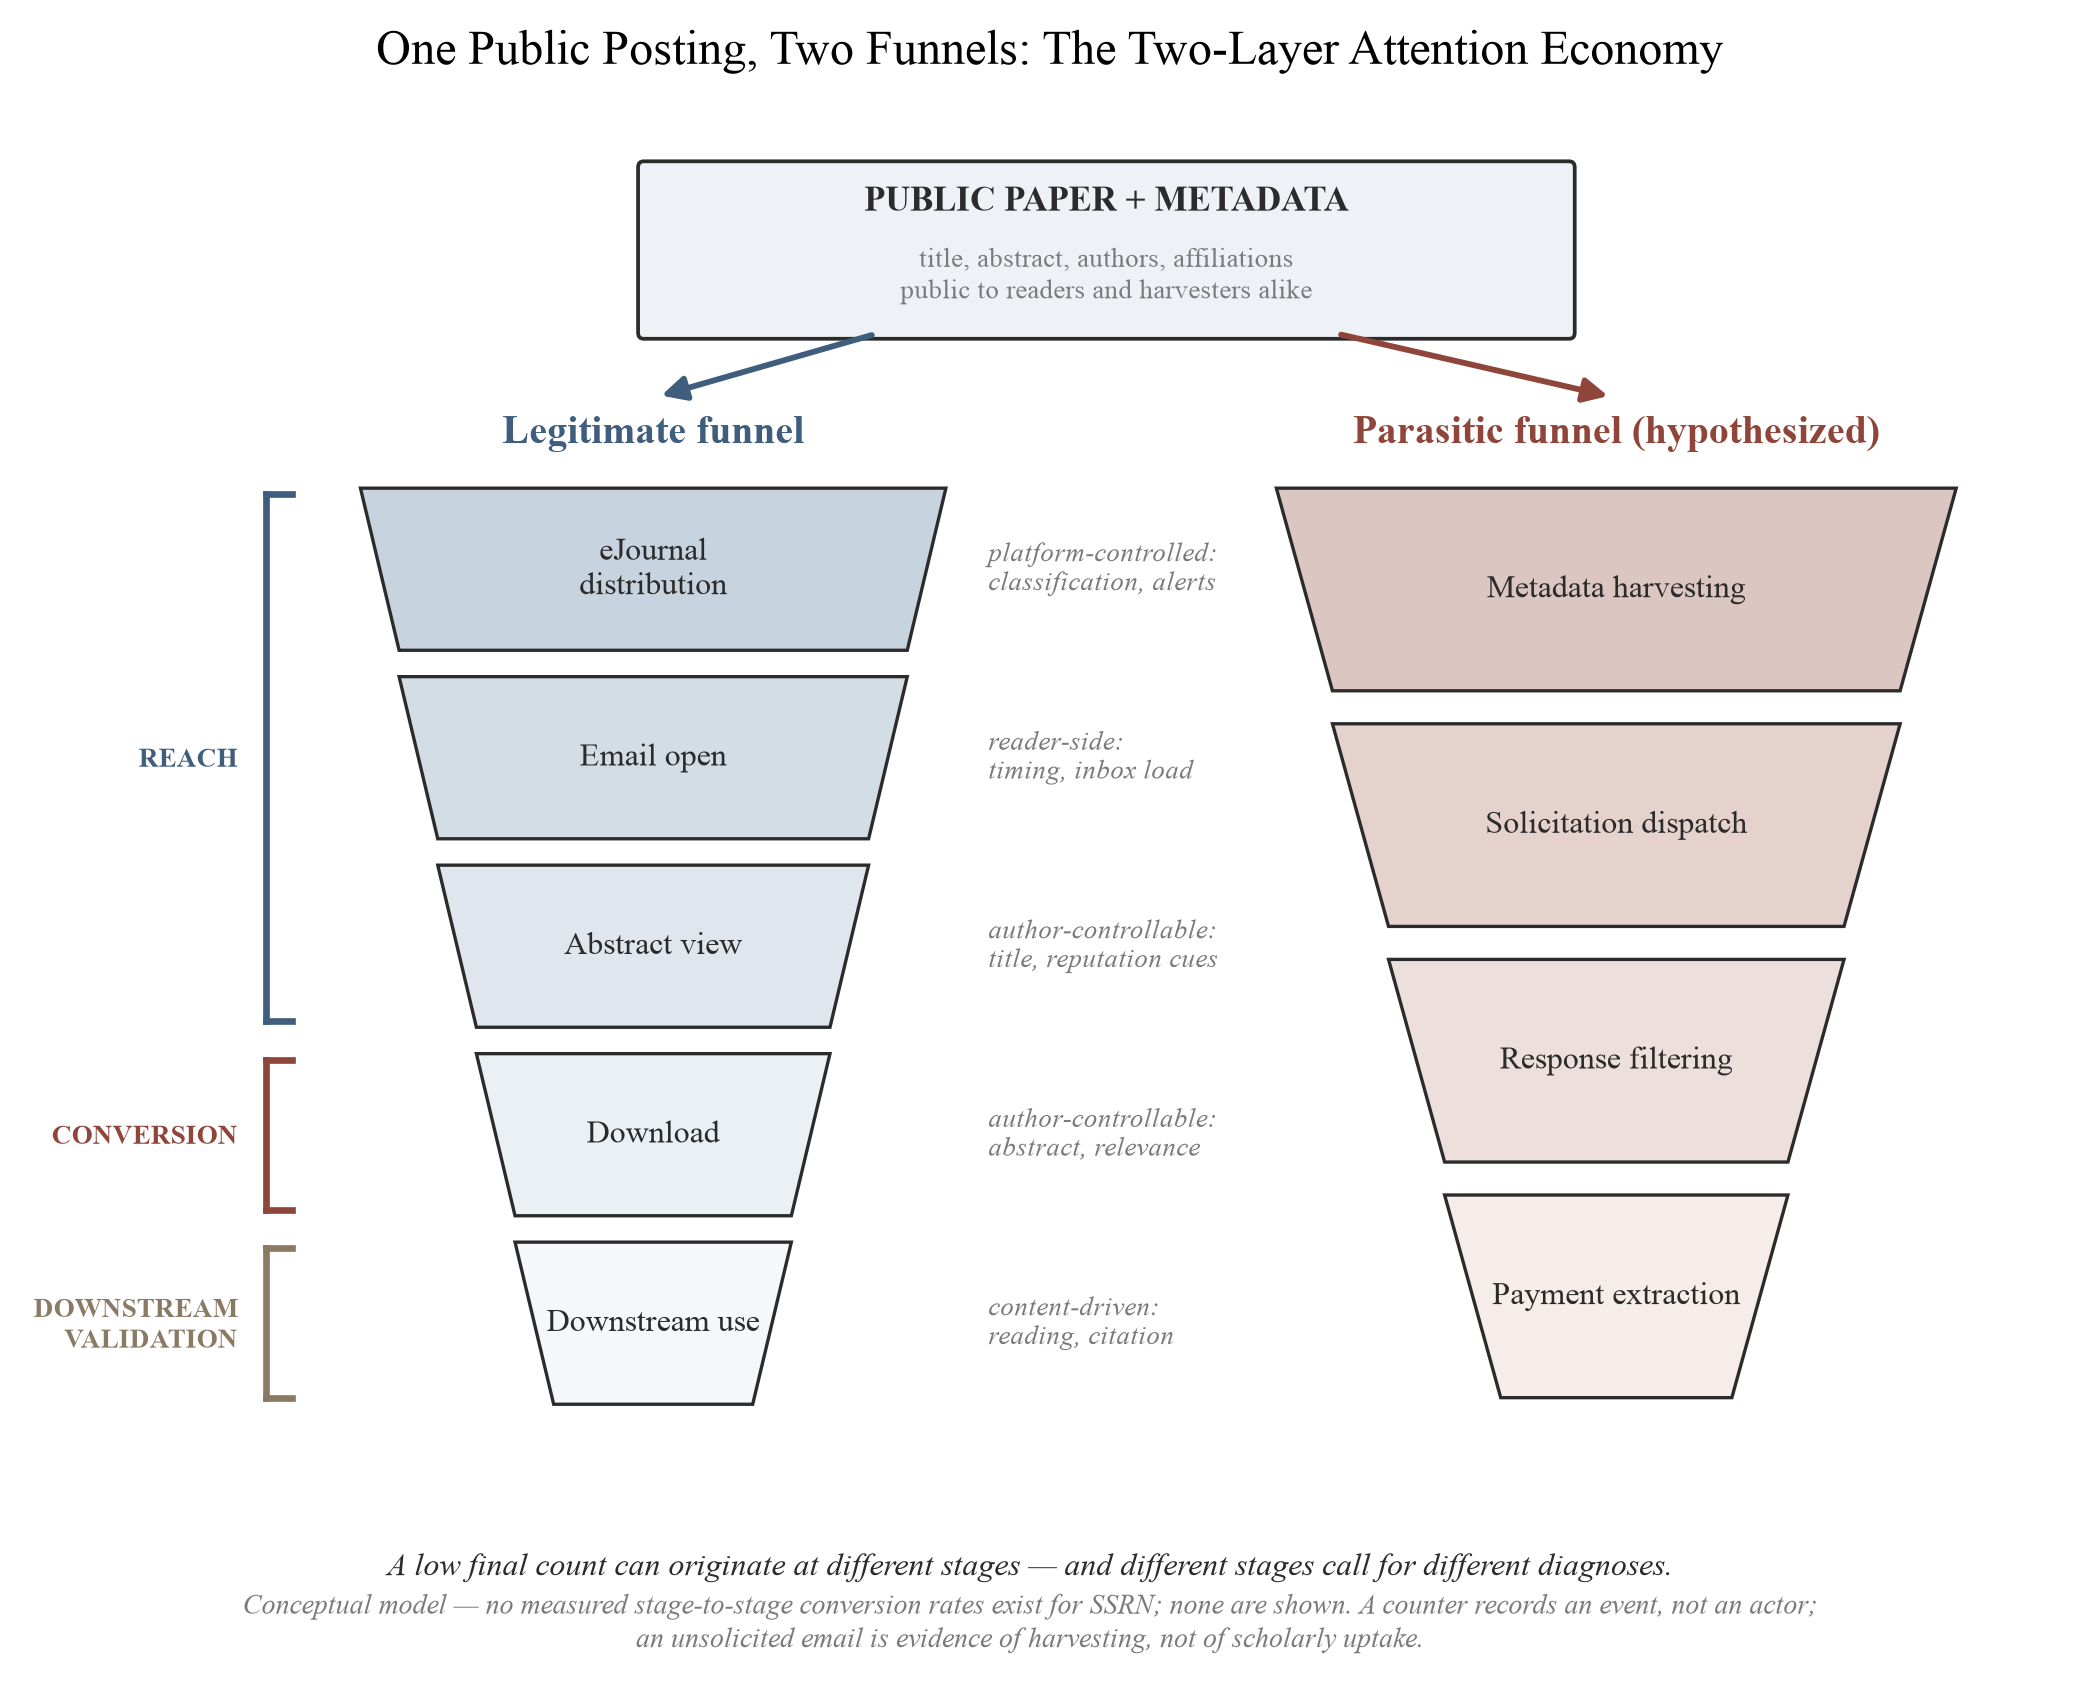
Figura 10. Modelo conceitual da economia de atenção de duas camadas. Ambos os funis são mostrados como sequências de estágios qualitativos; nenhuma taxa de conversão de estágio para estágio é exibida porque nenhuma taxa desse tipo foi medida para SSRN. O funil parasitário é uma reconstrução hipotetizada com base na literatura de solicitação-auditoria [61][63][107][159] (Seção 7.3).
7.2 A Escala Documentada da Solicitação Predatória
Que a solicitação predatória é um fenômeno em larga escala não está em dúvida. Uma revisão de 2026 identificou vinte e nove estudos empíricos de spam acadêmico, convergindo em um repertório de táticas: solicitação lisonjeira, alegações editoriais falsas e asserções duvidosas de métricas e indexação [61]. Os volumes medidos são substanciais. Quatorze oftalmologistas acadêmicos receberam 1,813 e-mails de solicitação de 383 editoras únicas, abrangendo 696 revistas únicas, dentro de uma janela de 30 dias [84]. Radiologistas acadêmicos tiveram uma média de 20.7 convites de manuscritos e 4.1 convites de palestrante durante um período de duas semanas [9]. Uma auditoria exploratória catalogou 422 e-mails de solicitação recebidos por um único urologista ao longo de 2023–24 [63], e um estudo de caso em publicação acadêmica registrou 1,024 e-mails de spam de revistas ao longo de 391 dias [89]. Uma observação de um único pesquisador durante um ano após postagens de pré-impressão registrou 875 convites de 256 revistas, 76% dos quais apareceram em listas de bloqueio selecionadas, uma fonte condicional, citada aqui com a ressalva de que os atrasos na chegada após o envio não foram medidos [B-10]. A solicitação também demonstravelmente converte. Entre autores que haviam publicado em revistas presumivelmente predatórias, 41% relataram que seu primeiro contato com a revista foi um convite por e-mail não solicitado [32], e análises de conteúdo de corpora de solicitação documentam linguagem lisonjeira, prazos fabricados e escopo temático vago como dispositivos de persuasão recorrentes [96].
Tampouco a evidência se restringe à medicina. Nas ciências sociais, disciplinarmente muito mais próximas à própria base do SSRN, três pesquisadores em ciências da educação receberam 210 convites de revistas não solicitados dentro de três meses, rastreados até 139 revistas e 37 editoras, a maioria delas classificável como predatória; aproximadamente metade dos convites ficou fora dos campos de expertise dos destinatários, a marca de direcionamento baseado em metadados em vez de orientado por leitores [155]. O ônus afeta, em primeiro lugar, o protagonista deste artigo, o autor em início de carreira. Uma autoauditoria longitudinal de um acadêmico em início de carreira registrou 1,280 solicitações predatórias (990 de revistas, 220 de conferências e 70 de outros tipos) ao longo de aproximadamente oito anos, junto com tentativas documentadas e em grande parte malsucedidas de desinscrição [160].
Duas características dessa base de evidências devem ser consideradas. As maiores auditorias provêm da medicina, e as auditorias de ciências sociais acima, embora disciplinarmente mais próximas ao SSRN, são menores; nenhum volume de qualquer uma das literaturas pode ser transplantado para autores do SSRN. Decisivo para este artigo, nenhum desses estudos mediu o tempo das solicitações em relação a um evento de postagem de pré-impressão. A auditoria em [63], por exemplo, catalogou conteúdo e proveniência, mas não vinculou tempos de chegada à atividade do SSRN. Toda afirmação que conecta a camada parasitária ao ato de postagem é, portanto, uma hipótese de mecanismo, não uma descoberta.
7.3 Mecanismos de Direcionamento Hipotéticos
Para alcançar um pré-print recém-postado, a camada parasitária deve primeiro localizá-lo. Os mecanismos abaixo são hipóteses com apoio parcial na literatura; nenhum corpus vincula solicitações a postagens no SSRN.
H-S1 (coleta de metadados). Operações predatórias raspam páginas públicas de resumos e listas de novos artigos para títulos, nomes de autores e afiliações. Fontes profissionais e consultivas descrevem este comportamento: periódicos predatórios são relatados como varrendo servidores de pré-print e enviando convites não solicitados que referenciam o título do artigo [159]. Um comentário de pesquisa jurídica afirma que os solicitadores "coletam emails, nomes, afiliações etc. vasculhando artigos acadêmicos existentes, p.ex. aqueles postados no SSRN" [107], e um guia de biblioteca jurídica vincula postagem de pré-print a "um aumento de spam de editoras predatórias que solicitam pesquisadores a republicarem seus artigos por uma taxa" [117]. Uma regularidade medida se encaixa no mecanismo. Na auditoria de radiologia, as auditorias de especialidade relatam altos volumes de solicitações entre autores que publicam ativamente [9], consistente com coleta da superfície bibliográfica cumulativa de um autor em vez de qualquer evento de postagem única. Study 3 (Section 8.6) registra portanto controles de exposição em nível de autor juntamente com a postagem focal.
H-S2 (aquisição de contatos). A solicitação requer um endereço de email. As páginas de resumos do SSRN historicamente incluíram informações de contato do autor [151], e endereços também circulam através dos próprios artigos, páginas institucionais e publicações anteriores. Não foi testado se o SSRN atualmente expõe emails de autores de forma coletável; o estudo de registro instrumentado de solicitações é especificado para medi-lo. O canal de aquisição para qualquer solicitação dada não é observado.
H-S3 (carona de distribuição). Resumos de eJournal e feeds do tipo RSS redistribuem metadados de novos artigos para assinantes [57][51]. Um ator parasitário inscrito nestes canais receberia pistas estruturadas sem fazer raspagem. Nenhuma auditoria verificou esta via.
A cadeia causal da postagem até ser alvo não foi empiricamente estabelecida; a Seção 8 especifica um teste pré-registrado destes mecanismos: registrando a chegada de solicitações contra os timestamps de postagem conhecidos para artigos recém-postados.
7.4 Uma Tipologia Hipotética de Sinais de Solicitação
Se os mecanismos de segmentação da Seção 7.3 operarem, diferentes classes de solicitação devem carregar informações distintas sobre a visibilidade de máquina de um artigo. A Tabela 14 estabelece isto como uma tipologia hipotética, suas categorias de estratégia fundamentadas em táticas de persuasão documentadas: incompatibilidade de credenciais e personalização fora do alvo [9][63], prazos fabricados e lisonjas [96], reivindicações de métricas falsas e indexação [61], e taxas encobertas em relação a um mercado APC documentado [136]. A coluna final é inferencial e não testada. A tabela não fornece percentuais de prevalência nem estimativas de tempo de chegada.
Tabela 14. Uma tipologia hipotética de sinais de solicitação predatória após postagem de pré-impressão. As frases de exemplo são ilustrativas, paráfrases inventadas de padrões documentados em auditorias de solicitação [9][61][96], não citações textuais de nenhuma mensagem específica.
| Padrão de solicitação | Descrição | Frase ilustrativa | Informação hipotética sobre visibilidade |
|---|---|---|---|
| Endereço genérico, sem referência de artigo | Convite automatizado sem menção do artigo ou campo específico | "Caro Pesquisador Estimado, envie seu trabalho valioso…" | Baixa: o endereço pode derivar de qualquer fonte; sem evidência de que o artigo em si foi visto |
| Incompatibilidade de credenciais | Convite citando expertise em um campo não relacionado ao artigo [9] | "Dada sua expertise em física quântica…" (para um artigo de direito) | Baixa a nenhuma: indica colheita em massa sem análise de metadados |
| Segmentado, com referência de título | Convite nomeando a pré-impressão específica e um local topicamente adjacente [159] | "Seu artigo recente '[título exato]' seria apropriado para nosso periódico…" | Mais alta (hipotética): os metadados do artigo chegaram ao remetente, implicando indexação bem-sucedida e acesso ao raspador |
| Personalização lisonjeira | Elogio do trabalho específico como "inovador" ou "estimado" [96] | "Sua contribuição inovadora…" | Nenhuma além do acesso ao título: o elogio é baseado em modelo, não lido |
| Urgência e métricas fabricadas | Prazos inventados, "fatores de impacto" com asterisco, reivindicações de indexação [61][96] | "Fator de Impacto 4.2*; envie em 7 dias" | Nenhuma: dispositivo de persuasão independente do artigo alvo |
| Taxas encobertas | APC divulgado tardiamente ou apenas em anexos; intervalo de mercado $25–$1.800 [136] | Taxa ausente do corpo do convite | Nenhuma: estratégia de precificação, não sinal de visibilidade |
| Convite de conferência, com referência de artigo | Convite para apresentar ou enviar para uma conferência questionável, frequentemente nomeando o artigo específico; convites de palestrantes são um componente mensurado de spam acadêmico [61][9] | "Convidamo-lo a apresentar seu artigo '[título exato]' como palestra principal em…" | Tal como para solicitação segmentada (hipotética): os metadados do artigo chegaram ao remetente; sem evidência de leitura substancial |
| Serviços de autor pagos | Ofertas de revisão por pares rápida, tradução ou serviços de edição direcionados a um pré-print recém-publicado [61][84] | "Revisão rápida e polimento profissional da linguagem para seu novo pré-print…" | Nenhum estabelecido: spam de serviço rastreia metadados de postagem recente, não conteúdo do artigo |
As linhas de adulação carregam uma dimensão psicológica que a leitura mecânica obscurece. Elogios modelados chegam a um autor que pode estar olhando para um contador estagnado, para quem a solicitação é a única "validação" que a postagem ainda produziu. O modelo de duas camadas, portanto, prevê uma inversão cruel na qual os primeiros respondentes a um novo pré-print são frequentemente predadores e não leitores (Seção 7.5), e um iniciante pode malinterpretar spam como interesse porque nenhum sinal legítimo chegou ainda. Um autor que espera o gancho pode descartá-lo.
A Tabela 14 lê as mensagens recebidas pelo que podem revelar sobre a visibilidade de um artigo. Como codificar essas mensagens é a questão complementar, e depende de uma distinção deixada implícita até agora, entre contato acadêmico legítimo e solicitação de risco mais alto. A Tabela 15 estabelece essa distinção como uma tipologia de seis sinais cuja coluna final traz as precauções de codificação: cada sinal é probabilístico e nenhum é prova por si só. A tipologia é também o esqueleto do codebook do Estudo 3 (Seção 8.6), uma vez que um estudo de solicitação sem uma classe positiva de contato acadêmico legítimo não pode medir a assimetria que a Seção 7.5 hipotetiza.
Tabela 15. Separando contato acadêmico legítimo de solicitação de risco mais alto: seis sinais com precauções de codificação. Um esquema de codificação hipotetizado, não um classificador validado. A coluna de visibilidade da Tabela 14 faz uma pergunta diferente e não é afetada: a mesma mensagem pode ser codificada em ambas as grades.
| Sinal | Contato acadêmico legítimo | Solicitação de risco mais alto | Precaução de codificação |
|---|---|---|---|
| Especificidade | Envolve um argumento concreto, método ou resultado | Elogios genéricos com o título ou palavras-chave inseridas | A especificidade pode ser imitada |
| Identidade do veículo | Histórico verificável de revista, editor, instituição ou conferência | Propriedade incerta, marca copiada, conselho não verificável | Novos veículos não são automaticamente predatórios |
| Solicitação | Pergunta substantiva, colaboração ou convite transparente | Pedido urgente de submissão ou pagamento não relacionado ao trabalho | Taxas sozinhas não são decisivas; a transparência importa |
| Cronograma | Qualquer cronograma; frequentemente segue leitura real | Contato modelado rápido logo após postagem pública | Proximidade temporal não prova a fonte da colheita |
| Linguagem | Específico do tópico e profissionalmente responsável | Adulação, falsa familiaridade, urgência artificial, escopo vago | Características de linguagem são probabilísticas, não prova |
| Verificação | Detalhes de contato e políticas independentemente verificáveis | Identificadores quebrados, métricas falsas, reivindicações de indexação enganosas | Revisão humana sob critérios documentados é necessária |
Na prática, a tipologia produz uma heurística de triagem em vez de um diagnóstico: uma solicitação de revista chegando nos primeiros dias após a postagem, antes que os canais de distribuição legítimos tenham plausivamente operado, é muito provavelmente predatória. Revistas legítimas de alto impacto não são relatadas como fazendo ligações frias para autores de manuscritos recém-postados [174], enquanto o convite não solicitado precoce é o modo de primeiro contato documentado de periódicos predatórios [32][174]. Propomos o ponto de corte específico às vezes proposto em discussões profissionais (considerando qualquer email de revista nos primeiros 96 horas aproximadamente como presumivelmente predatório) como uma heurística para autor pendente de validação. Nenhum estudo mediu a distribuição de atraso que calibraria tal limiar. A cautela de sincronização da Tabela 15 se aplica à própria heurística: proximidade temporal levanta suspeita mas não prova que o remetente colheu esta postagem particular, já que o endereço pode ser anterior ao preprint inteiramente, então a triagem de 96 horas classifica caixas de entrada em vez de evidência.
7.5 O Paradoxo do Spam e a Assimetria de Velocidade
Duas proposições adicionais sobre a camada parasitária decorrem do modelo de duas camadas.
O Paradoxo do Spam. Se a solicitação direcionada exige uma coleta de metadados bem-sucedida, então no ambiente pós-Rankings a ausência de spam predatório pode ser um indicador mais forte de invisibilidade de plataforma do que sua presença é de qualquer outra coisa. Um artigo que nunca desencadeia nem mesmo a camada parasitária pode ter falhado em atingir o limite mínimo de distribuição legível por máquina. A atração analítica dessa inversão, com spam como um proxy involuntário e tóxico para indexação, é que transforma um incômodo inevitável em um instrumento observacional gratuito. Seu poder diagnóstico é, no momento, apenas uma hipótese: a correlação entre o recebimento de solicitação e qualquer métrica de visibilidade nunca foi medida, e as linhas de solicitação genérica da Tabela 14 mostram por que o volume bruto de spam seria um sinal ruidoso até em princípio.
Os predadores chegam antes dos leitores. O funil legítimo opera com atrasos institucionais: a inclusão em eJournal é curada em vez de garantida, com atrasos de até 45 dias relatados para classificações de alto volume [53], e a indexação do Google Scholar leva seis a nove meses ou mais [55]. Downloads próximos a zero na primeira semana são consistentes com pré-distribuição normal em vez de rejeição (Seção 6). A camada parasitária, se coleta metadados programaticamente, não enfrenta nenhuma dessas defasagens. Portanto, hipotetizamos que para um autor cuja informação de contato é acessível, o tempo esperado para a primeira solicitação predatória atribuível a uma postagem é menor do que o tempo esperado para o primeiro contato acadêmico genuíno, de forma que o autor desconhecido encontraria a camada parasitária antes da legítima. O falsificador é direto: o contato genuíno antecede seguramente a solicitação.
Volumes de solicitação documentados medidos em dias e semanas [9][84], contrastados com a mecânica de distribuição medida em semanas e meses [55][53], tornam a hipótese plausível. Apenas o estudo de registro especificado na Seção 8 pode testá-lo, porque os corpora existentes não foram vinculados temporalmente aos eventos de postagem [63].
7.6 O Que a Camada Parasitária Não Diz a um Autor
Três declarações de fronteira limitam as conclusões desta seção.
Primeiro, email de solicitação não move os contadores da plataforma. Um convite enviado para o autor não gera visualização de resumo nem download do artigo. Na medida em que os scrapers visitam páginas de resumo, SSRN afirma que filtra atividades irregulares e automatizadas de suas contagens de download [66][69][144]. O volume de spam nunca é, portanto, evidência de leitura, e uma caixa de entrada repleta de solicitações coexistindo com downloads de um único dígito não envolve contradição: as duas camadas contam coisas diferentes.
Em segundo lugar, a camada parasitária também afeta mais duramente os autores menos equipados para absorver seus custos: pesquisadores em início de carreira e pesquisadores não nativos de inglês são notados como particularmente vulneráveis à solicitação [142]. O protocolo prático da Seção 6 portanto trata a higiene da caixa de entrada (triagem da lista de bloqueio de qualquer local de solicitação, não resposta a convites não solicitados, verificação através de serviços curados em vez de listas extintas) como parte da interpretação de métrica em vez de uma preocupação separada. A triagem automatizada de locais predatórios é em si uma direção de pesquisa ativa [157].
Em terceiro lugar, visibilidade antecipada tem um efeito colateral adicional, que os autores encontram como uma acusação aparente: em submissão posterior de periódico, o software de verificação de similaridade sinalizará uma correspondência quase completa entre o manuscrito e seu próprio precursor SSRN, uma vez que pré-impressões são indexadas no corpus Crossref Posted Content usado por iThenticate [36]. A documentação do fornecedor é explícita que uma correspondência de pré-impressão do mesmo autor é um resultado esperado e não plágio [81]. A resposta apropriada é divulgar a pré-impressão ao editor, não a retirar.
A camada parasitária é onde a alegação central deste artigo é mais fácil de ver: após o pôr do sol do Rankings, sinais brutos (downloads, visualizações e agora até spam) carregam significado interpretável apenas quando o mecanismo que os gerou é especificado. Essa especificação está parcialmente disponível para a camada legítima, e para a camada parasitária ainda é um programa de pesquisa.
8. Uma Agenda de Pesquisa Pronta para Pré-Registro: Reconstruindo a Classe de Referência Ausente
As seções anteriores sintetizaram a evidência verificável sobre métricas de atenção SSRN e propuseram um marco interpretativo para o ambiente pós-Rankings. Esta seção é uma agenda pronta para pré-registro para responder empiricamente as questões abertas do marco. Não relata resultados, por design: bandas pré-especificadas e falseáveis em vez de achados. Cada design, hipótese e banda de predição abaixo está pronto para ser registrado no Open Science Framework antes de qualquer coleta de dados, com código de análise lançado concomitantemente. A aposentadoria do SSRN Rankings em 15 de julho de 2026 [149], anunciada em 12 de junho de 2026 com uma data-alvo inicialmente anterior [148] e inserida em um refocamento de plataforma mais amplo [146], torna essa agenda inusitadamente sensível ao tempo: alguns dos designs abaixo exploram uma descontinuidade cujo período pré-recua a cada mês, e um deles, o registro de percentil da Seção 8.8, aborda uma lacuna de medição que o pôr do sol tornaria permanente para observadores externos.
8.1 Princípios de design
Quatro princípios governam a agenda.
Observação desde o nascimento. A raspagem retrospectiva de contadores cumulativos não consegue reconstruir o que um artigo tinha no dia 3, dia 7 ou dia 30. Qualquer painel de benchmarking credível deve, portanto, inscrever artigos no momento da postagem e registrar seus contadores em idades padronizadas: dias 1, 3, 7, 14, 30, 60, 90 e 180 (Tabela 11), com observação diária preferível durante os primeiros 45 dias, porque a SSRN afirma que a distribuição de alertas em tópicos amplamente inscritos pode levar até 45 dias [53]. Este princípio também protege contra vazamento: as medidas de reputação anterior do autor devem ser congeladas na data focal da postagem para que o sucesso futuro não contamine as covariáveis de linha de base. Sua disciplina complementar, mantida desde a Seção 5.6, é que eventos de distribuição, indexação e promoção entrem nos designs abaixo como tratamentos datados e nunca como contexto não modelado.
Separação de alcance e conversão. Seguindo a lógica diagnóstica da Seção 5 (Tabela 9), cada design abaixo registra visualizações de resumo e downloads como resultados distintos e modela downloads condicionados a visualizações. Baixo alcance e baixa conversão são diagnósticos diferentes: falha em entrar no conjunto de consideração do leitor versus não-aquisição após exposição. Agrupá-los em uma contagem única descarta a informação que um autor precisa.
Resultados distribucionais, não apenas médias. Como a atenção da plataforma é de cauda pesada [83][85][180], intervenções e mudanças na plataforma podem alterar a forma da distribuição enquanto deixam sua média praticamente inalterada. Os resultados, portanto, incluem o coeficiente de Gini de atenção, compartilhamentos de download dos 1% superiores e dos 10% superiores, a proporção de artigos em ou próximo de zero, e razões de atenção entre recém-chegados e estabelecidos, na tradição de medição de desigualdade de atenção em outras mídias [180].
Falsabilidade. Cada hipótese é emparelhada com uma estratégia de identificação e uma condição estabelecida sob a qual ela falha. O próprio framework está exposto à rejeição: se métricas iniciais normalizadas por idade e campo não superarem contagens brutas fora da amostra (RQ3 abaixo), a vantagem de medição reivindicada da normalização deve ser rejeitada ou restringida. A falsabilidade também é quantitativa: os tamanhos de amostra em toda a agenda devem ser finalizados por simulação de potência contra os menores tamanhos de efeito de interesse. A estratégia de multiplicidade para um programa de cinco hipóteses, três questões de pesquisa e cinco proposições é comprometida no pré-registro, e as análises confirmatórias e exploratórias são rotuladas como tal de antemão. O atrito (artigos retirados, mesclados ou materialmente revisados) é rastreado e reportado em vez de ser silenciosamente descartado, com um diagrama de fluxo de coorte em cada relatório empírico do programa (Seção 8.8).
8.2 Hipóteses e proposições
O framework gera cinco hipóteses e três questões de pesquisa sobre a alocação da atenção inicial, e cinco proposições sobre sua estrutura. A Tabela 16 vincula as hipóteses, as questões de pesquisa e as proposições com designs dedicados (P2, P3b, P4) a um resultado, um contraste e um design preferido; P1 e P3 são investigados pelos Estudos 1 e 2 na Tabela 17.
H1 (Desvantagem de cold-start). Condicionado ao campo, à coorte de postagem, ao tópico observável, às características do documento e às condições de calendário, artigos escritos exclusivamente por novatos da plataforma recebem menos visualizações iniciais da página de resumo do que artigos com pelo menos um autor SSRN previamente visível. O resultado central é visualizações em vez de downloads por visualização, porque H1 diz respeito à formação do público e não à conversão.
H2 (Prestígio e exposição). O prestígio institucional e do autor prediz positivamente o alcance inicial da página de resumo após controlar pela atividade anterior da plataforma e características observáveis do artigo, estendendo a literatura de status-atenção [104][105][111][140][60] para o primeiro estágio da difusão de preprint.
H3 (Prestígio e conversão condicional). O prestígio institucional prediz positivamente o download do texto completo condicionado à exposição da página de resumo. Jo e Li fornecem evidências recentes específicas do campo consistentes com esse padrão em Marketing, um prêmio de prestígio de aproximadamente +6,6% na taxa de download para um artigo de três autores com um autor top-50 [83], mas um teste longitudinal mais amplo permanece necessário. Conjuntamente, H2 e H3 definem o estimando-chave do painel: uma decomposição alcance-versus-conversão do gradiente de prestígio, significando a fração da desigualdade relacionada ao prestígio observada nos downloads que surge antes da visita à página de resumo (exposição) versus depois dela (conversão condicional). Uma descoberta de que a maioria do gradiente se forma antes de qualquer leitor ter visto o resumo localizaria a desigualdade na mecânica de descoberta em vez da avaliação de conteúdo, em forma diretamente mensurável.
H4 (Comunicação como igualador). Maior clareza do resumo e eficiência informacional estão associadas a maiores melhorias na conversão condicional entre autores de baixa visibilidade prévia do que entre autores já visíveis. H4 é a única hipótese cuja intervenção está totalmente sob o controle do autor. Deve ser testada com medidas textuais pré-especificadas e, separadamente, um experimento de resumo aleatorizado projetado para os padrões de experimento de campo online [30]. Não deve depender unicamente de classificadores automatizados "escritos por IA", que introduzem sua própria incerteza de medição.
H5 (Persistência de choques de exposição). Choques de exposição inicial exógenos ou quase-exógenos predizem atenção subsequente elevada além da janela de exposição imediata: o análogo de plataforma acadêmica da dinâmica sucesso-gera-sucesso documentada experimentalmente em outro lugar [112][131][162] e de efeitos de exposição posicional no arXiv [72][73].
RQ1. A aposentadoria de Rankings em 15 de julho de 2026 mudou a concentração, distribuição ou gradiente de prestígio da atenção? Duas previsões opostas são ambas plausíveis, e a questão é deixada bilateral: remover classificações pode diminuir os loops de retroalimentação de popularidade [112][131], ou pode, em vez disso, aumentar a dependência de redes de autores preexistentes ao remover uma superfície de descoberta através da qual artigos desconhecidos poderiam se tornar visíveis uma vez que começassem a atrair atenção.
RQ2. A distribuição de alerta de email curada produz ganhos de atenção proporcionalmente maiores para novatos ou para autores estabelecidos?
RQ3. As métricas normalizadas observadas nos dias 7 e 30 predizem melhor os resultados de citação ou publicação acadêmica posteriores do que os downloads cumulativos brutos?
As proposições reafirmam as alegações estruturais do framework em forma falsificável:
P1 (Assimetria e a maioria invisível). Em uma amostra estratificada aleatória de artigos SSRN, a distribuição de downloads vitalícios é de cauda pesada e enviesada para a direita de modo que a mediana é menos da metade da média, e uma parcela substancial de artigos têm dez ou menos downloads vitalícios. Falsificador: mediana ≥ 0,5 × média, ou uma parcela negligenciável ≤10-download. A razão Marketing-network publicada de média para mediana (aproximadamente 2,54) [83] e o ajuste quase-lognormal dos dados da lista superior de 2015 [85] motivam mas não estabelecem P1 para a plataforma em geral.
P2 (Classificação governa a exposição). Na camada de repositório, o número de classificações de eJournal está positivamente associado com downloads e negativamente associado com a probabilidade de downloads próximos a zero, controlando por idade e rede, uma replicação e atualização do padrão transversal de Whalen de 2018 [168] sob a mecânica de distribuição curada da plataforma [53][57]. Falsificador: nenhuma associação significativa após controles. A contagem de classificação é ela mesma potencialmente endógena: artigos de relevância mais ampla podem tanto receber mais classificações quanto atrair mais leitores, de modo que a associação transversal sobrestima qualquer efeito de exposição. A identificação preferida é, portanto, mudanças de classificação dentro do artigo onde disponível, com a estimativa transversal relatada explicitamente como um limite superior.
P3 (A visibilidade da máquina é baixa e dependente de recursos). Para consultas construídas de modo que um preprint SSRN específico seja a melhor fonte disponível, motores de resposta de IA de consumidor citam o preprint em si em uma minoria de casos, e a visibilidade da máquina aumenta com recursos análogos aos fatores de otimização de motor generativo documentados [5][164]. Falsificador: preprints são citados a maioria das vezes independentemente dos recursos, ou nenhum recurso prediz visibilidade.
P3b (Um efeito Mateus de camada de máquina). Condicionado à relevância de consulta validada por especialista, artigos com maior visibilidade web e acadêmica prévia são citados por sistemas de resposta de IA mais frequentemente do que artigos de cold-start de outra forma comparáveis. Sob a alternativa de equidade, motores generativos recuperam a relevância sem um prêmio na visibilidade anterior e P3b é rejeitada, um resultado sob o qual a camada de máquina seria mais igualitária do que as camadas de descoberta humana de H1–H3, não menos. Falsificador: nenhum gradiente de visibilidade na relevância de consulta pareada. P3b estende a linha de vantagem cumulativa de H1–H3 para o topo da pilha de descoberta. Testá-la requer a covariável de visibilidade prévia e a estratificação de consulta especificadas no Estudo 2 (Seção 8.6).
P4 (Predadores chegam antes dos leitores). Para um preprint recém-publicado cujos metadados bibliográficos e rotas de contato podem ser coletados do documento publicado ou de páginas públicas associadas, o tempo esperado até a primeira solicitação predatória atribuível à postagem é menor do que o tempo esperado até o primeiro contato acadêmico genuíno. Falsificador: contato genuíno precede de forma confiável a solicitação predatória. P4 é enunciado condicionalmente à colheitabilidade porque a visibilidade pública dos detalhes de contato do autor na interface da plataforma atual não está estabelecida. O próprio mecanismo de coleta está documentado para repositórios de preprints em geral [107][159][151], e e-mail não solicitado é o primeiro contato com um periódico predatório para uma parcela substancial de autores solicitados [32]. A atribuição, portanto, exige o design instrumentado do Study 3 em vez de inferência apenas a partir do tempo da caixa de entrada.
Tabela 16. Hipóteses, questões de pesquisa e estratégias de identificação.
| Questão | Desfecho primário | Contraste principal | Design preferido |
|---|---|---|---|
| H1: desvantagem do recém-chegado | Visualizações incrementais | Recém-chegado vs. estabelecido | Modelo de contagem longitudinal hierárquico |
| H2: prestígio e alcance | Visualizações incrementais | Prestígio anterior maior vs. menor | Painel ajustado por covariável + análise de sensibilidade pareada |
| H3: prestígio e conversão | Downloads condicionados a visualizações | Prestígio maior vs. menor | Modelo de exposição binomial negativo/Poisson |
| H4: equalizador de comunicação | Probabilidade/taxa de download condicional | Clareza × visibilidade anterior | Modelo de texto observacional + replicação aleatorizada |
| H5: atenção cumulativa | Visualizações/downloads pós-choque | Choque de exposição vs. trajetória pré-choque | Estudo de evento intra-artigo |
| RQ1: aposentadoria de classificações | Atenção diária; Gini; compartilhamentos principais; volume de novas postagens por campo | Campos anteriormente expostos a classificações vs. campos de comparação | Design interrompido/estudo de evento |
| RQ2: distribuição de e-mail | Visualizações/downloads diárias | Antes vs. depois da distribuição | Estudo de evento intra-artigo (Distribuição × Recém-chegado) |
| RQ3: validade preditiva | Citações de 6/12/18 meses | Métricas iniciais normalizadas vs. brutas | Comparação preditiva fora da amostra |
| P2: a classificação governa a apresentação | Downloads; probabilidade de downloads próximos a zero | Contagem de classificação; mudanças de classificação intra-artigo onde disponíveis | Regressão em painel + design de mudança intra-artigo |
| P3b: efeito Matthew de camada de máquina | Citação direta pelo sistema de resposta | Visibilidade anterior alta vs. baixa com relevância de consulta pareada | Auditoria de recuperação multinível repetida (Study 2) |
| P4: predadores antes dos leitores | Tempo até o primeiro e taxa de mensagens de entrada codificadas | Janelas pré vs. pós-postagem; contato predatório vs. genuíno | Coorte prospectiva instrumentada + modelo de história de eventos (Study 3) |
Nota. Todas as linhas são designs prospectivos. Nenhum foi executado. Desfechos, contrastes, regras de exclusão e classes de referência devem ser pré-registrados antes da coleta de dados.
8.3 O painel central
O design de referência é uma coorte multidisciplinar de artigos SSRN recém-publicados acompanhados por pelo menos doze meses desde o envio, observados no cronograma da Tabela 11. No nível do artigo, o dataset preserva a versão mais antiga disponível de título, resumo, nomes de autores e ordem, afiliações, data de envio, classificações, palavras-chave, contagem de páginas, DOI quando disponível, histórico de revisão, visualizações públicas de resumo, downloads públicos e indicadores de citação subsequentes, com correspondência de identidade de autores contra infraestrutura bibliográfica aberta [35][124] validada manualmente em uma subamostra aleatória antes que a reputação inferida seja usada em escala. O status de novato é definido como nenhum autor do artigo focal tendo um artigo SSRN datado antes do envio focal, com definições de sensibilidade baseadas em contagens de artigos anteriores e estoque de citações pré-envio. O prestígio institucional não faz parte dessa definição: porque o prestígio é em si uma variável explicativa em H2 e H3, incorporá-lo ao status de novato confundiria mecanicamente a novidade da plataforma com a visibilidade anterior do autor e colapsaria as hipóteses que o design pretende separar. O prestígio, portanto, entra nos modelos apenas como uma covariável distinta. A normalização pela visibilidade anterior deve ser tratada com cuidado correspondente por razões de equidade: subtrair uma linha de base de visibilidade anterior demasiadamente agressivamente penalizaria o sucesso genuinamente precoce de um autor iniciante e apagaria estatisticamente, em vez de expor, qualquer subexposição sistêmica de autores marginalizados e do Sul Global. A resposta do framework é medir onde a desigualdade se forma em vez de compensá-la: a decomposição alcance-versus-conversão localiza se uma lacuna de visibilidade surge na exposição ou na conversão, e o prestígio entra como uma covariável a ser compreendida, não como ruído a ser silenciosamente diferenciado. O efeito distribucional do prestígio na atenção é um resultado primário dos quase-experimentos (Seções 8.4–8.5). Os controles de calendário incluem dia da semana, semana do ano, estação acadêmica e efeitos fixos de data. A variação documentada de fim de semana e sazonal no acesso a artigos (atividade aproximadamente 11% menor nos finais de semana e 50% menor no verão em um painel recente de sete periódicos [178]) torna sua omissão difícil de justificar em qualquer estudo de uso de alta frequência. O dicionário completo de variáveis do painel (na ordem de duas dúzias de campos, incluindo incrementos de intervalo em vez de apenas contagens cumulativas, a data de distribuição onde consentido, estoques de citações com 6, 12 e 18 meses e número de revisão) é especificado no Apêndice C (Tabela C1), e o mesmo arquivo de schema é depositado com os materiais de pré-registro (Seção 8.8; Declarações).
O alcance é modelado como um processo binomial negativo hierárquico para visualizações incrementais, com efeitos campo-por-idade, efeitos de calendário e heterogeneidade no nível do artigo. A conversão condicional é modelada como downloads incrementais com visualizações incrementais do log como exposição, de modo que ganhar uma visita de página de destino e converter essa visita sejam estatisticamente separadas. Em forma compacta, para artigo i em intervalo t:
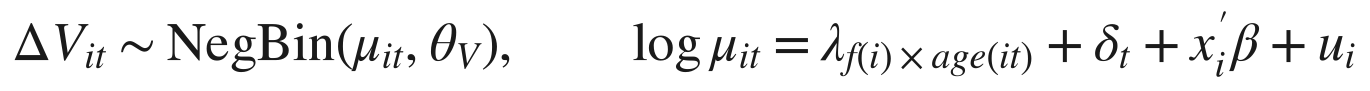

onde λ_{f×age} são efeitos campo-por-idade, δ_t são efeitos de data-calendário, u_i e w_i são heterogeneidade no nível do artigo, e o deslocamento de visualizações de log na segunda equação torna downloads condicionais à exposição de página de destino. A interação Novato × Clareza γ_3 é o teste H4. Essas equações fixam os estimandos pré-especificados e a separação do alcance da conversão, e a estrutura hierárquica realiza exatamente o agrupamento parcial empírico-Bayes que as Seções 5.2 e 8.8 exigem antes que qualquer percentil de célula esparsa seja publicado. Os controles de tópico em x_i são construídos a partir de embeddings de título-resumo congelados e agrupados no pré-registro, antes de qualquer resultado ser observado, para que a composição temática não possa ser ajustada aos resultados. Como os artigos ocupam até sete classificações simultaneamente, os efeitos de classificação são estimados com estruturas hierárquicas de múltipla pertinência, em vez de forçar cada artigo em um único campo. Como os efeitos fixos do artigo absorvem medidas de status invariáveis no tempo, os efeitos de linha de base de novato e prestígio são estimados entre artigos, enquanto os efeitos fixos do artigo são reservados para tratamentos dentro do artigo, como eventos de distribuição. Superdispersão e zeros em excesso são formalmente testados, alternativas de barreira e inflacionadas por zero são relatadas onde justificadas, e a cauda pesada é tratada por estimação quantílica e robusta em vez de deletar artigos bem-sucedidos. As regras de limpeza de dados são em si pré-especificadas em vez de discricionárias, e o protocolo de anomalia é sinalizar, não deletar. A lista de sinais pré-especificada cobre: um extremo de intervalo em relação ao próprio histórico do artigo, um pico de visualização sem movimento em downloads, uma descontinuidade na conversão, marcas de tempo idênticas repetidas e uma reafirmação do lado da plataforma. Um intervalo sinalizado nunca é removido do arquivo: é retido com um código de motivo, e todo resultado principal é relatado em uma escada de sensibilidade de quatro camadas: (i) contadores não modificados; (ii) excluindo apenas atividade inválida confirmada pela plataforma; (iii) estimação robusta ou winsorizada; (iv) excluindo todos os intervalos sinalizados, de modo que qualquer conclusão que sobreviva em apenas uma camada seja visível como frágil. Os limiares são calibrados em relação à distribuição observada em vez de serem definidos a priori. Onde logs de parceiros estão disponíveis, campos de referenciador, agente do usuário e geografia distinguem tráfego de boletim, blog, pré-busca e rastreador. Os picos de download acionados por blog documentados no SSRN [116] ilustram por que um valor extremo é frequentemente sucesso orgânico em vez de contaminação. A detecção de anomalia é uma ferramenta de medição. Ela não autoriza descartar sucesso inconveniente.
A mesma disciplina se aplica à estrutura temporal. O painel distingue atenção marginal de cumulativa: curvas de coorte de downloads de intervalo ΔD, e a parcela dos downloads de 180 dias de um artigo acumulada por cada idade, em vez de ler apenas totais de vida útil. Não impõe uma única meia-vida exponencial ao decaimento, já que a leitura decai em várias escalas de tempo simultaneamente [91]. As curvas de idade são, portanto, ajustadas com splines ou estimadores não paramétricos por padrão, com transformações logarítmicas usadas para estudar a estrutura e contagens brutas retidas para relatórios de referência. A robustez é tratada da mesma forma: o prestígio é operacionalizado por meio de várias medidas alternativas em vez de um único limite de classificação, o status de novato é retestado sob definições progressivamente mais rigorosas, e os resultados são relatados com verificações de sensibilidade winsorizada e gráficos de distribuição completa ao lado das estimativas de quantis.
Como não há API pública de SSRN [134][51], a coleta de dados prossegue por três rotas, em ordem de preferência: um pedido formal de dados para ou parceria com SSRN/Elsevier; exportações de painel de controle consentidas pelo autor, nas quais autores participantes contribuem com seus próprios dados do painel de estatísticas sob consentimento informado, o nível intermediário em que o registro da Seção 8.8 já se baseia; e amostragem por artigo de páginas públicas com limitação de taxa, que respeita robots.txt, cuja viabilidade técnica é estabelecida por ferramentas de coleta de código aberto existentes [134]. O design exclui raspagem em massa que violaria os termos de serviço, e não representa nenhum ponto de extremidade não documentado como uma API estável. As restrições de acesso são discutidas como uma limitação na Seção 9.
8.4 Quase-experimento I: distribuição de alertas por email como um choque de atenção
As seções 8.4 e 8.5 formam um módulo analítico, estudando duas intervenções do lado da plataforma como tratamentos complementares em uma mesma coorte de painel. A distribuição de alertas adiciona uma superfície de exposição, a aposentadoria dos Rankings removeu uma, e ambas são lidas em relação a um conjunto comum de resultados distribucionais (participação de recém-chegados, gradiente de prestígio, Gini de atenção, participações de topo). O mecanismo de alerta do SSRN é analiticamente valioso porque a postagem e a distribuição não precisam coincidir. Os artigos se tornam publicamente disponíveis primeiro, e o trabalho elegível é posteriormente distribuído através de alertas de eJournal curados cujo tempo varia e não é garantido [53][57]. Para autores que consentem fornecer suas datas de status de distribuição, um estudo de evento dentro do artigo pode estimar o caminho de atenção ao redor da data de distribuição, cada artigo servindo como seu próprio controle para que diferenças estáveis em apelo de tópico, identidade do autor e instituição sejam absorvidas. A especificação é a forma de estudo de evento padrão: para o resultado Y_it (visualizações ou downloads no intervalo),
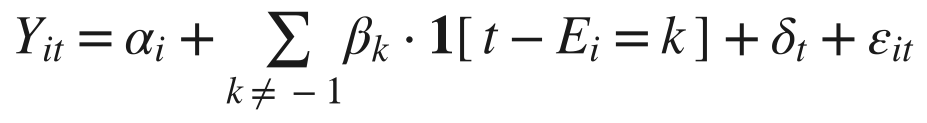
onde E_i é a data de distribuição do artigo i, α_i são efeitos fixos de artigo, δ_t efeitos de data de calendário, e os β_k, normalizados ao período de referência pré-distribuição k = −1, rastreiam o caminho de atenção ao redor do evento. A equação especifica o estimando para pré-registro. O efeito heterogêneo principal é a interação Distribution × Newcomer, estimada pela interação dos β_k com o status de recém-chegado. Se os alertas melhoram desproporcionalmente o alcance dos recém-chegados, a distribuição curada funciona como um equalizador de nível de plataforma; se os ganhos recaem desproporcionalmente sobre autores prestigiosos, a distribuição amplifica as vantagens de reputação existentes (RQ2). Evidência anterior de que eventos de exposição discreta (listagens de posição frontal no arXiv [72][73], cobertura de blog de artigos SSRN [116]) produzem picos de atenção precoces agudos indica que o design tem um primeiro estágio detectável. A especificação pré-especificada também inclui janelas de evento alternativas ao redor da data de distribuição e relatórios separados para artigos distribuídos rapidamente versus após uma longa fila de classificação, já que o atraso de até 45 dias [53] caso contrário mistura históricos de exposição heterogêneos em um único tempo de evento. Os efeitos fixos de artigo absorvem apenas apelo invariante no tempo, então três condições de design são críticas. O tempo de distribuição é curado, não aleatório: a plataforma seleciona quais artigos elegíveis distribui e quando [53][57]. A data do evento portanto carrega uma seleção variável no tempo sobre topicalidade (um artigo distribuído na semana em que um tópico se torna saliente difere do mesmo artigo distribuído em uma semana tranquila), e esta seleção sobrevive aos efeitos fixos de artigo, que é a razão pela qual a especificação condiciona sobre latência de distribuição e relata estratos de tempo de distribuição separadamente. As datas de status de distribuição também são observadas apenas para autores que consentem, então a amostra de estimação é um subconjunto auto-selecionado do painel. O status de consentimento é portanto registrado, e a amostra de estudo de evento é comparada à coorte completa em covariáveis observáveis; a seleção limita a validade externa. E os autores podem alinhar sua própria divulgação com o alerta: um pico de auto-promoção coordenado se apresentaria como um efeito de distribuição. Um log de auto-promoção de autor datado (o pacote de evidência versionado da Seção 6.1) é portanto um requisito deste design: sem ele um pico de distribuição orgânico não pode ser separado de um autogenerado, e a escada de anomalias da Seção 8.3 sinaliza em vez de deletar qualquer pico que coincida com auto-promoção registrada.
8.5 Quasi-experimento II: a aposentadoria do Rankings como um experimento natural
O encerramento de 15 de julho de 2026 [149] permite uma segunda análise se a exposição histórica de ranking puder ser reconstruída a partir de páginas de ranking arquivadas. Dois aspectos do desenho enfraquecem um estudo de evento de data única e limpa. O tratamento não chegou em uma única data: as páginas de ranking por eJournal pararam de ser atualizadas a partir de 11 de dezembro de 2025 (Seção 2.2 [B-2]), aproximadamente sete meses antes da remoção de 15 de julho de 2026, portanto a retirada da superfície de descoberta de ranking é melhor modelada como um processo escalonado, um congelamento de primeira etapa das páginas ao vivo seguido pela sua remoção final, do que como uma data de evento comum única. A especificação portanto carrega pelo menos dois tempos de evento (o congelamento de dezembro e a remoção de julho), com a forma escalonada como o modelo principal e o ajuste de data única testado contra ela. Também não se pode assumir disciplinas "anteriormente expostas ao ranking" pela estrutura da plataforma: os rankings eram em toda a plataforma, portanto a exposição diferencial é endógena e não é operacionalizada nomeando campos que "pareciam" classificados. A exposição deve ser medida, não atribuída: por exemplo, a partir de páginas de ranking arquivadas recuperadas através do Internet Archive, como a proporção de artigos de um campo que jamais entraram nas listas públicas principais ou a densidade da presença de um campo nas páginas por eJournal. Se o arquivo cobre as páginas de ranking de cada campo densamente o suficiente para render uma medida de exposição utilizável ainda não está estabelecido; o desenho relata essa densidade junto da medida de exposição. Com a exposição assim medida, uma especificação de estudo de evento no nível do artigo compara trajetórias de atenção em campos de alta e baixa exposição em torno das datas de congelamento e remoção: a equação da Seção 8.4 com os coeficientes de interesse em interações Exposure_f × EventTime_k ao invés de apenas nos termos de tempo de evento. Os resultados mais informativos são distribucionais (Seção 8.1). O mecanismo de ranking poderia mudar a concentração de atenção enquanto deixa as médias quase intactas, e porque qualquer efeito é esperado se concentrar nos artigos da cauda já visíveis que preencheram as listas, os resultados de campo-média são subpotentes por construção. Coeficientes de Gini, medidas de participação no topo, razões novato/estabelecido e gradientes de prestígio são portanto os resultados principais, com a predição bilateral de RQ1, e a simulação de potência da Seção 8.1 deve ser direcionada para estas estatísticas distribucionais, não para a atenção média, ou o estudo corre o risco de ser declarado nulo pela falta de potência no estimando errado.
Duas predições nomeadas e direcionais refinam a RQ1 bilateral sem substituí-la, ambas testes de heterogeneidade pré-especificados. A hipótese de precipício de visibilidade sustenta que coortes de postagem pós-encerramento em campos anteriormente expostos ao ranking experienciam uma queda discreta no alcance inicial em relação a coortes pré-encerramento correspondentes, porque uma superfície de descoberta foi removida em uma data conhecida. Sob uma hipótese compensatória, se os Rankings funcionassem como um mecanismo de visibilidade compensatória para campos com ecossistemas de descoberta fraco, o efeito de sua remoção deveria ser maior em campos com bases de assinatura eJournal pequenas, a extremidade inferior do gradiente de Whalen [168].
Um resultado secundário barato estende o desenho da alocação de atenção para a saúde da própria plataforma: o volume de novas postagens por campo, em janelas antes e depois de 15 de julho de 2026. Se os Rankings fornecessem parte do incentivo para postar, seu encerramento poderia desestimular novas submissões. Esse é um resultado comportamental distinto dos resultados de atenção acima, observável a partir de listagens de novos artigos públicos contra a própria linha de base da plataforma de mais de 250.000 novos artigos em 2025 [145], e uma resposta empírica direta à polêmica contemporânea de "pular o tubarão" registrada na Seção 2.2 [12][B-11]. A predição é deixada bilateral, como RQ1, e o resultado de volume de postagem conecta-se ao item (3) da pesquisa do Estudo 4 ("evitando novos uploads").
A análise é quase-experimental. Cinco ameaças são materiais. Uma é efeitos de anúncio e antecipação: o encerramento foi anunciado em 12 de junho de 2026 com um alvo inicial de 1º de julho e executado em 15 de julho, portanto uma janela de antecipação genuína existiu e mudou [148][149]. Um aglomerado de mudanças concorrentes na plataforma 2026 compartilha o calendário do encerramento e não pode ser separado dele por qualquer data de evento única: o reposicionamento estratégico anunciado em 13 de abril de 2026, o encerramento da série comercial de artigos de pesquisa executada até o final de dezembro de 2026, e a mudança de licença de autor de 20 de julho de 2026, cinco dias após a remoção [146][150]. Porque essas intervenções se sobrepõem à janela de julho, uma única data de evento comum atribuiria seu efeito combinado apenas ao encerramento. A identificação portanto se apoia no tempo escalonado acima (o congelamento de dezembro precede cada um deles), em datas placebo, e na assinatura distribucional específica para uma retirada de ranking, e o desenho relata quais mudanças co-temporizadas permanecem não separadas. Então há o vale de atenção do verão: meados de julho coincide com o declínio sazonal documentado no acesso acadêmico, com acessos caindo na ordem de 50% nos meses de verão [178], portanto um contraste entre campos executado na data de remoção confunde o encerramento com a sazonalidade de verão própria de um campo, que difere por disciplina. Efeitos fixos de data do calendário absorvem apenas o componente sazonal comum. O desenho portanto requer linhas de base sazonais específicas por campo (uma comparação de mesma janela do ano anterior por campo). Diferenças não aleatórias entre campos de alta e baixa exposição são uma ameaça adicional, abordada pela operacionalização de exposição medida acima e por grupos de comparação correspondentes. A ameaça restante é prospectiva: SSRN declarou que pode revisitar rankings, portanto uma reinstalação parcial durante a janela de observação introduziria um segundo evento. O desenho pré-registra tratamento de qualquer tal reinstalação como um ponto de censura para o pós-período e modelagem como um tratamento distinto ao invés de incorporá-lo ao contraste de encerramento. Em todo relatório, o tempo do evento é particionado em três períodos nomeados, anúncio (de 12 de junho de 2026), transição, e encerramento (de 15 de julho de 2026), para que efeitos de antecipação sejam estimados. O desenho pré-especificado portanto inclui testes de pré-tendência do tempo de evento, larguras de banda alternativas, datas placebo, tendências de tempo específicas por campo e linhas de base sazonais específicas por campo, e análises de sensibilidade excluindo o período de transição de anúncio para encerramento. A Figura 11 apresenta os resultados pretendidos de ambos os estudos de evento como modelos de desenho.
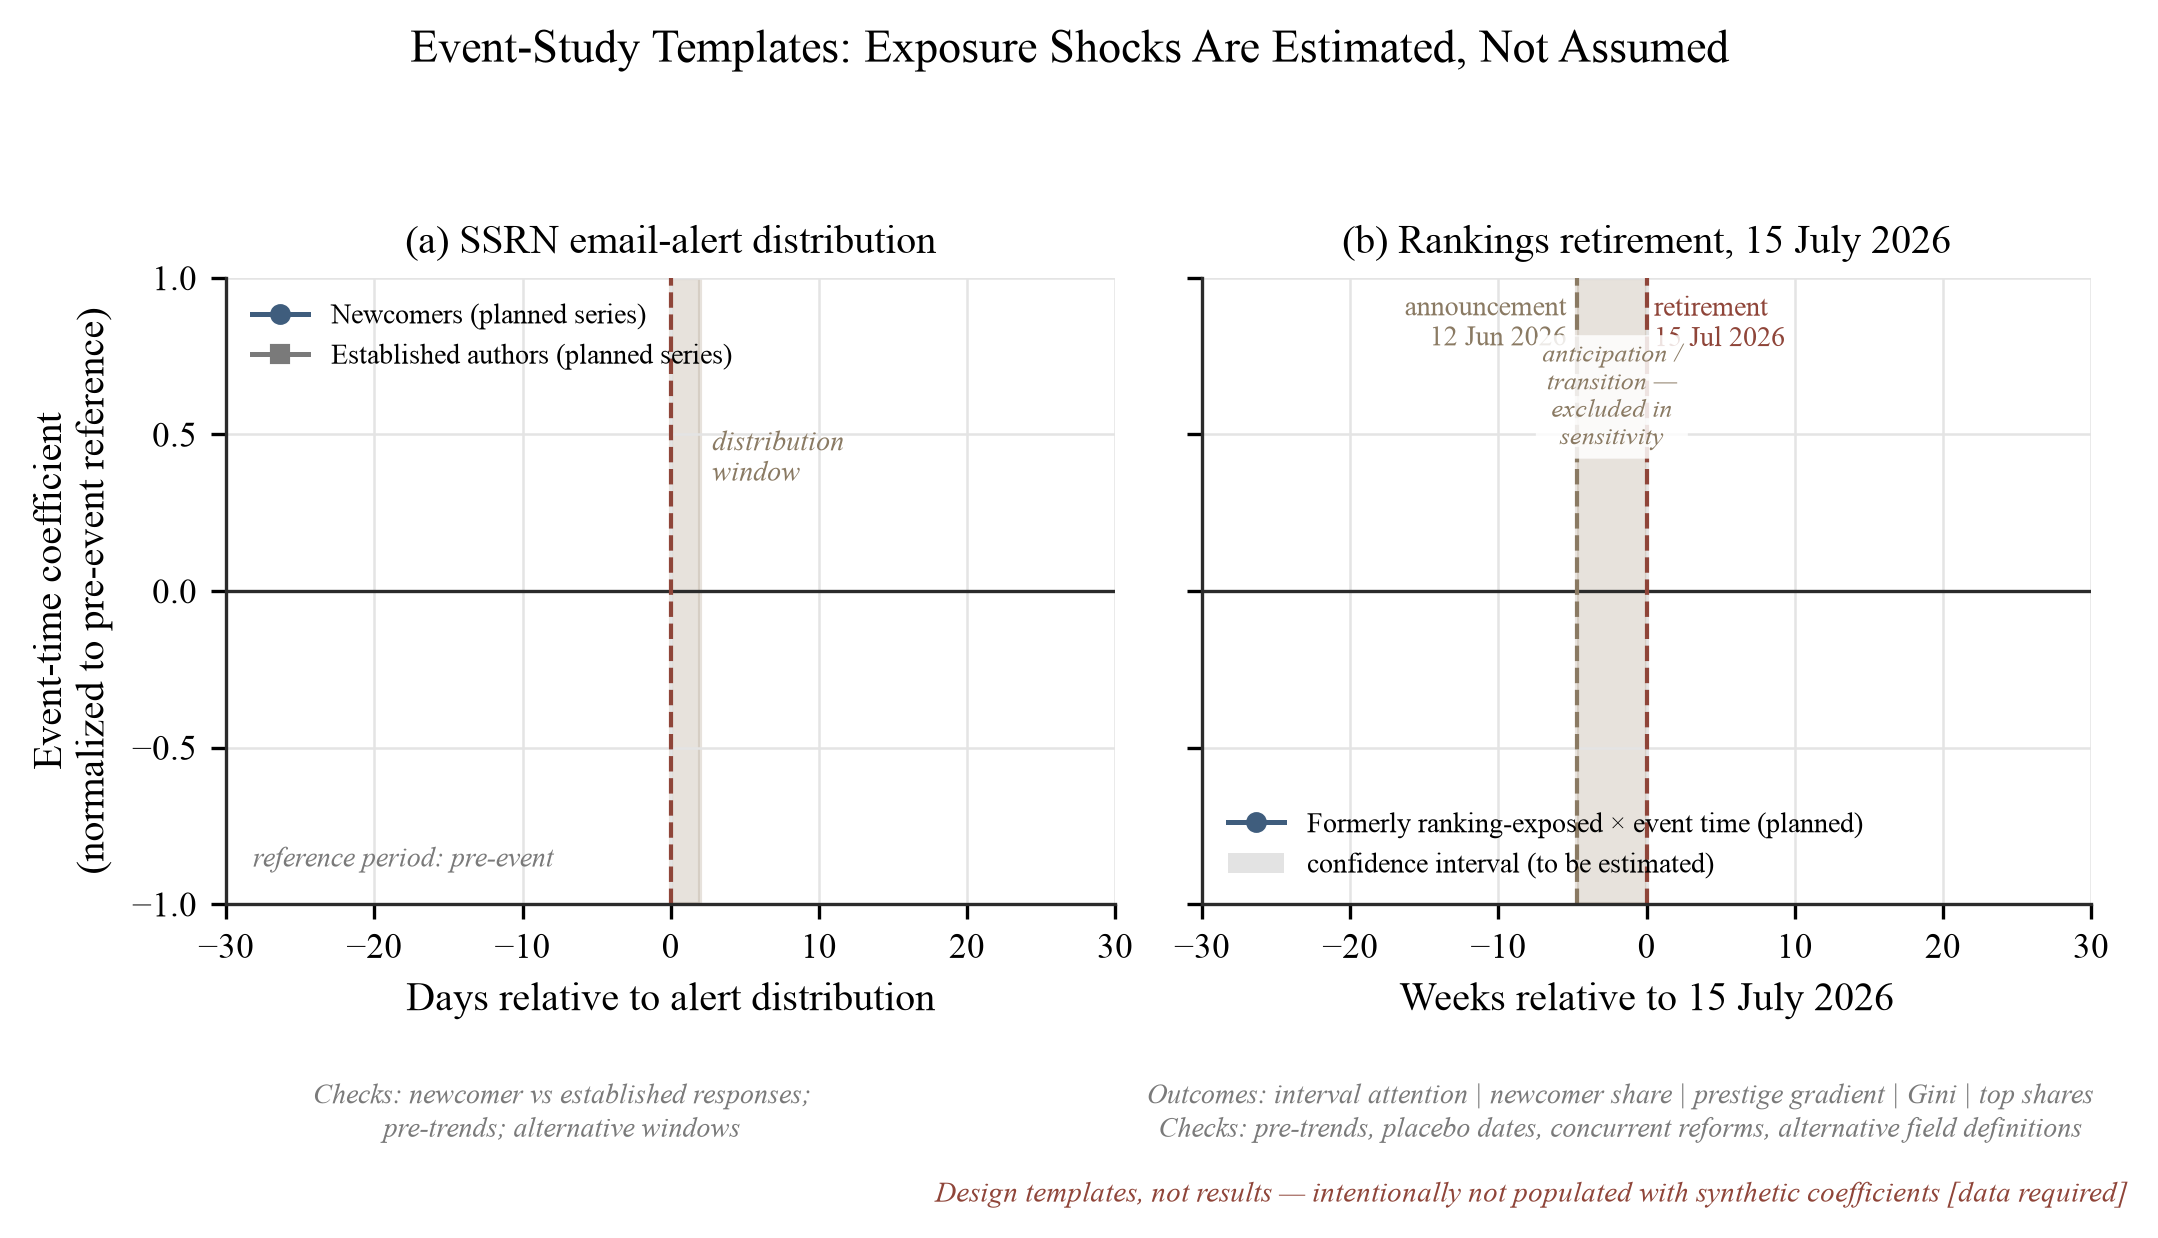
Figura 11. Modelos de design de estudo de eventos para os dois quase-experimentos de plataforma. Resultados de estudo de eventos pré-especificados para os designs das Seções 8.4–8.5: (a) atenção em torno da distribuição de alerta de email, autores iniciantes versus autores estabelecidos, com a janela de distribuição sombreada porque alertas chegam como uma janela, não um instante; (b) atenção e resultados de desigualdade em torno da aposentadoria do Rankings, com a data do anúncio (12 de junho de 2026) e a data da aposentadoria (15 de julho de 2026) marcadas e o período de antecipação/transição sombreado — a janela excluída nas análises de sensibilidade pré-especificadas. Os resultados distribucionais (atenção de intervalo, participação de iniciantes, gradiente de prestígio, Gini, participações principais) e verificações necessárias são declarados na figura em si. Os coeficientes são normalizados para o período de referência anterior ao evento; as regiões cinzentas sombreadas denotam intervalos de confiança. Estes painéis são modelos de design; nenhum valor empírico é mostrado, e o código de geração será lançado com os materiais de pré-registro.
8.6 Quatro estudos pré-especificados
Juntamente com o painel principal, quatro estudos são especificados e resumidos na Tabela 17. Os dois estudos com dados públicos (1 e 2) podem ser conduzidos por qualquer pesquisador sem permissões de acesso restrito, dentro dos limites de acesso observados na Seção 9 (coleta com taxa limitada de acordo com os termos de serviço da plataforma). Os dois estudos com sujeitos humanos (3 e 4) requerem participantes e seguem sob as aprovações éticas declaradas nas Declarações. Todos os quatro existem para começar a preencher o vácuo de referência imediatamente, e não após um painel de múltiplos anos se consolidar.
Tabela 17. Os quatro estudos pré-especificados.
| Estudo 1 | Estudo 2 | Estudo 3 | Estudo 4 | |
|---|---|---|---|---|
| Pergunta de pesquisa | Qual é a distribuição mediana/percentil de downloads? | Motores de resposta de IA citam o preprint em si? | Leitor ou predador primeiro? | Como os autores leem seus próprios contadores? |
| Dados | 3.000–5.000 IDs de artigos SSRN estratificados | 100–200 perguntas de nicho × ~5 motores | 2 publicações instrumentadas, log de entrada de 90 dias | Pesquisa de autor pré-registrada, quatro itens com redação fixa |
| Método | Mediana, Gini, curvas de decaimento, regressão de contagem de classificação | Codificação de recuperação + regressão logística | Rastreamento de alias por canal + codificação de mensagem | Questionário de forma fechada + compartilhamentos descritivos |
| Desfecho primário | Mediana; compartilhamento ≤10 downloads; Gini de atenção | Visibilidade de máquina V | t_leitor vs. t_predador | Compartilhamento nunca comparando contadores a nenhuma referência; distribuição de primeira leitura para "7 downloads" |
| Previsão falsável | mediana < 0,5 × média; Gini 0,75–0,90 | Preprint citado em 10–35% dos testes | t_predador < t_leitor | Maioria relata nunca comparar com nenhuma referência |
| Entrega principal | Tabelas públicas de referência percentil legíveis por máquina, estratificadas por idade, campo e coorte | Protocolo de auditoria de recuperação e atribuição reproduzível com um instantâneo com carimbo de data/hora | Protocolo aberto de postagem instrumentada com linha de base pré-postagem e codebook de codificação | Distribuição documentada de interpretações de autores e mudança de comportamento relatada |
| O design falha se | A normalização não melhora a estabilidade ou previsão fora da amostra sobre contagens brutas | Características não predizem nada além de relevância da consulta, motor e data | Nenhuma descontinuidade pós-postagem após controles de linha de base e exposição, ou codificação não confiável | Recrutamento ou auto-seleção deixa até os compartilhamentos descritivos ininterpretáveis |
| Perfil de recursos | Dados públicos; raspagem e estatísticas padrão | Consultas públicas de motor de IA; codificação manual | Duas postagens instrumentadas; log de caixa de entrada (IRB) | Pesquisa anônima de autor (IRB) |
Nota. Cada estudo deve ser registrado no OSF antes da coleta de dados, com código liberado.
Estudo 1: "Anatomia da Mediana." O estudo obtém uma amostra estratificada aleatória de 3.000–5.000 IDs de resumos SSRN, um intervalo de planejamento, com o N final definido por simulação de poder contra as faixas de previsão pré-especificadas e os menores efeitos de interesse (Seção 8.1). A estratificação é por ano de postagem e rede, e downloads de vida útil por artigo, visualizações de resumo, data de postagem e contagem de classificação são coletados através das rotas de acesso da Seção 8.3. Estimandos: downloads de vida útil mediana; as proporções de artigos com zero e com dez ou menos downloads; o Gini de atenção com intervalos de confiança bootstrap; a taxa de conversão de visualizações para downloads, estimada geral e estratificada por rede (um teste da hipótese de estilo de leitura de audiência da Seção 5.2); curvas de decaimento de downloads; e uma regressão de log de downloads na contagem de classificação com efeitos fixos de ano e rede (um teste direto de P2 [168]). As faixas de previsão pré-especificadas (downloads de vida útil mediana aproximadamente 30–80, uma proporção ≤10 downloads de 15–30%, Gini 0,75–0,90) são extrapolações dos ancoradouros datados da Seção 5 [83][85][139] e das magnitudes de Gini de atenção em mídia adjacente [180], declaradas antecipadamente para que o estudo possa falsificá-las. O Estudo 1 é a semente empírica da referência percentil discutida na Seção 8.8.
Estudo 2: "As Máquinas Leem Você?" Uma proporção crescente de busca de informações agora começa em interfaces generativas: aproximadamente metade dos adultos dos EUA relatam usar chatbots de IA, e cerca de um quarto os usam diariamente [121], com uma minoria substancial já tratando um chatbot como seu primeiro mecanismo de busca em amostras de conveniência [4]. A introdução (Seção 1.6) conceptualizou isso como uma migração ascendente do guardião de descoberta (marca de revista → repositório → mecanismo de busca → camada de resposta de IA) com cada passo realocando o controle mais longe do autor e mais longe de qualquer referência pública (Figura 12). Se a camada superior recupera preprints é desconhecido: a literatura de otimização de motores generativos se concentrou até agora em marcas e comércio [5][100][164], e auditorias de busca de IA se preocuparam com atribuição de notícias em vez de fontes acadêmicas [82]. Essas auditorias aconselham ceticismo sobre a confiabilidade do novo guardião: na auditoria do Tow Center (1.600 consultas em oito motores), os motores coletivamente falharam em recuperar informações corretas em mais de 60% dos testes, com o melhor desempenho (Perplexity) respondendo incorretamente 37% das vezes e o pior (Grok-3) 94%, e típicamente erravam com confiança injustificada em vez de se recusar a responder [82], figuras de um teste de atribuição de notícias, não de busca acadêmica. Nenhum estudo controlado de visibilidade de preprint acadêmico em motores de resposta de IA existia em agosto de 2026 [100]. A contribuição se posiciona contra duas linhas adjacentes de trabalho. Os estudos de otimização de motores generativos que este artigo se baseia medem e manipulam a visibilidade de marcas e páginas comerciais [5][164], não a recuperação de artefatos acadêmicos. Uma vertente separada mostra que quando modelos de linguagem geram referências, eles reproduzem e amplificam a tendência humana de citar trabalhos já altamente citados, estendendo um efeito Mateus para a camada de máquina [7], que é o mecanismo P3b (Seção 8.2) que testa. Nenhuma vertente examinou a descoberta de preprints científicos sob relevância de consulta controlada, e especificamente sua recuperabilidade após uma superfície de classificação de plataforma ser removida, que é o objeto que o Estudo 2 isola.
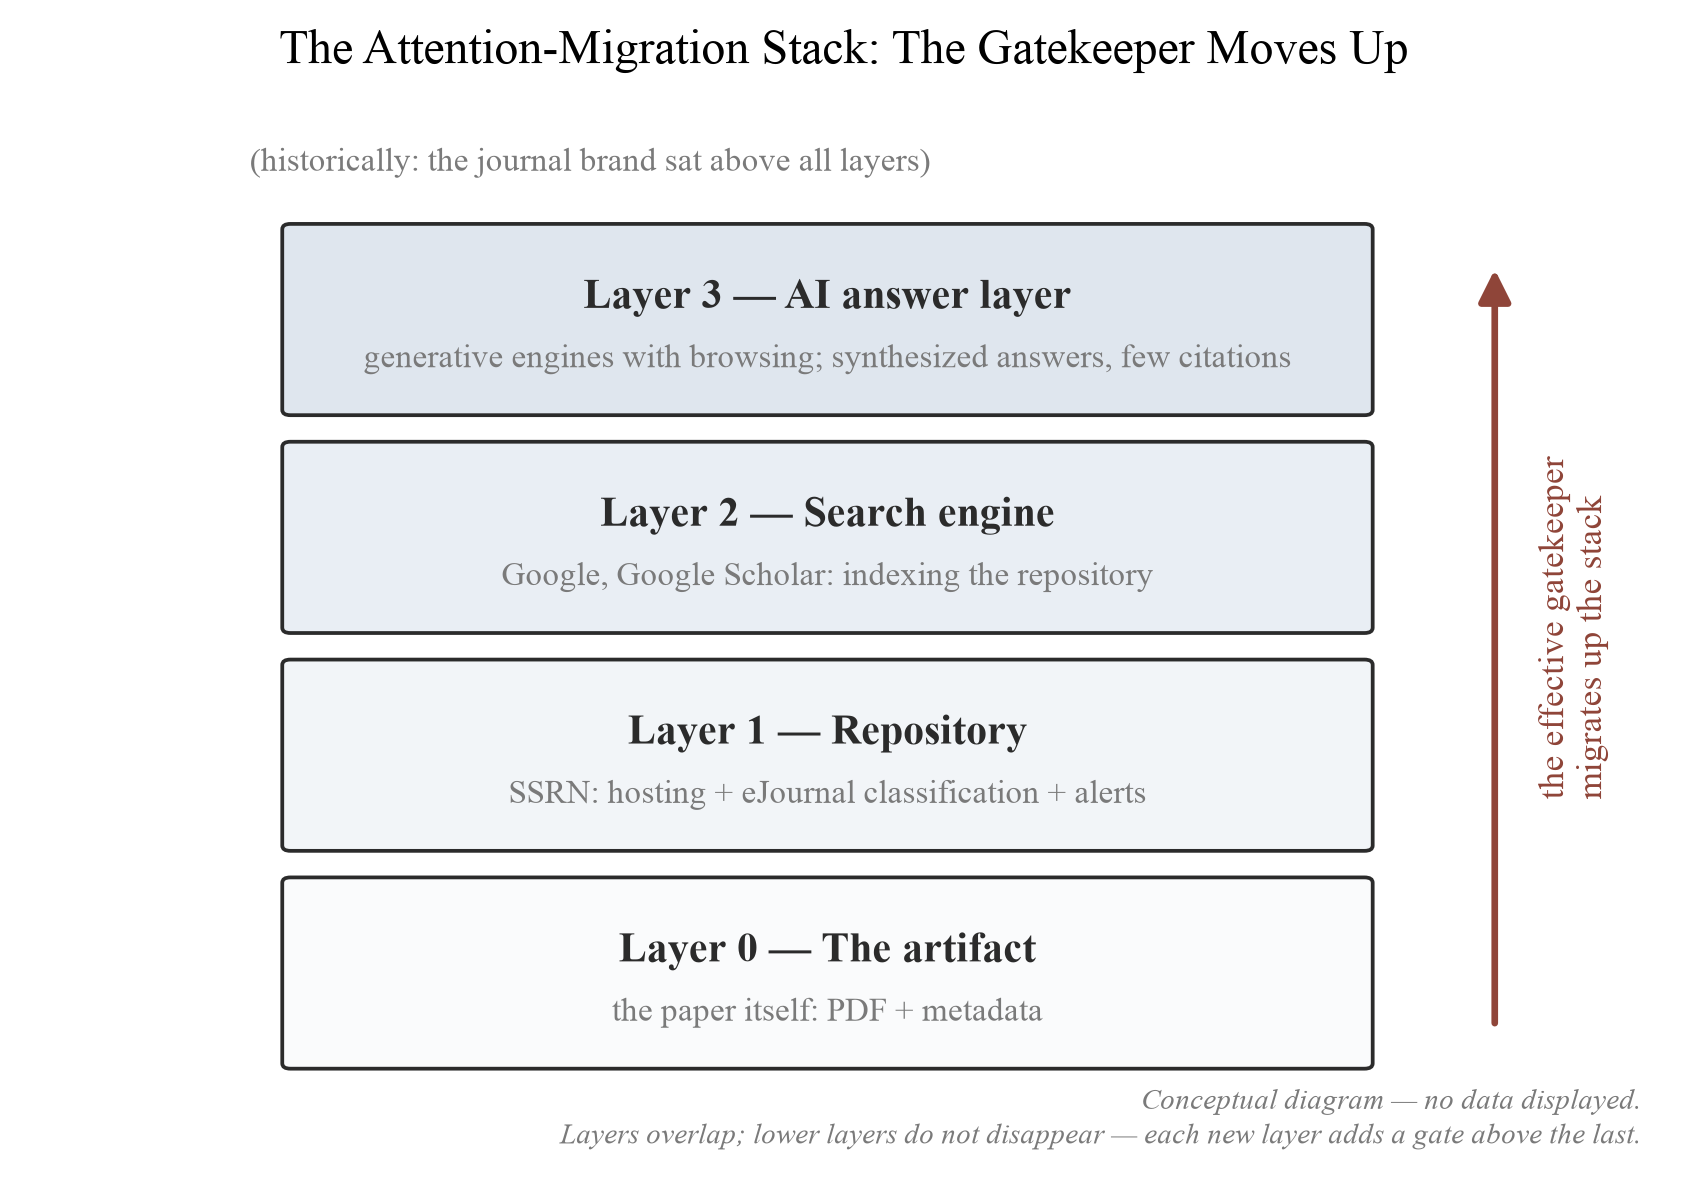
Figura 12. A pilha de migração de atenção. O caminho estratificado de um manuscrito concluído para a atenção de um leitor. A tese da migração sustenta que o guardião efetivo — a camada que decide quais artefatos recebem atenção — subiu ao longo do tempo, de marca de revista através de repositório e mecanismo de busca até à camada de resposta de IA; cada movimento ascendente desloca o controle ainda mais do autor e ainda mais longe de qualquer referência pública. A pilha é um modelo conceitual.
O Estudo 2 constrói 100–200 perguntas de nicho, cada uma engenhada de forma que um preprint SSRN específico seja a melhor fonte disponível, uma afirmação de relevância validada por avaliadores especialistas em cego em vez de autocertificada pelos autores da consulta. Ele consulta os principais sistemas de IA para consumidores com navegação ativada e codifica o resultado em seis categorias mutuamente exclusivas: (1) o próprio preprint focal citado; (2) a versão publicada ou um espelho do mesmo artigo citado, um caso que um esquema mais grosseiro classificaria incorretamente como ausência; (3) cobertura secundária citada sem o artigo; (4) uma fonte diferente mas defensável citada; (5) nenhuma fonte rastreável; e (6) recusa do mecanismo (Figura 13). Para cada resposta que cita o artigo focal ou uma versão dele, um sinalizador binário de fidelidade de atribuição adicionalmente registra se a afirmação na resposta é realmente apoiada pela fonte citada. A visibilidade e a fidelidade são relatadas separadamente e nunca mescladas em uma única pontuação, porque um mecanismo pode citar um artigo de forma proeminente enquanto o deturpa (lavagem de citação) ou reproduzir seu conteúdo sem nenhuma citação (influência sem atribuição). A regressão confirmatória permanece logística, no contraste "artigo focal ou sua versão citada" versus todos os outros resultados, com erros padrão agrupados, ou preferencialmente uma estrutura de efeitos aleatórios cruzados ajustada, para respeitar a não-independência de observações que compartilham um mecanismo, uma consulta ou um artigo focal, já que o mesmo artigo consultado em diferentes mecanismos e o mesmo mecanismo consultado em diferentes artigos cada um induz resultados correlacionados que erros independentes de teste ingênuos subestimariam. Formalmente, o estimando da auditoria é M_pqe: a probabilidade de que o artigo p seja citado pelo mecanismo e em resposta à consulta q. M_pqe não é uma propriedade do artigo sozinho, já que varia entre consultas, mecanismos, datas e versões de modelo, portanto a notação define o estimando e cada execução com timestamp é lida como uma estimativa de M_pqe em sua data. A amostra do mecanismo deve se estender além de chatbots para consumidores até a camada de recuperação acadêmica emergente (ferramentas como Consensus, Elicit, Scite e Semantic Scholar, que se baseiam em corpus acadêmicos e citam artigos reais), já que um preprint invisível para mecanismos de consumidor ainda pode ser descoberto por aqueles específicos da disciplina, e a divergência entre as duas camadas é em si um resultado de interesse. A visibilidade da máquina é então regredida em características do artigo operacionalizadas na Tabela 18, incluindo a covariável de visibilidade prévia que P3b exige: o footprint web e acadêmico pré-auditoria de cada artigo, congelado na construção da consulta. A amostra de consulta é estratificada por visibilidade prévia para que artigos de inicialização a frio sejam representados por design. Como os mecanismos geradores não são estacionários, o design emparelha um snapshot primário com timestamp com um protocolo de re-execução roteirizado que outros podem repetir. Três requisitos adicionais de higiene de auditoria são pré-especificados: controles negativos (artigos prestigiosos mas irrelevantes, variantes de título e prompts que não devem recuperar o trabalho focal) tornam a citação indiscriminada detectável; cada consulta é executada em variantes de prompt equivalentes sob estado de sessão registrado (sessões limpas versus conectadas; mecanismo, versão de modelo, data e geografia), para que artefatos específicos de prompt e sessão sejam separáveis do comportamento de recuperação estável; e um subconjunto aleatório de resultados é codificado em duplicado, com concordância entre avaliadores relatada. A lista de verificação de auditoria passo a passo completa é depositada com os materiais de pré-registro. A entrada principal do estudo é tempo do pesquisador (a validação de relevância em cego de 100–200 perguntas e a codificação dupla) em vez de dados de acesso restrito ou infraestrutura especializada. Um estudo que deve pagar pelo tempo de avaliador especialista a taxas de mercado deve orçar explicitamente esse trabalho. A previsão pré-especificada é que o preprint em si seja citado em uma minoria de testes (faixa 10–35%), com características de resumo estruturado e versão publicada elevando a visibilidade (P3). O Estudo 2 é um protocolo entre cinco itens de agenda. Uma auditoria completa de visibilidade de máquina acadêmica, incluindo comparações entre mecanismos e entre repositórios, é o assunto de um artigo complementar planejado.
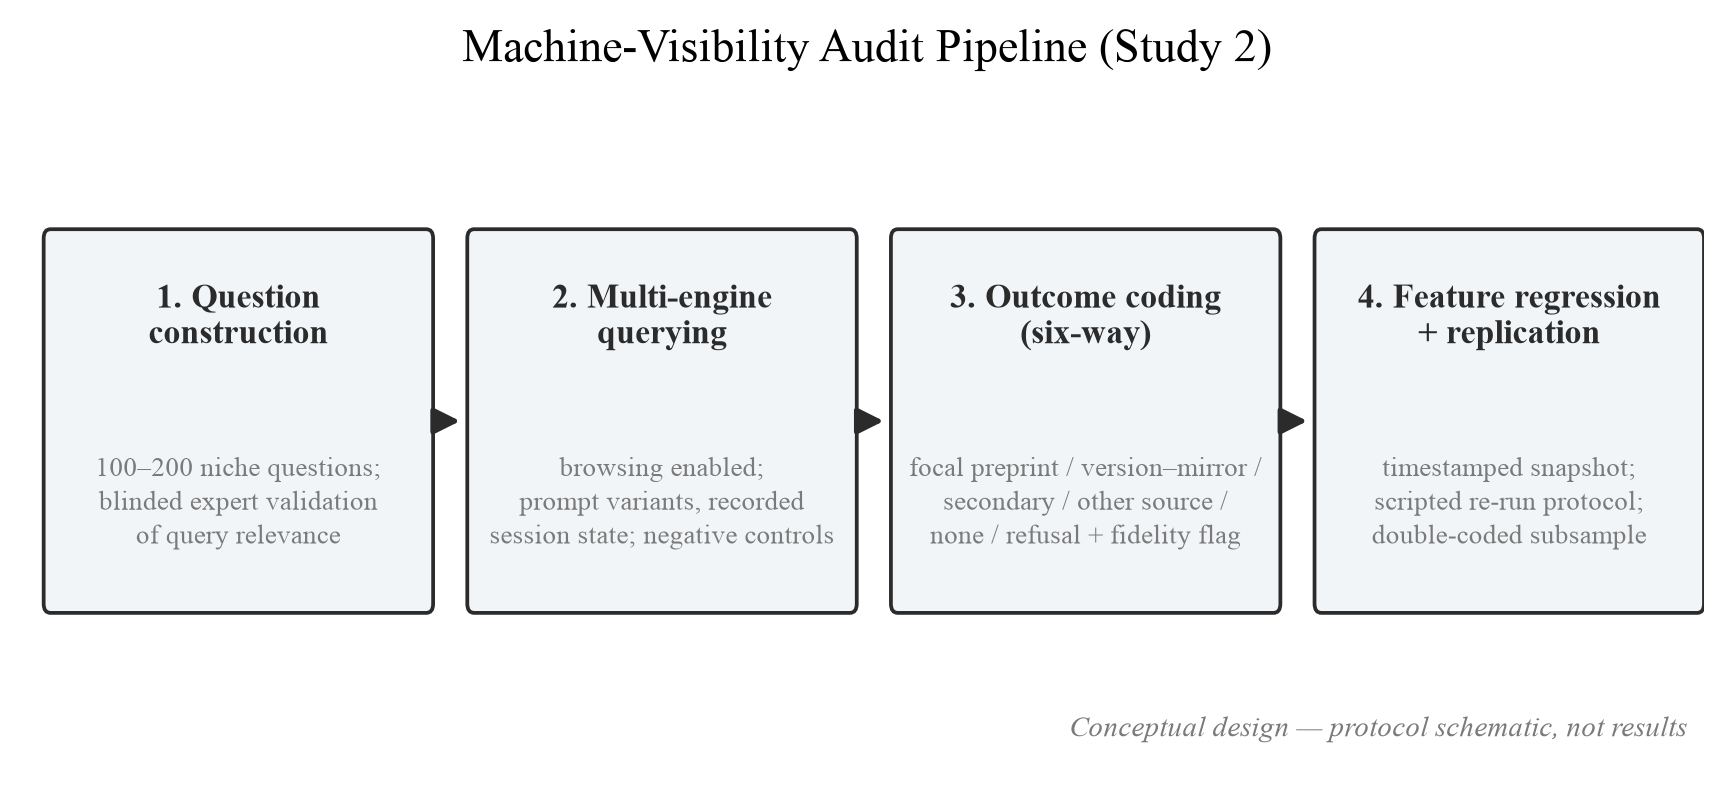
Figura 13. O pipeline de auditoria de visibilidade de máquina (Estudo 2). O pipeline de quatro etapas do Estudo 2. A codificação de seis vias separa a citação do preprint focal da citação de sua versão publicada ou espelho — prevenindo classificação falsa de ausência — e o sinalizador de fidelidade de atribuição mantém "foi citado" distinto de "foi citado fielmente". A estrutura snapshot-mais-replicação aborda a não-estacionariedade do modelo: o snapshot primário é datado, e o protocolo de re-execução permite que qualquer pesquisador reproduza a auditoria em uma data posterior.
Tabela 18. Operacionalização de características de visibilidade de máquina (Estudo 2).
| Variável | Definição | Codificação |
|---|---|---|
| DOI presente | Página do artigo expõe um DOI registrado | 1/0 |
| Tipo de título | Título descritivo vs. alusivo | descritivo = 1 |
| Estrutura do resumo | Estruturado/rico em estatísticas vs. narrativo | estruturado = 1 |
| Idade | Meses desde a primeira postagem | inteiro |
| Contagem de classificação | Número de eJournals atribuídos | inteiro |
| Cobertura secundária | ≥1 menção em blog/notícia indexada existe | 1/0 |
| Versão publicada | Uma versão de registro em periódico existe | 1/0 |
| Visibilidade anterior | Pegada web e acadêmica pré-auditoria do artigo e seus autores, congelada na construção da consulta (P3b) | ordinal estratificado |
| Resultado V | Resultado de recuperação para o artigo focal | seis categorias: preprint focal / versão publicada ou espelho / apenas secundária / outra fonte defensável / nenhuma rastreável / recusa; mais sinalizador de fidelidade de atribuição binária para casos citados |
Nota. As escolhas de características adaptam fatores de otimização de mecanismo generativo documentados [5][164] para artefatos acadêmicos. A maior auditoria desse tipo, da ordem de 252.000 testes em seis mecanismos baseados em LLM, identificou relevância temática e posição da lista no contexto recuperado como os principais impulsionadores de serem citados primeiro [164]. A posição da lista é, portanto, uma hipótese separada e transferível para o Estudo 2, e a posição da lista de resultados deve ser registrada onde for observável.
A Tabela 19 complementa a Tabela 18 em um nível diferente de descrição. A Tabela 18 operacionaliza os recursos no nível do artigo cujos efeitos o Estudo 2 estima, enquanto a Tabela 19 especifica os construtos de medição da auditoria: o que é medido, sob quais controles e contra qual ameaça primária à validade. Cada construto é uma afirmação distinta sobre a camada de máquina, e cada ameaça nomeia a maneira específica como uma auditoria ingênua daria errado.
Tabela 19. Construtos de medição da auditoria de visibilidade de máquina (Estudo 2).
| Construto | Medida operacional | Controles obrigatórios | Ameaça primária |
|---|---|---|---|
| Visibilidade direta de máquina | Preprint focal citado ou vinculado na resposta | Relevância da consulta, mecanismo, data, estado da sessão | Desvio de modelo e índice |
| Substituição de fonte | Versão publicada, espelho ou cobertura secundária citados em vez do preprint | Correspondência de versão, DOI, variantes de título | Classificação falsa como ausência |
| Posição da citação | Classificação e proeminência da citação focal na resposta | Comprimento da resposta e contagem de citações | Apresentação específica da interface |
| Fidelidade de atribuição | Afirmação na resposta apoiada com precisão pelo artigo citado | Verificação de afirmação cega–fonte | Lavagem de citação ou alucinação |
| Sensibilidade da consulta | Variação de resultados em frases de consulta equivalentes | Variantes de prompt aleatórios | Artefatos específicos do prompt |
| Replicabilidade | Mesmo resultado em data posterior ou em uma nova execução limpa | Protocolo arquivado e metadados do sistema | Não-estacionariedade do mecanismo |
A transferência mais defensável da literatura comercial de GEO é uma agenda de auditoria de características, não uma receita promocional: a Tabela 20 lista características candidatas cuja associação com visibilidade de máquina o Estudo 2 foi projetado para confirmar ou refutar. Cada linha é uma hipótese em vez de uma tática estabelecida, e uma característica associada à recuperação ainda pode ser um proxy para maturidade do artigo, popularidade do tópico ou visibilidade anterior em vez de uma alavanca.
Tabela 20. Agenda de auditoria de características para visibilidade de máquina (hipóteses para o Estudo 2, não recomendações).
| Característica candidata | Mecanismo hipotético | Evidência de apoio |
|---|---|---|
| Registrar um DOI | Identificador estável auxilia recuperação e correspondência de citação | [164] |
| Resumo estruturado e rico em estatísticas | A adição de estatísticas aumentou a visibilidade generativa em até ~40% em benchmarks comerciais | [5] |
| Título descritivo e denso em relevância | A relevância temática é um dos principais impulsionadores de citação em respostas de IA | [164] |
| Maximizar classificações precisas de eJournal | Mais classificações associadas a mais downloads, menos zeros | [168] |
| Garantir ≥1 item de cobertura secundária | Os mecanismos frequentemente citam cobertura secundária em vez de fontes primárias | [82] |
Estudo 3: "Quem Chega Primeiro?" Um protocolo de postagem instrumentalizada testa P4 diretamente. Dois artigos de trabalho reais são postados usando aliases de email com sinal de mais únicos por canal de exposição, com um log de entrada de 90 dias precedido por uma janela de linha de base pré-postagem de duas a quatro semanas nos mesmos aliases. Sem uma linha de base, um aumento no volume de solicitações não pode ser atribuído à postagem em absoluto, pois o spam acadêmico chega continuamente em relação a uma alta taxa de fundo. Cada mensagem é codificada como contato acadêmico genuíno ou solicitação predatória usando padrões de solicitação publicados [96] e critérios curados do tipo lista de bloqueio, em relação às altas taxas de fundo documentadas nas auditorias de especialidade revisadas na Seção 7.2 [9][84][63][61]. O resultado é a comparação de tempo para primeiro contato genuíno e tempo para primeira solicitação predatória atribuíveis à postagem. A previsão pré-especificada, de acordo com P4, é que a solicitação preceda o contato genuíno. Duas regras de medição são fixadas antes do lançamento. As janelas de linha de base e pós-postagem têm comprimentos desiguais (aproximadamente duas a quatro semanas em relação a noventa dias), portanto a comparação é de taxas de chegada (eventos por dia de alias) e de funções de sobrevivência, nunca de contagens de eventos brutos, que a assimetria de janela distorceria de outra forma. E o tempo para primeiro contato é censurado à direita por construção: com dois artigos, um alias que não recebe contato genuíno dentro da janela de 90 dias produz uma observação censurada, não uma observação zero, portanto a regra de censura é pré-especificada. As observações são censuradas à direita em 90 dias, aliases sem evento contribuem tempo censurado para a estimativa de sobrevivência em vez de serem descartados ou codificados como imediatos, e com N = 2 as curvas resultantes são relatadas com sua incerteza exata de amostra pequena em vez de como estimativas pontuais. O estimando causal do design de replicação distribuída é a mudança no risco de solicitação após postagem (não a identidade de nenhum downloader), estimada com métodos de sobrevivência/história de evento em janelas pré e pós-postagem correspondentes. Porque a produtividade visível de um autor plausivelmente prediz o volume de solicitações independentemente de qualquer postagem única (a solicitação é colhida da produção pública acumulada de um autor, portanto as altas taxas de fundo documentadas nas auditorias de especialidade da Seção 7.2 aumentam proporcionalmente a essa produção), replicações distribuídas devem registrar controles de exposição em nível de autor (postagens anteriores, volume de publicação e superfície de contato pública) ao lado do evento focal. Este é um estudo de caso instrumentalizado N = 2, uma prova de mecanismo e um protocolo aberto convidando replicação distribuída, que coletivamente produziria uma estimativa com poder adequado. N = 2 demonstra a viabilidade da instrumentação, não prevalência e não magnitude causal. Ao contrário dos Estudos 1, 2 e 4, que têm poder em relação aos tamanhos de efeito pré-especificados, o Estudo 3 é um piloto de viabilidade e um protocolo aberto de replicação.
O esquema de codificação é fixado antes do lançamento. As mensagens de entrada são codificadas em sete tipos: solicitação de revista, convite para conferência, solicitação de avaliação por pares, convite para comitê editorial, convite para capítulo de livro, oferta de serviço comercial e correspondência acadêmica genuína, um esquema mais amplo que uma divisão binária predatória/genuína. Cada registro carrega um conjunto mínimo de campos: timestamp, alias receptora (canal), nome da revista/conferência, divulgação de taxa, especificidade do artigo focal, linguagem de urgência, resultado de verificação em relação a serviços de triagem mantidos e confiança do codificador. Casos borderline e locais legítimos de baixo prestígio são regidos por regras pré-especificadas em vez de julgamento ad hoc. Um local novo ou obscuro não é automaticamente predatório. Uma subamostra aleatória é duplamente codificada com concordância entre avaliadores relatada. Apenas contagens agregadas são divulgadas (Seção 9; Declarações), e o codebook completo é depositado com o pré-registro. O volume de solicitação não é evidência de leitura, e a solicitação não move os contadores públicos: o sistema de integridade da SSRN exclui atividade automatizada anômala das contagens oficiais [144], e nenhuma inferência de caixa de entrada para painel é licenciada em qualquer direção.
Estudo 4: "Como Autores Leem Seus Contadores." Uma pesquisa de autores pré-especificada converte a evidência de demanda do fórum registrada na Tabela 1 em medição direta. O instrumento compreende quatro itens com redação fixa: (1) "Você já comparou seus downloads no SSRN com algum benchmark ou norma?", com opções de resposta distinguindo um número publicado específico, uma tabela específica da disciplina, comparação informal com pares e nunca; (2) "Quando você vê '7 downloads' em seu painel, qual é seu primeiro pensamento?", com opções abrangendo fracasso inferido, muito cedo para dizer, nenhuma ideia do que é normal, e esperado ou adequado; (3) "O encerramento do Rankings de julho de 2026 mudou seu comportamento com preprints?", com opções para parar de verificar estatísticas, evitar novos uploads, fazer upload mas verificar com menos frequência, e sem efeito; e (4) "Você acha que comitês de contratação e promoção entendem as métricas do SSRN?". As previsões pré-especificadas são de que a maioria dos respondentes relata nunca ter comparado seus contadores com nenhum benchmark, e que as primeiras leituras de uma contagem baixa tendem mais para fracasso inferido do que para a leitura prematura que a Seção 5.6 mostra ser geralmente o padrão correto. Alvo de tamanho da amostra, canais de recrutamento e código de análise são fixados no registro. Auto-seleção em direção a autores engajados e, plaussivelmente, mais ansiosos, limita a amostra, assim como o registro da Seção 8.8. O formato de escolha fixa também admite uma trilha qualitativa complementar: codificação temática pré-especificada de questões públicas de autores (com critérios de inclusão explícitos e confiabilidade entre codificadores, sob a ética de citação declarada na Seção 9) e entrevistas semi-estruturadas sobre como autores leem, e se sentem em relação aos seus contadores, alcançando as consequências humanas da apresentação de métricas que itens de forma fechada não conseguem alcançar. Um limite de design incide sobre o constructo central. Quatro itens fixos administrados apenas a autores do SSRN medem um nível de leitura livre de benchmark, não um contraste, e um nível não pode por si só identificar o caminho alegado do artigo da opacidade de benchmark para a cegueira métrica. Uma alta proporção nunca comparada no SSRN é igualmente consistente com uma indiferença geral aos contadores que não tem nada a ver com a opacidade da plataforma. Discriminância e tração causal, portanto, exigem uma condição de comparação: o mesmo instrumento administrado a autores que postam em plataformas com diferentes exposições a benchmarks, arXiv (baseado em endosso e listagem, com suas próprias superfícies de visibilidade) e OSF Preprints, transforma "como autores do SSRN leem seus contadores" em "se autores em plataformas mais e menos opacas leem seus contadores de forma diferente," que é o contraste que a alegação de opacidade para cegueira realmente prediz. O braço de plataforma cruzada é pré-especificado como parte do Estudo 4; sem ele, um resultado de plataforma única permaneceria descritivo do SSRN em vez de ser um teste do mecanismo. O Estudo 4 então testa as alegações interpretativas das Seções 1 e 5 diretamente, medindo o que os autores acreditam que seus contadores significam em vez do que os contadores são.
8.7 O artigo como seu próprio experimento
A própria trajetória de download deste artigo também é pré-especificada. Seus contadores serão registrados aos 30, 90 e 180 dias após a publicação e comparados à mediana do Estudo 1 uma vez que essa mediana seja conhecida. O registro é descritivo e não carrega regras de interpretação, porque ambas as leituras direcionais favoreceriam a tese, e um dispositivo no qual todo resultado confirma o argumento não testa nada; os números serão publicados conforme chegarem. Uma leitura iria contra o enquadramento do artigo: uma trajetória situada na mediana campo-e-idade, nem elevada nem suprimida, indicaria que o design autorreferencial não confere vantagem mensurável de descobribilidade neste caso único. A reflexividade não pode ser evitada, já que este artigo estuda uma métrica que ele próprio acumulará; as alavancas catalogadas são avaliadas pelos testes diretos na Seção 8, não por este registro.
8.8 O benchmark de percentil como bem público
O artefato mais útil que essa agenda pode produzir é uma tabela de percentil para downloads de preprints, o número que todo autor procura e não consegue encontrar. A plataforma historicamente publicou médias e listas top-N, mas não medianas ou percentis, e desde 15 de julho de 2026 exibe apenas contagens por-artigo e por-autor sem contexto comparativo algum [149]. Para o índice-h e indicadores similares existe um gênero de massa-audiência de guias graduados "X é bom?" [118][128]; a auditoria da Seção 2.5 não encontrou equivalente para downloads SSRN. Os materiais brutos para tal tabela existem impressos há anos [18][83][85][139][168], e o que falta é a tradução dessas distribuições para uma escala voltada para o autor.
Após o encerramento, a coleta externa de percentis de plataforma completa não é mais possível: as listas top que vazaram limiares de distribuição foram a única janela pública para a cauda, e se foram [149]. Duas rotas complementares permanecem. Uma é a amostra estratificada do Estudo 1, que produz percentis de plataforma no nível do artigo. A outra rota é um registro coletivo de contadores auto-relatados: um conjunto de dados comunitário voluntário no qual autores contribuem com snapshots de painel datados (idade do artigo, campo, visualizações de resumo, downloads), montados antes que a memória institucional das distribuições pré-encerramento decaia ainda mais. A etapa de preservação do protocolo de dossiê (Tabela 13), se adotada em escala, é a semente de exatamente tal registro. Há também um precedente funcional a estender em vez de inventar. IRUS (Jisc) já agrega estatísticas de uso padronizadas e conformes com COUNTER no nível de item, Total_Item_Requests entre elas, entre repositórios institucionais participantes [185], o que mostra que agregação de uso multi-instituição é operacionalmente tratável. Um registro de preprint é esse modelo estabelecido ampliado para carregar as variáveis de classe de referência que importam aqui (campo, coorte de postagem e estágio de carreira). Um equivalente norte-americano, CC-PLUS, fornece a mesma capacidade como infraestrutura de código aberto, com colheita SUSHI automatizada de uso COUNTER 5 entre consórcios [188], então um registro pode estender uma plataforma funcional em vez de ser encomendado do zero. Um registro deste tipo constituiria a primeira distribuição de download fresca e multidisciplinar desde as amostras de meados dos anos 2010 [85][139]. As fraquezas conhecidas são auto-seleção em direção a autores engajados e provavelmente acima da mediana, auto-relatórios não verificáveis a menos que capturas de tela datadas sejam exigidas, e lacunas de cobertura em campos pequenos. Percentis derivados dele devem portanto ser publicados com ressalvas de seleção explícitas e, onde possível, calibrados contra a amostra de probabilidade do Estudo 1, e células campo-por-idade escassas devem ser relatadas sob encolhimento empírico-Bayes em direção a classes de referência mais amplas em vez de percentis brutos instáveis (Seções 5.2, 8.3). O protocolo de registro e as regras de verificação serão publicados com os materiais de pré-registro, e o formato de contribuição é fixo aqui: um registro de registro é um subconjunto definido do esquema de painel do Apêndice C (os domínios de identidade, tempo, uso, exposição e auditoria), para que registros auto-relatados permaneçam combináveis com o painel do Estudo 1 em vez de acumular como um conjunto de dados incompatível segundo.
Os formatos de saída do registro são pré-especificados junto com seu protocolo, e dois artefatos são comprometidos. Um é uma tabela de tradução que recebe um único número (digamos 10, 40 ou 100 downloads) e retorna, para cada campo coberto, sua posição de percentil e a banda de linguagem clara da Tabela 8; com ela, a resposta para "7 downloads são bons?" pode finalmente ser procurada em vez de adivinhada. O outro é uma figura "leque" de percentil plotando as curvas de download do 25º, 50º, 75º e 95º percentil como funções da idade do artigo, por campo e estrato de recém-chegados: o formato no qual um benchmark responde "quanto é normal no dia X" (Figura 14; [dados necessários]: nenhum artefato pode ser populado com valores sintéticos). Cada lançamento de percentil de uma rota (a amostra de probabilidade ou o registro) é publicado sob a especificação de transparência do Apêndice D, incluindo suas regras de privacidade de célula mínima, para que o benchmark que essa agenda propõe não reproduza a opacidade que foi projetado para remediar. No topo dos dados pertence uma camada fina de auto-serviço, uma calculadora online pública na qual um autor insere campo, idade do artigo e contadores e recebe uma banda de percentil e um veredicto verbal. Transformaria as heurísticas não calibradas de estilo scorecard da Seção 6.3 em um instrumento calibrado assim que, e apenas quando, as distribuições de referência existissem. A Seção 8.10 propõe uma arquitetura multi-modelo através da qual tal serviço poderia ser operado e mantido atualizado. Essa mesma camada de auto-serviço impede que o protocolo de relatório imponha uma nova carga de trabalho aos comitês de contratação e posse, já que a normalização por-número que o formato de dossiê (Tabela 13) exige é realizada pela calculadora (esta seção) e, em escala, pela camada de orquestração (Seção 8.10). Seu caminho realista de implantação passa por encanamentos de informação-pesquisa existentes, a saber sistemas de informação de pesquisa atual (CRIS) e perfis ligados ao ORCID, para que uma leitura de referência possa ser produzida a partir dos identificadores de um artigo em vez de ser montada manualmente. Uma extensão natural entre plataformas é um protocolo de depósito paralelo comparando a trajetória do mesmo artigo em SSRN, arXiv (onde apropriado para o campo) e OSF Preprints, um teste direto de se as bandas da Tabela 8 transferem entre arquiteturas push- e pull- (Tabela 6).
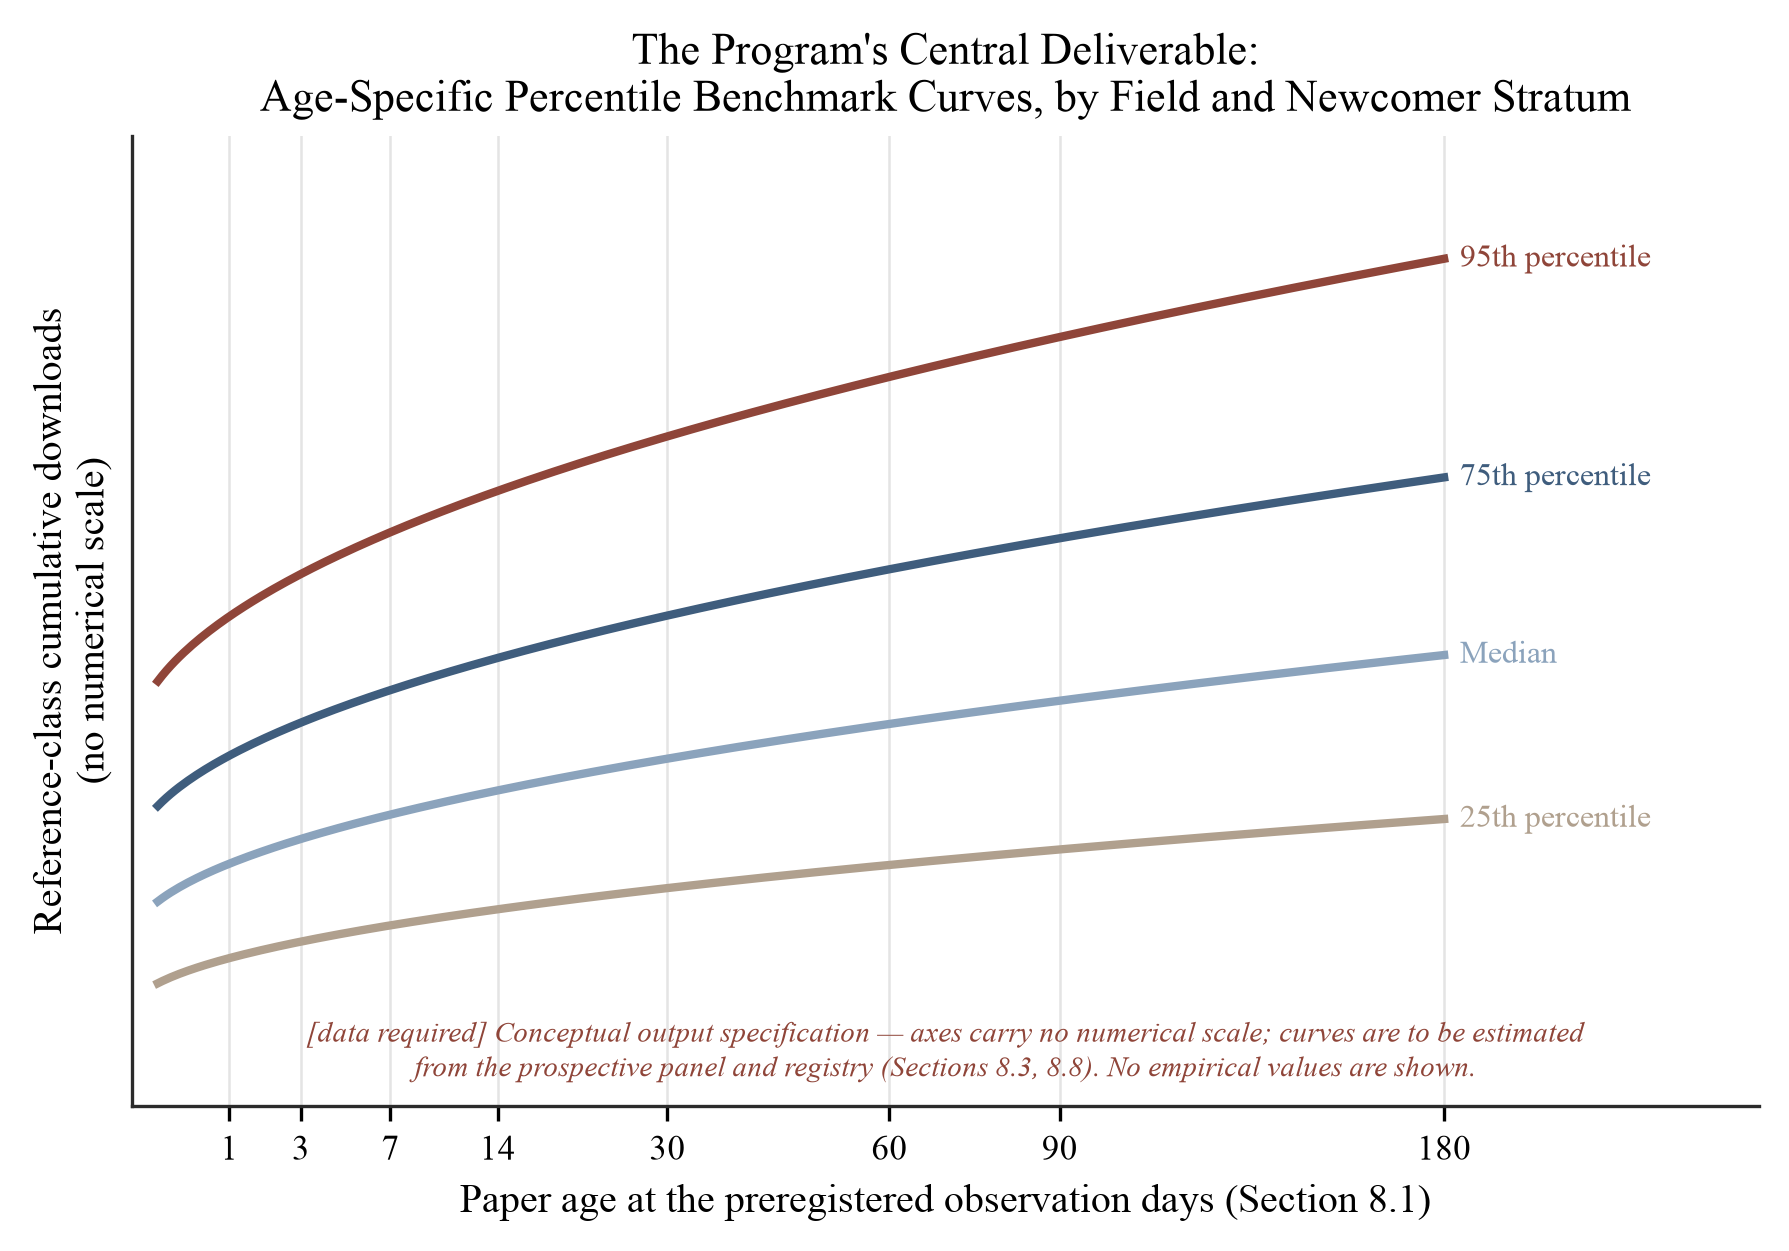
Figura 14. O leque de benchmark específico por idade: o entregável central do programa. Curvas de download de percentil (25º, 50º, 75º e 95º) como funções da idade do artigo, avaliadas nos dias de observação pré-especificados da Seção 8.1 e a serem estimadas por campo e estrato de recém-chegados da amostra do Estudo 1 e do registro comunitário. Os eixos não possuem escala numérica; a figura é uma especificação de saída conceitual, e é o formato de exibição por trás tanto da recomendação de plataforma da Seção 10.4 quanto da calculadora pública descrita acima.
Cada artigo empírico do programa se compromete com um pacote mínimo de relatórios: um diagrama de fluxo de coorte; distribuições brutas e normalizadas lado a lado; alcance e conversão relatados separadamente; históricos de exposição; resultados de sensibilidade a anomalias na escada de quatro camadas da Seção 8.3; resultados nulos e contrários relatados com a mesma proeminência que as confirmações; e uma tabela de referência legível por máquina, a condição sob a qual a saída do Estudo 1 pode realmente alimentar a calculadora pública descrita acima. Os resumos dos artigos do programa distinguem estimativas verificadas de expectativas pré-especificadas.
8.9 Validação preditiva
A prova somativa da agenda (RQ3) questiona se a normalização justifica sua complexidade. Uso inicial e citações posteriores são positivamente mas imperfeitamente associados em diferentes contextos: correlações na ordem de 0,11–0,35 em análises de Granger no nível de periódicos [80], aproximadamente 0,4 em coortes iniciais do arXiv, onde r ≈ 0,4 explica apenas cerca de 16% da variância [25], com associações comparáveis reportadas para pré-prints de química duas décadas atrás [26], para downloads em níveis de periódicos e artigos em geral [71], em dados de uso do RePEc [31], e em coortes do bioRxiv [62], e correlações de postos moderadas em uso de mega-periódicos [102]. Os conjuntos altamente baixados e altamente citados se sobrepõem apenas parcialmente [108][39]. Evidências recentes de painel vinculam acesso a citações com um desfasamento: em um painel de sete periódicos a associação era aproximadamente unitária-elástica, com um aumento de 10% em acessos associado a um aumento aproximado de 10% em citações cerca de nove meses depois [178]. Na notação da Seção 5.5, a comparação somativa estima
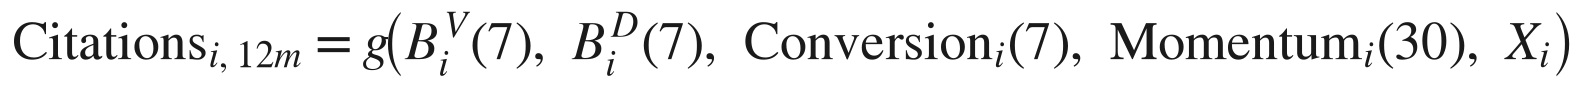
com g ajustado flexivelmente e avaliado apenas fora da amostra. A equação fixa quais entradas normalizadas competem contra contagens brutas. Modelos predizendo citações de 6, 12 e 18 meses a partir de métricas de dia-7 e dia-30 normalizadas por idade, campo e coorte devem ser comparados fora da amostra (por verossimilhança validada cruzadamente, calibração, correlação de postos e erro preditivo) com modelos usando apenas downloads cumulativos brutos, um problema de política de predição no sentido de Kleinberg et al. [88]. Um resultado particularmente informativo seria contagens brutas favorecendo autores estabelecidos enquanto medidas normalizadas de cold-start predizem melhor a adoção de citações posteriores. Esse padrão implicaria que parte do que contadores iniciais brutos medem é oportunidade inicial em vez de demanda intelectual subsequente. Se a normalização falhar em adicionar informação preditiva, a afirmação de medição do framework é rejeitada ou estreitada de acordo.
A Figura 15 reúne a agenda. Uma coorte prospectiva alimenta os quatro estudos e os dois quase-experimentos de plataforma em paralelo, e cada módulo deposita no mesmo conjunto de saídas públicas versionadas. Essa estrutura compartilhada torna a agenda um programa de pesquisa.
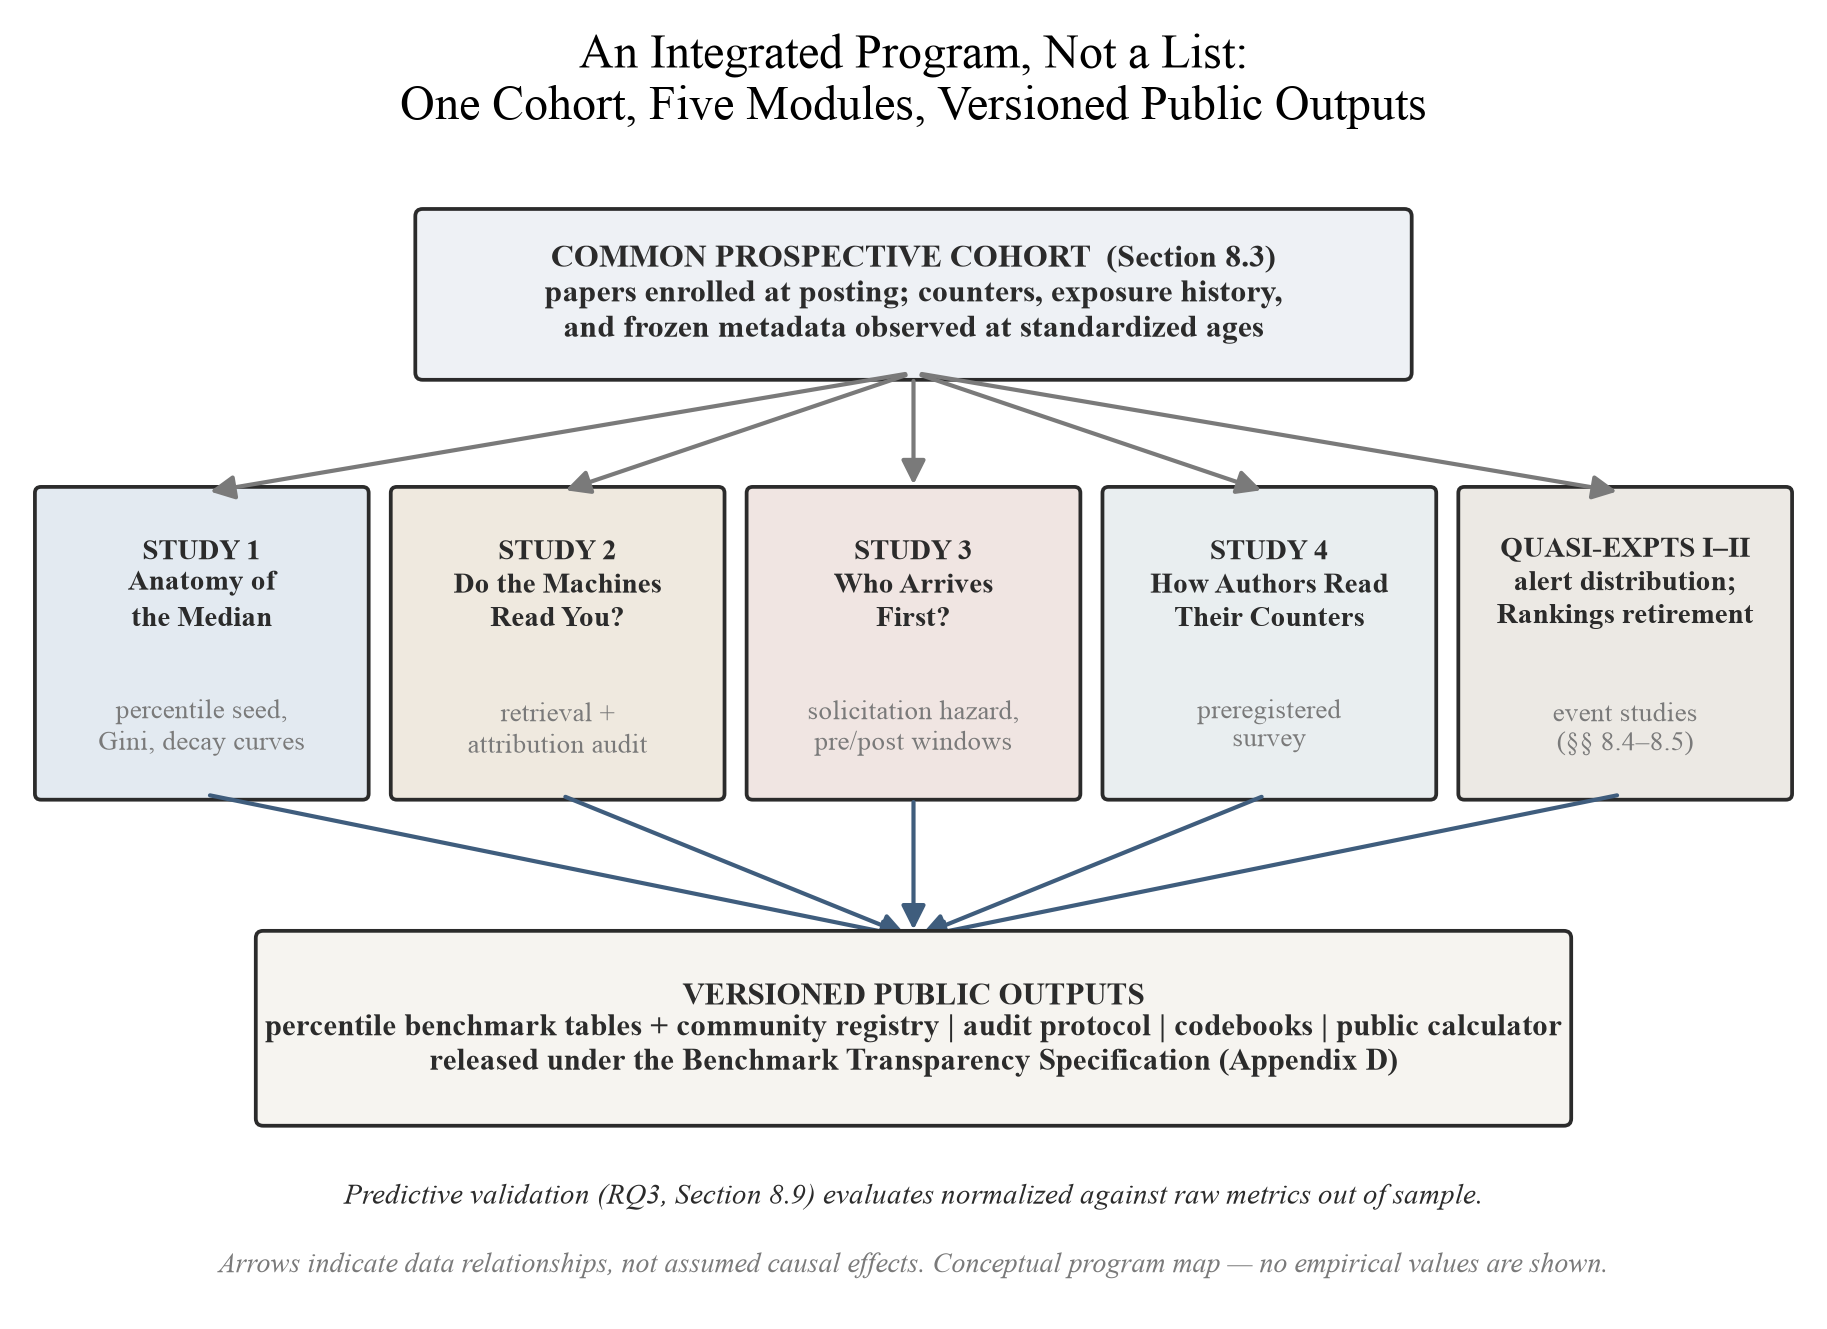
Figura 15. O programa de pesquisa integrado. Uma coorte prospectiva (Seção 8.3) alimenta os quatro estudos (Seção 8.6) e os dois quase-experimentos de plataforma (Seções 8.4–8.5); todos os módulos depositam em saídas públicas versionadas — as tabelas de percentil de benchmark e registro comunitário (Seção 8.8), o protocolo de auditoria, os livros de codificação, e a calculadora pública — lançados sob a Especificação de Transparência de Benchmark do Apêndice D, enquanto validação preditiva (Seção 8.9) avalia o benchmark resultante fora da amostra. As setas indicam relações de dados, não efeitos causais presumidos.
8.10 Uma proposta de design: modelos de fronteira orquestrados como camada de entrega do benchmark
A publicação ocasional não pode entregar o que os resultados da agenda exigem. As tabelas de percentis, o registro da comunidade, o formato de relatório CSAB (Seção 5.5; Apêndice B) e a calculadora pública (Seção 8.8) devem todas ser montadas a partir de fontes espalhadas e em deterioração, verificadas afirmação por afirmação, mantidas atualizadas conforme as regras de contagem e recursos da plataforma mudam, e entregues aos autores individuais em linguagem calibrada. Uma arquitetura candidata para essa camada de entrega e manutenção é um pipeline orquestrado de modelos de IA de fronteira especializados (uma classe de sistema que o autor desenvolve; veja Conflitos de interesse). Tudo nesta subseção é uma proposta de design. Nenhuma implementação existe, nenhum desempenho empírico é reivindicado, e nenhuma figura de precisão, custo ou tempo economizado é afirmada em nenhum lugar abaixo.
Uma alternativa para um sistema orquestrado é um modelo generalista único. Um autor que pergunta a um chatbot de consumidor "7 downloads é bom?" recebe uma afirmação fluente e inverificável, o modo de falha que as auditorias do mecanismo de resposta documentam, em que os sistemas erram com confiança infundada em vez de recusar responder [82]. Por baixo disso há um problema estrutural. A interpretação de métricas se decompõe em subtarefas com objetivos diferentes e parcialmente adversariais. Adquirir e datar a evidência, examinar um contador para tráfego não humano ou anômalo, normalizar o contador examinado em relação a uma classe de referência de idade, campo, coorte e visibilidade anterior, traduzir a posição normalizada em linguagem de banda e desafiar essa tradução antes do lançamento não são a mesma tarefa, e um componente otimizado para um é um juiz ruim de outro. O modelo que redige uma leitura tranquilizadora não deve ser a única autoridade sobre se o número subjacente está contaminado, e o modelo que redige linguagem de dossiê não deve certificar que a linguagem evita exageros. O princípio organizador é, portanto, uma divisão do trabalho epistêmico: geração e verificação são atribuídas a componentes separados com objetivos independentes, e o desacordo é preservado e relatado em vez de ser anulado pela média. A convergência de avaliadores independentemente solicitados ou arquitetonicamente distintos não é verdade, embora seja uma base mais forte para uma leitura do que a fluência de um único modelo, uma intuição de design consistente com evidências experimentais de que o debate multiagente entre instâncias de modelo de linguagem melhora visivelmente a validade factual e reduz alucinação em relação a um único modelo respondendo sozinho [43]. Quando os avaliadores divergem, a divergência é em si informação diagnóstica, assim como as fontes conflitantes foram tratadas como sinal em vez de ruído nas próprias regras de síntese deste artigo (Escopo e Disciplina de Evidência). Duas advertências de design temperam essa intuição. O acordo entre componentes não é em si evidência: pode surgir de dados de treinamento compartilhados, resultados de recuperação compartilhados, suposições de prompt comuns ou contaminação através do próprio orquestrador. Famílias de modelos extraídas de diferentes fornecedores não são independentes cientificamente, e a independência deve ser engenheirada, por meio de instruções separadas, fluxo de informação restrito entre componentes, saídas intermediárias preservadas e avaliação contra evidências que nenhum componente gerador é permitido editar. A verificação também não se torna confiável meramente porque um segundo modelo a realiza: afirmações que são contestadas ou consequentes exigem inspeção da fonte subjacente pelo usuário humano.
A Figura 16 mostra o pipeline proposto, e a Tabela 21 o decompõe por função. O processamento começa a partir de um arquivo de caso congelado, não de um prompt de forma livre: os contadores com suas datas de observação, idade do artigo, campo declarado e coortes de referência candidatas, histórico de exposição e a pergunta real do autor. Entradas ausentes permanecem ausentes, e o sistema não pode fabricar uma distribuição de percentis ausente, imputar um denominador ou aceitar um número gerado por modelo no lugar de um observado. O fluxo de informação então reproduz a sequência interpretativa que o artigo defende ao longo: contadores brutos → triagem de integridade → normalização de classe de referência → interpretação sob restrição. Um componente de monitoramento recupera contadores, documentos da plataforma e registros do registro com proveniência datada, para que cada valor a jusante seja rastreável para uma fonte arquivada. Toda saída factual viaja entre componentes como uma entrada em um livro de reivindicações. Cada entrada registra a afirmação, sua fonte de suporte ou campo de dados, um localizador estável, tempo de recuperação, qualquer transformação aplicada, sua classe de referência e seu estado de verificação, para que nenhuma saída não suportada possa se tornar silenciosamente uma premissa de um estágio posterior. A triagem de integridade aplica a detecção de anomalias de série temporal convencional (uma tarefa para métodos estatísticos, não geração de texto livre) contra o histórico documentado de filtragem de bots e contaminação de rastreador de IA [129][144]. Atribui quebras de trajetória a eventos de exposição datados quando o registro de exposição permite (Seção 5.6). A normalização é realizada por código estatístico determinístico invocado como uma ferramenta: as posições de percentis são calculadas em relação às tabelas Study 1 com versão e registro sob as regras de encolhimento da Seção 8.3. A aritmética de percentis nunca é delegada à geração de texto livre. Somente então um modelo de intérprete redige a leitura voltada para o autor, confinada à linguagem de banda da Tabela 8, ao diagnóstico de alcance versus conversão da Tabela 9 e ao modelo CSAB do Apêndice B, com fonte, data de origem e nível de confiança anexados a cada número. Um verificador e crítico separados verificam cada afirmação contra suas evidências registradas antes do lançamento, relatando cada uma como verificada, contestada, não suportada ou não avaliável, quatro estados distintos que nunca são comprimidos em um único escore de confiança sintética. Duas restrições são transferidas do framework sem mudanças. Qualquer recomendação é condicional ao gargalo diagnosticado, já que artigos limitados por alcance e limitados por conversão justificam ações diferentes (Tabela 9), e um sistema que não consegue distingui-los deve não dizer nada em vez de fornecer aconselhamento genérico. A outra restrição é que uma recomendação lançada é uma hipótese: ela prevê qual mecanismo deve se mover se o diagnóstico estiver correto, e observações subsequentes testam essa previsão. A função objetivo do sistema é correspondentemente estreita: remover atrito interpretativo identificável entre um artigo e sua classe de referência apropriada, e nunca a maximização de qualquer contador, um limite fixado pelas políticas de integridade da plataforma e de IA generativa [54][144] e pelo histórico de exploração da Seção 3 [44].
Tabela 21. Decomposição funcional da camada de orquestração proposta: função, tipo de componente, modo de falha principal e mecanismo de verificação independente. Cada linha é uma hipótese sobre uma divisão de trabalho viável.
| Função | Modelo ou tipo de componente | Modo de falha principal | Mecanismo de verificação independente |
|---|---|---|---|
| Orquestração e proveniência | Roteador de tarefas mantendo o arquivo de caso congelado e a razão de reivindicações | Uma suposição não fundamentada em estágio inicial propaga-se como premissa de cada estágio posterior | Nenhuma saída não verificada pode se tornar uma premissa confiável; fonte, transformação, tempo de recuperação e incerteza preservados em cada transferência |
| Aquisição e monitoramento de evidências | Modelo de recuperação com uso de ferramentas em cronograma de reexecução; correspondência bibliográfica com infraestrutura de citações abertas [35][124] | Fontes fabricadas, desemparelhadas ou recuperadas seletivamente | Registro de proveniência datado; cada valor rastreável até um instantâneo arquivado; subamostra aleatória recuperada novamente de forma independente por um segundo componente; buscas com falha e resultados contrários registrados, não descartados |
| Triagem de integridade | Detecção de anomalias em série temporal não gerativa [129][144] | Um pico rotulado como "bot" — ou "leitor" — sem evidência para nenhuma delas | Sinalizações de anomalia publicadas junto com agregados (Seção 8.8); sensibilidade relatada na escada de robustez de quatro camadas da Seção 8.3; anomalia tratada como uma sinalização, nunca como uma reivindicação de identidade |
| Normalização de classe de referência | Código estatístico determinístico invocado como ferramenta | Pares convenientes confundidos com uma população de comparação válida | Recomputação em relação às tabelas de benchmark públicas versionadas (Apêndice D); campo, idade, coorte, visibilidade anterior e data da fonte indicados ou o módulo se abstém; nenhuma aritmética em texto livre aceita no registro |
| Elaboração de interpretação | Modelo de linguagem generalista limitado à linguagem de faixa da Tabela 8 e ao modelo CSAB (Apêndice B) | Exagero fluente — certeza, escopo ou status causal além do que a evidência autoriza | Verificação no nível de reivindicação por um verificador separado em relação à evidência registrada; cada reivindicação relatada como verificada, contestada, não apoiada ou não avaliável; sentenças não apoiadas rejeitadas, não suavizadas |
| Revisão adversarial | Modelo crítico com objetivos adversariais ao redator | Crítica ritual ou consenso sintético que oculta desacordo material | Relatório de desacordo estruturado — status da evidência, padrão de avaliador, sensibilidade de decisão (o desacordo altera o diagnóstico ou apenas sua redação), incerteza residual — entregue não mesclado, nunca colapsado em um único número de confiança |
| Triagem de solicitação | Classificador especializado sobre o esquema de codificação das Tabelas 14–15 | Um veredicto categórico "predatório" que ultrapassa a evidência e arrisca dano reputacional | Apenas sinalização e revisão, nunca exclusão automática e nunca uma acusação publicada; taxas de erro relatadas em conjuntos rotulados; limites documentados e vieses da classificação de texto de IA reconhecidos [157][97] |
| Manutenção de benchmark | Orquestração programada de todos os componentes | Desvio silencioso: fontes obsoletas ou lançamentos sobrescritos sem deixar rastro | Lançamentos versionados e datados sob Apêndice D; revisões registradas, nunca silenciosamente sobrescritas — um mapa de benchmark vivo em vez de um instantâneo estático |
| Interpretação final e qualquer uso de carreira | Autor humano | Viés de automação e difusão de responsabilidade | Aprovação humana obrigatória antes de qualquer uso externo; linguagem de dossiê segue o protocolo da Tabela 13, com fonte, janela de tempo e limitações anexadas |
Dois limites completam a especificação. Um é um limite de permissão: acesso somente leitura é o padrão e a camada elabora, mas nunca executa. Ela não pode editar autonomamente um manuscrito, alterar metadados de plataforma, entrar em contato com pesquisadores ou periódicos, postar publicamente ou apagar uma mensagem de solicitação, e qualquer fluxo de trabalho implementado deve preservar a responsabilidade humana e as obrigações de divulgação das políticas de plataforma e envio aplicáveis [54][56][144]. O outro é um limite de abstenção: a saída nula é um resultado legítimo (frequentemente o correto) e cada estágio pode parar em vez de encaminhar uma entrada defeituosa para frente. Os gatilhos de abstenção obrigatória incluem uma classe de referência ausente ou indefensável; uma fonte não verificável central para a leitura; desacordo não resolvido sobre se uma formulação proposta preserva as reivindicações do artigo; qualquer solicitação de uma conclusão causal a partir de um padrão puramente descritivo ou para uma previsão de citações ou resultados de carreira sem um conjunto de dados de previsão validado (Seção 8.9); e qualquer solicitação para manipular, comprar, simular ou de outra forma aumentar a atenção. Esse último gatilho impede que a camada se torne o instrumento de manipulação de métricas cuja história a Seção 3 documenta [44][69][144]. Uma última separação governa os dois fluxos de evidência da agenda. As tabelas de percentil versionadas das Seções 8.6 e 8.8 são a única fonte de normalização admissível da camada, enquanto a auditoria de visibilidade de máquina do Estudo 2 alimenta uma verificação distinta de recuperação e atribuição. A recuperação de máquina não é um percentil de atenção humana e a camada não pode misturar os dois.
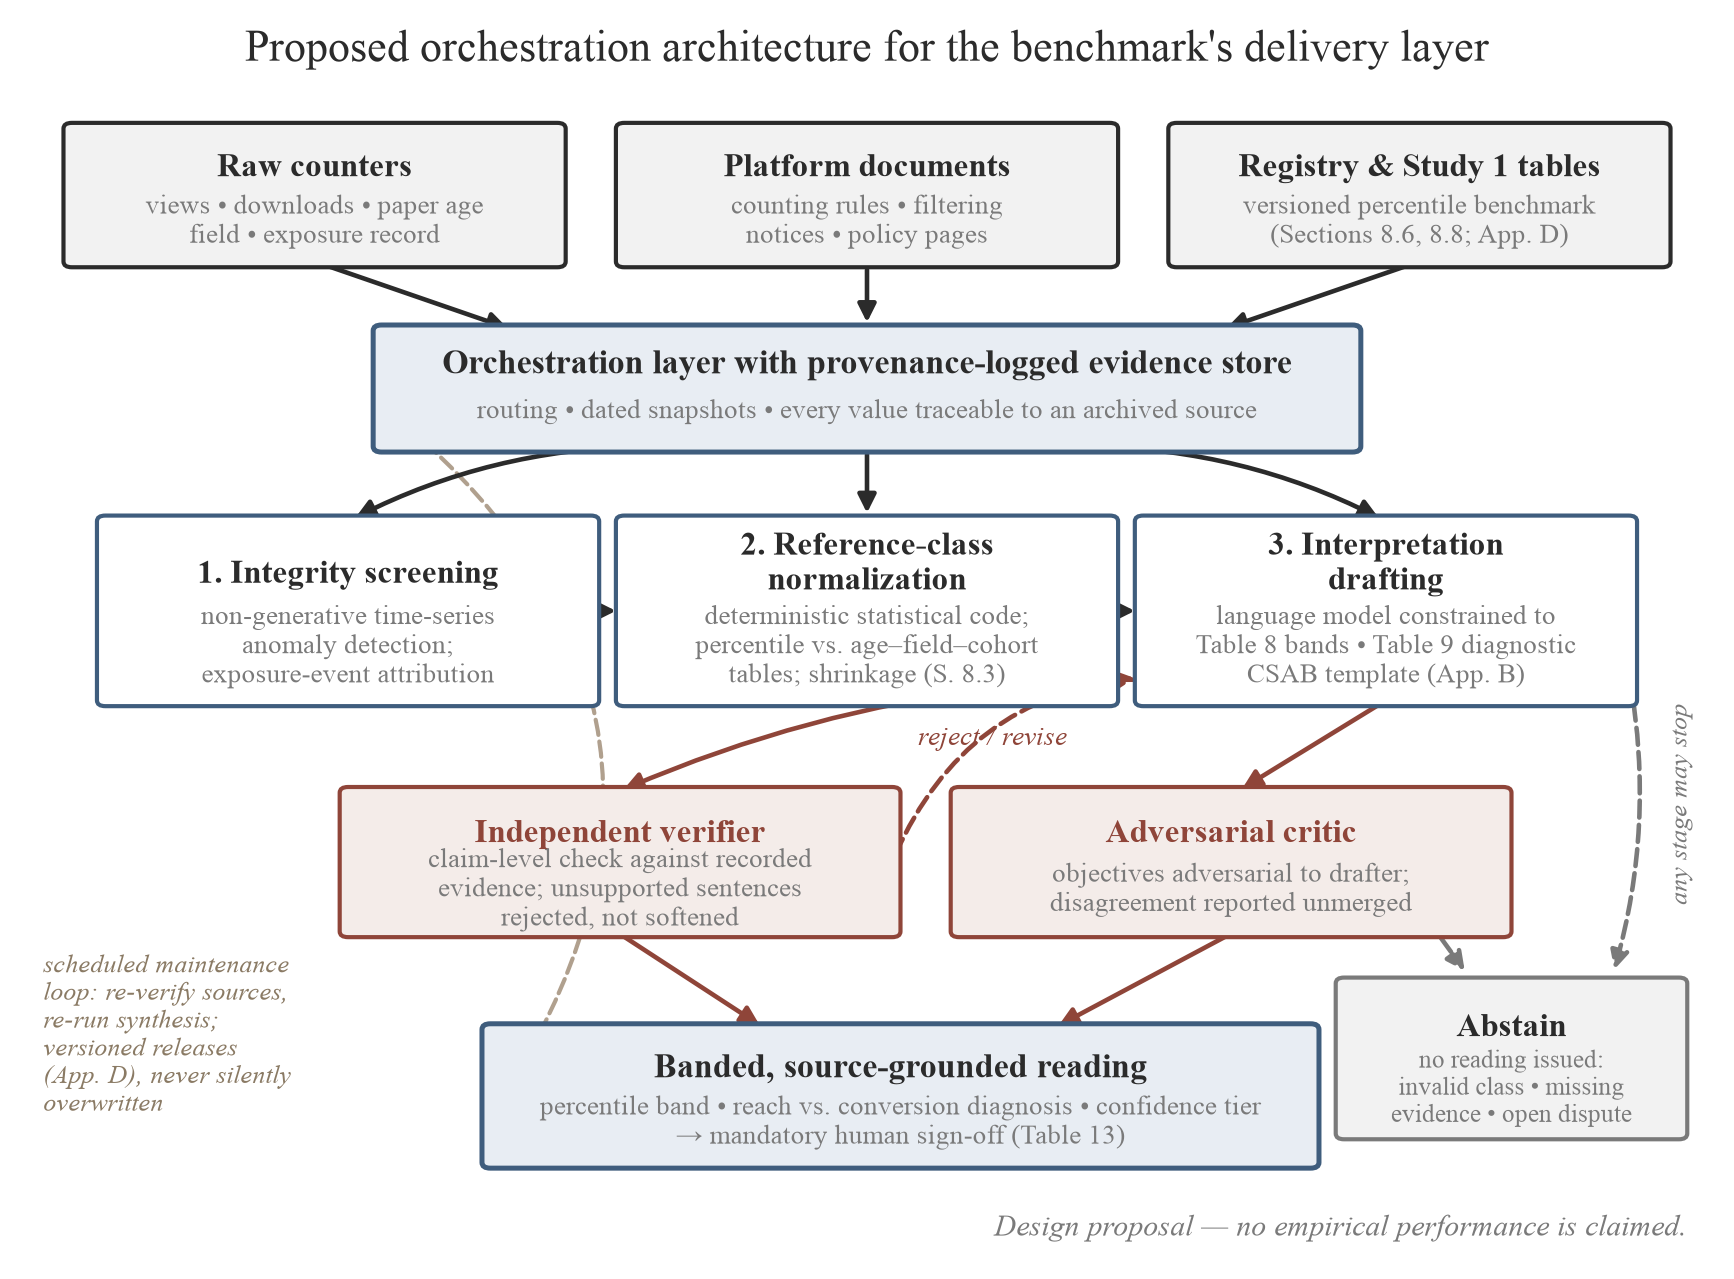
Figura 16. Arquitetura de orquestração proposta para a camada de entrega do benchmark (Seção 8.10; Tabela 21). Componentes especializados separam aquisição de evidências, triagem de integridade, normalização e interpretação, com verificação independente interposta entre geração e liberação, um caminho de abstenção disponível em cada estágio e um loop programado mantendo o benchmark versionado da Seção 8.8.
A mesma disciplina delimita o que a camada pode fazer uma vez que tenha um diagnóstico. A Tabela 22 fixa a política de ação: cada padrão observado (alcance e conversão lidos conjuntamente com momentum, no vocabulário das Tabelas 9–10) mapeia para um diagnóstico provisório, uma forma limitada de assistência permissível, o teste de mecanismo que poderia corroborar ou enfraquecer o diagnóstico, e a inferência ou ação que permanece proibida. A coluna teste-de-mecanismo operacionaliza a regra declarada acima de que uma recomendação divulgada é uma hipótese. Se uma correção de classificação é suposta remover um gargalo de alcance, o resultado que conta é alcance ajustado por idade, e uma narrativa retrospectiva sobre downloads totais não pode substituir isso. Uma predição falha é registrada como uma intervenção falha e retornada ao diagnóstico, nunca reavaliada contra uma medida de sucesso mais lisonjeira. A sequência completa assim se fecha em um loop: medir → validar → normalizar → diagnosticar → propor → criticar e verificar → decidir → observar → atualizar ou parar (Figura 17). Dentro desse loop, a decisão humana se situa entre a verificação e qualquer ação, observações pós-decisão retornam ao arquivo do caso, e o caminho de abstenção encerra o ciclo sempre que a evidência for insuficiente. O loop também controla a complexidade: quando a evidência apoia apenas preservação e monitoramento, ou quando uma regra determinística do playbook do autor (Seção 6) já responde à pergunta, a orquestração não adiciona nada e não deve ser executada.
Tabela 22. Política de diagnóstico para ação da camada de orquestração proposta. Os padrões são lidos dentro de uma classe de referência defensável sob as convenções percentilares da Tabela 9; cada linha é uma hipótese de política, e nenhuma célula afirma uma frequência empírica.
| Padrão observado (alcance, conversão, momentum) | Diagnóstico provisório | Assistência permissível | Teste de mecanismo | Inferência ou ação proibida |
|---|---|---|---|---|
| Alcance baixo, conversão alta, estável ou crescente | Um gargalo de descoberta é mais consistente com o padrão do que um gargalo de adoção de manuscrito ("interesse oculto", Tabela 9) | Auditar identificadores, classificações, metadados, indexação e descoberta de título; distribuição limitada e genuinamente relevante | Após uma mudança de metadados ou classificação, o alcance sobe enquanto a conversão se mantém? | Reescrever um resumo bem-convertendo meramente para torná-lo mais promocional |
| Alcance alto, conversão baixa, estável ou declinante | Falta de alinhamento de comunicação, falta de alinhamento de audiência e exposição de baixa intenção são explicações concorrentes ("atenção sem adoção") | Testar alinhamento título-resumo, clareza de escopo e adequação de audiência; apenas alternativas que preservem as afirmações | A conversão muda sob exposição comparável, com uma verificação de fidelidade em cada revisão? | Aumentar promoção indiscriminada; concluir que os leitores rejeitaram a ciência |
| Alcance baixo, conversão baixa | Subidentificado: exposição fraca, classe de referência errada, falha de metadados, atrito de comunicação ou demanda de nicho todos se adequam ("início a frio") | Validar primeiro a classe de referência e o registro de exposição; então auditar metadados e comunicação separadamente | Alterar um mecanismo mensurável por vez; preservar o resultado nulo | Inferir baixa qualidade do baixo uso; retornar um veredito de causa única |
| Alcance alto, conversão alta, crescente | Difusão inicial forte em relação à classe declarada | Preservar proveniência; monitorar em idades fixas; não mudar nada sem motivo | O padrão persiste após o evento de exposição e sob sensibilidade a anomalias? | Fabricar amplificação adicional; tratar atenção como prova de qualidade |
| Alcance alto, conversão alta, incrementos acentuadamente decrescentes | Atenção orientada por eventos, decaimento ordinário ou saturação (Seção 5.6) | Identificar o evento de exposição; comparar incrementos de intervalo, não totais cumulativos | O decaimento difere das trajetórias correspondidas por idade condicional ao evento? | Chamar incrementos decrescentes de falha científica — contagens cumulativas quase sempre se achatam em termos de taxa |
| Alcance baixo, conversão alta, incrementos decrescentes | O interesse condicional pode ser real enquanto a exposição continuada é fraca | Auditar se a distribuição ou indexação terminou; identificar canais limitados e relevantes | A exposição restaurada eleva o alcance sem degradar a conversão? | Ampliar afirmações ou remover especificidade técnica para perseguir um público mais amplo |
| Alcance alto, conversão baixa, exposição crescente | As chegadas estão crescendo sem adoção proporcional de texto completo | Testar tráfego de baixa intenção (Seção 4.2), falta de alinhamento de audiência e clareza de apresentação | A conversão responde a uma mudança de apresentação fiel às afirmações em exposição comparável? | Otimizar apenas o topo do funil; contar cada visualização como um leitor humano |
| Qualquer padrão com um contador reafirmado, pico inexplicado, coorte inválida ou denominador ausente | A métrica não é presentemente interpretável no nível desejado | Preservar snapshots; executar análises de sensibilidade; estreitar a afirmação; abster-se | A leitura sobrevive à exclusão do intervalo disputado ou a uma classe de referência melhor? | Rotular tráfego como humano ou automatizado sem evidência; emitir um percentil de um denominador fabricado |
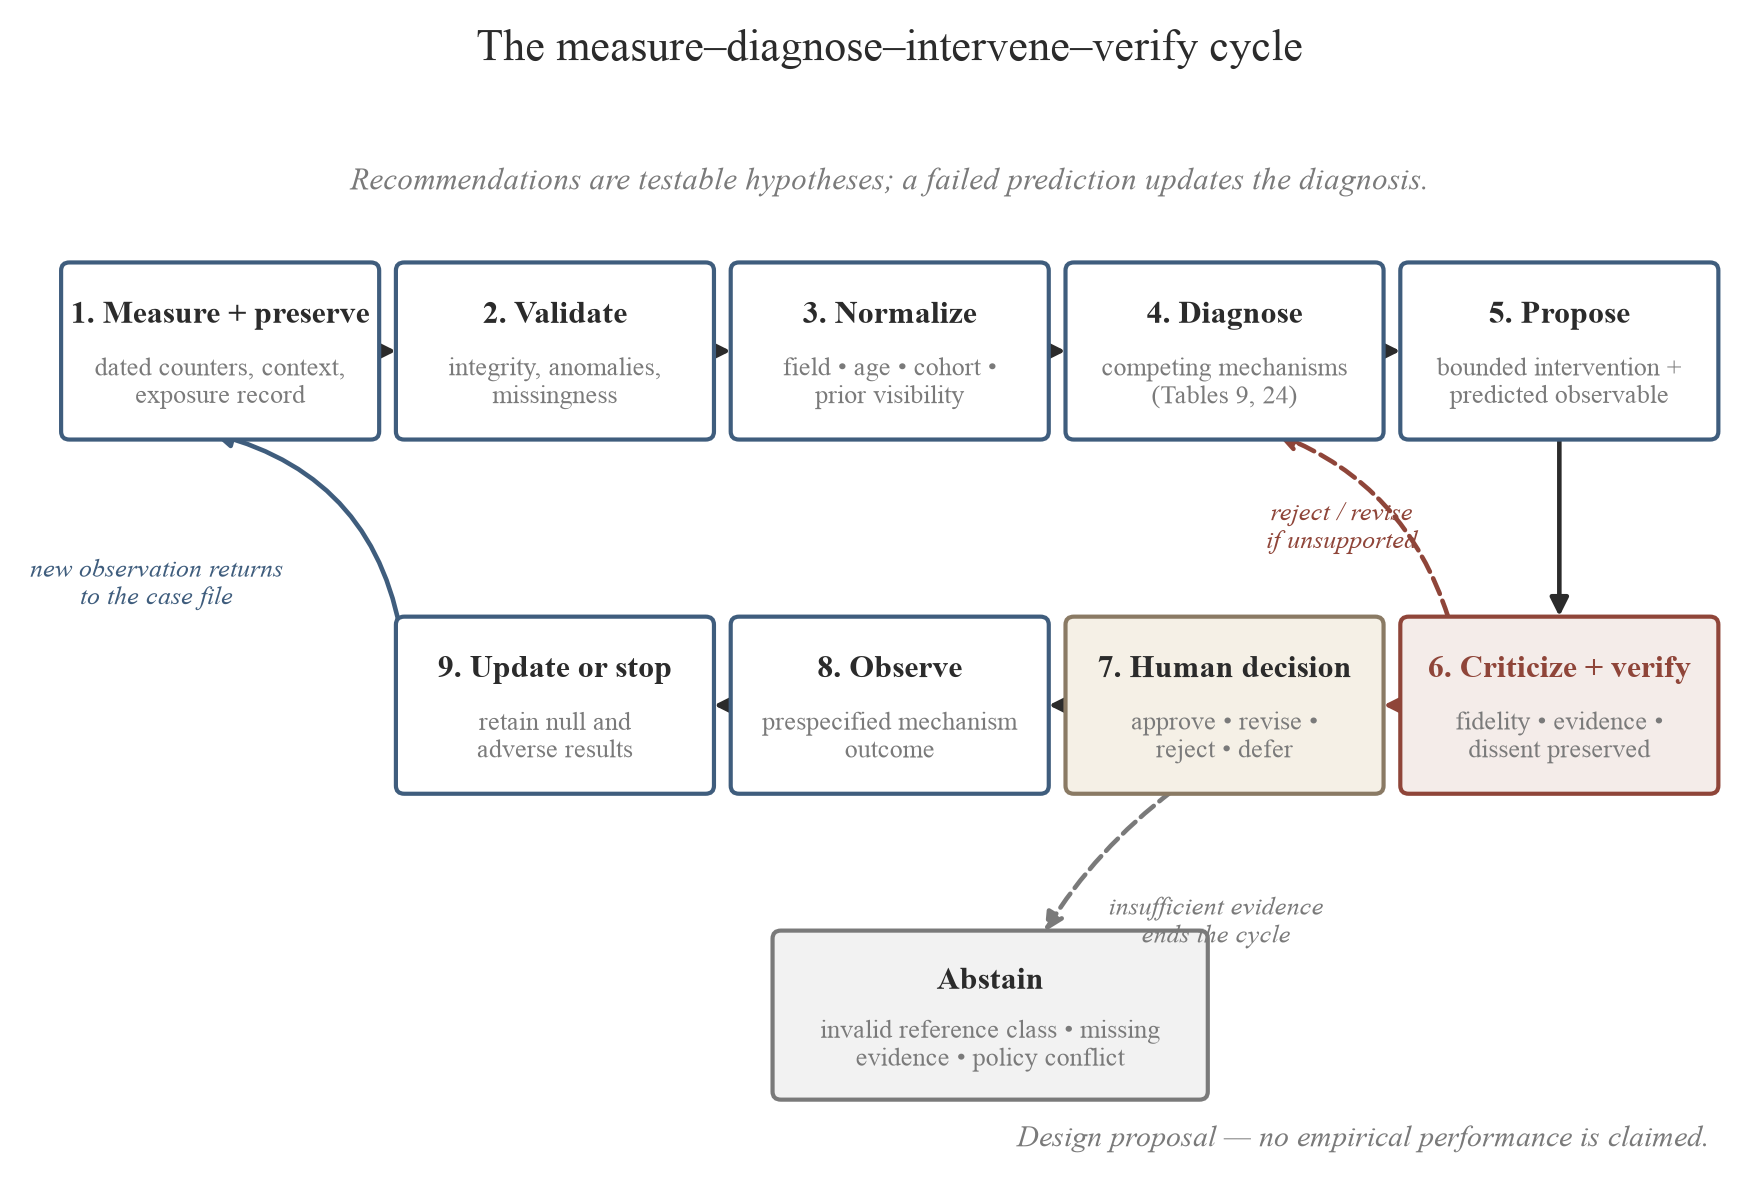
Figura 17. O ciclo medida–diagnóstico–intervenção–verificação (Seção 8.10; Tabela 22). Recomendações saem do loop apenas como hipóteses testáveis: cada uma nomeia o mecanismo que se destina a mover e a observação subsequente que poderia corroborar ou enfraquecer o diagnóstico. Predições falhas retornam ao diagnóstico e permanecem no registro de auditoria; a decisão humana se situa entre a verificação e qualquer ação; e o caminho de abstenção encerra o ciclo sempre que nenhuma classe de referência defensável ou evidência suficiente existe. O ciclo otimiza a interpretação que preserva evidência, não atenção bruta.
Quatro limitações limitam a proposta. Geração não é recuperação. Nenhum modelo, por mais orquestrado que seja, pode regenerar as distribuições percentilares que deixaram de ser observáveis quando as listas de topo foram removidas [149], e a camada pode manter apenas uma aproximação, com as ressalvas de piso conservador da Seção 5 intactas. Tampouco a orquestração pode identificar um baixador, distinguir tráfego humano de tráfego automatizado apenas por contadores (Seção 4.2), converter volume de solicitação em evidência de leitura (Seção 7.6), tornar independentes as saídas de modelo correlacionadas renomeando-as "agentes", substituir o juízo de pares ou transferir responsabilidade do pesquisador para um fluxo de trabalho. O próprio orquestrador precisa de um auditor. Uma camada de interpretação implantada se torna um novo guardião na pilha que este artigo mapeia (Figura 12), e não deve herdar a opacidade que foi construída para reparar: os rastreamentos de raciocínio e os logs de proveniência devem estar abertos para inspeção, e o comportamento de recuperação e interpretação da própria camada deve ser auditado com o rigor do Estudo 2 (instantâneos com carimbo de tempo mais um protocolo de replicação roteirizado), porque a não-estacionariedade do modelo torna cada saída uma estimativa datada, nunca um valor durável. Custo e equidade. Operar tal pipeline não é gratuito, e uma camada interpretativa paga excluiria os autores de baixo-recurso e não afiliados nos quais este framework se centra. Os vieses conhecidos de classificadores de texto de IA contra escritores não-nativos de inglês [97] fariam o mesmo, se não mitigados. A falsa precisão é o risco residual. Uma camada que emite veredictos com faixas sem camadas de confiança automatizaria a própria miscalibração diagnosticada na Seção 3: uma contagem sem escala comparativa substituída por um veredicto sem incerteza anexada. A arquitetura é em si um objeto falsificável e pertence à agenda nesses termos, avaliada contra assistência mais simples e não inferida da sofisticação de seu diagrama. O design apropriado é gradual. Pacotes de casos realistas com ambiguidades plantadas (citações inválidas, reafirmações contrárias, coortes indefensáveis, solicitações genuinamente limítrofes) são randomizados em condições que adicionam um ingrediente por vez: o protocolo manual das tabelas deste artigo (a linha de base correta, já que um método não-IA já existe), um único modelo generalista, o mesmo modelo com recuperação e cálculo determinístico, geração mais crítica independente, e o pipeline governado completo. Ablações que removem o verificador, a calculadora determinística, a visibilidade do desacordo ou o portão humano então isolam qual ingrediente de governança merece seu custo. Os resultados são pontuados separadamente, nunca como um composto: fidelidade de alegação e citação; validade de classe de referência; calibração das crenças do autor (instrumento do Estudo 4) e abstenção apropriada em casos ambíguos; tempo do pesquisador e carga de supervisão; falhas de governança (ações externas autônomas, conselhos de game de métrica, acusações categoriais de local); e, central para o argumento de inicialização fria do artigo, heterogeneidade de benefício por visibilidade anterior do autor e status de recém-chegado, já que uma camada que ajuda principalmente autores já-visíveis reproduziria a desigualdade que foi projetada para reduzir. Resultados de equidade nulos e adversos são achados reportáveis. Versões de modelo, prompts, permissões de ferramentas e instantâneos de fonte são arquivados, porque em um sistema não-estacionário cada resultado é uma estimativa datada. Dois estimandos permanecem separados durante todo o tempo: o efeito na qualidade da interpretação e o efeito na difusão subsequente. Uma camada que melhora o diagnóstico sem mover downloads é um sucesso, enquanto aquela que aumenta downloads enquanto distorce alegações é uma falha de governança. O design falha se o pipeline governado não supera um modelo único forte em acurácia de evidência e calibração: "vários modelos" não é a contribuição, e a hipótese em teste é a divisão do trabalho epistêmico. A proposta especifica um papel testável para interpretação assistida por IA. A IA pode ajudar um autor a fazer uma pergunta melhor sobre um número; apenas evidência verificada pode respondê-la.
9. Limitações
As alegações deste artigo são limitadas pelas limitações abaixo, cada uma anexada ao artefato que restringe.
Envelhecimento e composição da base de evidências. As âncoras distribucionais mais antigas no mapa de benchmark (Tabela 7) repousam em amostras coletadas entre 2012 e 2015 e dominadas por bolsa jurídica [85][139]; a única entrada recente é o instantâneo de rede única discutido abaixo [83]. As faixas da escala de interpretação (Tabela 8) são melhor lidas como faixas absolutas lenientes em vez de conservadoras para 2026 (Seção 5.1). O volume de download anual em toda a plataforma cresceu várias vezes entre meados de 2010 e 2020 [1][143], aumentando o fluxo de download por artigo e tornando um limite antigo fixo uma barreira mais suave hoje do que quando foi estimado. Nenhuma correção multiplicativa pode reparar isso, já que o crescimento muda numerador, denominador e composição simultaneamente (Seção 3.2). As faixas da Tabela 8 são aproximações derivadas de aritmética agregada em vez de normas redimensionadas. Nenhum estudo de distribuição em toda a plataforma pós-2020 de downloads do SSRN foi identificado.
Evidência contemporânea de fonte única. A única evidência distribucional recente usada aqui é um instantâneo publicado único de uma rede disciplinar: 2.361 artigos de Marketing observados em 15 de agosto de 2025 [83]. Demonstra assimetria e uma prima de prestígio condicional, mas não estabelece benchmarks em toda a plataforma, e dois valores internos de sua tabela publicada são reproduzidos "como publicado" com uma nota de cautela. Generalizações dessa fonte para outras redes SSRN são extrapolações. O Apêndice E reduz essa dependência adicionando uma seção transversal de arquivo independente de todos os campos (n = 1.360) que reproduz a assimetria, a lacuna média-mediana, a faixa de conversão, o multiplicador de campo e a lognormalidade no corpo observado. Carrega seu próprio viés de seleção ascendente e corrobora a forma da distribuição entre disciplinas. A agenda da Seção 8 ainda visa o benchmark representativo da plataforma.
Viés de lista de topo. O ajuste de grande amostra de 2015 cobre apenas as listas de topo (aproximadamente o decil superior de autores e seus artigos [85]), então o corpo da distribuição abaixo das listas de elite é inferido de uma lognormal ajustada em vez de observado. Declarações percentilares derivadas desse ajuste são baseadas em modelo.
A semântica dos contadores é instável. O que os registros de visualizações e downloads capturavam mudou ao longo do tempo e continuará mudando com redesenhos de interface e filtragem aprimorada de bots. O sistema de integridade da plataforma exclui algumas atividades suspeitas das contagens oficiais [144][66][69], e a infraestrutura adjacente RePEc/LogEc documenta tanto a escala histórica do tráfego de robôs quanto ondas recentes de rastreadores de IA que exigiram descartar a maioria absoluta do tráfego bruto [99][129]. As normas de conversão citadas na Seção 5 são, portanto, quantidades específicas do período, e as comparações de contadores entre anos confundem mudanças comportamentais e de filtragem. As estatísticas gerais de web-bots [158] não podem ser extrapoladas para os contadores filtrados do SSRN em nenhuma direção.
Volatilidade da plataforma e mudança de origem. A descontinuação dos Rankings está incorporada em uma reestruturação de produtos mais ampla em 2026 [146][149][150], portanto nenhuma análise deve tratar 15 de julho de 2026 como uma intervenção isolada. Essa ameaça está incorporada no design da Seção 8.5, mas não pode ser totalmente eliminada. As páginas de suporte da plataforma são revisadas sem aviso prévio; todas essas páginas são citadas aqui com datas de acesso, e a linguagem citada da plataforma deve ser verificada novamente contra cópias arquivadas antes do envio formal.
Sem dados de percentil. Nunca existiram dados de percentil de plataforma completa públicos, e após 15 de julho de 2026, nenhum marco de percentil representativo da plataforma pode ser coletado externamente, porque as classificações que anteriormente vazavam limites de lista superior foram removidas [149]. Uma distribuição de referência baseada em amostra ainda pode ser montada a partir de capturas arquivadas, e o Apêndice E relata uma; ela fixa a forma da distribuição e não fornece percentis da plataforma. Algumas quantidades de interesse (por exemplo, o destino dos emails de notificação de autores "top 10%" [161]) são oficialmente não documentadas, e observamos seu desaparecimento do marco público sem afirmar seu encerramento.
Uso não é leitura, e nem qualidade. Um download pode preceder leitura cuidadosa, inspeção superficial, armazenamento de arquivo ou nenhum uso. Downloads não são um indicador direto da qualidade de pesquisa e não são uma fonte causal garantida de citações: a associação downloads–citações é positiva mas heterogênea (aproximadamente 0,1 a 0,6 dependendo do campo, nível de agregação e horizonte [18][25][39][80][102][108]) e as populações altamente baixadas e altamente citadas se sobrepõem apenas parcialmente [108]. As citações em si podem ser positivas, negativas, superficiais ou estratégicas, e o processo de citação é sistematicamente enviesado contra trabalho inovador [166]. Nada neste artigo autoriza a substituição de métrica pelo julgamento de especialistas; o uso defensável do marco é diagnóstico e descritivo.
Exposição não observável e prestígio não aleatório. Nem toda exposição é observável: leitores encontram títulos em email, mídia social, resultados de busca e correspondência antes de qualquer visualização de página de resumo ser registrada, e autores bem conectados geram exposição fora da plataforma correlacionada tanto com prestígio quanto com qualidade. Os coeficientes de prestígio observacionais, portanto, misturam atenção baseada em status com diferenças genuínas em recursos, tópicos e redes [111][140]. A manipulação experimental de sinais de identidade do autor [154][64] complementa mas não substitui a observação da plataforma. A classificação de campo é parcialmente selecionada pelo autor, e artigos ocupam várias categorias, complicando atribuições de campo único.
Limitações da própria agenda. Os designs quase-experimentais das Seções 8.4–8.5 enfrentam efeitos de anúncio, mudanças de plataforma concorrentes e diferenças de campo não aleatórias. São rotulados como quase-experimentais porque um evento em toda a plataforma não oferece nenhum grupo de controle não tratado. O snapshot do Estudo 2 envelhecerá com os motores que audita, e seu protocolo de replicação mitiga mas não remove a não-estacionariedade. O Estudo 3 é um estudo de caso N = 2 cujo valor é mecanismo e protocolo, não uma estimativa populacional, e sua lógica de atribuição depende de aliases por canal em vez de qualquer afirmação sobre visibilidade de email público. O registro crowdsourced herda problemas de auto-seleção e verificação indicados na Seção 8.8. O acesso aos dados para todos os designs depende da cooperação da plataforma ou coleta com limite de taxa dentro dos termos de serviço [134][51]; nenhum é garantido.
Amplitude da bibliografia. A bibliografia é ampla porque o artigo é uma síntese; muitos dos estudos citados compartilham marcos, campos e limites de design, e postagens da comunidade documentam experiência sem estabelecer parâmetros populacionais. A evidência de uma afirmação é seu nível de verificação e marco de amostragem, não o número de referências por trás dela.
Bandas são alvos de calibração, não constantes. A banda de conversão de 11–19% e os limites de CSAB são quantidades a serem calibradas por campo e por plataforma, não constantes universais do comportamento acadêmico (Seções 4.4, 5.2). Sua forma atual é uma única banda entre campos, a ser substituída pelas distribuições por campo que o marco requer quando o Estudo 1 estratificado por campo (Seção 8.6) reportar.
A generalização além do SSRN requer recalibração, não transplantação. O problema de interpretabilidade diagnosticado aqui (contadores de uso exibidos sem uma escala comparativa pública) e a lógica de alcance versus conversão que o repara não são específicos do SSRN; aplicam-se a qualquer servidor de pré-print que mostra contadores de uso, incluindo bioRxiv, medRxiv, arXiv e OSF Preprints [11][62][2][24]. O que não se transfere é a banda específica de 11–19% ou os limites de CSAB. Curadoria, arquitetura de distribuição e interface diferem entre servidores: o tráfego de pull orientado por intenção do arXiv e suas listas de anúncios por email em comparação com os alertas de push curados do SSRN (Tabela 6). Os âncoras numéricas devem, portanto, ser re-estimadas em cada plataforma antes de serem citadas lá. O marco é portável; sua calibração é local. O protocolo de depósito paralelo da Seção 8.8 é o teste empírico direto de até onde as bandas de SSRN viajam. A escala dessa recalibração é fácil de subestimar: o download mediano de corpus inteiro do bioRxiv (cerca de 279, e aproximadamente 496 em genômica [2]) é várias vezes a mediana de 60 na seção transversal de arquivo do Apêndice E: aproximadamente cinco vezes no geral e cerca de oito vezes em genômica. A comparação é apenas indicativa. O número do bioRxiv vem de um censo de corpus inteiro, enquanto o 60 vem de uma amostra de arquivo que sobre-representa páginas capturadas, mistura idades e campos cuja composição muda com a idade e resolve a idade para anos inteiros. A direção do hiato é segura para ler; seu tamanho não é.
Ética. A dimensão de discurso comunitário deste artigo consiste em postagens públicas autosselecionadas utilizadas apenas como evidência de demanda, nunca como sentimento representativo, e citadas apenas quando existe uma fonte vivente e verificável. As postagens de usuários são citadas com atenção à ética de citar conteúdo de fórum semi-público, incluindo paráfrase em vez de citação textual quando os autores pudessem ser identificados contra suas expectativas, consistente com normas de transparência para evidências qualitativas [6]. O Estudo 3 registra apenas mensagens enviadas sem solicitação ao autor instrumentado e não coleta dados pessoais de terceiros além daqueles que os remetentes voluntariamente fornecem. O Estudo 4 coleta apenas respostas voluntárias e anonimizadas de questionário sob consentimento informado. O painel utiliza contadores exibidos publicamente e metadados bibliográficos, e qualquer coleta de informações não-públicas do painel (como datas de status de distribuição) exige consentimento informado do autor e, quando aplicável, revisão institucional. Os dois estudos que envolvem participantes humanos e dados gerados pelos participantes são o Estudo 4 (a pesquisa com autores) e o Estudo 3 (postagem instrumentada com registro de caixa de entrada). Como ambos são pesquisas com sujeitos humanos, ambos serão submetidos para aprovação pelo conselho de revisão institucional relevante ou comitê de ética em pesquisa e conduzidos sob consentimento informado dos participantes antes de qualquer coleta de dados começar, e dados pessoais contidos nos registros de caixa de entrada são agregados e desidentificados antes de qualquer análise ou relatório. Este protocolo é uma pré-condição de execução e é reproduzido nas Declarações.
10. Conclusão e Recomendações de Política
10.1 O que a análise estabeleceu
A extinção das SSRN Rankings em 15 July 2026 removeu a única escala comparativa pública [149]. Os contadores permaneceram em cada artigo e perfil, o que deixou métricas ilegíveis em vez de desprovidas de significado. Para compensar essa perda, este artigo reúne cada âncora empírica verificável em um mapa de referência com ressalvas explícitas de antiguidade e confiança (Table 7), constrói um marco interpretativo, a escala de cinco faixas, a decomposição alcance-conversão e o protocolo de dossiê (Tables 8, 9, 13), que traduz contadores em diagnósticos, e estabelece a agenda pronta para pré-registro da Seção 8, que especifica como as distribuições faltantes podem ser reconstruídas.
O mecanismo no cerne do argumento se resume a isto:
Ninguém sabe o que sete downloads significa sem saber sete downloads comparados com o quê, e após 15 July 2026 a plataforma não responde mais "com o quê".
As contribuições diferem em natureza. Nomear o problema da classe de referência é a contribuição diagnóstica: uma contagem bruta não responde nenhuma pergunta até que idade, campo, coorte e exposição definam seu grupo de comparação. A contribuição instrumental é o mapa de referência e CSAB, que normalizam um número emocionalmente saliente, mas cientificamente ambíguo, em um diagnóstico interpretável. O manual de procedimentos e o protocolo de dossiê são a contribuição prática, permitindo que autores e comitês ajam baseados em contadores hoje sem interpretá-los incorretamente. Em termos de política, a contribuição é a faixa de percentil anonimizada: contexto comparativo restaurado de uma forma que não identifica ninguém e não revive nenhuma tabela de classificação.
Com base na evidência reunida, a pergunta no título deste artigo é mal formulada até que uma classe de referência seja especificada. Contra toda âncora disponível, contagens pequenas são a norma estatística da plataforma em vez de um veredicto sobre o trabalho. Um artigo com 40 visualizações de resumo e 7 downloads é consistente, como resultado de triagem, com a faixa de conversão empírica da Seção 5 [139][172][83], enquanto a regra prática mais antiga de três visualizações por download [18] fica acima dessa faixa em vez de dentro dela. O artigo mediano na única amostra de estilo censitário acumulou 63 downloads em dois anos [139], e a entrada na lista dos 10.000 melhores de 2015, aproximadamente o top 1.8% do acervo de artigos em texto completo da plataforma (571,040, July 2016 [1]), exigiu 160 downloads ao longo da vida [85]. Sob um regime de atenção quase lognormal, a maioria dos autores fica nos degraus inferiores da escada por construção. O preprint mediano vive na cauda longa de uma distribuição log-normal que seu autor não consegue ver, e é elevado à superfície por mecanismos de classificação que favorecem os afiliados. É solicitado por predadores antes de ser lido por pares, e agora perdeu a classificação que antes o localizava. A escala coloca um artigo em algum lugar dessa escada, e a angústia que a pergunta carrega é produzida pela escala faltante em vez de pelo número.
Nada disso é peculiar a uma plataforma, e o evento não é sem precedentes. ResearchGate descontinuou seu próprio RG Score, fortemente criticado, em August 2022 [130], após crítica metodológica sustentada [90], e em 2022–2023 dezenas de escolas de direito americanas, lideradas por Yale e Harvard, se retiraram das classificações de escolas de direito do U.S. News [13]. Retirar uma medida contestada não é um ato cosmético, porque a medida nunca foi uma descrição passiva: a literatura sobre reatividade que cresceu das classificações de escolas de direito mostra que uma classificação pública reformula o comportamento daqueles que ela classifica [58][132], então tanto sua imposição quanto sua remoção mudam a conduta em vez de meramente mudar o que é relatado. Um contador e seu marco comparativo, conjuntamente, constituem uma métrica, e retirar o marco enquanto se mantém o contador deixa cada usuário segurando uma contagem sem nada para confrontá-la. Interpretabilidade, a disponibilidade de uma distribuição pública para um contador público, deve ser tratada como uma dimensão de qualidade de primeira classe de qualquer indicador, ao lado de validade e confiabilidade. As métricas sobrevivem a sua infraestrutura interpretativa, e uma métrica sem contexto é ruído, uma instância da disciplina geral de leitura cética de números descontextualizados [15]. A mesma métrica com contexto é uma calibração que capacita autores, melhora a comunicação acadêmica e sustenta a confiança nos repositórios que a exibem.
O marco exige alguns hábitos ordinários de seu usuário. Compare semelhante com semelhante, e mantenha o alcance separado da conversão. Leia trajetórias em vez de totais, trate cada número como datado, e não deixe nenhuma contagem circular sem sua fonte, período e limitações.
10.2 Recomendações para autores
Os autores podem agir agora, sem aguardar novos dados. Tire capturas de tela datadas de contadores em nível de artigo, que preservam o contexto: após o encerramento, elas são o único registro de posição que permanece sob o controle do autor, e alimentam o registro da comunidade da Seção 8.8. Informe contagens apenas com seu contexto (idade, campo, coorte e fonte), seguindo o protocolo de dossiê da Tabela 13, no qual cada número carrega sua fonte, janela de tempo e limitações. Leia o painel diagnosticamente em vez de emocionalmente: separe alcance de conversão (Tabela 9), trate uma primeira semana com zero downloads como comportamento normal de pré-distribuição [53], e compare com três a cinco artigos de colegas postados no mesmo mês em vez de comparar com a cauda visível, cujos números de marco circulante garantem má calibração sob um regime de cauda pesada [85][180]. Trate e-mail de solicitação como um fenômeno de raspagem, não como reconhecimento, e não como evidência sobre os contadores [61][107][144].
10.3 Recomendações para avaliadores
As instituições que importaram downloads de SSRN como uma moeda de avaliação [12][18][161][52] enfrentam uma questão de governança agora que a escala pública dessa moeda desapareceu. Contagens brutas de downloads não devem entrar em arquivos de contratação, promoção ou permanência: elas são manipuladas nos limiares exatos que importam [44], variam até oito vezes entre subcampos de uma única rede [168], e agora são opacas quanto aos benchmarks. A unidade minimamente defensável é um percentil dentro de uma coorte definida (mesmo campo, mesma faixa etária, mesmo período de postagem) acompanhada de sua fonte e data, e evidência de uso deveria complementar em vez de substituir citações, avaliação por pares e julgamento substantivo [108][109][110]. O consenso estabelecido de reforma de avaliação de pesquisa funciona nesse princípio. A injunção central de DORA é não usar um número único ou um proxy de venue como substituto para avaliar a pesquisa em si [8], e o Manifesto de Leiden insiste que a avaliação quantitativa apoie e não suplante o julgamento qualitativo de especialistas [78]. A revisão Metric Tide reforça essa insistência, pedindo indicadores que sejam robustos, humildes, transparentes, diversos e reflexivos e usados em apoio à avaliação de especialistas em vez de como substituto para ela [173], assim como o Acordo CoARA mais recente sobre Reforma de Avaliação de Pesquisa, cujas várias centenas de organizações signatárias se comprometem com avaliação qualitativa apoiada por, não suplantada por, uso quantitativo responsável [183]. Todo o consenso se aplica com força total a um contador de downloads cuja escala pública foi removida. Duas das cinco dimensões de Metric Tide se relacionam diretamente ao método proposto aqui: diversidade é a normalização de campo em que este artigo insiste, e reflexividade é a postura da Seção 8.7, na qual o artigo mede sua própria atenção. O sucessor da revisão voltado para REF carrega os mesmos cinco princípios para a prática atual do Reino Unido [184]. Este consenso é em si mesmo uma expressão da crítica mais ampla ao excesso de métricas na vida institucional [113]. Comitês de avaliação devem esperar e aceitar o formato de protocolo da Tabela 13 (a forma narrativa contextualizada de evidência que formatos de avaliação emergentes como o Résumé for Research and Innovation (R4RI) do Reino Unido são construídos para carregar [186]) em lugar da linguagem de classificação "top 10%" aposentada. Nos Estados Unidos a mesma alavanca de linguagem de dossiê é o foco da Higher Education Leadership Initiative for Open Scholarship (HELIOS Open), que trabalha com universidades para reescrever critérios de promoção e permanência [189]; a linha de uso contextualizada especificada aqui é exatamente a rubrica concreta que tais reformas frequentemente carecem de.
10.4 Recomendações para a plataforma
Desativar os rankings sem contexto de reposição troca um sinal falho por nenhum sinal. As consequências vão além do conforto dos autores. Se o encerramento reduz novas submissões, o resultado de volume de postagem especificado na Seção 8.5, é uma questão empírica aberta sobre a saúde da própria plataforma. O framework implica uma direção de produto concreta que não recria o aparato de tabela de classificação que SSRN escolheu desativar [149]:
1. Faixas de percentil anonimizadas por disciplina e idade do artigo. Exiba a posição de downloads e visualizações de cada artigo como uma faixa de percentil aproximada dentro de sua coorte de disciplina por idade: informação que todo autor precisa, publicada de forma que não identifica ninguém, não cria ranking, e reduz a dinâmica vencedor-leva-tudo das listas top-N. O contexto de percentil preserva a privacidade enquanto restaura a legibilidade. O formato de exibição alvo é exatamente o leque de referência específico da idade da Figura 14.
2. Exibição normalizada no tempo. Mostre comparações ajustadas pela idade em vez apenas de contagens cumulativas, de forma que um artigo de 14 dias nunca seja implicitamente comparado com trabalhos que acumularam atenção por anos.
3. Separar alcance de conversão. Relatar visualizações de resumo e downloads como sinais distintos com sua razão, em vez de convidar uma leitura de número único que confunde invisibilidade com rejeição.
4. Classes de referência transparentes. Qualquer indicador comparativo deve indicar a população, campo, período e faixa etária com a qual compara; um "top X%" sem rótulo é cientificamente não informativo. O Apêndice D especifica os dez campos de divulgação que um lançamento de percentil versionado deve conter, desde definições de população e coorte até regras de privacidade de célula mínima e um histórico de versão citável.
5. Auditoria de design para vantagem cumulativa. Classificação, distribuição de alerta, ranking de busca e sinais de popularidade visível alocam atenção escassa e devem ser avaliados por seus efeitos distributivos. Os designs empíricos das Seções 8.4–8.5 são diretamente utilizáveis para tal auditoria.
6. Planejamento para resíduo interpretativo ao desativar recursos. Quando recursos comparativos são removidos, a perda interpretativa deve ser avaliada e mitigada com o mesmo cuidado que a migração de dados, através de distribuições arquivadas, percentis de resumo publicados, ou uma transferência explícita para a comunidade, uma vez que uma métrica que não pode ser lida não pode informar.
7. Mecânicas de contato resistentes à coleta, reduzindo a externalidade de solicitação da visibilidade documentada na Seção 7 [107][159]. Um candidato concreto: atrasar ou ofuscar a exposição pública das rotas de contato do autor aproximadamente nas primeiras 48–72 horas após postagem, a janela na qual a distribuição legítima tipicamente ainda não começou mas a coleta programática é mais provável. O efeito de qualquer medida deve ser avaliado empiricamente, não assumido. O compromisso é real, uma vez que ocultar informações de contato também poderia desfavorecer exatamente os novatos que dependem de feedback direto.
8. Um log de filtragem público e mecânicas de distribuição documentadas. Publique um registro estilo LogEc do que os filtros de integridade descartam, e documente como a distribuição de eJournal e seleção de resumo operam. A infraestrutura adjacente de RePEc/LogEc demonstra que tal transparência é viável em escala [99][129], enquanto SSRN atualmente descreve seus filtros sem publicar seu histórico [144] (Tabela 6). Quando a filtragem é documentada, reformulações de um contador podem ser lidas como eventos de medição em vez de reputacionais.
9. Tornar o histórico de exposição legível. Uma página de artigo ou painel de autor deve distinguir postagem pública, atribuição de classificação, distribuição curada, confirmação de indexação e reformulações importantes de contador, de modo que um autor possa separar "não exposto ainda" de "exposto mas não convertido". Este é o equivalente do lado da plataforma da leitura de regime de exposição da Seção 5.6, e o tratamento mais barato para o estado de painel mais produtor de ansiedade, o zero inicial.
10.5 Recomendações para a comunidade de pesquisa
A comunidade não precisa aguardar a plataforma. O registro da Seção 8.8 (snapshots de dashboard datados, auto-relatados, contribuídos sob protocolo aberto) pode produzir a primeira nova distribuição de downloads em uma década. Os dois estudos de dados públicos da Tabela 17 (1 e 2) são executáveis por qualquer pesquisador dentro dos limites de acesso indicados na Seção 9, enquanto os dois estudos com participantes (3 e 4) requerem voluntários e as aprovações éticas indicadas nas Declarações. A cientometria deve considerar a interpretabilidade das métricas como parte de seu objeto de estudo: o caso presente, em que uma década de contadores sobreviveu à sua única escala pública, é improvável que seja o último. A replicação distribuída do protocolo de postagem instrumentado, manutenção comunitária de tabelas percentis (e da calculadora pública voltada para autores construída sobre elas, Seções 8.8 e 8.10), e avaliação do impacto interpretativo de mudanças na plataforma são todas contribuições de pesquisa por mérito próprio, e cada uma delas converte o trabalho de reparo deste artigo em prevenção.
10.6 Conclusão
A pergunta "o que meus sete downloads significam?" percorreu este artigo porque é a pergunta que os quase dois milhões de autores da plataforma ficaram segurando em 15 de julho de 2026 [49][149]. A resposta reunida aqui não é nem tranquilidade nem alarme, mas calibração. O número é consistente com as evidências de conversão disponíveis, mas permanece um resultado de triagem; a ansiedade é fabricada pela escala ausente, que pode ser reconstruída, em parte pela literatura, conforme as Seções 3–6 fizeram, e em parte por novos dados, conforme a Seção 8 especifica.
O artigo começou com a pergunta que todo autor fica segurando:
"O que meus 7 downloads significam?"
O framework a substitui por isto:
"Onde este artigo se situa entre artigos comparáveis da mesma idade, campo, coorte e histórico de distribuição? Sua limitação é alcance ou conversão? E está sendo recuperado e creditado pelos sistemas através dos quais os leitores agora descobrem pesquisa?"
Essa é uma pergunta que a cientometria pode responder, e este artigo especificou como.
O que os contadores registram são eventos, apenas eventos. Visualizações não são downloads; downloads não são leitura; uma média não é uma norma; um contador não é um veredicto; solicitação não é reconhecimento; recuperação por IA não é atribuição fiel; e um número sem escala não é informação.
Enquanto as plataformas mostrarem um contador apartado de seu contexto, autores, avaliadores e plataformas continuarão lendo fatos distributivos como veredictos pessoais. O acesso aberto venceu a batalha que lutou (o direito de postar e baixar sem barreiras de preço) e, ao vencer, expôs uma batalha que nunca lutou: a alocação de atenção. Autores podem ler contadores com campo, idade e conversão. As métricas do SSRN ainda têm valor, mas apenas para um autor que entende o que significam.
Apêndice A. Situação → Guia de Ação
A Tabela 23 condensa as Seções 4–6 nas situações que autores frequentemente relatam [161][127][139]. Sua coluna do meio afirma apenas o que as evidências reunidas licenciam, com fontes e janelas. A coluna de ressalvas apresenta a limitação que deve acompanhar cada leitura. Os números que aparecem aqui são dos Tabelas 6–7 e Figura 6 do texto principal.
Tabela 23. Situação → o que a evidência diz → o que fazer.
| # | Sua situação | O que a evidência diz | O que fazer | Fontes e ressalvas |
|---|---|---|---|---|
| 1 | "7 downloads e 40 visualizações de resumo no primeiro mês." | A conversão é 17,5%, dentro da faixa entre estudos de 11–19% como uma estimativa pontual, embora o intervalo de 95% de Clopper–Pearson em 7/40 (≈7,3–32,8%) seja amplo e atravesse a faixa; o artigo LSN mediano atingiu 63 downloads apenas após dois anos, e o artigo de marketing mediano ficou em 87 com uma idade mediana de 16 meses — âncoras de amostra madura, não correspondidas em idade para uma leitura no dia 20. Um resultado de triagem com um intervalo amplo, não evidência de falha. | Continue o cronograma de observação da Tabela 11; classifique a trajetória não antes do dia 60–90. | Faixa: [18][139][172]; medianas: [139] (2012 LSN), [83] (2025 Marketing). Todas as âncoras são de uma única disciplina e envelhecidas; a conversão de 7/40 é uma estimativa de triagem de intervalo amplo, não correspondida em idade com as âncoras maduras. |
| 2 | "Zero downloads na primeira semana." | Pré-distribuição normal: a classificação é selecionada e pode levar até 45 dias para tópicos sobrecarregados; alertas eJournal impulsionam visualizações iniciais e continuam pós-encerramento; a indexação do Google Scholar leva 6–9 meses ou mais. | Confirme o envio público; confirme a classificação eJournal; verifique se o artigo está indexado sob seu título exato — o teste de indexação mais barato disponível; aguarde o ciclo de anúncio; apenas então leia os contadores. | [53][147][57][55]. Mudanças na redação da página de suporte; re-verificar com datas de acesso. |
| 3 | "Muitas visualizações, poucos downloads — conversão bem abaixo de 11%." | Consistente com um desajuste resumo–texto: leitores chegam e saem no resumo. As variáveis de empacotamento (título, resumo, palavras-chave) são as alavancas de atenção mais robustamente associadas aos contadores. | Revise o título e o resumo; re-observe a conversão durante a próxima janela antes de outras alterações. | [139][168][172]. A leitura causal "conversão baixa = resumo fraco" é uma hipótese de triagem, não um diagnóstico validado. |
| 4 | "Conversão bem acima da faixa, ou um pico repentino de visualizações." | Tráfego que a navegação de resumo não explica — links de mídia ou agregadores, ou tráfego não humano que os filtros ainda não removeram. | Identifique a fonte externa (cobertura, listas de discussão); não cite o pico como leitura sem corroboração. | [116][138][144][102 — mecanismo de pré-busca de Safe Links, com o ressalvo que a filtragem própria do SSRN pode já excluir tal tráfego]. |
| 5 | "Meu contador caiu, ou os números foram reafirmados." | Plataformas revisam contadores quando as regras de filtragem mudam; RePEc descartou a grande maioria do tráfego bruto em episódios documentados (robôs ≈74% de visualizações em 2007; >99,5% do tráfego IDEAS em setembro de 2025). | Trate como um evento de medição; verifique suas capturas de tela datadas; nunca relate como leitura perdida sem corroboração. | [144][69][99][129][66]. |
| 6 | "As classificações desapareceram e não sei onde estou." | Nenhuma estrutura percentil pública permanece, e nenhuma representativa da plataforma pode ser coletada externamente. A seção transversal arquivada do Apêndice E fornece uma distribuição de referência baseada em amostra, e a comparação correspondida permanece o substituto para percentis de plataforma. | Construa um micro-benchmark de 3–5 artigos de pares postados no mesmo mês e acompanhe-os em seu próprio cronograma; opcionalmente, calcule a razão de seus downloads para uma mediana de coorte correspondida. | [149][51]; âncoras [139][83][85]. A razão não possui bandas de interpretação calibradas (Seção 6.3). |
| 7 | "Um comitê verá meus contadores." | Linhas de classificação em dossiês são prática documentada, e seu marco comparativo desapareceu; linguagem de faixa com fontes, qualificadores de campo e triangulação de citações sobrevive ao escrutínio onde contagens brutas não sobrevivem. | Aplique o protocolo de sete etapas da Tabela 13: preservar, traduzir, triangular, normalizar por campo, complementar, integridade, avaliação especializada. | [12][95][33][52][77][108]. Downloads medem demanda, não qualidade; o histórico de manipulação [44] é conhecido pelos avaliadores. |
| 8 | "Convites predatórios começaram a chegar dias após eu postar." | Um subproduto documentado da coleta em plataformas de preprints; auditorias adjacentes relatam dezenas de convites por quinzena por acadêmico. Volume sinaliza visibilidade para coletadores, não reconhecimento por leitores. | Nunca pague; verifique os locais por meio de Cabells e Think. Check. Submit.; encaminhe correspondência por um endereço dedicado; veja a Tabela 14 para a tipologia. | [107][159][9][84][63][32][136]; [B-1] (lista de Beall extinta desde 2017). Regularidades de tempo não foram medidas; o critério "dias-após-postagem" é qualitativo. |
| 9 | "A verificação de similaridade de um periódico sinalizou meu envio como correspondente ao meu próprio preprint SSRN." | O sistema de verificação está funcionando conforme projetado: preprints registrados como Crossref Posted Content fazem parte do corpus de comparação, e a orientação do iThenticate afirma que uma correspondência de preprint do mesmo autor não é plágio. Postar um documento de trabalho é permitido pelas políticas de publicação anterior da maioria dos periódicos, mas as políticas variam e o periódico alvo deve ser verificado; as principais exceções estão nos campos de medicina e clínica. | Identifique a fonte sinalizada ao editor responsável como seu próprio preprint com carimbo de tempo; não retire o preprint; para periódicos de medicina e clínica, verifique a política de preprint do periódico alvo (por exemplo, por meio do registro Sherpa Romeo) antes do envio. | [81][36]; Seção 4.5. As políticas de periódicos variam e mudam; verifique a política atual do periódico alvo em vez de confiar na regra geral. |
| 10 | "Os Rankings desapareceram — devo mover meus artigos para ResearchGate ou Academia.edu?" | Nenhuma migração de autor pós-sunset é documentada; contadores de download não são transferíveis entre plataformas; e as plataformas comparativas carregam o mesmo problema de interpretabilidade — ResearchGate aposentou seu próprio RG Score composto em agosto de 2022 após crítica metodológica. | Mantenha o registro SSRN e complemente em vez de deslocar: deposite o mesmo artigo em um repositório institucional ou temático (Tabela 13, etapa 5), preserve snapshots de contador com data, e não deletar-e-repostar em outro local, o que perde contadores acumulados. | [130][90][149]; [47][146] (complemento de repositório); [161] (um contador de uma plataforma diz nada sobre outros canais); [B-7] (deletar-e-repostar redefine as métricas). Ausência de migração documentada é ausência de evidência, não prova de estabilidade. |
Práticas de comunidade não verificadas (hipóteses candidatas para a agenda da Seção 8). As seguintes recomendações circulam em comunidades de autores e aparecem em rascunhos anteriores de guias práticos; nenhum estudo as suporta, e elas são registradas aqui como hipóteses testáveis e não devem ser citadas como descobertas: (a) limitar classificações eJournal a três (uma principal, uma ampla, uma interdisciplinar) em vez de usar mais dos sete permitidos [53][168]; (b) citar documentos de trabalho SSRN para que seus autores sejam notificados através de alertas do Google Scholar e retribuam com atenção; (c) ocultar o endereço de email do perfil nos primeiros quatorze dias após postagem para reduzir a coleta; (d) carregar uma revisão menor no dia 3 para desencadear re-anúncio (SSRN documenta apenas que revisões no local preservam contadores e URL [B-7]); (e) qualquer incidência numérica anexada ao critério "convite dentro de 96 horas é predatório"; (f) contato direto com três a cinco autores citados no artigo (uma breve mensagem anotando a citação de seu trabalho SSRN) como um canal para um primeiro público legítimo, enquadrado como comunicação acadêmica ordinária em vez de promoção. Cada uma é falsificável com os projetos observacionais da Seção 8; até ser testada, sua forma de citação apropriada é "prática de comunidade, não verificada."
A Tabela 24 re-ordena o playbook cronologicamente. Cada célula aponta de volta para uma seção e suas fontes. A visualização de cronograma responde à pergunta que os autores realmente fazem ("o que devo fazer agora?") na ordem em que as situações surgem, e complementa a Tabela 23 indexada por situação.
Tabela 24. O playbook como cronograma: três fases × três eixos. Todas as células resumem evidências e instruções já mencionadas nas Seções 4–7; práticas de comunidade não verificadas são excluídas (veja a lista acima).
| Fase | Mecanismos de plataforma e medição | Público e distribuição | Defesa contra solicitações |
|---|---|---|---|
| Antes de postar | Trate o título e o resumo como a superfície de conversão e redija-os de acordo (§6.4; [139][172]); planeje classificações eJournal — até sete são permitidas, e mais classificações estão associadas a mais downloads e menos zeros [53][168] | Identifique o grupo de micro-benchmark de 3–5 artigos para rastrear junto com seu próprio artigo (§6.3) | Encaminhe correspondência por um endereço dedicado antes que os metadados se tornem públicos (§6.6) |
| Ao postar | Confirme postagem pública e classificação eJournal; registre a linha de base do dia 1 da grade da Tabela 11 (§6.1) | Os alertas de email eJournal são o principal canal de push da plataforma e continuam pós-sunset [147][57] | Espere solicitações como uma consequência padrão da visibilidade, não um sinal de mérito (§6.6; [159][63]) |
| Primeiras semanas (dias 1–45) | Leia um zero inicial como pré-distribuição, não rejeição (§6.2 regra iv; [53]); registre contadores no cronograma da Tabela 11; classifique a trajetória não antes do dia 60–90 (§6.3) | Aplique alavancas externas legítimas onde apropriado — cobertura de blog e lista produziram picos iniciais mensuráveis (§6.4; [116][72]) | Nunca pague; analise qualquer local convidativo ([B-1]; Think. Check. Submit. [159]); verifique convites contra a tipologia da Tabela 14; nunca considere o volume de spam como leitorado (§7.6) |
Apêndice B. Modelo de Relatório CSAB
Uma declaração CSAB mínima voltada para autor ou avaliador (Seção 5.5; Tabela 10) relata:
Na idade do artigo [X dias], o artigo tinha [V] visualizações de resumo e [D] downloads validados. Relativo a [campo definido / coorte / classe de referência de novato], seu percentil de alcance era [RV], seu percentil de download [RD] e seu percentil de conversão ajustado por contração [RC]. O artigo [tinha / não tinha] recebido distribuição curada documentada até essa observação. Entre [idade 1] e [idade 2], sua posição normalizada [subiu / permaneceu estável / caiu]. Esses indicadores descrevem difusão e não estabelecem qualidade ou correção da pesquisa.
Até que um painel de referência contemporâneo tenha sido estimado (Seções 5.5, 8.3), os campos de percentil devem permanecer em branco: nenhum valor pode ser inserido por intuição, por médias em toda a plataforma ou por amostras antigas. Âncoras históricas podem ser relatadas ao lado do modelo: a mediana de 63 downloads de LSN de 2012 em dois anos [139] e a mediana da rede de Marketing de 2025 de 87 [83], cada uma com sua amostra, campo e idade declarados, mas nunca substitui a classe de referência ausente. O modelo é a contrapartida em nível de sentença da etapa de Tradução do protocolo do dossiê (Tabela 13, etapa 2).
Apêndice C. Dicionário de Variáveis do Painel
A Tabela C1 especifica o registro mínimo de intervalo de artigo para o painel central da Seção 8.3: o menor esquema suficiente para reproduzir as estimativas de CSAB da Seção 5.5 e as análises de evento de plataforma das Seções 8.4–8.5. Os lançamentos públicos substituem identificadores diretos por chaves de estudo estáveis sempre que a vinculação não é necessária analiticamente, e as contribuições do registro (Seção 8.8) usam o subconjunto deste esquema indicado lá.
Tabela C1. Esquema de dados de intervalo de artigo mínimo para o painel central.
| Domínio | Variável | Definição ou formato |
|---|---|---|
| Identidade | paper_id | Identificador de estudo estável |
| Identidade | ssrn_abstract_id | Identificador de plataforma; codificado em hash ou restrito em lançamentos públicos |
| Cronograma | posted_at | Data de primeira postagem pública |
| Cronograma | observed_at | Carimbo de tempo de observação de métrica (grade da Tabela 11) |
| Cronograma | paper_age_days | Dias desde a primeira postagem |
| Uso | abstract_views_cum | Visualizações cumulativas públicas de página de resumo |
| Uso | downloads_cum | Downloads validados cumulativos públicos |
| Uso | views_interval, downloads_interval | Incrementos da observação válida anterior |
| Exposição | classification_ids | Todas as classificações de eJournal ativas na observação |
| Exposição | distributed_status, distributed_at | Indicador de distribuição curada e data, onde consentido |
| Exposição | search_indexed | Status de índice externo definido por protocolo (teste de título exato) |
| Artigo | title_frozen, abstract_frozen, keywords, page_count, doi | Metadados de manuscrito observados mais cedo, congelados na primeira observação |
| Artigo | authors_frozen, affiliations_frozen | Nomes de autores, ordem e afiliações na primeira observação |
| Controle de versão | revision_id, revision_at, material_change_flag | Histórico de versão com um indicador de mudança material |
| Autores | author_count, platform_newcomer, prior_ssrn_papers | Estrutura da equipe e histórico da plataforma anterior à postagem (definições da Seção 8.3) |
| Reputação | prior_citations, prior_works, institution_measure | Congelado antes da postagem focal e normalizado por campo |
| Calendário | day_of_week, week, season, holiday_flag | Controles temporais predefinidos [178] |
| Posterior | citations_6m, citations_12m, citations_18m, publication_status | Resultados de validação posterior com fonte e data (horizontes da Seção 8.9) |
| Auditoria | collection_method, source_url, quality_flag | Proveniência, rota de acesso e documentação de anomalia (sinalizador, não excluir; Seção 8.3) |
Apêndice D. Especificação de Transparência da Referência
Para evitar que o ponto de referência de percentil da Seção 8.8 e qualquer sucessor mantido pela plataforma ou pela comunidade (Seção 10.4, recomendações 1 e 4) reproduzam a opacidade do ponto de referência que este artigo critica, cada lançamento de percentil é publicado com um acompanhamento versionado especificando:
1. a população de artigos elegível, redes, tipos de documento e exclusões;
2. datas de coorte de postagem e idades de observação;
3. a regra de atribuição de campo, incluindo o tratamento de classificações múltiplas;
4. as definições de visualizações, downloads, atores únicos, repetições e tráfego validado em vigor no lançamento;
5. a mediana, intervalo interquartil, P10/P25/P75/P90/P95, compartilhamento de zeros, coeficiente de Gini e compartilhamentos principais;
6. tamanhos de amostra e intervalos de incerteza para cada classe de referência relatada;
7. o tratamento de dados faltantes, retiradas, revisões, mesclagens e reafirmações contrárias;
8. as variáveis de distribuição e promoção externa incluídas em qualquer ajustamento;
9. regras de privacidade e células mínimas: para o registro colaborativo da Seção 8.8, onde pequenas células de campo por idade poderiam de outra forma identificar contribuidores individuais, este item é uma restrição vinculativa governada pela lei de proteção de dados (no Reino Unido, RGPD do Reino Unido e Lei de Proteção de Dados de 2018), não uma formalidade. O controle de divulgação deve estender além da anonimização simples para k-anonimidade ou agregados com ruído adicionado (diferencialmente privados) para células finas, e uma regra de uso permitido deve vincular o registro à interpretação em vez de avaliação, proibindo seu uso para contratação, promoção, alocação de recursos ou remontagem em qualquer placar público;
10. um histórico de versão e uma referência permanente citável para o lançamento.
Nenhuma pontuação composta pode substituir estes componentes. Razões simples para uma mediana de coorte (a alternativa não calibrada da Seção 6.3) podem ser instáveis quando a célula do denominador é pequena e podem falsamente sugerir que "duas vezes a mediana" mapeia para um percentil fixo em campos de formas diferentes. Os relatórios para autores, portanto, usam estimativas de percentil sob a contração de Bayes empírica já especificada para células esparsas na Seção 8.3, enquanto as distribuições brutas permanecem disponíveis para auditoria.
Apêndice E. Uma Seção Transversal Arquival Independente da Distribuição de Downloads
Para evidência recente de distribuição total, a síntese das Seções 3 e 5 se baseia em um único snapshot publicado [83]. Este apêndice relata uma seção transversal independente e reprodutível montada para este artigo que corrobora a estrutura distribucional entre campos, usando apenas dados públicos e sem acesso privilegiado à plataforma. É uma reconstrução arquival única com viés ascendente conhecido, oferecida como corroboração de forma, distinta do painel pré-registrado da Seção 8.6, que observa artigos prospectivamente a partir do envio.
Método. Uma amostra aleatória de artigos SSRN foi extraída do OpenAlex (fonte S4210172589, "SSRN Electronic Journal") em vinte e três sementes aleatórias independentes. Para cada artigo amostrado, os contadores de download pré-encerramento e visualização de resumo foram lidos da captura mais recente do artigo no Internet Archive, localizada através do endpoint de disponibilidade pública do Wayback Machine, em vez do site ativo, que é protegido por acesso (Seção 4) e não publica mais quadros comparativos. Ler os contadores a partir de cópias arquivadas em vez de consultar a plataforma mantém o procedimento limitado por taxa, respeitoso com a plataforma e reprodutível a partir dos identificadores divulgados. Porque os contadores por artigo sobreviveram ao encerramento do Rankings inalterados, e apenas os Rankings comparativos foram retirados, uma captura posterior a 15 de julho de 2026 permanece uma leitura válida dos contadores cumulativos de um artigo. Os snapshots não foram, portanto, restritos à janela pré-encerramento, e a data da captura é retida apenas para calcular a idade do artigo. Capturas que retornaram um desafio intersticial de bot em vez de conteúdo de página foram descartadas. De 2.600 artigos amostrados, 64% tinha uma captura arquivada utilizável e 52% resultou em uma contagem de download legível por máquina, resultando em n = 1.360 artigos abrangendo vinte e cinco campos, quatorze deles com pelo menos vinte artigos, e idades de artigos desde o ano de envio até mais de duas décadas. O conjunto de dados é lançado como appendixE-wayback-downloads.csv e depositado em https://doi.org/10.5281/zenodo.22285871, onde o mesmo arquivo recebe o nome study1-wayback-downloads.csv. Duas propriedades da amostra restringem o que pode ser lido a partir dela. As datas de envio contêm um ano e nenhum mês: 1.358 dos 1.360 registros são marcados com 1º de janeiro, porque o OpenAlex relata envios do SSRN em resolução de ano. A idade é, portanto, calculada como ano da captura menos ano de envio, relatada em anos inteiros, e nenhuma banda mais curta é defensável. As capturas também estão concentradas no tempo: 688 delas, metade da amostra, caem em um único rastreamento entre 25 de abril e 7 de maio de 2025, e 81,5 por cento caem em 2025, então a idade do artigo aqui se aproxima muito de uma reafirmação do seu ano de envio e os dois não podem ser separados. O primeiro destes é removível. A linha de envio "Posted: DD Mon YYYY" aparece nas mesmas capturas arquivadas, portanto datas completas podem ser recuperadas através de re-análise, o que o portão de acesso no site ativo não impede. A Tabela E1 torna este atrito explícito.
Tabela E1. Construção da seção transversal arquival e atrito em cada estágio.
| Estágio | Artigos | % do inicial | % do anterior |
|---|---|---|---|
| Registros do OpenAlex amostrados aleatoriamente (SSRN Electronic Journal) | 2.600 | 100,0 | — |
| Captura utilizável do Internet Archive localizada | ≈1.660 | 63,8 | 63,8 |
| Captura continha uma contagem de download legível por máquina | 1.360 | 52,3 | 81,9 |
| Amostra analítica final | 1.360 | 52,3 | 100,0 |
Resultados. A seção transversal reproduz cada característica qualitativa que as âncoras publicadas afirmam (Table E4). Os downloads são altamente assimétricos à direita: média 219, mediana 60 (IC bootstrap de 95% 55–69), razão média-para-mediana 3,65, com a média excedendo o 75º percentil (158). Também apresentam uma cauda superior pesada (95º percentil 816, mais de treze vezes a mediana; Gini 0,75, IC de 95% 0,71–0,78). No logaritmo, a distribuição é aproximadamente simétrica (assimetria de ln downloads ≈ 0,18), consistente com log-normalidade aproximada no corpo observado da distribuição, a propriedade que Kakushadze poderia ajustar apenas nas listas superiores (Section 3.4). A conversão de downloads para visualizações tem uma mediana de 16,2% e uma média de 17,3%, dentro da faixa entre estudos de 11–19% (Section 5.2). Os downloads medianos diferem entre os campos na mesma idade do artigo. Mantendo a faixa etária fixa, a diferença entre a mediana de campo mais alta e a mais baixa varia de aproximadamente três para aproximadamente cinco vezes, com o valor exato dependendo da faixa e do tratamento dos campos com amostragem reduzida. Agrupados em todas as idades, a diferença chega a cerca de doze vezes, e esse valor maior reflete a composição mutável da amostra: Engenharia fornece de 21 a 27 por cento dos artigos com idade de três anos ou menos e no máximo 5 por cento daqueles com nove anos ou mais, enquanto Economia fornece de 9 a 12 por cento e de 37 a 54 por cento dos mesmos grupos, e a idade mediana de um artigo de Economia aqui é nove anos contra um ano para Engenharia. A direção concorda com o multiplicador de campo da Section 3.6. As magnitudes não são comparáveis, porque esse multiplicador repousa em médias de vida útil em 94 subcampos de uma única disciplina e essa diferença em medianas em 25 disciplinas, e nenhuma é ajustada pela idade. Os downloads medianos são maiores nas faixas etárias mais antigas, com intervalos de confiança bootstrap de 95% não sobrepostos entre a maioria das faixas adjacentes (mediana 12 no ano de postagem, 172 além de dez anos), que é a dependência etária que motiva o argumento de classe de referência. Dentro de um único campo, a diferença se concentra nos primeiros três ou quatro anos: entre a faixa de cinco a dez e a faixa além de dez, não atinge significância (Mann-Whitney p = 0,57 para Economia, 0,82 para Ciências Sociais, 0,23 para Negócios). Aproximadamente um quarto do gradiente agrupado é composição de campo em vez de idade. A idade nesta amostra também se aproxima de uma reafirmação do ano de postagem, já que metade das capturas foram feitas em uma única captura entre 25 de abril e 7 de maio de 2025 e 81,5 por cento se enquadram em 2025, portanto idade e coorte não podem ser separadas aqui e as faixas relatam níveis em vez do caminho de qualquer artigo individual. A média da amostra (219) coincide com a média de rede de marketing publicada (221) [83], enquanto a mediana da amostra (60) se situa no nível da mediana legal de estilo censitário (63) [139]. A Table E2 fornece a distribuição de downloads por idade do artigo e a Table E3 por campo, ambas com intervalos de confiança bootstrap de 95% e tamanhos de amostra. Os intervalos de confiança são mais amplos para os campos menores, razão pela qual a diferença de campo é descrita como aproximadamente uma ordem de magnitude em vez de um múltiplo preciso único. O caso de abertura do artigo pode ser lido diretamente em relação à amostra. Entre artigos com menos de dois anos de idade com 30 a 50 visualizações de resumo, a faixa em que esse caso se enquadra, a contagem mediana de downloads é 7, com um intervalo interquartil de 4 a 11 (n = 42). O caso no título é o caso típico para sua faixa de visualizações e idade. No ano de postagem, 35 por cento da amostra registra 7 downloads ou menos, a contagem mediana de visualizações de resumo é 66, e a própria conversão do caso de 17,5 por cento se situa no 57º percentil da amostra. A faixa de conversão de 11–19% da Section 5.2 é uma faixa de medianas em vez de artigos: 41 por cento da amostra se enquadra nela, 23 por cento abaixo e 36 por cento acima. Metade da amostra, 51 por cento, fica abaixo da mediana legal de estilo censitário de 63 [139], o que coloca o intervalo nascente na parte preenchida da distribuição.
Table E2. Distribuição de downloads por idade do artigo na seção transversal arquivística.
| Idade do artigo | n | Mediana [IC de 95%] | Média | AIQ (P25–P75) |
|---|---|---|---|---|
| ano de postagem | 203 | 12 [11–14] | 33 | 5–21 |
| 1 ano | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4 anos | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9 anos | 188 | 130 [110–151] | 384 | 72–374 |
| 10 anos e mais | 341 | 172 [157–189] | 453 | 96–336 |
| Todos os artigos | 1.360 | 60 [55–69] | 219 | 23–158 |
Table E3. Distribuição de downloads por campo (campos com n ≥ 20) na seção transversal arquivística.
| Campo (n ≥ 20) | n | Mediana [IC de 95%] | Média | AIQ |
|---|---|---|---|---|
| Economia | 285 | 150 [134–169] | 443 | 76–302 |
| Negócios | 161 | 150 [126–188] | 335 | 72–330 |
| Psicologia | 24 | 107 [35–192] | 179 | 32–229 |
| Ciências Sociais | 241 | 85 [78–117] | 219 | 45–189 |
| Ciências da Decisão | 32 | 74 [56–158] | 615 | 49–260 |
| Ciência da Computação | 63 | 42 [36–73] | 167 | 26–104 |
| Medicina | 40 | 42 [24–59] | 81 | 22–66 |
| Agríc. e Ciências Biológicas | 36 | 31 [24–57] | 65 | 23–67 |
| Bioquímica | 21 | 30 [23–37] | 38 | 20–38 |
| Ciência Ambiental | 72 | 26 [18–32] | 44 | 14–50 |
| Engenharia | 196 | 24 [20–26] | 46 | 13–46 |
| Física e Astronomia | 21 | 23 [15–38] | 112 | 13–45 |
| Ciência dos Materiais | 55 | 18 [15–25] | 26 | 11–36 |
| Energia | 21 | 12 [11–22] | 25 | 11–22 |
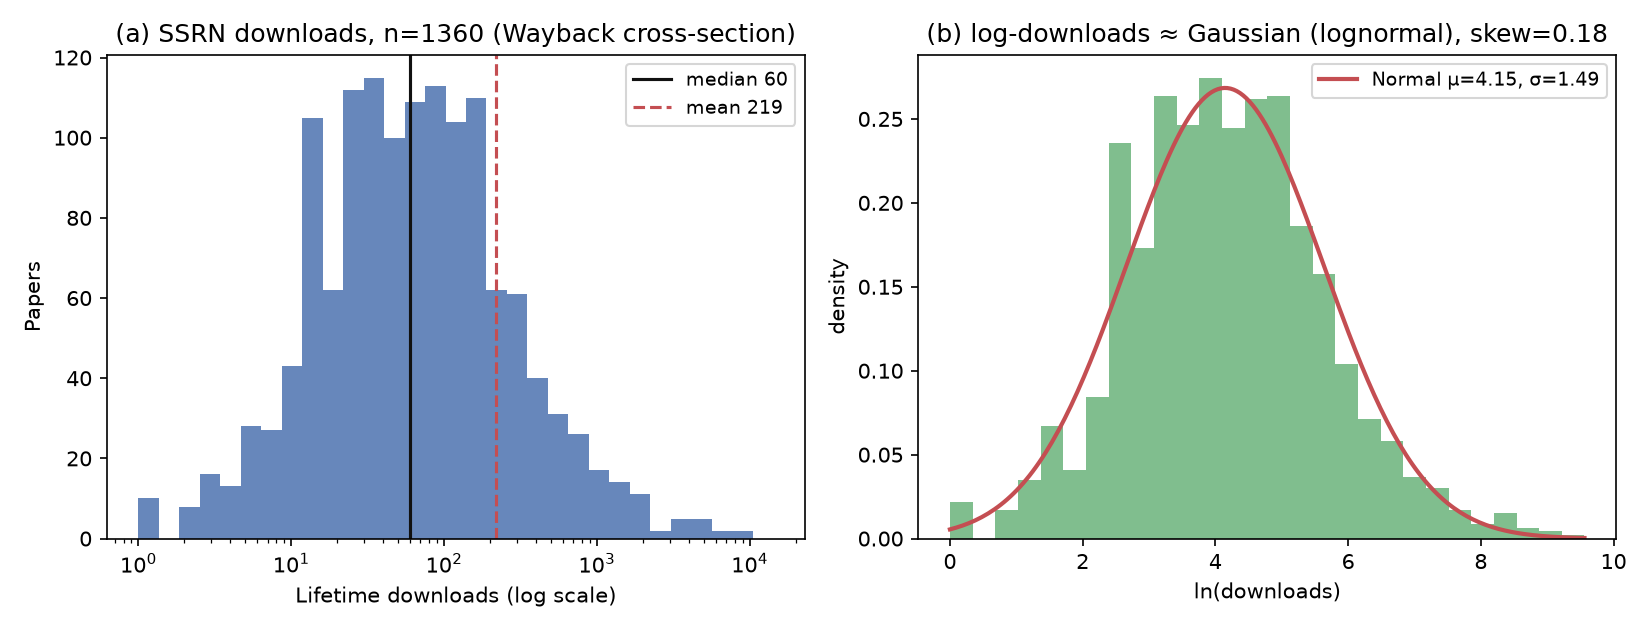
Figura E1. (a) A distribuição de downloads em escala logarítmica com a média e mediana marcadas; (b) um histograma de ln(downloads) com uma densidade normal ajustada. Assimetria de log-downloads ≈ 0,18. n = 1.360.
Tabela E4. Âncoras publicadas versus a seção transversal de arquivo independente (n = 1.360).
| Característica | Âncora publicada | Seção transversal de arquivo |
|---|---|---|
| Downloads médios | 221 (marketing) [83] | 219 |
| Downloads medianos | 87 (marketing) [83]; 63 (law) [139] | 60 |
| Média / mediana | 2,54 [83] | 3,65 |
| 95º percentil / mediana | > 8 [83] | 13,6 |
| Conversão de download para visualização | Faixa de 11–19% (§5.2) | 16,2% mediana |
| Dispersão de campo (medianas) | ≈ 8× médias de campo, não ajustado por idade [168] | ≈ 3–5× em idade igual; 12,5× agrupado |
| Forma da distribuição | log-normal, apenas cauda [85] | assimetria de log 0,18 (corpo observado) |
O que a seção transversal estabelece. A seção transversal corrobora a forma da distribuição e sua estrutura central e superior em disciplinas, em uma amostra independente de todos os campos muito mais ampla em cobertura de campo do que qualquer instantâneo único publicado do SSRN. Não estima percentis representativos da plataforma, e dois aspectos de sua construção a enviesam para cima. As capturas de arquivo sobre-representam páginas visíveis, de modo que os artigos pesados em downloads são mais prováveis de serem capturados. Um artigo também entra na amostra apenas se tivesse uma página de arquivo com um contador legível, que censura a cauda extremamente baixa: a proporção da amostra de artigos com dez ou menos downloads (cerca de 10%) está consequentemente bem abaixo dos 15–30% que as Seções 3.4 e 8.6 antecipam para uma amostra de plataforma inteira imparcial, e não deve ser lida como uma estimativa dessa proporção. Que a mediana da amostra (60) ainda assim fica em ou abaixo das medianas publicadas de direito (63) e marketing (87) indica que o viés para cima é modesto para a massa central e que as conclusões de assimetria e cauda pesada são, se for o caso, conservadoras. Para benchmarks calibrados, os instrumentos apropriados permanecem sendo as faixas de percentil representativas da plataforma recomendadas na Seção 10 e o painel pré-registrado da Seção 8.6; esta seção transversal corrobora que a estrutura que eles mediriam é a que este artigo descreve. Três das faixas de previsão que o Estudo 1 fixa antecipadamente (Seção 8.6) podem ser lidas contra esta amostra, tendo em mente seu viés para cima. A mediana da amostra de 60 downloads fica dentro dos 30 a 80 previstos. O Gini de atenção de 0,75 fica na borda inferior dos 0,75 a 0,90 previstos, que é a direção que o viés de amostragem prevê, já que a cauda baixa censurada comprime a desigualdade medida. A razão mediana-para-média de 0,27 está abaixo do teto previsto de 0,5. Nada disso valida o design prospectivo, cujo valor é que observa artigos desde a postagem em uma amostra de probabilidade; registra que as faixas não foram definidas de forma implausível.
Declarações
Disponibilidade de dados. Cada âncora sintetizada reproduzida aqui pode ser rastreada até as fontes publicadas citadas no texto e nas tabelas, com frames de amostragem e status de verificação declarados no ponto de uso, e nenhum novo conjunto de dados representativo da população fundamenta as reivindicações de benchmark do artigo. O único conjunto de dados original gerado para este artigo é a seção transversal de arquivo independente do Apêndice E, uma amostra aleatória de todos os campos de 1.360 artigos cujos contadores pré-aposentadoria foram recuperados de arquivos públicos, lançado como appendixE-wayback-downloads.csv (um conjunto de dados do Apêndice E, não o Estudo 1 prospectivo) com o código de análise, para que o procedimento possa ser re-executado e estendido; corrobora a forma da distribuição e não é um benchmark representativo da plataforma. O conjunto de dados é depositado em https://doi.org/10.5281/zenodo.22285871 sob CC BY 4.0, onde o mesmo arquivo carrega o nome study1-wayback-downloads.csv, e vem com uma ferramenta aberta que lê uma contagem de downloads contra ele enquanto condiciona em idade e campo do artigo, em https://github.com/vadimchernets/ssrn-benchmark (licença MIT, apenas biblioteca padrão Python). Leitores que desejam colocar seu próprio contador nesta classe de referência podem executar essa ferramenta em vez de reconstruir a análise. Materiais para a agenda pronta para pré-registro da Seção 8, incluindo o dicionário de variáveis de painel (Apêndice C, Tabela C1) e o inventário de consultas de auditoria de pesquisa, estão preparados para depósito em pré-registro (Seção 8.8); as contribuições de registro seguem o subconjunto de esquema definido na Seção 8.8, e qualquer versão de percentil do programa de benchmark é publicada sob a especificação de transparência do Apêndice D. O modelo de relatório CSAB do Apêndice B pode ser reutilizado livremente, sujeito à sua regra de percentil em branco. Em 24 de agosto de 2026, um pedido formal foi apresentado ao Suporte SSRN (ticket 260824-003051) para a classe de referência agregada que os Rankings desativados implicavam — mediana, intervalo interquartil e faixas de decil de downloads estratificados por campo e idade do artigo, sem identificadores por artigo; seu resultado (concessão, recusa ou não-resposta) será relatado em uma revisão subsequente.
Acesso aberto a este artigo. Uma cópia licenciada abertamente deste manuscrito é depositada em https://doi.org/10.5281/zenodo.22166896 (CC BY 4.0), onde o texto completo é recuperável diretamente e sem um desafio de acesso. O depósito é fornecido porque o registro canônico no SSRN é servido atrás de mitigação de bot que recusa clientes sem um mecanismo JavaScript, uma condição documentada na Seção 4.2; leitores, gerenciadores de referências e clientes automatizados que não conseguem acessar a cópia canônica podem obter o mesmo texto do depósito. Os artigos complementares são depositados nos mesmos termos em https://doi.org/10.5281/zenodo.22166995 e https://doi.org/10.5281/zenodo.22168724.
Disponibilidade do código. O código de coleta e análise para a seção arquival independente do Apêndice E é liberado juntamente com seu conjunto de dados em https://github.com/vadimchernets/ssrn-benchmark, para que o procedimento possa ser reproduzido e a classe de referência re-derivada dos contadores brutos. De outro modo, o artigo não relata resultados que exigem código de análise; modelos de geração de figuras para os designs empíricos da Seção 8 serão lançados como um apêndice online acompanhando os materiais de pré-registro.
Ética. Os designs empíricos da Seção 8 baseiam-se em contadores de nível de artigo exibidos publicamente e metadados bibliográficos; qualquer coleta de informações de painel não públicas, datas de status de distribuição ou mensagens de email requer consentimento informado e, quando aplicável, revisão institucional (veja Seção 9). Os dois designs que constituem pesquisa com seres humanos, Estudo 4 (a pesquisa do autor) e Estudo 3 (postagem instrumentada com registro de caixa de entrada), serão submetidos para aprovação do conselho de revisão institucional ou comitê de ética em pesquisa e conduzidos sob consentimento informado dos participantes antes de qualquer coleta de dados começar. Conjuntos de dados de mensagens são agregados e desidentificados antes de qualquer relatório, e postagens da comunidade são citadas apenas quando existe uma fonte ao vivo e verificável, com paráfrase quando os autores poderiam ser identificados contra suas expectativas. A coleta de dados é confinada aos meios permitidos pelos termos de serviço das plataformas: os designs usam contadores exibidos publicamente e metadados bibliográficos e não empregam scraping que violaria os termos de uso de uma plataforma, e qualquer design que exija dados em massa ou não públicos procede através de uma solicitação de dados formal e revisão legal em vez de extração automatizada. A citação de conteúdo de fórum semi-público atenta para o consentimento do colaborador e o risco de re-identificação, o que é o motivo pelo qual tal material é parafraseado em vez de reproduzido literalmente onde um autor poderia ser identificado contra suas expectativas. O artigo não rotula nenhuma revista ou editora específica como "predatória"; a triagem de local aplica critérios validados e transparentes, o que mantém qualquer classificação defensável e evita difamação.
Agradecimentos. O autor agradece a Stefanie Haustein pelos comentários críticos, enviados por email em agosto de 2026, que levaram a revisões da Seção 4.2, e a Vincent Larivière, cuja pergunta em correspondência — qual normalização única um autor deveria insistir em primeiro, e sua insistência em ver dados em vez de argumentação — levou à seção arquival relatada no Apêndice E.
Conflitos de interesse. O autor é o desenvolvedor dos métodos de orquestração multi-modelo discutidos na Seção 8.10, que são abertos e reproduzíveis, um interesse que os leitores devem ponderar. O autor é um candidato nomeado em pedidos de patente pendentes, não patentes concedidas, cobrindo sistemas de orquestração de IA e validação multi-modelo do tipo discutido naquela seção. O design de entrega de camada de orquestração proposto na Seção 8.10 é uma especificação conceitual sobre a qual nenhuma das descobertas do artigo repousa. A Seção 8.10 poderia ser excluída completamente sem alterar nenhum diagnóstico, resultado ou recomendação em outro lugar do artigo.
Ferramentas e verificação. Assistentes de IA foram usados como instrumentos sob a direção do autor; as ideias, pesquisa e conclusões são do autor. Todas as afirmações quantitativas e citações foram verificadas pelo autor contra suas fontes primárias ou cópias arquivadas; o autor tem responsabilidade exclusiva pelo conteúdo.
Referências
As fontes citadas no texto como [B-n] (páginas da plataforma, threads de fórum, postagens de blog e outros materiais de apoio) são listadas separadamente abaixo em "Fontes adicionais." As páginas da plataforma com data de acesso são instáveis e devem ser re-verificadas contra cópias arquivadas.
[1] AALL / ALL-SIS (2024, June 14). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, May 28). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; survey fielded May 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, November 16). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). Editoras predatórias estão corrompendo o acesso aberto. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). Chamando a Mentira: A Arte do Ceticismo em um Mundo Orientado por Dados. Random House.
[16] Bessembinder, H. (2018). As ações superam títulos do Tesouro? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). Acesso aberto versus periódicos por assinatura: uma comparação do impacto científico. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). Classificação de Faculdades de Direito: Utilizando SSRN para Medir o Desempenho Acadêmico. Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). Fator de impacto de uso: Os efeitos das características da amostra em métricas de impacto baseadas em uso. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). As altmétricas apontam para o impacto mais amplo da pesquisa? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). Como normalizar contagens do Twitter? Uma primeira tentativa baseada em periódicos no Índice do Twitter. Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). O uso de percentis e classes de postos percentis na análise de dados bibliométricos: Oportunidades e limitações. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). Normalização de dados inflacionados de zeros: Uma análise empírica de uma nova família de indicadores e seu uso com dados de altmétricas. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). Dez regras simples para considerar a respeito da submissão de pré-impressões. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). Estatísticas anteriores de uso da Web como preditoras do impacto de citação posterior. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). O papel de pré-impressões eletrônicas na comunicação química: Análise de citação, uso e aceitação na literatura de periódicos. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). Avaliando o impacto da mudança social planejada. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). Congestionamento na infovia de informações: Ineficiências em artigos de trabalho de economia. Journal of Public Economics, 225, 104978 (também NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). Mitigando Tráfego Agressivo de Rastreadores na Era da IA Generativa: Uma Abordagem Colaborativa das Bibliotecas da Universidade da Carolina do Norte em Chapel Hill. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). Experimentos de campo online. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). Downloads versus citações em economia: relacionamentos, fatores contribuintes e além. In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informetrics), Madrid.
[32] Cobey, K. D., et al. (2019). Conhecimento e motivações de pesquisadores publicando em periódicos presumivelmente predatórios. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). "Showcase Your Scholarship, Part Three: Self-Publishing". https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). "Social Science Research Network (SSRN) Ending Commercial Products". https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. Documentação da API REST. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. Documentação de Verificação de Similaridade. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). Publicação de acesso aberto, downloads de artigos e citações: ensaio controlado randomizado. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). O arXiv leva a citações mais altas e downloads de editoras reduzidos para artigos de matemática? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). Revisitando a relação entre downloads e citações: uma perspectiva de artigos com diferentes padrões de citação no caso do Lancet. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). A Vantagem do Acesso Aberto para Revistas de Direito Americanas. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). O efeito do financiamento na citação e atenção social: os Objetivos de Desenvolvimento Sustentável (ODS) das Nações Unidas como um caso de estudo. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). "How many reads does a typical academic article get?" https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Melhorando a Factualidade e Raciocínio em Modelos de Linguagem através de Debate Multiagente. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). Comparações Sociais e Decepção em Hierarquias do Local de Trabalho: Evidência de Campo e Experimental. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (circulado desde 2009)
[45] Eisenberg, T. (2006). Avaliando as Classificações de Faculdades de Direito Baseadas em SSRN. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). "Elsevier Acquires the Social Science Research Network (SSRN)…". PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (também LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. "SSRN Research Paper Series Sunset — DC Options". https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. "SSRN First Look" (página de produto). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. "SSRN for Authors and Researchers" (página de produto). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. "How can researchers gauge a paper's impact?" https://www.elsevier.support/ssrn/answer/gauge-impact (acessado em 14.08.2026)
[51] Elsevier/SSRN Support. "What are RSS and Data Feeds on SSRN". https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. "What is SSRN?" https://www.elsevier.support/ssrn/answer/what-is-ssrn (acessado em 14.08.2026)
[53] Elsevier/SSRN Support. Classification and distribution. https://www.elsevier.support/ssrn/answer/classification-distribution (acessado em 14.08.2026)
[54] Elsevier/SSRN Support. Generative AI policy. https://www.elsevier.support/ssrn/answer/AI (acessado em 14.08.2026)
[55] Elsevier/SSRN Support. Google / Google Scholar indexing. https://www.elsevier.support/ssrn/answer/google-scholar (acessado em 14.08.2026)
[56] Elsevier/SSRN Support. Submission guidelines / Get started. https://www.elsevier.support/ssrn/answer/get-started (acessado em 14.08.2026)
[57] Elsevier/SSRN Support. Subscriptions (correspondências de revistas eletrônicas). https://www.elsevier.support/ssrn/answer/subscriptions ; também https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). Rankings and reactivity: How public measures recreate social worlds. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). Citation Advantage of Open Access Articles. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). Matthew effects in science and the serial diffusion of ideas. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). Identifying academic spam and recommendations for dealing with it: a literature review. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (publicado em 8 de maio de 2026)
[62] Fraser, N., et al. (2020). The relationship between bioRxiv preprints, citations and altmetrics. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). Trust, but Verify: An Exploratory Audit of Predatory Journal and Publisher Solicitations. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). Impact of author characteristics on outcomes of single- versus double-blind peer review: a systematic review of comparative studies in scientific abstracts and publications. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv at 20. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. "SSRN and Download Statistics" (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; "Update on SSRN", https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). Problems of monetary management: The U.K. experience. In Papers in Monetary Economics, Vol. I. Sydney: Reserve Bank of Australia. Reprinted in C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). London: Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). The Digital Lawyer's Evolving Education in Scholarly Research. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). The Question of Data Integrity in Article-Level Metrics. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). Relationship between downloads and citations at journal and paper levels, and the influence of language. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). Positional effects on citation and readership in arXiv. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). Last but not least: Additional positional effects on citation and readership in arXiv. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). Characterizing social media metrics of scholarly papers. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). Tweets as impact indicators: Examining the implications of automated "bot" accounts on Twitter. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). Interpreting "altmetrics": viewing acts on social media through the lens of citation and social theories. In: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). Ranking the Academic Impact of 100 American Law Schools. Jurimetrics, 60(1), 1–39 (Outono de 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). Bibliometrics: The Leiden Manifesto for research metrics. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). An index to quantify an individual's scientific research output. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). On the relationship between download and citation counts: An introduction of Granger-causality inference. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. Guias: "Understanding the Similarity Report"; "Preprints". https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, March 6). AI search has a citation problem. Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). A IA pode reduzir o prêmio de reputação na difusão do conhecimento? Evidências de artigos de pesquisa de marketing da SSRN. Marketing Letters, 37, Artigo 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). Uma análise de solicitações de periódicos predatórios em oftalmologia. American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — fonte da figura "1813 emails"
[85] Kakushadze, Z. (2016). Um índice para downloads da SSRN. Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). O efeito do acesso aberto (Conferência AEA 2014). https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). Scrapers respeitam seletivamente as diretivas robots.txt: evidências de um estudo empírico em grande escala. Anais da Conferência ACM de Medição da Internet (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). Problemas de previsão de políticas. American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). Spam em publicação acadêmica: um estudo de caso. JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). Um olhar crítico sobre o ResearchGate Score como medida de reputação científica. Apresentado em ASCW'15 (Quantificando e analisando comunicação acadêmica na web), Conferência de Web Science 2015, Oxford. http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (versão popular: "The ResearchGate Score: a good example of a bad metric," LSE Impact Blog, 9 Dec 2015)
[91] Kurtz, M. J., et al. (2005). As propriedades bibliométricas da informação de leitura de artigos. JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). Bibliometria de uso. Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). A vantagem de citação do acesso aberto é real? Uma revisão sistemática da citação de artigos de acesso aberto e baseados em assinatura. PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). O oligopólio dos editores acadêmicos na era digital. PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. "Publishing Tips" (PDF). https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). Características de solicitações por e-mail de periódicos e editoras de enfermagem predatórios. The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). Detectores de GPT têm enviesamento contra escritores não-nativos de inglês. Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). Artigo convidado — Amor, morte e robôs: edição acadêmica. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. Sobre LogEc (metodologia de filtragem de tráfego). https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). Otimizando visibilidade em motores generativos: uma pesquisa crítica de otimização de motores generativos (2023–2026). arXiv:2607.14035 (submetido em 15 de julho de 2026). https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). "Maynooth University's School of Law and Criminology ranks first…". https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). A relação entre uso e citações em um megaperiódico de acesso aberto. Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). Evidência de um efeito Matthew de Harvard e Chicago. Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). O efeito Matthew na ciência. Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). O efeito Matthew na ciência, II: vantagem cumulativa e o simbolismo da propriedade intelectual. Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. "Safe Links in Microsoft Defender for Office 365". https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ Microsoft P&R em cliques em UrlClickEvents; + análise de aberturas falsas)
[107] Milanovic, M. EJIL:Talk! "Academic Spam [UPDATED]". https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). Sobre distribuições de download de texto completo e citações em periódicos científico-acadêmicos. JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). Informetria avaliativa aplicada. Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). Avaliando cientistas para contratação, promoção e permanência. PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). Prestígio impulsiona desigualdade epistêmica na difusão de ideias científicas. EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). Viés de influência social: um experimento randomizado. Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). A tirania das métricas. Princeton, NJ: Princeton University Press. ISBN 978-0-691-17495-2.
[114] Nature Neuroscience, Editorial (2008). https://www.nature.com/articles/nn0608-619
[115] Northwestern University LibGuides (avaliação de pesquisa/métricas). https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). Blogs influenciam downloads da SSRN? Testando empiricamente os efeitos Volokh e Slashdot. U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. "Get Published — Guide for Law Review Members". https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. "What is a good h-index?" https://paperpile.com/g/what-is-a-good-h-index/ (guias similares: Elsevier, Researcher.Life, Academia Insider)
[119] Perneger, T. V. (2004). Relação entre "contagens de acessos" on-line e citações subsequentes: estudo prospectivo de artigos de pesquisa no BMJ. BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). Reputação e impacto nas carreiras acadêmicas. PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, Junho 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (cópia arquivada em web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Publicado 30 Junho 2026 (Release 5.1 publicado 5 Maio 2023). https://www.countermetrics.org/ ; "Best Practice on AI Usage" (orientação para R5.1.1, atualizado 30 Junho 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "To what extent would you recommend or discourage publishing an academic working paper on SSRN…". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, Agosto 10). Thread 15newc2 "Endless spam since I published a paper a few months ago". https://www.reddit.com/r/AskAcademia/comments/15newc2/ (confirmado via o arquivo pullpush.io)
[128] Remler, D. (2014, Abril 23). Are 90% of academic papers really never cited? Reviewing the literature on academic citations. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: "How RePEc counts views and downloads" (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; "AI issues in RePEc" (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; "RePEc in June 2026" (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, Agosto). "Removing the RG Score". https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Experimental study of inequality and unpredictability in an artificial cultural market. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). The discipline of rankings: Tight coupling and organizational change. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Methods and metrics for cold-start recommendations. Em Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. Pacote R SSRN. https://github.com/enricoschumann/SSRN (também scrapers github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, Junho 3). The impact of AI bots and crawlers on open repositories: Results of a COAR survey, Abril 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). 'Predatory' open access: a longitudinal study of article volumes and market characteristics. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). The feasibility of developing and implementing journal usage factors: a research project sponsored by UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). How the scientific community reacts to newly submitted preprints. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Legal Research in Search of Attention: A Quantitative Assessment. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Versão working-paper: "What Determines SSRN Downloads", SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Status, Quality, and Attention: What's in a (Missing) Name? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Designing organizations for an information-rich world. Em M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). Unexpected Emails to Submit Your Work: Spam or Legitimate Offers? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, Abril 13). Anúncio do eLibrary Stats. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, Junho 5). What SSRN Means When We Talk About Data Integrity. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, Dezembro 16). 2025 Year in Review: How SSRN Enhanced Access to Preprints and Early-Stage Research. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, Abril 13). SSRN Strategic Update: Renewed Focus on Core Research Sharing Mission (autor do artigo: S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, Junho 4). SSRN's Ongoing Commitment to Legal Scholarship. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, Junho 12). SSRN to Sunset Rankings from Julho 1st 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, Julho 15). SSRN Ranking has sunsetted as of 15 Julho 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, Julho 20). SSRN will now allow you to choose the licence that's right for your work. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. Historical FAQ (cópia em PDF, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Página de Assinatura. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Measuring Research: What Everyone Needs to Know. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). A revisão pelos pares dupla-cega reduz vieses? Evidências de uma conferência de ciência da computação de destaque. JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (sobrenome do segundo autor conforme Crossref: "Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). Periódicos e editoras predatórios: características e impacto do spam acadêmico em pesquisadores das ciências educacionais. Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.): "SSRN e-Journal Rankings By Average Downloads Per Paper" (2018, May), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; "SSRN Has Not Jumped the Shark" (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). A IA pode detectar periódicos predatórios? O caso dos periódicos FT50. SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). Relatório Imperva Bad Bot 2025. https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, February 4). "Is a journal interested in your preprint? Separating the wheat from the chaff in journal solicitations to submit". https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). Análise de e-mails predatórios no início da carreira acadêmica e tentativas de prevenção. Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library. LibGuide "SSRN Metrics" (atualizado em 29 de set de 2025). https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ página p=9061269 em eJournals)
[162] van de Rijt, A., et al. (2014). Experimentos de campo da dinâmica sucesso-gera-sucesso. PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Center for Teaching / Office of Innovative Technologies) (2023). Orientação sobre detecção de IA e por que estamos desabilitando o detector de IA do Turnitin. Publicado em 16 de agosto de 2023. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (acessado em 15 de agosto de 2026).
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). O que é citado: GEO competitivo em mecanismos de resposta com IA. SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). Expandindo o Drake Journal of Agricultural Law: A Edição Verde. Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). Viés contra a novidade na ciência. Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, June). Os bots de IA estão derrubando o patrimônio cultural da internet? GLAM-E Lab (NYU Engelberg Center / University of Exeter). https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, May 3). Periódicos-e SSRN e downloads. https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). Ferramentas para melhorar distribuição, discussão e downloads… SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (publicado em U. Detroit Mercy Law Review)
[170] Wikipedia: "Social Science Research Network"; "List of academic journals by preprint policy"; "Preprint". https://en.wikipedia.org/wiki/Social_Science_Research_Network e páginas relacionadas.
[171] Willey, R., & Knapp, M. (2021). Como aumentar as citações de trabalhos jurídicos. Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). O impacto do SSRN nas citações de trabalhos jurídicos e como maximizá-lo. University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). A Maré das Métricas: Relatório da revisão independente do papel das métricas na avaliação e gestão da pesquisa. HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). Solicitações não solicitadas: identificação de características de e-mails não solicitados de periódicos potencialmente predatórios e o papel dos bibliotecários. Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016, September 21). "Which Legal Articles Generate the Most Attention on SSRN". https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). Os relatórios de downloads medem confiabilmente o uso de periódicos? College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). Usuários, narcisismo e controle — rastreando o impacto de publicações acadêmicas no século XXI. SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). Acessos a artigos: links para citações, efeitos de fim de semana e sazonalidade. Scientometrics (publicado em 23.07.2026). DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). Leitura no Mendeley como ferramenta de filtragem para identificar publicações altamente citadas. Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). Desigualdade de atenção em mídia social. arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). Quantificando a evolução do impacto científico individual. Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). Universalidade das distribuições de citações: em direção a uma medida objetiva do impacto científico. PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). O Acordo sobre Reforma da Avaliação de Pesquisa. Coalition for Advancing Research Assessment. https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). Aproveitando a Maré das Métricas: indicadores, infraestruturas e prioridades para avaliação responsável de pesquisa do Reino Unido. Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). Estatísticas de uso padronizadas e conformes com COUNTER para repositórios. https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024). Résumé for Research and Innovation (R4RI): orientação. https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton. A ferramenta de inteligência de políticas. https://www.overton.io
[188] CC-PLUS. Consórcios Colaborando em uma Plataforma para Estatísticas de Uso em Bibliotecas (coleta de código aberto SUSHI/COUNTER-5; financiado por IMLS, PALCI et al.). https://www.cc-plus.org/
[189] HELIOS Open. Iniciativa de Liderança em Educação Superior para Bolsa Aberta. https://www.heliosopen.org/
Fontes adicionais
Fontes adicionais citadas no texto como [B-n]: páginas de plataformas, fios de discussão em fóruns, postagens em blogs e outros materiais que apoiam pontos específicos no texto. As páginas de plataformas são instáveis e devem ser reverificadas em comparação com cópias arquivadas.
[B-1] Cabells Predatory Reports (serviço ativo de triagem de revistas predatórias); Beall's List (apenas arquivado; não atualizado desde janeiro de 2017).
[B-2] Caron, P. TaxProf Blog (2026, 25 de janeiro). "The SSRN Top Five New Tax Papers Ranking Is Broken". https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors (EJMR), fios de discussão sobre downloads e classificações de autores do SSRN (por exemplo, /topic/ssrn-downloads-and-views; /topic/top-10-of-authors-on-ssrn-by-downloads). Fórum anônimo; citado apenas como evidência de que tais discussões existem.
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, thread 1seeyq3 (6 abr 2026, "I've uploaded a working paper to SSRN… honest advice"); Reddit r/academia, thread 13w6zjw (31 mai 2023, "SSRN Approval Time is Absurd"). Existência confirmada por meio de arquivos de terceiros do Reddit.
[B-6] SSRN — texto padronizado de anúncios (por exemplo, https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/) e o anúncio de abril de 2018 (04132018ann002). Páginas de plataformas; verificar em comparação com cópias arquivadas. Cópia arquivada: https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/ (instantâneo 29 de dezembro de 2025; acessado em 15 de agosto de 2026).
[B-7] SSRN FAQ — controle de versão e ORCID. https://www.ssrn.com/index.cfm/en/faq/ (acessado em 2026; verificar em comparação com uma cópia arquivada).
[B-8] SSRN — página "SSRN has Sunset Rankings". https://www.ssrn.com/ssrn/rankings-sunset. Cópia arquivada: https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset (instantâneo 19 de julho de 2026; acessado em 15 de agosto de 2026).
[B-9] SSRN — páginas de classificações históricas em hq.ssrn.com / papers.ssrn.com/topten: Top 10,000 Papers (TRN_gID=10), Top 30,000 Authors (TRN_gID=7), Top 3,000 Law Authors, Top 350 U.S. Law Schools, Top 500 International Law Schools, Eigenfactor, Recent Top Papers (60 days), "Ranking Data Explained" (ranking_data_explain.cfm?id=6 / id=10). Páginas históricas; desde 15 de julho de 2026 estas URLs retornam respostas 403/placeholder — citar por meio de cópias arquivadas. Cópia arquivada da página Top 10,000 Papers: https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10 (instantâneo 14 de julho de 2026, o dia antes do encerramento; acessado em 15 de agosto de 2026).
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints (observação de um ano: 875 convites de 256 periódicos, 76% de listas de bloqueio). DOI 10.1080/10875301.2025.2550600; ResearchGate publication 384286174.
[B-11] Caron, P. TaxProf Blog (2026, 7 de junho). "SSRN Has Not Jumped the Shark". https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/ (resposta a Bainbridge [12]; acessado em setembro de 2026).
Correspondência: [email protected].↩︎
Como citar
Chernets, V. (2026). What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset [Pré-print]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}