Що означає 7 завантажень? Сліпота щодо метрик та холодний старт наукової уваги після припинення рейтингів SSRN
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- Опублікована версія: SSRN 7296358 · DOI 10.2139/ssrn.7296358
- Архівна копія, придатна для цитування та завантаження: 10.5281/zenodo.22166896 — концептуальний DOI, завжди розв'язується до останньої версії
- Повний текст як Markdown та PDF: GitHub
- Читаний HTML: https://polyhelper.ai/research/download-metrics/
Той самий текст розташований на чотирьох поверхнях, щоб його можна було отримати, коли одна з них недоступна. SSRN зберігає опублікову версію; цитуйте саме цю.
Що означає 7 завантажень?
Сліпота щодо метрик та холодний старт наукової уваги після припинення рейтингів SSRN
Тип рукопису: Критичний синтез, методологічна рамка та готова до передреєстрації емпірична порядок денна
Версія: вересень 2026
Автор: Vadym Chernets, PhD1
Афіліація: архітектор систем AI
Анотація
15 липня 2026 року Мережа соціально-наукових досліджень (SSRN) припинила свої публічні рейтинги, таблиці ранжування статей, авторів та установ, які довгий час постачали єдину широко доступну порівняльну рамку платформи, при цьому кількість завантажень та статистика цитувань залишилися на окремих статтях та профілях авторів (SSRN Blog, 15 липня 2026). Результатом стала асиметрична подія вимірювання: автори зберегли числа та втратили норму. Лічильники SSRN не стали безглуздими; вони стали нечитаними. Кожна кількість завантажень стала числом без шкали.
У цій статті стверджується, що питання «Що означає 7 завантажень?» є науково некоректно поставленим до тих пір, поки не буде вказаний референтний клас статті. Сирова кумулятивна кількість використань не може бути інтерпретована без урахування віку статті, галузі, когорти публікації, масштабу розповсюдження та попередньої видимості автора. Проблема найгостріша для нових статей та авторів низької видимості, чия рання увага формується менш науковим інтересом, ніж архітектурою платформи, розповсюдженням email-сповіщень, індексуванням пошуку, престижем автора та важкохвостою динамікою уваги. Ми називаємо цю умову холодним стартом наукової уваги. Вимога не нова: нормалізація кількостей за галуззю, віком та типом документа є давно встановленою практикою в бібліометриці цитувань, а паралельне питання щодо даних про використання вже було поставлено близько п'ятнадцяти років тому (Kurtz & Bollen, 2010). Бібліометричні показники цього типу припускають базу даних, у якій відомі галузь, вік та тип, а показник обчислюється від імені читача, тоді як платформа препринту дає своїм авторам голе число без референтного класу, без інструментів та (з липня 2026) без порівняльної рамки взагалі. Чого не вистачає, так це не методу, а його втілення: SSRN не надає інструмента, який застосовує його для автора.
Доступні докази показують, чому прості середні значення вводять в оману. В єдиному недавно опублікованому зовнішньому дослідженні великої вибірки мережі SSRN (2361 робочий документ з маркетингу) середнє значення завантажень становило 221,3, тоді як медіана дорівнювала 87, і середнє значення перевищувало навіть 75-й процентиль (206) (Jo & Li, 2026). Розподіли завантажень мають квазілогарифмічний характер із екстремальними верхніми хвостами, і в межах однієї дисциплінарної мережі середні завантаження різняться приблизно в восьмикратному розмірі в різних підгалузях (Whalen, 2018), тому середнє значення в масштабі платформи не описує ніякий конкретний документ; порівняння нового документа з ним — це калібрування за вигаданою агрегацією. На основі доступних даних про конверсію кількість, така як 7 завантажень із 40 переглядів анотацій, не вказує на невдачу. Це результат скринінгу з широким інтервалом навколо нього, і його потрібно читати через охоплення, конверсію, вік і галузь.
На основі цих доказів стаття будує концептуальну схему для метрик SSRN після рейтингів, яка розділяє експозицію, перегляд анотацій, завантаження повного тексту та подальше використання, і додає діагностику охоплення-конверсії, яка розрізняє невидимість від відхилення. Замість одного показника тщеславства вона пропонує Cold-Start Scholarly Attention Benchmark (CSAB) — багатовимірну альтернативу. Її супроводжує протокол досьє, за яким кожна повідомлена метрика містить своє джерело, часовий період, референцний клас і обмеження. Далі стаття визначає готову до передреєстрації програму для перебудови відсутної шкали: перспективну панель нових документів SSRN, спостережувану з дня 1 по день 180, квазіексперименти з використанням курованого розповсюдження сповіщень електронної пошти та самого закриття рейтингів, побудований спільнотою еталонний процентиль і аудит видимості препринтів у системах відповідей на основі ШІ. Основа доказів поєднує цитовані дослідження з непредставницьким архівним перехрестям Додатка E; стаття визначає, як можна перебудувати відсутний еталон, і чому жоден показник завантажень не повинен розповсюджуватися без його контексту на платформі, яка його не надає.
Ключові слова: підрахунок завантажень; метрики використання; нормалізація в галузі; оцінка досліджень; препринти; наукометрія; просування та забезпечення посади; юридичні науки; альтметрика; ефект Матфея; кумулятивна перевага; економіка уваги; перегляди анотацій; хижацькі журнали; оптимізація для генеративних систем.
Класифікація JEL: A14; D83; I23; O33; L86
Основні моменти
Необроблені підрахунки завантажень SSRN не мають стійкої інтерпретації без врахування віку документа, галузі, когорти публікацій, експозиції розповсюдження та попередньої видимості автора.
Закриття рейтингів 15 липня 2026 року усунуло єдину публічну порівняльну рамку платформи, тоді як усі лічильники збереглися: автори зберегли цифри і втратили норму.
У єдиній недавно опублікованій розповсюдженні великої вибірки завантаження мають сильний перекіс вправо, середнє 221,3 проти медіани 87: «середній» документ за конструкцією є нетиповим.
Розділення охоплення (переглядів анотацій) від конверсії (завантажень на перегляд) розрізняє невидимість від відхилення: різні діагнози, що вимагають різних дій.
Опубліковані якорі конверсії переглядів на завантаження групуються в смузі приблизно 11–19%, на якій 7 завантажень із 40 переглядів анотацій узгоджується зі значенням як результат скринінгу: що, на основі доступних доказів, не є ознакою невдачи.
Cold-Start Scholarly Attention Benchmark (CSAB) повідомляє про нормалізоване охоплення, продуктивність завантажень, конверсію, динаміку і подальшу валідацію замість одного показника тщеславства.
Наперед визначена, готова до передреєстрації програма (перспективна панель, два надзвичайно своєчасні квазіексперименти, створені самими реформами платформи, побудований спільнотою еталонний процентиль та аудит систем відповідей на основі ШІ, необхідний до того, як оптимізацію для генеративних систем можна розглядати як засновану на доказах) визначає, як перебудувати відсутну шкалу.
Область дослідження та дисципліна доказів
Ця стаття є критичним синтезом, поєднаним з методологічною схемою та емпіричною програмою, готовою до передреєстрації, і єдині нові дані, які вона повідомляє, — це непредставницькі архівні перехрестя Додатка E. Три класи доказів залишаються окремими на всьому протязі, і кожна цифра в статті супроводжується своїм класом:
1. Перевірені оцінки: опубліковані цифри, перевірені в порівнянні з їх первинним джерелом і наведені з їх рамкою вибірки та датою, або перевірені з заявленими застереженнями, де перевірка є частковою.
2. Історичні якорі: раніші вибірки та знеактивовані функції платформи, збережені тому, що вони розкривають структуру розповсюдження, а не тому, що вони залишаються каліброваними нормами для 2026.
3. Концептуальні та запропоновані результати: наперед визначені передбачення, шаблони еталонів та конструкції досліджень, явно позначені як такі й не містять синтетичних результатів.
Проблема інтерпретовності, аргумент референцного класу та розкладання охоплення–конверсії є аналітичними твердженнями, обґрунтованими наведеними вище доказами. Інфраструктура, яку пропонує стаття, пропонується як проект для спільноти, яку потрібно побудувати та оцінити, а не як встановлений рецепт: реєстр процентилів спільноти (Розділ 8.8), калькулятор для авторів і архітектура організації Розділу 8.10. Жодна діагностична претензія в статті не залежить від того, щоб будь-що з цього було прийнято.
У галузі, що щойно втратила свій найбільш використовуваний публічний еталон, рідким суспільним благом є повторюваний протокол, який будь-який автор будь-де може запустити, разом із синтезом, який визначає походження та вік існуючих цифр.
Випадок 40-переглядів-анотацій-і-7-завантажень повторюється в цьому методологічному синтезі, тому що він ілюструє питання, каталогізовані в Таблиці 1; висновки спираються на цитовані докази, а не на будь-яку окрему панель.
Три правила керують синтезом як таким. Одиниці нормалізуються до двох спільних знаменників, накопичене завантаження на документ та завантаження за дванадцять місяців на документ. Перехід виконується лише там, де джерело само повідомляє про необхідний коефіцієнт, і вихідна одиниця зберігається скрізь, де конверсія вимагала би припущень, яких джерела не підтримують. Кожне фактичне твердження має рівень верифікації (перевірено в порівнянні з первинним джерелом, перевірено з заявленими застереженнями, або перевірка очікується) записаний у стовпцях впевненості джерела таблиць. Коли джерела конфліктують, найбільш помітно щодо ефективної дати закриття, конфлікт вирішується на користь пізнішого офіційного джерела і позначається. Кожна оцінка зберігає свій рівень, дату та застереження про вік, де б вона не використовувалася повторно.
Одне правило керує включенням джерел: посилання зберігається, коли воно надає чіткий механізм, результат, факт платформи, попередження про вимірювання або прецедент дизайну; кількість цитувань не є метою. Публікування та прочитання – це різні досягнення; ця стаття присвячена другому й краху інструментів його вимірювання. Правдоподібна таблиця не є доказом, і в статті про числа без контексту це правило насамперед стосується самої статті.
1. Вступ
1.1 Сорок переглядів, сім завантажень
Розглянемо дослідника (на ранньому етапі кар'єри, можливо, без інституціональної приналежності, або просто новачка платформи), який завантажує ретельно підготовлену робочу роботу на SSRN і, через кілька тижнів, у серпні 2026, відкриває панель статистики статті. Панель показує «40 переглядів анотації» і «7 завантажень». На цьому етапі, без практичного розуміння статистики наукової уваги, автор не може визначити, чи означають ці цифри катастрофічне відхилення рецензентами, стандартну статистичну базу для спеціалізованого тексту, чи початок незвичайно сильної траєкторії. Автор запитує колег: «Це жахливо?» Ніхто не може сказати. Ні панель, ні наукова література, ні сама платформа не дають відповіді, і лічильник не має еталону для порівняння. Цю умову називають метричною сліпотою, нездатністю, стоячи перед своїми лічильниками, розрізнити невдачу від нормальної продуктивності від успіху. Термін вводиться тут як теоретична конструкція, а не виміряна величина. Дослідження 4 (розділ 8.6) надає конкретний показник (частка авторів, які повідомляють, що ніколи не зіставляли свій лічильник з будь-яким еталоном, разом з розподілом перших читань, які викликає низький лічильник), так що термін позначає явище, яке передзареєстроване опитування може оцінити.
Подібна сцена, розказана авторами на форумах спільноти і наведена тут як ілюстративний анекдот, є більш контрастною. Дослідник завантажує перший препринт і спостерігає, як панель залишається на нулі переглядів і нулі завантажень, в той час як протягом кількох днів вхідна скринька доставляє п'ять листів від журналів, які просять рукопис, всі вони хижацькі. Єдина відповідь, яку отримує новачок, надходить від хижацьких журналів. Розділ 7 розвиває цю асиметрію як набір чітких гіпотез, і Дослідження 3 (розділ 8.6) визначає, як це встановити в часі. Сцена є живим еквівалентом інформаційного вакууму: законна економіка уваги дає цьому автору лічильник без еталону для його розуміння, в той час як паразитична привносить лесть без читачів.
До літа 2026 року існувала приблизна відповідь. Публічні рейтинги SSRN (топові статті, топові автори та інституціональні таблиці рейтингів) дозволили авторові розташувати лічильник в межах видимого розподілу. 15 липня 2026 ці рейтинги були припинені [149]. Припинення послідувало за оголошенням від 12 червня 2026, яке обгрунтовувало рішення твердженням, що «дослідження повинні говорити самі за себе» [148], а також за попереднім стратегічним переорієнтуванням, оголошеним 13 квітня 2026, ресурсів платформи на її основну місію обміну дослідженнями [146]. Вилучення було асиметричним: лічильники завантажень за статтею і статистика цитувань «продовжуватимуть записуватися і відображатися на ваших окремих статтях та профілю автора» [149], в той час як розподіл, який надавав цим лічильникам масштаб, був видалений. Ситуація дослідника перед панеллю тим самим була узагальнена на всю базу користувачів платформи: більше ніж 1.9 мільйона авторів і 1.5 мільйона статей [49].
Ця стаття про цю ситуацію, і її теза складається з двох частин. Припинення рейтингів видалило контекст, а не дані. Лічильники за статтею пережили закат і все ще відображаються; порівняльна шкала, через яку ці лічильники можна було читати, пропала, саме тому метрики не читаються, але не є безсмисловними.
Друге полягає в тому, що питання, «що означають 7 завантажень?», є науково неправильно поставленим, доки не будуть визначені правильний знаменник і група порівняння. Надання цього знаменника, і засобів його використання, є завданням цієї статті.
1.2 Число без масштабу
Інтерпретаційна проблема виглядає простіше, ніж вона насправді є. Десять завантажень через сім днів і десять завантажень через дев'яносто днів — це однакові підрахунки, чиї значення майже напевно різняться, і вони відрізняються знову, якщо одна стаття містить ім'я міжнародно визнаного професора в дуже видимій установі, а інша — це дебют автора-новачка. Показники використання у науці, тим не менше, подаються саме в цій позбавленій контексту формі, тому кожне число неминуче стає тестом Роршаха: те саме «40 переглядів» викликає паніку в одного автора і байдужість в іншого, тому що немає спільної точки відліку.
Очікуване значення необробленого лічильника завантажень змінюється залежно від усього, що лічильник не показує: віку статті, її галузі, її когорти публікування та календарного середовища, фактичного розповсюдження та попередньої видимості її авторів. Кожна з цих залежностей емпірично задокументована. Середні завантаження за весь період існування статті відрізняються приблизно в вісім разів у всіх eJournals однієї дисциплінарної мережі, від близько 438 у корпоративному та цінних паперів праві до близько 53 у сільськогосподарському праві [168]. Активність доступу змінюється залежно від самого календаря, зменшується приблизно на 11% у вихідні дні і приблизно на 50% у літні місяці в даних доступу до журналів [178]. Позиція та розповсюдження мають значення незалежно від змісту: статті, які з'являються в найбільш видимій позиції списків оголошень arXiv, згодом отримали суттєво вищу читацькість та цитування, з медіанним приростом цитувань близько 83% в астрофізиці [72]. Ідеї, що походять від престижних установ, поширюються швидше та ширше, ніж порівнянні ідеї з менш престижних установ [111], закономірність, узгоджена з давніми свідченнями про статус та увагу [104][105][140][103]. На платформі SSRN конкретно додатковий ко-автор у топ-50 пов'язаний із вимірюваною премією в темпах завантажень [83]. Власна розповсюджувальна машинерія платформи також впливає на лічильник: автори вибирають до семи класифікацій, включення до кураторських оповіщень на основі тем не гарантується, а теми з великим обсягом можуть зазнавати затримок до 45 днів [53][57]. Ранній лічильник статті може відображати не більше ніж те, чи відбулося її відповідне розповсюдження.
Правила підрахунку платформи додають другий рівень, який автори рідко бачать. SSRN фільтрує свої лічильники, відкидаючи очевидну активність ботів і повторні завантаження однією й тією ж людиною [144][66][69]; без таких фільтрів підрахунки були б завищені «в п'ять чи більше разів» [18]. Перегляди та завантаження пов'язані приблизно стабільною конверсією, і Black and Caron повідомили в 2006 році, що «загалом три перегляди анотації на веб-сайті SSRN призводять до одного фактичного завантаження статті» [18]. Пізніші зразки розміщують конверсію приблизно між 11% та 19% переглядів анотацій [139][172], при цьому нещодавній маркетинговий зразок у середньому складав близько 24 завантажень на 100 переглядів [83]. Автор, який знає цю анатомію, вже може перевірити 40 переглядів та 7 завантажень заголовка (Розділ 5.2 проводить розрахунок, який потрапляє в зазначений діапазон як результат скринінгу з широким інтервалом), але нічого на платформі це не повідомляє.
Ніяка зовнішня шкала не заповнює цю прогалину, що робить це вимірювальним збоєм, а не простою незручністю. Для h-індексу [79] існує цілий жанр посібників «що таке хороший X» [118][128]. Для завантажень SSRN аудит Розділу 2.5 не знайшов аналога станом на серпень 2026 року в будь-якому громадському джерелі. Бібліометрична література повідомляє розподіли [85][139][168][83], але жодна з них не перекладає їх на норми для авторів. Окремі дослідники імпровізували кухонні еталони зі своїх портфелів [42], а бібліотечні посібники пояснюють, що таке лічильники, без вказування того, що вони означають [161][50]. Число, яке гуглить кожен автор, неможливо знайти.
1.3 На кону: кар'єри, тривога та стимул до завищення
Цей розрив важливий, оскільки цифри мають наслідки. Власна документація SSRN описує свої метрики як такі, що "автори використовують для цілей просування та забезпечення посад, а установи використовують для найму та рейтингування" [52]. Використання конкретне й задокументоване: видатний правничий учений повідомив про те, що був "розташований на 13-му місці серед 3000 правничих авторів за загальною кількістю завантажень всіх часів, що юридична школа враховувала при виборі просування та суміжних рішень" [12]; посібники зі подання робіт до юридичних журналів радять упомінати "завантаження на SSRN (якщо чимало)" та поява в топ-десятці в супровідних листах [95]; і установи видавали прес-релізи про свої позиції на SSRN до кількох тижнів перед закриттям [101]. На агрегованому рівні завантаження SSRN корелюють на рівні 0,84 із рейтингами, побудованими на основі цитування, сотні юридичних шкіл [77], асоціація на рівні установ, яка не спускається на рівень окремих статей чи авторів, — застереження щодо екологічного висновування розділу 6.2(iii). Те, що установи взагалі діють на основі таких показників, є проявом добре вивченої динаміки: публічні рейтинги є реактивними, переформатуючи поведінку саме тих акторів, яких вони мають на меті описати. Механізм був детально обґрунтований для рейтингів юридичних шкіл, де комменсурація та самозбувне пророцтво спонукали школи переорганізуватися навколо цього показника [58][132]. SSRN посилював цю валюту безпосередньо, періодично надсилаючи листи топ-30000 авторів (приблизно 8% з близько 360000 зареєстрованих авторів), щоб повідомити їх про те, що вони були "у топ 10%" [161]. "10%" — це частка зареєстрованих авторів (30000/360000 ≈ 8,3%), і проти повної бази зареєстрованих авторів, яка налічує понад 1,9 мільйона [49], ті ж 30000 ближче до 2%, отже, формулювання описує рейтингованих авторів, а не всіх учасників. Тим часом поради щодо кар'єри попереджають, що самостійно опубліковані метрики "ймовірно не будуть враховуватися для цілей просування та забезпечення посад у юридичних школах" [33], і ширша література з оцінювання задокументована і тим, наскільки глибоко оцінка на основі індикаторів проникає в процеси найму та забезпечення посад, і тим, наскільки часто вона розроблена погано [110][115][153]. Самі завантаження — це показники уваги, а не прямі показники якості: ранне використання передбачає пізніші цитування лише скромно (кореляції близько 0,4, пояснюючи приблизно 16% варіації в ранніх роботах [25], і 0,11–0,35 в пізніших оцінках [80]), і набори високо завантажених і високо цитованих статей істотно відрізняються [108]. Установи ставляться до цих цифр як до докази кар'єри, хоча вони не мають шкали й мають лише слабкий зв'язок з науковим впливом, що є постійним запрошенням до неправильної інтерпретації у двох симетричних напрямках: без шкали автор може передчасно припинити роботу над напрямком на основі неправильно прочитаного лічильника, або витратити рідкісний час та соціальний капітал на просування статті, чиї показники ніколи не були аномальними. Рейтинги, попри всі їх недоліки, точно інформували те постійно повторюване рішення про те, чи варто було продовжувати просування статті, і їх видалення залишило цей вибір без даних (питання, розглянуте в розділі 6.4).
На кону також емоційний аспект: те, що автори відчувають на інформаційній панелі, є своєрідною формою тривоги від метрик, і кількість завантажень спостерігають компульсивно. Дослідники в галузі наукометрії описали жанр інструментів самостеження видимості як "технології нарцисизму" ще в 2012 році [177], і визнання одного видатного правничого академіка того, що моніторинг його показників був для нього "як наркотик" (Bainbridge, 2007, як цитується в літературі про маніпулятивну поведінку на SSRN), став емблематичним [44]. Та ж програма дослідження експериментально встановила, що породжує тривога: автори самостійно завантажують свої власні статті, щоб завищити лічильники, і роблять це найбільш інтенсивно поблизу порогів видимості топ-десятки та в умовах несприятливого соціального порівняння з колегами [44]. Соціальні цикли зворотного зв'язку цього типу є загальною властивістю ринків уваги: ранні соціальні сигнали посилюють нерівність і непередбачуваність на культурних ринках [131], перші позитивні сигнали упереджують подальші оцінки [112], і успіх породжує успіх в польових експериментах [162]. Віхи, про які люди самі повідомляють на соціальних медіа, зміщені в бік успішних виконавців, загострюють порівняння для усіх, чиї панелі показують 7. Таким чином, відсутність публічного орієнтиру створює тривогу, підживлює неправильну інтерпретацію й стимулює штучне завищення, яке підриває метрику для всіх. Проблема полягає в вимірюванні раніше, ніж у продуктивності: метрика, яка одночасно видима, емоційно забарвлена, актуальна для кар'єри та непрозора, є справжньою невдачею інфраструктури вимірювання, а не особистою недосконалістю людини, яка дивиться на інформаційну панель.
1.4 Кого найбільше постраждало: вимір справедливості
Вартість нечитаних метрик розподіляється нерівномірно. Автори з розвинутою професійною мережею можуть неофіційно порівнювати; авторитетні автори переносять попередню видимість з роботи в роботу. Відсутність публічних норм найбільш тяжко позначається на дослідниках на початку кар'єри, незалежних та неафільованих учених, авторів вузьких підгалузей, авторів дисциплін, що історично не домінували на платформі, та авторів поза елітними установами. Ця невигідна позиція є структурною, а не лише інформаційною: механізм виявлення SSRN направляє увагу через серії інституційних робочих матеріалів та сповіщення про передплачені eJournal [57]. Неафільований дослідник може розмістити роботу, але не може розмістити її у широко відвідувану серію інституційних праць і повністю залежить від предметної класифікації для видимості [168][53]. Для такого автора канал інституційної видимості фактично закритий, тому тягар виявлення припадає непропорційно на пошукові та ШІ-шари. Машинна видимість, розглянута в Розділі 8, є питанням справедливості, а не лише технічним питанням. Сама належність до поля зміщує очікувані завантаження у кілька разів, перш ніж враховується будь-яке судження про якість [168]. Ефекти престижу діють у момент першої видимості, оскільки публічна сторінка SSRN відображає імена авторів та їхні афіліації поруч із заголовком і анотацією. Двійно сліпе рецензування діє інакше: видалення даних про авторів помітно знижує оцінки рецензентів для авторів з високим престижем (у одному дослідженні 5,027 поданих робіт ICLR із набагато менш визначеним впливом на рішення про прийняття) [154], а оцінки експериментально реагують на сигнали ідентичності [64]. На дні розподілу уваги явище є відсутністю, а не нерівністю: у даних altmetric медіанна соціальна увага до нефінансованих досліджень дорівнює нулю у всіх вивчених галузях у великій SDG-орієнтованій вибірці [41], а увага на суміжних відкритих платформах більш нерівна, ніж доходи в розвинених економіках, з коефіцієнтами Джіні вище 0,9 [180]. Для медіанного автора питання «чи 7 завантажень – це погано?» є спробою прочитати єдиний сигнал, який система повертає, у грі з структурно нерівними шансами, а не проявом тщеславства. Будь-яка схема інтерпретації, яка ігнорує цю асиметрію, систематично помилково діагностуватиме знедолених, інтерпретуючи невидимість як відхилення. Ця асиметрія також поширюється вперед: якщо виникаючий шар ШІ-відповідей успадкує упередження бренду та позиції, задокументовані для оптимізації комерційних генеративних двигунів [5][164], він відтворюватиме, а не усуватиме цю нерівність. Ця перспектива найбільш тяжко позначається на неафільованих дослідниках та авторах з Глобального Півдня, і це одна з причин, чому аудит машинної видимості Розділу 8.6 належить до порядку денного справедливості, а не до платформних дрібниць.
1.5 Задокументована вимога до інтерпретації
Вимога до шкали не є гіпотетичною. Вона є однією з найперсистентніших закономірностей у дискурсі наукової спільноти і передує припиненню принаймні на десятиліття. Таблиця 1 узагальнює повторювані кластери питань і занепокоєння авторів із найсильнішим задокументованим свідченням для кожного, небезпечне скорочення, яке запрошує кожен кластер (коротка відповідь, що виглядає корисною і є помилковою), та розділ цієї статті, який на неї відповідає.
Таблиця 1. Вимога до інтерпретації: задокументовані кластери болю спільноти (2005–2026)
| # | Кластер | Що запитують або повідомляють автори | Задокументоване свідчення (впевненість) | Небезпечне скорочення | Розглядається у |
|---|---|---|---|---|---|
| 1 | «Чи моє число нормальне?» — відсутня еталонна шкала | Чи є задана кількість завантажень хорошою, поганою або типовою для порівнюваної статті | Публічне питання "Importance of paper download statistics," Academia StackExchange, 2016 (назву та дату перевірено через офіційний API) [3]; запитання користувачів щодо розміщення на SSRN та його цінності [126]; повторювані потоки форумів, які запитують, скільки завантажень вважаються «хорошими» (існування потоку підтверджено; окремі відповіді неможливо незалежно перевірити, а матеріал форуму розглядається протягом як слабке свідчення попиту, а не як дані) [B-3]; запит автора-новачка щодо «чесної поради» щодо новоопублікованого робочого документа (Reddit, квітень 2026; існування перевірено через архіви третіх сторін) [B-5] | Універсальний поріг сирого підрахунку («N завантажень = добре») | Розділи 3, 5–6 |
| 2 | Плутанина механіки — перегляди та завантаження | Чому перегляди перевищують завантаження; чи означає низький коефіцієнт слабку анотацію | Історичне практичне правило 3:1 [18]; повідомлений діапазон конвертації 11–19% [139][172]; нещодавний вибірковий середній ≈24% [83]; керівництва бібліотеки документують невизначеність авторів щодо того, що включають лічильники [161] | Автоматичне твердження, що низький коефіцієнт означає, що анотація погана | Розділи 4–5 |
| 3 | Емоції та соціальне порівняння | Компульсивне перевірення; сором як при низьких, так і при високих числах | "Like crack to me" (Bainbridge, 2007, як наведено у [44]); експериментальне свідчення самозавантаження біля порогів топ-списку під час соціального порівняння [44] | Порівняння себе з загальносередньовідліковим середнім або видимими зірками | Розділи 1, 5 |
| 4 | Карієрні докази — що замінює рядок рейтингу в дозьє | Що цитувати в матеріалах про закріплення, просування та найму після припинення | Рейтинг завантажень «враховується в різних рішеннях про просування та пов'язаних рішеннях» [12]; імейли з повідомленням топ-10% [161]; поради щодо супровідного листа [95]; інституційні прес-релізи [101]; опис платформи щодо оціночного використання [52] | Цитування сирого кумулятивного числа без дати, джерела або знаменника | Розділ 6 (Таблиця 13) |
| 5 | Спам із запитами після розміщення | Невиклікані запрошення від журналів, які приходять незабаром після розміщення | "Everyday, I get at least two of these emails" (Reddit r/AskAcademia, 2023; перевірено через архів; автор публікував у журналі MDPI, а не на SSRN) [127]; збір адрес із робіт «наприклад, опублікованих на SSRN» [107]; аудити обсягу запитів [9][84][63]; систематичний огляд, який визначив 29 емпіричних досліджень академічного спаму [61] | Висновки про ідентичність або намір читачів з агрегованого лічильника | Розділ 7 |
| 6 | Довіра до лічильників — боти, маніпулювання, раптові падіння | Чи є числа реальними; чому падають лічильники | "SSRN does absolutely zero to validate their accuracy" (Goldman, 2005, що передує поточним фільтрам; пізніше оновлення записує, що SSRN дисконтує повторні завантаження з одного джерела) [66]; опубліковане SSRN фільтрування цілісності даних [144][66][69]; трафік ботів становить ~74% перегляди анотацій, але лише ~7% завантажень у ранніх даних RePEc [99]; великомасштабні операції фільтрування ботів на RePEc через 2025–2026 [129] | Трактування відображеного числа як точного підрахунку унікальних людських читачів | Розділи 4, 9 |
| 7 | Діагностика — «чому нульові завантаження?» | Що означає нуль або затримка в перші тижні | Невизначеність авторів після припинення, задокументована в потоках спільноти (існування підтверджено через архіви третіх сторін) [B-5]; сторінки підтримки платформи описують показники, але, станом на серпень 2026 року, не пропонують жодних орієнтацій для інтерпретації [52][50] (аудит пошуку, розділ 2.5) | Трактування попередньої нулю розповсюдження як відмови | Розділи 4–6 |
Примітка. Лише цитати, незалежно перевірені проти живого або архівованого джерела, наводяться слово в слово; весь інший матеріал спільноти перефразується й позначається за його статусом впевненості. Етика цитування постів користувачів, включаючи анонімізацію та обробку видаленого вмісту, розглядається у розділі 9.
Найсильніший кластер у таблиці 1 — це хронічне питання «чи моє число нормальне?», яке повторюється впродовж років, платформ та дисциплін. Навіть інсайдери платформи не пропонують еталонну шкалу в обмін, і сарказм, який часто відповідає на це у форумах спільноти, сигналізує, що ніхто, включаючи досвідчених користувачів, не володіє відсутньою шкалою [B-3]. Кластери також причинно пов'язані: відсутня еталонна шкала (кластер 1) створює емоційне навантаження (кластер 3), що створює стимул маніпулювання, задокументований у [44], що в свою чергу підриває довіру, досліджену у кластері 6. Відновлення інтерпретованості розглядає ланцюг у його основі. Структура спрямована не на збільшення завантажень, а на відновлення значення.
1.6 Що стверджує ця стаття: вісім позицій
Це позиції, які стаття обґрунтовує, кожна з них розглядається у зазначеному розділі.
1. Абсолютні показники не піддаються інтерпретації без референтного класу. Накопичена кількість завантажень не має стійкого значення без урахування віку роботи, галузі, когорти розміщення, каналу розповсюдження та попередньої видимості автора [83][168][178][53]. Це проблема референтного класу розділу 5, що робить запитання "чи 7 завантажень – це добре?" некоректно поставленим.
2. Низька охоплення та низька конверсія – це різні діагнози. Робота, яку зустрічають мало людей, становить інше завдання, ніж робота, яку багато хто переглядає, але мало хто завантажує, і вимагає іншої дії. Невидимість – це не відхилення змісту. Розділи 4–5 розвивають цю різницю в діагностику охоплення-конверсії (Таблиця 9), включаючи конфігурацію "прихованого інтересу", в якій сильна конверсія співіснує зі слабким охопленням.
3. Лічильники пережили; порівняльна шкала – ні. Асиметрія припинення (числа збережено, норми вилучено [149]) точно описує стан після припинення рейтингів і перетворює давно приховану проблему інтерпретабельності на невідкладну та універсальну (розділ 2).
4. Процентильний бенчмарк – це суспільне благо. Число, яке кожен автор шукає в гуглі і не знаходить, – це таблиця процентилів за дисципліною та віком роботи. Розділи 5 та 8 визначають, як спільнота може створити та підтримувати таку таблицю, тепер коли вона більше не може бути прочитана з платформи.
5. Калібровані норми потребують панелі, спостеріганої з моменту розміщення. Опубліковані докази складаються зі старіючих поперечних перерізів і окремих снімків [139][85][168][83]. Одне нещодавне велике дослідження явно визначає панельні дані як необхідний наступний крок [83]. Без спостереження з нульового дня, норми "першого тижня" та "першого місяця" є екстраполяціями і повинні позначатися як такі (розділ 8).
6. Багатовимірний бенчмарк переважає один показник тщеславства. Повідомлення нормалізованої охоплення, продуктивності завантажень, конверсії, імпульсу та подальшої валідації окремо (CSAB, Таблиця 10) зберігає діагностичну інформацію, яку знищує будь-який композитний індекс (розділ 5).
7. Рівень відповідей штучного інтелекту стає новим охоронцем уваги. Пошук мігрує вгору по стеку від бренду журналу до репозиторію до пошукового механізму до рушіїв ШІ-відповідей, які синтезують єдину відповідь і цитують кілька джерел [5][164]. Вже чверть дорослих у США щодня використовує ШІ чат-боти [121], тоді як надійність цих рушіїв як каналів цитування залишається оспорюваною [82] і жодне контрольоване дослідження видимості наукових препринтів у них ще не проводилося [100]. Розділ 8 викладає компактний протокол аудиту; повний аудит зарезервовано для супровідної роботи.
8. Протокол інформаційної панелі та досьє потрібен сьогодні. Автори та комітети не можуть чекати на нову інфраструктуру даних. Розділ 6 містить тимчасові правила читання інформаційної панелі та семикроковий протокол обґрунтування для досьє (Таблиця 13), основною вимогою якого є те, щоб кожне повідомлене число указувало своє джерело, часовий діапазон та обмеження.
1.7 Внески
Список нижче показує, що стаття додає до наявної літератури, у порядку, в якому розвиває її розділи.
1. Діагноз. Вона визначає проблему класу відсилань у метриках використання платформи і називає основне явище: холодний старт наукової уваги. Термін адаптований з літератури про рекомендаційні системи, де елемент cold-start не має історії взаємодій, необхідної для його розміщення [133]. У цьому холодному старті нові папери та нові автори входять у систему дифузії, в якій рання увага суттєво залежить від архітектури платформи, розповсюдження та попередньої репутації, перш ніж змістовна якість може здійснити свій повний вплив [72][111][140][83]. Центральний аргумент — це теза про некоректність постановки в розділі 1.1: на питання в заголовку немає відповіді, поки не надано його знаменник і групу порівняння.
2. Консолідована карта контрольних показників. Вона збирає, вперше з моменту закриття (аудит розділу 2.5, серпень 2026 р.), кожний перевірений емпіричний контрольний показник для завантажень SSRN та переглядів анотацій в одну таблицю (Таблиця 7), з явними рамками вибірки, віками, застереженнями щодо старіння та оцінкою впевненості джерела для кожного рядка. Контрольні показники — це велико-вибіркові докази розповсюдження [83], квазілогнормальні скрейпи топ-списків [85], зразки юридичної науки [139][168][171][172] та агрегати платформи [1][49].
3. Рамка воронки уваги з діагностикою. Вона розкладає дифузію на експозицію, перегляд анотацій, завантаження повного тексту та подальше використання. Потім вона виводить матрицю охоплення за конверсією (Таблиця 9), яка розділяє невидимість від відхилення і включає конфігурацію прихованої зацікавленості, яку сирі кількості систематично приховують.
4. Інструменти інтерпретації. Вона перетворює карту контрольних показників на градуйовану шкалу інтерпретації (Nascent / Modest / Solid / Strong / Exceptional; Таблиця 8), смугу конверсії з опрацьованими прикладами та Контрольний показник холодного старту наукової уваги (CSAB; Таблиця 10), багатовимірний формат звітування нормалізований за полем, віком, когортою та попередньою видимістю автора. Смуги шкали є порівняльними лише в межах однієї галузі та віку паперу, оскільки сама приналежність до галузі змінює очікувані завантаження в кілька разів, а кожна межа або має джерело, або явно позначена як авторська оцінка.
5. Практичний шар. Вона надає правила для читання власної панелі, діагностику для випадку нульового завантаження, таблицю дій на основі ситуації (Таблиця 23), гіпотетичну типологію сигналів хижацької розсилки зі застереженням, що спам розсилки не змінює лічильники і не підтверджує читання (Таблиця 14), та протокол із семи кроків (Таблиця 13).
6. Порядок денний дослідження, готовий до реєстрації. Вона визначає перспективну панель зі спостереженнями на 1, 3, 7, 14, 30, 60, 90 та 180 днів після публікації, та два квазі-експериментальні дизайни: курійовану розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену розповсюджену
1.8 Організація статті
Решта статті містить дев'ять додаткових розділів і п'ять додатків. Розділ 2 відтворює подію та її контекст: повну хронологію пакету реформ 2026 року, що залишилося і що було видалено (Таблиця 2, Рисунок 1), та заявлену платформою обґрунтування переспрямування ресурсів та переорієнтації. Розділ 3 представляє верифіковані докази розподілу та показує, чому середнє значення вводить в оману. Він охоплює розрив між середнім і медіаною [83], квазілогнормальний хвіст [85] та дисциплінарну гетерогенність [168] (Рисунки 2–4, Таблиці 3–5), на фоні теоретичного тла Matthew effect та cumulative advantage [104][105][131][162] (динаміка, яка була безпосередньо квантифікована в довгострокових кар'єрах та траєкторіях цитування [120]), та розрізнення між мірами уваги та мірами якості [25][80][108][178]. Розділ 4 розглядає механіку лічильників: фільтрування та цілісність даних [144][66], роботизований та фантомний трафік з необхідними контраргументами [99][106][129], архітектури платформи (Таблиця 6) та гігієну метаданих та версіонування. Розділ 5 викладає ядро інтерпретації: аргумент класу посилання, консолідовану карту еталонів (Таблиця 7), шкалу інтерпретації (Таблиця 8), смугу конверсії, матрицю охоплення за конверсією (Таблиця 9) та CSAB (Таблиця 10). Розділ 6 трансформує основу в практику для авторів та оцінювальних комітетів, включаючи протокол досьє (Таблиця 13) та, у Додатку A, ситуаційне керівництво (Таблиця 23). Розділ 7 аналізує паразитичний шар економіки уваги, хижацькі прохання розглядаються як гіпотетичні сигнали видимості, з усіма твердженнями про часові рамки та поширеність, викладеними як гіпотези [9][61][63][84][107]. Розділ 8 описує дослідницьку програму, готову до попередної реєстрації, включаючи компактне розглядання міграції уваги вгору стеком до шару AI-відповідей та його наслідків для виявляємості препринтів [5][100][82][121][164]. Розділ 9 деталізує обмеження, включаючи однієї-джерельний характер найкращих доступних доказів розподілу [83], застарівання зразків 2012–2015 років та нестабільність документації платформи. Розділ 10 завершується рекомендаціями політики для SSRN (передусім, анонімні процентильні смуги за дисципліною та віком статті як заміна, яка відновлює контекст без відродження конкуренції рейтингів) та для дослідницької спільноти.
2. Подія: Захід рейтингів та його контекст
2.1 Що являли собою рейтинги
Більшу частину своєї історії лічильники використання SSRN знаходились всередині щільного апарату порівнювання. На рівні статей платформа вела списки Top 10,000 за завантаженнями за дванадцять місяців та за весь час разом з переліками «нещодавніх найкращих статей» за журналами eJournal, обчисленими за ковзними вікнами тривалістю шістдесят днів. На рівні авторів вона вела список Top 30,000 у всіх дисциплінах та у дисциплінарних лігах, таких як Top 3,000 авторів права, які можна сортувати за новими завантаженнями, усіма завантаженнями, завантаженнями на статтю та цитуваннями. На рівні установ вона вела місячні таблиці ліг, включаючи Top 350 юридичних шкіл США та Top 500 міжнародних юридичних шкіл [B-9, історичні сторінки рейтингів; усі такі URL-адреси повертали помилку або сторінку-заповнювач з 15 липня 2026 року і можуть цитуватися лише з архівованих копій]. Платформа також перетворила рейтинг на прямий зворотний зв'язок у вигляді процентилей. Як задокументовано в посібнику бібліотеки University of Washington Gallagher Law Library щодо метрик SSRN, «SSRN періодично надсилає повідомлення до топ 30,000 авторів за новими завантаженнями та за всіма завантаженнями, щоб дати їм знати, що вони перебувають у топ 10%». Проти власної цифри посібника «понад 360,000 авторів» цей поріг відповідав приблизно топ 8% зареєстрованих авторів (30,000 з близько 360,000) [161, доступно 14 серпня 2026], широкий верхній шар, а не вузька еліта; розділ 1.3 зазначає, що проти повної зареєстрованої бази ті ж 30,000 сидять ближче до топ 2%. Ці списки та повідомлення були по суті єдиною інформацією про процентилі, яку надала платформа, звернену до авторів щодо завантажень SSRN, коли-небудь опублікованою.
Апарат порівнювання не був декоративним. Блек і Карон запропонували в 2006 році, що завантаження SSRN можуть служити «бета»-мірою наукової продуктивності викладачів права, доповнюючи опитування репутації та підрахунки цитувань [18]. Той же том симпозіуму містить критичне дослідження цієї пропозиції [45]. На інституційному рівні пропозиція вдалася: рейтинги завантажень увійшли в матеріали найму, файли просування та інституційну публічність. Власна документація SSRN описує свої метрики як цифри «які автори використовують для цілей просування та тенюре та які установи використовують у своїй діяльності з найму та складання рейтингів» [52, доступно 14 серпня 2026]. У посібнику з публікацій Legal Writing Institute радили авторам згадувати «завантаження SSRN (якщо багато), включення до списків Top Ten Downloads на SSRN» у супровідних листах до журналів права [95]. У червні 2026 Стівен Бейнбридж озвучив роль рейтингів у кар'єрі: він був «рангований 13-й серед 3,000 юристів за загальною кількістю завантажень за весь час, що юридична школа враховувала при різних рішеннях щодо просування та інших рішень» [12]. Керівництво SSRN задокументувало трансформацію платформою правового наукового спілкування в препринті свого тогочасного генерального директора [68]. Установи також маркетували ліги: ще в січні 2026 Maynooth University оголосив, що його School of Law and Criminology зайняв перше місце серед ірландських факультетів у SSRN Top 500 International Law Schools, посилаючись на понад 143,500 завантажень [101]. Вплив апарату на поведінку задокументовано в аналізі журналів серверів SSRN Едельманом і Ларкіном. Дослідження виявило, що обманливе самозавантаження посилювалось саме в той момент, коли стаття наближалась до межі списку топ-десяти, і виявило соціальне порівняння, а не лише ставки на кар'єру, як основний рушій маніпуляції [44]. Те ж дослідження поширило зауваження, приписане Бейнбриджу в 2007 році, що моніторинг своїх лічильників завантажень був «як крек для мене» [44].
Апарат мав другу функцію, яка привертала менше уваги. Цитування та опитування репутації мають багаторічні цикли; рейтинги повертали зворотний зв'язок в майже реальному часі, і вони дозволили ранньокар'єрним дослідникам та авторам поза престижними установами продемонструвати видимий вплив безпосередньо, без очікування більш повільних та консервативних інструментів контролю. Якими б не були їх недоліки, таблиці ліг були єдиним компаративним пристроєм однаково видимим для кожного автора на платформі. Це частина того, чому їх видалення, як стверджує розділ 1.4, ймовірно найбільше впливає на авторів, у яких найменше неформальних альтернатив. Прямих доказів розподільного впливу видалення ще не існує, тому це спрямована гіпотеза, яку перевіряє RQ1 (розділ 8.5): двостороння, вона запитує, чи видалення сконцентрувало чи розсіяло увагу без припущення щодо напрямку ефекту.
2.2 Хронологія Відступу 2026 року
Видалення рейтингів 15 липня 2026 року було кульмінацією серії рішень платформи, які розпочалися наприкінці 2025 року, узагальнених на рисунку 1.
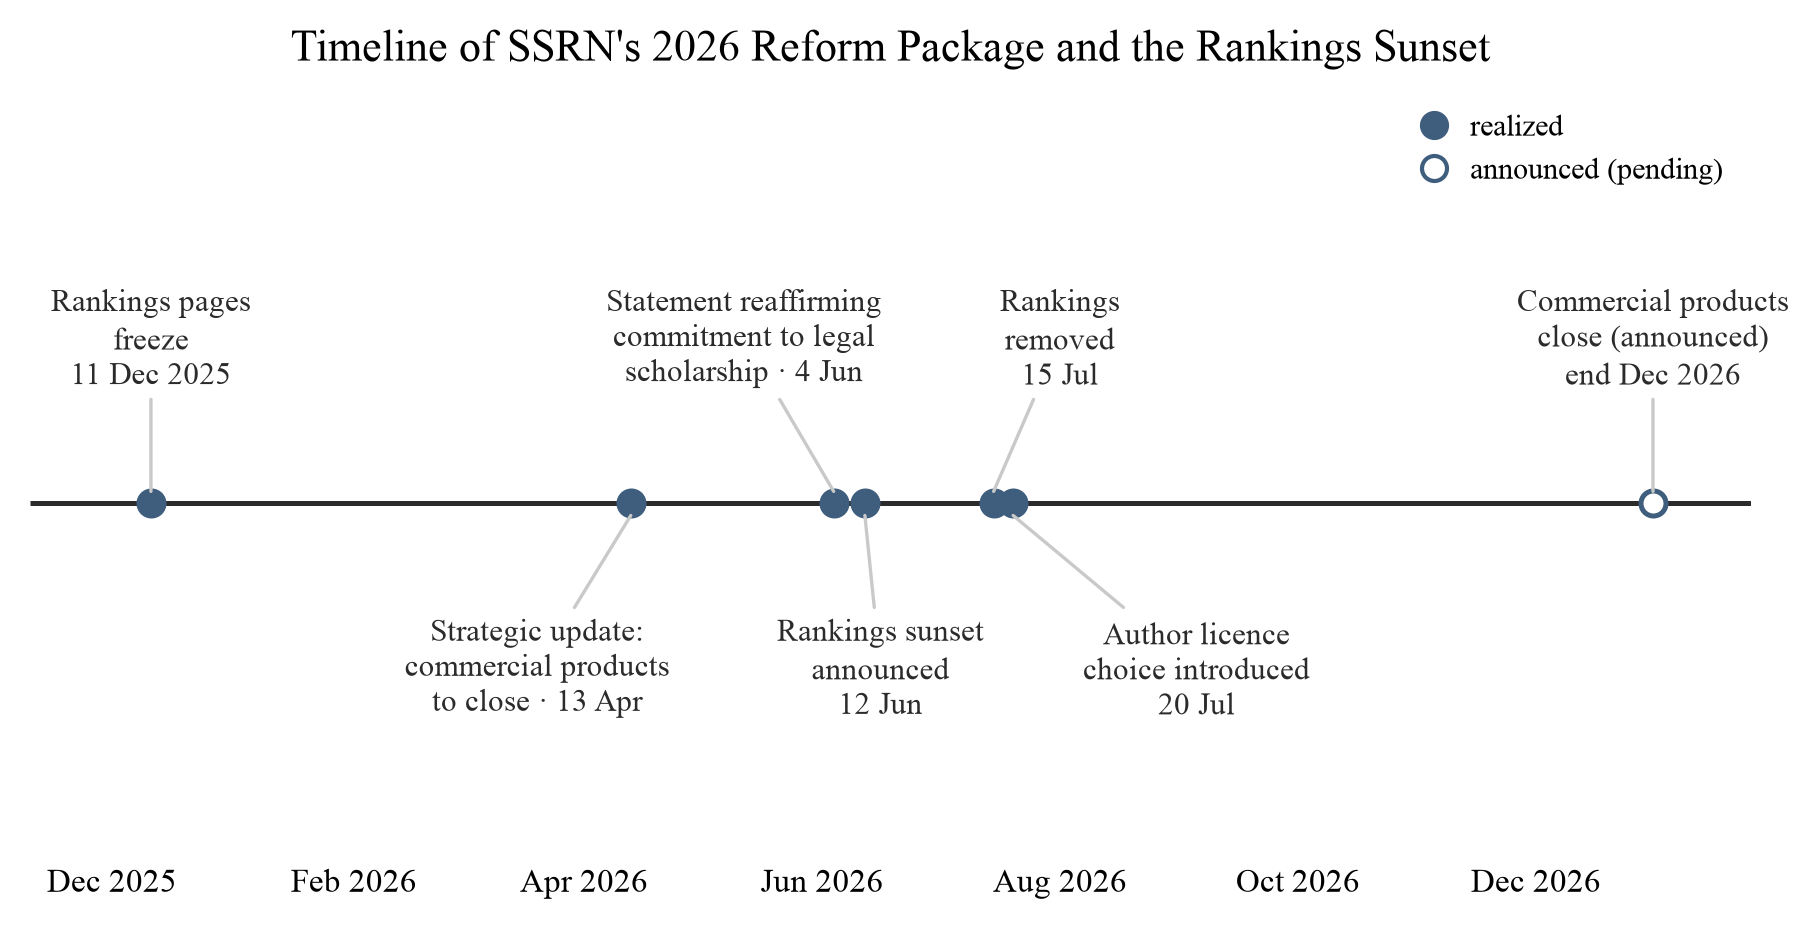
Рисунок 1. Шкала часу пакету реформ SSRN 2026 року. Події: заморозка сторінок рейтингу завантажень eJournal (з 11 грудня 2025 року, як задокументовано у дописі на TaxProf Blog від 25 січня 2026 року [B-2]); стратегічне оновлення, яким оголошувалось про закриття всіх комерційних продуктів до кінця 2026 року (13 квітня 2026 року) [146]; публічна заява, яка підтверджує зобов'язання SSRN перед правничою наукою (4 червня 2026 року) [147]; оголошення про те, що рейтинги будуть припинені "з 1 липня 2026 року" (12 червня 2026 року) [148]; фактичне видалення рейтингів (15 липня 2026 року) [149]; запровадження авторського вибору ліцензії (20 липня 2026 року) [150]; оголошене закриття решти комерційних продуктів (кінець грудня 2026 року) [146]. Джерела: [146][147][148][149][150][B-2].
Деградація почалася до будь-якого офіційного оголошення. 11 грудня 2025 року сторінки рейтингу завантажень за eJournal припинили оновлюватися. Paul Caron протягом понад двох десятиліть вів щотижневу рубрику "Top Five New Tax Papers", побудовану на основі цих рейтингів. У дописі від 25 січня 2026 року він задокументував, що податкові рейтинги були заморожені в період "12 жовтня 2025 – 11 грудня 2025" і написав, що "це може бути кінцем SSRN Top Five New Tax Papers" [B-2, цитується як переказ допису від 25 січня 2026 року, а не якогось оголошення SSRN].
13 квітня 2026 року SSRN опублікував "Стратегічне оновлення", яким оголошувалось про відновлену зосередженість на своїй "основній місії обміну дослідженнями" та закриття всіх комерційних продуктів (Research Paper Series, Sponsored Networks, Site Subscriptions, платні видання матеріалів конференцій, панелі аналітики, вакансії та оголошення та потоки даних) до кінця грудня 2026 року [146]. Спостерігачі з бібліотек зареєстрували зміну протягом кількох днів [34], а підрозділ Digital Commons компанії Elsevier опублікував настанови щодо міграції для установ, колекції Research Paper Series яких були виведені з обігу [47].
Це оголошення викликало громадську полеміку в правничій академії, у середовищі найбільш зацікавленому в інфраструктурі рейтингу. 3–4 червня 2026 року Bainbridge опублікував широко читаний критичний виступ під заголовком "The Social Science Research Network Has Jumped the Shark", за яким послідував допис, в якому вказано, що SSRN відповів на його скарги уточненнями щодо часу припинення серій документів та збереження eJournal за предметною спеціалізацією [12]. 4 червня 2026 року SSRN видав заяву про своє постійне зобов'язання перед правничою наукою, обіцяючи, що розповсюджування eJournal та сповіщення по електронній пошті будуть "продовжуватися без змін" [147]. 7 червня 2026 року Caron відповів Bainbridge на TaxProf Blog під заголовком "SSRN Has Not Jumped the Shark" [B-11]. Цей обмін є стислим громадським записом того, яку цінність спільнота надавала порівняльним функціям платформи напередодні їх видалення.
12 червня 2026 року SSRN оголосив, що припинить рейтинги з 1 липня 2026 року, заявляючи, що "у SSRN ми завжди вважали, що дослідження мають говорити самі за себе" [148]. Припинення вступило в силу двома тижнями пізніше, ніж спочатку оголошено: 15 липня 2026 року рейтинги документів, авторів та установ були видалені [149]. П'ять днів потому, 20 липня 2026 року, подальша реформа запровадила авторський вибір ліцензії [150]. Двотижневий розрив між оголошеними та фактичними датами та місячний період між оголошенням та виконанням сам по собі мають аналітичне значення: вони створили період очікування, протягом якого автори та установи могли спостерігати наближаючуюся зміну, момент, розглянутий у квазіекспериментальному дизайні розділу 8.
2.3 Офіційне обґрунтування та його еволюція
Офіційне обґрунтування припинення було розподілення ресурсів та переорієнтація платформи. Оголошення в липні пояснило, що рейтинги «потребують значних ресурсів на розроблення та розвиток продукту» та представило рішення як частину переорієнтації платформи на швидшу публікацію, кращу видимість та дослідницьку доброчесність. Також було зазначено, що «кількість завантажень та статистика цитувань продовжуватимуть записуватися та відображатися на ваших роботах та у профілі автора» [149]. Оголошення залишило відкритою можливість повернення порівняльних функцій: SSRN написав, що він «може переглянути ідею різних рейтингів» [149], тому вилучення не слід описувати як постійне. Мовчання в записі також має значення: оголошення не пов'язують рішення з ігрою в метрики, маніпуляцією чи конкурентним зловживанням рейтингами, та версії, які наводять такі мотиви, виходять за межами опублікованих текстів [148][149].
Тон офіційного пояснення еволюціонував між оголошенням та цільовою сторінкою, яка замінила URL-адреси рейтингів. Там, де пост червня говорив про ресурси, цільова сторінка заявляє, що «новий напрямок SSRN ставить окремих авторів та їхні роботи в центр усього, що ми робимо», та що «агреговані таблиці рейтингів установ та відділів більше не вписуються в цей образ» [B-8; сторінка має обмеження доступу, і ці фрази наводяться з копій індексу пошуку, тому будь-яку цитату повинна супроводжувати архівна копія]. Пост червня представляє припинення як рішення про витрати, а цільова сторінка як принципову переорієнтацію, яка повністю відходить від інституційного порівняння.
SSRN не залишив авторів цілком без офіційного вказівника контексту. Його документація підтримки щодо оцінки впливу роботи спрямовує авторів до лічильників на рівні роботи (перегляди анотацій та завантаження), доповнених PlumX Metrics, продуктом Elsevier з альтметрики, який агрегує цитування, використання та сигнали соціальних медіа [50, accessed 14 August 2026]. PlumX таким чином стає фактичною заміною платформи для контексту інтерпретації. Це часткова заміна: вона агрегує додаткові сигнали для окремої роботи, але не забезпечує розподіл, перцентиль або порівняння когорти. Це були елементи, які рейтинги, як би неідеально вони це не робили, забезпечували. Припинення не поширюється на інтеграцію SSRN з робочими процесами журналів: програма First Look продовжує з'єднувати платформу з більш ніж 1200 журналами Elsevier [48][145]. Комерційне управління платформи також розташовує ці рішення щодо продукту у межах високо зконцентрованого ринку наукових публікацій [94].
2.4 Що залишилось та що було видалено
Таблиця 2 відображає стан платформи після припинення роботи рейтингів разом з наслідками вимірювання кожного елемента: що означає кожна збережена, зникла або не повідомлена функція для будь-кого, хто намагається прочитати підрахунок. Видалення було асиметричним. Кожний лічильник для кожної статті та для кожного профілю збережувся. Порівняльний апарат, побудований на цих лічильниках, було повністю вилучено.
Таблиця 2. Що залишилось та що було видалено після припинення роботи рейтингів 15 липня 2026 року з наслідками для вимірювання. Джерела: [147][149][161][B-8][B-9]; рядки механізму експозиції: [53][57][55][144][66][69].
| Функція | Статус після 15 липня 2026 р. | Джерельна основа | Наслідки для вимірювання |
|---|---|---|---|
| Кількість завантажень на статтю | Залишаються; відображаються на сторінках статей | Підтверджено дослівно в оголошенні про припинення [149] | Сирове використання залишається спостережуваним, але тепер не має власного класу посилання |
| Перегляди анотацій на статтю | Залишаються (не названі дослівно в оголошенні про припинення, яке перелічує «кількість завантажень та статистику цитування»; перегляди продовжують відображатися) | [149], спостереження платформи, доступне 14 серпня 2026 р. | Охоплення залишається спостережуваним, тому діагностика охоплення–конверсії для кожної статті (Таблиця 9) залишається обчислюваною |
| Статистика цитування (стаття та профіль автора) | Залишаються | Підтверджено дослівно [149] | Подальше використання все ще може доповнювати ранні показники привернення уваги |
| Профіль автора (статті, афіліації) | Залишається | Спостереження платформи, доступне 14 серпня 2026 р. | Агрегація на рівні портфеля залишається можливою з тим самим відсутнім знаменником |
| Підписки на eJournal та сповіщення електронної пошти | Залишаються | «Продовжуються без змін», заява від 4 червня 2026 р. [147] | Канал розсилання залишається, тому ранні лічильники залишаються залежними від архітектури (Розділ 4.4) |
| Класифікація тем (1–7, вибрані автором) | Залишаються; керують маршрутизацією eJournal | Документація платформи [53] | Класифікація є потенційно суттєвою змінною експозиції |
| Кураторське розповсюджування eJournal | Продовжується; включення «кураторське та цільове, не гарантоване» | [53][57][147] | Статус розповсюджування та дата повинні розглядатися як чинник, а не як фон |
| Затримка розповсюджування в темах з великим обсягом | Продовжується; до 45 днів | [53] | Підрахунки за перший місяць можуть змішувати режими до та після розповсюджування |
| Зовнішнє індексування (Google, Google Scholar) | Продовжується з часом, контрольованим пошуковою системою («6–9 місяців або довше») | [55] | Процес цензурованої за інтервалами експозиції: дата експозиції обмежена, не спостерігається |
| Фільтрування підозрілої активності | Продовжується | [144][66][69] | Підрахунки є відфільтрованими подіями, а не перевіреними читаннями або схвалюванням |
| Отримання статей у відповідях ШІ | Не повідомляється SSRN | Платформою не повідомляється; Розділ 8.6 | Видимість для машин вимагає незалежного, повторного аудиту (Дослідження 2) |
| Метрики PlumX на сторінках статей | Залишаються; офіційний вказівник для оцінки впливу | Документація підтримки [50] | Додаткові сигнали для кожної статті, але без розповсюджування, процентиля або порівняння когорти (Розділ 2.3) |
| Списки найкращих статей (Топ 10 000; за eJournal для недавніх/всіх часів) | Видалено; URL-адреси повертають помилку або цільову сторінку припинення | [149][B-8][B-9] | Основна порівняльна рамка — і можлива поверхня виявлення — зникла |
| Списки найкращих авторів (Топ 30 000; дисциплінарні ліги) | Видалено | [149][B-9] | Позиція процентиля на рівні автора більше не спостерігається публічно |
| Ліги на рівні установи (Топ 350 США / Топ 500 міжнародних юридичних шкіл тощо) | Видалено | [149][B-8][B-9] | Порівняння установ більше не можна обчислити на основі даних платформи |
| Публічне фреймування за процентилем (ранг автора, позиціонування «топ 10%») | Видалено разом з інфраструктурою рейтингів | [149][161] | Клас посилання тепер необхідно перебудувати зовні (Розділи 5, 8) |
| Повідомлення на електронну пошту «Топ 10% авторів» | Доля не розглянута в офіційних повідомленнях; повідомлення були пов'язані з інфраструктурою рейтингів | [161][149] | Сигнал процентиля для досьє більше не може бути припущено як такий, що буде отримано |
Збережені рядки в Таблиці 2 - це саме сирові лічильники та машинерія експозиції, яка їх живить: платформа продовжує виробляти числа з такою ж швидкістю, як і раніше. Видалені рядки - це саме набір порівняльних рамок: розподіли, пороги, рейтинги та повідомлення про квантилі. Тому подія має точну інформаційну структуру (дані збережені, референтний клас вилучений), і ця структура перетворює давню прихову проблему - як читати номер SSRN - на гостру та універсальну. Ми називаємо властивість платформи, яка змінилася, непрозорістю еталону: властивість платформи, що описує, чи вона публікує розподільчу статистику, необхідну для локалізації окремого підрахунку (квантилі, медіани, розподіли когорт), чи тільки сирові лічильники, середні значення та топ-N списки. 15 липня 2026 року SSRN перейшла одним кроком від часткової прозорості до майже повної непрозорості еталону, і решту статті можна розглядати як дослідження того, яку ціну така властивість коштує її користувачам. Непрозорість, так визначена, має щонайменше чотири виміри: охоплення населення (що описує опублікована статистика), деталізація референтного класу (чи вони залежать від поля, віку та когорти), часова стабільність (чи залишаються визначення та вікна порівняними з часом) та можливість аудиту (чи правила підрахунку досить публічні для перевірки). Ці чотири виміри працюють відчасти незалежно: рейтинги можуть зменшити одну форму непрозорості, збільшуючи іншу, якщо їх знаменники та правила вибору не ясні. Ця часткова незалежність - це причина того, чому рекомендації платформи з Розділу 10.4 (пункти 4 і 8) стосуються самого розкриття, а не тільки повернення порівняльних чисел. Щоб зробити властивість вимірюваною, кожен вимір оцінюється за явним порядковим контрольним списком, застосованим до публічного інтерфейсу та документації платформи: охоплення населення (0 = тільки сирові підрахунки, 1 = опублікована зведена статистика платформи, 2 = розподільча статистика для визначених популяцій); деталізація референтного класу (0 = немає, 1 = одна вісь, наприклад поле, 2 = спільна залежність від поля × віку × когорти); часова стабільність (0 = визначення підрахунку та вікна недокументовані або мовчазно переглянуті, 1 = задокументовані, 2 = задокументовані та версіоновані); та можливість аудиту (0 = правила підрахунку не опубліковані, 1 = описані прозою, 2 = опубліковані в деталях для перевірки). Профіль непрозорості платформи - це тоді четвірка оцінок, а не один ярлик. Той же інструмент оцінює SSRN до та після заходу (рухаючи її вниз за охопленням, деталізацією та, для видалених списків, деталізацією референтного класу), і дозволяє виразити порівняння між платформами з Таблиці 6 як оцінки, а не враження. Платформа може відображати багато чисел і залишатися майже повністю непрозорою. Рубрика - це перша операціоналізація, яка буде вдосконалена та перехресно перевірена оцінювачами, а не завершений індекс.
2.5 Попит на інтерпретацію
Питання, яке припинення зробило невідкладним, ставили задовго до того. Таблиця 1 (Розділ 1.5) збирає документовані кластери попиту авторів на інтерпретацію, обмежені перевіреними джерелами. Матеріал форуму цитується там як докази попиту, а не розподілів, і цитати з постів користувачів відтворюються лише там, де сам пост був розташований (етика цитування напівпублічних постів форуму розглядається в Розділі 9).
Негативні твердження, що слідують далі, грунтуються на структурованому аудиті пошуку, а не на випадковому пошуку, як і паралельні твердження у Розділах 1.2, 1.5 (Таблиця 1) і 8.8. Протокол викладено тут один раз. Ми склали інвентарний перелік понад 25 формулювань запитів англійською мовою, організованих у шість кластерів інтенцій: нормативні («скільки завантажень SSRN вважається хорошим»), дефініційні («що включає лічильник завантажень SSRN»), навігаційні після припинення («рейтинги SSRN зникли — де порівнювати»), оцінювальні («завантаження SSRN як докази стажу»), діагностичні («чому паперу SSRN нульові завантаження»), і практичні («як збільшити завантаження SSRN»). Для кожного запиту ми записали, хто його наразі відповідає і наскільки добре, критерієм було те, чи пропонує будь-яке повернене джерело поступові, обумовлені полем значення орієнтирів, а не опис метрики чи анекдот. Як позитивний контроль, ми провели аналогічні запити для h-індексу, оцінки ResearchGate та кількості цитувань, які надійно виявляють жанр порогових рекомендацій, задокументований у [118][128]. Ті самі формулювання інтенцій для завантажень SSRN не дали еквівалента ні до, ні після припинення. Розрив поширюється на найбільш консультовані спільнотні посилання: енциклопедійні огляди платформи описують, що являють собою лічильники, але не пропонують інтерпретаційних норм для них [170]. Аудит був проведений у липні–серпні 2026 року за допомогою спеціального конвеєру, що охоплює загальні пошукові системи та вживацькі системи відповідей на базі AI, автоматизуючи виконання запитів та оцінку якості відповідей. Повний список запитів доступний від автора. Результат є негативною знахідкою і стверджується лише як така: відсутність доказів станом на період аудиту, у мовах і системах, охоплених, а не докази того, що такий ресурс не може існувати.
Для сусідніх метрик інтерпретаційний попит, задокументований у Таблиці 1 (Розділ 1.5), давно задовольняється жанром для широкої аудиторії: «що таке хороший h-індекс» обслуговується десятками поступових, обумовлених полем порогових рекомендацій [118], а норми цитування на рівні дисципліни висвітлюються у широко читаних посібниках [128]. Для завантажень SSRN такого жанру немає. Гірше того, найкраще структурована рекомендація, яка існувала, сторінка бібліотеки юридичного факультету Вашингтонського університету, продовжувала після 15 липня 2026 року описувати рейтинги Top Authors та Top Papers в теперішньому часі, роблячи її частково оманливою саме тоді, коли попит досяг найвищої точки [156, доступ 14 серпня 2026 року]. Припинення не створило проблему інтерпретації; воно видалило єдину часткову відповідь, яку мала екосистема, у момент, коли інституціональна пам'ять про розподіли почала затухати.
3. Що показують дані: чому середнє значення оманливе
3.1 Що вимірюють лічильники та чого вони не вимірюють
Будь-яке використання залишившихся лічильників передбачає розуміння того, що вони вимірюють. Таблиця 3 узагальнює зміст вимірювання кожної метрики, її основні змішувачі та діагностичну роль, яку вона може законно відіграти.
Таблиця 3. Що вимірюють метрики SSRN — та чого вони не вимірюють.
| Метрика | Найбільш близька змістовна інтерпретація | Основні змішувачі | Відповідна діагностична роль |
|---|---|---|---|
| Переглядання сторінки анотації | Охоплення лендінг-сторінки матеріалу | Видимість у пошуку, розміщення на платформі, репутація автора, зовнішнього просування, назва, розмір галузі, час онлайн | Видимість / охоплення |
| Завантаження повного тексту | Намір перевірити або використовувати повний матеріал | Всі фактори, що впливають на переглядання, плюс якість та релевантність анотації та тертя при завантаженні | Залученість |
| Завантаження на переглядання анотації | Умовний перехід від видимості лендінг-сторінки до отримання повного тексту | Малі знаменники, повторна поведінка, неоднорідні джерела трафіку | Конверсія |
| Цитування | Спостережувана інтеграція в пізніші наукові документи | Норми цитування в галузі, затримка публікації, охоплення бази даних, самоцитування, вплив статусу | Подальше наукове використання |
| Сигнали Altmetric / PlumX | Ширша онлайн-залученість | Склад платформи та поведінка користувачів | Додаткові свідчення дифузії |
Зміст таблиці можна стиснути до контрастування двох рівнянь. Прочитання, яке панель приладів мовчко запрошує, - це Завантаження = Наукова якість. Обґрунтована репрезентація -
Спостережуване Завантаження = f(Q, E, R, C, T, P, ε),
де Q позначає ознаки, пов'язані з якістю дослідження або релевантністю, E видимість, R репутація, C характеристики комунікації, T час та вік, P механізми платформи, і ε ненаблюдаємі впливи. Вираз класифікує змішувачі; жодна функціональна форма або коефіцієнт не визначається. Класифікація точно викладає практичну складність: дослідник звичайно спостерігає лише ліву частину.
До таблиці поширюються дві граничні умови. Лічильники - це не необроблені журнали трафіку. SSRN фільтрує свої показники щонайменше з 2000-х років: платформа заявляє, що виключає явні повторні завантаження однією особою та явні завантаження роботами, використовуючи «ознаки неправильної діяльності», та анонімні завантаження під сумнівом виключаються з загального показника автора [144]. Black та Caron встановили, що без такої фільтрації лічильники були б завищені «у п'ять або більше разів» [18]. Підраховане завантаження записує подію залученості та нічого не говорить про схвалення. Лічильники вимірюють етапи процесу уваги. Жоден з них не вимірює наукову якість, і кожен ускладнений факторами видимості, що діють до оцінки змісту будь-яким читачем [44][72][144]. Ці обмеження визнавалися з самих ранніх бібліометричних аналізів даних про читачів [91]. Етапи також можуть розходитися один від одного через два гіпотетичні механізми: статті з політично релевантних тем можуть активно завантажуватися практиками, які їх читають, але не цитують, тоді як спеціалізовані статті можуть отримувати мало завантажень, але бути постійно цитованими невеликою експертною спільнотою, яка їх потребує. Будь-яка із цих схем розділяє видимість від подальшого використання, що є однією з причин того, що набори найбільш завантажених та найбільш цитованих статей лише частково перекриваються [108].
3.2 Платформні агрегати та фікція середнього значення
Єдиними релевантними для розподілу цифрами, які сама SSRN публікує, є загальні числа платформи, і перше, на що слід звернути увагу в цих даних, — це те, що відбувається при усередненні цих значень. Таблиця 4 збирає перевірену статистику платформи з датами, на які вона розраховується.
Таблиця 4. Перевірена статистика платформи SSRN з датами та статусом верифікації.
| Кількість | Значення | Дата | Джерело | Статус верифікації |
|---|---|---|---|---|
| Повнотекстові статті | 1,157,048 | 18 Dec 2023 | ALL-SIS Citation Methods White Paper [1] | Перевірено порівняно з опублікованим PDF |
| Анотації | 1,309,385 | 18 Dec 2023 | [1] | Перевірено |
| Автори | 1,479,875 | 18 Dec 2023 | [1] | Перевірено |
| Накопичені завантаження | 256,678,716 | 18 Dec 2023 | [1] | Перевірено |
| Завантаження за останні 12 місяців | 40,642,329 | 18 Dec 2023 | [1] | Перевірено |
| Повнотекстові статті (ранніша точка відліку) | 571,040 | 6 Jul 2016 | [1] | Перевірено |
| Завантаження за останні 12 місяців (ранніша точка) | 12,897,685 | 6 Jul 2016 | [1] | Перевірено |
| Препринти / статті; автори | "1.5+ million"; "1.9+ million" | 2026 product page | Документація продукту Elsevier SSRN [49], переглянуто 14 Aug 2026 | Перевірено (заокруглені маркетингові цифри) |
| Статті; автори; завантаження загалом; завантаження за 12 мес. | >1.7M; >2.4M; >344M; >54M | 1 Nov 2025 | SSRN announcement boilerplate [B-6] | Порядок величини підтверджено; точні значення (344.8M / 54.7M) вимагають архівних копій оголошення перед цитуванням |
| Похідне: середнє накопичене завантаження на повнотекстову статтю | ≈222 | Dec 2023 basis | Обчислено автором: 256,678,716 ÷ 1,157,048 [1] | Арифметика на основі перевірених цифр |
| Похідне: середнє завантаження на статтю на рік | ≈35 | Dec 2023 basis | Обчислено автором: 40,642,329 ÷ 1,157,048 [1] | Арифметика на основі перевірених цифр |
Останні два рядки обчислені автором і позначені як такі; SSRN не публікує усередні показники на статтю. Загальні показники платформи різняться залежно від джерела, дати та визначення (повний текст або всього статей), тому похідні за статтю беруться з узгоджених цифр повного тексту за грудень 2023 [1]; первинний шаблон листопада 2025 [B-6] утримується вище тільки як дані, доступні виключно в поєднанні з архівованими копіями (наприклад, через web.archive.org), оскільки оригінальні сторінки оголошень більше не можна безпосередньо отримати.
На основі узгоджених цифр грудня 2023 р. середня стаття SSRN отримала приблизно 222 завантаження протягом свого життя та приблизно 35 за минулий рік [1]. Це похідне число є найближчим до норми, яку автор може обчислити в масштабах платформи, але воно систематично вводить в оман, оскільки середнє значення є фікцією агрегування. Кожне емпіричне дослідження розподілу завантажень SSRN виявляє сильне правостороннє зміщення: середнє значення тягне далеко вище медіани довгим верхнім хвостом, тому «середня стаття» описує майже жодну реальну статтю. Решта цього розділу встановлює розмір та наслідки цієї розбіжності. Один додатковий агрегат важливий для калібрування. Щорічні завантаження на платформі зросли з приблизно 0,5 мільйона у 2000 році до приблизно 3 мільйонів у 2005 році [18], 12,9 мільйонів у 2016 році та 40,6 мільйонів до 2023 року [1]. Потік завантажень на статтю сам зріс: щорічні завантаження зросли приблизно в 3,15 рази з 2016 по 2023 рік, тоді як запас статей зріс приблизно в 2,03 рази [1], підняли потік на статтю приблизно на 55%. Старше дослідження, таким чином, недооцінює абсолютні показники, які порівнювана стаття заробила б сьогодні. Напрямок, на який вказує це зміщення, залежить від порівняння: фіксований старий поріг є нижньою межею сьогоднішніх показників, що робить його більш м'яким, а не консервативним, стандартом, коли його читають як абсолютну смугу рівня 2026 року. Зворотна маніпуляція однаково недопустима: старий поріг не можна «постарити» у норму 2026 року, помноживши його на зростання платформи, оскільки більший репозиторій одночасно змінює чисельник, знаменник, склад авторів, канали розповсюдження, фільтрування ботів та конкуренцію за увагу. Читання з урахуванням зміщення за період, яке використовується повсюдно, спирається на наведену вище агрегатну арифметику потоків та запасів, а не на будь-яке переміщення старих порогів. Власний щорічний огляд платформи підтверджує постійне зростання: у 2025 році опубліковано більше 250 000 нових статей (на 20% більше, ніж у 2024 році), з понад 53 мільйонами завантажень протягом року [145].
3.3 Середнє значення не є типовою статтею: Пряме свідчення
Найновіші опубліковані дані про розподіл для SSRN походять від Jo and Li, які аналізують 2,361 статтю з Marketing Research Network SSRN у єдиному поперечному зрізі, зібраному 15 August 2025 [83]. Таблиця 5 нижче повністю відтворює їхню описову статистику, а консолідована контрольна карта розділу 5 їх включає. Середня кількість завантажень становила 221.346 проти медіани 87: середнє значення приблизно в 2.54 рази перевищує медіану. 95-й процентиль, 726, більш ніж у восьмеро перевищує медіану. Середнє значення перевищує навіть 75-й процентиль (206), що ставить більше ніж три чверті статей у вибірці нижче «середньої статті». Дослідник, якому сказали, що середня стаття в цій мережі має приблизно 221 завантаження, висновував би, що стаття зі 100 завантаженнями суттєво нижче норми, хоча 100 перевищує опубліковану медіану на значну величину. Рисунок 2 безпосередньо відображає цю структуру.
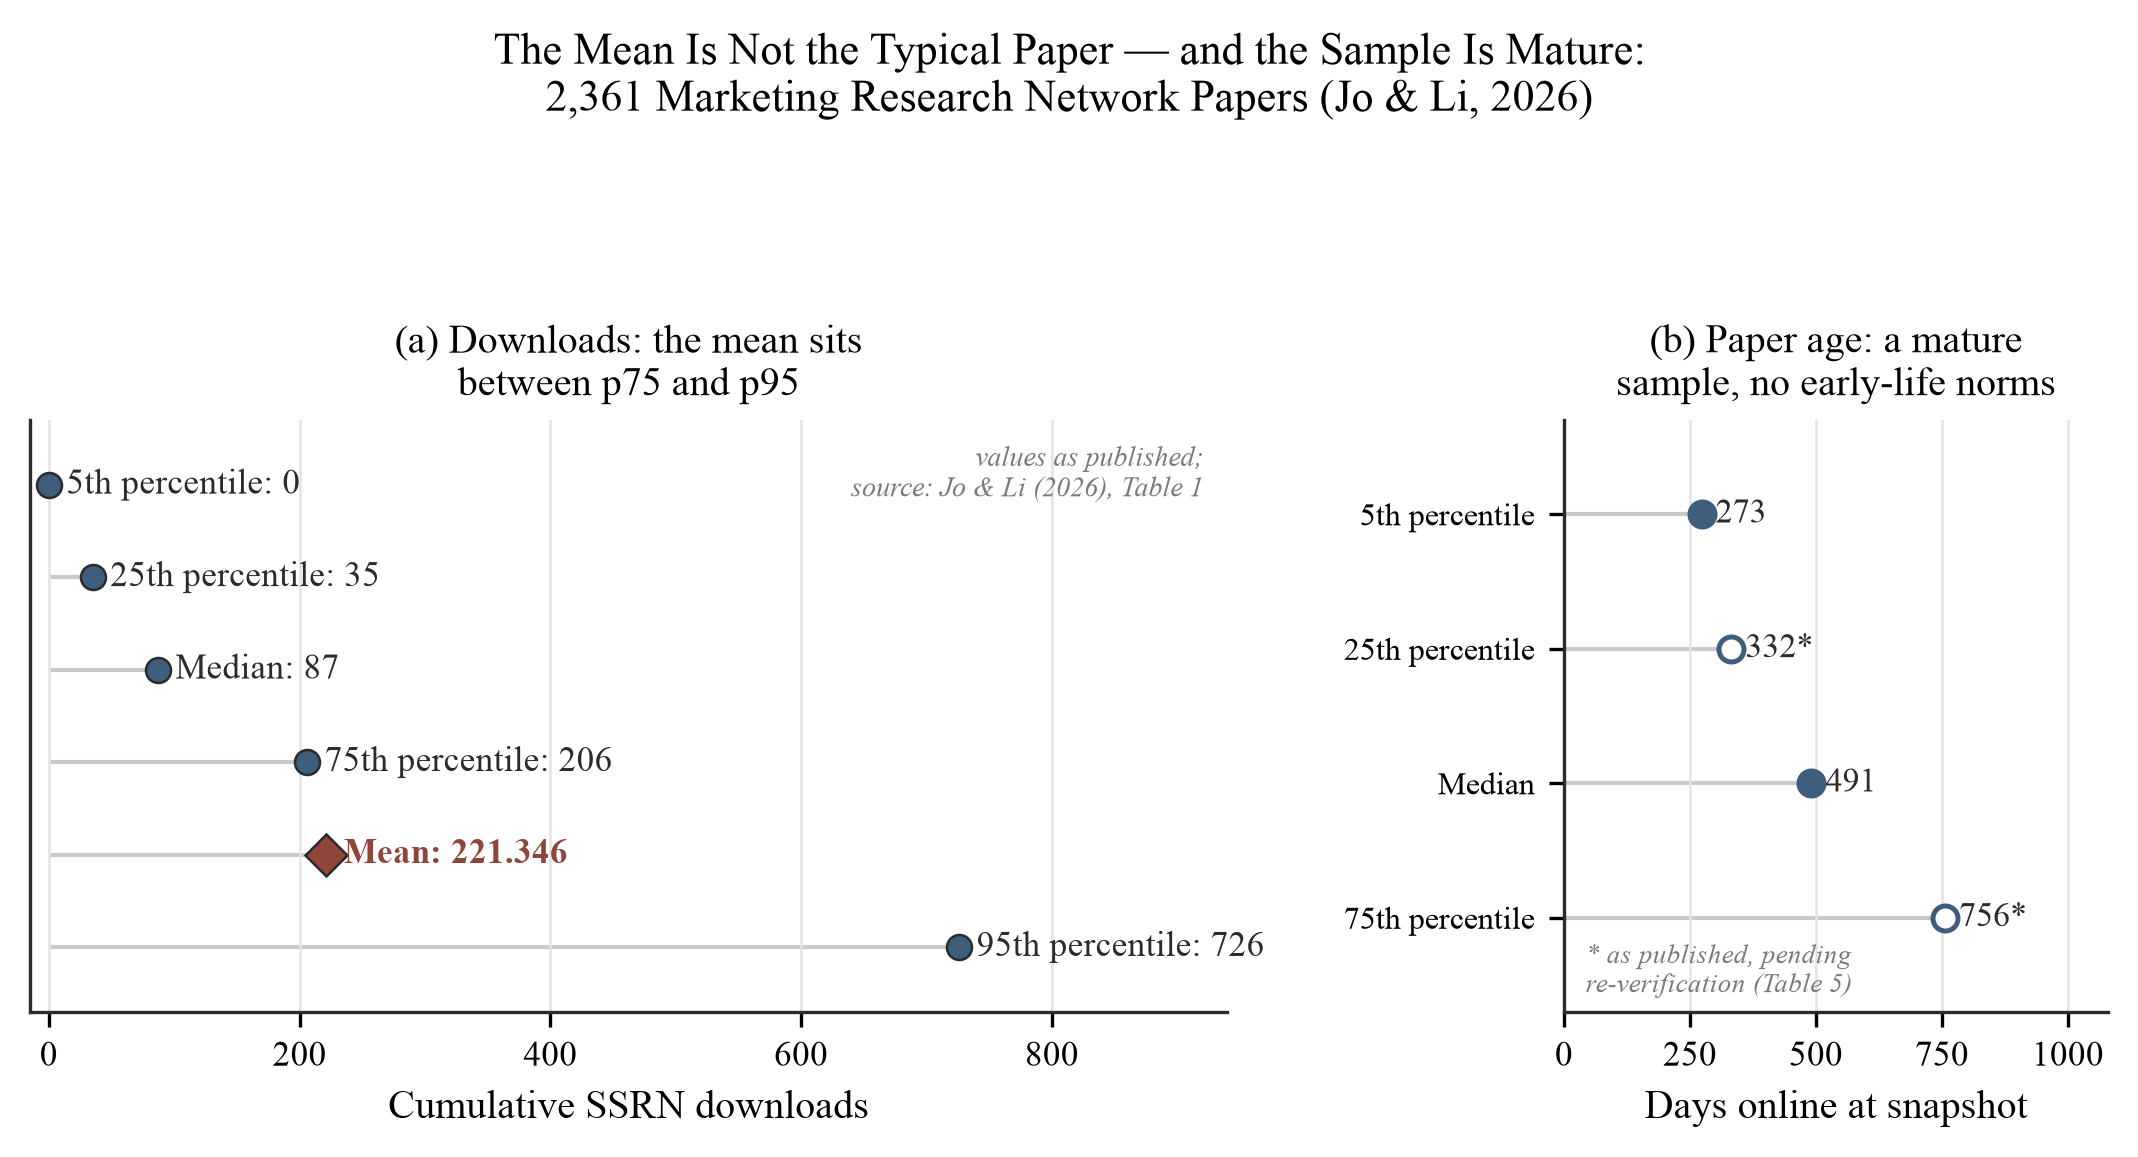
Рисунок 2. Опубліковані описові статистики для 2,361 статей Marketing Research Network. Панель (a): завантаження — p5 = 0, p25 = 35, медіана = 87, p75 = 206, середнє = 221.346, p95 = 726, побудовані в порядку значення (зауважте, що середнє значення падає між p75 і p95). Панель (b): вік статей у тій же вибірці — 5-й процентиль 273 дні та медіана 491 день перевірені за джерелом; 25-й (332 дні) та 75-й (756 днів) процентилі відтворені «як опубліковано» (Таблиця 5). Два значення у Таблиці 1 джерела позначені та відтворені «як опубліковано», але це аномалії різних видів. 95-й процентиль переглядів анотацій (966) знаходиться лише приблизно на 0.32 SD вище середнього (611.973; SD 1,100.5) — майже неможливо для асиметрично розподіленої кількості, чий p75 уже 833 — отже, це підозрювана помилка джерела, найімовірніше опечатка, хоча помилка транскрипції або округлення не може бути виключена, і інші клітинки рядка переглядів анотацій розглядаються як потенційно зачинені тією самою пов'язаною помилкою (позначено для запиту автора до Jo and Li, чия відповідь ще недоступна). 95-й процентиль конверсії (77.7, проти 27.2 при p75) є іншим явищем: артефакт співвідношення малої чисельності знаменника точно такого виду, що передбачає Section 5.2, а не статистична неможливість. Панель віку робить видимою інтерпретаційну межу: це статистика зрілих статей, і вибірка не може забезпечити норми ранньої стадії. Джерело: Jo and Li (2026), Table 1 [83].
Таблиця 5 відтворює повну описову статистику дослідження, його супутні змінні, а також розподіл завантажень, оскільки це єдина опублікована вибірка SSRN з повною панеллю процентилів; кілька її клітинок виконують інтерпретаційну роботу в іншому місці цієї статті. Стандартні відхилення описують важкий хвіст як один число: SD 940.9 проти середнього 221.3 для завантажень. 5-й процентиль завантажень дорівнює рівно нулю, тому значення нуль знаходиться в межах нормального діапазону навіть зрілої вибірки. Процентилі конверсії обмежують міжстатевий діапазон розділу 5.2 з обох сторін (p25 = 12.1, медіана = 18.9, p75 = 27.2 на 100 переглядів). Процентилі віку (інтерквартильна амплітуда 332–756 днів) встановлюють зрілість вибірки, а рядки авторства та упакування забезпечують норми коваріатів, на які посилаються розділи 6.4 та 8.3.
Таблиця 5. Повна опублікована описова статистика вибірки Jo and Li (2026), «як опубліковано» (N = 2,361 статей Marketing Research Network; снімок від 15 August 2025). Усі значення відтворені з Таблиці 1 джерела [83]. Ядро розподілу — середні та медіани завантажень і переглядів, квартилі; середня та медіана конверсії; медіана віку та 5-й процентиль — перевірено за опублікованою таблицею (див. Таблицю 7). Залишок клітинок (стандартні відхилення; процентилі конверсії та віку за межами ядра; рядки авторства, сторінок та довжини анотацій) відтворені «як опубліковано» і не були самостійно перерахунку тут; існування джерела, місцеперебування та авторство було підтверджено через Crossref 14 August 2026. Дві внутрішні аномалії зберігаються «як опубліковано» та позначаються, а не виправляються, і вони не одного й того ж виду проблеми. 95-й процентиль переглядів анотацій (966) знаходиться лише приблизно на 0.32 SD вище повідомленого середнього (611.973; SD 1,100.5) — статистично майже неможливо для такої асиметричної кількості і суперечить власному p75 рядка 833 — отже, це підозрювана опечатка в джерелі; залишок клітинок переглядів анотацій позначаються як потенційно зачинені пов'язаною помилкою і знижуються до повторної перевірки у разі запиту автора до Jo and Li. 95-й процентиль конверсії (77.704, проти 27.187 при p75) натомість є артефактом малої чисельності знаменника, передбачуваним Section 5.2, а не розподільчою аномалією того ж виду.
| Змінна | Середнє | SD | p5 | p25 | Медіана | p75 | p95 |
|---|---|---|---|---|---|---|---|
| Завантаження | 221.346 | 940.855 | 0 | 35 | 87 | 206 | 726 |
| Перегляди анотацій | 611.973 | 1,100.536 | 151 | 288 | 504 | 833 | 966 («як опубліковано») |
| Завантаження на 100 переглядів анотацій | 23.699 | 20.118 | 0 | 12.105 | 18.944 | 27.187 | 77.704 («як опубліковано») |
| Доступність на SSRN, дні | 550.210 | 230.557 | 273 | 332 | 491 | 756 | 955 |
| Кількість авторів | 2.578 | 1.705 | 1 | 1 | 2 | 3 | 5 |
| Кількість сторінок | 32.734 | 29.186 | 1 | 13 | 27 | 46 | 75 |
| Довжина анотацій, слова | 182.274 | 71.641 | 87 | 137 | 178 | 217 | 295 |
Три подальші ознаки дослідження мають значення для інтерпретації. Перегляди анотацій демонструють цю саму асиметрію на вищому рівні: середні перегляди становили 611.973 проти медіани 504 (p5 = 151, p25 = 288, p75 = 833; p95 966 відтворено «як опубліковано», але це підозрювана друкарська помилка в джерелі, лише ≈0.32 SD вище середнього і нижче хвоста, передбаченого p75 833, і не входить до жодного подальшого розрахунку; див. примітку до Figure 2), з опублікованою конверсією 23.699 завантажень на 100 переглядів [83]. Дослідження також розрізняє охоп від конверсії: у моделі експозиції Пуассона авторів інституційний престиж передбачав завантаження в залежності від переглядів анотацій (коефіцієнт 0.192, і для статті з трьома авторами один автор з афіліацією в топ-50 відповідав оцінюваному на 6.6% вищому показнику завантажень на перегляд анотації), і ця престижна премія послабла зі зростанням допомоги AI в анотаціях (взаємодія −0.627, p < .01) [83]. SSRN тепер вимагає розкриття матеріального використання генеративного AI при поданні [54][56]. Отже, увага відстежує сигнали статусу навіть після того, як читач потрапив на сторінку анотації, що є прямим доказом того, що кількість завантажень втілює видимість та репутаційні ефекти, а не лише оцінку змісту. Обмеження, яке самі автори визначають, встановлює порядок денний: один знімок однієї дисциплінарної мережі не може розкрити часові траєкторії уваги, і вони явно визначають панельні дані як необхідний наступний крок [83], крок, розглянутий у розділі 8.
Вибірка — це одна мережа в одній галузі, спостережувана в один момент: ці показники не є універсальними орієнтирами SSRN, і їх цінність полягає в структурі. Відношення середнього до медіани 2.54 та відношення p95 до медіани понад 8 є ознаками важкої правої асиметрії, що повторюються в кожному іншому масиві доказів SSRN, включаючи вибірку з іншої дисципліни й десятиліття: в єдиній вибірці у стилі перепису правничої науки, статті, розміщені на Legal Scholarship Network у 2012 році й вимірені два роки пізніше (n = 1,107), мали медіану 63 завантажень проти середнього 122.55, розрив майже в два рази після лише двох років експозиції [139].
3.4 Форма розподілу: квазілогнормальність і довгий хвіст
Крупномасштабну анатомію розподілу встановив Какушадзе, який аналізував публічні топ-списки SSRN: 29 985 авторів у списку Top 30,000 та 367 478 статей, прикріплених до них (добір рейтингів 2015 року) [85]. Центральний висновок полягає в тому, що завантаження мають квазілогнормальний розподіл, сильно асиметричні з довгим верхнім хвостом у лінійному масштабі й приблизно гауссові у логарифмічному масштабі (підібрані параметри для ln завантажень на статтю: середнє 5,406, стандартне відхилення 1,016) [85]. Какушадзе явно формулює практичний висновок з логнормальності: лінійна арифметика не працює на таких даних. Пряме застосування h-індексу до завантажень є неінформативним: кількість завантажень на порядки більша за кількість цитувань, тому індекс зводиться до кількості статей. Замість цього він пропонує індекс, побудований на цілій частині логарифма завантажень, k = ⌊ln D⌋ [85]. З точки зору інтерпретації це означає, що змістовні різниці у завантаженнях є мультиплікативними, а не адитивними. Така форма не властива тільки завантаженням: розподіл індивідуального наукового впливу сам по собі приблизно логнормальний, як це встановила Q-модель Синатри, Ванга, Девіля, Сонга та Барабаші (2016) на всіх наукових кар'єрах [181], тому мультиплікативне прочитання, яке вимагають лічильники, є нормою для наукової уваги, а не артефактом SSRN.
Той же набір даних надає єдині опубліковані орієнтири порога для верхнього розподілу. Включення у список Top 10,000 статей (приблизно 1,8% повного текстового архіву платформи, 571 040, липень 2016 [1], що відповідає, а не перевищує цифри «топ 1–2%», які іноді цитуються) вимагало мінімум 160 завантажень, медіани 805, середнього значення 1 800 та максимуму 152 242 [85]. Серед авторів Top 30,000 мінімальні загальні завантаження становили 129, медіана для автора становила 1 626, медіана завантажень на статтю становила 210, а максимум, Майкл С. Йенсен, становив 824 762 [85]. Нестача зберігається на рівні статей навіть у цій елітній вибірці: із 367 478 проаналізованих статей лише 112 793 (приблизно 30,7%) мали достатньо завантажень, щоб взагалі внести вклад у логарифмічний індекс своїх авторів [85]. Більшість окремих статей найбільш завантажених авторів платформи привертають скромну увагу, а поза топ-списками частка може бути тільки нижчою. Рисунок 3 візуалізує припасований розподіл з позначеними опублікованими порогами.
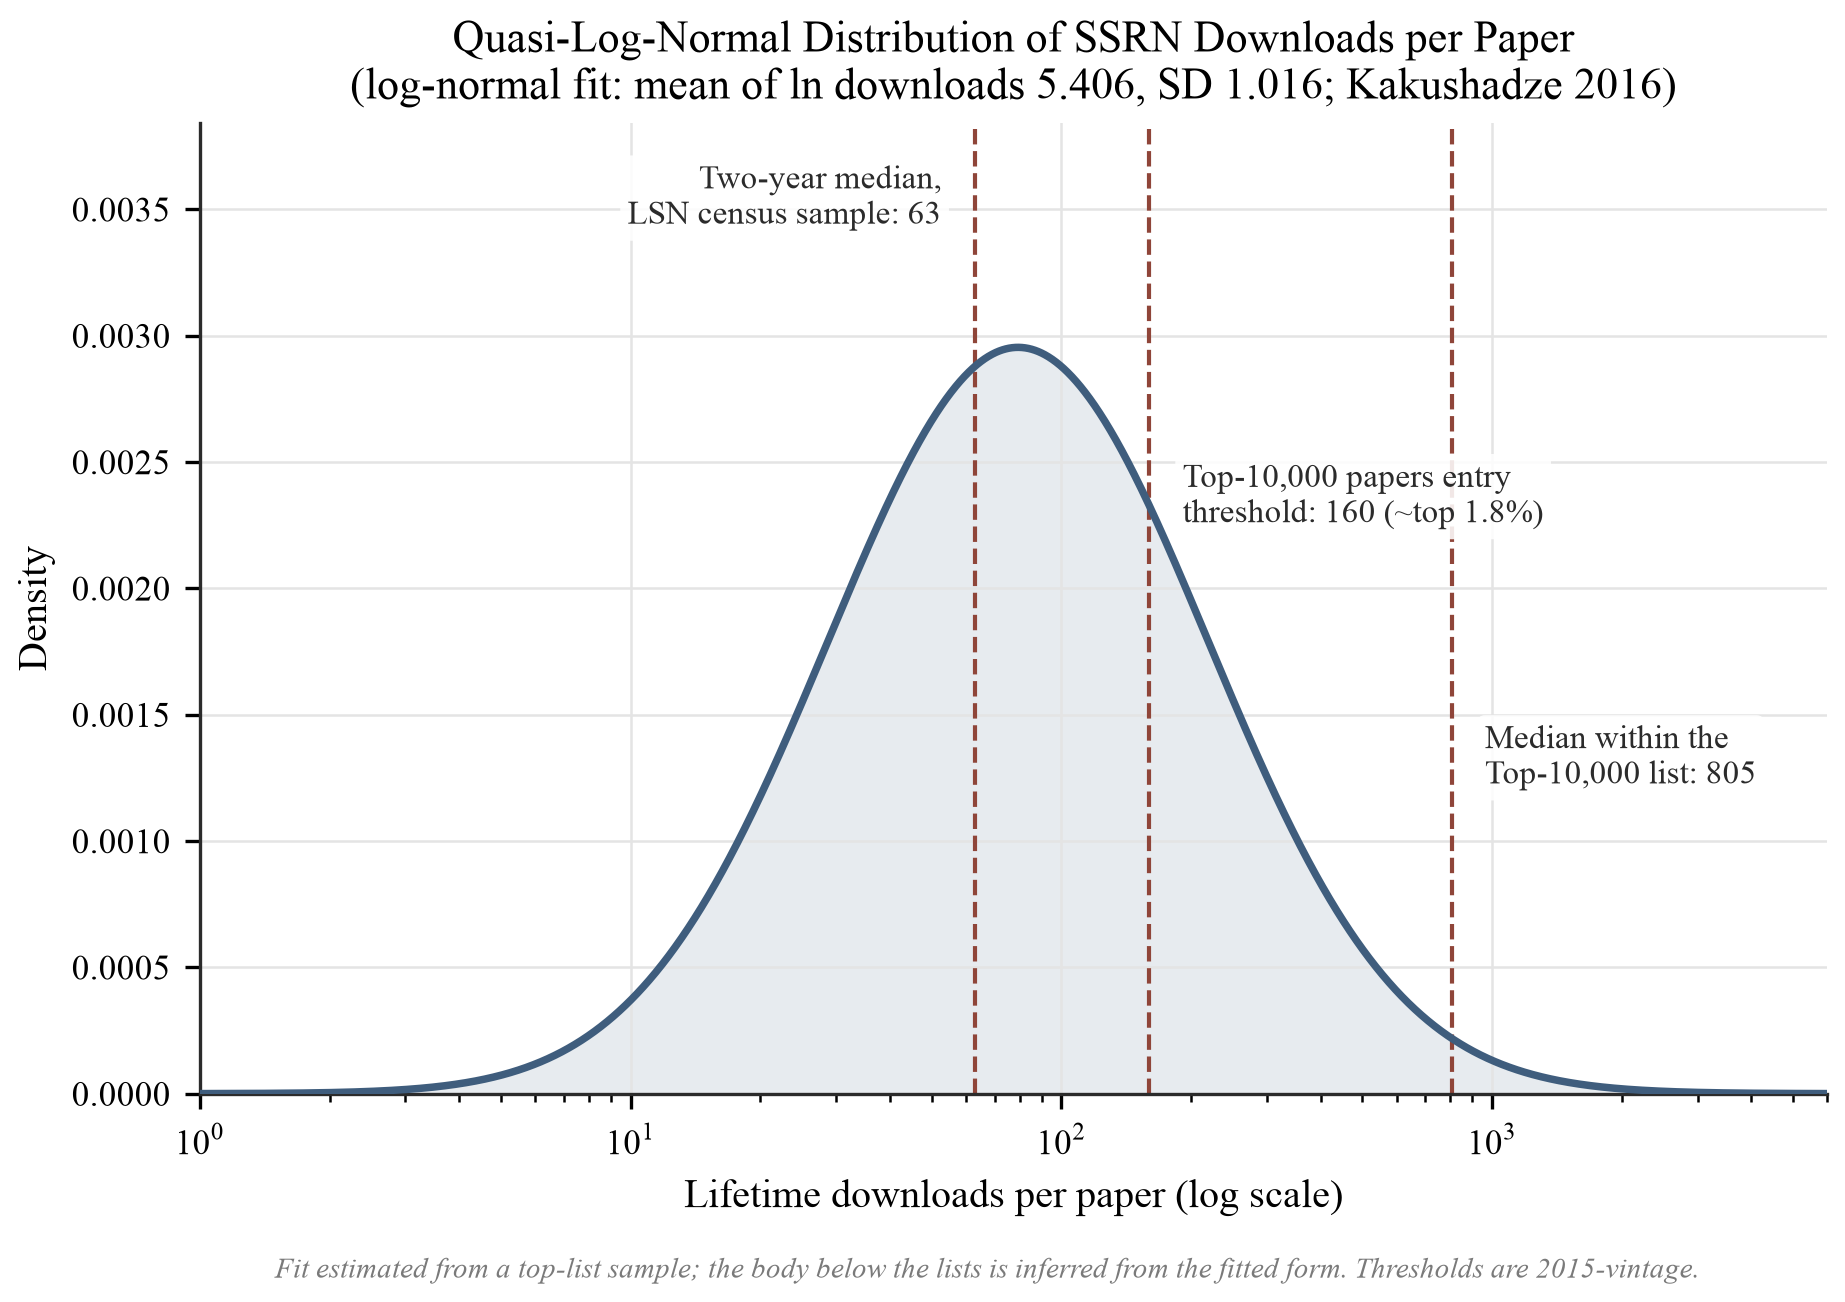
Рисунок 3. Логнормальна щільність, припасована з параметрами, повідомленими Какушадзе (середнє ln завантажень 5,406, SD 1,016) [85]; припасована медіана, exp(5.406) ≈ 223, розташована приблизно на 6% вище повідомленої внутрішньогрупової медіани на статтю 210, адекватний, але неповний збіг з розподілом топ-списків. Пунктирні лінії позначають двохрічну медіану 63 завантажень з переписної вибірки юридичних робіт [139], поріг входження в Top-10,000-papers у розмірі 160 (приблизно 1,8% повного текстового архіву платформи, 571 040 у липні 2016 [1]) та медіану у списку Top 10,000 (805) [85]. Припасування оцінюється на основі топ-списків — приблизно верхнього дециля авторів платформи — тому тіло розподілу нижче списків виводиться з припасованої форми, а не спостерігається; пороги датуються 2015 роком (інфляція з тих пір: розділ 5.1). Кількісне застереження належить до рисунка, оскільки крива запрошує до прочитання його нижнього хвоста: при цій припасованій щільності передбачені маси нижнього хвоста становлять P(X ≤ 63) ≈ 10,7% та P(X ≤ 10) ≈ 0,1% — на два-три порядки нижче від 15–30% частки ≤10-завантажень, яку дослідження 1 (розділ 8.6) передбачає для вибірки ймовірностей усієї платформи. Розбіжність не є суперечністю, а прямою мірою домену припасування: щільність, оцінена на верхньому децилі авторів, не може описати нижній хвіст, який вона ніколи не спостерігала, тому переписні орієнтири ([139]'s двохрічна медіана 63; входження Top-10,000 у розмірі 160 та його медіана 805) наносяться як зовнішні опорні точки, розташовані на припасованій кривій, а не як твердження, що припасування їх відтворює. Відстань між орієнтирами та місцем, де припасована крива розташовує ті самі значення, сама по собі є візуальним свідченням того, що тіло нижче списків не спостерігалося, і жодна частка нижнього хвоста всієї платформи не повинна читатися з цієї кривої.
Ці орієнтири потребують двох застережень. Рамка вибірки становить верхівку розподілу, тому статистика Какушадзе описує хвіст, а маса звичайних статей нижче списків характеризується тільки через припасовану логнормальну форму. Авторство належить одному авторові: дослідження — це праця Какушадзе (2016), Journal of Informetrics [85]; повторне неправильне цитування додає другого автора й повинно бути уникнене.
Незалежний архівний поперечний розріз, повідомлений в Додатку E, спостерігає тіло розподілу безпосередньо на випадковій міжгалузевій вибірці 1 360 статей, чиї попередні лічильники відновлено з публічних архівів. Він виявляє спостережуваний розподіл приблизно логнормальним (асиметрія log-завантажень ≈ 0,18), що підтверджує на тілі форму, яку Какушадзе міг припасувати тільки на хвосту, й незалежно відтворює розрив між середнім та медіаною, смугу конверсії та множник поля. Його власна упередженість вибірки в бік зростання залишає екстремальний нижній хвіст недостатньо спостереженим. Тим не менше, він відтворює єдиний сучасний якір для цілого розподілу, на який синтез інакше спирається: середнє реконструкції (219) співпадає з опублікованим маркетинговим середнім мережи 221, тому основна форма підтверджується й цілком окремим джерелом даних. (Щодо відновлення історичних веб-даних з Internet Archive як перевіреного соціально-наукового методу та щодо його упередженостей покриття та частоти краулювання див. Arora, Li, Youtie & Shapira, 2016, Journal of the Association for Information Science and Technology, 67(8), 1904–1915, doi:10.1002/asi.23503.)
3.5 Неправильна калібровка за видимим хвостом
Спільна структура розділів 3.2–3.4 пояснює систематичну психологічну помилку. Найбільш завантажуваний автор у вибірці 2015 року мав 824,762 завантаження, приблизно в 500 разів більше від медіани групи топ-авторів (1,626) і на чотири порядки більше від типової статті [85]. За квазілогнормальним законом важливі відстані мають мультиплікативний характер: крок від медіани звичайної статті (десятки завантажень) до порога входження в топ-список (160) менший, ніж крок від цього порога до медіани топ-списку (805), яка, в свою чергу, затьмарюється дистанцією до максимуму хвоста [85][139]. Проте числа, які циркулюють публічно (оголошення про вехи, профілі «топ-авторів», інституційні прес-релізи [101]), черпаються майже виключно з видимого хвоста. Тому автори калібрують «добре» щодо еталонного класу, розташованого на сотні разів вище від медіани, тоді як основна маса розподілу перебуває біля медіани. Показання панелі керування в 7 завантажень сприймаються як невдача, навіть якщо це звичайне для віку та галузі статті. Середнє значення долучається до тієї ж помилки у м'якшій формі: як показав розділ 3.3, воно перебуває вище 75-го перцентиля, тому навіть офіційно звучаче «середнє» є еталоном, забрудненим хвостом. У цьому сенсі середнє обманює: воно обчислюється правильно, а потім помилково приймається за типове значення в розподілі, який не має типового значення.
Кілька додаткових груп доказів посилюють висновок, що сирові лічильники відображають структуру видимості щонайменше стільки ж, скільки вміст. Увага реагує на позицію: у списках оголошень arXiv статті, які з'являються на першій позиції, мали приблизно на 83% вищу медіану цитувань у astro-ph, ефект, який автори в основному приписують видимості, а не лише самовідбору [72]. Вона також реагує на затримку індексування. SSRN сам зазначає, що зовнішнє індексування його вмісту Google Scholar контролюється пошуковими системами і може зайняти «6–9 місяців або довше» [54, доступ 14 серпня 2026], тому лічильники молодої статті генеруються до того, як основний канал виявлення почав працювати. Увага також тече назад від цитувань до завантажень: цитування залучає читачів (серед них цитованих авторів та їхні мережи) до статті, що цитує, і аналіз причинності Гренджера встановлює цей шлях цитувань-до-завантажень активним для значної частки статей [80][39], тому частина лічильника індексує позицію статті в мережі цитування та співпраці, а не будь-яке судження читача щодо її вмісту. Кожен із цих механізмів формує лічильник через структуру видимості (позиція, затримка виявлення, розташування в мережі), а не через судження читача щодо якості, і жодна з них не видна в числі панелі керування. Ширша економіка уваги показує ту ж концентрацію в екстремальній формі: у соціальних мережах коефіцієнти Джині уваги досягають 0,90–0,94, причому топ 1% облікових записів отримує більше уваги, ніж нижні 99% разом [180], сучасне відлуння максими Саймона про те, що багатство інформації створює бідність уваги [141]. Наукова увага на SSRN належить у м'якшій формі до тієї ж сім'ї перекошених процесів дифузії. Аудиторія, якій найбільш комфортно на SSRN, економісти та правознавці, впізнають цю структуру з фінансів. Аналіз Бессембіндера даних CRSP за 1926–2016 років показав, що приблизно $34,8 трильйонів чистого створення багатства фондового ринку було обумовлено менш ніж 4% публічних компаній, причому більшість акцій не змогла протягом їх існування перевищити дохідність казначейських облігацій [16]. Паралель наводиться як ілюстрація, а не як доказ: у багатстві, як і в увазі, сукупні підсумки генеруються тонким екстремальним хвостом, а вимірювання себе проти середнього, яким керують гіганти, є категоріальною помилкою. Дефіцит також не обмежується лічильниками використання: у юридичній науці загалом 43% статей у юридичних журналах у переписі 2007 року не цитувалися взагалі, і лише 18% когорти 2015–2019 отримали одне цитування протягом п'яти років [171].
3.6 Множник поля: дисциплінарна структура норми
Розподіл — це не один розподіл: він різниться від галузі до галузі. Аналіз Whalen майже чверть мільйона статей, класифікованих у 94 електронних журналах мережи Legal Scholarship Network, показує, що дисциплінарна базова лінія варіюється приблизно у восьмикратному розмірі навіть у межах однієї узагальнювальної дисципліни: середня кількість завантажень за весь період існування на одну статтю варіювалась від 438.35 у Corporate, Securities & Finance Law до 53.48 в Agricultural Law & Policy [168]. Рисунок 4 відображає градієнт.
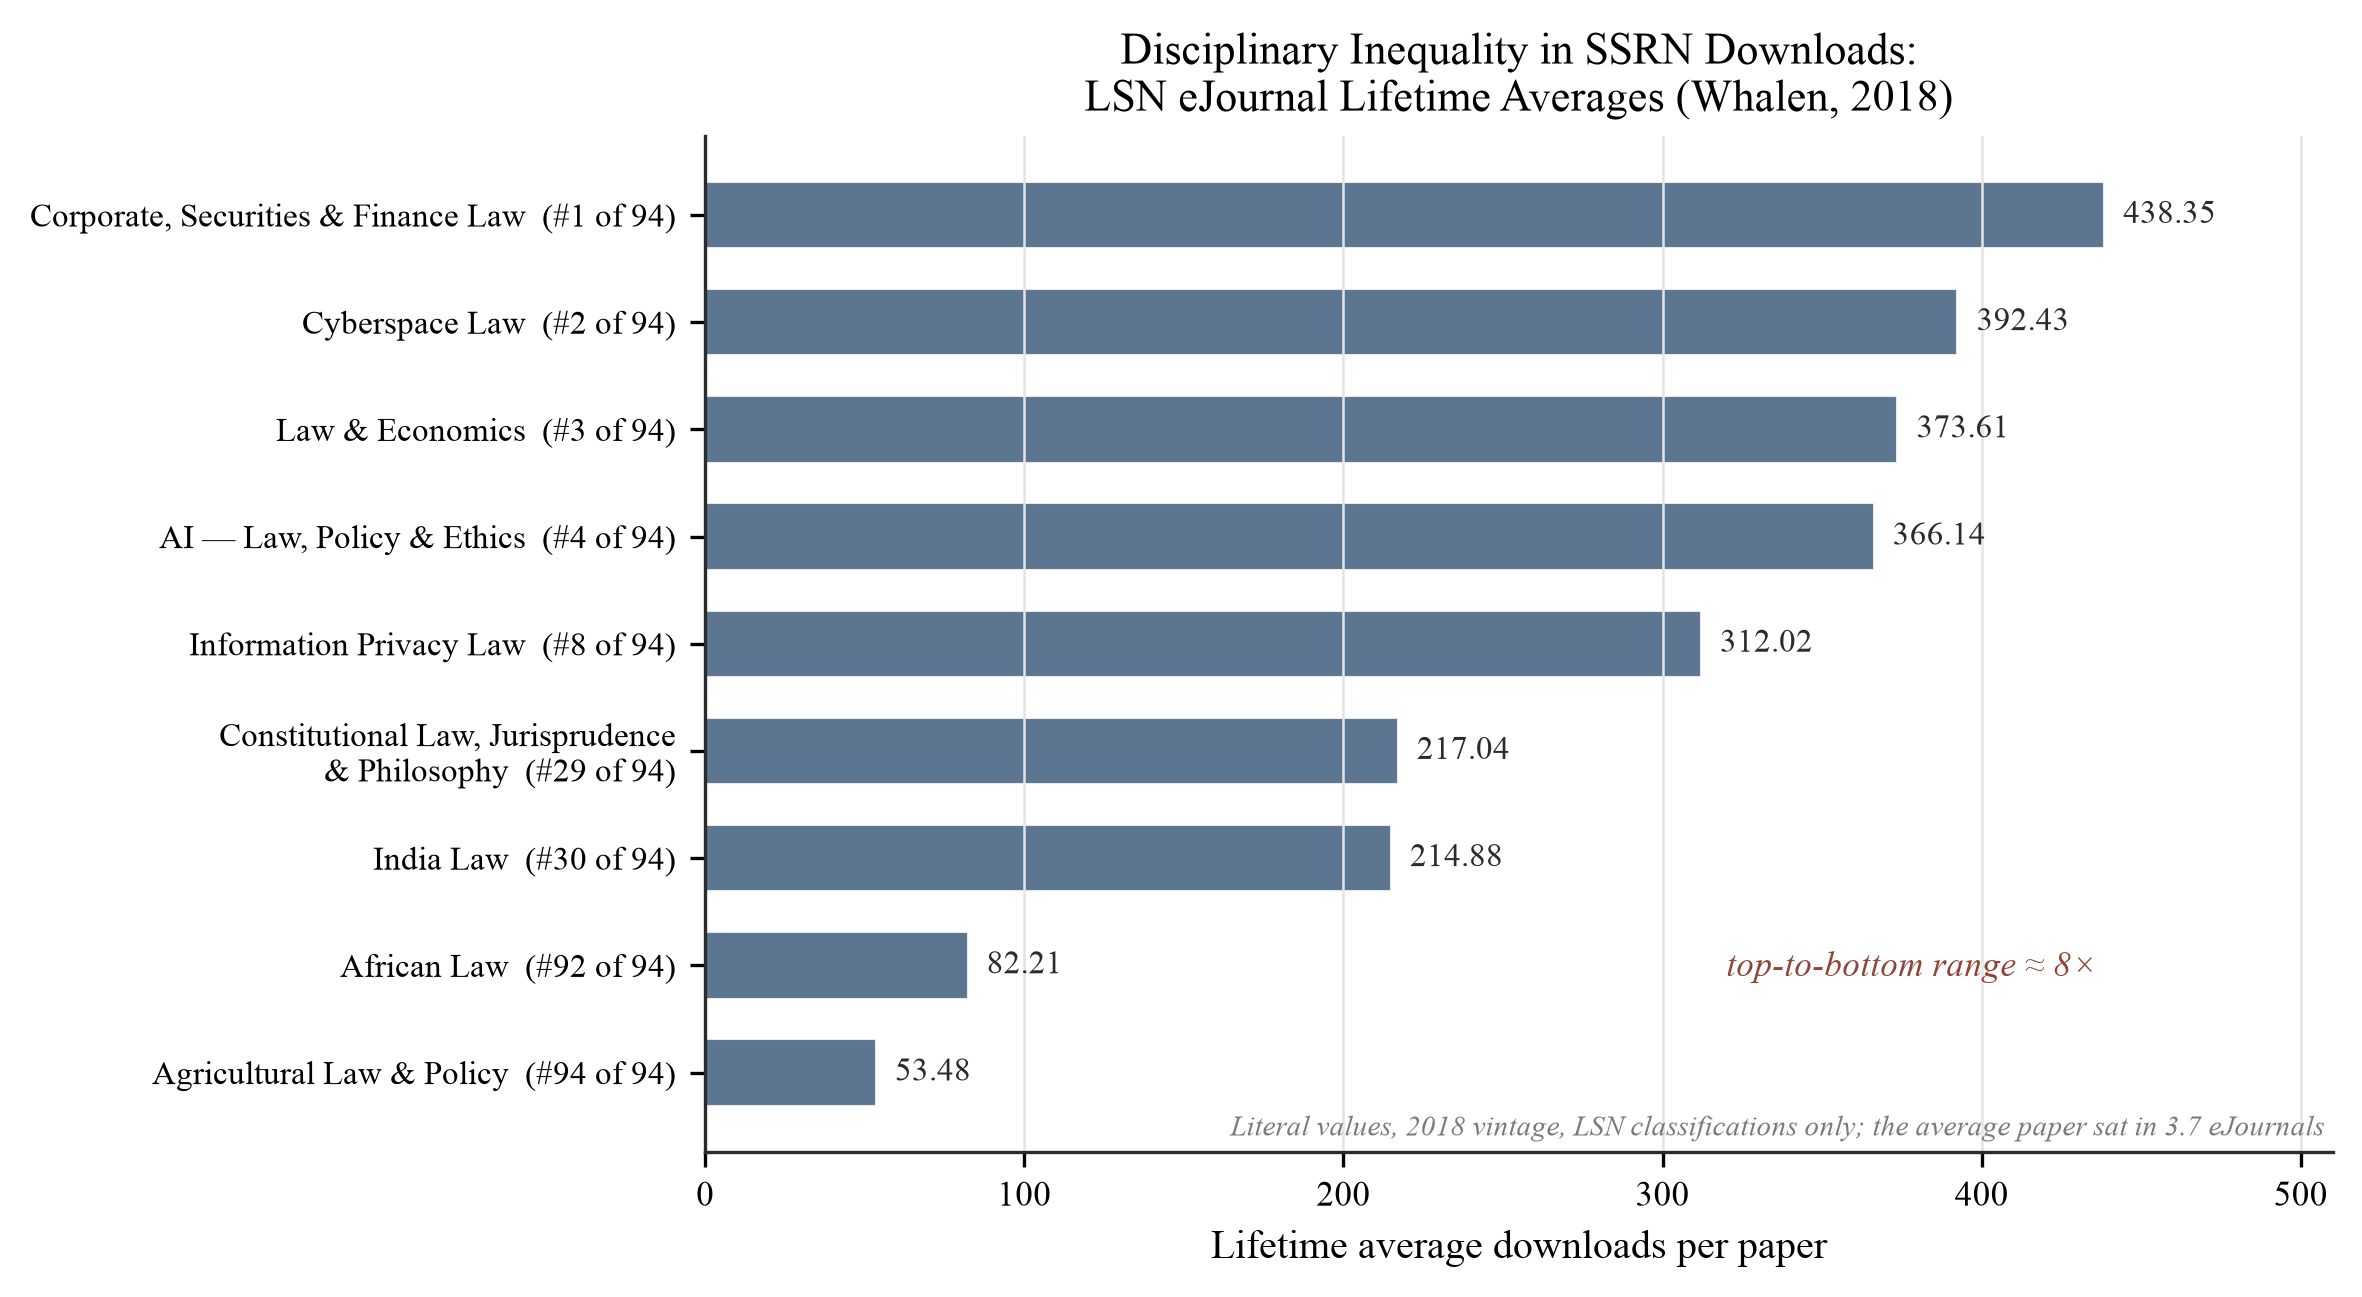
Рисунок 4. Середня кількість завантажень за весь період існування на одну статтю для обраних електронних журналів LSN, буквальні значення від Whalen (2018) [168]: Corporate, Securities & Finance Law 438.35 (ранг 1 із 94); Cyberspace Law 392.43 (2); Law & Economics 373.61 (3); AI – Law, Policy & Ethics 366.14 (4); Information Privacy Law 312.02 (8); Constitutional Law, Jurisprudence & Philosophy 217.04 (29); India Law 214.88 (30); African Law 82.21 (92); Agricultural Law & Policy 53.48 (94). Діапазон від верхнього до нижнього складає приблизно восьмикратний розмір. Значення мають дату 2018 року та охоплюють лише класифікації LSN; середня стаття була класифікована у 3.7 електронних журналах.
Механізм має структурну, а не меритократичну природу: виявлення в SSRN ґрунтується на класифікації (передплатники електронного журналу отримують сигналізацію про статті, класифіковані в ньому), тому аудиторія, якій доступна стаття, визначена базою передплатників її галузі до того, як почне діяти будь-який показник якості. Whalen крім того виявляє, що статті з більшою кількістю класифікацій отримують більше завантажень і менш імовірно записують нульові завантаження [168]. Структура галузі також впливає на лічильники через культуру цитування: Black та Caron спостерігали, що співвідношення завантажень та цитувань систематично різняться поперед галузями, оскільки юридична наука цитує попередні роботи повніше, ніж економіка чи фінанси [18], а у межах права увага концентрується на конкретних темах та характеристиках автора: у зразку перепису 2012 року теми корпоративного та міжнародного права, авторство США та афіліація топ-20 всі передбачали значно вищі показники [139], визначники, відбиті у сучасному коментарі юридичної бібліотеки [175]. Отже, число, яке не примітне у корпоративному праві, може бути винятковим у історії права чи аграрному праві, і будь-який орієнтир або масштаб (включаючи той, що побудований у розділі 5) повинен читатися як відносний до галузі. На стороні цитування існує добре встановлений прецедент для цього: Radicchi, Fortunato та Castellano (2008) показали, що розподіли цитувань збігаються до однієї універсальної кривої лише після того, як число кожної статті переманштабується середнім значенням її галузі [182], аналог класу посилання, який, на думку цієї статті, показники використання повинні мати так само.
Три приклади, цілком засновані на перевірених даних вище, демонструють важливість цього. Автор аграрного права, чия стаття має 60 завантажень за весь період існування, розташована вище від середнього значення її електронного журналу 53.48 [168], однак, порівнюючи з показниками корпоративного права, які є найбільш видимими, може читати те ж число як невдачу. Автор корпоративного та цінних паперів права з тим же 60 розташована далеко нижче від середнього значення цієї галузі 438.35 [168]. А автор, чия стаття з маркетингу досягає медіани мережі 87 [83], може недооцінити результат, який, за побудовою, є типовим. Помилка, спричинена відсутністю масштабу, працює в обох напрямках: вона породжує необґрунтований відчай та залишає успіх невизнаним.
Розділи 3.2–3.6 встановлюють емпіричне ядро цієї статті. Розподіл завантажень SSRN сильно зміщений вправо та приблизно логарифмічно нормальний, і середнє перевищує не лише медіану, але й 75-й перцентиль. Видимий хвіст розширюється до 500 разів елітних медіан та спотворює неофіційні порівняння; лічильники вбудовують престиж, позицію, індексацію та ефекти структури галузі, які діють незалежно від вмісту; і дисциплінарна база варіюється у восьмикратному розмірі в межах однієї наукової галузі. Отже, необроблена кількість завантажень, прочитана проти середнього або проти хвоста, не може бути змістовно інтерпретована за побудовою. Обґрунтоване прочитання потребує класу посилання: розподілу, обумовленого галуззю, віком статті та когортою. Рейтинги, попри всі їх недоліки, були єдиною публічною спробою платформи забезпечити такий клас посилання, і їх видалення робить побудову зовнішнього (карту орієнтирів та шкалу інтерпретації розділу 5) центральним завданням решти цієї статті.
4. Механіка лічильників: лічильник під правилом
Перш ніж будь-яке число на панелі SSRN можна інтерпретувати, необхідно встановити, що насправді записує це число. SSRN відображає два основних показники використання на рівні статті, перегляди анотацій та завантаження, поряд зі статистикою цитувань та показниками PlumX [50]. Після припинення роботи рейтингів 15 липня 2026 року ці лічильники залишилися на місці: SSRN заявив, що «числа завантажень та статистика цитувань будуть продовжувати записуватися та відображатися на ваших окремих статтях та профілі автора» [149]. Масштаб порівняння зник, але дані залишилися. Однак лічильники, які залишилися, не є простими спостереженнями про читацьку поведінку: вони є спільним продуктом архітектури платформи, розповсюджувального механізму, трафіку без участі людини та фільтрування цілісності. Кожен із цих шарів аналізується нижче, а розділ 5 потім будує структуру інтерпретації на їх основі.
4.1 Що таке перегляд і запис завантаження та що вони не є
Абстрактний перегляд реєструє запит до сторінки статті. Завантаження записує отримання повнотекстового PDF. Обидва є подіями залучення; жодне не є прямим свідченням читання, розуміння, схвалення або наукового затвердження. Ця розрізнення обмежує кожне твердження, зроблене в решті цієї статті.
Публічні лічильники SSRN не є простими логами HTTP-запитів. Платформа застосовує фільтрування цілісності даних з перших років своєї роботи [69] і публічно описала свій підхід: автоматичні завантаження, повторні самозавантаження та спроби маніпулювання показниками фільтруються за допомогою «ознак нерегулярної активності», а підозрілі завантаження (включаючи в деяких випадках анонімні завантаження) виключаються з показників, видимих авторам [144]. Незалежні спостерігачі задокументували таку саму поведінку раніше: повторні завантаження з однієї IP-адреси не додаються до лічильника [66]. Тому лічильник завантажень є обробленою статистикою, суттєво надійнішою за необроблений журнал сервера. Фільтрування видаляє найлегше виявлювану нелюдську та маніпулятивну активність і не більше того. Лічильник завжди є лічильником за правилом, а не природною одиницею, і правила змінюються (розділ 4.3).
4.2 Неживий трафік та асиметрія між переглядами та завантаженнями
Автоматичні агенти становлять більше половини загального інтернет-трафіку у недавніх вимірюваннях індустрії [158]. Цю цифру не можна перенести на лічильники SSRN: не було виявлено жодного опублікованого вимірювання частки ботів у переглядах анотацій або завантаженнях SSRN, і будь-який конкретний відсоток, заявлений щодо SSRN, був би необґрунтований. Те, що можна встановити, це структура проблеми, розглядається з двох напрямків: механізми, які правдоподібно завищують перегляди, та прозорий запис фільтрації сусідньої платформи.
Кілька механізмів правдоподібно створюють неживі перегляди анотацій. Краулери пошукових систем регулярно індексують новозаписані сторінки анотацій. Інституційні системи безпеки електронної пошти, найпомітніше Safe Links у Microsoft Defender for Office 365, сканують і попередньо завантажують URL-адреси, що містяться у вхідній пошті, які можуть реєструвати запити на стороні сервера, перш ніж будь-який людський одержувач відкриє повідомлення [106]. Оскільки основний канал розповсюдження SSRN - це електронна пошта (розділ 4.4), сканування посилань у листах оповіщення є структурно правдоподібним джерелом фантомних переглядів. Жодне опубліковане дослідження не вимірює внесок попередього завантаження за допомогою безпекового проксі до лічильників переглядів SSRN, а SSRN сама аудирує свої метрики та виключає неправильну активність з підрахунків завантажень [144][66][69], тому платформа, можливо, фільтрує значну частку такого трафіку, особливо на стороні завантажень. Твердження, що «більшість переглядів SSRN не є людськими», з'являється в неофіційних обговореннях, але ніколи не було вимірено.
Прозорий приклад - це RePEc. Його служба логування, LogEc, публікує як свою методологію фільтрації, так і історію фільтрації, і запис демонструє, наскільки сильною та наскільки асиметричною може бути неживе забруднення. Ще в липні 2007 року роботи становили приблизно 74% переглядів анотацій на моніторованих сервісах RePEc, але лише близько 7% завантажень [99]. Історія фільтрації читається як хронологія гонки озброєнь: евристики проти сканерів анти-шкідливого ПО були додані в липні 2010 року; новий тип систематичного масового завантаження був розглянутий в січні 2017 року; фільтри пом'якшення DDoS, запроваджені в січні 2022 року, видалили 54% переглядів анотацій, але лише 7% завантажень [99]. З жовтня 2025 року RePEc задокументував сплеск трафіку ботів, керованих ШІ, видаючи себе за людських користувачів [129]. У вересні 2025 року більше 99,5% необробленого трафіку до IDEAS був відкинений як неживий [129]. Після очищення звіт RePEc за червень 2026 року налічував близько 2,36 мільйона переглядів анотацій та 238 тисяч завантажень у своїх сервісах [129].
Докази RePEc підтримують два висновки щодо SSRN. Забруднення асиметричне за конструкцією: автоматичні агенти краулять сторінки HTML анотацій набагато агресивніше, ніж вони виконують пошук повнотекстових PDF, тому лічильники переглядів завищуються набагато більше, ніж лічильники завантажень, де фільтрація є недосконалою. Ця асиметрія, роботи на ~74% переглядів, але ~7% завантажень у вимірюванні 2007 року [99], є архітектурною властивістю трафіку репозиторію, а не ідіосинкразією RePEc. Конкретні пропорції не підлягають передачі: правила фільтрації SSRN, модель розповсюдження та аудиторія відрізняються, і SSRN не публікує еквівалентного журналу фільтрації. Розділ 5.2 розробляє практичні наслідки, які полягають у тому, що коефіцієнти, побудовані на переглядах (як-от коефіцієнт конверсії), повинні читатися як нижні межі якості людської взаємодії, оскільки знаменник є більш забрудненою кількістю. Цей напрямок нижньої межі залежить від закупівлі, а не від закону: він тримається, поки фільтрація на стороні перегляду відстає від фільтрації на стороні завантаження, що є історично задокументованим режимом [99], але це послабилося б або змінилося б навпаки, якби фільтри перегляду платформи наздогнали фільтри завантаження, або якби забруднення на стороні завантаження зростало швидше, ніж на стороні перегляду (оскільки епізод ШІ-бота 2025–2026 поніс обидва [129]). Напрямок слід перевіряти заново, коли платформа переглядає свої правила підрахунку.
Подальше розуміння виникло з тих пір, як були розроблені ці режими фільтрації. Фільтри були побудовані для видалення автоматичних запитів з підрахунку, призначеного для проксування людської уваги, і це правило все ще видаляє шум. Те, що він більше не може робити без розгляду, - це розглядати залишок як людський, оскільки три класи автоматичних запитів тепер сидять там, де фільтр бачив один: краули, які збирають текст для навчання моделі, краулери, які індексують для пошукової служби або служби відповідей, і вибірки, які система робить у реальному часі від імені людини, яка щось запитала. Перші два залишаються шумом для підрахунку уваги. Третій - це делегований акт з людиною позаду, оскільки система, яка витягує повний текст статті для відповіді на запитання користувача або для підтримки пошуку літератури, отримала вміст і використала його, хоча жодна людина ніколи не завантажувала сторінку. Автоматичний запит сам по собі не є доказом того, що щось було прочитано. Проксі ослаб, а не фільтр: людина проти машини більше не надійно відстежує розрізнення, яке потрібне цій статті, а саме питання про те, чи є подія доказом наукової уваги, людської чи делегованої.
Проект COUNTER почав розглядати це у своїй лексиці звітування, а не у своєму фільтрі. Рекомендації найкращої практики щодо використання ШІ, видані в квітні 2026 року та оновлені 30 червня 2026 року для версії 5.1.1, надають необов'язковий Access_Method агента, визначається як вміст та метадані, до яких звернулася система штучного інтелекту, разом із типами метрик, специфічними для ШІ, тоді як версія 5.1.1 продовжує вимагати, щоб «діяльність, створена традиційними ботами та краулерами, ПОВИННА бути виключена з усіх звітів COUNTER» [125]. Інструмент має три обмеження, які мають значення тут. Це необов'язкове розширення, виробляється лише в звітах, які постачальник вирішує згенерувати, і спрямовано насамперед на системи ШІ, вбудовані на власній платформі постачальника, а не на вхідні краулери. Його елементи «НЕ ПОВИННІ включатися в жодні стандартні перегляди звітів COUNTER» [125], тому стандартний перегляд не буде розрізняти доступ агента навіть там, де постачальник реалізує рекомендації. Питання про те, чи видаляються позначені події агента з усіх за замовчуванням чи виконуються без позначення, є питанням реалізації, на яке рекомендації мовчать. Він також класифікує доступ, який був надано, а не доступ, який було відмовлено: рекомендації вказують, що «немає показників відмови, пов'язаних конкретно з Access_Method Agent» [125]. Ніщо з цього не досягає голого загального лічильника у будь-якому випадку, оскільки такий лічильник не є звітом COUNTER і не має методу доступу; стандарт - це аналог, за яким його можна судити, а не його опис.
Відмова також не гіпотетична, і вона діє попереду будь-яких правил підрахунку, але її інструменти різні за характером і не діють як один. robots.txt платформи просить названих агентів не сканувати; резервування щодо видобування тексту та даних стверджує юридичну позицію; умови використання обов'язують контрактно; служба виклику утримує сторінку від клієнтів, які не можуть її завершити. Тільки останній із них є примусовим. На досліджуваній платформі, як отримано 29 серпня 2026 р., robots.txt назвав трьох агентів (GPTBot, ChatGPT-User та Google-Extended) і мовчав про інших, мовчання як стандартне значення Robots Exclusion, яке коректні краулери читають як дозвіл; відповіді мали резервування щодо видобування даних, що вказує на політику видавця, яка дозволяє його для цілей, визначених у статті 3 Директиви ЄС про єдиний цифровий ринок, і вимагає ліцензії в інших випадках; умови використання зберігають права на видобування тексту та даних і навчання штучного інтелекту, за винятком випадків, коли автор вибрав відкриту ліцензію, можливість, доступна тільки з 20 липня 2026 року і за умовчанням всі права зберігаються; і один неаутентифікований запит, зроблений без механізму JavaScript, отримав керовану Cloudflare виклик замість сторінки. Один з названих агентів - це викликаний користувачем вибирач, а не краулер навчання: це делегований клас попереднього абзацу. Ці матеріали записують опубліковані обмеження та одне спостереження конфігурації. Вони не встановлюють, скільки запитів, автоматизованих чи людських, були відхилені. Директиви дотримуються нерівномірно: при великомасштабному вимірюванні поведінки краулерів, деякі агенти повністю дотримувалися заборон всього сайту, але дотримувалися забори шляху менше третини часу, а інші ігнорували файл повністю [87]. Побічні наслідки також не односторонні, оскільки розгортання викликів завдали шкоди дійсним користувачам в іншому місці (одна університетська бібліотека зареєструвала два такі інциденти протягом перших чотирьох місяців використання [29]).
Історичну асиметрію тому не можна просто перенести. Впевненість висновку 2007 року про те, що роботи становили приблизно 74% переглядів анотацій, але близько 7% завантажень [99], ґрунтувалася на краулерах, які переглядали цільові сторінки і рідко завантажували повний текст. Система, яка отримує документи для обґрунтування відповіді, не має причини зупиняватися на анотації, тому сторона завантажень більше не гарантовано чистіша метрика за конструкцією. Там, де необроблений науковий трафік вимірювався в 2025–26, автоматизована частка не була маргінальною, і вона була виявлена в кількості завантажень і відвідувань, а не тільки в переглядах сторінок: одна колекція культурної спадщини переглянула кількість відвідувань у березні 2025 р. з 1 000 000 на 125 000 після видалення підозрюваного трафіку ботів [167]; класифікація постачальника приблизно тридцяти мільйонів запитів доступу в одному інституційному сховищі позначила лише приблизно чверть їх людськими [98]; і сховище, яке відповідало на опитування відкритих сховищ, приписувало принаймні чверть своїх власних завантажень ботів, близько половини мільйона запитів, одинадцяти названим агентам штучного інтелекту [135]. Жодна з цих цифр не є вимірюванням досліджуваної платформи: вони беруться з різних платформ з різним, в деяких випадках відсутнім, захистом, і два з трьох враховують відвідування або запити, а не события завантажування, які відображає публічний лічильник. Вони встановлюють попередню умову, а не величину. В поточному середовищі інтерпретовність будь-якого підрахунку використання залежить від якості фільтра, і там, де платформа не публікує своє фільтрування, ця якість не піддається аудиту.
Далі йдуть дві проблеми ідентифікації, і вони посилюють одна одну. Спочатку склад: з самого по собі публічного довічного лічильника, долі людських, звичайних автоматизованих і опосередкованих агентом подій неможливо оцінити, і власна точка зору платформи може бути не кращою, оскільки спостерігалося, що автоматизовані клієнти представляють себе як браузери робочого столу [167]. Щодо відбору, лічильник не може розкрити, яка частка спроб доступу була обслужена, оскаржена або виключена перед застосуванням будь-якого правила підрахунку. Опубліковані політики розкривають, що такі механізми існують. Вони не розкривають, як часто вони працюють, як вони працювали в минулому, або їхній вплив на включення. Спроби запитів, оскаржені запити, события обслуговування повного тексту, відображені завантаження та відповіді, створені з отриманого паперу, тому є п'ять різних популяцій, і вони не повинні розглядатися як взаємозамінні. Те, що залишається невідомим, це величина або чистий знак для цієї платформи. Невідфільтроване наукове використання тепер відомо як сприйнятливе до завищення за рахунок автоматизованого трафіку, включаючи завантаження, але залишають неопубліковані фільтри цієї платформи, правила виклику та політики краулера більш людсько-зважений залишок, розрив у виявленні, опосередкованому агентом, обоє чи жодне, не вимірюється. Також суміш не є стабільною протягом років, які охоплює довічний итог - від режиму ботів до 2024 року, через всплеск скрейпінгу 2025–26, до стандарту ліцензії, введеного у липні 2026 року. Наслідки питання, що випливають, задокументовані: сайти, які блокують великий краулер штучного інтелекту, значно рідше отримуються двигунами відповідей штучного інтелекту, навіть там, де вміст залишається доступним [70]. Для жодного великого сервера препринтів не існує опублікованої оцінки частки агента, дослідницька прогалина, а не свідчення малого ефекту, і аудит, зазначений у розділі 8, призначений для його вимірювання. Публічний довічний итог - це сума невідомої суміші, отримана з невідомої частки спроб доступу, без зовнішнього оцінювача для жодного з них і без підстави розглядати будь-яке як стаціонарне.
4.3 Падаючі лічильники як события вимірювання
Лічильники можуть також падати або переоцінюватися, коли змінюються правила фільтрування — подальший наслідок запису про фільтрування, якого не пояснює жоден дашборд. Переглад фільтру RePEc від січня 2022 видалив половину раніше підраховуваних переглядів анотацій за один крок [99]. Його період ШІ-ботів у 2025–2026 роках змусив подальші методологічні зміни [129]. Статистика завантажень від поставників, як відомо, чутлива до умовностей підрахунку: аудит з боку бібліотеки виявив, що звіти про завантаження від одного великого видавця були приблизно удвічі вищі, ніж на порівняних платформах, з «пониженими» показниками на рівні 43% від заявленої цифри [176]. Раптове падіння лічильників автора на SSRN тому так само може бути подією вимірювання, зміною фільтрування або переоцінки з боку платформи, як і подією читання, і його ніколи не слід сприймати як репутаційну втрату без підтвердження. Те ж саме міркування керує будь-яким використанням показників у досьє, де датовані записи повинні зберігатися (протокол, розроблений у розділі 6). Цифри платформи можуть бути переглянуті, а датований архів автора не може бути переглянутий.
4.4 Push versus pull: архітектура формує співвідношення
Архітектура розповсюдження є останнім механічним шаром. Вона якісно відрізняється між основними репозиторіями та безпосередньо формує взаємозв'язок між переглядами та завантаженнями. SSRN працює переважно за моделлю push. При подачі автори вибирають від однієї до семи предметних класифікацій (середня стаття LSN містила 3,7 призначень eJournal [168]), і вони визначають розміщення в дослідницьких мережах та право на одержання темаспецифічних сповіщень електронної пошти eJournal. Включення в сповіщення є «кураторським і спрямованим, але не гарантованим», а розповсюдження в темах з високим обсягом може займати до 45 днів [53]. Підписники отримують анотаційні повідомлення електронною поштою [57]. Кожний одержувач, який перейде за посиланням зі сповіщення, незалежно від того, чи то з сфокусованого інтересу, чи з простої цікавості, реєструє перегляд анотації. arXiv, навпаки, працює переважно як платформа pull: некомерційний репозиторій, чий трафік формується дослідниками, які активно відвідують списки та стрічки [11][65], де навіть позиція в межах щоденного списку анонсів вимірно впливає на кількість читачів і цитування [72]. RePEc агрегує метадані з децентралізованих архівів і застосовує ретельне задокументоване фільтрування, описане вище [99][129].
Таблиця 6 узагальнює порівняння платформ як якісну схему управління та механіки виявлення. Порівняльні дані про трафік між платформами не існують у опублікованих джерелах.
Таблиця 6. Архітектури платформ та їхній механічний вплив на показники використання (якісна схема).
| Характеристика | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| Управління | Комерційна (Elsevier, з травня 2016) [46] | Некомерційна (Cornell University) [11] | Децентралізована мережа волонтерів [99] |
| Основний канал виявлення | Push: курировані сповіщення електронного журналу, керовані класифікацією, вибраною авторами (1–7; розповсюдження до 45 днів у темах з великим обсягом) [53][57] | Pull: візити, керовані чітким намірам, до списків і стрічок; задокументовані позиційні ефекти в межах оголошень [11][72] | Агрегація розподілених архівів; виявлення через IDEAS/EconPapers [99] |
| Прозорість фільтрування | Політика описана якісно; немає публічного журналу фільтрування [144] | Показники використання не опубліковані централізовано | Повністю задокументована методологія та історія редакцій (LogEc) [99][129] |
| Очікуваний механічний вплив на співвідношення перегляди : завантаження | Підвищені перегляди відносно завантажень: клацання на посилання електронної пошти реєструють перегляди з експозиції без сильної наміру | Вищий коефіцієнт перетворення відвідувань у завантаження: трафік керований намірами | Коефіцієнт набуває сенсу лише після видалення великої кількості ботів; опубліковані показники - це результат фільтрування [129] |
Архітектура впливає на психологію автора, оскільки високе співвідношення перегляди-завантаження на SSRN значною мірою є результатом дизайну: модель push створює широку експозицію з низькою намірами. Беглий перегляд анотацій також є легітимною науковою поведінкою (дослідники регулярно моніторять галузі через анотації без завантаження повних текстів), тому перегляд, що не конвертується, може означати, що анотація вже передала свою інформаційну цінність, а не що вона відштовхнула читача. Власне історичне правило, повідомлене Black та Caron, було приблизно «три перегляди анотацій … призводять до одного фактичного завантаження статті» [18]. Ті ж автори зазначили, що без фільтрів цілісності сирові лічильники були б завищені «в п'ять чи більше разів» [18]. Розділ 5.2 розміщує ці застарілі якорі поруч із сучасними вимірюваннями.
Дві механічні особливості того, як представлена стаття, визначають конверсію разом із інтересом читача, що робить виміряний коефіцієнт конверсії частково властивістю інтерфейсу, а не дослідження. Одна - це користувацький інтерфейс платформи. Незалежно від того, чи пропонується повний текст як вбудована HTML-трансляція браузера або лише як PDF, що завантажується, суттєво впливає на те, чи спонукає зацікавлений читач лічильник завантажень, оскільки читач, який споживає повний текст у браузері, задовольняє той же намір, одночасно збільшуючи лише перегляди. Інша - це склад пристроїв аудиторії. Мобільний доступ знижує завантаження повнотекстових PDF у порівнянні зі стаціонарними комп'ютерами, тому стаття, до якої читачі приходять переважно через телефони (з посилання соціальних мереж або мобільного поштового клієнта), матиме систематично менше завантажень і порівняно вищі перегляди при однаковому науковому інтересі. Обидва ефекти діють у тому ж напрямку, що й механічне завищення знаменника, вже встановлене вище, і обидва є додатковими причинами розглядати емпіричну смугу розділу 5.2 як діапазон, залежний від платформи, а не як фіксований поріг: норма конверсії, оцінена на основі інтерфейсу однієї платформи та комбінації пристроїв, повинна бути перекалібрована, а не копіюватися, коли будь-яка з них змінюється. Література про метрики використання висловлює аналогічне попередження щодо надійності порівнюваності звітів про завантаження на різних платформах і правилах підрахунку [176].
4.5 Передбачувані побічні ефекти: самоспівпадіння подібності та гігієна метаданих
Два додаткові механічні наслідки розміщення препринту передбачувані, і обидва регулярно викликають непотрібну тривогу, тому обидва належать до решти механізму.
Самоспівпадіння подібності. Коли робочий документ, розміщений на SSRN, згодом подається до журналу, журнальний скринінг на подібність, як очікувалось, позначить майже повну відповідність препринту автора. Документація iThenticate явно викладає обидві половини інтерпретації: програмне забезпечення «не перевіряє плагіат; воно перевіряє подібність», і «якщо ви бачите матч препринту для того самого автора, це не плагіат» [81]. Механізм також документований. Препринти, зареєстровані як Crossref Posted Content, включені до баз даних порівняння перевірки подібності, тому збіг з власним розміщеним препринтом – це система, що працює як задумано [36]. Матчі можуть виявитися навіть коли редактори виключають джерела препринту, оскільки вторинні агрегатори, які дублюють метадані репозиторію, також сканюються [81]. Відповідь автора має бути адміністративною, а не оборонною: визначити позначене джерело редактору, який обробляє матеріал, як власний препринт автора з позначкою часу. Керівництво Crossref та iThenticate рекомендує якісний редакційний огляд, а не механічні пороги балів подібності [36][81]. Тут не визначено числовий поріг, оскільки жодне значення не схвалюється самими послугами скринінгу. Впевненість, яку передбачає ця порада, має документовану основу в політиці видавця: розміщення робочого документа на сервері препринту дозволено згідно з політиками попередньої публікації більшості академічних журналів, хоча політики відрізняються, і поточну політику цільового журналу слід перевірити; позиції препринту публічно індексуються в реєстрах, таких як Sherpa Romeo. Помітні виключення групуються в медицині та суміжних клінічних областях, де деякі журнали все ще обмежують або не рекомендують попередню публікацію препринту. Автори в цих областях мають перевірити політику препринту цільового журналу перед розміщенням, а не після подання.
Виявлення AI-письма: суміжний канал хибної тривоги. Новіший шар скринінгу несе структурно подібний ризик хибної тривоги. Детектори AI-письма виробляють документовані помилкові позитиви, і тягар непропорційно падає на авторів, що не є носіями англійської мови: при оцінці Стенфордом семи публічно доступних детекторів GPT (дослідження не включало Turnitin), в середньому 61,3% есе TOEFL, написаних нерідними мовцями, були неправильно класифіковані як створені AI [97]. Інституційна практика зареєструвала цю проблему. У серпні 2023 року Університет Вандербільта публічно вимкнув функцію виявлення AI свого програмного забезпечення для перевірки подібності, посилаючись на його ненадійність: власна заявлена постачальником частота помилкових позитивів, відсутність будь-якої опублікованої методології виявлення та те саме непропорційне навантаження на авторів, що не є носіями англійської мови, описане вище [163]. Оборонна позиція тут паралелює самоспівпадіння подібності і є адміністративною, а не суперечливою: зберегти історію версій рукопису та записи при редагуванні як сучасні докази авторства (подальший аргумент на користь гігієни версіонування нижче), і відповідати на будь-який прапор документацією, а не тривогою.
Версіонування та гігієна метаданих. Оскільки лічильники накопичуються за сторінкою паперу, практика переглядання безпосередньо впливає на цілісність показників. SSRN підтримує розміщення переглянутих версій на тій самій сторінці паперу, зберігаючи накопичені лічильники та індексовану URL, тоді як видалення паперу та його повторне завантаження скидає показники та розриває існуючі посилання (SSRN FAQ; сторінка підтримки, що підлягає переглядові, доступна 14 серпня 2026 [B-7]). Вибір класифікації також має метричні наслідки, оскільки вони визначають маршрутизацію eJournal і, отже, основні події експозиції паперу [53]. Зовнішнє індексування працює повільніше, ніж очікують автори: SSRN стверджує, що індексування Google Scholar контролюється пошуковою системою і може зайняти «6–9 місяців або довше» [55]. Ранні лічильники паперу тому створюються майже повністю внутрішньою логістикою розповсюдження платформи, яка якорить інтерпретацію ранніх нулів у розділі 5.6.
5. Каркас інтерпретації: перебудова відсутньої шкали
Питання «це число добре?» є науково некоректно поставленим, доки не буде вказана група порівняння. Цей розділ збирає опубліковані емпіричні записи у відсутній порівняльний апарат: консолідовану карту еталонів з явною впевненістю джерела (5.1), емпіричну смугу конвертації (5.2), градуйовану шкалу інтерпретації (5.3), двовимірну діагностику охоплення–конвертації (5.4), багатовимірну специфікацію еталонів (5.5) та протокол часової інтерпретації (5.6). Значення наводяться в усьому з їхніми рамками вибірки та віком. Жодне з них не є каліброваним процентилем для платформи 2026 року, і все слід читати з урахуванням застереження про інфляцію розділу 5.1.
5.1 Консолідована карта бенчмарків
Таблиця 7 консолідує кожен придатний опублікований бенчмарк для метрик використання SSRN, виявлених у аудиті розділу 2.5, кожний з його фреймом вибірки та явним визначенням довіри джерела. Оскільки бенчмарк неправильно використовується в момент, коли його розтягують за межи його фрейму, кожна запис також називає висновкову роль, яку джерело може законно грати, та основне обмеження, яке його обмежує. Докази скупі: карта ґрунтується на п'яти дослідженнях з різними фреймами: переписна вибірка однієї юридичної мережі у 2012 р. [139], скрейпинг власних топ-списків платформи у 2015 р. [85], знімок однієї мережі в поперечному розрізі у 2025 р. [83], агрегати на рівні платформи [1] та один підполевий розпад [168]. Ці фрейми не є взаємозамінні: скрейпинг топ-списків описує елітний хвіст, переписи мереж описують типові папери, а агрегати платформи не описують жодного з них. Кожен розподіл також сильно перекошений вправо, тому середні значення систематично перевищують медіани та описують атипові папери.
Таблиця 7. Консолідована карта бенчмарків для метрик використання SSRN з фреймами вибірки, довірою джерела, допустимими висновковими ролями та основними обмеженнями.
| Бенчмарк | Значення | Джерело (рік; фрейм вибірки) | Довіра джерела | Допустима висновкова роль | Основне обмеження |
|---|---|---|---|---|---|
| Медіана завантажень папірів приблизно через 2 роки на платформі | 63 (середнє 122.55) | Siems 2016 [139]; n = 1,107 LSN папери опубліковано в двох вікнах 2012, показники прочитано два роки пізніше | Середньо-висока: вибірка та показники завантажень перевірені; лише право; когорта 2012 | Історичний погляд на розподіл звичайних папірів | Якір дволітнього спостереження юридичної мережі, не поточна норма на рівні платформи |
| Медіана переглядів анотацій папірів приблизно через 2 роки | 369 (середнє 564.62; кореляція переглядів–завантажень 0.852) | Siems 2016 [139] | Середньо-висока: показники перевірені за Таблицею 1 джерела; лише право; когорта 2012 | Історичний погляд на охоплення звичайних папірів | Того ж віку, однодисциплінарний фрейм; лічильники переглядів більш неточне число (розділ 4.2) |
| Медіана завантажень папірів, снимок однієї мережі | 87 (середнє 221.3; p25 = 35; p75 = 206; p95 = 726; медіана віку паперу 491 день) | Jo & Li 2026 [83]; N = 2,361 папери Marketing Research Network, снимок на 15 серпня 2025 | Висока: перевірено за опубліканою таблицею; примітка про два аномалії різних видів повідомлені «як опубліковано» — p95 переглядів = 966 є підозрюваною друкарською помилкою джерела (≈0.32 SD вище середнього; рядок позначений для перевірки), p95 конверсії = 77.7 є артефактом малого знаменника (розділ 5.2); повна таблиця в Таблиці 5 | Недавній розподіл у поперечному розрізі та модель конверсії | Одна мережа, одне поле, одна дата; зрілі папери; без траєкторій |
| Медіана переглядів анотацій папірів, снимок однієї мережі | 504 (середнє 611.973; p5 = 151; p25 = 288; p75 = 833; p95 = 966 "як опубліковано") | Jo & Li 2026 [83]; та ж вибірка як вище | Висока: перевірено за опубліканою таблицею; значення p95 (966) є підозрюваною друкарською помилкою джерела — ≈0.32 SD вище середнього — відтворено «як опубліковано» та позначене для перевірки, очікуючи запиту автора | Недавній розподіл охоплення у поперечному розрізі | Та ж рамка однієї мережи, однієї дати |
| Конверсія переглядів→завантажень, емпірична смуга | 11–19% (≈ одне завантаження на 5.3–9 переглядів анотацій) | Siems 2016 [139]; Willey & Knapp 2022/23 [172]; Jo & Li 2026 [83] | Середньо-висока: показники Siems, Willey–Knapp та Jo & Li перевірені за таблицями джерел | Норма умовного залучення (конверсія) | Мало фреймів вибірки; знаменник здатний до автоматичного наповнення ботами, тому виміряна конверсія є нижною межею, тоді як переглядови залишаються більш завищеним лічильником (розділ 4.2) |
| Історичне практичне правило платформи | ~3 переглядів анотацій : 1 завантаження (~33%) | Black & Caron 2006 [18], повідомляючи про власну статистику SSRN | Середня: дослівно перевірено; від 2006 року; на рівні всієї платформи | Анатомія метрики та історія цілісності | Ранній період платформи; верхня точка відліку, не поточна норма |
| Поріг входу, топ-10,000 папірів за всю історію | ≥160 завантажень за все життя (≈ топ 1.8% запасів повнотекстових папірів платформи, 571,040 у липні 2016 [1]); медіана в групі 805; середнє 1,800; максимум 152,242 | Kakushadze 2016 [85]; скрейпинг топ-списків SSRN, 2015; 367,478 папірів | Висока: перевірено за опубліканими таблицями; рамка топ-списку; робота одного автора | Форма розподілу та поведінка хвоста | Вибір топ-списку; непридатний для оцінки медіани сучасного папіру |
| Поріг входу, топ-30,000 авторів | 129 всього завантажень (мінімум); медіана в групі 1,626 всього; медіана 210 завантажень на папір; максимум 824,762 | Kakushadze 2016 [85]; група описана в SSRN як «топ 10%» авторів [161] | Висока: перевірено за опубліканими таблицями | Поведінка хвоста на рівні портфеля автора | Та ж вибір топ-списку; 2015 року |
| Невідкоригована середня платформи за все життя | ~222 завантажень на папір (~35 за останні 12 місяців) | Обчислено з даних платформи на грудень 2023: 256,678,716 завантажень за все життя для 1,157,048 повнотекстових папірів; ALL-SIS 2024 [1] | Середня: виведений агрегат; механічно завищено старими папірами; не особистий критерій | Калібрування лише масштабу платформи | Середнє значення за два десятиліття накопичення; описує майже жоден реальний папір (розділ 3.3) |
| Поширення підполя в одній дисципліні | ~8× у середньому завантажень на папір (438.35 Corporate/Securities/Finance Law vs 53.48 Agricultural Law) | Whalen 2018 [168]; 94 LSN eJournals, ~250,000 папірів | Середньо-висока: перевірено з джерела; 2018; середні, не медіани | Класифікація та гетерогенність підполів | Середні, не медіани з прив'язкою до віку; лише право; 2018 |
| Ранні завантаження → пізніші цитування | r ≈ 0.39–0.43 за першими 180 днів (≈16% варіативності пояснено) | Brody, Harnad & Carr 2006 [25]; arXiv (HEP), N = 14,442 | Висока: перевірено; інша платформа, передавальність припущена, а не показана | Валідація наступного прогнозування | Інша платформа та епоха; кореляції на рівні папіру скромні |
| Календарна структура доступу; запізнення доступу→цитування | Доступи ~на 11% менші в вихідні дні та ~на 50% менші влітку; ≈одиничноеластична реакція цитування ~через 9 місяців після змін доступу | Yuret 2026 [178]; >1,500 статей із семи журналів простежено ~1 рік | Висока: DOI, площадка та назва перевірені через Crossref (14 серпня 2026); всі чотири показники — більше ніж 1,500 статей із семи журналів, доступи на близько 11% менші в вихідні дні та на близько 50% менші влітку, та приблизно одиничноеластична реакція цитування (10%-ний ріст доступів пов'язаний з приблизно 10%-ним зростанням цитувань) близько дев'яти місяців пізніше — перевірені слово в слово порівняно з опублікованою анотацією статті (Springer, 15 серпня 2026) | Тимчасова нормалізація та предиктивна валідація — календарно-нормалізаційний якір CSAB | Дані доступу до журналів, а не специфічні для SSRN |
| Чутливість підрахунків до конвенцій підрахунку | Звіти постачальників щодо завантажень можуть бути ~в 2× більшими за порівняльні платформи («дефльовані» підрахунки становлять 43% від повідомленої цифри); метрики на рівні статті вимагають явної перевірки цілісності даних | Wood-Doughty et al. 2019 [176]; Gordon et al. 2015 [69] | Середньо-висока: обидва джерела перевірені та вже цитовані у розділах 4.1–4.3 | Попередження щодо цілісності та порівнюваності — обмежує точність будь-якого кроссплатформного або кросс-вендорного порівняння | Не прямий еталон SSRN; не існує аудиту, специфічного для SSRN |
Далі слідують три структурні читання карти.
Середнє значення не є типовою статтею. У єдиному останньому опублікованому розподілі середнє значення (221.3) в 2.54 рази перевищує медіану (87) і навіть перевищує 75-й процентиль (розділ 3.3) [83]. У більш ранній переписі Сімса середнє значення було приблизно в два рази більше від медіани [139]. Середнє значення на рівні платформи ~222 завантаження протягом всього часу [1] є найменш придатним особистим мірилом: воно агрегує два десятиліття накопичення статтями всіх віків.
Кожний еталон позначений часом свого встановлення, і напрямок часового упередження залежить від порівняння. Річні завантаження на платформі зросли з приблизно 0.5 мільйона у 2000 році та 3 мільйонів у 2005 році [18] до 12.9 мільйонів у 2016 році та 40.6 мільйонів у 2023 році [1], що становить 3.15-кратне зростання з 2016 по 2023 рік, тоді як колекція статей зросла приблизно в 2.03 рази за той же період (571,040 до 1,157,048 [1]). На рисунку 5 представлена ця траєкторія. Оскільки завантаження зростали швидше, ніж кількість статей, потік завантажень на одну статтю зріс приблизно на 55% (з приблизно 22.6 до приблизно 35.1 на одну статтю на рік [1]), тому фіксований поріг 2015 року тепер становить меншу частку того, що отримує типова стаття, ніж було тоді. Якщо розглядати як абсолютну межу для 2026 року, старий поріг, такий як запис у топ-списку з ~160 завантажень, буде тому поблажливим, а не консервативним: його досягнення менш селективне сьогодні, ніж у 2015 році, не більше. Упередження залежить від складу. Для позиції процентилю за умови продовження правого перекосу старі опорні точки можуть все ще недооцінювати хвіст, але для абсолютних підрахунків інфляція завантажень робить їх м'якими, тому жоден старий поріг не повинен наводитися як «консервативна основа» без цього застереження. Множення порога 2015 року на наступне зростання платформи також не оправдане: склад авторів, канали розповсюдження, фільтрування та конкуренція за увагу — все змінилось разом із потоком завантажень.
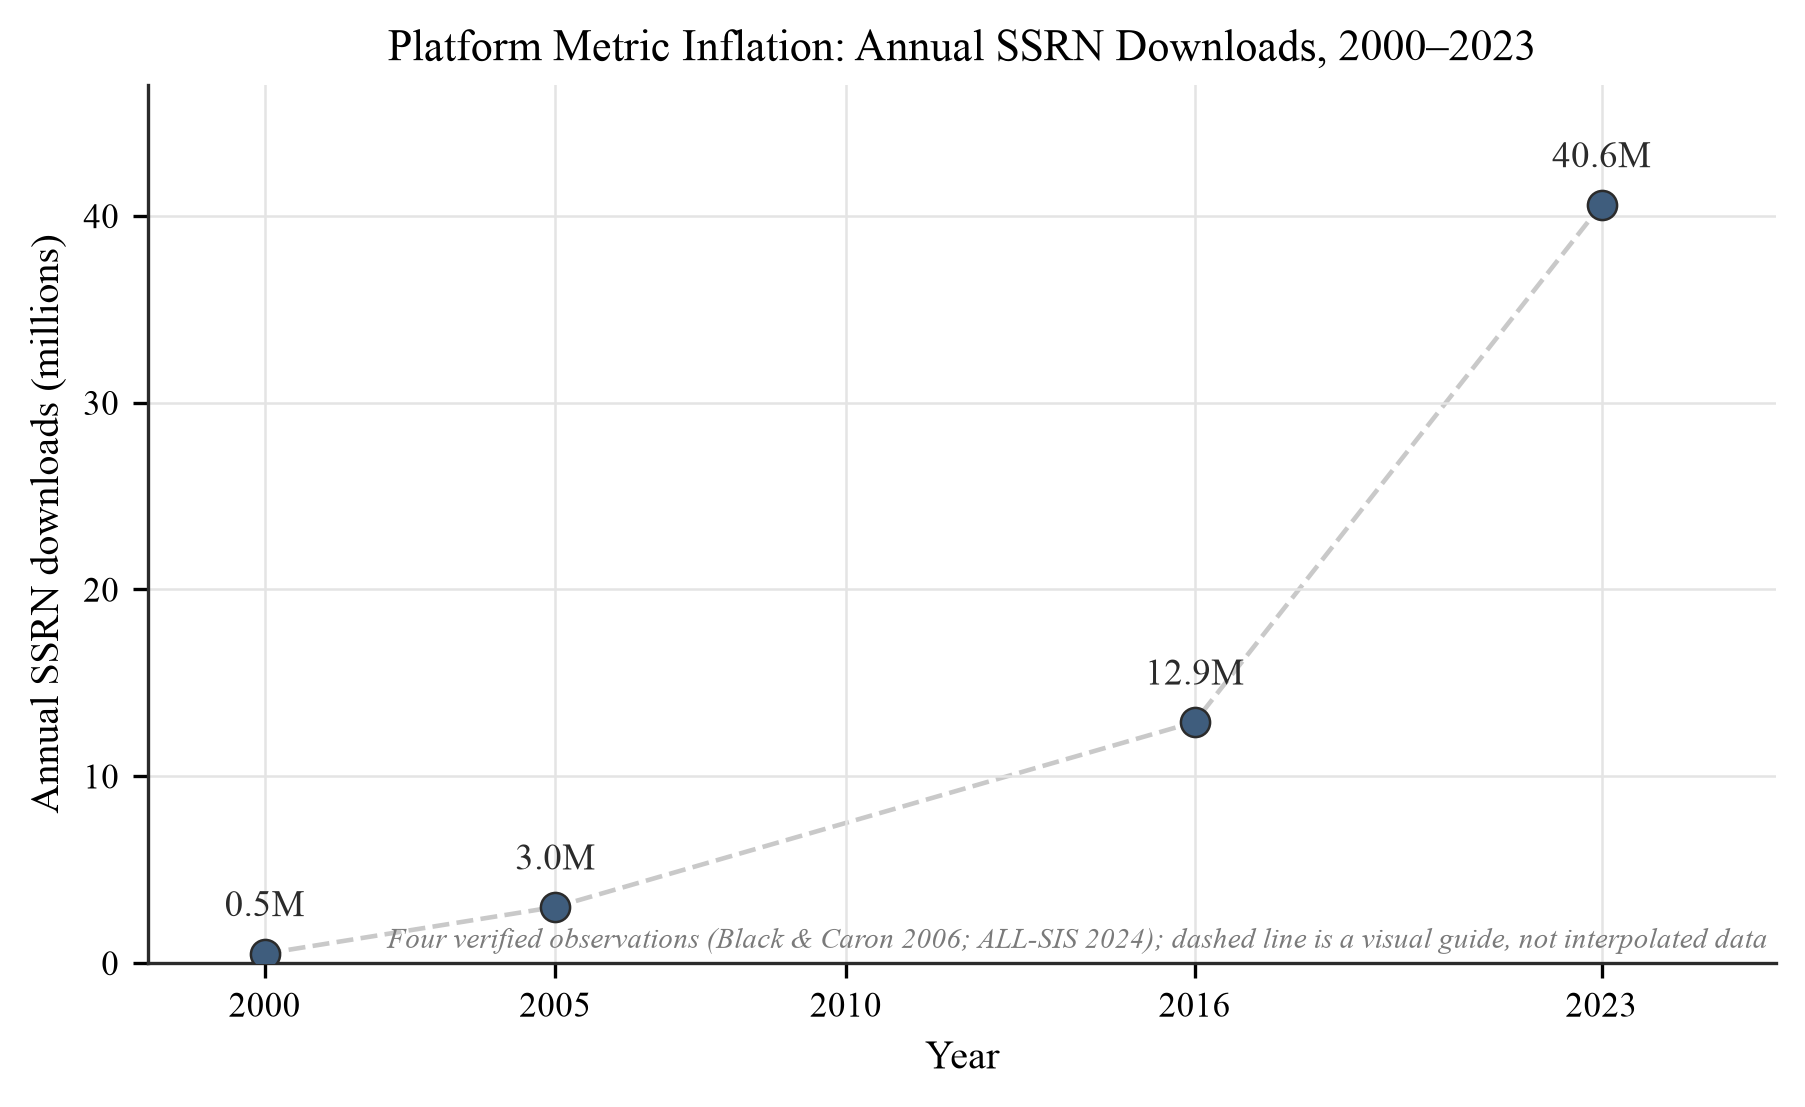
Рисунок 5. Інфляція метрик платформи, 2000–2023. Річні завантаження SSRN: ~0.5 мільйона (2000) та ~3 мільйони (2005) [18]; 12.9 мільйонів (2016) та 40.6 мільйонів (2023) [1]. Оскільки потік завантажень зростав швидше, ніж колекція статей (≈3.15× проти ≈2.03× з 2016 по 2023 [1]), підвищуючи потік завантажень на одну статтю приблизно на 55%, абсолютні еталони, оцінені на основі вибірок 2012–2015, виглядають поблажливо, а не консервативно для показань 2026. Тільки чотири перевірені річні значення, зазначені тут, нанесені на графік; не передбачається будь-яка інтерполяція між ними.
Не існує актуального джерела даних про процентилі. У аудиті розділу 2.5 не було виявлено жодного дослідження розподілу завантажень SSRN, проведеного після 2020 року (знімок однієї мережі 2025 року [83], опублікований у 2026 році, є єдиною останньою опублікованою зовнішньою вибіркою), і після 15 липня 2026 року сама платформа не публікує порівняльні дані, з яких можна було б реконструювати процентилі. Прогалина стосується актуальності та специфіки платформи. Розподіл і нерівність уваги до препринтів — це зріла дослідна область на інших репозиторіях (цитування та альтметричний профіль записів bioRxiv характеризуються по всьому серверу [62]), а квазі-логнормальна форма завантажень SSRN була вже встановлена до 2020 року Какушадзе [85]. Того, що не вистачає, — це поточний, специфічний для SSRN розподіл процентилю після припинення служби. Карта вище складена з доступних даних, що є аргументом на користь набору даних еталону спільноти, запропонованого в дослідницькій програмі (розділ 8).
5.2 Смуга конверсії
Співвідношення завантажень до переглядів анотацій є єдиною величиною на панелі інструментів із розумно стійкою міждослідницькою нормою, і автори помиляються при її прочитанні частіше, ніж з будь-якою іншою. При наївному прочитанні кожен перегляд без конверсії вважається відхиленням, і автор із 40 переглядами та 7 завантаженнями сприймає "коефіцієнт невдачі 82,5%". Таке прочитання є неправильним як з механічної, так і з емпіричної точки зору.
Розділ 4 встановив механіку: знаменник (перегляди) є більш забрудненою ботами та більш архітектурно завищеною величиною, оскільки натискання на посилання у push-email та трафік краулерів накопичують перегляди без припущення наміру читача, тоді як лічильник завантажень активно перевіряється [144][99][106]. Поки автоматизований трафік завищує перегляди більше, ніж завантаження, виміряний коефіцієнт конверсії є нижньою межею конверсії справді зацікавлених людських відвідувачів; розділ 4.2 пояснює, чому та асиметрія більше не може розглядатися як факт там, де системи штучного інтелекту отримують повний текст, і межа послаблюється відповідно. За емпіричними даними, опубліковані вимірювання збігаються на вузькій смузі. Сімс виміряв медіану коефіцієнту завантажень на перегляд 0,171 (середнє значення 0,187) у переписі LSN [139]; Віллі та Кнапп повідомляють про конверсію 15% серед їхньої групи найкращих статей та 11% серед статей з однією цитатою [172]. Снімок Джо та Лі дає медіану 18,9 завантажень на 100 переглядів анотацій [83]. Результуюча емпірична смуга становить 11–19%, тобто приблизно одне завантаження на 5,3–9 переглядів анотацій. Власне давніше правило SSRN приблизно 3 : 1 (~33%) [18] розташоване вище смуги і краще розглядається як верхній якір ранньої ери, загальний для платформи, а не як поточна норма. Як міжгалузева ілюстрація (популяції та наміри категорично розрізняються), коефіцієнт від переглядання до здійснення в цьому діапазоні вважався б високим у програмному забезпеченні для споживачів, де типові еталони конверсії freemium від безплатного до платного зосереджуються в однозначних цифрах [10]. Порівняння є суто ілюстративним, і воно переформульовує інтуїцію, що "7 із 40" сигналізує про дезінтерес. На рисунку 6 побудовано оцінки.
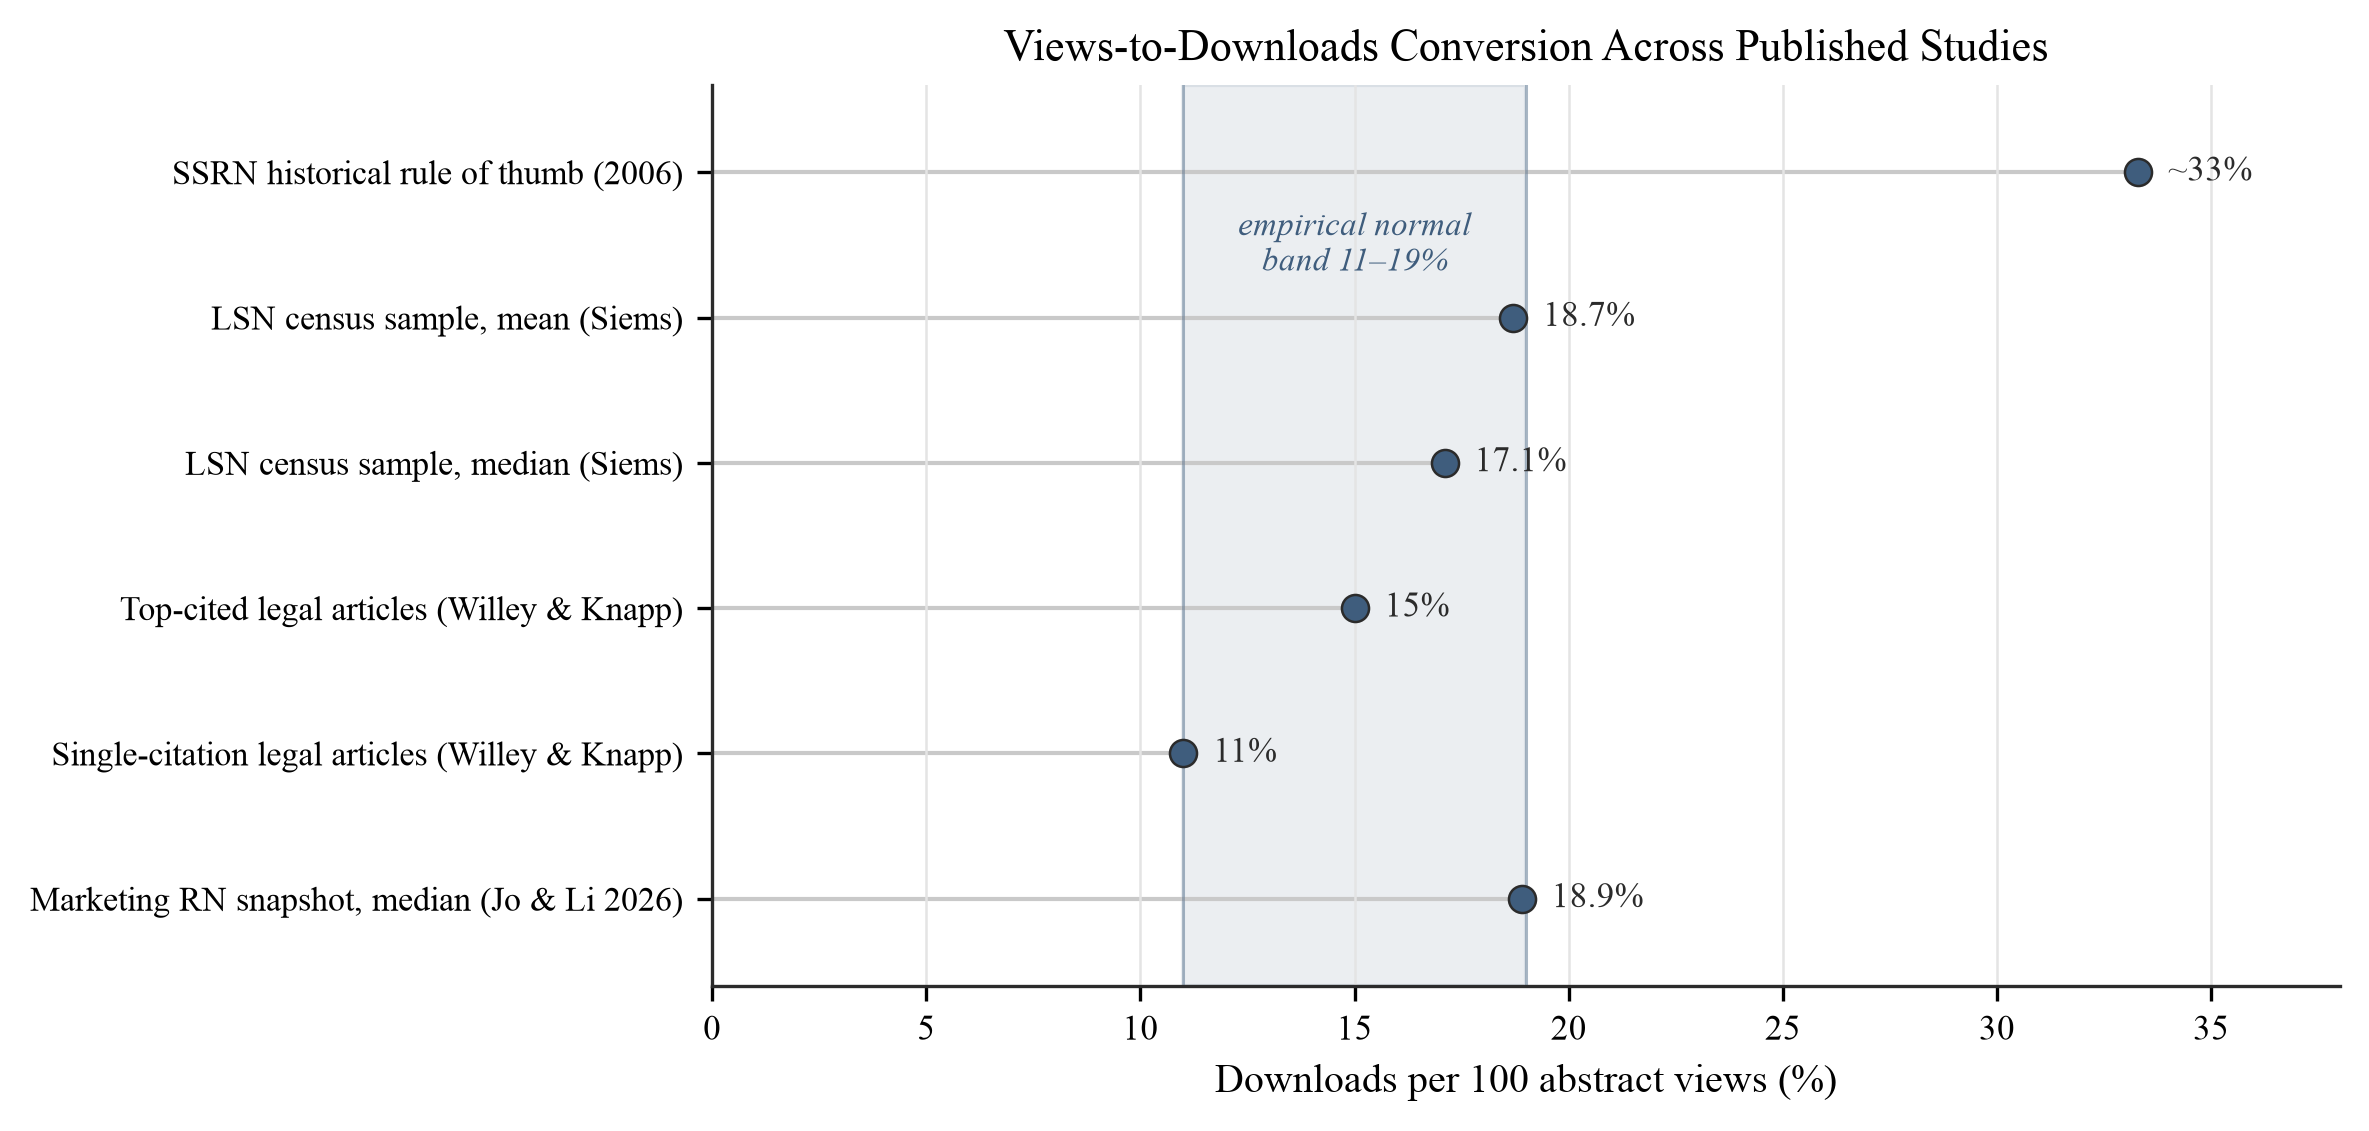
Рис. 6. Конвертація переглядів на завантаження в різних дослідженнях. Оцінки конвертації за опублікованим записом: історичне правило SSRN приблизно 33% (як повідомлялось у 2006) [18]; середнє значення перепису LSN 18,7% та медіана 17,1% [139]; 15% серед найбільш цитованих та 11% серед статей з однією цитатою з правничої сфери [172]; медіана 18,9 завантажень на 100 переглядів анотації у знімку Marketing Research Network 2025 [83]. Затінена смуга позначає емпіричний нормальний діапазон 11–19% — охоплення гетерогенних оцінок (медіани всієї мережі поряд з показниками підвибірки, вибраної за цитатами, чиї тип статистики джерело залишає невказаним); середнє значення вибірки Jo and Li (23,7 на 100) перевищує її. Усі значення опубліковані в цитованих джерелах; нових оцінок не введено.
Члени цієї смуги — це різні статистики різних вибірок, тому це охоплення гетерогенних точкових оцінок. Показники Siems (17,1%) та Jo and Li (18,9%) — це медіани вибірок усієї мережі, тоді як цифри Willey та Knapp 15% та 11% наводяться для підвибірок, вибраних за цитатами (найбільш цитовані порівняно зі статтями з однією цитатою з правничої сфери), чиї тип статистики джерело не вказує і чия вибірка є причиною того, що нижній край смуги знаходиться там, де він є. Верхній край ще м'якіший: середня конвертація у вибірці Jo and Li, 23,7 завантажень на 100 переглядів [83], лежить вище смуги, і різко відрізняється від співвідношення сукупних середніх цієї вибірки (221,346 ÷ 611,973 = 36,2 на 100). Те, що співвідношення середніх 36,2 лежить так далеко вище середнього значення відношень 23,7, само по собі є діагностичним. Оскільки співвідношення середніх алгебраїчно є зваженим переглядами середнім значенням коефіцієнтів конвертації для кожної роботи, його перевищення невзважених середніх відношень означає позитивну коваріацію між охопленням та конвертацією: роботи з більшим охопленням конвертуються дещо з вищими коефіцієнтами, а не нижчими. Читання консервативне: інфляція малих знаменників штовхала б невзважені середні відношення вгору, працюючи проти цього впорядкування, тому спостереження співвідношення середніх вище нього у будь-якому разі робить висновок про позитивну залежність більш надійним, а не менш.
Смуга надає центральний опрацьований приклад цієї статті. За опублікованими якорями, робота з 40 переглядами анотації, як очікується, дасть приблизно 4–8 завантажень. «7 завантажень» у назві, на 40 переглядах, є конвертацією 17,5%, точкова оцінка, яка попадає всередину смуги, але несе широку невизначеність при цьому знаменнику. Точний інтервал Clopper–Pearson 95% на 7 із 40 становить приблизно від 7,3% до приблизно 32,8%, охоплюючи смугу з обох сторін: лише 40 переглядів оцінка не може досягти точності смуги, тому читання є результатом скринінгу, а не класифікацією. Два фактори далі обмежують приклад. Знаменник малий (нестійкість, про яку йдеться далі), і порівняння не вирівняно за віком: 40 переглядів приблизно на день 20 — це читання на ранньому етапі життя, тоді як якорі медіани походять від зрілих вибірок (Siems за два роки [139], Jo and Li за медіанним віком роботи 491 день [83]), і Позиції 1 та 5 та Розділ 5.6 стверджують, що експозиція на ранньому етапі життя є іншим режимом, тому вісь віку не вирівняна. Обґрунтоване читання, отже, полягає в тому, що 17,5% узгоджується зі смугою перехресних досліджень як результат скринінгу, а не точний процентиль популяції, і не «безумовно всередину» нього. Стрес, який спричиняє така цифра, відбиває відсутність масштабу, а не відсутність читацької аудиторії. Вінтаж та обсяг лежачих в основі якорів викладені в Розділі 9.
Малі знаменники роблять відношення нестійким. Стаття з двома переглядами та одним завантаженням має номінальну конверсію 50%, але така оцінка заслуговує на не більшу впевненість, ніж та, що побудована на 500 переглядах; для будь-якого публічного бенчмаркування емпірико-баєсівське стиснення в напрямку ставки еталонного класу повинно запобігти тому, щоб малі знаменники створювали екстремальні оцінки (розділи 8.3 і 8.8). Смуга також працює як діагностика в обидва напрями. Конверсія далеко нижче смуги, при нетривіальному знаменнику, зазвичай свідчить про невідповідність між назвою–рефератом–текстом: читачі приходять, читають реферат і йдуть, це практична проблема комунікації (перепишіть назву та реферат), а не вердикт про якість дослідження. Конверсія далеко вище смуги сигналізує про трафік, який не пояснюється переглядом рефератів (висвітлення в ЗМІ, впровадження в курсах або вірусне розповсюдження) і повинна спонукати перевірку походження переглядів. Жодне відхилення саме по собі не встановлює нічого щодо якості дослідження. Подальше уточнення — це гіпотеза, а не висновок. Конверсія може систематично варіюватися в різних областях як властивість стилю читання аудиторії, а не окремих статей: великі поля можуть виявляти поведінку «прогулянки вікнами», з багатьма відвідуваннями рефератів і небагатьма завантаженнями, тоді як малі, сильно залучені спільноти конвертуються з вищими ставками. Смуга вище оцінюється за надто малою кількістю випадків, щоб це вирішити, тому Дослідження 1 (розділ 8.6) включає стратифіковану за областями конверсію серед своїх результатів.
Діагностика, ніколи не мета: обмеження проти маніпуляції. Смуга конверсії є потужною, тому що її можна читати як норму, і ця потужність несе небезпеку. Закон Гудхарта стверджує, що мара, прийнята як мета, перестає бути хорошою мірою [67], принцип, паралельний Закону Кемпбелла про корупцію соціальних показників, використаних для прийняття рішень [27]. Якби смуга 11–19%, або будь-який компонент структури бенчмаркування розділу 5.5, була прийнята як поріг просування ("статті повинні знаходитися всередині смуги конверсії, щоб рахуватися"), коефіцієнт відразу став би об'єктом оптимізації, а не спостереження. Атака є конкретною та дешевою: оскільки знаменник є більш маніпульованою величиною (розділ 4.2), координоване збільшення переглядів реферату у фіксованій пропорції до завантажень утримувало б коефіцієнт у смузі й зробило б штучний сигнал статистично невідрізним від органічної конверсії. Відповідь структури — це питання визначення. Смуга конверсії, діагностика охоплення–конверсії (розділ 5.4) і компоненти CSAB (розділ 5.5) є діагностичним вектором, ніколи не метою, і жоден компонент не може читатися як критерій просування. Механізм, що опирається маніпуляції, вбудований у дизайн: смуга зазначена як нижня межа, тому що її знаменник піддається надуванню ботом, тому читання консервативне щодо інфляції за конструкцією; протокол аномалій розділу 8.3 є позначка, не видалення, тому штучний скачок зберігається і робиться видимим, а не мовчазно поглинається; та фільтрування цілісності розділу 4.1 вже відсіює найбільш виявлювану координовану діяльність. Читаючи як діагностика, смуга розкриває маніпуляцію як позасмугове або внутрішньо несумісне означення; читаючи як мету, вона запросила б саму координацію, яку вона має на меті виявити. Це положення узгоджує структуру з встановленим консенсусом реформи оцінки досліджень: Декларація Сан-Франциско з оцінки досліджень (DORA), яка відкидає однозначні та журнально-брендові проксі на користь оцінки за власним змістом дослідження [8], і Лейденський маніфест, принципи якого застерігають проти саме цієї підстановки легкого показника замість експертного судження [78].
Завантаження не мають публічного журналу аудиту: подальша причина читати смугу як нижню межу. Структурна асиметрія між цитуванням і завантаженнями загострює занепокоєння щодо маніпуляції. Цитування залишає публічний, перевіряємий слід: цитуючий документ існує, є виявляємим і може бути перевірений, тому маніпулювання цитуванням в принципі піддається аудиту будь-якою третьою стороною. Лічильник завантажень не залишає такого публічного шляху. Це приватна сума на серверах платформи, без зовнішнього запису про те, які запити були враховані, відфільтровані або переформатовані, що залишає його унікально експонованим до прихованої маніпуляції, яку ніякий зовнішній спостерігач не може реконструювати після того, як це сталося. Ця експозиція є незалежною причиною, крім забруднення знаменника ботом, розглядати виміряну швидкість конверсії як нижню межу, а не точкову оцінку (підпорядковану застереженню розділу 4.2 щодо пошуку AI), і завжди спарювати лічильник з протоколом аномалій та документованим фільтруванням цілісності, на яке спирається структура (розділ 4.1). Відсутність журналу аудиту — це не причина недовіри до лічильника; це причина читати його консервативно та наполягати на дисципліні позначки-не-видалення, яка зберігає видимість маніпульованого показання (розділ 8.3).
Смуга є метою калібрування, а не константою. Один наслідок випливає з того, як цифра 11–19%, і кожен поріг CSAB, має бути процитована: це величини, які мають бути відкалібровані за областю та за платформою (розділи 4.4, 5.5). Механізм цієї калібрування вже зазначений: стратифіковане за областями Дослідження 1 (розділ 8.6) призначене для надання розподілів конверсії та завантажень на кожну область, які потребує структура, і побудоване для споживання. Поки Дослідження 1 не буде повідомлено, архівна розрізна вибірка додатка E надає оцінку, розмежовану за областю. У чотирнадцяти областях, що утримують щонайменше двадцять статей, медіанна конверсія коливається від 0.134 в енергетиці до 0.195 у комп'ютерній науці, розповсюдження близько 1,5 разу, і утримуючи вік статті фіксованим, вона коливається від 0.134 до 0.224, близько 1,7 разу. У порівнянні з розповсюдженням у три-п'ятираз завантажень, конверсія є більш портативною з цих двох величин, що робить її придатною як діагностика. Вік — це вимір, який вона не переживає: у кожній області, достатньо великій для тестування, конверсія падає, коли статті стають старішими, з коефіцієнтами Спірмена від −0.14 до −0.41 у восьми областях, що утримують щонайменше сорок статей. Смуга конверсії, процитована без віку статті, робить менше роботи, ніж здається.
5.3 Градуйована шкала інтерпретації
Автори Post-Rankings найбільш помітно не мають градуйованої шкали у встановленому форматі посібників з інтерпретації h-індексу [118], яка перетворює необроблені лічильники на простомовні діапазони. Розділи 5.1–5.2 надають інгредієнти для цього. Таблиця 8 представляє запропоновану шкалу для чотирьох величин: завантаження статей за все життя на рівні статті, завантаження в перший місяць, конверсія переглядів на завантаження та загальне завантаження на рівні автора.
Таблиця 8. Запропонована шкала інтерпретації метрик SSRN. Діапазони синтезують докази 2012–2015 років [139][85][18][172]; оскільки потік завантажень на статтю зріс з того часу (Розділ 5.1), їхні абсолютні пороги краще читати як поблажливі а не консервативні діапазони для 2026 року, і в будь-якому разі як наближення. Стовпець першого місяця не є відкаліброваним щаблем шкали, а попередньо зареєстрованим прогнозом з широкою невизначеністю, який буде перевірено планованою групою Дослідження 1 (Розділ 8.6); його клітинки не повинні розглядатися як пороги або щаблі просування (див. текст). Межа Strong/Exceptional на 10 000 є попередньою оцінкою автора: жодне опубліковане джерело, виявлене в аудиті Розділу 2.5, не пов'язує 10 000 завантажень із процентилем. Діапазон Nascent не вводить нові числа: його стель — це існуюча двирічна медіана якоря 63 [139]. Межі діапазонів встановлені на круглих числах і утримуються приблизно на ширину одного повного діапазону: стель точності, встановлена літературою про наукову цілісність (Розділи 3.1, 4.1–4.3), робить тонші градації хибно точними, тому грубість діапазонів навмисна. Стовпець простомовного вердикту описує завантаження шкалу тільки і не переносять на стовпець конверсії: медіана конверсії 18,9% є звичайною, а не «Solid», а p75 27,2% не «Strong». Межі завантажень за все життя не перетинаються за конструкцією (Nascent нижче 63, Modest 63–159, Solid 160 і вище); де таблиця друкує спільну кінцеву точку між вищими рядками — 800 між Solid і Strong, і відповідне скорочення конверсії та рівня автора — інтервал напіввідкритий, кожне спільне значення належить вищому діапазону. Два значення межі часу життя самі базуються на непорівнювальних референтних класах: 63 — це медіана двирічного вікна для перепису юридичної науки однієї дисципліни [139], тоді як 160 — це порог входження за все життя для списку найкращих на всій платформі [85]. Тому вони знаходяться на різних шкалах часу (фіксований двирічний вік статті проти необмеженого накопичення часу життя) і описують різні популяції (одна галузь проти всіх галузей), тому об'єднання їх в одну абсолютну драбину є комбінацією референтних класів з різними віками, галузями та правилами відбору — обмеження, яке мають усунути процентилі, специфічні для галузі та віку, Дослідження 1. Структурна межа цих якорів заслуговує наголосу: оскільки доступні референтні точки групуються біля двирічної медіани (63 [139]) та у верхньому хвості платформи, чотири з п'яти вербальних діапазонів — Modest, Solid, Strong та Exceptional — описують документи на рівні медіани або вище, тому шкала щільна вище медіани і дискримінує тільки слабко по широкому діапазону 50–98-го процентиля, в якому насправді падає більшість статей. Це стиснення є прямою наслідком якорення на доказах верхнього хвоста; розрізнення звичайного від просто-над-медіанного очікує на процентилі, специфічні для галузі та віку, Дослідження 1. Шкала ілюстративна, а не нормативна: жодна межа діапазону не повинна входити в рішення про звільнення, наймання або просування як поріг прохідності/невдачі, доки планована група Дослідження 1 (Розділ 8.6) не відкалібрує процентилі, специфічні для галузі та віку, для заміни цих застарілих абсолютних якорів.
| Діапазон | Стаття: завантаження за все життя | Стаття: завантаження в перший місяць (екстрапольовано) | Конверсія (завантаження / перегляди) | Автор: всього завантажень | Простомовний вердикт |
|---|---|---|---|---|---|
| Nascent | Нижче двирічної медіани 63 [139] | — (без окремого якоря; див. текст) | — (знаменник зазвичай занадто малий; Розділ 5.2) | — | Занадто рано або нижче медіани галузі — статистична норма для молодих та нішевих статей; спочатку діагностувати експозицію (Розділи 5.4, 5.6), а не якість |
| Modest | 63–159 | <15 | <11% | <~130 | Типово для платформи; медіанний діапазон |
| Solid | 160–800 | 15–50 | 11–19% | ~130–1,600 | На рівні або за межами історичного входження до списку найкращих |
| Strong | 800–10,000 | 50–250 | 19–30% | 1,600–10,000 | Типово для історичних списків найкращих |
| Exceptional | >10 000 (попередня оцінка автора) | >250 | >30% | >10 000 (попередня оцінка автора) | За межами документованого діапазону звичайної наукової циркуляції |
Кожен внутрішній якір пов'язаний з опублікованим порогом. Смуга Nascent охоплює регіон нижче медіани LSN за два роки (63) [139]. Цей регіон густонаселений, а не аномальний: заздалегідь визначені смуги Study 1 (розділ 8.6) передбачають, що значна частина статей платформи, на рівні 15–30% під рамками передбаченої смуги, мають десять або менше завантажень за все життя, тому шкала, найнижча смуга якої починалася б поблизу медіани, залишила б найчисленніші статті платформи, включаючи цю статтю, поза межами шкали. Висновок Nascent є неоціночним. Нижче медіани поля, особливо для молодих статей, лічильник не дозволяє жодної оцінки якості, і першим діагностичним кроком є експозиція (розділи 5.4 і 5.6), а не вміст. Смуга Modest прив'язана до медіани LSN за два роки (63) [139]. «Modest» — це медіанна смуга: типовість не є невдачею. Границя Modest/Solid (~160 завантажень за все життя) є точкою входу Kakushadze до зареєстрованих за всі часи Top-10,000 статей, що становить приблизно топ 1,8% фонду повнотекстових статей платформи (571 040, липень 2016 р. [1]) [85]. Функціонально «Solid» стаття є статтю з топ-списку. Границя Solid/Strong (~800) є медіаною в межах цієї еліти (805) [85]: вона розділяє статті, які просто входять до історичної еліти, і статті, типові для неї. У портфельній шкалі стовпець рівня автора повторює цю логіку: група, описана у власних повідомленнях SSRN як топ 10% авторів [161], мала мінімум входу 129 всього завантажень та внутрішню медіану 1626 [85]. Оскільки кожен якір рівня автора узятий з цього рейтингового списку, стовпець автора описує верхній хвіст розподілу авторів, а не типового автора. Автор нижче межі ~130 не просто «Modest»: цей автор повністю виходить за межи історично рейтингової групи, тому нижні смуги стовпця читаються як «нижче історичної еліти», а не як відкалібрована позиція серед усіх авторів. Це те ж саме якорення верхнього хвоста, що стискує шкалу рівня статей; якорі стовпця автора очікують на перцентилі рівня портфеля від Study 1. Стовпець конверсії є міжекспериментальною смугою розділу 5.2. Границя Strong/Exceptional при 10 000 не має опублікованого якоря перцентиля й зберігається як горизонт порядку величини.
Стовпець першого місяця має інший статус. Це заздалегідь зареєстроване передбачення, спростовний прогноз із широкою невизначеністю, яку Study 1 (розділ 8.6) розроблено для тестування, і жодна комірка першого місяця не може використовуватися як поріг або інтерпретаційний щабель. У опублікованій літературі не існує прямого еталона першого місяця, тому стовпець є проекцією, а не виміром, екстрапольованою з документованої ранньої концентрації завантажень (піки уваги групуються в перші тижні, особливо під зовнішнім покриттям [18][116][138]) на наведені вище пороги завантажень за все життя. Певні границі походять з одного опублікованого якоря: у вибірці топ-списку Kakushadze, приблизно топ 1,8% фонду повнотекстових статей платформи (571 040, липень 2016 р. [1]), медіанна кількість дванадцятимісячних завантажень становила 247 [85]. Перший місяць вище ~250 таким чином перевищував би річну норму історичної еліти платформи, звідси границя Exceptional, тоді як 15–50 завантажень першого місяця, якби вони тривали, проектуються на поріг входу ~160 за все життя, звідси Solid. Ці комірки є проекціями з одного історичного якоря й є найслабшими комірками таблиці; якщо їх цитують, слід зазначати цю похідну.
Два застереження регулюють використання шкали. Дисциплінарний кваліфікатор не є факультативним: у межах однієї дисципліни середні завантаження на статтю відрізняються приблизно у восьм разів на підполях (438,35 у Corporate/Securities/Finance Law проти 53,48 у Agricultural Law) [168], тому кожне твердження смуги має мати мітку поля. Це середні значення за все життя й не коригуються за віком статті, і архівна вибірка додатку E показує, чому це важливо: очевидний рівень поля рухається з профілем віку статей, вибраних з нього, а утримання віку фіксованим звужує розповсюдження приблизно до трьох-п'яти разів. Друге полягає в тому, що альтернативні однопараметрові евристики, запропоновані у цьому просторі (індекси відносної продуктивності на основі коефіцієнтів (завантаження статті, поділені на медіану співставної когорти), логарифмічні евристики рівнів на основі ⌊ln D⌋ та вердикти вербальної картки оцінок («швидкий старт / стійкий інтерес / повільний старт»)), тут охоплюються як неокалібровані евристики авторів, оскільки жодна не має перевірених числових смуг. Сама логарифмічна інтуїція обґрунтована й варта збереження в словах: у квазілогнормальному розподілі [85], переміщення від 7 до 20 завантажень — це зміна на одну одиницю натурального логарифма видимості, і розуміння як додавання 13 кліків упускає це.
Шкала також пояснює чому автори систематично неправильно оцінюють свої лічильники. Числа, що циркулюють у віхах, профілях та оголошеннях, походять, як задокументовано в розділі 3.5, з видимого хвоста в сотні разів вище медіани, тоді як маса розподілу знаходиться поблизу медіани LSN 63, і під квазілогнормальним законом відстані між щаблями є мультиплікативними, а не адитивними. Рисунок 7 організовує ці значення (медіана звичайних статей, пороги входу, медіани еліти, хвіст) як еталонну драбину на логарифмічній шкалі.
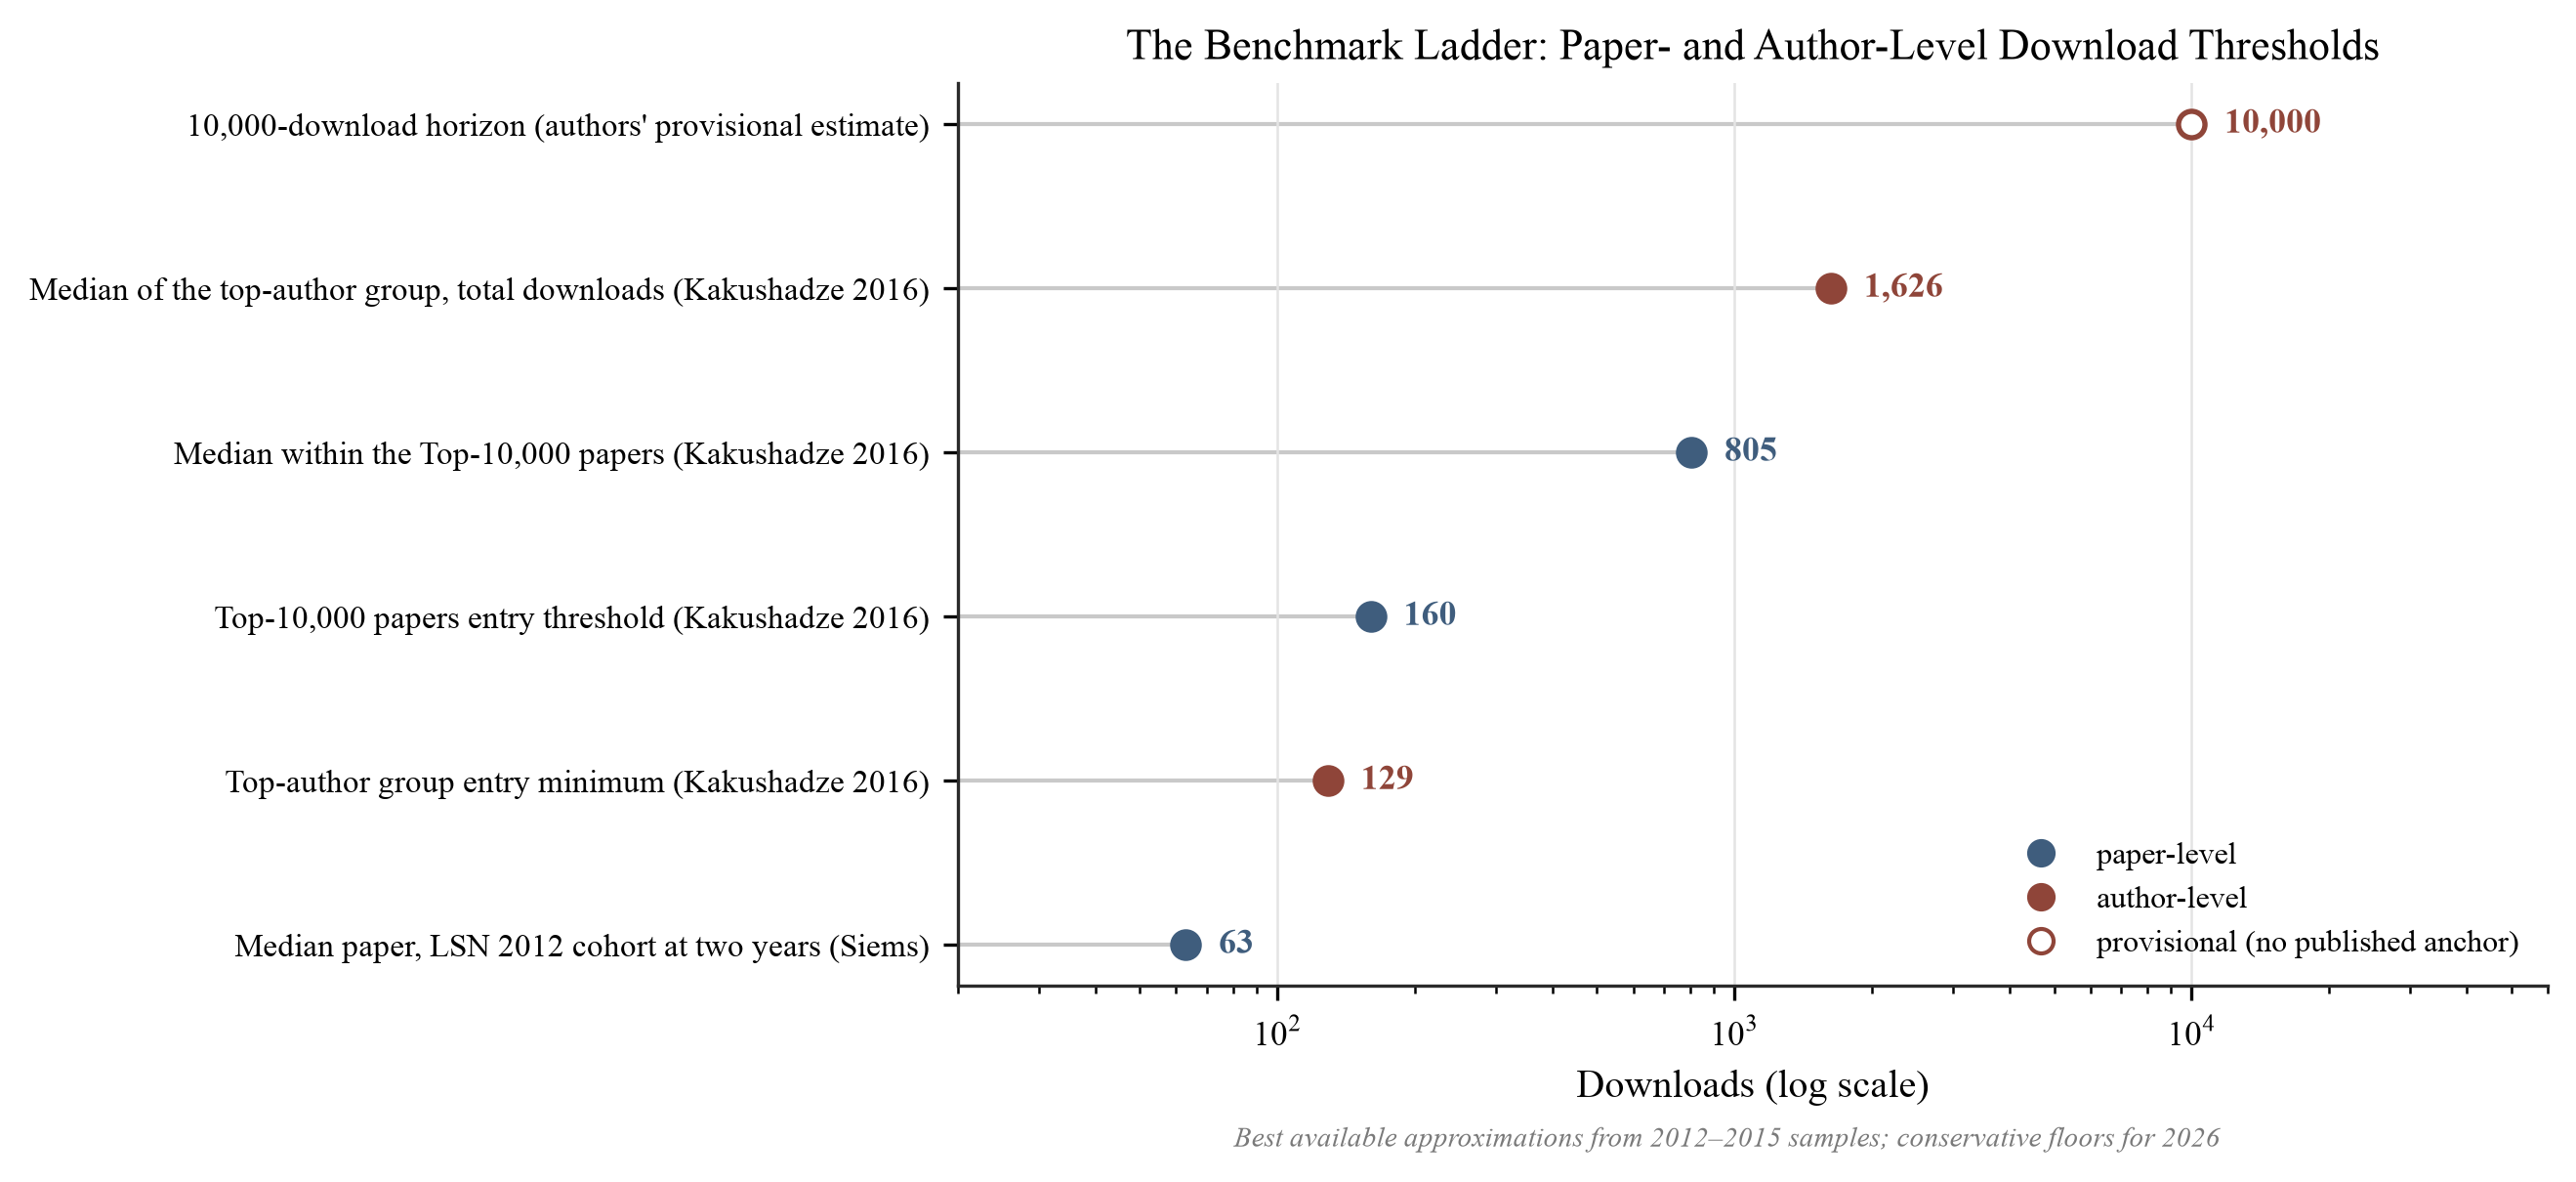
Рисунок 7. Еталонна драбина. Пороги завантажень рівня статей та авторів на логарифмічній шкалі: медіана LSN за два роки 63 [139]; мінімум входу топ-автора 129 та вхід топ-статей ~160 [85]; медіана в межах Top-10,000 статей 805 [85]; медіана групи топ-авторів 1626 [85]; горизонт 10 000 завантажень (попередня оцінка автора, немає опублікованого якоря перцентиля). Регіон нижче медіани за два роки 63 відповідає смузі Nascent таблиці 8. Значення походять зі зразків 2012–2015 років (інфляція з тих пір: розділ 5.1).
5.4 Охоплення та конверсія: двовимірна діагностика
Однократний підрахунок, навіть розбитий на діапазони, не може розрізнити різні механізми, що його генерують. Механіка розділу 4 має одне значення, що найбільше важить на практиці: невидимість та нереагування на вміст — це різні діагнози: стаття може бути мало завантажена, оскільки мало читачів з нею зустрілися, або оскільки ті, хто з нею зустрівся, відмовилися від повного тексту. Таблиця 9 поєднує два нормалізовані виміри.
Таблиця 9. Матриця діагностики охоплення–конверсії. Охоплення та конверсія оцінюються як процентилі в межах референтного класу порівнюваних статей (та сама дисципліна, когорта публікації, вік статті та попередня видимість автора; розділ 5.5), з медіаною класу як межею. Жодне абсолютне числове значення порогу не обґрунтовується на поточних доказах, і жодне не наводиться. Дисплей 2×2 дихотомізує кожну вісь на медіані класу для зручності; базові процентилі охоплення та конверсії є неперервними (розділ 5.4), і доступні тонші розділення, такі як терцилі.
| Низька конверсія | Висока конверсія | |
|---|---|---|
| Низьке охоплення | «Холодний старт» (низьке охоплення, низька конверсія). Стаття не зустрічається широко і не часто завантажується після експозиції. Дані не встановлюють, слабким чи є базове дослідження; вони встановлюють лише те, що дифузія ще не розпочалася. | «Прихований інтерес» (низьке охоплення, висока конверсія). Читачі, які зустрічаються зі статтею, реагують добре, але з нею зустрічається надто мало людей. Виявляємість є основною видимою вузькою місцем — це проблема розповсюдження, а не проблема змісту. |
| Високе охоплення | «Увага без засвоєння» (високе охоплення, низька конверсія). Заголовок, тема або розміщення на платформі, як видається, привертає відвідування, але мало відвідувачів отримує повний текст. Виключіть забруднений знаменник перед діагностуванням невідповідності комунікації: високе охоплення може бути фантомними переглядами а не справжньою увагою, оскільки перегляди є більш забрудненим з двох лічильників (розділ 4.2) — у прозорому записі RePEc/LogEc роботи становили приблизно 74 % переглядів анотацій, але лише близько 7 % завантажень [99], тому нефільтроване нелюдське трафік створює саме цей підпис високого охоплення, низької конверсії. Лише коли виключено перегляди, завищені ботами, залишкові дані обґрунтовують дослідження відповідності аудиторії та комунікації заголовку і анотації. | «Сильна ранна дифузія» (високе охоплення, висока конверсія). Стаття досягає порівняно великої аудиторії і перетворює експозицію на інтерес до повного тексту. |
Чотири квадранти позначені дифузійною закономірністю, яку показують два процентилі (холодний старт, прихований інтерес, увага без засвоєння, сильна ранна дифузія). Мітки описують закономірність дифузії, а не саме дослідження, і операційно важливим є розділення механізмів; жоден квадрант низького охоплення не дає підстав для висновку про якість дослідження — момент, що безпосередньо впливає на будь-яке оцінне використання цих показників. Квадрант низької дифузії отримує назву власної діагностики цієї статті — холодний старт. Матриця має практичну цінність, оскільки відповідне втручання відрізняється за квадрантами: кандидат на прихований інтерес потребує розповсюдження (перегляду класифікації, часу оголошення, зовнішньої видимості), тоді як увага без засвоєння вимагає ремонту комунікації (заголовку та анотації) або аудиту трафіку. Рисунок 8 представляє площину як шаблон.
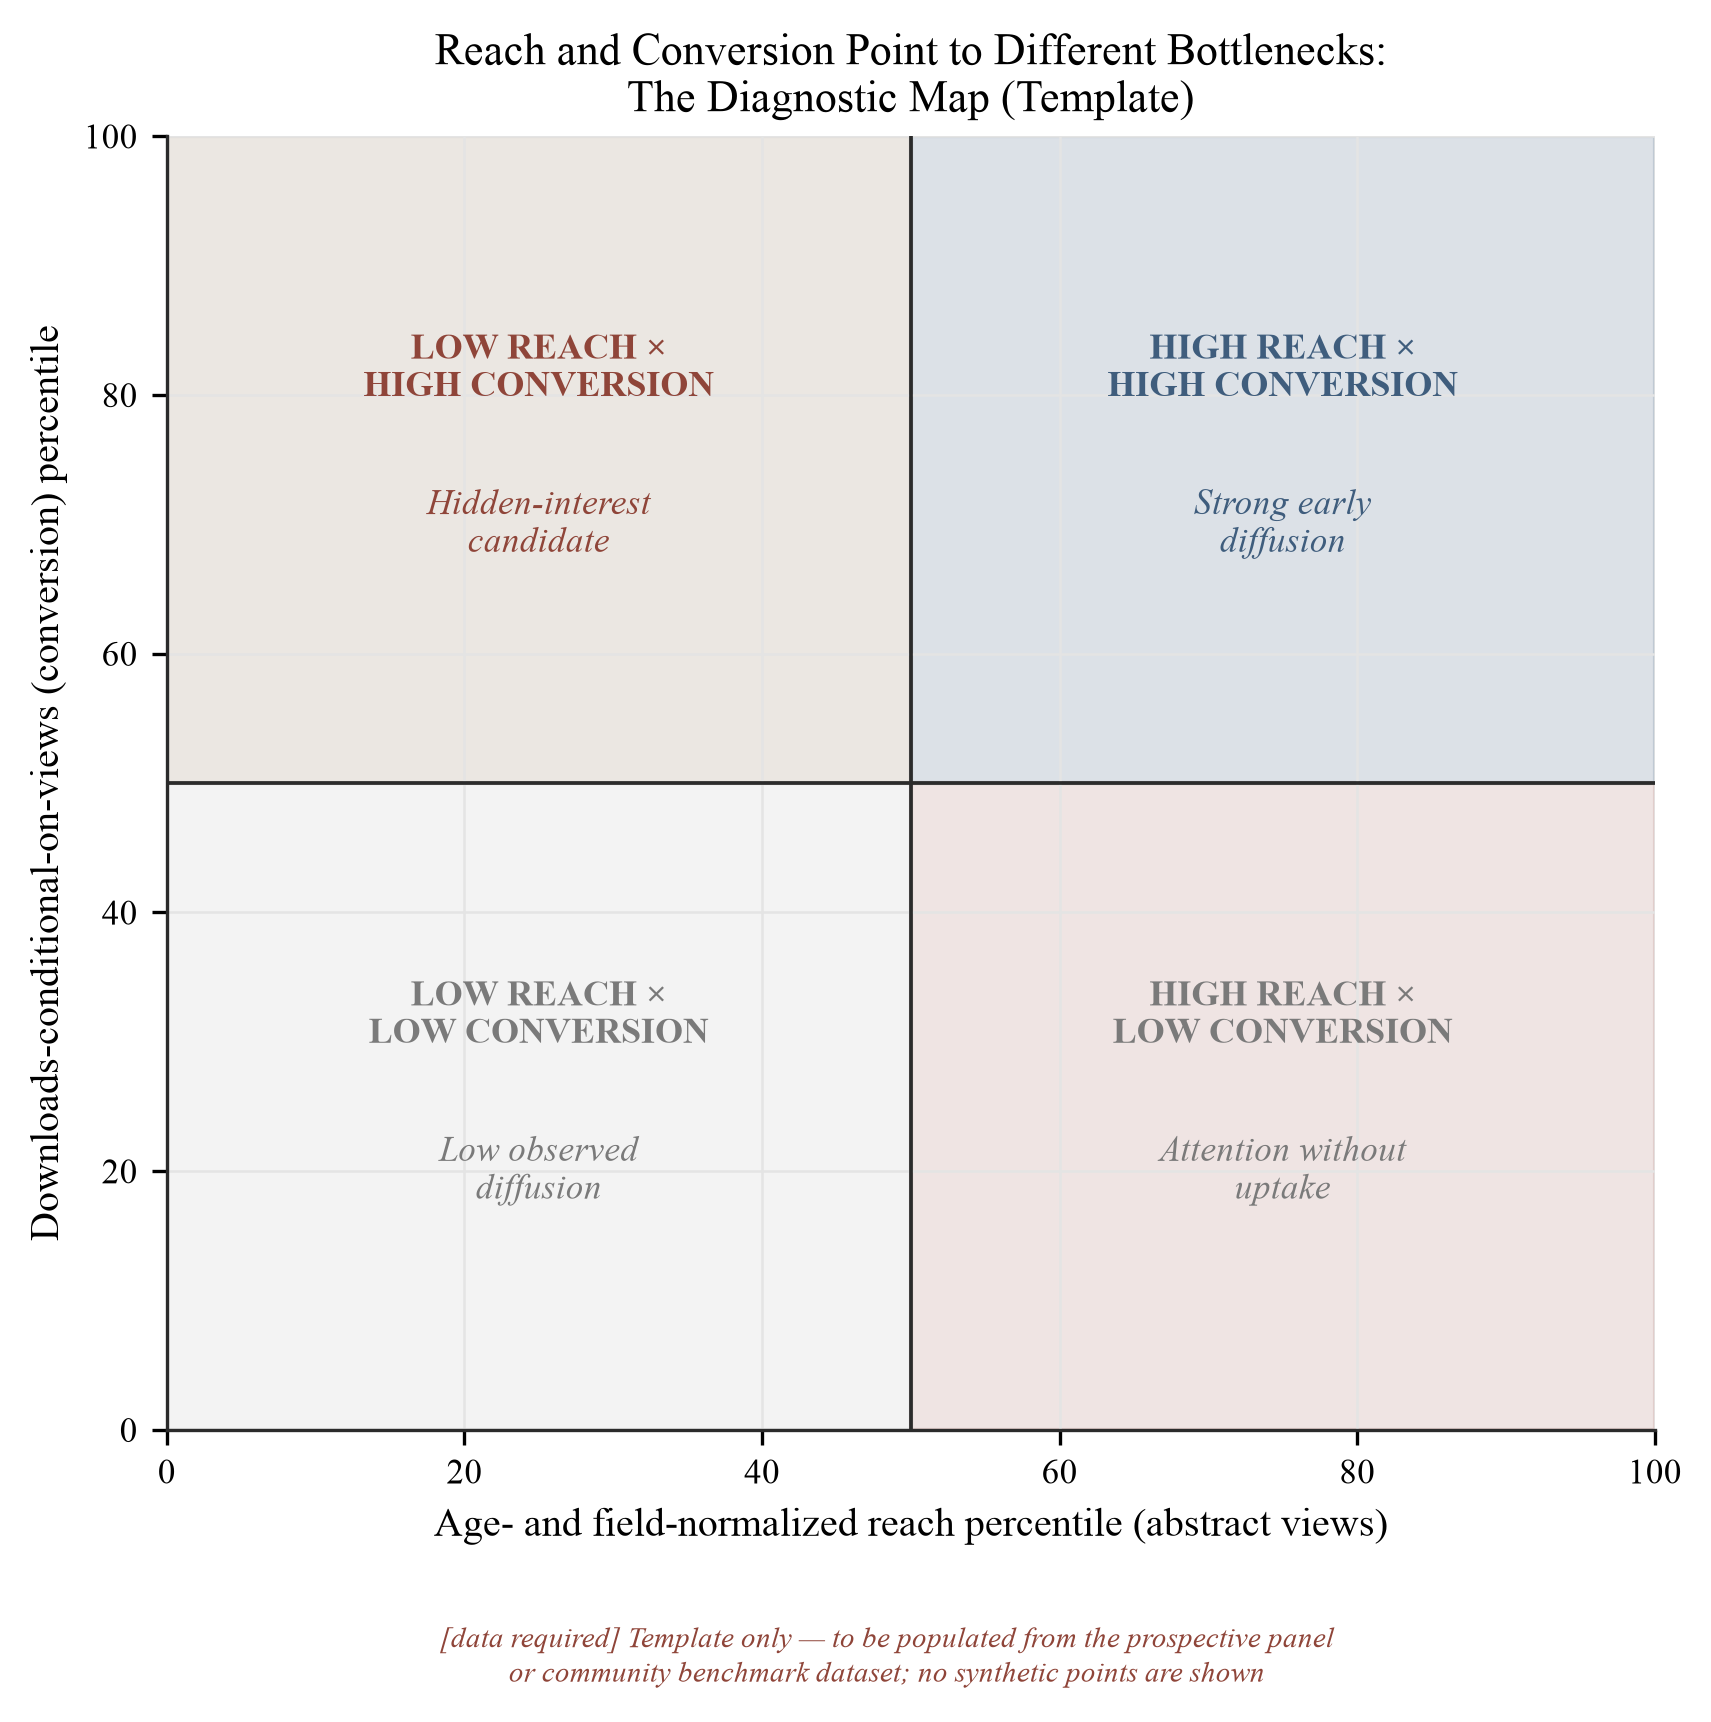
Рисунок 8. Карта охоплення–конверсії. Шаблон для позиціонування статей за нормалізованими за віком, дисципліною, когортою та видимістю авторів процентилями переглядів (охоплення, горизонтально) та обумовленими переглядами процентилями завантажень (конверсія, вертикально), з квадрантами як у таблиці 9 (холодний старт, прихований інтерес, увага без засвоєння, сильна ранна дифузія). Верхній лівий квадрант виявляє статті з конверсією вище медіани попри охоплення нижче медіани, клас, який сирі підрахунки завантажень систематично недооцінюють. Емпіричні значення не показані; карта має бути заповнена з перспективної панелі або набору даних контрольного показника спільноти розділу 8.
5.5 Від основної цифри до еталону: розміри CSAB
Кожна з попередніх підсекцій виправляє один режим відмови в сирому лічильнику, а Cold-Start Scholarly Attention Benchmark (CSAB) є цією інтеграцією: рамка звітування, яка замінює єдину основну цифру п'ятьма нормалізованими компонентами (Таблиця 10). Змінні нормалізації (вік статті, галузь, когорта опублікування та попередня видимість автора), кожна емпірично обґрунтована: сукупні показники механічно зростають з віком; норми галузі в середньому відрізняються на порядок величини [168]; календарні умови вимірно змінюють увагу (доступи до статей падають ~11% у вихідні дні та ~50% у літні місяці [178]); і новачок на платформі не має тієї ж початкової аудиторії, що й встановлений автор [83]. Одна конвенція популяції має бути зафіксована перед обчисленням будь-якого процентиля. Сукупний лічильник визначається над запасом статей з гетерогенним виживанням (статті іноді вилучаються, об'єднуються або замінюються пізнішими версіями), тому кожен процентиль CSAB є твердженням про запас статей, що пережили, на дату спостереження. Дослідження 1 (Розділ 8.6) заздалегідь визначає правило включення (обробка версій, вилучення та розв'язання дублікатів) замість того, щоб залишити еталонну популяцію неявною.
Два центральні компоненти допускають компактне визначення. Для статті i віком τ (днів з моменту опублікування), у галузі f, когорті опублікування c та шарі попередної видимості s:
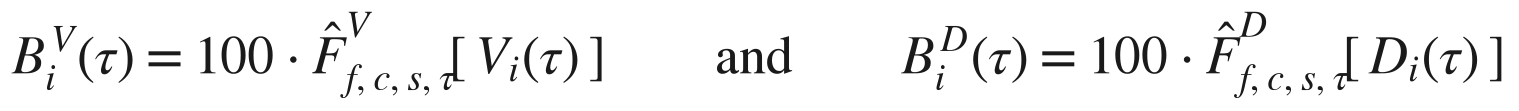
де V_i(τ) та D_i(τ) є кумулятивними переглядами анотацій та завантаженнями, а F̂^V, F̂^D є емпіричними функціями розподілу цих підрахунків у межах еталонного класу, визначеного f, c, s, та τ. Визначення фіксує цільовий параметр, процентиль у межах зазначеного еталонного класу. Жодна F̂ не може бути записана сьогодні, оскільки еталонні розподіли не існують (Розділ 5.1). Формула є специфікацією, яку дослідження 1 та панель Розділу 8 розроблені для оцінки, і однакове позначення переноситься через конструкцію прогностичної валідації Розділу 8.9. Нормалізація за процентилем та еталонним класом сама по собі є встановленим бібліометричним методом: процентилі є стандартним способом нормалізації кількості публікацій за галуззю, типом документа та роком публікації [22], з спеціальними процедурами для нормалізації за галуззю та часом показників, які домінуються нулями [23], саме те, чим займається лічильник завантажень. Нормалізація показників використання конкретно (завантажень та переглядів замість цитувань) за еталонним класом також є зрілою лінією роботи: література з бібліометрії використання давно розглядає вплив на основі завантажень як розподіл, обумовлений характеристиками спільноти користувачів та кадру вибірки [92][19], а програми журналу-фактора-використання побудували саме такі нормалізовані показники використання з даних, сумісних із COUNTER [137]. Стандартизація самого підрахунку використання є предметом розвиненої інфраструктури практиків, Кодексу практики COUNTER [125]. Нормалізовані за галуззю показники читаності мають порівнянний встановлений прецедент у літературі альтметрики [179]. Метод тому встановлений. Внесок тут полягає в його застосуванні до завантажень SSRN та конструюванні еталонного класу, стратифікованого за віком, галуззю та когортою, для середовища після рейтингів.
Цільовий параметр є добре визначеним, але три питання операціоналізації мають бути вирішені перед тим, як будь-яка F̂ буде вилаштована. Перше є найбільш суттєвим, оскільки воно стосується того, для чого служить еталон. Обумовлення еталонного класу попередньою видимістю автора (стратум s) є правильним, коли питання є діагностичним: «як цей документ розвивається серед порівнянних документів порівнянно видимих авторів?» Це повністю неправильно, коли питання є питанням справедливості H1–H3, оскільки нормалізація за попередньою видимістю усуває розрив новачок–встановлений, який рамка справедливості призначена вимірювати. Процентиль в межах s не може виявити дефіцит холодного старту, оскільки дефіцит був обумовлений за конструкцією. Рамка тому розділяє два різні використання CSAB, які ніколи не мають бути об'єднані в одне число. Як описовий еталон він повідомляє про позицію автора в повністю стратифікованому еталонному класі (включаючи s), що є тим, чого хоче окремий автор на інформаційній панелі. Як коригований цільовий параметр для H1–H3 він видаляє попередню видимість з набору обумовлення та розглядає її як предиктор інтересу, вимірюючи градієнт замість видалення його. Дві відповіді відрізняються, вони відповідають різним питанням, і будь-який звіт, який представляє нормалізований за видимістю процентиль, має вказати, який з двох це є. Друге питання – розмір вибірки. Стратифікація за галуззю × когорта × стратум видимості × вісім точок віку швидко вичерпує імовірнісну вибірку 3000–5000 документів (Розділ 8.6): кількість повністю перехресних комірок становить тисячи, тому більшість комірок малі або порожні. Емпіричне Байєс-сжимання до ширших еталонних класів названо для цієї причини (Розділи 8.3, 8.8), але сжимання вимагає своєї специфікації: мінімальна ієрархічна структура (галузь в межах широкої області, вік в межах грубої групи віку) та попередньо визначене правило мінімальної комірки для оцінки, нижче якого комірка запозичує від батька замість повідомлення про сирий процентиль. Це правило мінімальної комірки на стороні оцінки відрізняється від, і суворіше міркувати про нього, ніж правило мінімальної комірки, керованого приватністю, яке керує публічним випуском у Додатку D; ці два служать різним цілям і виконуються окремо. Останнє питання – імпульс (Таблиця 10), визначене як зміна в оціненій нормалізованій позиції. Показник змін у оціненій величині запрошує регресію до середнього: документ, який приходить високо на день 7 частково через шум оцінки, матиме тенденцію падати до дня 30 з чисто статистичних причин. Імпульс тому вимагає явної моделі основної траєкторії (наприклад, оцінки сжимання або емпіричного Байєса прихованої позиції з розповсюдженою помилкою вимірювання) замість сирої різниці двох миттєвих знімків процентилю, і сира різниця повідомляється, якщо взагалі, тільки як описовий супровід до модельованої величини.
Таблиця 10. Benchmark холодного старту наукової уваги (CSAB): п'ять вимірів замість одного числа. Копіюваний шаблон звітування на рівні речення для цих вимірів наведено в Додатку B.
| Вимір | Метрика | Основне питання | Інтерпретація |
|---|---|---|---|
| Охоплення | Age/field/cohort/newcomer-normalized view percentile | Чи зустріли відповідні аудиторії цю роботу? | Виявлення |
| Показники завантажень | Normalized cumulative download percentile | Скільки повнотекстових придбань сталося порівняно з порівнюваними роботами? | Загальна ранна дифузія |
| Конверсія | Downloads conditional on view opportunities (Section 5.2) | Чи прагнули читачі, які познайомилися з роботою, отримати повний текст? | Умовна залученість |
| Динаміка | Change in normalized position or interval-level attention | Чи прискорюється дифузія, залишається стабільною чи затухає? | Часова траєкторія |
| Подальша валідація | Later citation or use conditional on early metrics | Чи передбачила рання увага подальше наукове сприйняття? | Прогностична валідність |
Фреймворк відхиляє будь-який універсальний сирий поріг «успіху». Успіх має бути визначений відносно аналітичної мети: для виявлення — високий перцентиль охоплення серед робіт того ж віку та галузі; для читацького засвоєння — конверсія вище еталонного класу, умовна на експозицію; для дифузії — спільний розподіл двох; для наукового впливу — подальші цитування або документоване використання. Раннього використання самого по собі недостатньо для останної мети, оскільки ранні завантаження пояснюють лише приблизно 16% дисперсії подальшого цитування [25]. Це робить інтерпретацію прикладу заголовка точною. Сім завантажень — це «добре» лише тією мірою, наскільки сім завантажень розміщує роботу необично високо серед інших порівнюваних робіт на тому ж етапі їхнього життєвого циклу. Значення за день-7 та значення за день-180 не можуть оцінюватися за одним бенчмарком.
Чотири дизайнерські рішення відповідають восьмому принципу Лейденського маніфесту: що кількісні показники не повинні перевищувати силу припущень, на яких вони базуються, і що хибна точність сама по собі становить помилку вимірювання [78]. Фреймворк повідомляє діапазони, а не точкові оцінки (Таблиця 8); він фіксує CSAB як діагностичний вектор, а не ціль (Розділ 5.2); він малює свої вихідні цифри, карту охоплення–конверсії (Рисунок 8) та веєр бенчмарку (Рисунок 14), без чисельної шкали, так щоб форму не можна було помилити з каліброваною величиною; і він приєднує рівень верифікації та дату до кожного числа, яке використовує (Таблиця 7). Кожне з цих утримує точність, яку докази не можуть підтримати, як просить DORA від оцінювання досліджень, коли вона відхиляє однозначні та журнальні проксі для змістовної оцінки змісту роботи [8]. Згортання CSAB назад в один бал повторно введе саме хибну точність, про яку обидва документи попереджають.
Для автора звітування CSAB замінило б простий запис «Завантажень: 12» чимось на кшталт цього: 12 завантажень через 14 днів: загальний перцентиль завантажень серед порівнюваних робіт: 67-й; перцентиль охоплення: 39-й; перцентиль конверсії: 81-й; інтерпретація: висока умовна цікавість, нижче медіани експозиція. Кожне число в цьому макеті є ілюстративним, оскільки такі перцентилі не існують, поки не будуть оцінені еталонні розподіли Розділу 8, і жодне з цих значень не може бути процитоване як бенчмарк, але формат показує, що дає розкладання. Той самий сирий підрахунок, що видається просто розчаруванням, розпадається на конкретний діагноз: читачі, які познайомилися з роботою, реагують необично добре, але занадто мало людей її зустрічають, тож рекомендована дія — поширення, а не переробка. Опрацьований приклад є відповідником CSAB квадранту «прихованої цікавості» Таблиці 9. Додаток B встановлює цей формат як копіюваний шаблон звітування, чиї поля перцентилів залишаються порожніми, поки не існують розподіли Розділу 8.
5.6 Траєкторії читання: експозиція є втручанням, а не фоновим шумом
Остатній компонент структури є часовим: новоопублікована стаття не входить до однорідного середовища уваги. Вона проходить через чіткі режими експозиції (розміщення → внутрішнє виявлення → розповсюдження електронною поштою → зовнішнє індексування → дифузія в мережі), а кумулятивна сума об'єднує ці режими в одне число. Межи режимів встановлюються механізмами розділу 4: розповсюдження eJournal керується і може тривати до 45 днів у темах із великим обсягом [53], а зовнішнє індексування пошуку може займати 6–9 місяців або більше [55].
Найбільш тривожний стан панелі випливає безпосередньо з цього: нульові завантаження на першому тижні є нормальним передрозповсюдженням, а не відмовою. Перш ніж цикл оголошення завершиться, стаття ще не була представлена своїй основній аудиторії. Діагностична послідовність для раннього нуля є адміністративною: підтвердити, що стаття опублікована публічно; підтвердити призначення eJournal; дочекатися завершення циклу оголошення; тільки тоді читати лічильники. Навпаки, першомісячні показники, після здійснення розповсюдження, є найранішим і найшумнішим провідним індикатором: ранні завантаження корелюють з подальшими цитуваннями приблизно r ≈ 0.4 [25], інформативно, але далеко від вироку, і ранні сплески часто є подіями експозиції (блоги або медійне висвітлення) на противагу стійкому інтересу [116][138].
Оскільки ретроспективне скребання кумулятивних значень не може реконструювати, скільки завантажень мала стаття на день 3 або день 30, інтерпретація на основі траєкторії (і дослідницька програма розділу 8) вимагає спостереження від моменту опублікування на стандартизованій сітці. Таблиця 11 визначає мінімальний графік. Вона також служить шаблоном для самостійного відстеження окремими авторами. Траєкторія класифікується тільки попередньо при читанні на 60- та 90-денних позначках сітки таблиці 11 і з впевненістю при читанні на 180-й день, ніколи на день 7.
Таблиця 11. Мінімальний графік поздовжнього спостереження для праць SSRN.
| Вік статті | Основна мета спостереження |
|---|---|
| День 1 | Негайна експозиція платформи |
| День 3 | Дуже раннє виявлення |
| День 7 | Першотижневий тест (очікуване значення для більшості статей: на нулі або біля нуля, передрозповсюджування) |
| День 14 | Ранняя стабілізація |
| День 30 | Першомісячний тест |
| День 60 | Розповсюдження та дозрівання пошуку (цикли eJournal завершені [53]) |
| День 90 | Середньострокова рання дифузія |
| День 180 | Перехід до вимірювання подальшого впливу |
Де це можливо, щоденне спостереження протягом перших 45 днів є переважним, оскільки розповсюдження електронною поштою може відбутися в різні часи в цьому часовому вікні [53]. Інтервальні читання на цій сітці перетворюють панель зі статичного вироку в траєкторію, єдину форму, в якій ранні метрики SSRN мають обґрунтовану інформацію.
Розділи 4 і 5 замінюють питання, на яке автор не може відповісти («чи добре 7 завантажень?»), на чотири питання, які може підтримати опублікований запис: де розташовується кількість відносно еталонної карти та її років (5.1, 5.3); чи знаходиться конверсія всередині емпіричної смуги (5.2); у якому квадранті площини охоплення–конверсії міститься стаття (5.4); та що показує траєкторія на сітці спостереження (5.6)? Жодне з цих питань не вимагає припинених рейтингів, але всі вони вимагають порівняльних даних, збір яких пропонують остатні розділи цієї статті.
6. Практичний посібник для авторів
Еталонна карта розділу 5 (таблиця 7) відновлює відсутній масштаб, і цей розділ застосовує її для автора, який відкриває панель статистики після 15 липня 2026 року і бачить показники без контексту [148][149]. Вона має чотири завдання по черзі: процедуру для спостереження власних лічильників (6.1–6.2), замінники для порівняльної схеми, яку раніше надавали рейтинги (6.3), важелі, які можуть законно підвищити видимість (6.4), та протокол для перетворення лічильників у обґрунтовану кар'єрну доказ (6.5–6.6). Кожна числова опора, використана тут, веде до опублікованого джерела з явним планом вибірки та часовим вікном; таблиця 7 їх консолідує. Практики, що циркулюють у співтоваристві авторів і які не мають доказової підтримки, позначаються як непровірені, де б вони не з'явилися, і збираються як гіпотези-кандидати для тестування в кінці додатка А.
Таблиця 12 стискає суть посібника в протокол семи питань, заданих по черзі, кожне спаровано з доказами, вартими збереження, та найсильнішим висновком, який відповідь може законно дозволити. Розділи 6.1–6.2 розгортають цей протокол в процедури та правила читання, а таблиця 23 (додаток А) залишається її ситуаційним супутником, індексованою станами панелі, які автори насправді зустрічають.
Таблиця 12. Протокол автора для інтерпретації лічильника SSRN: сім питань, докази для збереження та допустимий висновок. Жоден крок не розглядає лічильник як оцінку якості; остатній стовпець визначає верхню межу того, що може підтримати кожна відповідь.
| Крок | Питання | Докази для збереження | Допустимий висновок |
|---|---|---|---|
| 1 | Скільки років було статті, коли спостерігався лічильник? | Датована скрінлот або експорт, плюс дата розміщення | Спостереження, специфічне для часу, а не довічний вирок |
| 2 | Чи сталися керовані розповсюдження та зовнішнє індексування? | Сповіщення про розповсюдження та дата, де доступна; статус індексу пошуку | Ідентифікація передекспозиційного порівняно з постекспозиційним режимом (розділ 5.6) |
| 3 | Що таке перегляди, завантаження та конверсія разом? | Як лічильники, так і знаменник | Діагноз охоплення та умовної взаємодії (таблиця 9), а не єдиний вирок |
| 4 | Що таке найбільш вузький обґрунтований референтний клас? | Поле, когорта, вік статті, статус новачка, історія класифікації | Відносне становище тільки в межах цього класу (розділ 5.5) |
| 5 | Чи змінюється траєкторія? | Повторні спостереження на фіксованих віках таблиці 11 | Імпет або плато, підлягаючи подіям експозиції — не прискорення «якості» |
| 6 | Чи є подальше підтвердження? | Цитування, суттєві контакти, публікація або задокументоване використання | Багатошарові докази впровадження, а не докази якості |
| 7 | Чи можна відтворити твердження? | Джерело, дата, правило підрахунку, архівний запис | Звіт для аудиту, а не необґрунтована веха |
6.1 Процедура вимірювання
Інтерпретація починається з дисциплінованого запису, оскільки SSRN відображає лише поточні сумарні підрахунки і жодну історію під контролем автора. Шість кроків, застосованих з дня розміщення, створюють мінімальний запис, який вимагає кожне подальше висновування.
1. Запишіть обидва лічильники та їхнє співвідношення. Зверніть увагу на перегляди анотацій, завантаження та коефіцієнт конверсії завантажень до переглядів у фіксовані інтервали. Сітка спостереження з Таблиці 11 (дні 1, 3, 7, 14, 30, 60, 90, 180) визначає розклад та призначення кожного показання. Датований знімок екрана у кожному інтервалі — це єдина версія запису, який контролює автор, оскільки лічильники платформи можуть бути перераховані при змінах правил фільтрування [144][69]. Накопичувальний запис — це версіонований пакет доказів: версія рукопису, його метадані та класифікації, датовані снімки панелі керування, повідомлення про розповсюдження, датований журнал власних подій просування автора (розміщена тема, доповідь, оголошення розсильного списку) та подальші цитування та змістовні контакти. Журнал просування має значення, оскільки просування — це форми експозиції. Без датованого запису про власну публічність автор не може відрізнити органічний стрибок від одного, створеного самостійно, і ніхто, хто перевіряє твердження, також не може (Розділ 8.3).
2. Нормалізуйте за часом з моменту розміщення. Виражайте ранню продуктивність як завантаження в місяць протягом перших трьох-шести місяців, а не як сирий накопичений підрахунок. Стаття тримісячної давності, порівняна з накопичними сумами старіших робіт, дає систематично оманливі висновки, оскільки лічильники накопичуються протягом всього життя статті на платформі, обсяг річного завантаження якої зріс з приблизно 12,9 мільйона у 2016 році до 40,6 мільйона у 2023 році [1].
3. Ніколи не змішуйте вікна спостереження. Тижневий підрахунок не може порівнюватися з дванадцятимісячним середнім, і 90-денний підрахунок не може порівнюватися з накопичними сумами. Кожне порівняння в цьому посібнику поєднує подібні вікна з подібними. Порушення цього правила були серед найпоширеніших помилок інтерпретації при використанні рейтингової статистики до припинення [161].
4. Розташуйте статтю в її дисциплінарному середовищі, а не проти платформи. Середнє завантаження на папір відрізнялося приблизно в вісім разів у межах Legal Scholarship Network eJournals самих по собі (438.35 у Corporate/Securities/Finance проти 53.48 у Agricultural Law, дані 2018 року) [168]. Підрахунок, який є непримітним в одній підобласті, є виключним в іншій. Відповідний референтний клас — це власний eJournal статті або мережа суб'єктів, розглянута в тому ж віці статті.
5. Не переінтерпретуйте поодинокі малі підрахунки. Дослідження цілісності встановлює верхню межу точності лічильників використання: завантаження, про які повідомляють видавці, можуть бути вдвічі більшими за такі на порівнюваних платформах [176], фільтри платформи відкидають значну частину сирого трафіку [99][129][144], а без таких фільтрів власні лічильники SSRN були б завищені "в п'ять разів чи більше" [18]. Невеликі різниці між порівнюваними числами тому не несуть ніякої інформації.
6. Контролюйте накопичення в довгостроковій перспективі, а не реагуйте на ранні показники. Увага на платформах робочих папірів зосереджена рано [116][28] (останній висновок походить від NBER, а не від даних SSRN), але рівні виявлення дозрівають повільно: SSRN повідомляє, що індексація Google Scholar займає "6–9 місяців чи довше" [55]. Крім того, читання спадає на кількох часових масштабах одночасно, і читання та цитування не обов'язково слідують одному й тому ж часовому процесу [91], тому жодне одне вимірювання 'періоду напіврозпаду' своєї кривої не є безпечним. Траєкторія спочатку може бути попередньо класифікована на 60–90-денних показаннях сітки Таблиці 11 і з більшою впевненістю на 180 днів, ніколи на 7-денному показанні.
6.2 П'ять правил читання панелі
Маючи цей запис, розподільчі докази розділу 5 зводяться до п'яти практичних правил для щоденного читання панелі.
(i) Порівнюйте з медіанами, а не з середніми значеннями або видимими максимумами. Єдиний подібний до перепису зразок звичайних статей встановлює медіану на рівні 63 завантажень та 369 переглядів анотацій протягом двох років (LSN, статті опубліковані 2012) [139]. В одній нещодавній опублікованій вибірці медіана становить 87 завантажень, при середньому значенні 221,3, яке перевищує навіть 75-й процентиль (розділ 3.3) [83]. Цифри-орієнтири, які циркулюють, походять з видимого хвоста, максимальні значення якого в 2015 році сягали сотень тисяч завантажень (розділ 3.5) [85]; автор, який калібрується проти них, калібрується проти хвоста квазілогарифмічного розподілу, що гарантує невірну калібровку. Середнє значення платформи ~222 пожиттєвих завантажень на статтю, обчислене з агрегатів грудня 2023 року [1], є настільки ж непридатним як особистий еталон.
(ii) Перевіряйте коефіцієнт конверсії, а не лише кількість. Незалежні вимірювання збігаються на нормальній смузі приблизно 11–19% завантажень на перегляд анотації: середнє значення вибірки LSN 18,7% і медіана 17,1% [139], та цифри 15% (найбільш цитовані статті) та 11% (статті з однією цитатою) з досліджень правових цитувань [172]. Давнє правило SSRN три переглади на одне завантаження [18] розташовується вище цієї смуги, а не всередині неї. Нещодавна вибірка Marketing-network розташовується трохи вище цієї смуги із середнім значенням 23,7 завантажень на 100 переглядів [83]. Рисунок 6 показує оцінки разом. Проведіть центральний опрацьований приклад розділу 5.2 через правило: 40 переглядів анотацій та 7 завантажень становлять 17,5%, всередині смуги як точкова оцінка, але з широким 95% інтервалом Клоппера–Пірсона (≈7,3–32,8%). При n = 40 результат не є невдачею і не є точним процентилем: результат скринінгу, що відповідає звичайній конверсії. Конверсія значно нижче смуги відповідає невідповідності між анотацією та статтею, де читачі приходять, читають анотацію та йдуть. На це можна вплинути, і дія полягає у переробленні заголовка та анотації. Конверсія значно вище смуги сигналізує про трафік, який не пояснюється переглядом анотацій, такий як прямі посилання з ЗМІ або охоплення агрегаторами, і це має спонукати перевірку того, звідки беруться перегляди. Обидва читання є скринінг-діагностикою: жодне дослідження не підтвердило причинно-наслідковий зв'язок від низької конверсії до якості анотацій, і діагноз має бути записаний як гіпотеза про власну статтю.
(iii) Розглядайте завантаження за перший місяць як найранішу та найшумнішу ознаку цитування. Ранні завантаження корелюють з пізнішим цитуванням приблизно r ≈ 0,4 у даних arXiv, що самі оригінальні автори перекладають на лише близько 16% пояснену дисперсію [25]. Найранішою такою ознакою в записах є біомедична: кількість онлайн-звернень на першому тижні після публікації в BMJ корелювала приблизно 0,50 з цитуванням, накопленим протягом наступних років [119]. У правничій науці Блек та Карон повідомили про кореляції завантажень та цитувань на рівні статей порядку 0,50, зростаючи до близько 0,55 у вибірці сотні молодих професорів права [18]. Через різні поля та часові горизонти кореляції на рівні статей коливаються від приблизно 0,1 до 0,6 [80][25], і завантаження arXiv втрачають статистичну значущість як предиктори, коли контролюється одночасна увага у Twitter [138]. На сукупному рівні асоціація посилюється: 0,84 між рейтингами на основі завантажень та рейтингами на основі цитувань сотні юридичних навчальних закладів [77], і R = 0,724 між завантаженнями PDF за шість місяців і пізнішим цитуванням у власному аналізі одного журналу [114]. Ці сукупні цифри не визначають, де закінчиться будь-яка окрема стаття, і перший місяць завантажень є ранній сигнал про пізніші цитування.
(iv) Нульові завантаження на першому тижні — це нормальний стан перед розповсюдженням, а не відмова. Новоопублікована стаття привертає увагу лише після того, як вона пройде модерацію, буде класифікована до eJournals за предметом і вступить в цикл оголошень. Власна документація SSRN описує класифікацію як кураторську, а не гарантовану, з затримками до 45 днів для сильно завантажених тем [53], і розповсюджувань eJournal та email-сповіщення були явно підтверджені для продовження без змін після припинення [147][57]. Послідовність діагностики проходить так: підтвердіть, що стаття опублікована в Інтернеті, підтвердіть класифікацію eJournal, дочекайтесь завершення циклу оголошень, і читайте лічильники лише після цього. Виявлення через пошукові системи приходить пізніше [55].
(v) Спадаючий або плоский лічильник може відображати фільтрування, а не втрату читачів. SSRN публічно документує, що вона відкидає очевидні повторні завантаження, завантаження роботів та інші нерегулярні дії [144][66][69]. Досвід RePEc/LogEc показує, наскільки великими можуть бути такі корекції: у липні 2007 року роботи становили приблизно 74% переглядів анотацій, але лише близько 7% завантажень [99], а в вересні 2025 року понад 99,5% сирого трафіку IDEAS було відкинуто через втручання AI-ботів [129]. Раптовий спад чи перевідлення тому в рівній мірі можуть бути подією вимірювання, як і подією читання, і це ніколи не повинна читатися як втрата репутації без підтвердження.
6.3 Бенчмаркування без рейтингів
Рейтинги послужили порівняльною основою. Сьогодні автор має три заміни для неї, упорядковані від найменшої до найбільшої роботи.
Мікро-бенчмарки. Найпрямішою заміною є референтна група, яку будує сам автор: визначити три–п'ять методологічно порівняльних статей колег у порівняльних установах, опублікованих того самого місяця, та відстежувати їхні публічні лічильники за тим самим графіком табл. 11, що й свою. Результатом є локалізована процентильна основа саме щодо правильного класу референцій, узгоджена за конструкцією щодо галузі, віку статті та ери платформи, де вийшлі з ужитку рейтинги порівнювали статті всіх років і галузей у одній лізі. Це пропонований процес, який використовує лише публічні підрахунки для кожної статті, і його слід фіксувати як такий у будь-якому використанні в досьє. Він також передбачає певну знайомість з колегіальною літературою, яку найбільш ізольовані новачки, саме автори, на яких найбільше впливає умова холодного старту, можуть не мати. Для них засіб з боку платформи з розділу 10.4 (анонімні процентильні смуги) — це структурне рішення, оскільки воно не вимагає самостійно зібраної мережі для використання.
Коефіцієнт відносної продуктивності. Та сама логіка може бути виражена як одне число: відношення завантажень статті в певному віці до медіанних завантажень узгодженої когорти, тобто тієї самої дисципліни, того самого віку статті та, якщо можливо, того самого типу статті. Коефіцієнт 1,0 означає точно медіанну видимість для когорти, а значення вище або нижче 1,0 читаються відповідно. Індекс впорядковує статті в межах узгодженої когорти; процентильні смуги чекають на еталонний розподіл. Опубліковані медіани, з яких можна було б побудувати основу когорти, є застарілими та вузькими (63 завантажень за два роки для правничої науки, опублікованої в 2012 р. [139], 87 для робіт із маркетингу, спостережених у 2025 р. [83]), а відображення значень коефіцієнта на процентилі вимагає повного розподілу, а не лише медіани. Приписування позначок процентилів смугам коефіцієнтів без цього розподілу створює хибну точність. Попередньо зареєстрована програма розділу 8 включає калібрування смуг; доти коефіцієнт є впорядковуючим пристроєм, а не шкалою оцінювання. Дві подальші застереження обмежують цей пристрій. Він взагалі не повинен обчислюватися для малих підрахунків, оскільки нестійкість малого знаменника з розділу 5.2 застосовується як до чисельника коефіцієнта, так і до тонкої медіани когорти, а емпірично-баєсівське скорочення (розділи 8.3, 8.8) є належною корекцією в будь-якому місці, де такий коефіцієнт повідомляється публічно. Даний коефіцієнт не перекладається у фіксований процентиль: «вдвічі медіана когорти» відповідає різним позиціям процентилів у розподілах різної форми, тому коефіцієнт впорядковує статті в межах однієї когорти, але не може порівнюватися в когортах або епохах, розподіли яких мають різні форми.
Мова вердиктів для траєкторій. Інструменти, спрямовані на громадськість, запропонували класифікувати ранню траєкторію статті на три якісні вердикти (швидкий старт, постійний інтерес, повільний старт) як гуманну альтернативу сирим числам. Словниковий запас варто збережити, оскільки він перетворює підрахунок на твердження про траєкторію, а «повільний старт» свідомо не є синонімом невдачі. Пороги, спочатку запропоновані для цих вердиктів, спирались на порівняння неузгоджених часових вікон та на статистику «мережевого середнього значення» на рівні платформи, яка не існує як публічна метрика: SSRN не пропонує публічний самообслуговуючий API або кінцеву точку статистики [51], а найближча історична метрика («Нові завантаження на статтю», статистика рейтингу рівня автора) була припинена разом із рейтингами ([B-9], цитується з застереженням, що історичні сторінки рейтингів більше недоступні). Призначайте вердикти, отже, лише на основі узгоджених порівнянь: групу мікро-бенчмарків або коефіцієнт медіани когорти вище, читати не раніше за позначку 60–90 днів.
Яка б заміна не використовувалась, зовнішня триангуляція її посилює. Дані рівня цитування з Crossref та OpenAlex [35][124] та індикатори PlumX, відображені на сторінках SSRN [50], відповідають на інше питання, про подальше використання, а не про видимість. Інструмент цитування політики, такий як Overton, розширює ту саму триангуляцію на охват політики та практики, відображаючи, де статтю цитують у державних та інституційних документах [187], що відповідає базі права, економіки та політики SSRN. Ці рівні розглядаються спільно з лічильниками в структурі CSAB таблиці 10 та діагностиці охоп–конверсії таблиці 9. Індикатори Altmetric є подальшим рівнем триангуляції. Задумані з самого початку як сигнали ранної уваги [123][122], вони дотримуються моделей, відмінних від цитувань [74][20], та допускають нормалізацію за дисципліною [21]. Вони також вразливі до автоматизованого завищення [75] та вимагають інтерпретації, спрямованої теорією, а не читання за номіналом [76].
6.4 Покращення законної видимості
До закриття Rankings надавав грубий, але реальний зворотний зв'язок щодо одного повторюваного рішення авторів: чи варто було далі просувати статтю (Розділ 1.3). Після закриття це рішення слід приймати на основі важелів і діагностики, зібраних тут. Література про детермінанти виявляє невелику кількість важелів під контролем автора та узгоджених з правилами платформи. Кожен впливає на видимість, а не на якість, і жоден не змінює вміст статті. Швидке поширення та ранній зворотний зв'язок є серед визнаних цілей розміщення препринтів у методологічній літературі про препринти [24], а посібник законної видимості використовує цю встановлену функцію.
Оформлення. У виборці LSN характеристики заголовка, довжина анотації та значущість теми були суттєво пов'язані з увагою, з власною обережністю автора щодо того, що такі змінні можуть виступати проксі для неспостережуваної якості [139]. У дослідженнях юридичного цитування статті верхнього децилю містили більше ключових слів і довші анотації, ніж статті нижнього децилю [172] (конкретні цифри чекають на перевірку проти оригіналу). Сторінка анотації — це поверхня конверсії, на яку впливає правило (ii), тому коли конверсія постійно знижується нижче смуги, заголовок і анотація — це перше, що слід переглянути. Будь-яке таке переглядання спрямоване на узгодження між обіцянням і вмістом, а не на безлюдне залучення трафіку: переписування вже зрозумілої анотації для максимізації кліків може пошкодити її точність, і, привертаючи неподібних відвідувачів, це може відштовхнути конверсію далі від смуги, а не до неї.
Класифікація. Статті, класифіковані у більше eJournals, мали в середньому більше завантажень і менше результатів нульового завантаження в аналізі LSN 2018 року [168]. SSRN дозволяє від однієї до семи класифікацій на статтю та курує включення [53]. Популярне вдосконалення спільноти, непровірене, оскільки жодне дослідження не порівнює стратегії класифікації, обмежує класифікації трьома, обраними як один базовий, один широкий та один міждисциплінарний eJournal; цю пораду слід розглядати серед перевіряємих гіпотез Додатку А.
Поширення та зовнішня увага. Оповіщення електронної пошти eJournal залишається основним каналом push платформи і продовжується після закриття [147][57][152]. За межами платформи освітлення в блогах створило різкі ранні піки завантажень в одному емпіричному тесті питання [116], видима позиція в списку підвищила читаність і цитування в позиційних дослідженнях arXiv [72], і участь у конференції була пов'язана з додатковими 17–26 завантаженнями на статтю в квазіекспериментальному дослідженні, побудованому навколо скасованої засідання з політичної науки ([B-4], цитується з застереженням, що налаштування — APSA 2012, а не вибірка SSRN-economics). Посібники практиків збирають подальші інструменти поширення для юридичної науки [169]. Обґрунтування раннього відкритого поширення встановлюється незалежно: рандомізоване дослідження відкритого доступу виявило більше завантажень, хоча без короткострокового збільшення цитування [37], тоді як когортні та польові дослідження повідомляють про переваги цитування приблизно від 10% до дворазового [59][86][17][93], включаючи +53% для американських юридичних оглядів [40], і аудит юридичних цитувань виявив, що 87% найбільш цитованих статей були доступні на SSRN проти 44–46% мало цитованих статей, з 95% найбільш цитованої групи розміщеної на SSRN в їх рік публікації або раніше [172]. Депозит препринту пов'язаний з більш високими цитуваннями та меншим завантаженням з сайту видавця на arXiv [38], і завантаження bioRxiv корелюють з результатами журналу [62]. У переписі всіх препринтів bioRxiv кількість завантажень корелює з імпакт-фактором журналу, в якому препринт пізніше публікується (Kendall τb = 0,59), асоціація, напрям причинності якої невідомий [2]. Шари машинного виявлення (пошукові системи та генеративні системи відповідей) розглядаються окремо в рамці аудиту Розділу 8 та порядку денному перевірки функцій Таблиці 20 [5][164].
Гігієна версіонування. Переглядання, завантажені на ту саму сторінку SSRN, зберігають накопичені лічильники та стабільний URL, тоді як видалення та повторне розміщення скидає метрики на нуль ([B-7], цитується з застереженням, що формулювання сторінки підтримки змінюється з часом і повинно бути перевірене повторно при подачі). Подальша претензія спільноти, що незначне переглядання на день 3 спричиняє повторне оголошення та "другу хвилю" уваги, не документована, і вона перебуває серед непровірених практик Додатку А. Ідентичність потребує такої ж уваги. Пов'язування перевіреного ORCID iD з профілем автора SSRN зберігає статті та їх лічильники, прикріплені до правильної людини, а не до однофамильця, і це низько витратна гарантія від проблеми розмежування авторів, яку конструкція панелі Розділу 8.3 повинна інакше вирішити статистично ([B-7], те саме застереження щодо повторної перевірки).
Чого не робити. Самозавантаження та пов'язана маніпуляція задокументовані у власних журналах сервера SSRN, посилювалися біля порогів топ-списків і були викликані соціальним порівнянням [44]. Фільтри запобігання шахрайству платформи є публічними [144][69], і комітети оцінювання, які знайомі з цією історією, скептично ставляться до непідтримуваних претензій. Тому література про маніпуляцію несе практичне попередження поряд з етичним: маніпульовані лічильники виявляються і коштують дорого репутацією. Рисунок 9 ілюструє часовий підпис проблеми на змодельованих даних. Органічна увага накопичується як ранній пік із довгим хвостом, тоді як маніпуляція створює зосереджені піки саме того типу, який фільтри цілісності розроблені виявляти [144][69].
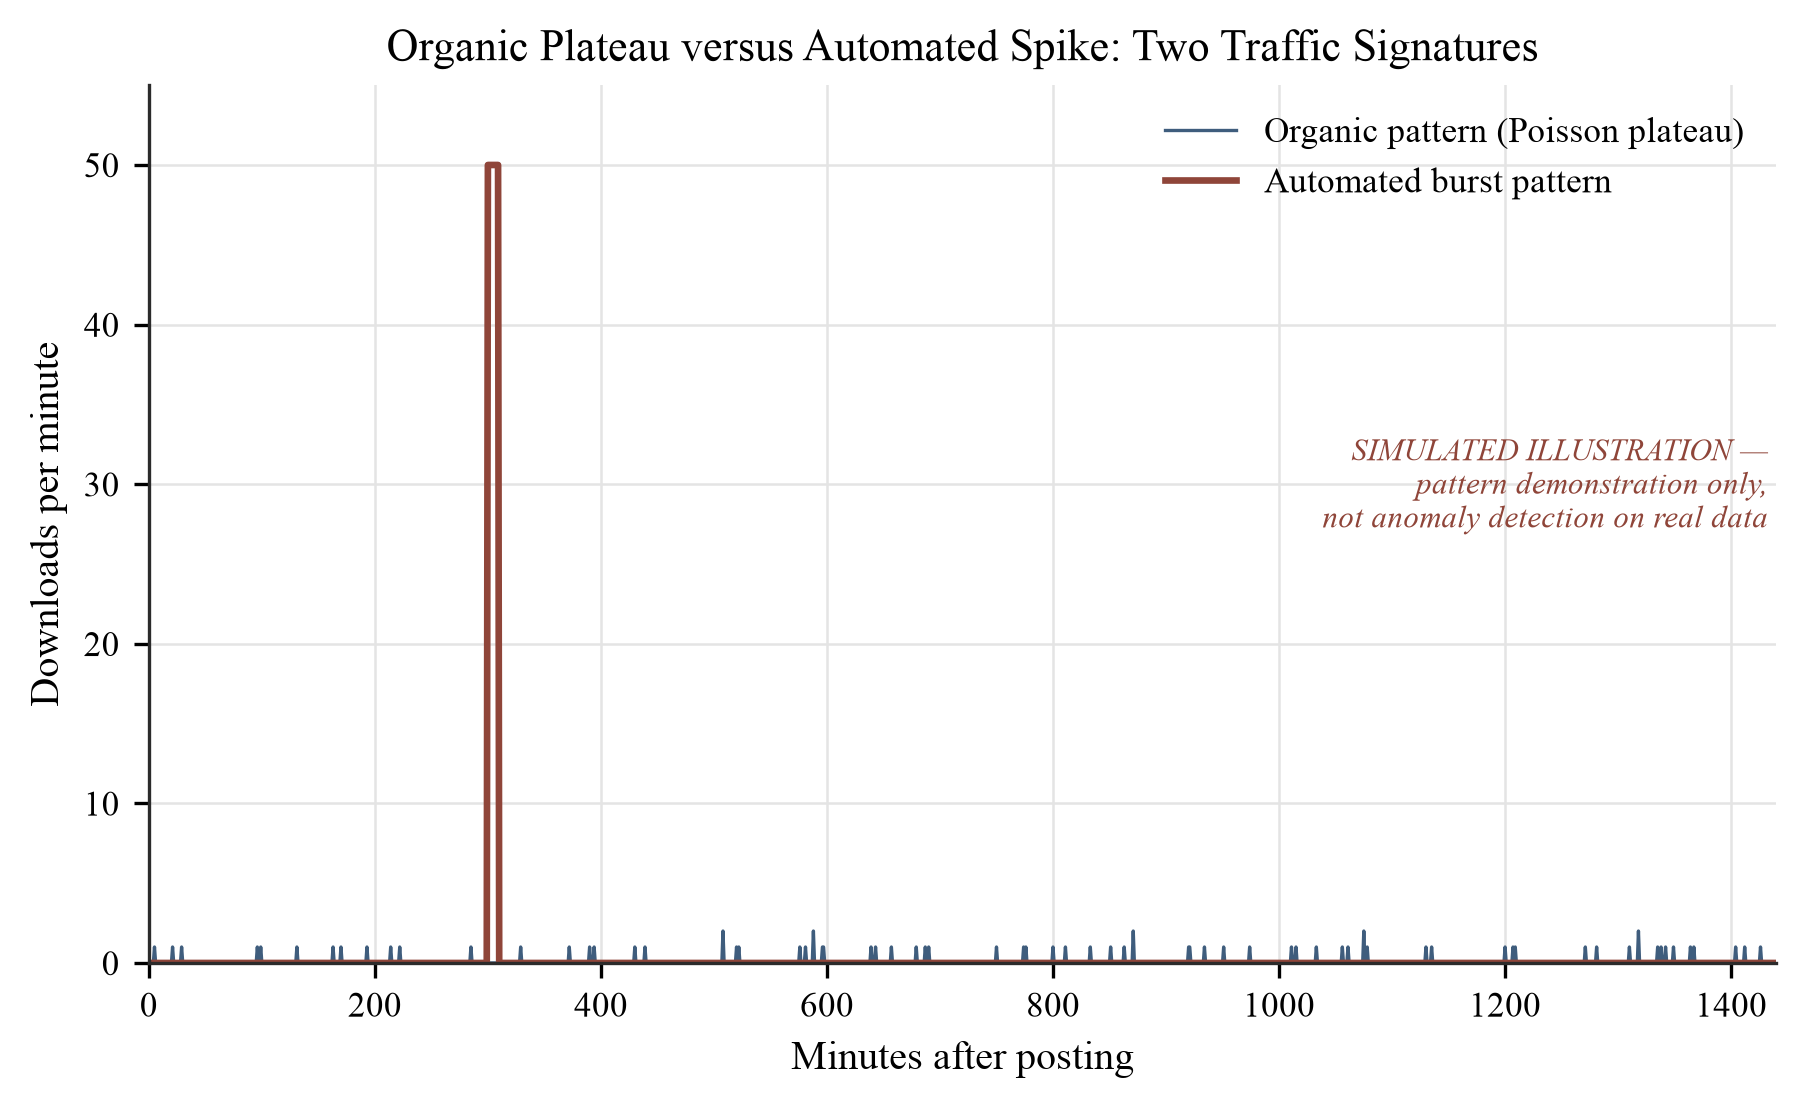
Рисунок 9. Органічне накопичення проти маніпуляційного піку. Плавна органічна траєкторія завантаження, контрастована із різким однодневним піком, характерним для самозавантаження, що мотивує попередження про маніпуляцію Розділу 6.4 та обговорення цілісності Розділу 4 [44][69][144]. Усі показані дані змодельовані; жодного емпіричного набору даних виявлення аномалій для SSRN не існує.
6.5 Перетворення лічильників на кар'єрні докази: протокол досьє
Перед припиненням рейтингів SSRN докази, засновані на рангуванні, були стандартизованим компонентом досьє. Публічний рейтинг автора безпосередньо входив до файлів просування: "посідав 13-те місце з 3000 юридичних авторів за загальною кількістю всіх завантажень, які юридичний факультет врахував у різних рішеннях щодо просування та пов'язаних рішень" [12]. Посібники з написання супровідних листів рекомендували посилатися на кількість завантажень та появи в Топ-10 [95], керівництво практиків одночасно застерігало, що самостійно розміщена робота "ймовірно, не буде враховуватися для цілей просування та посадостійності на юридичному факультеті" [33], а власна документація платформи описувала свої метрики як дані, "які автори використовують для цілей просування та посадостійності, а установи використовують у своїй діяльності з найму та рейтингування" [52]. Кожен з цих артефактів передбачав публічну раму для порівняння, яка більше не існує [149]. Оцінювальне використання лічильників було оспорюване з його першої пропозиції, більше того: справа Black and Caron 2006 року на користь завантажень як "бета"-міри наукової продуктивності [18] отримала відповідь у тому ж томі симпозіуму критикою Eisenberg щодо того, що можуть дійсно вимірювати рейтинги на основі SSRN [45]. Досьє, яке посилається на завантаження, успадковує ту невирішену дебату. Таблиця 13 визначає семикроковий протокол для реконструкції обґрунтованих доказів з того, що залишилося, а його керівна вимога, застосована в третьому та четвертому стовпцях, полягає в тому, що кожне число, цитоване в досьє, повинно супроводжуватися його джерелом, часовим вікном та обмеженнями. Твердження, яке перетворюється на точність без джерел, гірше, ніж жодне твердження взагалі.
Таблиця 13. Протокол доказів після припинення для метрик SSRN у досьє посадостійності, просування та найму. Кожен крок називає дію, доказову основу з її часовим вікном, обмеження, яке повинно бути розкрито разом з будь-яким числом, антипаттерн, якого слід уникати, та найсильніший висновок, до якого дає право крок.
| Крок | Дія | Доказова основа (джерело; часове вікно) | Обмеження для розкриття | Уникати | Дозволений висновок |
|---|---|---|---|---|---|
| 1. Збереження | Архівувати датовані скріншоти панелі статистики кожної роботи та профілю автора в інтервалах Таблиці 11 та перед будь-яким поданням; зібрати їх, з повідомленнями про розповсюдження та датованим журналом власних подій просування автора, в версійний пакет доказів розділу 6.1. | Лічильники для кожної роботи пережили припинення ([148][149]; 2026). Лічильники можуть бути переоцінені, коли змінюються правила фільтрування ([144][69]; задокументовано з 2018 року). | Датований особистий архів є єдиною версією запису під контролем автора; цифри платформи піддаються перегляду, і не існує публічної історії. | "Робота має X завантажень" — цитовано без дати або знаменника. | Датований, перевіримий запис того, що показала платформа — спостереження у конкретний час, а не вирок на все життя. |
| 2. Перекласти | Перевести підрахунки на мову діапазонів, використовуючи Таблицю 8 (наприклад, "lifetime downloads above the ~160 entry threshold of the 2015 Top-10,000 papers list, i.e., approximately the top 1.8% of the platform's full-text paper stock, 571,040 in July 2016 [1], at that time"), завжди назвавши джерело, вибірку та рік; шаблон CSAB Додатку B надає формат на рівні речення, залишаючи поля відсоткових рангів порожніми, доки не буде створена референс-панель. | Пороги на рівні документа: порог входу ≥160, медіана в групі 805 (вибірка з топ-списку; 2015) [85]. На рівні автора: вхідний мінімум 129 завантажень всього, медіана в групі 1626 (та сама вибірка) [85]. Якорі типових документів: медіана 63 за два роки (LSN; 2012→2014) [139]; медіана 87 (мережа Marketing; знімок 2025) [83]. | Усі пороги отримано з вибірок 2012–2015 років (інфляція з того часу [1]: Розділ 5.1); фрейм 2015 року охоплює тільки топ-списки; два якорі медіани є однодисциплінарними. Мову діапазонів не слід переформулювати як відкалібрований процентильний ранг. | Універсальні мітки на кшталт «відмінне» на старому сирому порозі. | Відносне становище в межах названої вибірки, галузі та року — нічого ширшого. |
| 3. Триангулювати | Поєднати лічильники SSRN з незалежними доказами цитування: Google Scholar, HeinOnline для права, RePEc для економіки, Crossref/OpenAlex як шари відкритого цитування, PlumX як відображено на SSRN. | Рейтинги завантажень SSRN і цитувань HeinOnline на рівні навчального закладу корелюють на рівні 0,84 (100 юридичних шкіл США; 2019) [77]; кореляції завантажень–цитувань на рівні документа коливаються від ~0,1 до ~0,6 залежно від галузі та часового горизонту [80][25]; інфраструктура відкритого цитування [35][124]; PlumX [50]. | Показник 0,84 — це кореляція на рівні навчального закладу і не застосовується до жодного окремого документа чи автора (обережність щодо екологічного висновування, Розділ 6.2(iii)); завантаження вимірюють попит, а не читання чи схвалення; кореляції на рівні документа скромні, а набори з високим завантаженням і високим цитуванням накладаються лише частково [108]. Конвергентні докази цитування, а не сам лічильник, обґрунтовують твердження про вплив. | Прирівнювання завантаження до схвалення чи коректності. | Багатошарові докази прийняття, а не доказ якості. |
| 4. Нормалізувати за полем | Явно вказати дисциплінарну рамку (наприклад, «у корпоративно-правовому науці, де середні показники eJournal відрізняються приблизно в вісім разів у різних юридичних підгалузях»). | Середні показники підгалузей 438,35 проти 53,48 завантажень/документ (eJournals LSN; 2018) [168]; коефіцієнти завантажень до цитувань самі мають структуру галузі [18]. | Оцінка розходження стосується лише права і датується 2018 роком; перенесення будь-якого порога між дисциплінами вимагає обережності, і мова процентильних рангів без кваліфікатора галузі неінтерпретуюча. | Порівняння нового документа з багаторічним сумарним показником або перенесення порога між галузями. | Порівняння з кваліфікацією за галуззю та віком — ніколи універсальна оцінка. |
| 5. Доповнити | Цитувати інституційні репозиторії та інші канали розповсюджень разом з SSRN. | Лічильники SSRN нічого не говорять про завантаження тих самих документів з інших служб [161]; реформи 2026 року встановили серії на основі репозиторіїв як шлях міграції для інституційного поширення [47][146]. | Жоден лічильник однієї платформи не вимірює загальне поширення документа; твердження в досьє стосується документа, а не одного лічильника. | Представлення лічильника однієї платформи як загального поширення документа. | Твердження про розповсюджування статті, з окремо названим лічильником кожного каналу. |
| 6. Цілісність | Вкажіть правило підрахунку платформи поряд з будь-яким цитованим показником та зберігайте датовані архіви, які документують число так, як воно відображається. | Фільтрація та переформулювання є задокументованою поведінкою платформи ([144][69][66]; постійно); статистика завантажень, повідомлена постачальником, залежить від конвенцій підрахунку ([69][176]; 2015–2019). | Лічильники є відфільтрованими, переглядними оцінками; немає публічної історії переформулювань, тому датований архів автора — єдиний стійкий запис. | Трактування лічильників як точних чисел унікальних людських читачів. | Відфільтрована оцінка за зазначеним правилом у зазначену дату — не перепис читачів. |
| 7. Експертна оцінка | Подавайте кожен рядок метрики як контекст для якісної оцінки внеску роботи та її суворості, ніколи не як її заміну. | Метрики вимірюють етапи поширення, а не валідність (Розділи 3.1, 5.5); набори з високим завантаженням та високим цитуванням перекриваються лише частково [108]. | Жодна метрика використання, нормалізована чи сира, не оцінює, чи є дослідження правильним або важливим. | Підміна метрики на експертне судження. | Контекстуальні докази, що супроводжують експертне рецензування — претензія на якість спирається на рецензування, а не на число. |
Стовпець «Уникати» збирає антипатерни протоколу. Два попередження обмежують протокол в цілому. Завантаження записує пасивний попит, а не читання, схвалення чи якість, і показники реагують на динаміку розголосу (висвітлення блогів, помітні заголовки, тематичні хвилі) настільки ж, як на науковість [116][139][138]. Комітети, які знають запис маніпуляції [44], дисконтуватимуть невідповідні цифри, а інгредієнти, що пережили таке дисконтування, — це саме ті, які вимагає протокол: датовані скріншоти, мовлення діапазонів зі вказаними джерелами, кваліфікатори поля та триангуляція.
6.6 Наслідок просування
Просування має один документований побічний ефект, про який не повідомляють на жодній панелі: непрошені запрошення від хижацьких журналів і конференцій, створені в результаті збирання імен, афіліацій та назв статей з платформ препринтів [107][159]. Обсяг є суттєвим у суміжних аудитах, де спеціалізовані дослідження документують потоки запрошень, що варіюються від десятків на одного вченого за два тижні до тисяч на фахову групу за місяць (Розділ 7.2) [9][84][63]. Перший контакт із хижацьким журналом — це непрошена електронна пошта приблизно в 41% обстежених випадків [32]. Розділ 7 і таблиця 14 аналізують явище. Для посібника наслідки зводяться до чотирьох інструкцій. Очікуйте запрошень як природного наслідку видимості, і ніколи не сприймайте їх обсяг як наукове визнання: відправники механічно орієнтуються на видимість, а не вибірково оцінюють якість [159][63]. Спрямовуйте кореспонденцію через виділену адресу, щоб збирання не забруднило основну поштову скриньку; широко розповсюджений прийом приховування адреси електронної пошти профілю протягом перших двох тижнів після просування — це непідтверджена практика (Додаток A). Ніколи не платіть, оскільки модель бізнесу — це комісія, при цьому плати за обробку статей у перевірених хижацьких виданнях коливаються від $25 до $1,800 [136]. Гроші — це менша ставка: ті самі комітети оцінювання, які ретельно перевіряють досьє (Розділ 6.5), також читають бібліографії, і відоме хижацьке видання у переліку публікацій накладає репутаційні витрати, які тривають довше, ніж будь-яка комісія. Перевірте будь-яке видання, що запрошує, проти активно підтримуваної служби скринінгу на кшталт Cabells Predatory Reports ([B-1]; Beall's list не оновлювалася з січня 2017 року і не повинна використовуватися як актуальне джерело), а також проти контрольних списків Think. Check. Submit. [159]. Механізм збирання також забезпечує якісний фільтр: журнал, який надсилає запрошення протягом кількох днів після просування препринту — раніше, ніж люди встигли б його прочитати — дуже малоймовірно буде легітимним. Це евристика; жодне дослідження не виміряло її частоту виникнення [63].
6.7 Обсяг довідника
Опорні точки довідника датуються 2012–2015 роками і насичені правовим та маркетинговим змістом [139][85][83][1]. Потік завантажень на статтю зріс з того часу (розділ 5.1). Свіжі процентильні дані, стратифіковані за галузями, ще не існують; їх збирання платформою або спільнотою є предметом розділів 8 і 10. Довідник зменшує неправильну інтерпретацію і не вимірює якість. Чотири правила роблять його використання механічним: порівнювати зіставні випадки, тримати вікно спостереження незмінним, указувати джерело для кожного числа та позначити гіпотезу як гіпотезу.
7. Паразитний шар уваги: видимість та хижацькі звернення
Розроблена до сьогодні інтерпретаційна схема розглядає увагу як єдину лійку, яка йде від експозиції до перегляду анотації до завантаження до подальшого використання. Однак прожитий досвід розміщення препринту часто включає другий потік "уваги", що надходить через зовсім іншій канал: невпрошені запрошення електронною поштою від журналів, конференцій та редакційних послуг сумнівної легітимності [14][61][117][142]. Нижче йде концептуальний опис цього другого потоку разом з аудиторськими доказами його документованого масштабу.
7.1 Двошарова модель уваги
Середовище після опублікування розглядається тут як двошарова економіка уваги (Малюнок 10). Шар 1 — це законна воронка, описана в розділах 4 і 6: розповсюдження eJournal, перегляди анотацій, завантаження та подальше наукове використання. Шар 2 — це паразитний шар, екосистема хижацьких видавців і постачальників послуг, які живляться тією ж публічною інфраструктурою (назви, анотації, імена авторів та афіліації) та мають на меті перетворити авторів на платних клієнтів, а не прочитати їхні роботи. Література про запити та аудити документує життєвий цикл. Публічні метадані препринтів (назви SSRN, анотації, імена авторів та афіліації) збираються [107][159], імітаційні запрошення, які дзеркалюють законні заклики до подання статей, розповсюджуються [61][63], а автори, які беруть участь, перетворюються на платних клієнтів. Економічний механізм також документований: плата за обробку статей у передбачуваних хижацьких журналах становить в середньому приблизно $178 з повідомленим діапазоном від $25 до $1 800 [136].
Асиметрія між двома шарами важлива для інтерпретації. Шар 1 вимагає, щоб читач помітив, відкрив і оцінив статтю, тоді як Шар 2 вимагає лише того, щоб метадані статті стали машиночитаними. Тому препринт принципово може бути повністю обробленим паразитним шаром, залишаючись фактично непрочитаним у законному. Це ситуація папірів платформи з майже нульовими завантаженнями, так звані «папери-привиди», які машини обробляють, а люди фактично не читають.
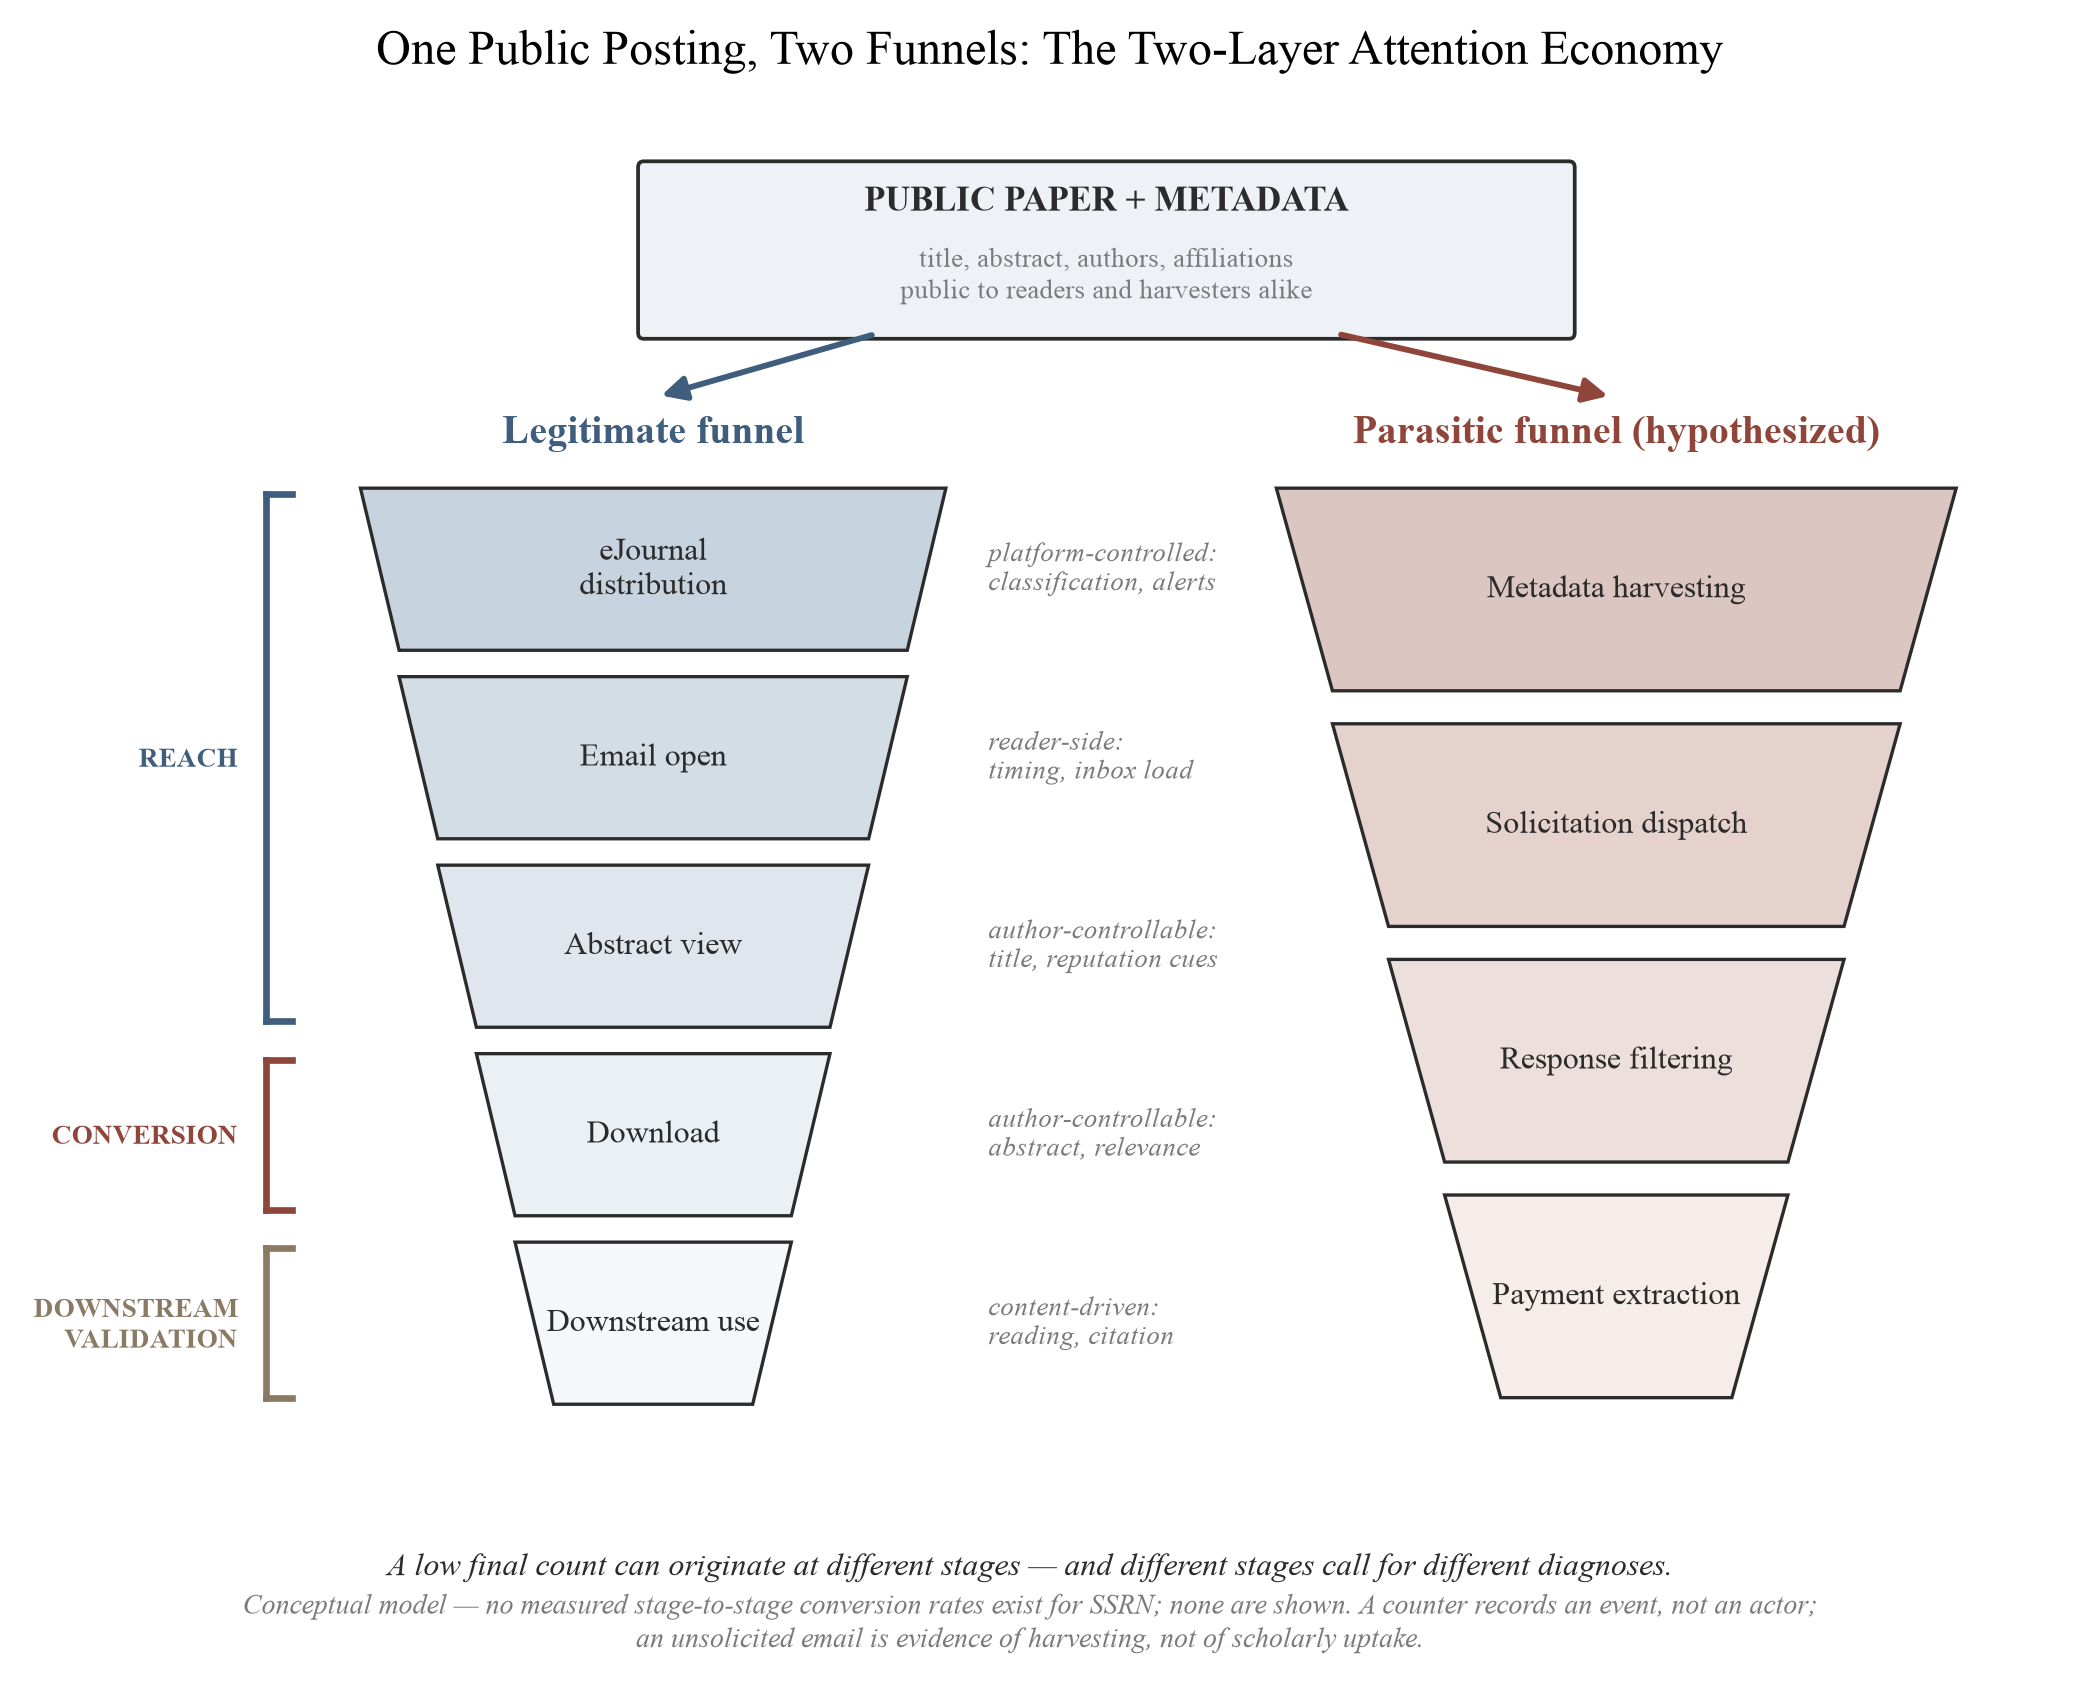
Малюнок 10. Концептуальна модель двошарової економіки уваги. Обидві воронки показані як якісні послідовності етапів; коефіцієнти переходу від етапу до етапу не відображаються, оскільки такі коефіцієнти не були виміряні для SSRN. Паразитна воронка — це гіпотетична реконструкція на основі літератури про запити та аудити [61][63][107][159] (розділ 7.3).
7.2 Задокументований масштаб хижацької розсилки
Те, що хижацька розсилка є масштабним явищем, не викликає сумнівів. Огляд 2026 року виявив двадцять дев'ять емпіричних досліджень академічного спаму, які сходяться на спільному переліку тактик: лестива розсилка, помилкові редакційні претензії та сумнівні твердження щодо метрик і індексування [61]. Виміряні обсяги істотні. Чотирнадцять академічних офтальмологів отримали 1813 листів розсилки від 383 унікальних видавців, охоплюючи 696 унікальних журналів, протягом одного 30-денного періоду [84]. Академічні радіологи отримали в середньому 20,7 запрошень на публікацію рукописів та 4,1 запрошення виступити як доповідач протягом двотижневого періоду [9]. Пошуковий аудит каталогізував 422 листи розсилки, отримані одним урологом протягом 2023–24 [63], а тематичне дослідження в академічному видавництві зафіксувало 1024 листи спаму від журналів протягом 391 дня [89]. Річне спостереження одного дослідника після розміщення препринтів зафіксувало 875 запрошень від 256 журналів, 76% яких опинилися у складених блоклистах, умовному джерелі, цитованому тут з застереженням, що затримки прибуття після розміщення не були виміряні [B-10]. Розсилка також очевидно конвертується. Серед авторів, які публікувалися в припущених хижацьких журналах, 41% повідомили, що їхній перший контакт з журналом виник через невипрошене запрошення електронною поштою [32], а аналіз змісту корпусів розсилки документує лестиву мову, вигадані дедлайни та нечітко визначену тематичну сферу як повторювані засоби переконання [96].
Докази також не обмежуються медициною. У суспільних науках, дисциплінарно набагато ближче до власної бази SSRN, три дослідники в освітніх науках отримали 210 невипрошених запрошень від журналів протягом трьох місяців, прослідкованих до 139 журналів і 37 видавців, більшість з яких класифікуються як хижацькі; приблизно половина запрошень вийшла за межи сфер експертизи одержувачів, характерна ознака спрямування, керованого метаданими, а не читацькою аудиторією [155]. Найбільше від цього страждає центральна фігура цієї статті — дослідник на початку кар'єри. Один поздовжній самоаудит дослідника на початку кар'єри зафіксував 1280 хижацьких розсилок (990 від журналів, 220 від конференцій та 70 інших видів) протягом приблизно восьми років, разом з задокументованими та здебільшого невдалими спробами відписатися [160].
Два аспекти цієї доказової бази необхідно мати на увазі. Найбільші аудити походять з медицини, а аудити суспільних наук вище, хоча дисциплінарно ближче до SSRN, є меншими; жодні результати з цих досліджень не можуть бути прямо перенесені на авторів SSRN. Для цієї статті вирішальним є те, що жодне з цих досліджень не вимірювало час надходження розсилок відносно до моменту розміщення препринту. Аудит у [63], наприклад, каталогізував вміст та походження, але не пов'язав час прибуття з активністю SSRN. Тому кожне твердження, що пов'язує паразитарний шар з актом розміщення, є гіпотезою механізму, а не емпіричним висновком.
7.3 Гіпотезовані механізми спрямування
Щоб знайти щойно завантажений препринт, паразитний шар має його спочатку локалізувати. Механізми, наведені нижче, є гіпотезами, які частково підтримуються літературою; немає корпусу, що встановлює зв'язок між запитами та скиданнями на SSRN.
H-S1 (збір метаданих). Хижацькі операції витягають дані з публічних сторінок анотацій та переліків нових робіт для збору назв, імен авторів та афіліацій. Практичні та консультативні джерела описують цю поведінку: про хижацькі журнали повідомляється, що вони сканують сервери препринтів та відправляють нежадані запрошення, які посилаються на назву роботи [159]. Коментар юридичної науки констатує, що ті, хто надсилає запити, "збирають електронні адреси, імена, афіліації тощо шляхом сканування існуючих наукових робіт, наприклад тих, що розміщені на SSRN" [107], а путівник бібліотеки права пов'язує публікацію препринтів із "зростанням спаму від хижацьких видавництв, які просять дослідників перевидавати їх роботи за плату" [117]. Одна виміряна закономірність узгоджується з цим механізмом. В аудиті радіології аудити спеціальностей повідомляють про високі обсяги запитів серед активно публікуючих авторів [9], узгоджено зі збиранням з сукупної бібліографічної поверхні автора, а не з однієї публікації. Дослідження 3 (Розділ 8.6) відповідно записує контролі впливу на рівні автора поряд із цільовою публікацією.
H-S2 (отримання контактної інформації). Запит вимагає електронної адреси. Сторінки анотацій SSRN історично включали інформацію про контакти автора [151], а адреси також поширюються через самі роботи, інституційні сторінки та попередні публікації. Те, чи наразі SSRN розкриває електронні адреси авторів у формі, придатній для збору, залишається невивченим; дослідження з інструментальним логуванням запитів розроблено для його вимірювання. Канал придбання для будь-якого запиту залишається невідомим.
H-S3 (паразитування на розповсюджуванні). Дайджести електронних журналів та потоки типу RSS перерозповсюджують метадані нових робіт підписникам [57][51]. Паразитний суб'єкт, підписаний на ці канали, отримував би структуровані дані про нові роботи без витягування даних. Жоден аудит не перевірив цей механізм.
Причинно-наслідковий ланцюг від публікації до таргетування не було емпірично встановлено; Розділ 8 визначає попередньо зареєстрований тест цих механізмів: логування надходження запитів в порівнянні з відомими часовими мітками публікацій для щойно опублікованих робіт.
7.4 Гіпотезована типологія сигналів звернення
Якщо механізми адресування розділу 7.3 функціонують, різні класи звернення повинні нести різну інформацію про видимість документа для машин. Таблиця 14 представляє це як гіпотезовану типологію, категорії стратегії якої засновані на задокументованих тактиках переконання: невідповідність в експертизі та персоналізація з промахом [9][63], вигадані дедлайни та лестощі [96], хибні твердження про метрики та індексування [61] та приховані збори порівняно з задокументованим ринком APC [136]. Остання колонка є виводною та невипробуваною. Таблиця не містить відсотків поширеності та оцінок часу надходження.
Таблиця 14. Гіпотезована типологія хижацьких сигналів звернення після публікації препринту. Приклади формулювань є ілюстративними, вигаданими переказами патернів, задокументованих в аудитах звернень [9][61][96], а не дослівними цитатами з якогось конкретного повідомлення.
| Патерн звернення | Опис | Ілюстративне формулювання | Гіпотезована інформація про видимість |
|---|---|---|---|
| Загальна адреса, без посилання на документ | Автоматизоване запрошення без згадування конкретного документа чи галузі | "Шановний Поважний Дослідниче, надішліть вашу цінну роботу…" | Низька: адреса може походити з будь-якого джерела; немає ознак того, що сам документ переглянули |
| Невідповідність в експертизі | Запрошення, яке посилається на експертизу в галузі, не пов'язаній з документом [9] | "Враховуючи вашу експертизу в квантовій фізиці…" (до документа з права) | Низька або відсутня: вказує на масовий збір даних без аналізу метаданих |
| Таргетоване, з посиланням на назву | Запрошення, яке називає конкретний препринт та топічно суміжне видання [159] | "Ваш недавній документ '[exact title]' був би відповідним для нашого журналу…" | Вища (гіпотезована): метаданих документа досягли адресата, що припускає успішне індексування та доступ скрейпера |
| Персоналізація лестощами | Похвала конкретної роботи як "революційної" або "шанованої" [96] | "Ваш революційний внесок…" | Жодна крім доступу до назви: похвала є шаблонною, а не прочитаною |
| Вигадана терміновість та метрики | Вигадані дедлайни, позначені зірочкою "impact factors," твердження про індексування [61][96] | "Impact Factor 4.2*; надайте протягом 7 днів" | Жодна: засіб переконання незалежний від цільового документа |
| Приховані збори | APC розкриті пізно або лише в додатках; діапазон ринку $25–$1,800 [136] | Збір відсутній в тілі запрошення | Жодна: стратегія ціноутворення, а не сигнал видимості |
| Запрошення на конференцію, з посиланням на документ | Запрошення представити на або подати до сумнівної конференції, часто називаючи конкретний документ; запрошення спікерів є вимірюваним компонентом академічного спаму [61][9] | "Ми запрошуємо вас представити ваш документ '[exact title]' як основну доповідь на…" | Як для таргетованого звернення (гіпотезована): метаданих документа досягли адресата; немає ознак змістовного читання |
| Платні послуги для авторів | Пропозиції швидкого рецензування, перекладу або редагування послуг запропоновані щойно опублікованому препринту [61][84] | "Експресне рецензування та професійна обробка мови для вашого нового препринту…" | Жодна встановлена: спам послуг відстежує метаданих нового публікування, а не вміст документа |
Рядки з лестощами мають психологічний вимір, який механічне читання затьмарює. Шаблонна похвала потрапляє до автора, який може дивитися на стагнуючий лічильник перегледів, для якого звернення є єдиною "валідацією", яку публікування досі видало. Двошарова модель таким чином передбачає жорстоку інверсію, в якій ті, хто першими звертаються до нового препринту, часто є хижаками, а не читачами (розділ 7.5), і новачок може помилково інтерпретувати спам як прояв інтересу, оскільки ще не було жодного легітимного сигналу. Автор, який очікує на гак, може його проігнорувати.
Таблиця 14 читає вхідні повідомлення, щоб встановити, що вони можуть розкрити про видимість документа. Те, як взагалі кодувати ці повідомлення, є комплементарним питанням, і це залежить від розрізнення, залишеного неявним дотепер, між легітимним науковим контактом та звернення з вищим ризиком. Таблиця 15 представляє це розрізнення як типологію шести сигналів, остання колонка якої містить застереження щодо кодування: кожен сигнал є ймовірносним, і жоден сам по собі не є доказом. Типологія також є скелетом кодбуку дослідження 3 (розділ 8.6), оскільки дослідження звернень без позитивного класу легітимного контакту не може виміряти асиметрію, яку гіпотезує розділ 7.5.
Таблиця 15. Розділення легітимного наукового контакту від звернень з вищим ризиком: шість сигналів з застереженнями щодо кодування. Гіпотезована схема кодування, а не перевірений класифікатор. Колонка видимості таблиці 14 ставить інше питання і залишається незміненою: одне й те саме повідомлення може бути закодовано на обох сітках.
| Сигнал | Легітимний науковий контакт | Звернення з вищим ризиком | Застереження щодо кодування |
|---|---|---|---|
| Специфічність | Спирається на конкретний аргумент, метод або результат | Загальна похвала з вставленою назвою або ключовими словами | Специфічність можна імітувати |
| Ідентичність видання | Перевірюваний журнал, редактор, установа або історія конференції | Неясна власність, скопійоване брендування, неперевірюваний редакційний совіт | Нові видання не є автоматично хижацькими |
| Запит | Змістовне питання, співпраця або прозоре запрошення | Термінова подача або запит платежу, не пов'язаний з роботою | Лише збори не мають вирішального значення; прозорість має значення |
| Час | Будь-який час; часто слідує за фактичним читанням | Швидкий шаблонний контакт невдовзі після публічного публікування | Тимчасова близькість не доводить джерело збору даних |
| Мова | Тематично-специфічна та професійно відповідальна | Лестощі, хибна звичність, штучна терміновість, неясний обсяг | Мовні особливості є ймовірносними, а не доказом |
| Верифікація | Незалежно перевірюванізовані контактні дані та політики | Розбиті ідентифікатори, хибні метрики, введення в оману твердження про індексування | Людський огляд за задокументованими критеріями є обов'язковим |
На практиці ця типологія дає скринінгову евристику замість діагностики: звернення від журналу, що прибуває протягом перших днів після публікації, до того як легітимні канали розповсюдження могли б розумно спрацювати, дуже вірогідно є хижацьким. Легітимні журнали високого впливу, як відомо, не звертаються з холодними дзвінками до авторів щойно опублікованих рукописів [174], у той час як ранні непрохані запрошення — це задокументований перший спосіб контакту хижацьких видань [32][174]. Ми пропонуємо конкретний поріг, який іноді висувається в обговореннях практиків (розглядання будь-якого листа від журналу приблизно протягом перших 96 годин як умовно хижацького), як авторську евристику, що очікує на валідацію. Жодне дослідження не виміряло розподіл затримки, який би калібрував такий поріг. Застереження щодо часу з таблиці 15 стосується самої евристики: часова близькість викликає підозру, але не доводить, що відправник почерпнув адресу з цієї конкретної публікації, оскільки адреса могла виникнути раніше, ніж препринт, тому скринінг на 96 годин сортує листи, а не надає доказ.
7.5 Спам-парадокс і асиметрія швидкості
Дві додаткові пропозиції щодо паразитного шару випливають із двошарової моделі.
Спам-парадокс. Якщо цільована розсилка потребує успішного збору метаданих, то в середовищі post-Rankings відсутність хижацького спаму може бути сильнішим показником невидимості платформи, ніж його наявність є показником чогось іншого. Стаття, яка ніколи не спричиняє навіть паразитний шар, могла не відповідати мінімальній планці машинозчитуваного розповсюдження. Аналітична привабливість цієї інверсії, коли спам виступає як неумисний та токсичний проксі для індексування, полягає в тому, що вона перетворює неминучу досаду на безкоштовний спостережний інструмент. Його діагностична сила наразі є лише гіпотезою: кореляція між отриманням розсилок і будь-яким показником видимості ніколи не вимірювалася, і рядки загальної розсилки таблиці 14 показують, чому сирий обсяг спаму був би шумним сигналом навіть принципово.
Хижаки приходять раніше за читачів. Легітимна воронка працює з інституціональними затримками: включення до eJournal кураторське, а не гарантоване, з затримками до 45 днів для об'ємних класифікацій [53], а індексування Google Scholar займає від шести до дев'яти місяців або довше [55]. Завантаження близькі до нуля на першому тижні узгоджуються з нормальним передрозповсюдженням, а не відхиленням (Розділ 6). Паразитний шар, якщо він програмно збирає метадані, не має жодних таких затримок. Ми тому висуваємо гіпотезу, що для автора, чия контактна інформація доступна, очікуваний час до першої хижацької розсилки внаслідок публікації коротший за очікуваний час до першого справжнього вченого контакту, так що невідомий автор зустрив би паразитний шар раніше за легітимний. Спростування просте: справжній контакт надійно передує розсилці.
Задокументовані обсяги розсилок, виміряні в днях і тижнях [9][84], порівняні з механікою розповсюдження, виміряною в тижнях і місяцях [55][53], роблять гіпотезу правдоподібною. Лише дослідження логування, зазначене в Розділі 8, може перевірити це, оскільки існуючі корпуси не були часово прив'язані до подій публікування [63].
7.6 Що паразитичний шар не розповідає авторові
Три граничні твердження обмежують висновки цього розділу.
По-перше, електронні листи-запрошення не змінюють лічильники платформи. Запрошення, надіслане авторові, не генерує перегляд анотації та не спричиняє завантаження статті. Оскільки скрейпери відвідують сторінки анотацій, SSRN стверджує, що фільтрує нерегулярну та автоматизовану активність зі своїх підрахунків завантажень [66][69][144]. Обсяг спаму тому ніколи не є доказом читачів, а переповнена запрошеннями скринька разом із однозначними завантаженнями не містить суперечності: два шари враховують різні речі.
По-друге, паразитичний шар найбільше впливає на авторів, найменше обладнаних для поглинання його витрат: дослідники на початку кар'єри та дослідники з нерідною англійською мовою зазначаються як особливо вразливі до запрошень [142]. Практичний протокол розділу 6 тому розглядає гігієну скрині (скринінг чорних списків будь-яких запрошуючих платформ, ігнорування нежаданих запрошень, перевірка через офіційні сервіси замість застарілих списків) як частину інтерпретації метрик, а не окрему проблему. Автоматизована перевірка хижих видавництв сама по собі є активним напрямом дослідження [157].
По-третє, ранна видимість має ще один побічний ефект, з яким автори стикаються як із явним звинувачуванням: при пізнішій підачі до журналу програмне забезпечення перевірки подібності позначить майже повну відповідність між рукописом та його власним попередником на SSRN, оскільки препринти індексуються в корпусі Crossref Posted Content, який використовує iThenticate [36]. Документація постачальника явно стверджує, що відповідність препринту того ж автора є очікуваним результатом, а не плагіатом [81]. Відповідна відповідь — розкрити препринт редакторові, а не видаляти його.
Паразитичний шар — це місце, де центральне твердження цієї статті найлегше побачити: після заходу Рейтингів, сирі сигнали (завантаження, перегляди і тепер навіть спам) мають значення, яке можна інтерпретувати, тільки коли визначений механізм, який їх породив. Ця специфікація частково доступна для законної шару, а для паразитичного шару вона все ще залишається предметом дослідження.
8. Дослідницька програма, готова до попередньої реєстрації: Відновлення відсутнього референтного класу
Попередні розділи синтезували перевірювані докази щодо метрик уваги SSRN та запропонували рамки інтерпретації для середовища після Рейтингів. Цей розділ є програмою дослідження, готовою до попередньої реєстрації, для емпіричного відповідання на відкриті питання рамок. За дизайном вона не надає результатів: попередньо задані, придатні до фальсифікації діапазони замість висновків. Кожний дизайн, гіпотеза та діапазон передбачень нижче готові бути зареєстровані в Open Science Framework перед будь-яким збиранням даних, з кодом аналізу випущеним одночасно. Припинення Рейтингів SSRN 15 липня 2026 [149], оголошене 12 червня 2026 з першочергово встановленою раннішою цільовою датою [148] та вбудоване в ширше переспрямування платформи [146], робить цю програму особливо чутливою до часу: деякі з дизайнів нижче використовують розрив, чий період перед цим скорочується з кожним місяцем, і один з них, реєстр процентилів розділу 8.8, розглядає розрив вимірювання, який сам захід зробив постійним для зовнішніх спостерігачів.
8.1 Принципи проектування
Чотири принципи визначають порядок денний.
Спостереження від народження. Ретроспективне збирання кумулятивних лічильників не може реконструювати те, що стаття мала на день 3, день 7 або день 30. Отже, будь-яка надійна еталонна панель повинна залучити статті на момент публікації та записувати їхні лічильники у стандартизованому віці: дні 1, 3, 7, 14, 30, 60, 90 та 180 (таблиця 11), з щоденним спостереженням, бажаним протягом перших 45 днів, оскільки SSRN зазначає, що розповсюдження сповіщень у переповнених темах може тривати до 45 днів [53]. Цей принцип також захищає від витоку інформації: показники репутації автора до публікації мають бути заморожені на дату публікації, щоб майбутній успіх не міг забруднювати базові коваріати. Його супутня дисципліна, перенесена з розділу 5.6, полягає в тому, що події розповсюдження, індексування та просування входять у представлені нижче проекти як датовані втручання і ніколи як необраховані контексти.
Розділення охоплення та конверсії. Дотримуючись діагностичної логіки розділу 5 (таблиця 9), кожен нижче наведений проект записує перегляди анотацій та завантаження як окремі результати та моделює завантаження в залежності від переглядів. Низька досяжність та низька конверсія — це різні діагнози: неспроможність потрапити до множини розглядів читача та невикористання після експозиції. Об'єднання їх у один показник викидає інформацію, яка потрібна автору.
Розподільні результати, а не лише середні. Оскільки увага платформи має важко хвостований розподіл [83][85][180], втручання та зміни платформи можуть змінити форму розподілу, залишаючи його середнє значення практично незмінним. Результати, отже, включають коефіцієнт Джині уваги, частки завантажень у топ-1% та топ-10%, частку статей при нульовому або близькому до нуля значенні та коефіцієнти уваги новачків до уваги установлених, у традиції вимірювання нерівності уваги в інших медіа [180].
Можливість фальсифікації. Кожна гіпотеза парується зі стратегією ідентифікації та явною умовою, за якої вона не спрацьовує. Сама рамка піддається можливості відхилення: якщо нормовані за віком та галуззю ранні метрики не перевищують сирові підрахунки поза вибіркою (RQ3 нижче), заявлена перевага нормалізації при вимірюванні повинна бути відхилена або звужена. Можливість фальсифікації також є кількісною: розміри вибірок по всій програмі мають бути завершені за допомогою моделювання потужності для найменших розмірів ефектів, які представляють інтерес. Стратегія множинності для програми з п'яти гіпотез, трьох дослідницьких питань та п'яти положень визначена при попередній реєстрації, а підтверджувальні та розвідувальні аналізи позначені як такі заздалегідь. Атрицю (відкликані, об'єднані або істотно переглянуті статті) відстежується та повідомляється, а не мовчки опускається, з діаграмою потоку когорти в кожному емпіричному звіті програми (розділ 8.8).
8.2 Гіпотези та твердження
Рамка генерує п'ять гіпотез та три дослідницькі питання щодо розподілу ранної уваги та п'ять тверджень щодо її структури. Таблиця 16 пов'язує гіпотези, дослідницькі питання та твердження з виділеними планами (P2, P3b, P4) з результатом, контрастом та переважним планом; P1 та P3 супроводжуються дослідженнями 1 та 2 у таблиці 17.
H1 (Недолік холодного старту). За умови поля, когорти публікацій, спостережуваної теми, характеристик документа та календарних умов статті, авторами яких є виключно новачки платформи, отримують менше первинних переглядів сторінки анотації, ніж статті з принаймні одним раніше видимим автором SSRN. Центральний результат - переглядає, а не завантажень на перегляд, оскільки H1 стосується формування аудиторії, а не конверсії.
H2 (Престиж та експозиція). Інституційний та авторський престиж позитивно передбачають ранній охоп сторінки анотації після контролю за попередньою активністю платформи та спостережуваними характеристиками статей, розширюючи літературу про статус та увагу [104][105][111][140][60] на перший етап дифузії препринту.
H3 (Престиж та умовна конверсія). Інституційний престиж позитивно передбачає завантаження повного тексту за умови експозиції на сторінці анотації. Jo та Li надають недавні свідчення, специфічні для галузі, що відповідають цьому паттерну в маркетингу, премію престижу приблизно +6,6% у швидкості завантаження для триавтора статті з одним автором з топ-50 [83], але ширший лонгітюдний тест залишається необхідним. Разом H2 та H3 визначають головну оцінку панелі: розкладання охоп-та-конверсія градієнта престижу, що означає частину спостережуваної нерівності, пов'язаної з престижем, у завантаженнях, яка виникає до відвідування сторінки анотації (експозиція) проти після нього (умовна конверсія). Знахідка, що більшість градієнта формується до того, як будь-який читач побачив анотацію, розташовувала б нерівність в механіці виявлення, а не в оцінці вмісту, у безпосередньо вимірюваній формі.
H4 (Комунікація як егалізатор). Більша ясність анотації та інформаційна ефективність пов'язані з більшими поліпшеннями в умовній конверсії серед авторів із низькою попередньою видимістю, ніж серед вже видимих авторів. H4 - єдина гіпотеза, обробка якої повністю знаходиться під контролем автора. Її слід тестувати з попередньо визначеними текстовими мірами та окремо з рандомізованим експериментом анотації, розробленим за стандартами онлайн-польових експериментів [30]. Вона не повинна покладатися виключно на автоматизовані класифікатори «написано ШІ», які вводять власну невизначеність вимірювання.
H5 (Стійкість шоків експозиції). Екзогенні або квазіекзогенні ранні шоки експозиції передбачають підвищену подальшу увагу поза безпосередньою вікном експозиції: аналог для наукових платформ динаміки «успіх породжує успіх», експериментально задокументованої в інших місцях [112][131][162], та позиційних ефектів експозиції на arXiv [72][73].
RQ1. Чи змінило скасування Рейтингів 15 липня 2026 р. концентрацію, розподіл або градієнт престижу уваги? Два протилежні передбачення однаково правдоподібні, і питання залишається двостороннім: видалення рейтингів може ослабити цикли популярності-зворотного зв'язку [112][131], або це може замість цього збільшити залежність від попередньо існуючих авторських мереж, видаливши поверхню виявлення, через яку невідомі статті могли б стати видимими після того, як вони почали привертати увагу.
RQ2. Чи виробляє кураторське розповсюджування email-сповіщень більші пропорційні прирости уваги для новачків чи для вже встановлених авторів?
RQ3. Чи передбачають нормовані ранні показники, спостережені на 7-й та 30-й дні, подальші результати наукового цитування або публікації краще, ніж необроблені накопичені завантаження?
Твердження переформулюють структурні позиції рамки у фальсифікованій формі:
P1 (Асиметрія та невидима більшість). На основі випадкової стратифікованої вибірки статей SSRN розподіл загальних завантажень є важкохвостим та правосторонньо асиметричним таким, що медіана менша від половини середнього значення, та істотна частина статей має десять або менше всього завантажень. Фальсифікатор: медіана ≥ 0,5 × середнє значення, або незначна ≤10 завантажень доля. Опубліковане для маркетингової мережі співвідношення середнього до медіани (приблизно 2,54) [83] та квазілогнормальне припасування даних списку 2015 року [85] мотивують, але не встановлюють P1 для платформи в цілому.
P2 (Класифікація визначає розповсюджування). У межах шару репозиторію кількість класифікацій eJournal позитивно пов'язана з завантаженнями та негативно пов'язана з ймовірністю майже нульових завантажень, з контролем за віком та мережею - це репліката та оновлення крос-секційного паттерну Уелена 2018 року [168] в умовах механіки кураторського розповсюджування платформи [53][57]. Фальсифікатор: немає значимого зв'язку після контролю. Кількість класифікацій сама по собі потенційно ендогенна: статті більш широкої релевантності можуть одночасно отримати більше класифікацій та привернути більше читачів, тому крос-секційний зв'язок перебільшує будь-який ефект розповсюджування. Бажана ідентифікація є тому змінами класифікацій у межах статті, де доступні, з експліцитно повідомленою крос-секційною оцінкою як верхнюю межею.
P3 (Видимість для машин низька та залежна від ознак). Для запитів, побудованих так, щоб конкретний препринт SSRN був найкращим доступним джерелом, AI системи генерування відповідей цитують препринт у меншості випадків, а видимість для машин підвищується з функціями, аналогічними задокументованим факторам оптимізації генеративних двигунів [5][164]. Фальсифікатор: препринти цитуються в більшості випадків незалежно від функцій, або жодна функція не передбачає видимість.
P3b (Матфіївський ефект на рівні машин). За умови експертом підтвердженої релевантності запиту статті з більшою попередньою видимістю в вебі та в науці цитуються AI системами відповідей частіше, ніж інакше порівняні статті з холодного старту. За альтернативою справедливості генеративні двигуни шукають за релевантністю без премії за попередню видимість, і P3b відхиляється, результат, за якого рівень машин був би більш егалітарним, ніж людські шари виявлення H1–H3, а не менш. Фальсифікатор: немає градієнту видимості при матчованій релевантності запиту. P3b розширює лінію кумулятивної переваги H1–H3 до вершини стека виявлення. Тестування цього вимагає коваріат попередньої видимості та стратифікації запиту, вказаних у дослідженні 2 (Розділ 8.6).
P4 (Хижаки приходять раніше за читачів). Для щойно розміщеного препринту, чиї бібліографічні метаданні та контактний шлях можна отримати з розміщеного документа або пов'язаних публічних сторінок, очікуваний час до першого хижацького запиту, що приписується розміщенню, коротший, ніж очікуваний час до першого справжнього наукового контакту. Спростування: справжній контакт надійно передує хижацькому запиту. P4 наведено умовно залежно від можливості отримання даних, оскільки публічна видимість контактних даних автора на поточному інтерфейсі платформи не встановлена. Механізм отримання даних задокументований для препринтних сховищ у загальному [107][159][151], а непрошена електронна пошта є першим контактом з хижацьким журналом для значної частини запрошених авторів [32]. Атрибуція тому вимагає інструментованого дизайну Дослідження 3, а не висновку виключно на основі часу надходження.
Таблиця 16. Гіпотези, дослідницькі питання та стратегії ідентифікації.
| Питання | Первинний результат | Основний контраст | Бажаний дизайн |
|---|---|---|---|
| H1: невигідна позиція новачків | Поступові перегляди | Новачок проти встановленого | Ієрархічна поздовжня модель підрахунку |
| H2: престиж та охоплення | Поступові перегляди | Вищий проти нижчого попереднього престижу | Панель, скорегована за коваріатами + узгоджений аналіз чутливості |
| H3: престиж та конверсія | Завантаження залежно від переглядів | Вищий проти нижчого престижу | Модель експозиції від'ємного біноміального розподілу/Пуассона |
| H4: вирівнювач комунікації | Умовна ймовірність/швидкість завантаження | Ясність × попередня видимість | Спостережна текстова модель + рандомізована реплікація |
| H5: накопичена увага | Перегляди/завантаження після удару | Удар експозиції проти допередударної траєкторії | Внутрідокументне дослідження подій |
| RQ1: вихід рейтингів з ужитку | Щоденна увага; Gini; основні акції; обсяг нових розміщень за областями | Раніше піддавалися рейтингуванню проти порівняльних полів | Переривана конструкція/дизайн дослідження подій |
| RQ2: розповсюдження електронної пошти | Щоденні перегляди/завантаження | До та після розповсюдження | Внутрідокументне дослідження подій (Розповсюдження × Новачок) |
| RQ3: прогностична валідність | Цитування за 6/12/18 місяців | Нормалізовані проти сирих ранніх метрик | Порівняння прогнозів поза вибіркою |
| P2: класифікація визначає представлення | Завантаження; ймовірність майже нульових завантажень | Підрахунок класифікації; внутрідокументні зміни класифікації, де доступні | Панельна регресія + внутрідокументний дизайн змін |
| P3b: ефект Матвія на рівні машини | Пряме цитування системою відповідей | Висока проти низької попередньої видимості при узгодженій релевантності запиту | Повторний багаторівневий аудит пошуку (Дослідження 2) |
| P4: хижаки раніше за читачів | Час до першого та швидкість закодованих вхідних повідомлень | До розміщення проти після розміщення вікон; хижацький проти справжнього контакту | Інструментована перспективна когорта + модель історії подій (Дослідження 3) |
Примітка. Усі рядки є перспективними дизайнами. Жоден не був виконаний. Результати, контрасти, правила виключення та референтні класи мають бути передзареєстровані перед збиранням даних.
8.3 Основна панель
Еталонний дизайн — це багатодисциплінарна когорта статей, недавно розміщених на SSRN, за якими спостерігали принаймні дванадцять місяців від розміщення, спостережено за графіком таблиці 11. На рівні статті набір даних зберігає найдавнішу доступну версію назви, анотації, імен авторів та їхнього порядку, приналежності, дати розміщення, класифікацій, ключових слів, кількості сторінок, DOI де доступний, історію редагувань, кількість переглядів публічної анотації, кількість публічних завантажень та подальші показники цитування з відповідністю ідентичності авторів до відкритої бібліографічної інфраструктури [35][124], вручну перевіреної на випадковій підвибірці перед використанням виведеної репутації у масштабі. Статус новачка визначається як відсутність у жодного автора розглядуваної статті публікації на SSRN, датованої до дати розміщення розглядуваної статті, з визначеннями чутливості на основі кількості попередніх статей та запасу цитування до розміщення. Престиж установи не входить до цього визначення: оскільки престиж сам є пояснювальною змінною в H2 та H3, вбудування його у статус новачка механічно змішало б новизну платформи з попередньою видимістю автора й звело б нанівець гіпотези, які дизайн покликаний розділити. Престиж тому входить у моделі лише як окрема коваріата. Нормалізація за попередньою видимістю має бути обробена з відповідною обережністю з міркувань справедливості: занадто агресивне вирахування базисної лінії попередньої видимості штрафувало б справжній ранній успіх молодого автора та статистично стирало б, а не розкривало б, будь-яке систематичне недостатньо представлення авторів з маргіналізованих груп та Глобального Півдня. Відповідь рамки — виміряти, де формується нерівність, а не нівелювати її: розкладання досяжності-проти-конверсії локалізує, чи виникає розрив видимості на рівні експозиції чи конверсії, а престиж входить як коваріата для розуміння, а не як шум для мовчазного диференціювання. Розподільчий ефект престижу на увагу є первинним результатом квазиекспериментів (розділи 8.4–8.5). Календарні контролі включають день тижня, тиждень року, академічний сезон та фіксовані ефекти дати. Документована варіація доступу до статей у вихідні дні та сезонна варіація (активність приблизно на 11% нижча у вихідні дні та на 50% нижча влітку в недавній панелі семи журналів [178]) ускладнює обґрунтування їх пропуску у будь-якому дослідженні високочастотного використання. Повний словник панельних змінних (у межах близько двадцяти полів, включаючи прирости інтервалу, а не лише сукупні підрахунки, дату розповсюдження де надана згода, запаси цитування на 6, 12 та 18 місяців та номер редакції) вказано в додатку C (таблиця C1), а той же файл схеми депонований з матеріалами попередньої реєстрації (розділ 8.8; Декларації).
Досяжність моделюється як ієрархічний процес від'ємного біноміального розподілу для додаткових переглядів з ефектами поля-за-віком, календарними ефектами та гетерогенністю рівня статей. Умовна конверсія моделюється як додаткові завантаження з логарифмом додаткових переглядів як експозиція, так що отримання відвідування цільової сторінки та конверсія цього відвідування статистично розділені. У компактній формі для статті i в інтервалі t:
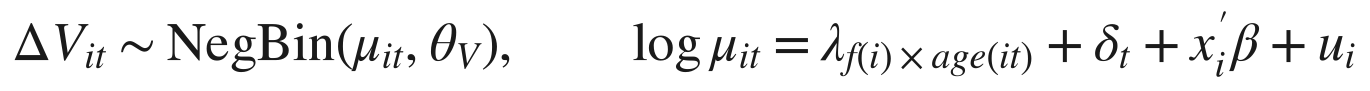

де λ_{f×age} — ефекти поля-за-віком, δ_t — ефекти календарної дати, u_i та w_i — гетерогенність рівня статей, а зміщення логарифму переглядів у другому рівнянні робить завантаження залежними від експозиції цільової сторінки. Взаємодія Новачок × Ясність γ_3 є тестом H4. Ці рівняння фіксують попередньо визначені оцінювачі та розділення досяжності від конверсії, а ієрархічна структура виконує саме часткове об'єднання емпіричного Байєса, яке розділи 5.2 та 8.8 вимагають перед публікацією процентилю будь-якої рідкісної клітинки. Контролі тем у x_i конструюються з вкладень назви–анотації, заморожених та кластеризованих при попередній реєстрації, перед спостереженням будь-яких результатів, так щоб композицію тем неможливо було адаптувати до результатів. Оскільки статті одночасно займають до семи класифікацій, ефекти класифікацій оцінюються за допомогою ієрархічних структур множинного членства, а не примусовим розподілом кожної статті до однієї категорії. Оскільки фіксовані ефекти статей поглинають часово-інваріантні показники статусу, базові ефекти новачка та престижу оцінюються між статтями, тоді як фіксовані ефекти статей зарезервовані для внутрішньостаттєвих обробок, таких як події розповсюдження. Надмірна дисперсія та надлишкові нулі формально перевіряються, альтернативи бар'єру та нульової інфляції звітуються де обґрунтовано, а важкий хвіст обробляється квантильною та робастною оцінкою, а не видаленням успішних статей. Правила очистки даних самі по собі попередньо визначені, а не на розсуд, а протокол аномалії — позначити, не видалити. Попередньо визначений список сигналів охоплює: крайність інтервалу порівняно з історією самої статті, скачок переглядів без руху завантажень, розрив у конверсії, повторені однакові мітки часу та переформулювання платформи. Позначений інтервал ніколи не видаляється з архіву: він зберігається з кодом причини, і кожен основний результат звітується на чотирирівневій драбині чутливості: (i) незмінені лічильники; (ii) виключаючи лише підтверджену платформою недійсну активність; (iii) робастна чи винзоризована оцінка; (iv) виключаючи всі позначені інтервали, так щоб будь-який висновок, що пережив лише на одному рівні, був видимий як хиткий. Пороги калібруються проти спостережуваного розподілу, а не встановлюються апріорно. Де доступні журнали партнерів, поля реферера, користувацького агента та географії розрізняють трафік новин, блога, попередньої загрузки та краулера. Документовані всплески завантажень, викликані блогом, на SSRN [116] ілюструють, чому екстремальне значення часто є органічним успіхом, а не забрудненням. Виявлення аномалій — це інструмент вимірювання. Це не дозволяє відкидати незручний успіх.
Та сама дисципліна застосовується до часової структури. Панель розрізняє граничну та кумулятивну увагу: криві когорт інтервальних завантажень ΔD та частка завантажень статті за 180 днів, накопленої в кожному віці, а не лише загальна кількість завантажень за весь час. Вона не накладає єдиний експоненціальний період напіврозпаду на затухання, оскільки завантажування затухає на кількох часових шкалах одночасно [91]. Криві віку тому встановлюються зі сплайнами або непараметричними оцінювачами за замовчуванням, з логарифмічними трансформаціями, що використовуються для вивчення структури, і сирові дані збережені для еталонного звітування. Надійність обробляється так само: престиж операціоналізується через кілька альтернативних показників, а не один поріг рейтингу, статус новачка повторно перевіряється за прогресивно строгішими визначеннями, і результати звітуються з вінзоризованими перевірками чутливості та графіками повного розподілу поряд з оцінками квантилів.
Оскільки не існує публічного SSRN API [134][51], збір даних здійснюється трьома шляхами в порядку переваги: формальний запит на дані у SSRN/Elsevier або партнерство з SSRN/Elsevier; експорти панелей інструментів з дозволу авторів, в яких автори, що беруть участь, вносять свої власні дані панелей статистики з інформованою згодою, проміжний рівень, на який вже спирається реєстр розділу 8.8; і обмежена за частотою та що поважає robots.txt вибірка статей з публічних сторінок, чия технічна можливість встановлена існуючими інструментами збору з відкритим кодом [134]. Дизайн виключає масовий скрейпинг, що порушив би умови обслуговування, і він не представляє жодну недокументовану кінцеву точку як стабільний API. Обмеження доступу обговорюються як обмеження у розділі 9.
8.4 Квазі-експеримент I: розповсюдження email-сповіщень як шок уваги
Розділи 8.4 та 8.5 утворюють один аналітичний модуль, досліджуючи дві платформні втручання як взаємодоповнювальні обробки в одній панельній когорті. Розповсюдження сповіщень додає поверхню експозиції, скасування Rankings вилучило її, і обидва розглядаються на тлі спільного набору результатів розподілу (частка новачків, градієнт престижу, Gini уваги, топові частки). Механізм сповіщень SSRN аналітично цінний, тому що розміщення та розповсюдження можуть не збігатися. Папери спочатку стають публічно доступними, а відповідна робота потім розповсюджується через кураторські сповіщення e-журналу, час яких варіюється і не гарантується [53][57]. Для авторів, які дають згоду надати дати статусу розповсюдження, подієве дослідження в межах папера може оцінити шлях уваги навколо дати розповсюдження, причому кожен папір служить собі контролем, щоб стійкі різниці в привабливості теми, ідентичності автора та установі були поглинені. Специфікація — це стандартна форма дослідження подій: для результату Y_it (перегляди в інтервалі чи завантаження),
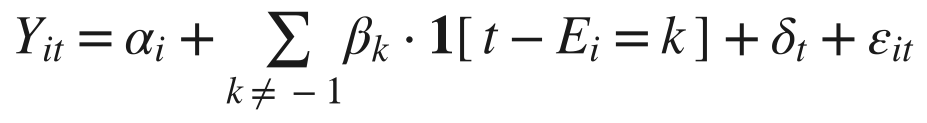
де E_i — дата розповсюдження папера i, α_i — фіксовані ефекти папера, δ_t — ефекти календарної дати, а β_k, нормовані до k = −1 періоду референції перед розповсюдженням, відстежують шлях уваги навколо подіі. Рівняння задає оцінюваний параметр для передреєстрації. Ключовий гетерогенний ефект — це взаємодія Distribution × Newcomer, оцінена через взаємодію β_k зі статусом новачка. Якщо сповіщення диспропорційно покращують досяжність новачків, кураторське розповсюдження функціонує як врівнювач на рівні платформи; якщо прибутки накопичуються диспропорційно для престижних авторів, розповсюдження посилює існуючі репутаційні переваги (RQ2). Попередні докази того, що дискретні експозиційні подіі (списки на передніх позиціях на arXiv [72][73], висвітлення публікацій SSRN у блогах [116]) дають гострі ранні піки уваги, вказують, що дизайн має виявлюваний перший етап. Передзазначена специфікація також включає альтернативні часові вікна навколо дати розповсюдження та окремі звіти для паперів, розповсюджених швидко, порівняно до розповсюджених після довгої черги класифікації, оскільки затримка тривалістю до 45 днів [53] інакше змішує гетерогенні історії експозиції в один час події. Фіксовані ефекти папера поглинають тільки часово-інваріантну привабливість, тому три умови дизайну є основними. Час розповсюдження курується, а не випадковий: платформа вибирає, які допустимі папери вона розповсюджує та коли [53][57]. Дата події тому містить часово-змінну селекцію за актуальністю (папір, розповсюджений на тижні, коли тема стає помітною, відрізняється від того ж папера, розповсюдженого в спокійному тижні), і ця селекція зберігається попри фіксовані ефекти папера, що є причиною того, що специфікація залежить від затримки розповсюдження та окремо звітує про стратифіковані часи розповсюдження. Дати статусу розповсюдження також спостерігаються тільки для авторів, які дають згоду, тому оціночна вибірка є самовибраною підмножиною панелі. Статус згоди тому реєструється, а вибірка дослідження подій порівнюється з повною когортою за спостережуваними коваріатами; селекція обмежує зовнішню валідність. Крім того, автори можуть синхронізувати час своєї публіцитету зі сповіщенням: узгоджена саморекламна піка видавалася б як ефект розповсюдження. Датований журнал промоції автора (версіонований пакет доказів розділу 6.1) тому є вимогою цього дизайну: без нього органічна піка розповсюдження не може бути розрізнена від самостійно генерованої, і схема аномалій розділу 8.3 позначує, а не видаляє будь-яку піку, яка збігається з зареєстрованою авторською промоцією.
8.5 Квазі-експеримент II: припинення роботи рейтингів як природний експеримент
Припинення 15 липня 2026 року [149] дозволяє провести другий аналіз, якщо історичну експозицію рейтингу можна реконструювати з архівованих сторінок рейтингу. Дві особливості дизайну послаблюють чистий аналіз подій за однією датою. Втручання не мало місце в одну дату: сторінки рейтингу per-eJournal припинили оновлюватися з 11 грудня 2025 року (Розділ 2.2 [B-2]), приблизно за сім місяців до видалення 15 липня 2026 року, тому вилучення поверхні виявлення рейтингу краще моделюється як поступовий процес — перший етап заморозки живих сторінок, за яким слідує їх остаточне видалення, ніж як єдина загальна дата подіїї. Відповідно, специфікація передбачає принаймні два часи подій (заморозка грудня та видалення липня), зі ступінчастою формою як первинна модель та однодатовим підгонянням, протестованим проти неї. Крім того, не можна припускати дисципліни, «раніше піддані рейтингу», виходячи зі структури платформи: рейтинги охоплювали всю платформу, тому диференційна експозиція є ендогенною і не операціоналізується називанням полів, які «сприймалися» рейтингованими. Експозиція має бути виміряна, а не призначена: наприклад, на основі архівованих сторінок рейтингу, відновлених через Internet Archive, як частка робіт поля, що коли-небудь потрапили до публічних топ-списків, або щільність присутності поля на сторінках per-eJournal. Питання про те, чи архів достатньо щільно охоплює сторінки рейтингу кожного поля, щоб дати вимірювану експозицію, ще не встановлено; дизайн повідомляє про цю щільність поряд з мірою експозиції. З такою виміреною експозицією специфікація аналізу подій на рівні статті порівнює траєкторії уваги у полях з високою та низькою експозицією навколо дат заморозки та видалення: рівняння розділу 8.4 з коефіцієнтами інтересу щодо взаємодій Exposure_f × EventTime_k, а не лише щодо термінів часу подій. Найбільш інформативні результати є розподільними (Розділ 8.1). Механізм рейтингу міг би змінити концентрацію уваги, залишаючи середні показники майже без змін, і оскільки будь-який ефект, очікується, концентруватиметься в уже видимих хвостових працях, що заповняли списки, показники середнього поля мають недостатню потужність за конструкцією. Коефіцієнти Джині, показники топ-частки, коефіцієнти новачків/утверджених та градієнти престижу є тому первинними результатами, з двобічним передбаченням RQ1, і моделювання потужності розділу 8.1 повинне бути спрямовано на ці розподільні статистики, а не на середню увагу, інакше дослідження ризикує бути оголошеним нульовим через недостатню потужність щодо неправильного оцінюваного параметра.
Два названі, спрямовані прогнози уточнюють двосторонній RQ1, не замінюючи його, обидва з них — попередньо визначені тести гетерогенності. Гіпотеза видимості-обриву стверджує, що когорти постингу після закриття у полях, які раніше були піддані впливу рейтингів, переживають дискретний спад у ранній досяжності порівняно з відповідними когортами до закриття, оскільки поверхню виявлення було видалено на відому дату. За компенсаторною гіпотезою, якби рейтинги функціонували як компенсаторний механізм видимості для полів зі слабкими екосистемами виявлення, вплив їх видалення мав би бути найбільшим у полях з малими базами підписок на eJournal, на нижчому кінці градієнта Уейлена [168].
Простий вторинний результат розширює дизайн від розподілу уваги до здоров'я самої платформи: обсяг нових постингів за полями у вікнах до і після 15 липня 2026 р. Якби рейтинги давали частину стимулу для постингу, їх припинення могло б охолодити нові публікації. Це поведінковий результат, відмінний від результатів уваги вище, спостережуваний на основі публічних переліків нових статей порівняно з власною базовою лінією платформи, де налічується більше ніж 250 000 нових робіт у 2025 р. [145], та прямої емпіричної відповіді на одночасну полеміку "jumped the shark", записану в розділі 2.2 [12][B-11]. Прогноз залишається двостороннім, як RQ1, і результат обсягу постингу пов'язується з пунктом (3) опитування Study 4 («уникнення нових завантажень»).
Аналіз є квазіекспериментальним. П'ять загроз є суттєвими. Однією є ефекти оголошення та передчуття: припинення було оголошено 12 червня 2026 р. з первісною цільовою датою 1 липня і виконано 15 липня, тому існувало справжнє вікно передчуття, яке змінилось [148][149]. Кластер одночасних змін платформи 2026 р. поділяє календар закриття і не може бути відокремлений від нього жодною окремою датою事件: стратегічне переорієнтування, оголошене 13 квітня 2026 р., припинення комерційної Research Paper Series, що тривала до кінця грудня 2026 р., і зміна ліцензування авторів від 20 липня 2026 р., п'ять днів після видалення [146][150]. Оскільки ці втручання перекриваються з липневим вікном, одна спільна дата подій приписувала б їхній сукупний ефект винятково закриттю. Визначення тому спирається на розподілену послідовність часу, зазначену вище (грудневий заморозок передує всім їм), на плацебо-дати та розподільну сигнатуру, специфічну для вилучення рейтингу; дизайн вказує, які синхронізовані за часом зміни залишаються невідокремленими. Потім є літня впадина уваги: середина липня збігається з задокументованим сезонним спадом у науковому доступі, при доступах, що зменшуються на порядок 50% у літні місяці [178], тому кросполярний контраст, проведений на дату видалення, змішує закриття з власною літньою сезонністю поля, яка різниться за дисципліною. Фіксовані ефекти календарної дати поглинають лише спільну сезонну складову. Дизайн тому вимагає сезонних базових ліній, специфічних для поля (порівняння окна попереднього року для кожного поля). Невипадкові різниці між полями з високим і низьким впливом — це подальша загроза, розв'язувана операціоналізацією виміряного впливу, наведеною вище, і узгодженими групами порівняння. Залишаюча загроза є перспективною: SSRN заявив, що він може переглянути рейтинги, тому часткове відновлення під час вікна спостереження ввело б другу подію. Дизайн попередньо реєструє обробку будь-якого такого відновлення як точки цензурування для пост-періоду та моделювання його як окремого лікування, а не включення його в контраст закриття. У всіх звітах час подій розділяється на три названих періоди, оголошення (від 12 червня 2026 р.), перехід та припинення (від 15 липня 2026 р.), щоб оцінити ефекти передчуття. Попередньо визначений дизайн тому включає передтрендові тести часу подій, альтернативні смуги пропускання, плацебо-дати, тренди часу, специфічні для поля, сезонні базові лінії, специфічні для поля, та аналізи чутливості, виключаючи період переходу від оголошення до припинення. Рисунок 11 представляє очікувані результати обох аналізів подій як шаблони дизайну.
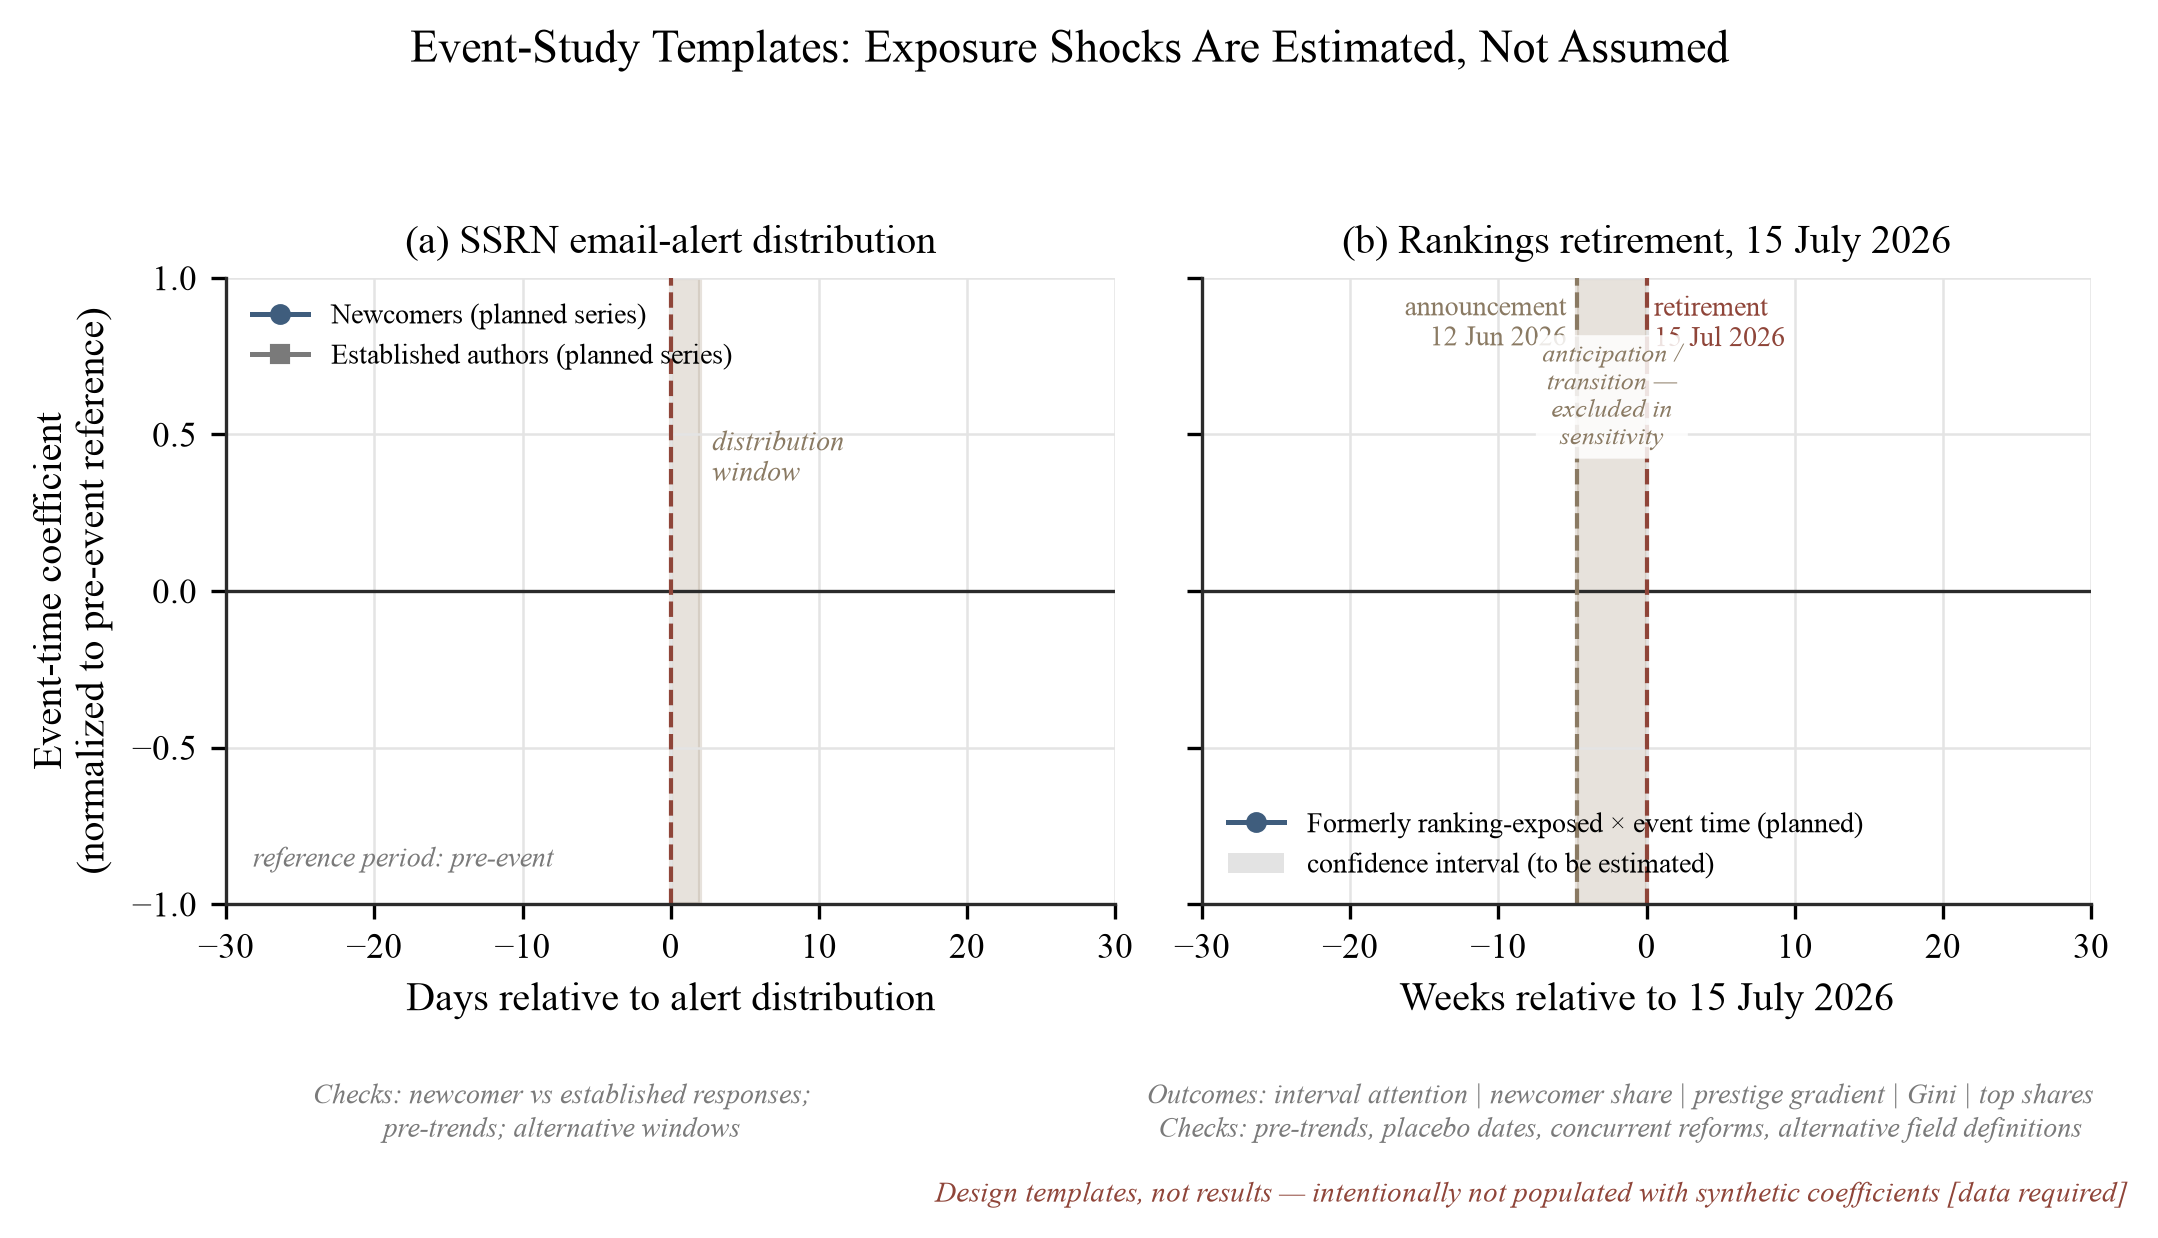
Рисунок 11. Шаблони дизайну event-study для двох платформних квазіекспериментів. Попередньо задані результати event-study для дизайнів розділів 8.4–8.5: (a) увага навколо розповсюдження email-оповіщень, новачки проти маститих авторів, з затіненим вікном розповсюдження, оскільки оповіщення надходять як вікно, а не миттєво; (b) результати уваги та нерівності навколо припинення Рейтингів, з обома позначеними датами оголошення (12 червня 2026) та припинення (15 липня 2026) та затіненим періодом передбачення/переходу — вікно виключено в попередньо заданих аналізах чутливості. Розподільні результати (інтервальна увага, частка новачків, градієнт престижу, Gini, топові частки) та необхідні перевірки вказані на самій фігурі. Коефіцієнти нормалізовані до довідкового періоду до подієї; затінені сірі регіони позначають довірчі інтервали. Ці панелі є шаблонами дизайну; емпіричні значення не показані, а генерований код буде випущений разом з матеріалами попередньої реєстрації.
8.6 Чотири попередньо визначені дослідження
Крім основної панелі, чотири дослідження визначені й узагальнені в Таблиці 17. Два дослідження з відкритими даними (1 і 2) можуть проводити будь-які дослідники без обмежень на доступ у межах обмежень доступу, зазначених у Розділі 9 (збір з обмеженням частоти відповідно до умов обслуговування платформи). Два дослідження з людьми-учасниками (3 і 4) потребують учасників і проводяться відповідно до схвалень етики, зазначених у Деклараціях. Усі чотири існують, щоб негайно почати заповнювати вакуум еталонів, а не чекати, поки багаторічна панель сформується.
Таблиця 17. Чотири попередньо визначені дослідження.
| Дослідження 1 | Дослідження 2 | Дослідження 3 | Дослідження 4 | |
|---|---|---|---|---|
| Дослідницьке питання | Яка медіана/процентильний розподіл завантажень? | Чи цитують механізми відповідей AI сам препринт? | Читач чи хижак першим? | Як автори читають власні лічильники? |
| Дані | 3000–5000 стратифіковані ID документів SSRN | 100–200 нішевих питань × ~5 механізмів | 2 оснащені публікації, 90-денний журнал вхідних даних | Попередньо зареєстроване опитування авторів, чотири пункти зі стандартними формулюваннями |
| Метод | Медіана, Gini, криві розпаду, регресія кількості класифікацій | Кодування витягування + логістична регресія | Відстеження псевдонімів за каналами + кодування повідомлень | Закритий опитувальник + описові частки |
| Основний результат | Медіана; частка завантажень ≤10; Gini уваги | Видимість машини V | t_reader порівняно з t_predator | Частка тих, які ніколи не порівнювали лічильники ні з яким еталоном; розподіл першого читання для «7 завантажень» |
| Спростовна прогнозна гіпотеза | медіана < 0,5 × середнє; Gini 0,75–0,90 | Препринт цитований у 10–35 % випробувань | t_predator < t_reader | Більшість повідомляють, що ніколи не порівнювали ні з яким еталоном |
| Основний результат | Публічні, зчитувальні машиною таблиці еталонів процентилів, стратифіковані за віком, полем та когортою | Відтворюваний протокол аудиту витягування та атрибуції з позначеною часом миттєвою копією | Відкритий протокол оснащеної публікації з вихідною лінією до публікації та кодексом кодування | Документований розподіл інтерпретацій авторів та повідомлених змін поведінки |
| Дизайн не спрацює, якщо | Нормалізація не покращує стійкість або позапробіркове передбачення порівняно з необробленими підрахунками | Ознаки не передбачають нічого крім релевантності запиту, механізму та дати | Немає розриву після публікації після контролю вихідної лінії та впливу, або ненадійне кодування | Набір учасників або самовідбір залишає навіть описові частки неінтерпретовними |
| Профіль ресурсів | Публічні дані; стандартний скрейпінг та статистика | Публічні запити AI-механізмів; ручне кодування | Дві оснащені публікації; логування входу (IRB) | Анонімне опитування авторів (IRB) |
Примітка. Кожне дослідження має бути зареєстроване на OSF перед збором даних з випущеним кодом.
Дослідження 1: «Анатомія медіани». Дослідження відбирає випадкову стратифіковану вибірку з 3000–5000 ID анотацій SSRN (діапазон планування) з остаточним обсягом вибірки, встановленим моделюванням потужності порівняно з попередньо визначеними смугами прогнозу та найменшими ефектами, що цікавлять (Розділ 8.1). Стратифікація здійснюється за роком публікації та мережею, а загальна кількість завантажень документа, перегляди анотацій, дата публікації та кількість класифікацій збираються через шляхи доступу в Розділі 8.3. Оцінювані параметри: медіана накопичених завантажень; частки документів з нулем та з десятьма або менше завантаженнями; Gini уваги з довірчими інтервалами бутстреп; коефіцієнт конверсії переглядів на завантаження, оцінено загалом і стратифіковано за мережею (тест гіпотези про стиль читання аудиторії в Розділі 5.2); криві розпаду завантажень; та регресія логарифму завантажень на кількість класифікацій з фіксованими ефектами року та мережі (прямий тест P2 [168]). Попередньо визначені смуги прогнозу (медіана накопичених завантажень приблизно 30–80, частка завантажень ≤10 становить 15–30 %, Gini 0,75–0,90) є екстраполяціями з опорних точок у Розділі 5 [83][85][139] та з величин уваги Gini у суміжних носіях інформації [180], зазначених заздалегідь, щоб дослідження могло їх спростувати. Дослідження 1 є основою для еталону процентилів, обговореного в Розділі 8.8.
Дослідження 2: «Чи читають вас машини?» Все більша частка пошуку інформації тепер починається з генеративних інтерфейсів: приблизно половина дорослих в США повідомляють про використання чат-ботів AI, а близько чверті використовують їх щодня [121], з суттєвою меншістю, яка вже розглядає чат-бот як свою першу пошукову систему в зручних вибірках [4]. Вступ (Розділ 1.6) концептуалізував це як вертикальну міграцію шлюзу доступу (журнальний бренд → сховище → пошукова система → рівень відповідей AI) з кожним кроком, що переміщує контроль все далі від автора й від будь-якого публічного еталону (Рисунок 12). Невідомо, чи верхній рівень взагалі витягує препринти: література про оптимізацію генеративних механізмів поки що зосереджувалася на брендах та комерції [5][100][164], а аудити пошуку AI стосувалися атрибуції новин, а не наукових джерел [82]. Ці аудити радять скептично ставитися до надійності нового шлюзу доступу: в аудиті Tow Center (1600 запитів у восьми механізмах) механізми в цілому не змогли витягти правильну інформацію більш ніж у 60 % випробувань, з кращим виконавцем (Perplexity), який неправильно відповідав 37 % часу, та гіршим (Grok-3) 94 %, і вони, як правило, помилялися з необґрунтованою впевненістю, а не відмовлялися відповідати [82], цифри з тесту атрибуції новин, а не з наукового пошуку. Жодного контрольованого дослідження видимості наукових препринтів у системах відповідей AI не існувало станом на август 2026 р. [100]. Дана робота розглядається на тлі двох суміжних напрямів дослідження. Дослідження з оптимізації для генеративних механізмів, на яких побудована ця стаття, вимірюють і маніпулюють видимістю брендів і комерційних сторінок [5][164], а не витягуванням наукових артефактів. Окремий напрям показує, що коли мовні моделі взагалі генерують цитування, вони відтворюють і посилюють людську тенденцію посилатися на вже часто цитовані роботи, поширюючи ефект Матвія на рівень машини [7], який є механізмом, що його перевіряє P3b (Розділ 8.2). Жоден напрям не дослідив виявляємість наукових препринтів за контрольованої релевантності запитів, і зокрема їх витяговність після видалення поверхні рейтингу платформи, що є тим, що специфічно виділяє Дослідження 2.
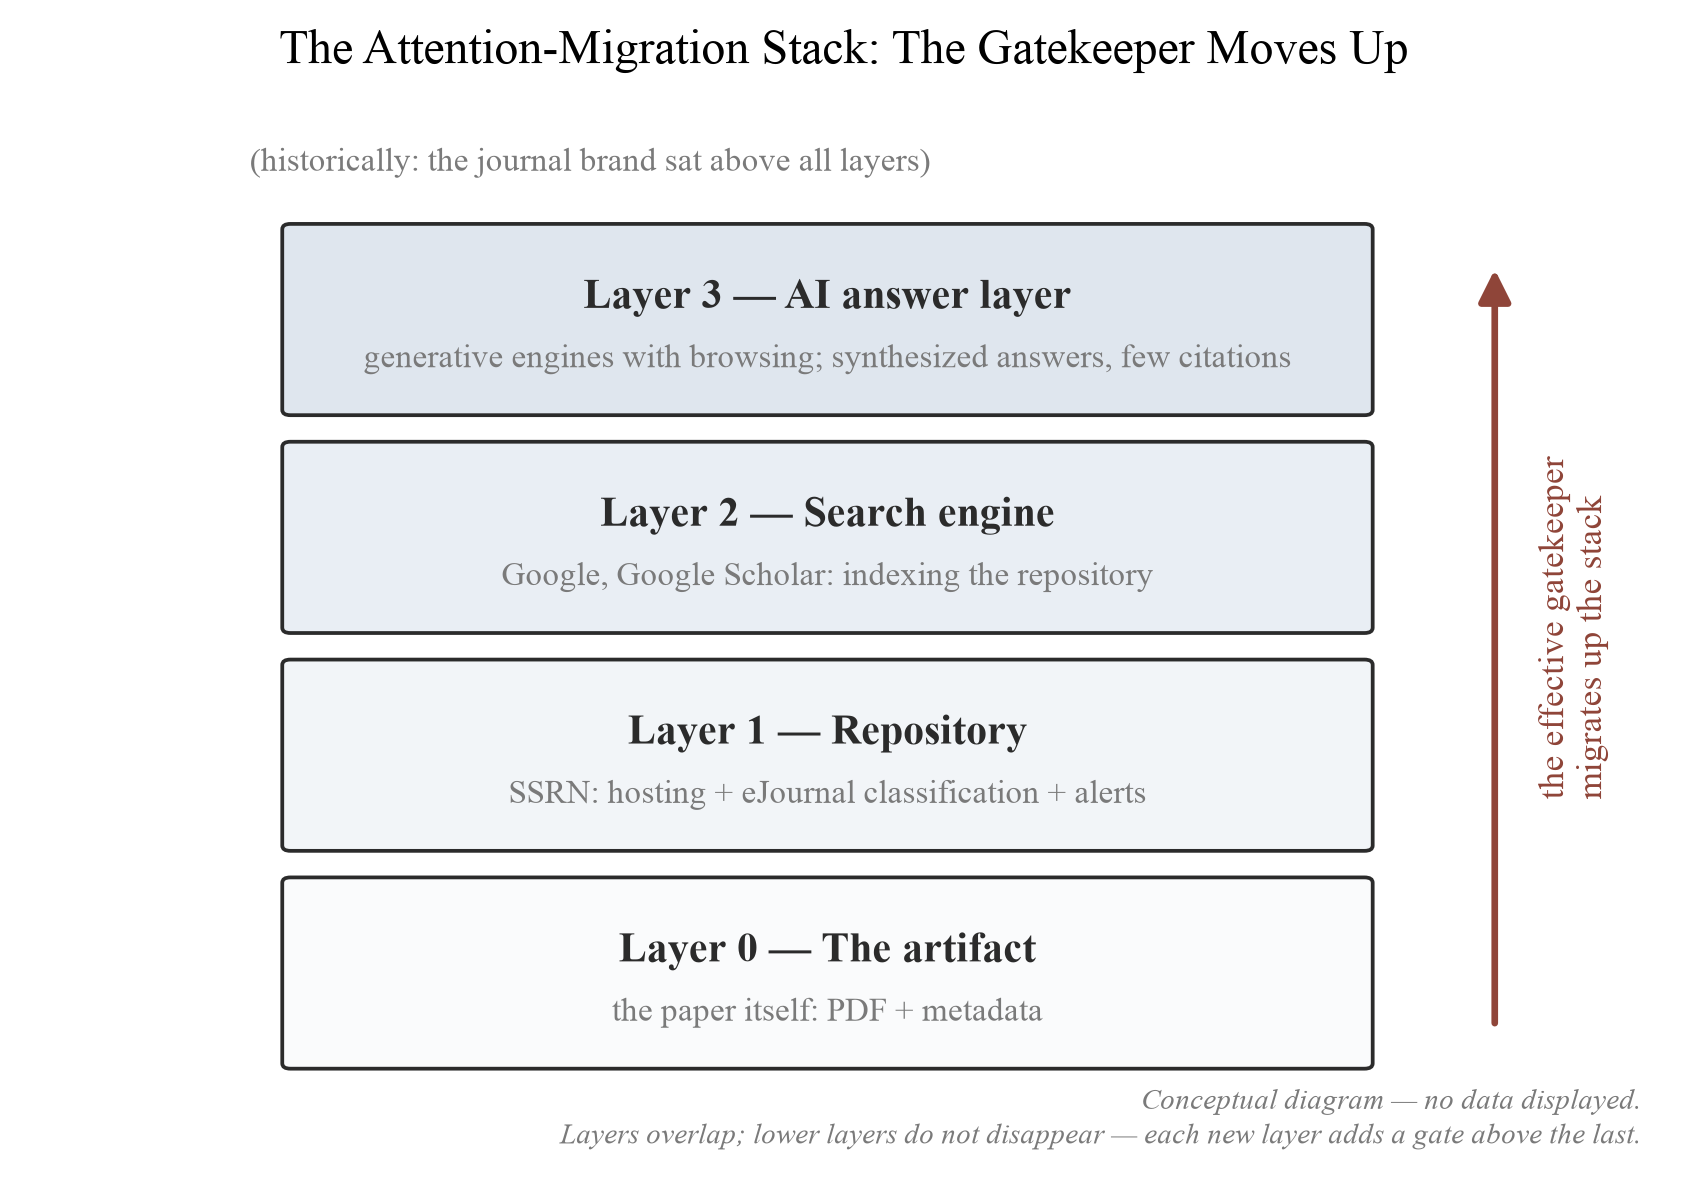
Малюнок 12. Стек міграції уваги. Багатошарова траєкторія від закінченого рукопису до уваги читача. Теза міграції стверджує, що ефективний охоронець — шар, який вирішує, які артефакти отримують увагу, — переміщувався вверх з часом, від марки журналу через репозиторій та пошукову машину до шару відповідей штучного інтелекту; кожне переміщення вверх переміщує контроль далі від автора та далі від будь-якого публічного еталону. Стек є концептуальною моделлю.
Дослідження 2 конструює 100–200 нішевих запитань, кожне спеціально розроблене так, щоб один конкретний препринт SSRN був найкращим доступним джерелом, твердження про релевантність підтверджене сліпими експертними оцінювачами, а не самосертифіковане авторами запиту. Воно надсилає запити до основних споживацьких систем штучного інтелекту з увімкненим переглядом та кодує результат у шість взаємовиключних категорій: (1) центральний препринт цитується; (2) опублікована версія або дзеркало того ж паперу цитується, випадок, який грубіша схема неправильно класифікувала б як відсутність; (3) вторинне висвітлення цитується без паперу; (4) цитується інше, але обґрунтоване джерело; (5) жодного відслідковуваного джерела; та (6) відмова двигуна (Малюнок 13). Для кожної відповіді, яка цитує центральний папір або його версію, бінарний прапорець точності атрибуції додатково фіксує, чи твердження в відповіді насправді підтримується цитованим джерелом. Видимість та точність повідомляються окремо і ніколи не об'єднуються в один показник, оскільки двигун може помітно цитувати папір, при цьому його перекручуючи (відмивання цитат), або відтворювати його вміст без будь-якої цитати (вплив без атрибуції). Підтвердна регресія залишається логістичною, на контрасті «центральний папір або його версія цитується» проти всіх інших результатів, зі стандартними помилками, кластеризованими, або краще — з пристосованою перехрещеною структурою випадкових ефектів, щоб урахувати залежність спостережень, які мають спільний двигун, запит або центральний папір, оскільки той самий папір, запитаний через різні двигуни, та той самий двигун, запитаний щодо різних паперів, кожен індукує корельовані результати, які припущення про незалежність випробувань мали б занижити. Формально оцінюваний параметр аудиту — це M_pqe: ймовірність того, що папір p цитується двигуном e у відповідь на запит q. M_pqe не є властивістю самого паперу, оскільки він змінюється залежно від запитів, двигунів, дат та версій моделей, тому позначення визначає оцінюваний параметр і кожен позначений часом запуск читається як оцінка M_pqe на його дату. Вибірка двигунів повинна виходити за межі споживацьких чатботів до емергентного шару наукового пошуку (інструменти такі як Consensus, Elicit, Scite та Semantic Scholar, які грунтуються на академічних корпусах та цитують реальні папіри), оскільки препринт невидимий для споживацьких двигунів може все ще бути виявлений фахово-специфічними двигунами, та розбіжність між двома шарами сама по собі є результатом, який становить інтерес. Видимість машини регресується на ознаки паперу, операціоналізовані в Таблиці 18, включаючи коваріату попередньої видимості, яку вимагає P3b: веб- та наукова стопа кожного паперу перед аудитом, заморожені в момент конструювання запиту. Вибірка запитів стратифікована за попередньою видимістю так, щоб папіри «холодного старту» були представлені за задумом. Оскільки генеративні двигуни є нестаціонарними, проект поєднує позначену часом первинну знімок з скриптованим протоколом повторного запуску, який можуть повторити інші. Три подальші вимоги щодо гігієни аудиту заздалегідь визначені: негативні контролі (престижні, але нерелевантні папіри, варіанти назв та підказки, які не мають отримувати центральну роботу) дозволяють виявити неразбірне цитування; кожний запит виконується у еквівалентних варіантах підказки під записаним станом сеансу (чистих та залогованих сеансів; двигуна, версії моделі, дати та географії), так щоб артефакти, специфічні для підказки та сеансу, були відокремлювані від стабільної поведінки пошуку; та випадкова підвибірка результатів подвійно кодується, з повідомленням про згоду між оцінювачами. Повний покроковий контрольний список аудиту розташований у матеріалах попередньої реєстрації. Основним вхідним даним дослідження є час дослідника (сліпа перевірка релевантності 100–200 запитань та подвійне кодування), а не дані з обмеженим доступом або спеціалізована інфраструктура. Дослідження, яке повинно платити за час експертних оцінювачів за ринковими цінами, повинно явно закладати цю працю в бюджет. Заздалегідь визначене передбачення полягає в тому, що сам препринт цитується в меншості випробувань (діапазон 10–35%), з функціями структурованої анотації та опублікованої версії, що підвищують видимість (P3). Дослідження 2 є одним протоколом серед п'яти пунктів порядку денного. Повний аудит видимості наукової машини, включаючи порівняння між двигунами та між репозиторіями, є предметом запланованої супровідної статті.
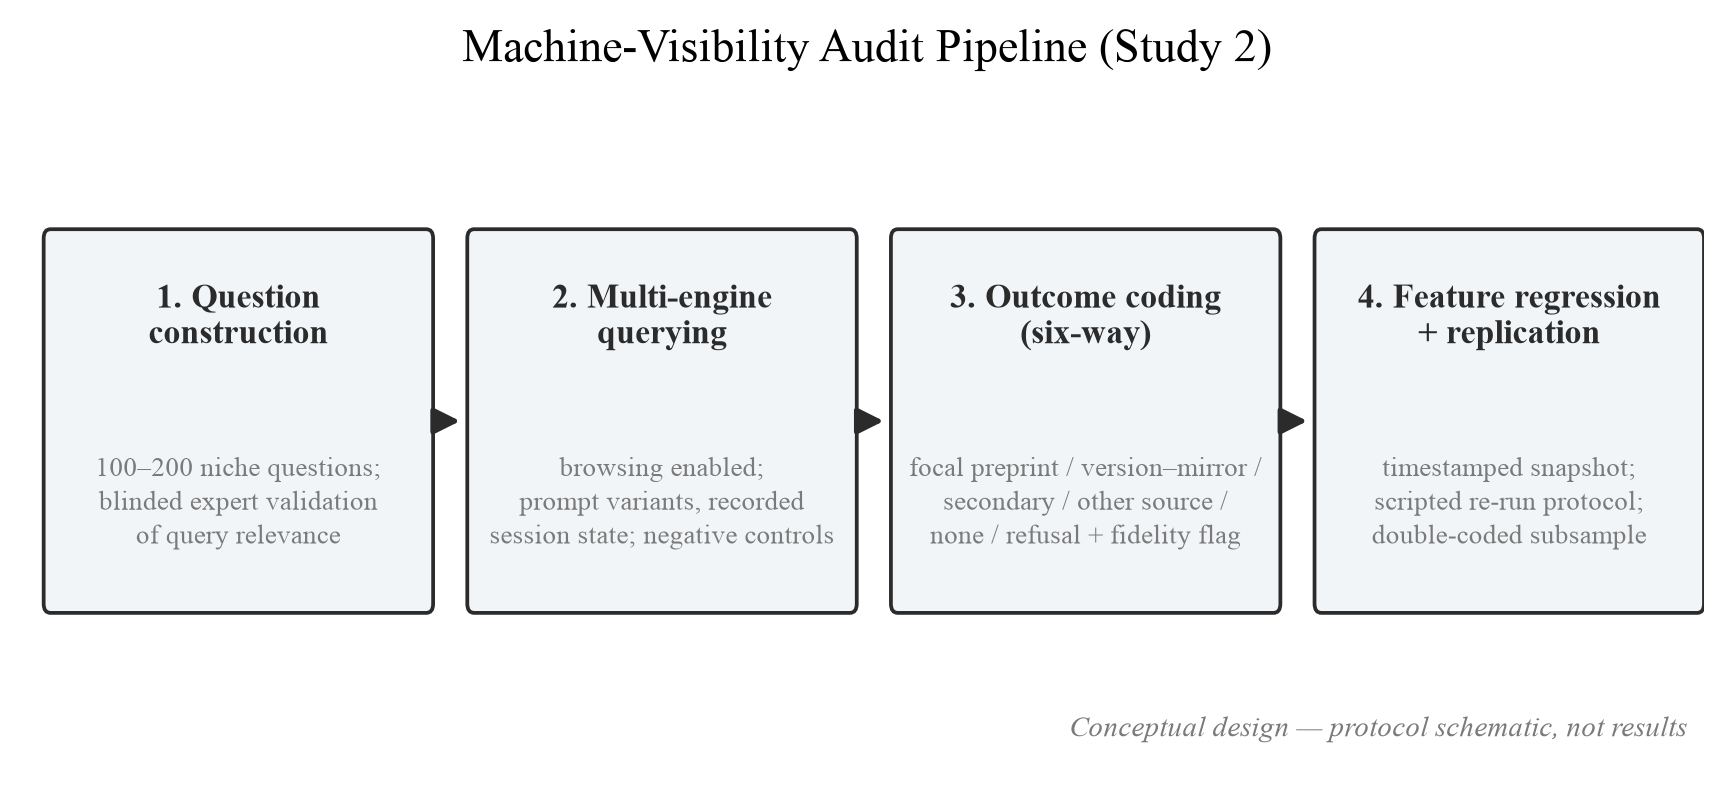
Рисунок 13. Конвеєр аудиту машинної видимості (Дослідження 2). Чотирикроковий конвеєр Дослідження 2. Кодування в шість способів розділяє цитування основного препринту від цитування його опублікованої версії або дзеркала — запобігаючи помилковій класифікації відсутності — та прапор вірності атрибуції зберігає "чи було це цитовано" окремо від "чи було це цитовано вірно." Структура снімка та реплікації розв'язує проблему нестаціонарності моделі: первинний снімок датований, а протокол повторного запуску дозволяє будь-якому дослідникові повторити аудит пізніше.
Таблиця 18. Операціоналізація функцій машинної видимості (Дослідження 2).
| Змінна | Визначення | Кодування |
|---|---|---|
| Наявність DOI | Сторінка документа містить зареєстрований DOI | 1/0 |
| Тип заголовка | Описовий проти алюзивного заголовка | descriptive = 1 |
| Структура анотації | Структурована/статистично насичена порівняно з нарративною | structured = 1 |
| Вік | Місяців з часу першої публікації | integer |
| Кількість класифікацій | Кількість призначених електронних журналів | integer |
| Вторинне охоплення | ≥1 індексована згадка в блозі/новинах існує | 1/0 |
| Опублікована версія | Існує журнальна версія запису | 1/0 |
| Попередня видимість | Веб-присутність та наукова видимість статті та її авторів до аудиту, зафіксовані в момент конструювання запиту (P3b) | стратифікована порядкова |
| Результат V | Результат пошуку для основної статті | шість категорій: основний препринт / опублікована версія або дзеркало / вторинні джерела / інші обґрунтовані джерела / жодне не простежується / відмова; плюс бінарний прапорець точності атрибуції для цитованих випадків |
Примітка. Вибір ознак адаптує документовані фактори оптимізації генеративних двигунів [5][164] до наукових артефактів. Найбільша така аудит, близько 252 000 випробувань на шести двигунах на основі LLM, виявила тематичну релевантність та позицію в списку у отриманому контексті як основні чинники того, щоб бути цитованою першою [164]. Позиція в списку є тому окремою, передавальною гіпотезою для Дослідження 2, і позицію в списку результатів слід записувати, де вона спостерігається.
Таблиця 19 доповнює Таблицю 18 на іншому рівні опису. Таблиця 18 операціоналізує особливості на рівні статті, чиї ефекти Дослідження 2 оцінює, тоді як Таблиця 19 визначає конструкти вимірювання аудиту: що вимірюється, під якими контролями та проти якої первинної загрози достовірності. Кожен конструкт — це окремо сформульоване твердження про машинний шар, і кожна загроза називає конкретний спосіб, яким наївний аудит міг би піти не так.
Таблиця 19. Конструкти вимірювання аудиту машинної видимості (Дослідження 2).
| Конструкт | Операційна міра | Необхідні контролі | Первинна загроза |
|---|---|---|---|
| Пряма машинна видимість | Основний препринт цитується або пов'язується у відповіді | Релевантність запиту, двигун, дата, стан сеансу | Дрейф моделі та індексу |
| Заміна джерела | Опублікована версія, дзеркало або вторинне охоплення цитується замість препринту | Узгодження версій, DOI, варіанти назви | Неправильна класифікація як відсутність |
| Позиція цитування | Ранг та значущість основного цитування в межах відповіді | Довжина відповіді та кількість цитувань | Специфічна для інтерфейсу презентація |
| Точність атрибуції | Твердження у відповіді точно підтримується цитованою статтею | Сліпа верифікація твердження–джерела | Відмивання цитування або галюцинація |
| Чутливість запиту | Варіація результатів у різних еквівалентних формулюваннях запиту | Рандомізовані варіанти підказки | Артефакти, специфічні для підказки |
| Повторюваність | Той же результат на пізнішу дату або під час чистого перезапуску | Архівований протокол та системні метадані | Нестаціонарність двигуна |
Найбільш обґрунтований трансфер з комерційної літератури GEO — це програма аудиту ознак, а не промоційний рецепт: Таблиця 20 перелічує ознаки-кандидати, чиї асоціації з машинною видимістю Дослідження 2 розраховане підтвердити або спростувати. Кожен рядок — це гіпотеза, а не встановлена тактика, і ознака, пов'язана з пошуком, все ще може бути проксі для зрілості статті, популярності теми або попередньої видимості замість важеля.
Таблиця 20. Програма аудиту ознак для машинної видимості (гіпотези для Дослідження 2, а не рекомендації).
| Ознака-кандидат | Гіпотетичний механізм | Підтримуючі докази |
|---|---|---|
| Зареєструвати DOI | Стійкий ідентифікатор допомагає пошуку та узгодженню цитувань | [164] |
| Структурована, багата на статистику анотація | Додавання статистики підвищило генеративну видимість на до ~40% у комерційних тестах | [5] |
| Описовна, насичена релевантністю назва | Тематична релевантність — головний чинник цитування в відповідях AI | [164] |
| Максимізувати точні класифікації eJournal | Більше класифікацій пов'язано з більшою кількістю завантажень, менше нулів | [168] |
| Отримати ≥1 елемент вторинного охоплення | Двигуни часто цитують вторинне охоплення замість первинних джерел | [82] |
Дослідження 3: "Хто приходить першим?" Інструментований протокол розміщення безпосередньо перевіряє P4. Два справжніх робочих документи розміщуються за допомогою унікальних адрес електронної пошти з плюс-адресуванням для кожного каналу експозиції з 90-денним журналом вхідних повідомлень, якому передує вікно базової лінії перед розміщенням тривалістю від двох до чотирьох тижнів на тих самих адресах. Без вихідної лінії, збільшення обсягу звернень неможливо приписати розміщенню взагалі, оскільки академічний спам постійно надходить на фоні високого фонового рівня. Кожне повідомлення кодується як автентичний науковий контакт або хижацькі звернення за допомогою опублікованих сигнатур звернень [96] та перевірених критеріїв типу чорних списків проти високих фонових рівнів, задокументованих у спеціалізованих аудитах, розглянутих у розділі 7.2 [9][84][63][61]. Результатом є порівняння часу до першого автентичного контакту та часу до першого хижацького звернення, які можна приписати розміщенню. Заздалегідь встановлене передбачення згідно P4 полягає в тому, що звернення передує автентичному контакту. Два правила вимірювання встановлюються перед запуском. Вікна базової лінії та після розміщення мають різну довжину (приблизно від двох до чотирьох тижнів проти дев'яносто днів), тому порівняння проводиться на рівні швидкостей надходження (подій на адресу-день) та функцій виживання, ніколи на рівні необроблених підрахунків подій, що інакше спотворила б асиметрія вікна. А час до першого контакту цензурується справа за побудовою: з двома документами адреса, яка не отримує автентичного контакту протягом 90-денного вікна, дає цензоване, а не нульове спостереження, тому правило цензурування заздалегідь встановлено. Спостереження цензуються справа на 90 днів, адреси без подій сприяють цензурованому часу для оцінки виживання, а не видаляються чи кодуються як негайні, а при N = 2 отримані криві повідомляються з їх точною невизначеністю малої вибірки, а не як точкові оцінки. Причинно-наслідковим оцінюваним параметром проекту розподіленої репліції є зміна ризику звернення після розміщення (не ідентичність будь-якого завантажувача), оцінена за допомогою методів виживання/історії подій на узгоджених вікнах перед та після розміщення. Оскільки видима продуктивність автора правдоподібно передбачає обсяг звернень незалежно від якого-небудь окремого розміщення (звернення збирається з накопиченого публічного виходу автора, тому високі фонові рівні, задокументовані в спеціалізованих аудитах розділу 7.2, масштабуються з цим виходом), розподілені репліції повинні записувати контролі експозиції на рівні автора (попередні розміщення, обсяг публікацій та поверхня публічного контакту) разом з фокусною подією. Це інструментоване дослідження випадку N = 2, доказ механізму та відкритий протокол, що запрошує розподілену репліцію, яка в сукупності дало б потужну оцінку. N = 2 демонструє здійсненність інструментарію, а не поширеність та не величину причинного ефекту. На відміну від досліджень 1, 2 та 4, які розраховані на заздалегідь встановлені розміри ефекту, дослідження 3 є пілотом здійсненності та протоколом відкритої репліції.
Рамка кодування встановлюється перед запуском. Вхідні повідомлення кодуються в сім типів: звернення від журналу, запрошення на конференцію, запит рецензії, запрошення редакційної ради, запрошення розділу книги, пропозиція комерційної послуги та автентична наукова кореспонденція, ширша рамка, ніж двійковий поділ на хищацькі та автентичні. Кожен запис містить мінімальний набір полів: мітка часу, адреса отримання (канал), назва місця проведення, розкриття плати, специфічність до фокусного документа, мова термінової необхідності, результат перевірки проти обслуговуваних служб скринінгу та впевненість кодувальника. Граничні випадки та законні низькопрестижні місця проведення керуються заздалегідь встановленими правилами, а не ad hoc судженнями. Нове чи неясне місце проведення не є автоматично хищацьким. Випадкова підвибірка кодується двічі з повідомленою міжоцінювальною згодою. Випускаються лише сукупні підрахунки (розділ 9; Декларації), а повна кодова книга депонується разом з передреєстрацією. Обсяг звернень не є доказом читання, та звернення не рухає публічні лічильники: система цілісності SSRN виключає аномальну автоматизовану діяльність з офіційних підрахунків [144], та жодне висновок від вхідної пошти до панелі управління не дозволено в жодному напрямку.
Дослідження 4: «Як автори читають свої лічильники.» Попередньо визначене опитування авторів перетворює свідчення попиту на форумі, записане в Таблиці 1, на прямі вимірювання. Інструмент складається з чотирьох пунктів зі фіксованим формулюванням: (1) «Чи коли-небудь ви порівнювали ваші завантаження з SSRN з якимось орієнтиром чи нормою?», з варіантами відповідей, що розрізняють конкретне опубліковане число, таблицю, специфічну для дисципліни, неформальне порівняння з колегами та ніколи; (2) «Коли ви бачите '7 завантажень' на своїй інформаційній панелі, яка ваша перша думка?», з варіантами, що охоплюють припущену невдачу, занадто рано говорити, не маю уявлення, що є нормою, та очікувано або нормально; (3) «Чи змінила закриття Рейтингів у липні 2026 вашу поведінку з препринтами?», з варіантами для припинення перевірки статистики, уникнення нових завантажень, завантаження, але менш частої перевірки, та відсутності ефекту; та (4) «Вважаєте ви, що комітети з найму та присудження звань розуміють метрики SSRN?». Попередньо визначені прогнози полягають у тому, що більшість респондентів повідомляють, що ніколи не порівнювали свої лічильники з жодним орієнтиром, і що перші показання низького лічильника схиляються в бік припущеної невдачи, а не в бік занадто раннього читання, яке розділ 5.6 показує, що зазвичай є правильною настройкою за замовчуванням. Цільовий розмір вибірки, канали набору та код аналізу фіксуються при реєстрації. Саморепрезентація активних і, ймовірно, більш занепокоєних авторів обмежує вибірку, як це робить реєстр розділу 8.8. Формат з фіксованим вибором також допускає якісну супровідну лінію: попередньо визначене тематичне кодування публічних питань авторів (з явними критеріями включення та надійністю кодувальників, відповідно до етики цитування, зазначеної в розділі 9) та напівструктуровані інтерв'ю про те, як автори читають свої лічильники та до них ставляться, досягаючи людських наслідків представлення метрик, яких не можуть закриті пункти. Одне обмеження дизайну стосується центральної конструкції. Чотири фіксовані пункти, застосовані лише до авторів SSRN, вимірюють рівень читання без орієнтира, а не контраст, і рівень самостійно не може виявити заявлений у статті шлях від непрозорості орієнтира до метричної сліпоти. Висока частка ніколи не порівнюючих авторів на SSRN однаково узгоджується з загальною байдужістю до лічильників, що не має ніякого стосунку до непрозорості платформи. Дискримінантна та причинна ефективність тому потребують умови порівняння: той же інструмент, застосований до авторів, які публікують на платформах з різною видимістю орієнтирів, arXiv (на основі схвалення та внесення в список, зі своїми поверхнями видимості) та OSF Preprints, перетворює «як автори SSRN читають свої лічильники» на «чи читають автори на більш і менш непрозорих платформах свої лічильники по-різному», що є тим контрастом, який твердження про перехід від непрозорості до сліпоти насправді передбачає. Кроспалтформна гілка попередньо визначена як частина Дослідження 4; без неї результат на одній платформі залишився б описовим для SSRN, а не тестом механізму. Дослідження 4 тоді тестує інтерпретативні твердження розділів 1 та 5 безпосередньо, вимірюючи те, що автори вважають, що означають їхні лічильники, а не те, що ці лічильники являють собою насправді.
8.7 Стаття як власний експеримент
Траєкторія завантажень цієї статті також попередньо визначена. Її показники будуть записані через 30, 90 та 180 днів після публікації та порівняні з медіаною Дослідження 1, коли та медіана буде відома. Цей запис є описовим і не містить правил інтерпретації, оскільки обидва напрями читання льстили б тезі, а методика, при якій кожен результат підтверджує аргумент, нічого не тестує; числа будуть опубліковані в міру їх надходження. Один результат суперечив би структурі статті: траєкторія, що знаходиться на медіані галузі та віку, ні піднесена, ні придушена, вказала б на те, що самореферентний дизайн не надає вимірюваної переваги у виявляємості в цьому окремому випадку. Рефлексивність неможливо уникнути, оскільки ця робота вивчає метрику, яку вона сама накопичуватиме; каталогізовані важелі оцінюються прямими тестами у розділі 8, а не цим записом.
8.8 Перцентильний еталон як суспільне благо
Один найцінніший артефакт, який може створити ця програма — це таблиця перцентилів для завантажень препринтів, число, котре шукає кожен автор, але не може знайти. Платформа історично публікувала середні значення та TOP-N списки, але ні медіан, ні перцентилів, і з 15 липня 2026 р. вона відображає лише кількості на документ і на автора без жодного порівняльного контексту [149]. Для h-індексу та подібних показників існує жанр градуйованих гайдів «чи це добре?» для масової аудиторії [118][128]; аудит розділу 2.5 не знайшов еквівалента для завантажень SSRN. Сирові матеріали для такої таблиці років існують у друці [18][83][85][139][168], і чого не вистачає — це переведення цих розподілів на шкалу, орієнтовану на авторів.
Після закриття зовнішнє збирання перцентилів на рівні всієї платформи більше неможливо: TOP-списки, які розкривали пороги розподілу, були єдиним публічним доступом до хвостових значень, і вони зникли [149]. Залишаються два взаємодоповнюючих маршути. Один — це стратифікована вибірка Дослідження 1, яка дає перцентилі платформи на рівні документа. Інший маршут — краудсорсна реєстрація самозвітування лічильників: добровільний набір даних спільноти, до якого автори вносять датовані знімки своїх панелей (вік документа, галузь, перегляди анотацій, завантаження), зібрані до того, як інституційна пам'ять про розподіли допри-закриття далі розпадеться. Крок збереження протоколу досьє (Таблиця 13), якщо його прийняти в масштабі, є насінням саме такої реєстрації. Існує також робочий прецедент для розширення замість винаходження. IRUS (Jisc) вже агрегує стандартизовану статистику використання на рівні елемента, сумісну з COUNTER, включаючи Total_Item_Requests, у інституційних репозиторіях, що беруть участь [185], що показує, що агрегація використання в межах установ операційно здійсненна. Реєстр препринтів — це розширена версія цього встановленого моделю, яка несе змінні еталонного класу, що важливі тут (галузь, когорта розміщення та етап кар'єри). Північноамериканський аналог CC-PLUS надає той самий потенціал як інфраструктура з відкритим кодом, з автоматичним збиранням SUSHI статистики COUNTER 5 у консорціумах [188], тому реєстр може розширити діючу платформу замість розробки з нуля. Реєстр такого роду являв би собою першу нову багатодисциплінарну розподіл завантажень з часів вибірок 2010-х років [85][139]. Відомі недоліки — самовідбір на користь залучених та ймовірно вищих за медіану авторів, неперевірювані самозвіти без датованих скрінів, та розриви у покритті невеликих галузей. Перцентилі, отримані з нього, повинні тому публікуватися з явними застереженнями щодо відбору та, де можливо, калібруватися за допомогою ймовірнісної вибірки Дослідження 1, а розріджені комірки за полем та віком слід повідомляти під емпіричним скороченням Байєса у бік ширших еталонних класів, а не як нестійкі сирі перцентилі (розділи 5.2, 8.3). Протокол реєстру та правила верифікації буде опубліковано з матеріалами попередньої реєстрації, а формат внеску встановлено тут: запис реєстру є визначеною підмножиною схеми панелі Додатку C (домени ідентифікації, хронування, використання, експозиції та аудиту), щоб самозвітні записи залишалися сумісними з панеллю Дослідження 1, а не накопичувалися як несумісний другий набір даних.
Формати виходу реєстру визначені попередньо разом з його протоколом, і два артефакти визначено. Один — це таблиця перекладу, яка приймає одне число (скажімо, 10, 40 або 100 завантажень) і повертає для кожної охопленої галузі її перцентильну позицію та простомовну категорію таблиці 8; за її допомогою відповідь на питання «чи 7 завантажень добре?» можна нарешті подивитися, а не вгадувати. Інший — це графік перцентильного «віяла», що відображає криві завантажень 25-го, 50-го, 75-го та 95-го перцентилю як функції віку документа за полем та категорією новичків: формат, у якому еталон відповідає на питання «скільки норми в день X» (Рисунок 14; [дані потрібні]: жоден артефакт не може бути заповнений синтетичними значеннями). Кожний випуск перцентилю з будь-якого маршуту (ймовірнісна вибірка або реєстр) публікується відповідно до специфікації прозорості Додатку D, включаючи мінімальні правила конфіденційності для комірок, щоб еталон, який пропонує ця програма, не повторив непрозорість, яку він був розроблений усувати. Над даними розміщується тонкий рівень самообслуговування — публічний онлайн-калькулятор, в який автор вводить поле, вік документа та лічильники й отримує перцентильну смугу та вербальне рішення. Це перетворило б неперевірені евристики на зразок карток оцінки розділу 6.3 в калібровану інструмента один раз, і лише один раз, коли еталонні розподіли існують. Розділ 8.10 пропонує багатомодельну архітектуру, через яку такою служба могла б операціювати та залишатися актуальною. Той самий рівень самообслуговування запобігає тому, щоб протокол звітування накладав новий обов'язок на комітети з найму та просування, оскільки нормалізація за кожним числом, яку вимагає формат досьє (Таблиця 13), виконується калькулятором (цей розділ) та у масштабі оркестровочним шаром (Розділ 8.10). Його реалістичний шлях розгортання проходить через існуючу науково-інформаційну інфраструктуру, а саме через поточні системи інформації про дослідження (CRIS) та профілі, пов'язані з ORCID, щоб еталонне читання могло бути вичислене з ідентифікаторів документа, замість того щоб зібрати вручну. Одне природне розширення на кількох платформах — це протокол паралельного розташування, який порівнює траєкторію того ж документа на SSRN, arXiv (де це відповідне для поля) та OSF Preprints, прямий тест того, чи смуги таблиці 8 передаються між архітектурами push та pull (Таблиця 6).
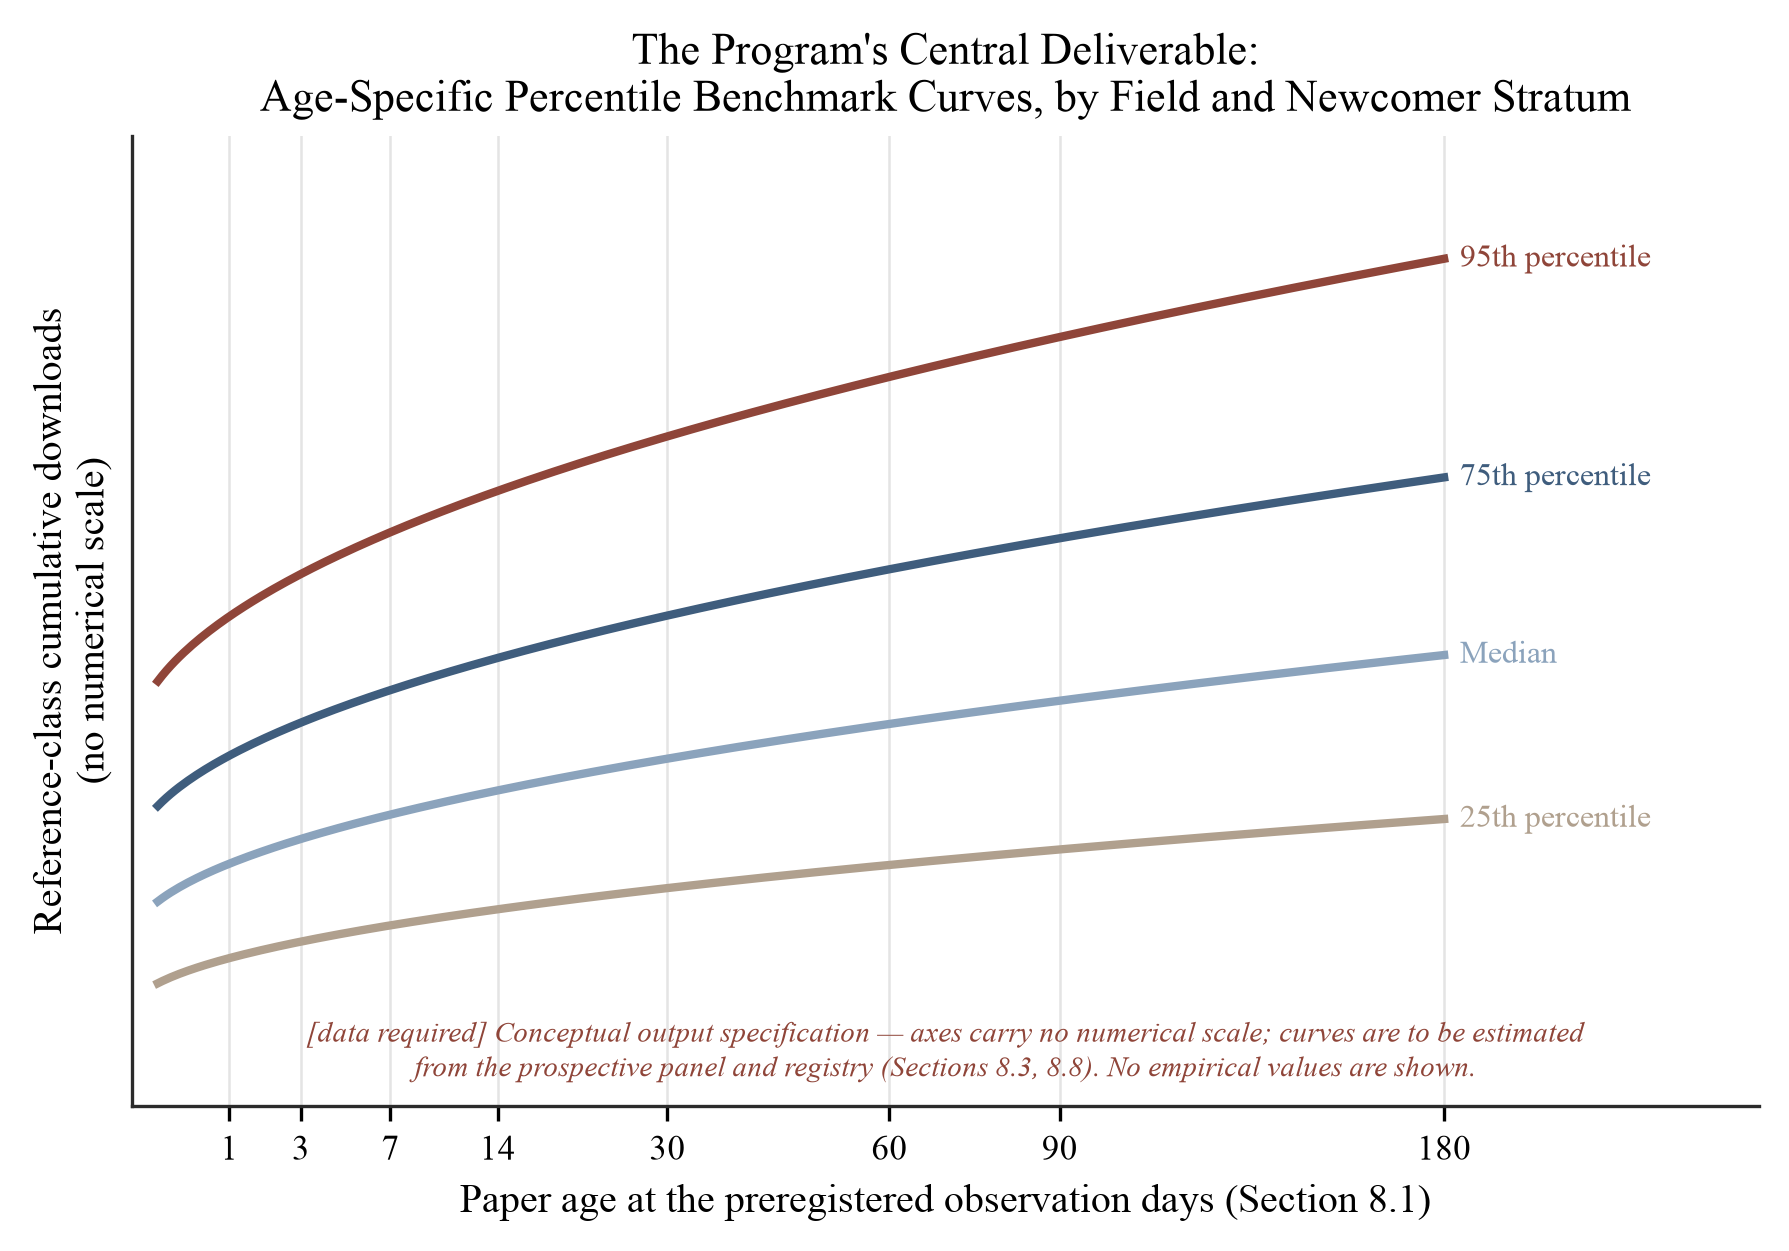
Рисунок 14. Еталон «віяло» специфічний для віку: центральна поставка програми. Криві завантажень перцентилю (25-го, 50-го, 75-го та 95-го) як функції віку документа, оцінені за попередньо визначеними днями спостереження розділу 8.1 та мають оцінюватися за полем та категорією новичків з вибірки Дослідження 1 та реєстру спільноти. Осі не мають числової шкали; фігура є специфікацією концептуального виходу, і це формат відображення, що стоїть за рекомендацією платформи розділу 10.4 та публічним калькулятором, описаним вище.
Кожна емпірична стаття програми зобов'язується дотримуватися мінімального пакета звітування: діаграма потоку когорти; сирі та нормалізовані розподіли поряд; охоплення та конверсія, повідомлені окремо; історії експозицій; результати чутливості до аномалій на чотирирівневій шкалі розділу 8.3; нульові та суперечливі результати, повідомлені з такою ж вагомістю, як підтвердження; та машинозчитувана таблиця еталонів, умова, за якої результат дослідження Study 1 може насправді живити громадський калькулятор, описаний вище. Анотації статей програми розрізняють перевірені оцінки та передбачені очікування.
8.9 Прогностична валідація
Підсумкова перевірка порядку денного (RQ3) запитує, чи виправдовує нормалізація свою складність. Ранне використання та пізніші цитування позитивно, але неповною мірою пов'язані в різних контекстах: кореляції порядку 0,11–0,35 у аналізах Granger на рівні журналів [80], приблизно 0,4 у ранніх когортах arXiv, де r ≈ 0,4 пояснює лише близько 16% дисперсії [25], з порівнювальними асоціаціями, про які повідомляється для препринтів з хімії два десятиліття тому [26], для завантажень на рівні журналів та статей в цілому [71], у даних використання RePEc [31], та у когортах bioRxiv [62], та помірні рангові кореляції при використанні мегажурналів [102]. Набори з високим числом завантажень та набори з високим числом цитувань перекриваються лише частково [108][39]. Свідчення недавніх панельних досліджень пов'язують доступ до цитувань із затримкою: в одній панелі семи журналів асоціація була приблизно одиничною еластичною, де 10% збільшенням доступів було пов'язано приблизно з 10% збільшенням цитувань приблизно дев'ять місяців потім [178]. У позначеннях розділу 5.5 підсумкова порівняльна оцінка
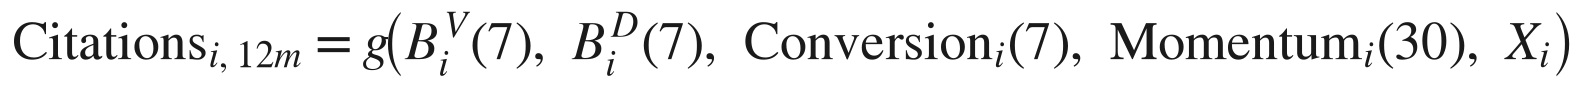
з g підібраною гнучко та оціненою лише за межами вибірки. Рівняння визначає, які нормалізовані входи конкурують з необробленими підрахунками. Моделі, що передбачають цитування через 6, 12 та 18 місяців на основі нормалізованих за віком, полем та когортою метрик дня 7 та дня 30, повинні бути порівняні за межами вибірки (за допомогою перехресно перевіреної правдоподібності, калібрування, рангової кореляції та помилки передбачення) з моделями, що використовують самі по собі необроблені накопичені завантаження, проблема політики передбачення у сенсі Kleinberg та ін. [88]. Особливо інформативним результатом було б, якби необроблені підрахунки надавали перевагу встановленим авторам, тоді як нормалізовані показники холодного старту краще передбачали пізніші цитування. Ця закономірність означала б, що частина того, що вимірюють необроблені ранні лічильники, — це початкова можливість, а не подальший інтелектуальний попит. Якщо нормалізація не додає передбачувальну інформацію, твердження про вимірювання рамки відхилено або звужено відповідно.
Рисунок 15 збирає воєдино порядок денний. Одна перспективна когорта живить чотири дослідження та два квазі-експерименти платформи паралельно, і кожен модуль депонує в один набір версіонованих публічних результатів. Ця спільна структура робить порядок денний дослідницькою програмою.
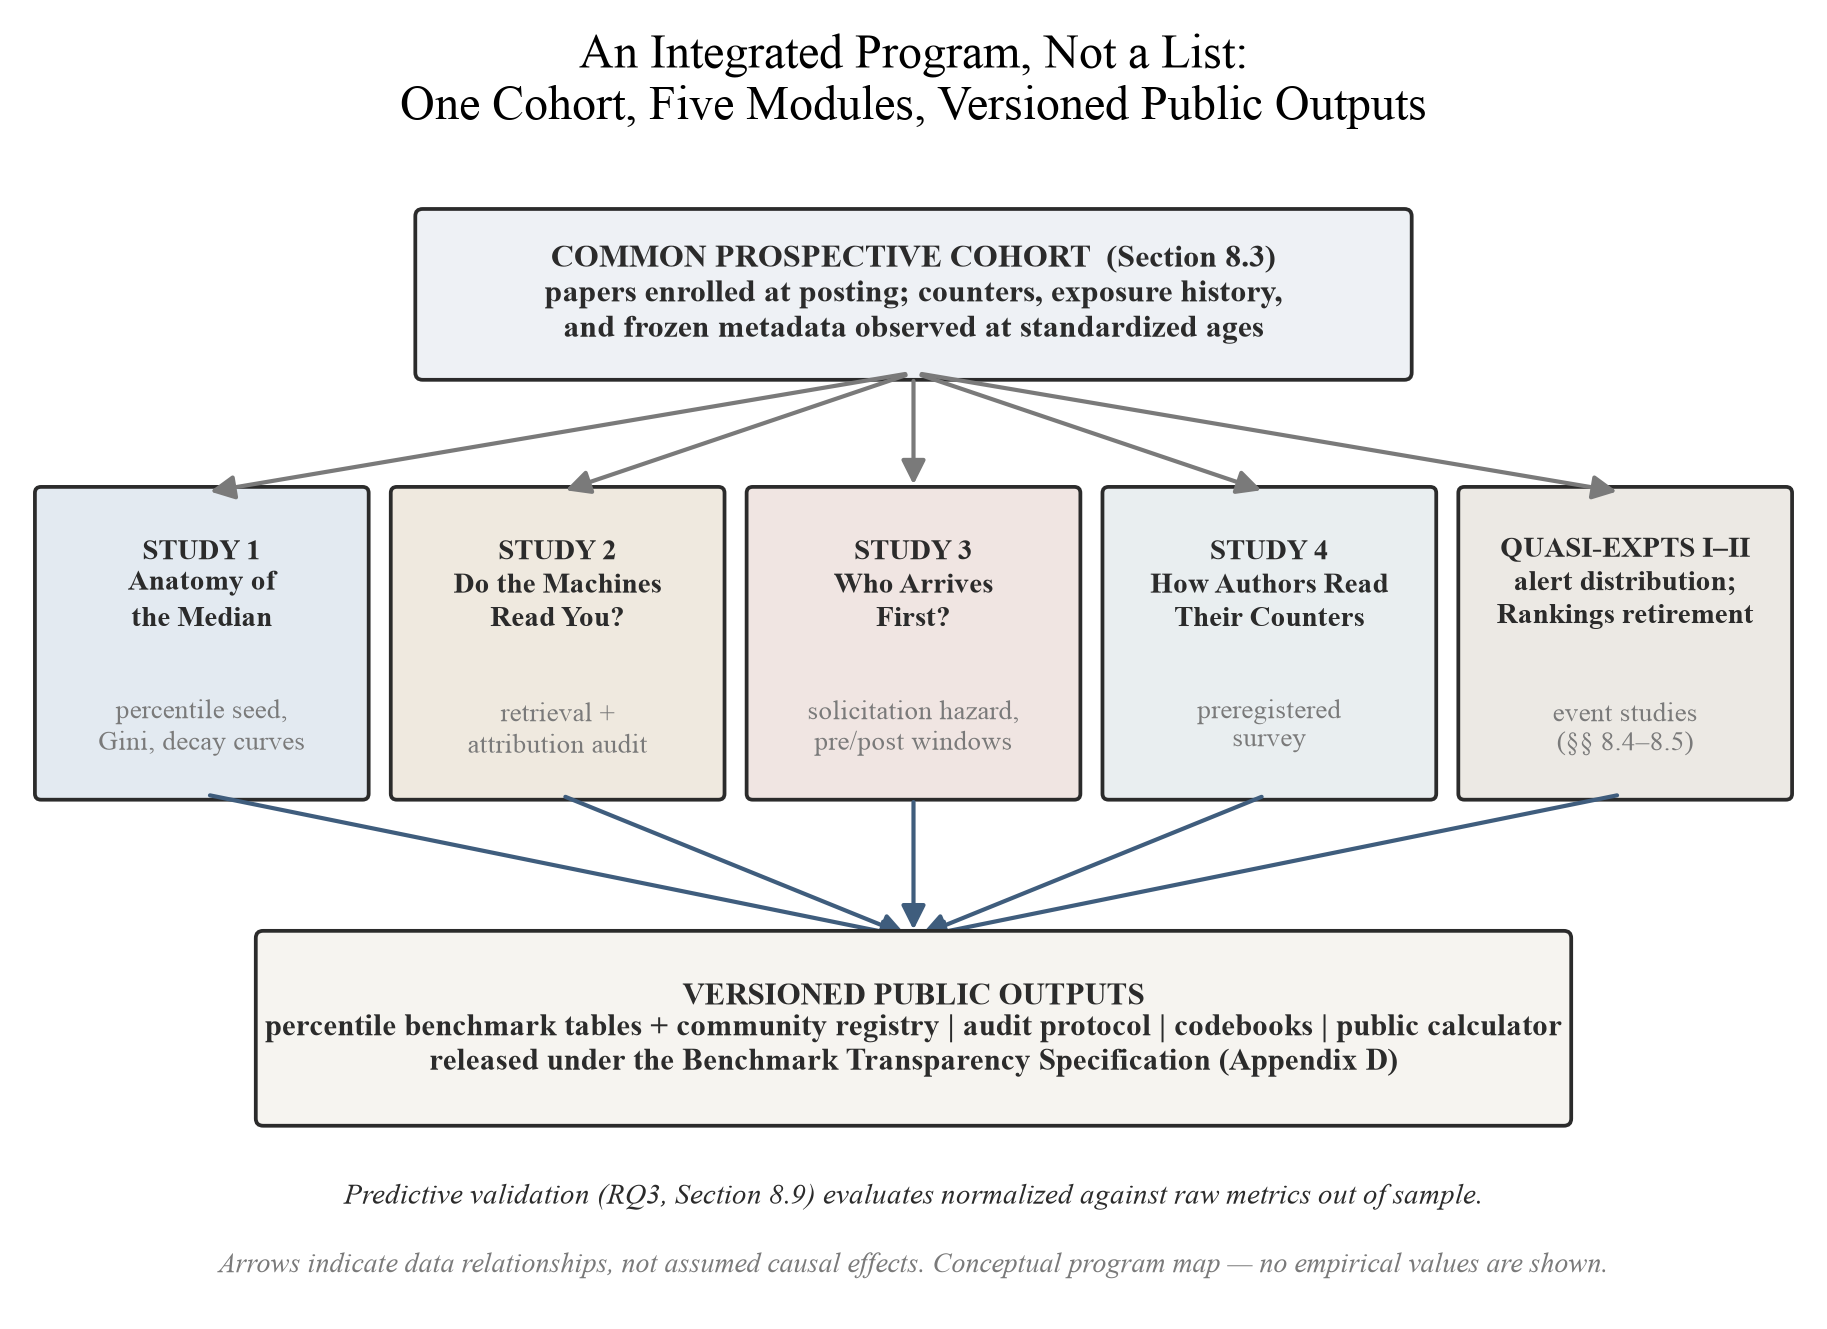
Рисунок 15. Інтегрована дослідницька програма. Одна перспективна когорта (розділ 8.3) живить чотири дослідження (розділ 8.6) та два квазі-експерименти платформи (розділи 8.4–8.5); всі модулі депонують версіоновані публічні результати — таблиці еталонних процентилів та реєстр спільноти (розділ 8.8), протокол аудиту, кодові книги та публічний калькулятор — випущені під Специфікацією прозорості еталонів додатку D, тоді як прогностична валідація (розділ 8.9) оцінює отриманий еталон за межами вибірки. Стрілки вказують на взаємозв'язки даних, а не на припущені причинно-наслідкові зв'язки.
8.10 Пропозиція дизайну: оркестровані передові моделі як рівень доставки бенчмарків
Одноразова публікація не може забезпечити те, що вимагає продукція порядку денного. Таблиці відсоткових рангів, реєстр спільноти, формат звітування CSAB (розділ 5.5; додаток B) та публічний калькулятор (розділ 8.8) мають бути зібрані з розпорошених і деградуючих джерел, перевірені твердження за твердженням, оновлені в міру зміни правил підрахунку та функцій платформи, і доставлені окремим авторам у відкаліброваній мові. Кандидатською архітектурою для цього рівня доставки та обслуговування є оркестрований конвеєр спеціалізованих передових моделей штучного інтелекту (клас системи, який розробляє автор; див. Конфлікти інтересів). Усе в цьому підрозділі є пропозицією дизайну. Жодної реалізації не існує, жодна емпірична ефективність не заявляється, і жодна цифра щодо точності, витрат або заощадження часу не стверджується нижче.
Однією альтернативою оркестрованій системі є одна універсальна модель. Автор, який запитує у споживацького чатбота «чи є 7 завантажень хорошим результатом?», отримує бігучу, неперевірену заяву — режим відмови, який документують аудити систем відповідей, в яких системи помиляються з невиправданою впевненістю замість того, щоб відмовитися від відповіді [82]. Під цим лежить структурна проблема. Інтерпретація метрики розпадається на підзадачі з різними, частково суперечливими цілями. Отримання та датування доказів, перевірка лічильника на неживий або аномальний трафік, нормалізація перевіреного підрахунку проти еталонного класу за віком, галуззю, когортою та попередньою видимістю, переведення нормалізованої позиції в мову діапазону та оскарження цього переведення перед випуском — це не одне й те саме завдання, і компонент, оптимізований для одного, є поганим судьєю іншого. Модель, яка складає заспокійливе прочитання, не повинна бути єдиною владою щодо того, чи забруднено базове число, і модель, яка складає мову досьє, не повинна засвідчувати, що мова уникає перебільшення. Організуючим принципом є розподіл епістемічної праці: генерування та верифікація призначаються окремим компонентам з незалежними цілями, а розбіжність зберігається та повідомляється замість усереднення. Збіжність незалежно спровокованих або архітектурно відмінних оцінювачів не є істиною, хоча вона є міцнішою основою для прочитання, ніж виразність однієї моделі, — інтуїція дизайну, узгоджена з експериментальними свідченнями того, що багатоагентні дебати серед примірників мовної моделі вимірно покращують фактичну валідність та зменшують галюцинації порівняно з однією моделлю, яка відповідає самостійно [43]. Там, де оцінювачі розходяться, сама розбіжність є діагностичною інформацією, подібно до того, як конфліктуючі джерела трактувалися як сигнал, а не шум у власних правилах синтезу цієї статті (Обсяг та дисципліна доказів). Два застереження дизайну пом'якшують цю інтуїцію. Згода компонентів не є сама по собі доказом: вона може виникати зі спільних даних навчання, спільних результатів пошуку, спільних припущень підказки або забруднення через самого оркестратора. Родини моделей від різних постачальників не є науково незалежними, і незалежність має бути розроблена через окремі інструкції, обмежений потік інформації між компонентами, збережені проміжні результати та оцінювання проти доказів того, що жоден генеруючий компонент не дозволено редагувати. Верифікація також не стає надійною просто тому, що другу модель залучено для її проведення: твердження, які є спірними або наслідковими, вимагають перевірки основного джерела самим користувачем-людиною.
Рисунок 16 показує пропонований конвеєр, а таблиця 21 розкладає його за функціями. Обробка починається від замороженого файлу справи, а не від вільної форми підказки: лічильники з датами спостереження, віком документа, заявленою галуззю та кандидатськими еталонними когортами, історією експозиції та фактичним запитанням автора. Відсутні входи залишаються відсутніми, і система не може виробити відсутній розподіл відсоткових рангів, емпірично оцінити знаменник або прийняти число, згенероване моделлю, замість спостережуваного. Потім потік інформації відтворює інтерпретаційну послідовність, яку стаття захищає протягом усього часу: сирові лічильники → перевірка цілісності → нормалізація еталонного класу → інтерпретація під обмеженням. Компонент моніторингу отримує лічильники, документи платформи та записи реєстру з датованою провенансою, так що кожне подальше значення піддається стеженню до архівованого джерела. Кожен фактичний результат передається між компонентами як запис у реєстрі претензій. Кожен запис фіксує претензію, її підтримуюче джерело або поле даних, стабільний локатор, час отримання, будь-яку застосовану трансформацію, її еталонний клас та її стан верифікації, так щоб жоден непідтриманий результат не міг мовчки стати передумовою пізнішого етапу. Перевірка цілісності застосовує звичайне виявлення аномалій часових рядів (завдання для статистичних методів, а не для вільної генерації тексту) на документованому фоні фільтрування ботів та забруднення AI-краулерами [129][144]. Вона приписує розриви траєкторії датованим подіям експозиції, де це дозволяє запис експозиції (розділ 5.6). Нормалізація виконується детермінованим статистичним кодом, викликаним як інструмент: позиції відсоткових рангів обчислюються проти версіонованих таблиць Дослідження 1 та реєстру за правилами усадки розділу 8.3. Арифметика відсоткових рангів ніколи не делегується вільній генерації тексту. Тільки потім модель інтерпретатора складає читання, орієнтоване на автора, обмежене мовою діапазону таблиці 8, діагностичною логікою охоплення проти конверсії таблиці 9 та шаблоном CSAB додатку B, з джерелом, датою та рівнем впевненості, прикріпленими до кожного числа. Окремий верифікатор і критик перевіряють кожну претензію проти її записаного доказу перед випуском, повідомляючи кожну як верифіковану, оспорювану, непідтриману або не оцінювану — чотири окремі стани, які ніколи не стискаються в один синтетичний бал впевненості. Два обмеження переносяться з фреймворку без змін. Будь-яка рекомендація залежить від діагностованого вузького місця, оскільки документи, обмежені охопленням, і документи, обмежені конверсією, вимагають різних дій (таблиця 9), і система, яка не може їх розрізнити, повинна мовчати замість того, щоб видавати загальні поради. Інше обмеження полягає в тому, що випущена рекомендація — це гіпотеза: вона передбачає, який механізм повинен змінитися, якщо діагноз є правильним, і подальші спостереження тестують цю передбачення. Функція мети системи відповідно вузька: усунути виявлені інтерпретаційні тертя між документом та його відповідним еталонним класом, а ніколи максимізацію будь-якого лічильника, межу, встановлену політикою цілісності платформи та політикою генеративного AI [54][144] та історією маніпуляцій розділу 3 [44].
Таблиця 21. Функціональна декомпозиція запропонованого шару оркестрування: функція, тип компоненти, головний режим відмови та механізм незалежної перевірки. Кожен рядок — це гіпотеза про придатний розподіл праці.
| Функція | Модель або тип компоненти | Головний режим відмови | Механізм незалежної перевірки |
|---|---|---|---|
| Оркестрування та походження | Маршрутизатор завдань, що зберігає замерзлий файл справи та реєстр претензій | Рання недокументована припущення розповсюджується як передумова кожного наступного етапу | Неперевірений вихід не повинен стати довіреною передумовою; джерело, трансформація, час вилучення та невизначеність збережені при кожній передачі |
| Набуття та моніторинг доказів | Модель вилучення з використанням інструментів за розкладом повторного запуску; бібліографічне зіставлення з відкритою інфраструктурою цитування [35][124] | Вигадані, невідповідні або вибірково вилучені джерела | Датований журнал походження; кожне значення простежуване до архівованого снімка; випадкова підвибірка незалежно повторно отримана другим компонентом; невдалі пошуки та суперечливі результати записані, не видалені |
| Перевірка цілісності | Неґенеративна детекція аномалій часових рядів [129][144] | Сплеск, позначений як "бот" — або "читач" — без доказів будь-якої з цих ідентичностей | Прапори аномалій публіковані разом із агрегатами (розділ 8.8); чутливість повідомлена на чотирирівневій драбині надійності розділу 8.3; аномалія розглядається як прапор, ніколи як претензія на ідентичність |
| Нормалізація класу посилання | Детермінований статистичний код, що викликається як інструмент | Зручні однолітки помилково прийняті за дійсну популяцію для порівняння | Перерахунок порівняно з версіонованими публічними таблицями еталонів (додаток D); поле, вік, когорта, попередня видимість та давність джерела зазначені або модуль утримується; жодна вільнотекстова арифметика не приймається до запису |
| Розробка інтерпретації | Модель мови широкого профілю, обмежена мовою смуги таблиці 8 та шаблоном CSAB (додаток B) | Вільне перебільшення — впевненість, область чи причинний статус за межами того, що дозволяють докази | Перевірка кожної претензії окремим верифікатором щодо записаних доказів; кожна претензія звітується як перевірена, оспорювана, непідтримана чи недоступна для оцінювання; непідтримані речення відхиляються, не пом'якшуються |
| Змагальна рецензія | Модель критика з цілями, що противагу цілям автора | Ритуальна критика або синтетичний консенсус, що приховує істотну незгоду | Структурований звіт про незгоду — статус доказів, закономірність оцінювання, чутливість рішення (чи змінює спір діагноз чи лише його формулювання), залишкова невизначеність — доставлені без об'єднання, ніколи не згорнуті в одне число довіри |
| Сортування звернень | Спеціалізований класифікатор за рамкою кодування таблиць 14–15 | Категоричне рішення про "хижацтво", що виходить за межи доказів та ризикує репутаційною шкодою | Лише позначка та перевірка, не автоматичне видалення і не опублікована звинувачення; показники помилок повідомлені на позначених наборах; задокументовані обмеження та упередження класифікації тексту ШІ визнано [157][97] |
| Обслуговування еталона | Запланована оркестрування всіх компонентів | Тиха дрейф: застарілі джерела або випуски перезаписані без сліду | Версіоновані, датовані випуски під додатком D; ревізії записані, ніколи не перезаписані мовчки — жива карта еталона, а не статичний снімок |
| Остаточна інтерпретація та будь-яке кар'єрне використання | Людський автор | Упередження автоматизації та розповсюдження відповідальності | Обов'язкове людське схвалення перед будь-яким зовнішнім використанням; мова досьє дотримується протоколу таблиці 13, з прикріпленим джерелом, часовим вікном та обмеженнями |
Дві межі завершують специфікацію. Одна — це межа дозволу: доступ лише для читання за замовчуванням, а шар розробляє проекти, але ніколи не виконує. Він не може автономно редагувати рукопис, змінювати метадані платформи, контактувати вчених чи видавництва, публікувати публічно чи видаляти повідомлення звернення, і будь-який реалізований робочий процес повинен зберегти людську відповідальність та зобов'язання розкриття інформації застосовної платформи та політик подання [54][56][144]. Інша — це межа утримання: нульовий вихід — це законний (часто правильний) результат, і кожен етап може зупинитися, а не передавати дефектний вхід далі. Обов'язкові тригери утримання включають відсутність або необґрунтованість класу посилання; неперевіреного джерела, центрального для читання; невирішену незгоду про те, чи запропоноване формулювання зберігає претензії статті; будь-яку вимогу причинного висновку з чисто описової закономірності або передбачення цитувань чи результатів кар'єри без затвердженого набору даних передбачень (розділ 8.9); та будь-яку вимогу маніпулювати, купувати, моделювати чи інакше збільшувати увагу. Цей останній тригер запобігає шару стати інструментом ігор метрик, історію яких документує розділ 3 [44][69][144]. Остаточне розділення керує двома потоками доказів програми. Версіоновані таблиці процентилів розділів 8.6 та 8.8 є єдиним припустимим джерелом нормалізації шару, тоді як аудит видимості машини дослідження 2 забезпечує окрему перевірку вилучення та атрибуції. Вилучення машиною не є процентиллю людської уваги, і шар не може змішувати обидва.
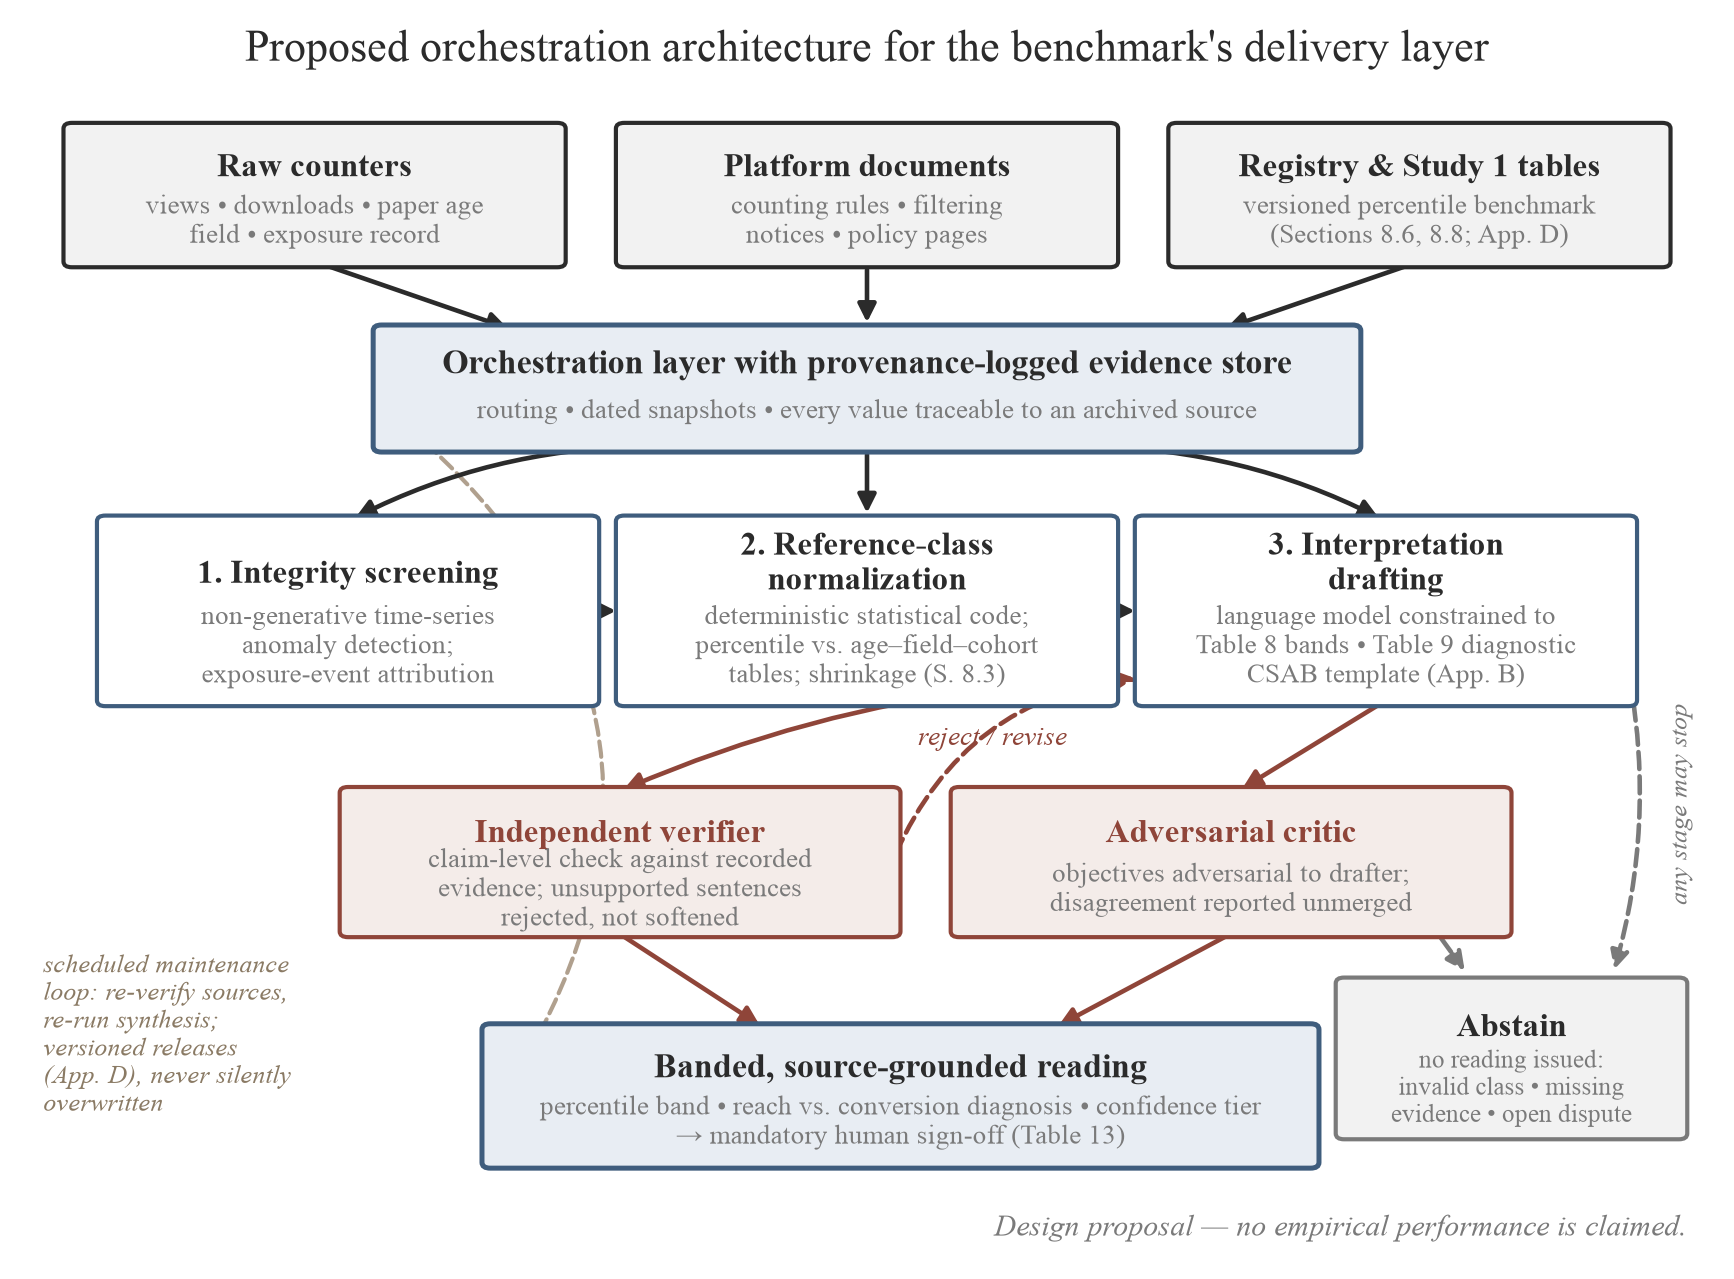
Малюнок 16. Запропонована архітектура оркестрування для шару доставки еталона (розділ 8.10; таблиця 21). Спеціалізовані компоненти розділяють набуття доказів, перевірку цілісності, нормалізацію та інтерпретацію, з незалежною перевіркою, вставленою між генеруванням та випуском, шляхом утримання, доступним на кожному етапі, та запланованою петлею, що зберігає версіонований еталон розділу 8.8.
Та сама дисципліна обмежує те, що шар може робити після встановлення діагнозу. Таблиця 22 визначає політику дій: кожна спостережена закономірність (охоплення та конверсія, читаються разом із імпульсом, у словнику таблиць 9–10) відображає попередній діагноз, обмежену форму допустимої допомоги, тест механізму, який міг би підтвердити або послабити діагноз, та висновок або дію, які залишаються забороненими. Колона тесту механізму операціоналізує правило, висловлене вище, що випущена рекомендація — це гіпотеза. Якщо корекція класифікації має видалити вузьке місце охоплення, результатом, який має значення, є охоплення, скориговане за віком, а ретроспективна розповідь про загальні завантаження не зможе його замінити. Невдала передбачення записується як невдала інтервенція і повертається до діагностування, ніколи не переоцінюється на основі більш сприятливої міри успіху. Повна послідовність таким чином замикається в цикл: вимірити → перевірити → нормалізувати → діагностувати → запропонувати → критикувати та перевірити → вирішити → спостерігати → оновити або припинити (Рисунок 17). У межах цього циклу людське рішення розташоване між перевіркою та будь-якою дією, спостереження після рішення повертаються до справи, а шлях утримання припиняє цикл, коли доказ недостатній. Цикл також контролює складність: коли доказ підтримує лише збереження та моніторинг, або коли детерміноване правило посібника автора (розділ 6) вже дає відповідь на питання, оркестрування не додає нічого і не повинно запускатися.
Таблиця 22. Політика переходу від діагнозу до дії для запропонованого шару оркестрування. Закономірності читаються в межах обґрунтованого референтного класу відповідно до процентильних конвенцій таблиці 9; кожен рядок є гіпотезою політики, і жодна комірка не стверджує емпіричну частоту.
| Спостережена закономірність (охоплення, конверсія, імпульс) | Попередній діагноз | Допустима допомога | Тест механізму | Забороняний висновок або дія |
|---|---|---|---|---|
| Низьке охоплення, висока конверсія, стабільна або зростаюча | Вузьке місце виявлення узгоджується з закономірністю більше, ніж вузьке місце прийняття рукопису («прихована зацікавленість», таблиця 9) | Перевірити ідентифікатори, класифікації, метадані, індексування та видимість за назвою; обмежене, справді релевантне поширення | Чи зростає охоплення при збереженні конверсії після зміни метаданих або класифікації? | Переписування добре конвертованої анотації лише для того, щоб зробити її більш просуваючою |
| Високе охоплення, низька конверсія, стабільна або падаюча | Невідповідність комунікації, невідповідність аудиторії та експозиція з низьким намірам є конкуруючими поясненнями («увага без прийняття») | Перевірити вирівнювання назви та анотації, ясність обсягу та відповідність аудиторії; лише альтернативи, що зберігають претензію | Чи змінюється конверсія при порівнянній експозиції з перевіркою точності на кожен перегляд? | Збільшення невибірної промоції; висновок, що читачі відкинули науку |
| Низьке охоплення, низька конверсія | Недостатньо ідентифіковано: слабка експозиція, невірний референтний клас, відмова метаданих, комунікаційне тертя або нішевий попит — все підходить («холодний старт») | Спочатку перевірити референтний клас і запис про експозицію; потім окремо перевірити метадані та комунікацію | Змінити один вимірюваний механізм одночасно; зберегти нульовий результат | Висновок низької якості з низького використання; винесення однопричинного вироку |
| Високе охоплення, висока конверсія, зростаюча | Сильна рання дифузія щодо зазначеного класу | Зберегти походження; моніторити у фіксовані віки; не змінювати без причини | Чи зберігається закономірність після події експозиції і при чутливості до аномалій? | Виробництво подальшого посилення; розглядання уваги як доказу якості |
| Високе охоплення, висока конверсія, різко падаючі прирости | Увага, керована подіями, звичайне розпадання або насичення (розділ 5.6) | Визначити подію експозиції; порівняти прирости інтервалів, а не кумулятивні суми | Чи відрізняється розпадання від розподілених за віком траєкторій залежно від події? | Називання спадних приростів науковою невдачею — кумулятивні підрахунки майже завжди сплющуються в темпах |
| Низьке охоплення, висока конверсія, падаючі прирости | Умовна зацікавленість може бути реальною, тоді як продовжувана експозиція слабка | Перевірити, чи закінчилось поширення або індексування; визначити обмежені, релевантні канали | Чи підвищує відновлена експозиція охоплення без погіршення конверсії? | Розширення претензій або видалення технічної специфіки для переслідування ширшої аудиторії |
| Високе охоплення, низька конверсія, зростаюча експозиція | Прибуття зростають без пропорційного прийняття повного тексту | Перевірити трафік низького наміру (розділ 4.2), невідповідність аудиторії та ясність представлення | Чи реагує конверсія на зміну представлення, вірну претензіям, при порівнянній експозиції? | Оптимізація лише верхівки воронки; підрахунок кожного перегляду як читача людини |
| Будь-яка закономірність із переповідним лічильником, необ'ясненим стрибком, невалідною когортою або відсутнім знаменником | Метрика наразі не піддається інтерпретації на бажаному рівні | Зберегти знімки; запустити аналізи чутливості; звузити претензію; утримуватися | Чи виживає читання виключення спірного інтервалу, або за кращого референтного класу? | Маркування трафіку як людського або автоматизованого без доказу; генерація процентилю з вигаданого знаменника |
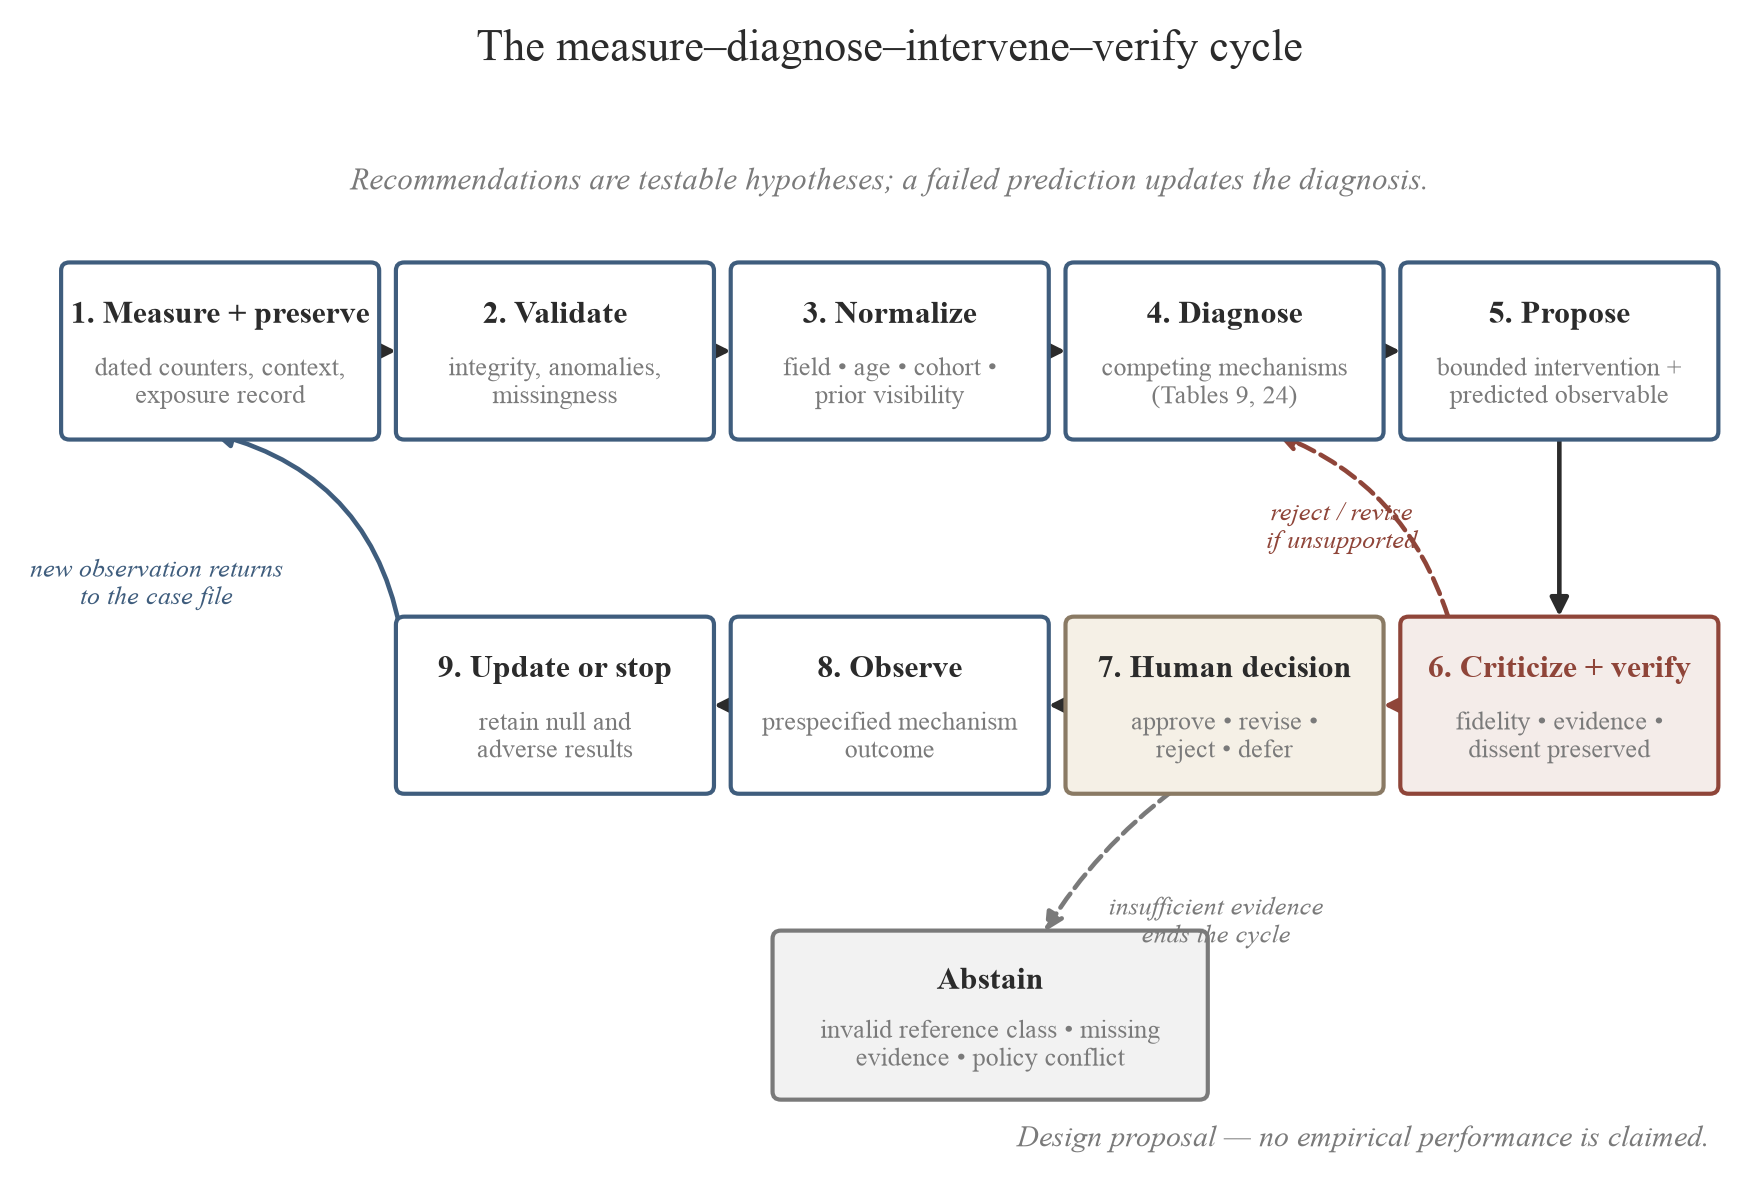
Рисунок 17. Цикл вимірювання–діагностування–втручання–перевірки (розділ 8.10; таблиця 22). Рекомендації залишають цикл лише як перевіряємі гіпотези: кожна називає механізм, який вона має намір спрацювати, та подальше спостереження, яке могло б підтвердити або послабити діагноз. Невдалі передбачення повертаються до діагностування та залишаються в записі аудиту; людське рішення розташоване між перевіркою та будь-якою дією; і шлях утримання від дій закінчує цикл, коли не існує обґрунтованого референтного класу або достатніх доказів. Цикл оптимізує тлумачення, яке зберігає докази, а не сиру увагу.
Чотири обмеження обмежують пропозицію. Генерація — це не відновлення. Жодна модель, якою б вона ні була організована, не може регенерувати процентильні розподіли, які перестали спостерігатися, коли були видалені топ-списки [149], а шар може тримати лише наближення, зі збереженням застережень консервативної межі з розділу 5. Також оркестрація не може ідентифікувати завантажувача, розрізнити людський трафік від автоматизованого трафіку самих лічильників (розділ 4.2), перетворити обсяг запитів на докази читацької аудиторії (розділ 7.6), зробити корельовані виходи моделі незалежними, переіменувавши їх на «агентів», замінити судження рецензентів або передати відповідальність від дослідника до робочого процесу. Сам оркестратор потребує аудитора. Розгорнутий шар інтерпретації стає новим привратником у стеку, який цей документ відображує (Рисунок 12), і він не повинен успадкувати непрозорість, яку він був покликаний виправити: сліди міркування та логи походження повинні бути відкриті для перевірки, а власна поведінка шару щодо пошуку та інтерпретації має бути перевірена з суворістю дослідження 2 (часові знімки плюс письмовий протокол повторення), оскільки нестаціонарність моделі робить кожен вихід датованою оцінкою, ніколи не стійкою вартістю. Вартість та справедливість. Експлуатація такого конвеєра не є безплатною, і платний шар інтерпретації виключив би авторів з низькими ресурсами та без інституційної афіліації, на яких ця основа фокусується. Відомі упередження класифікаторів тексту AI проти письменників, для яких англійська не рідна мова [97], зробили б те ж саме, якщо їх не пом'якшити. Помилкова точність — залишковий ризик. Шар, який видає смугасті вироки без рівнів впевненості, автоматизував би саму невідкалібровану ситуацію, діагностовану в розділі 3: підрахунок без порівняльної шкали, замінений вироком без невизначеності. Архітектура сама по собі є фальсифікованим об'єктом і належить до порядку денного на цих умовах, оцінена проти простішої допомоги, а не виведена зі складності її діаграми. Відповідна конструкція повинна тестуватися поступово. Реалістичні пакети випадків з посадженими неоднозначностями (невалідні цитування, протилежні переформулювання, невизначені когорти, справді граничні запити) випадково розподіляються по умовам, які додають один інгредієнт за раз: ручний протокол таблиць цієї статті (правильна базова лінія, оскільки метод без штучного інтелекту вже існує), одна універсальна модель, та сама модель з пошуком та детермінованим розрахунком, генерація плюс незалежна критика та повний керований конвеєр. Абляції, які видаляють верифікатор, детермінований калькулятор, видимість розбіжності або людський шлюз, ізолюють, який інгредієнт керування заслужує свою вартість. Результати оцінюються окремо, ніколи як один композит: правдивість претензії та цитування; дійсність класу посилання; калібрування переконань автора (інструмент дослідження 4) та відповідне утримання від голосу у неоднозначних випадках; час дослідника та навантаження нагляду; збої в керуванні (автономні зовнішні дії, рекомендації метричних ігор, категоричні звинувачення місця); та, центральне для аргументу холодного пуску статті, гетерогенність переваги за попередньою видимістю автора та статусом новачка, оскільки шар, який допомагає в основному вже видимим авторам, відтворив би нерівність, яку він був розроблений для зменшення. Нульові та невигідні результати справедливості — це звітні висновки. Версії моделей, запити, дозволи інструментів та знімки джерел архівуються, оскільки в нестаціонарній системі кожен результат є датованою оцінкою. Два оцінювані залишаються окремими протягом всього часу: вплив на якість інтерпретації та вплив на наступне поширення. Шар, який поліпшує діагностику без переміщення завантажень, є успіхом, тоді як той, який підвищує завантаження при спотворенні претензій, є збоєм керування. Конструкція зазнає невдачі, якщо керований конвеєр не перевершує сильну окрему модель щодо точності доказів та калібрування: «кілька моделей» не є внеском, а гіпотеза під тестом — це розподіл епістемічної праці. Пропозиція визначає тестовану роль для інтерпретації, допоміжної штучним інтелектом. AI може допомогти авторові поставити краще питання до числа; тільки верифіковане свідчення може відповісти на нього.
9. Обмеження
Висновки цієї статті обмежені наступними обмеженнями, кожне прикріплене до артефакту, який він обмежує.
Старіння та склад основи доказів. Старіші опорні точки розподілу в карті еталонів (Таблиця 7) спираються на зразки, зібрані між 2012 та 2015 роками та домінуючі юридичною стипендією [85][139]; один недавній запис — це знімок однієї дисциплінарної мережі, обговорений нижче [83]. Смуги шкали інтерпретації (Таблиця 8) найкраще розглядаються як м'які, а не консервативні абсолютні смуги для 2026 року (розділ 5.1). Обсяг завантажень щорічно платформою виріс у кілька разів між серединою 2010-х та 2020-х роками [1][143], піднімаючи потік завантажень на папір і роблячи фіксований старий поріг м'якішою смугою сьогодні, ніж коли він був оцінений. Жадна мультиплікативна корекція не може цього виправити, оскільки ріст змінює чисельник, знаменник та склад одночасно (розділ 3.2). Смуги таблиці 8 — це наближення, отримані з агрегованої арифметики, а не перемасштабованих норм. Жодного дослідження розподілу завантажень SSRN для всієї платформи після 2020 року не було знайдено.
Сучасні докази одного джерела. Єдиним останнім розповсюджувальним доказом, використаним тут, є один опублікований знімок однієї дисциплінарної мережі: 2361 робота з маркетингу, спостережувані 15 серпня 2025 року [83]. Це демонструє асиметрію та умовну премію престижу, але це не встановлює еталони для всієї платформи, і два внутрішні значення його опублікованої таблиці відтворюються «як опубліковано» з обережною приміткою. Узагальнення з цього джерела до інших мереж SSRN — це екстраполяції. Додаток E зменшує цю залежність, додаючи незалежний архівний поперечний переріз для всіх полів (n = 1360), який відтворює асиметрію, різницю середнього до медіани, смугу переходу, множник поля та логарифмічну нормальність на спостережуваному тілі. Він несе свою власне упередження висхідного відбору і підтверджує форму розподілу по дисциплінам. Порядок денний розділу 8 все ще спрямований на еталон, репрезентативний для платформи.
Упередження топ-списку. Припасування великої вибірки 2015 року охоплює лише топ-списки (приблизно верхній дециль авторів та їх праць [85]), тому тіло розподілу нижче елітних списків інферується з припасованої логарифмічної норми, а не спостерігається. Висловлювання процентилів, отримані з цього припасування, засновані на моделі.
Семантика лічильників нестійка. Те, що записують перегляди та завантаження, змінювалось з часом і продовжуватиме змінюватись з переробленням інтерфейсу та еволюцією фільтрування ботів. Система цілісності платформи виключає певну підозрілу діяльність із офіційних підрахунків [144][66][69], а суміжна інфраструктура RePEc/LogEc документує як історичний масштаб трафіку роботів, так і нещодавні хвилі AI-краулерів, які вимагали відкидання переважної більшості необроблених даних трафіку [99][129]. Норми конверсії, цитовані в Розділі 5, є тому кількостями, специфічними для років випуску, а порівняння лічильників впродовж років змішують поведінкові та фільтраційні зміни. Загальну статистику веб-ботів [158] не можна екстраполювати на відфільтровані лічильники SSRN у жодному з напрямків.
Нестійкість платформи та зміщення джерел. Припинення Рейтингів вбудоване в більш широку перебудову продукту 2026 року [146][149][150], тому жаден аналіз не повинен розглядати 15 липня 2026 року як відокремлене втручання. Ця загроза вбудована в проект Розділу 8.5, але не може бути повністю усунута. Сторінки підтримки платформи оновлюються без попередження; усі такі сторінки цитуються тут з датами доступу, а цитована мова платформи повинна бути перевірена повторно проти архівних копій перед офіційною подачею.
Немає даних процентилей. Жодні публічні дані про процентилі на рівні всієї платформи ніколи не існували, і після 15 липня 2026 року жадна репрезентативна для платформи рамка процентилів не може бути зібрана ззовні, оскільки рейтинги, які раніше розкривали пороги топ-списку, були видалені [149]. Розподіл, заснований на вибірці, все ще може бути зібраний з архівних знімків, і Додаток E повідомляє про один; він фіксує форму розподілу і не надає процентилів платформи. Деякі величини, представляючі інтерес (наприклад, доля сповіщень авторам «топ 10%» [161]), офіційно не документовані, і ми відзначаємо їх зникнення із публічного кадру без твердження про їх припинення.
Використання не є читанням, і так само не якістю. Завантаження може передувати ретельному читанню, поверховому огляду, архівному зберіганню або взагалі відсутності використання. Завантаження не є прямим індикатором якості досліджень і не є гарантованим причинним джерелом цитувань: асоціація завантажень–цитувань є позитивною, але неоднорідною (приблизно від 0,1 до 0,6 залежно від галузі, рівня агрегації та горизонту [18][25][39][80][102][108]) і популяції з високим завантаженням та високим цитуванням перекриваються лише частково [108]. Самі цитування можуть бути позитивними, негативними, формальними або стратегічними, а процес цитування систематично упереджений проти нових робіт [166]. Ніщо в цій статті не дозволяє замінити метрику на експертне судження; обґрунтоване використання фреймворку є діагностичним і описовим.
Ненаблюдаема експозиція та невипадковий престиж. Не кожна експозиція спостережувана: читачі натикаються на назви у електронній пошті, соціальних мережах, результатах пошуку та кореспонденції до того, як буде залоговано будь-який перегляд сторінки анотації, і автори з добрими зв'язками генерують позаплатформену експозицію, корельовану як з престижем, так і з якістю. Спостережувальні коефіцієнти престижу тому змішують увагу, засновану на статусі, з реальними різницями в ресурсах, темах і мережах [111][140]. Експериментальне маніпулювання сигналами авторської ідентичності [154][64] доповнює, але не замінює спостереження платформи. Класифікація поля частково обрана авторами, і праці займають кілька категорій, ускладнюючи призначення в одне поле.
Обмеження самого порядку денного. Квазіекспериментальні проекти розділів 8.4–8.5 стикаються з ефектами оголошення, одночасними змінами платформи та невипадковими різницями в полях. Вони позначаються як квазіекспериментальні, оскільки подія на рівні всієї платформи не пропонує необробленої контрольної групи. Знімок дослідження 2 буде старіти разом з двигунами, які він перевіряє, а його протокол репродукції пом'якшує, але не усуває нестаціонарність. Дослідження 3 — це дослідження конкретного випадку N = 2, цінність якого полягає в механізмі та протоколі, а не в оцінці популяції, і його логіка атрибуції залежить від псевдонімів для кожного каналу, а не від будь-якого твердження про видимість публічної електронної пошти. Реєстр, заснований на краудсорсингу, успадковує проблеми самовідбору та верифікації, викладені в розділі 8.8. Доступ до даних для всіх конструкцій залежить від співпраці платформи або обмеженого за ставкою збору в межах умов обслуговування [134][51]; жодна не гарантується.
Широта бібліографії. Бібліографія широка, тому що стаття є синтезом; багато з цитованих досліджень мають спільні рамки, поля та обмеження конструкції, а публікації спільноти документують досвід без встановлення параметрів популяції. Доказ твердження — його рівень верифікації та рамка вибірки, а не кількість посилань за ним.
Смуги — це цілі калібрування, а не константи. Смуга конверсії 11–19% та пороги CSAB — це величини, які повинні калібруватися за полем і за платформою, а не універсальними константами вченої поведінки (розділи 4.4, 5.2). Їхня поточна форма — це одна міжполева смуга, яка буде замінена розподілами для кожного поля, які вимагає фреймворк, коли буде опубліковано дослідження 1, розділене за полями (розділ 8.6).
Узагальнення за межами SSRN вимагає перекалібрування, а не трансплантації. Проблема інтерпретовності, діагностована тут (лічильники використання, відображені без публічної порівняльної шкали), і логіка досяжності та конверсії, яка її виправляє, не є специфічними для SSRN; вони застосовуються до будь-якого сервера препринтів, який показує лічильники використання, включаючи bioRxiv, medRxiv, arXiv та OSF Preprints [11][62][2][24]. Те, що не передається, — це конкретна смуга 11–19% або пороги CSAB. Кураторство, архітектура розповсюдження та інтерфейс відрізняються на серверах: трафік витягування, керований намірами arXiv, та його списки сповіщень електронною поштою проти куратованих сповіщень push SSRN (таблиця 6). Числові якорі мають тому бути переоцінені на кожній платформі перед тим, як вони будуть там цитовані. Фреймворк є портативним; його калібрування є місцевим. Протокол паралельного депозиту розділу 8.8 є прямим емпіричним тестом того, наскільки далеко подорожують смуги SSRN. Масштаб цього перекалібрування легко недооцінити: медіанне завантаження по всьому корпусу bioRxiv (близько 279, і приблизно 496 в геноміці [2]) у кілька разів перевищує медіану 60 в архівному перерізі додатка E: приблизно п'ять разів загалом і близько восьми разів в геноміці. Порівняння лише вказівне. Цифра bioRxiv походить із перепису всього корпусу, в той час як 60 походить із архівної вибірки, яка надмірно представляє захоплені сторінки, змішує вікові та полові композиції, які змінюються з часом, і представляє вік у цілих роках. Напрямок розриву безпечно читати; його розмір — ні.
Етика. Гілка суспільного дискурсу цієї статті складається з добровільно обраних публічних постів, використовуваних лише як докази попиту, ніколи як репрезентативну думку, і цитованих лише там, де існує живе, перевірне джерело. Користувацькі пости цитуються з урахуванням етики цитування змісту напівпублічного форуму, включаючи парафраз замість дослівного цитування у випадках, коли авторів можна було б ідентифікувати всупереч їхнім очікуванням, узгоджено з нормами прозорості для якісних доказів [6]. Дослідження 3 реєструє лише повідомлення, надіслані непрохаючи авторові з інструментарієм, і не збирає персональні дані третіх осіб, крім того, що добровільно надають відправники. Дослідження 4 збирає лише добровільні анонімізовані відповіді на анкету на основі інформованої згоди. Дизайн панелі використовує публічно відображені лічильники та бібліографічні метадані, і будь-яке збирання непублічної інформації панелі (таких як дати статусу розповсюджування) потребує інформованої згоди автора та, де це застосовується, інституційного огляду. Два дослідження, які включають людських учасників та дані, створені учасниками, це Дослідження 4 (опитування автора) та Дослідження 3 (розміщення з реєстрацією вхідної пошти). Оскільки обидва є дослідженнями із залученням людей, обидва будуть подані на затвердження відповідною інституційною комісією з огляду або комітетом з етики досліджень і проводитися під інформованою згодою учасників до того, як розпочнеться збирання даних, а персональні дані, що містяться в журналах вхідної пошти, агрегуються та деідентифікуються до будь-якого аналізу або звіту. Цей протокол є передумовою виконання і відтворюється у Деклараціях.
10. Висновок та рекомендації щодо політики
10.1 Що встановив аналіз
Припинення служби SSRN Rankings 15 липня 2026 року усунула єдину публічну порівняльну шкалу [149]. Лічильники залишилися на кожній статті та профілі, що залишило метрики нечитаними, а не безсенсовими. На тлі цієї втрати ця стаття збирає кожний перевіримий емпіричний якір у карту еталонів з явними застереженнями щодо часу та впевненості (Таблиця 7), будує основу для інтерпретації, п'ятирівневу шкалу, розкладання охоплення–конверсії та протокол досьє (Таблиці 8, 9, 13), які перекладають лічильники в діагнози, і викладають готову до попередньої реєстрації програму розділу 8, який визначає, як можна перебудувати відсутні розподіли.
Механізм, що лежить в основі аргументу, зводиться до цього:
Ніхто не знає, що означають сім завантажень без порівняння, а після 15 липня 2026 року платформа більше не відповідає «з чим».
Внески різняться за своєю природою. Визначення проблеми класу посилань є діагностичним: сирий підрахунок не дає відповіді на жодне питання, поки вік, галузь, когорта та експозиція не визначать його групу порівняння. Інструментальний внесок — це карта еталонів і CSAB, які нормалізують емоційно значимий, але науково неоднозначний показник в інтерпретовану діагностику. Посібник і протокол досьє — це практичний внесок, який дозволяє авторам і комітетам діяти на основі лічильників сьогодні без неправильного їх прочитання. З точки зору політики, внесок — це анонімізований процентильний діапазон: порівняльний контекст відновлений у формі, яка нікого не ідентифікує і не відновлює жодну таблицю рейтингу.
На основі зібраних доказів питання в назві цієї статті погано поставлене, поки не буде визначено клас посилань. Проти кожного доступного якоря малі лічильники є статистичною нормою платформи, а не вердиктом про роботу. Стаття з 40 переглядами анотацій та 7 завантаженнями узгоджена, як результат скринінгу, з емпіричною смугою конверсії розділу 5 [139][172][83], тоді як стара практична норма три перегляди на одне завантаження [18] знаходиться вище цієї смуги, а не всередині неї. Медіанна стаття в єдиній переписоподібній вибірці накопила 63 завантаження протягом двох років [139], а вступ до списку найкращих 10 000 за 2015 рік, приблизно 1,8% повнотекстового багажу статей платформи (571,040, липень 2016 [1]), вимагав 160 завантажень за все життя [85]. За квазілогнормального режиму уваги більшість авторів за конструкцією стоять на нижніх щаблях драбини. Медіанний препринт живе в довгому хвості логнормального розподілу, який його автор не може бачити, і його виводять механіки класифікації, які сприяють афіліованим. На нього звертаються хижаки перш, ніж його прочитають коліги, і він тепер втратив рейтинг, який його колись розміщував. Шкала розміщує стаття десь на цій драбині, і розпач, який несе питання, створюється відсутною шкалою, а не самим числом.
Нічого в цьому не притаманне одній платформі, і подія не є безпрецедентною. ResearchGate припинила роботу свого критикованого складеного показника RG Score в серпні 2022 року [130], після тривалої методологічної критики [90], а в 2022–2023 роках десятки американських правничих шкіл, очолювані Yale та Harvard, вийшли з рейтингів правничих шкіл U.S. News [13]. Припинення використання оспорюваного показника не є косметичним актом, оскільки показник ніколи не був пасивним описом: література реактивності, яка виросла з рейтингів правничих шкіл, показує, що публічний рейтинг змінює поведінку тих, кого він ранжує [58][132], тому як його впровадження, так і його видалення змінюють поведінку, а не просто змінюють те, що повідомляється. Лічильник і його порівняльна рамка разом є метрикою, а припинення роботи рамки при збереженні лічильника залишає кожного користувача з числом без порівняння. Інтерпретовність, наявність публічного розподілу для публічного лічильника, слід розглядати як першокласний вимір якості будь-якого індикатора, поряд з валідністю та надійністю. Метрики переживають свою інтерпретивну інфраструктуру, і метрика без контексту — це шум, приклад загальної дисципліни критичного прочитання деконтекстуалізованих чисел [15]. Та ж метрика з контекстом — це калібрування, яке розширює можливості авторів, поліпшує вчену комунікацію та підтримує довіру до репозиторіїв, які її показують.
Цей фреймворк вимагає від користувача кількох звичайних практик. Порівнюйте однакове з однаковим і розділяйте охоплення та конверсію. Читайте траєкторії, а не підсумки, розглядайте кожне число як датоване, і не дозволяйте жодному лічильнику ходити без його джерела, часового вікна та обмежень.
10.2 Рекомендації для авторів
Автори можуть діяти зараз, не чекаючи нових даних. Зробіть датовані знімки екрана лічильників на рівні статей, які зберігають контекст: після припинення вони є єдиним записом про статус, який залишається під контролем автора, і вони формують основу спільнотного реєстру розділу 8.8. Повідомляйте про підрахунки лише з їх контекстом (вік, галузь, когорта та джерело), дотримуючись протоколу досьє таблиці 13, в якому кожне число супроводжується його джерелом, часовим вікном та обмеженнями. Читайте панель діагностично, а не емоційно: розмежуйте охоплення від конверсії (таблиця 9), розглядайте нульові завантаження на першому тижні як нормальну поведінку до розповсюдження [53], і порівнюйте з трьома–п'ятьма статтями колег, опублікованими в тому ж місяці, а не з видимим хвостом, чиї циркулюючі показники віх гарантують некаліброваність у важкохвостому режимі [85][180]. Розглядайте листи із проханнями як явище скрейпінгу, а не як визнання, і не як доказ щодо лічильників [61][107][144].
10.3 Рекомендації для оцінювачів
Установи, які імпортували завантаження SSRN як валюту оцінювання [12][18][161][52], стоять перед питанням управління, коли публічна шкала цієї валюти зникла. Сирові підрахунки завантажень не повинні входити у файли найму, просування або призначення: вони маніпулюються саме на порогах, які мають значення [44], вони варіюються до восьмикратно в межах підгалузей однієї мережі [168], і тепер вони непрозорі щодо еталонів. Мінімально захищеною одиницею є процентиль у межах визначеної когорти (та ж область, та ж вікова група, той же період публікації) зі своїм джерелом і датою, і докази використання повинні доповнювати, а не замінювати цитування, експертну оцінку та змістовне судження [108][109][110]. Усталений консенсус реформи оцінювання досліджень працює на цьому принципі. Основна вказівка DORA полягає в тому, щоб не використовувати єдине число чи замінник місця публікації як заміну для оцінювання самого дослідження [8], і Leiden Manifesto наполягає, що кількісна оцінка повинна підтримувати, а не замінювати якісне експертне судження [78]. Огляд Metric Tide підтримує цю наполегливість, закликаючи до показників, які є надійними, скромними, прозорими, різноманітними та рефлексивними, і використовуються на підтримку експертної оцінки, а не як її заміна [173], так само як і новітша CoARA Agreement on Reforming Research Assessment, сотні організацій-підписантів якої зобов'язуються до якісного оцінювання, підтримуваного, а не замінюваного, відповідальним кількісним використанням [183]. Весь цей консенсус застосовується в повній мірі до лічильника завантажень, чия публічна шкала була вилучена. Два з п'яти вимірів Metric Tide безпосередньо стосуються методу, запропонованого тут: різноманітність — це нормалізація за галуззю, на якій наполягає ця стаття, а рефлексивність — це позиція розділу 8.7, в якому стаття вимірює власну увагу. Його наступник, орієнтований на REF, переносить ті ж п'ять принципів у практику Великобританії [184]. Цей консенсус сам по собі є одним виразом ширшої критики надмірного використання метрик у інституційному житті [113]. Комітети з оцінювання мають очікувати та приймати формат протоколу Таблиці 13 (контекстуалізовану, наративну форму доказів, яку формати оцінювання, що розвиваються, такі як R4RI Великобританії (Résumé for Research and Innovation), розраховані передавати [186]) замість застарілої мови рейтингу «топ 10%». У Сполучених Штатах той самий важіль мови досьє є предметом Higher Education Leadership Initiative for Open Scholarship (HELIOS Open), яка працює з університетами над переписуванням критеріїв просування та призначення [189]; контекстуалізована лінія використання, зазначена тут, є саме конкретною рубрикою, якої часто бракує таким реформам.
10.4 Рекомендації для платформи
Припинення рейтингів без контексту заміни означає обмін одного хибного сигналу на його повну відсутність. Наслідки виходять далеко за межи комфорту авторів. Чи припинення охолоджує нові розміщення — результат обсягу розміщень, зазначений у розділі 8.5 — є відкритим емпіричним питанням щодо здоров'я самої платформи. Рамка передбачає конкретний напрямок розвитку продукту, який не відтворює механізм рейтингування, який SSRN вирішив припинити [149]:
1. Анонімізовані процентильні смуги за дисципліною та віком роботи. Показуйте рейтинг завантажень та переглядів кожної роботи як грубу процентильну смугу в межах когорти своєї дисципліни за віком: інформацію, яка потрібна кожному автору, опубліковану у формі, яка не ідентифікує нікого, не створює лідерборд та зменшує динаміку «переможець забирає все» у списках топ-N. Процентильний контекст зберігає приватність, одночасно відновлюючи читаність. Цільовий формат відображення — це саме еталонна діаграма за віком на рисунку 14.
2. Часово-нормалізоване відображення. Показуйте порівняння з урахуванням віку замість лише довічних підсумків, щоб робота, яка існує 14 днів, ніколи не порівнювалась неявно з роботами, які накопичували увагу роками.
3. Розділіть охоплення від конверсії. Повідомляйте про перегляди анотацій та завантаження як окремі сигнали з їх співвідношенням, замість запрошення однозначного читання, яке плутає невидимість із відхиленням.
4. Прозорі референтні класи. Будь-який порівняльний показник повинен вказувати на популяцію, область, період та групу віку, з якою він порівнюється; немарковане «топ X%» є науково неінформативним. Додаток D визначає десять полів розкриття, які повинна містити версійна процентильна версія, від визначень популяції та когорти до правил приватності мінімальної комірки та цитованої історії версій.
5. Дизайн аудиту для кумулятивної переваги. Класифікація, розповсюдження сповіщень, рейтинг пошуку та видимі сигнали популярності розподіляють дефіцитну увагу та мають бути оцінені на предмет їх розподільчих ефектів. Емпіричні проекти розділів 8.4–8.5 безпосередньо придатні для такої перевірки.
6. План щодо інтерпретативного залишку при вилученні функцій. Коли порівняльні функції видаляються, втрату інтерпретації слід оцінити та пом'якшити з такою ж обережністю, як міграція даних, через архіровані розповсюдження, опубліковані зведені процентилі або явну передачу спільноті, оскільки показник, який не можна прочитати, не може інформувати.
7. Механіка контактів, стійка до збирання даних, яка зменшує негативну зовнішність видимості у вигляді розпитувань, задокументовану в розділі 7 [107][159]. Один конкретний спосіб: затримати або затемнити публічне розкриття маршрутів контактів автора приблизно протягом перших 48–72 годин після розміщення — під час яких законне розповсюдження зазвичай ще не розпочалось, але програмне збирання найбільш ймовірне. Ефект будь-якого такого заходу слід оцінити емпіричним шляхом, а не припускати. Компроміс є реальним, оскільки приховування контактної інформації також може поставити у невигідне становище саме новачків, які залежать від прямого зворотного зв'язку.
8. Публічний журнал фільтрування та задокументована механіка розповсюдження. Опублікуйте запис у стилі LogEc того, що відкидають фільтри цілісності, та задокументуйте, як працює розповсюдження eJournal та вибір дайджесту. Суміжна інфраструктура RePEc/LogEc демонструє, що така прозорість можлива у масштабі [99][129], тоді як SSRN наразі описує свої фільтри без опублікування їх історії [144] (таблиця 6). Коли фільтрування задокументовано, переформулювання лічильника можна читати як подій вимірювання, а не як подій репутації.
9. Зробіть історію експозиції зрозумілою. Сторінка роботи або дашборд автора повинні розрізняти публічне розміщення, призначення класифікації, кураторське розповсюдження, підтвердження індексування та основні переформулювання лічильника, щоб автор міг розділити «ще не експоновано» від «експоновано, але не конвертовано». Це платформна відповідність читанню режиму експозиції розділу 5.6 та найдешевше лікування найбільш тривожного стану дашборду — раннього нуля.
10.5 Рекомендації для дослідницької спільноти
Спільнота не має чекати платформи. Реєстр розділу 8.8 (датовані, самозвітні знімки панелі приладів, надані за відкритим протоколом) може утворити першу свіжу базу розподілу завантажень за десятиліття. Два дослідження публічних даних таблиці 17 (1 і 2) можуть бути виконані будь-яким дослідником у межах обмежень доступу, зазначених у розділі 9, тоді як два дослідження із залученням учасників (3 та 4) потребують волонтерів та етичних схвалень, викладених у Деклараціях. Наукометрія повинна розглядати інтерпретованість метрик як частину свого предмета: нинішній випадок, у якому десятиліття лічильників пережили їхню єдину публічну шкалу, навряд чи буде останнім. Розподілена репліація протоколу інструментованого постинга, спільнотне обслуговування таблиць процентилів (та публічного калькулятора для авторів, побудованого на них, розділи 8.8 та 8.10), та оцінювання інтерпретативного впливу змін платформи є самостійними науковими внесками, і кожна з них перетворює репаративну роботу цієї статті на профілактику.
10.6 Завершення
Питання «що означають мої сім завантажень?» проходить через цю статтю, тому що це питання, з яким залишилися майже два мільйони авторів платформи 15 липня 2026 року [49][149]. Зібрана тут відповідь — це ні заспокоєння, ні тривога, а калібрування. Число відповідає доступним свідченням конверсії, але залишається результатом скринінгу; тривога виробляється відсутною шкалою, яка може бути відновлена частково з літератури, як зробили розділи 3–6, і частково з нових даних, як визначає розділ 8.
Стаття почалася з питання, з яким залишається кожен автор:
«Що означають мої 7 завантажень?»
Фреймворк замінює його на це:
«Де стоїть ця робота серед порівнюваних праць того ж віку, галузі, когорти та історії поширення? Його обмеження — це охоплення чи конверсія? І чи вона вилучається та цитується системами, через які читачі тепер виявляють дослідження?»
Це питання, на яке може відповісти наукометрія, і ця стаття визначила, як.
Те, що записують лічильники, — це події, і тільки події. Перегляди — це не завантаження; завантаження — це не читання; середнє значення — це не норма; лічильник — це не вердикт; звернення — це не визнання; пошук ШІ — це не точне цитування; а число без масштабу — це не інформація.
Доки платформи показують лічильник окремо від його контексту, автори, оцінювачі та платформи будуть продовжувати читати розподільчі факти як особисті вердикти. Відкритий доступ виграв битву, яку вів (право розміщувати та завантажувати без цінових бар'єрів), і, виграючи її, виявив битву, яку ніколи не вів: розподіл уваги. Автори можуть читати лічильники з галуззю, віком та конверсією. Метрики SSRN все ще мають цінність, але тільки для автора, який розуміє, що вони означають.
Додаток A. Ситуація → Керівництво дій
Таблиця 23 зводить розділи 4–6 до ситуацій, які автори найчастіше повідомляють [161][127][139]. Його середня колонка містить лише те, що дозволяє зібране свідчення, з джерелами та вікнами. Колонка застережень містить обмеження, яке повинно супроводжувати кожне читання. Числа, що з'являються тут, — це числа таблиць 6–7 та рисунка 6 основного тексту.
Таблиця 23. Ситуація → що говорить свідчення → що робити.
| # | Ваша ситуація | Що говорить свідчення | Що робити | Джерела та застереження |
|---|---|---|---|---|
| 1 | «7 завантажень і 40 переглядів анотації в першому місяці.» | Конверсія становить 17,5%, у межах міжстудійної смуги 11–19% як точкова оцінка, хоча 95% інтервал Клоппера–Пірсона на 7/40 (≈7,3–32,8%) широкий і охоплює смугу; медіана роботи LSN досягла 63 завантажень тільки через два роки, а медіана роботи з маркетингу становила 87 при медіанному віці 16 місяців — анкери зрілої вибірки, не відповідні за віком читанню на день 20. Результат скринінгу з широким інтервалом, а не свідчення невдачі. | Продовжуйте графік спостережень таблиці 11; класифікуйте траєкторію не раніше дня 60–90. | Смуга: [18][139][172]; медіани: [139] (2012 LSN), [83] (2025 Marketing). Усі анкери є однодисциплінарними та застарілими; конверсія 7/40 — це оцінка скринінгу з широким інтервалом, не відповідна за віком до зрілих анкерів. |
| 2 | «Нульові завантаження на першому тижні.» | Нормальна попередня розповсюджень: класифікація курується і може займати до 45 днів для завантажених тем; сповіщення eJournal сприяють раннім переглядам і продовжуються після завершення; індексування Google Scholar займає 6–9 місяців або більше. | Підтвердьте публічне розміщення; підтвердьте класифікацію eJournal; перевірте, чи індексується робота під її точною назвою — найдешевший доступний тест індексування; дочекайтесь циклу оголошень; тільки потім читайте лічильники. | [53][147][57][55]. Зміни формулювання сторінки підтримки; повторно перевірте з датами доступу. |
| 3 | «Багато переглядів, мало завантажень — конверсія набагато нижче 11%.» | Узгоджується з невідповідністю анотація–текст: читачі приходять та йдуть на анотації. Змінні пакування (назва, анотація, ключові слова) — це важелі уваги, найбільш стійко пов'язані з лічильниками. | Переглиньте назву та анотацію; повторно спостерігайте конверсію протягом наступного вікна перед подальшими змінами. | [139][168][172]. Причинне читання «низька конверсія = слабка анотація» — це гіпотеза скринінгу, а не перевірений діагноз. |
| 4 | «Конверсія значно вище смуги, або раптовий стрибок переглядів.» | Трафік, який не пояснює переглядання анотацій — посилання ЗМІ чи агрегаторів, або неживий трафік, який фільтри ще не видалили. | Визначте зовнішнє джерело (охоплення, списки розсилок); не посилайтесь на стрибок як на читаність без підтвердження. | [116][138][144][102 — механізм попередньої вибірки Safe Links, з застереженням, що власна фільтрація SSRN може вже виключати такий трафік]. |
| 5 | «Мій лічильник впав, або числа були перераховані.» | Платформи переглядають лічильники, коли змінюються правила фільтрації; RePEc відкинув велику частину сирого трафіку в документованих випадках (роботи ≈74% переглядів у 2007 році; >99,5% трафіку IDEAS у вересні 2025 року). | Сприймайте це як подію вимірювання; перевірте ваші датовані скріншоти; ніколи не повідомляйте про це як про втрачену читаність без підтвердження. | [144][69][99][129][66]. |
| 6 | «Рейтинги пішли, і я не знаю, де я стою.» | Не залишилося жодної публічної рамки перцентилів, і жодної репрезентативної платформи неможна зібрати зовні. Архівна поперечна частина додатку E забезпечує розподіл посилання на основі вибірки, а згодоване порівняння залишається замінником платформи перцентилів. | Побудуйте мікро-тест 3–5 колегіальних робіт, опублікованих в тому ж місяці, і відслідковуйте їх за своїм графіком; за бажанням обчисліть співвідношення ваших завантажень до медіани відповідної когорти. | [149][51]; анкери [139][83][85]. Співвідношення не має каліброваних смуг інтерпретації (розділ 6.3). |
| 7 | «Комітет побачить мої рахунки.» | Рядки рангу у досьє — це документована практика, і їхня порівняльна рамка пішла; мова смуги з джерелами, кваліфікаторами поля та триангуляцією цитування витримує розгляд там, де сирі рахунки не витримують. | Застосуйте семикроковий протокол таблиці 13: збережіть, перекладіть, триангулюйте, нормалізуйте поле, доповніть, цілісність, експертна оцінка. | [12][95][33][52][77][108]. Завантаження вимірюють попит, а не якість; історія маніпуляції [44] відома оцінювачам. |
| 8 | "Хижацькі запрошення почали надходити дні після публікації." | Задокументований побічний продукт збирання з платформ препринтів; суміжні аудити повідомляють про десятки запрошень на два тижні на одного вченого. Обсяг сигналізує про видимість для скребків, а не про визнання читачами. | Ніколи не платіть; перевіряйте видання через Cabells і Think. Check. Submit.; спрямовуйте кореспонденцію через спеціальну адресу; див. Таблицю 14 для типології. | [107][159][9][84][63][32][136]; [B-1] (список Beall неактивний з 2017 року). Часові закономірності не вимірюються; екран "днів після публікації" має якісний характер. |
| 9 | "Перевірка подібності журналу позначила мою подачу як збіг з моїм власним препринтом SSRN." | Система скринінгу працює як задумано: препринти, зареєстровані як Crossref Posted Content, є частиною корпусу порівняння, а рекомендація iThenticate зазначає, що збіг препринту того ж автора не є плагіатом. Розміщення робочого документа дозволяється політиками попередньої публікації більшості журналів, але політики різняться, і цільовий журнал слід перевірити; основні винятки стосуються медицини та клінічних галузей. | Вкажіть позначене джерело редакторові як свій препринт з часовою міткою; не виводьте препринт; для медичних та клінічних видань перевіряйте політику препринтів цільового журналу (наприклад, через реєстр Sherpa Romeo) перед подачею. | [81][36]; Розділ 4.5. Політики журналів різняться та змінюються; перевіряйте поточну політику цільового журналу замість покладання на загальне правило. |
| 10 | "Рейтинги пішли — чи слід мені перенести мої статті на ResearchGate або Academia.edu?" | Не задокументовано жодної міграції авторів після sunset; лічильники завантажень не передаються між платформами; і платформи-компаратори мають ту саму проблему інтерпретивності — ResearchGate припинила свій комбінований RG Score у серпні 2022 року після методологічної критики. | Збережіть запис SSRN та доповніть замість переміщення: розмістіть ту саму статтю в інституціональному або тематичному сховищі (Таблиця 13, крок 5), збережіть знімки лічильників з датою та не видаляйте та не перепублікуйте в іншому місці, що призводить до втрати накопичених лічильників. | [130][90][149]; [47][146] (доповнення сховища); [161] (лічильник однієї платформи нічого не говорить про інші канали); [B-7] (видалення та повторна публікація скидає метрики). Відсутність задокументованої міграції — це відсутність доказів, а не доказ стабільності. |
Непровірені практики спільноти (кандидатні гіпотези для порядку денного Розділу 8). Наступні рекомендації циркулюють у спільнотах авторів і з'являються в попередніх проектах практичних посібників; жодне дослідження їх не підтримує, і вони записані тут як перевірювані гіпотези і не повинні цитуватися як результати: (a) обмеження класифікацій eJournal на трьох (одна основна, одна широка, одна міждисциплінарна) замість використання більшої кількості з дозволених семи [53][168]; (b) цитування робочих документів SSRN, щоб їх автори були повідомлені через сповіщення Google Scholar та взаємно реагували увагою; (c) приховання адреси електронної пошти профілю протягом перших чотирнадцяти днів після публікації, щоб зменшити збирання; (d) завантаження незначної редакції на день 3 для активування переоголошення (SSRN документує лише те, що редакції на місці зберігають лічильники та URL [B-7]); (e) будь-яке числове виявлення, пов'язане з екраном "запрошення протягом 96 годин є хижацьким"; (f) пряме звертання до трьох-п'яти авторів, цитованих у статті (коротке повідомлення, що зазначає цитування їхньої роботи SSRN) як канал до першої законної аудиторії, сформульоване як звичайна наукова комунікація, а не промоція. Кожна є спростовною за допомогою спостережних проектів Розділу 8; поки не перевірено, їхня належна форма цитування — "практика спільноти, непровірена."
Таблиця 24 переупорядковує посібник хронологічно. Кожна комірка вказує назад на розділ та його джерела. Представлення на часовій шкалі відповідає на питання, яке насправді задають автори ("що мені робити зараз?") у порядку, в якому виникають ситуації, та доповнює індексовану ситуаціями Таблицю 23.
Таблиця 24. Посібник як часова шкала: три фази × три осі. Усі комірки підсумовують докази та інструкції, уже викладені в розділах 4–7; непровірені практики спільноти виключені (див. список вище).
| Фаза | Механіка платформи та вимірювання | Аудиторія та розповсюдження | Захист від запрошень |
|---|---|---|---|
| Перед публікацією | Розглядайте заголовок та анотацію як поверхню конверсії та оформляйте їх відповідно (§6.4; [139][172]); планіруйте класифікації eJournal — дозволено до семи, і більше класифікацій пов'язані з більшим завантаженням та менше нулів [53][168] | Визначте когорту мікротестування з 3–5 статей для отримання поряд з вашою власною статтею (§6.3) | Спрямовуйте кореспонденцію через спеціальну адресу до того, як метадані стану public (§6.6) |
| При публікації | Підтвердіть публічну публікацію та класифікацію eJournal; запишіть базову лінію першого дня сітки Таблиці 11 (§6.1) | Сповіщення електронної пошти eJournal є основним каналом push платформи та продовжуються після sunset [147][57] | Очікуйте запрошень як природної наслідку видимості, а не сигналу про цінність (§6.6; [159][63]) |
| Перші тижні (дні 1–45) | Читайте ранній нуль як попередньо-розповсюдження, а не відхилення (§6.2 правило iv; [53]); логуйте лічильники за графіком Таблиці 11; класифікуйте траєкторію не раніше дня 60–90 (§6.3) | Застосовуйте законні зовнішні важелі, де доречно — блог та списокове висвітлення дали вимірювані ранні піки (§6.4; [116][72]) | Ніколи не платіть; скринуйте будь-яке запрошуване видання ([B-1]; Think. Check. Submit. [159]); перевіряйте запрошення проти типології Таблиці 14; ніколи не читайте обсяг спаму як читацтво (§7.6) |
Додаток B. Шаблон звітування CSAB
Мінімальне твердження CSAB, орієнтоване на авторів або оцінювачів (Розділ 5.5; Таблиця 10), повідомляє:
На момент віку статті [X днів] статя мала [V] переглядів анотацій та [D] перевірених завантажень. Відносно [визначеної галузі / когорти / референтного класу новачків], її персентиль досяжності становив [RV], персентиль завантажень [RD] та персентиль конверсії з коригуванням на скорочення [RC]. Стаття [мала / не мала] зареєстрованого кураторського розповсюджування на момент цього спостереження. Від [віку 1] до [віку 2] її нормалізоване положення [зросло / залишилося стабільним / впало]. Ці показники описують дифузію й не встановлюють якість або коректність дослідження.
Доки не буде оцінена сучасна референтна панель (розділи 5.5, 8.3), поля персентилів мають залишатися порожніми: жодне значення не може бути введене з інтуїції, з платформових середніх значень або з застарілих зразків. Історичні якорі можуть бути звітовані поряд із шаблоном: медіана LSN 2012 року 63 завантажень на два роки [139] та медіана Marketing-network 2025 року 87 [83], кожна з вказаними зразком, галуззю та віком, але ніколи не замінюючи відсутній референтний клас. Шаблон є еквівалентом на рівні речення кроку Translate протоколу досьє (таблиця 13, крок 2).
Додаток C. Словник змінних панелі
Таблиця C1 визначає мінімальний запис інтервалу статей для основної панелі розділу 8.3: найменша схема, достатня для відтворення оцінок CSAB розділу 5.5 та аналізів подій платформи розділів 8.4–8.5. Публічні випуски замінюють прямі ідентифікатори стабільними ключами дослідження, де зв'язок аналітично не необхідний, а внески до реєстру (розділ 8.8) використовують підмножину цієї схеми, зазначену там.
Таблиця C1. Мінімальна схема даних інтервалу статей для основної панелі.
| Область | Змінна | Визначення або формат |
|---|---|---|
| Ідентифікація | paper_id | Стабільний ідентифікатор дослідження |
| Ідентифікація | ssrn_abstract_id | Ідентифікатор платформи; хешований або обмежений у публічних випусках |
| Час | posted_at | Дата першого публічного розміщення |
| Час | observed_at | Часова мітка спостереження метрики (сітка таблиці 11) |
| Час | paper_age_days | Дні з моменту першого розміщення |
| Використання | abstract_views_cum | Публічні кумулятивні переглядів сторінок анотацій |
| Використання | downloads_cum | Публічні кумулятивні перевірені завантаження |
| Використання | views_interval, downloads_interval | Збільшення від попереднього коректного спостереження |
| Експозиція | classification_ids | Усі класифікації eJournal активні на момент спостереження |
| Експозиція | distributed_status, distributed_at | Індикатор кураторського розповсюджування та дата, де надана згода |
| Експозиція | search_indexed | Статус зовнішнього індексу, визначений протоколом (тест точної назви) |
| Стаття | title_frozen, abstract_frozen, keywords, page_count, doi | Метаінформація рукопису, найранніше спостережена та заморожена при першому спостереженні |
| Стаття | authors_frozen, affiliations_frozen | Імена авторів, порядок та приналежності при першому спостереженні |
| Версіонування | revision_id, revision_at, material_change_flag | Історія версій з індикатором суттєвої зміни |
| Автори | author_count, platform_newcomer, prior_ssrn_papers | Структура команди та історія платформи до розміщення (визначення розділу 8.3) |
| Репутація | prior_citations, prior_works, institution_measure | Заморожено перед основним розміщенням та нормалізовано за галуззю |
| Календар | day_of_week, week, season, holiday_flag | Попередньо визначені часові контролі [178] |
| Подальше | citations_6m, citations_12m, citations_18m, publication_status | Пізніші результати валідації з джерелом та датою (горизонти розділу 8.9) |
| Аудит | collection_method, source_url, quality_flag | Походження, маршрут доступу та документування аномалій (прапор, не видалення; розділ 8.3) |
Додаток D. Специфікація прозорості еталону
Щоб запобігти тому, щоб персентильний еталон розділу 8.8 та будь-який його наступник, який підтримується платформою або спільнотою (розділ 10.4, рекомендації 1 та 4), не відтворював непрозорість еталону, яку критикує ця стаття, кожний випуск персентилю публікується з версіонованим супровідним документом, що визначає:
1. відповідну популяцію статей, мережі, типи документів та винятки;
2. дати когорт розміщення та віки спостережень;
3. правило розподілу за галуззями, включаючи обробку множинних класифікацій;
4. визначення переглядів, завантажень, унікальних акторів, повторів та перевіреного трафіку на момент випуску;
5. медіану, міжквартильний розмах, P10/P25/P75/P90/P95, нульову частку, коефіцієнт Джині та топ-частки;
6. розміри зразків та інтервали невизначеності для кожного звітованого референтного класу;
7. обробку пропущених значень, зняття, ревізій, злиттів та повторних заяв;
8. змінні розповсюджування та зовнішньої промоції, включені в будь-яке коригування;
9. приватність та правила мінімальної комірки: для краудсорсованого реєстру розділу 8.8, де малі комірки за галуззю та віком в іншому випадку могли б ідентифікувати окремих учасників, цей пункт є зв'язуючою умовою, керованою законом про захист даних (у Великобританії UK GDPR та Data Protection Act 2018), а не формальністю. Контроль розкриття інформації повинен виходити за межи простої анонімізації до k-анонімності або агрегацій з доданим шумом (диференціально приватні) для тонких комірок, і правило дозволеного використання повинно прив'язати реєстр до тлумачення, а не оцінювання, забороняючи його використання для наймання, просування, розподілу ресурсів або переупорядкування в будь-який публічний рейтинг;
10. історію версій та постійне цитоване посилання для випуску.
Жоден складений показник не може замінити ці компоненти. Прості співвідношення до медіани когорти (некалібрований резервний варіант розділу 6.3) можуть бути нестабільними, коли комірка знаменника мала, і можуть неправильно припустити, що «удвічі медіана» відповідає фіксованому персентилю в різних сформованих галузях. Таким чином, звітування, спрямоване до авторів, використовує оцінки персентилів в умовах скорочення емпіричного-Байєса, вже визначеного для розріджених комірок у розділі 8.3, тоді як сирі розподіли залишаються доступними для аудиту.
Додаток E. Незалежний архівний переріз розподілу завантажень
Для недавніх доказів розподілу в цілому синтез розділів 3 та 5 спирається на один опублікований знімок [83]. Цей додаток описує незалежний, відтворюваний переріз, зібраний для цієї статті, який підтверджує структуру розподілу в різних галузях, використовуючи лише відкриті дані без привілейованого доступу до платформи. Це одноразова архівна реконструкція з відомим упередженням у бік завищення, запропонована як підтвердження форми, відмінна від попередньо зареєстрованої панелі розділу 8.6, яка спостерігає статті від моменту їх розміщення наперед.
Метод. Випадкову вибірку робіт SSRN було виконано з OpenAlex (джерело S4210172589, "SSRN Electronic Journal") по двадцяти трьох незалежних випадкових насінах. Для кожної вибраної роботи лічильники завантажень та переглядів анотацій до закриття читалися з найбільш свіжого снімка роботи в Internet Archive, знайденої через загальнодоступну кінцеву точку Wayback Machine, а не з живого сайту, який із обмеженим доступом (розділ 4) і більше не публікує порівняльні рамки. Читання лічильників з архівних копій замість запиту до платформи утримує процедуру обмеженою за темпом, з повагою до платформи та відтворюваною з випущених ідентифікаторів. Оскільки лічильники для кожної роботи пережили закриття рейтингів без змін, і були відведені лише порівняльні рейтинги, снімок з датою після 15 липня 2026 року залишається дійсним прочитанням накопленої кількості роботи. Снімки тому не були обмежені вікном до закриття, і дата снімка зберігається лише для обчислення віку роботи. Снімки, які повернули проміжне запитання для перевірки ботів замість вмісту сторінки, були відкинуті. З 2,600 вибраних робіт 64% мали придатний архівний снімок і 52% дали машиночитаний лічильник завантажень, що дало n = 1,360 робіт, що охоплюють двадцять п'ять полів, чотирнадцять з них містили щонайменше двадцять робіт, і вік робіт від року розміщення до понад двох десятиліть. Набір даних випущено як appendixE-wayback-downloads.csv і депонується за адресою https://doi.org/10.5281/zenodo.22285871, де той же файл носить назву study1-wayback-downloads.csv. Дві властивості вибірки обмежують те, що можна з неї прочитати. Дати розміщення містять рік, але не місяць: 1,358 з 1,360 записів позначені 1 січня, оскільки OpenAlex повідомляє про розміщення SSRN з точністю до року. Вік обчислюється як різниця року снімка та року розміщення, представляється цілими роками, і жоден коротший період часу не є обґрунтованим. Снімки також зосереджені в часі: 688 з них, половина вибірки, припадають на один краул між 25 квітня і 7 травня 2025 року, і 81,5 відсотка припадають на 2025 рік, тому вік роботи тут практично еквівалентний року розміщення, і ці два не можуть розглядатися окремо. Перший із цих недоліків можна усунути. Рядок розміщення "Posted: DD Mon YYYY" з'являється в тих же архівних снімках, тому повні дати можна відновити шляхом їх повторного аналізу, що обмеження доступу на живому сайті цьому не перешкоджає. Таблиця E1 робить це вибуття явним.
Таблиця E1. Побудова архівного перерізу та вибуття на кожному етапі.
| Етап | Роботи | % від початкової | % від попередньої |
|---|---|---|---|
| Випадково вибрані записи OpenAlex (SSRN Electronic Journal) | 2,600 | 100.0 | — |
| Знайдено придатний снімок Internet Archive | ≈1,660 | 63.8 | 63.8 |
| Снімок містив машиночитаний лічильник завантажень | 1,360 | 52.3 | 81.9 |
| Остаточна аналітична вибірка | 1,360 | 52.3 | 100.0 |
Результати. Поперечний переріз відтворює кожну якісну ознаку, яку стверджують опубліковані якорі (Table E4). Завантаження мають значний правий скіс: середнє 219, медіана 60 (95% bootstrap CI 55–69), співвідношення середнього до медіани 3.65, причому середнє значення перевищує 75-й перцентиль (158). Вони також мають важкий верхній хвіст (95-й перцентиль 816, більш ніж у тринадцять разів перевищує медіану; Gini 0.75, 95% CI 0.71–0.78). У логарифмічній шкалі розподіл близький до симетричного (асиметрія ln завантажень ≈ 0.18), узгоджено з приблизною логнормальністю спостережуваної частини розподілу, властивість, яку Kakushadze міг припасувати лише до топ-списків (Section 3.4). Коефіцієнт перетворення завантаження-до-перегляду має медіану 16.2% і середнє 17.3%, в межах смуги 11–19% міжстудійного (Section 5.2). Медіанні завантаження різняться між галузями при одному віці статті. При фіксованому віковому діапазоні різниця між найвищою та найнижчою медіаною галузі коливається від приблизно трьох до приблизно п'яти разів, точна цифра залежить від діапазону та обробки слабко відібраних галузей. При об'єднанні по всіх вікових групах різниця досягає близько дванадцяти разів, і ця більша цифра відображає змінюючийся склад вибірки: Інженерія становить 21–27% статей віком три роки або менше та не більше 5% тих, що дев'ять років і старші, тоді як Економіка становить 9–12% та 37–54% однакових груп, а медіанний вік статті з економіки тут дев'ять років проти одного року для інженерії. Напрямок узгоджується з множником поля розділу 3.6. Величини не порівнювальні, оскільки той множник спирається на середні за весь період часу упродовж 94 підгалузей однієї дисципліни, а цей розкид - на медіани по 25 дисциплінах, і жодна не скоригована за віком. Медіанні завантаження вищі у старших вікових діапазонах, з неперетинаючимися 95% bootstrap довірчими інтервалами між більшістю сусідніх діапазонів (медіана 12 у рік розміщення, 172 понад десять років), що є залежністю від віку, яка мотивує аргумент опорного класу. У межах однієї галузі різниця зосереджена в перші три чи чотири роки: між діапазоном п'яти-до-десяти та діапазоном понад-десяти це не досягає значимості (Mann-Whitney p = 0.57 для Економіки, 0.82 для Суспільних наук, 0.23 для Бізнесу). Близько чверті об'єднаного градієнта припадає на склад галузі, а не на вік. Вік у цій вибірці також майже збігається з роком розміщення, оскільки половина захопів було зроблено в одному пошуку між 25 квітня та 7 травня 2025 р., і 81.5% припадають на 2025, тому вік і когорта не можуть бути розділені тут, і діапазони показують рівні, а не траєкторію будь-якої окремої статті. Середнє значення вибірки (219) збігається з опублікованим середнім значенням маркетингової мережи (221) [83], тоді як медіана вибірки (60) знаходиться на рівні юридичної медіани у стилі перепису (63) [139]. Таблиця E2 дає розподіл завантажень за віком статті, а таблиця E3 - за галуззю, обидві з 95% bootstrap довірчими інтервалами та розмірами вибірок. Довірчі інтервали є найширшими для найменших полів, тому розкид поля описується як приблизно порядок величини, а не один точний множник. Вступний випадок статті можна безпосередньо порівняти з вибіркою. Серед статей віком менше двох років з 30–50 переглядами анотацій, у смузі, в яку потрапляє цей випадок, медіанна кількість завантажень дорівнює 7, з міжквартильним розмахом 4–11 (n = 42). Випадок у назві є типовим випадком для його смуги переглядів та віку. У рік розміщення 35% вибірки мають 7 або менше завантажень, медіанна кількість переглядів анотацій дорівнює 66, і власна конверсія випадку 17.5% знаходиться на 57-му перцентилі вибірки. Смуга конверсії 11–19% розділу 5.2 є смугою медіан, а не статей: 41% вибірки потрапляє до неї, 23% нижче та 36% вище. Половина вибірки, 51%, знаходиться нижче юридичної медіани у стилі перепису 63 [139], що розташовує зароджуючийся діапазон у заповненій частині розподілу.
Таблиця E2. Розподіл завантажень за віком статті в архівному поперечному перерізі.
| Вік статті | n | Медіана [95% CI] | Середнє значення | МКР (P25–P75) |
|---|---|---|---|---|
| рік розміщення | 203 | 12 [11–14] | 33 | 5–21 |
| 1 рік | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4 роки | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9 років | 188 | 130 [110–151] | 384 | 72–374 |
| 10 років і більше | 341 | 172 [157–189] | 453 | 96–336 |
| Усі статті | 1,360 | 60 [55–69] | 219 | 23–158 |
Таблиця E3. Розподіл завантажень за галуззю (поля з n ≥ 20) в архівному поперечному перерізі.
| Галузь (n ≥ 20) | n | Медіана [95% CI] | Середнє значення | МКР |
|---|---|---|---|---|
| Економіка | 285 | 150 [134–169] | 443 | 76–302 |
| Бізнес | 161 | 150 [126–188] | 335 | 72–330 |
| Психологія | 24 | 107 [35–192] | 179 | 32–229 |
| Суспільні науки | 241 | 85 [78–117] | 219 | 45–189 |
| Науки про прийняття рішень | 32 | 74 [56–158] | 615 | 49–260 |
| Комп'ютерні науки | 63 | 42 [36–73] | 167 | 26–104 |
| Медицина | 40 | 42 [24–59] | 81 | 22–66 |
| Сільськ. & Біол. науки | 36 | 31 [24–57] | 65 | 23–67 |
| Біохімія | 21 | 30 [23–37] | 38 | 20–38 |
| Екологічна наука | 72 | 26 [18–32] | 44 | 14–50 |
| Інженерія | 196 | 24 [20–26] | 46 | 13–46 |
| Фізика & Астрономія | 21 | 23 [15–38] | 112 | 13–45 |
| Наука про матеріали | 55 | 18 [15–25] | 26 | 11–36 |
| Енергетика | 21 | 12 [11–22] | 25 | 11–22 |
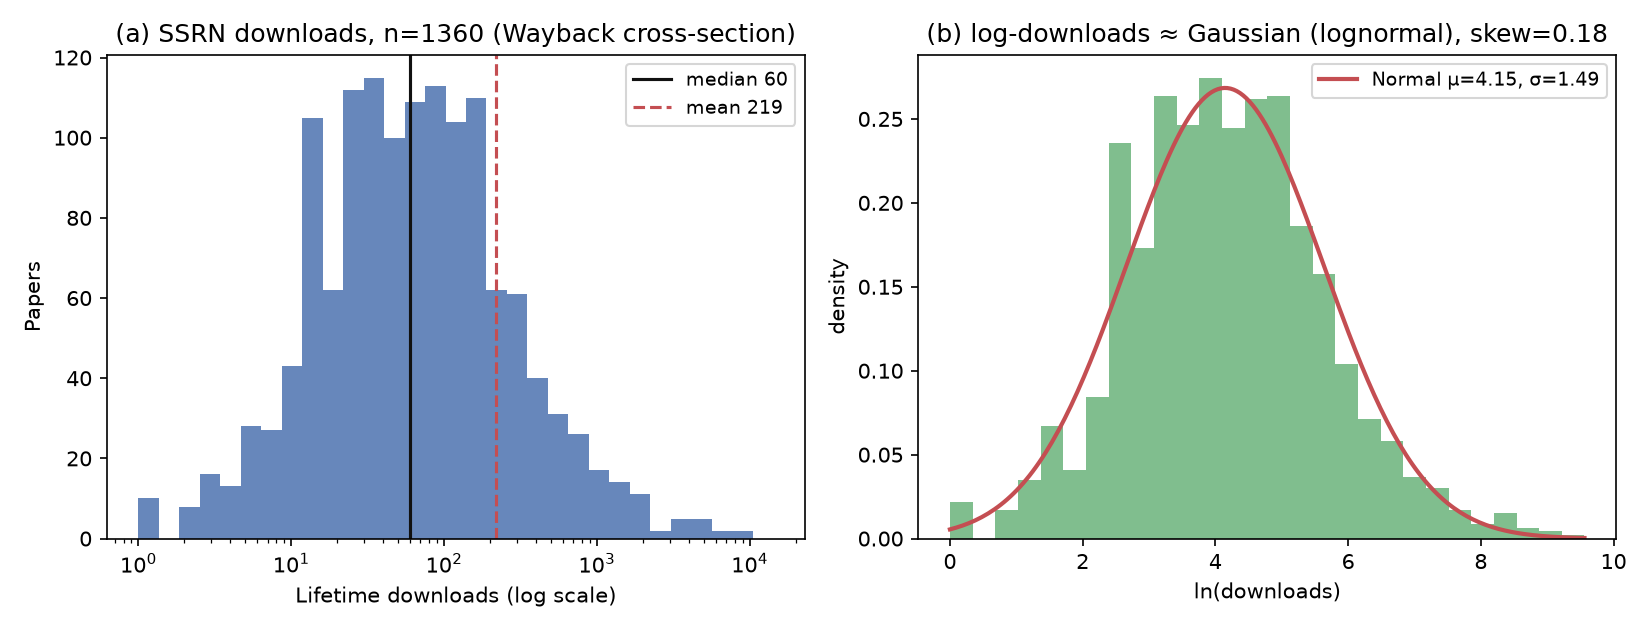
Figure E1. (a) Розподіл завантажень на логарифмічній шкалі з позначеним середнім значенням та медіаною; (b) гістограма ln(завантажень) з підібраною щільністю нормального розподілу. Асиметрія логарифмованих завантажень ≈ 0.18. n = 1,360.
Table E4. Опубліковані якорі проти незалежного архівного поперечного перерізу (n = 1,360).
| Ознака | Опублікований якір | Архівний поперечний переріз |
|---|---|---|
| Середнє завантажень | 221 (маркетинг) [83] | 219 |
| Медіана завантажень | 87 (маркетинг) [83]; 63 (право) [139] | 60 |
| Середнє / медіана | 2.54 [83] | 3.65 |
| 95-й перцентиль / медіана | > 8 [83] | 13.6 |
| Конверсія завантажень у перегляди | 11–19% смуга (§5.2) | 16.2% медіана |
| Розповсюдження по полях (медіани) | ≈ 8× середні значення по полям, без урахування віку [168] | ≈ 3–5× при однаковому віці; 12.5× об'єднані |
| Форма розподілу | логнормальний, тільки хвіст [85] | асиметрія логарифмів 0.18 (спостережене тіло) |
Що встановлює поперечний переріз. Поперечний переріз підтверджує форму розподілу та його центральну та верхню структуру по дисциплінам на незалежній всепольовій вибірці, набагато ширшій за охопленням поля, ніж будь-який один опублікований снімок SSRN. Він не оцінює репрезентативні для платформи перцентилі, і дві особливості його конструкції зміщують його вгору. Архівні снімки надмірно представляють видимі сторінки, тому статті з високим завантаженням з більшою ймовірністю будуть захоплені. Стаття також входить до вибірки лише якщо вона мала архівовану сторінку з читаємим лічильником, що цензурує крайній нижній хвіст: частка статей у вибірці з десятьма чи меншою кількістю завантажень (близько 10%) відповідно значно нижча за 15–30%, які розділи 3.4 та 8.6 передбачають для неупередженої цілої платформи, і не повинна читатися як оцінка цієї частки. Те, що медіана вибірки (60) все ж таки знаходиться на рівні або нижче за опубліковані медіани в праві (63) та маркетингу (87), вказує на те, що зміщення вгору скромне для центральної маси та що висновки про асиметрію та важкий хвіст, якщо щось, консервативні. Для каліброваних еталонів відповідні інструменти залишаються смуги перцентилів, репрезентативні для платформи, рекомендовані в розділі 10, та попередньо зареєстрована панель розділу 8.6; цей поперечний переріз підтверджує, що структура, яку вони виміряли б, є тією, яку описує ця стаття. Три з прогнозних смуг, які Дослідження 1 встановлює заздалегідь (розділ 8.6), можна розглядати в порівнянні з цією вибіркою, беручи до уваги її зміщення вгору. Медіана вибірки з 60 завантажень знаходиться у передбаченому діапазоні 30–80. Коефіцієнт Джині уваги 0.75 знаходиться на нижньому краю передбаченого 0.75–0.90, що є напрямом, який передбачає упередженість вибірки, оскільки цензурований нижній хвіст стискає виміряну нерівність. Коефіцієнт медіани до середнього 0.27 нижче передбачуваної верхньої межі 0.5. Ніщо з цього не підтверджує перспективний дизайн, цінність якого полягає в спостереженні статей від розміщення на ймовірнісній вибірці; він записує, що смуги були встановлені правдоподібно.
Декларації
Доступність даних. Кожен синтезований якір, відтворений тут, можна простежити до опублікованих джерел, наведених у тексті та таблицях, з рамками вибірки та статусом перевірки, зазначеними в місці використання, та немає нового набору даних, репрезентативного для населення, котрий лежить в основі претензій еталона статті. Єдиний оригінальний набір даних, створений для цієї статті, — це незалежний архівний поперечний переріз додатка E, випадкова всепольова вибірка з 1,360 статей, лічильники яких до припинення роботи були відновлені з публічних архівів, випущена як appendixE-wayback-downloads.csv (набір даних додатка E, а не перспективне Дослідження 1) з кодом аналізу, тому процедуру можна повторити та розширити; він підтверджує форму розподілу та не є репрезентативним для платформи еталоном. Набір даних розміщений за адресою https://doi.org/10.5281/zenodo.22285871 під ліцензією CC BY 4.0, де той самий файл має назву study1-wayback-downloads.csv, і він поставляється з відкритим інструментом, який читає кількість завантажень на його основі залежно від віку статті та галузі, за адресою https://github.com/vadimchernets/ssrn-benchmark (ліцензія MIT, тільки стандартна бібліотека Python). Читачі, які хочуть розмістити свій лічильник у цьому еталонному класі, можуть запустити цей інструмент, а не перебудовувати аналіз. Матеріали для програми, готової до попередної реєстрації, розділу 8, включаючи словник змінних панелі (додаток C, таблиця C1) та інвентар запитів пошукового аудиту, підготовлені до розміщення при попередній реєстрації (розділ 8.8); внески в реєстр дотримуються підмножини схеми, визначеної в розділі 8.8, та будь-який випуск перцентилю з програми еталона публікується відповідно до специфікації прозорості додатка D. Шаблон звітування CSAB додатка B може бути вільно повторно використаний, з урахуванням його правила порожніх перцентилів. 24 серпня 2026 року формальний запит був поданий до служби підтримки SSRN (квиток 260824-003051) щодо сукупного еталонного класу, який передбачали припинені Рейтинги — медіана, інтерквартильний розмах та смуги децилів завантажень, розшаровані по галузі та віку статті, без ідентифікаторів для кожної статті; його результат (схвалення, відмова або відсутність відповіді) буде повідомлено в подальшому перегляді.
Відкритий доступ до цієї статті. Відкрито ліцензована копія цієї рукописи розміщена за адресою https://doi.org/10.5281/zenodo.22166896 (CC BY 4.0), де повний текст можна отримати безпосередньо та без обмежень доступу. Депозит надається, оскільки канонічний запис на SSRN подається за спеціальним захистом від ботів, яке відхиляє клієнтів без рушія JavaScript, умова, задокументована в розділі 4.2; читачі, менеджери посилань та автоматизовані клієнти, які не можуть отримати доступ до канонічної копії, можуть отримати той же текст з депозиту. Супровідні статті розміщені на тих же умовах за адресами https://doi.org/10.5281/zenodo.22166995 та https://doi.org/10.5281/zenodo.22168724.
Доступність коду. Код для збору та аналізу даних для незалежного архівного зрізу додатку E випущено разом з його набором даних за адресою https://github.com/vadimchernets/ssrn-benchmark, тому процедуру можна відтворити, а референтний клас можна перевивести з вихідних лічильників. Стаття в іншому випадку не повідомляє про результати, які вимагають коду аналізу; шаблони генерування рисунків для емпіричних проектів розділу 8 будуть випущені як онлайн-додаток, що супроводжує матеріали попередньої реєстрації.
Етика. Емпіричні проекти розділу 8 спираються на публічно відображені лічильники на рівні статей та бібліографічні метадані; збір будь-якої непублічної інформації панелі інструментів, дат статусу розповсюдження або електронних повідомлень вимагає інформованої згоди та, де це застосовується, інституційного огляду (див. розділ 9). Два проекти, які становлять дослідження з участю людей, Дослідження 4 (опитування авторів) та Дослідження 3 (інструментований постинг зі журналюванням вхідної скриньки), будуть передані на затвердження комісії інституційного огляду або дослідницького комітету з етики та проводитимуться з інформованою згодою учасників перед тим, як почнеться будь-який збір даних. Набори даних повідомлень агреговані та дезідентифіковані перед будь-яким повідомленням, а постинги спільноти цитуються лише там, де існує живе, перевіряєме джерело, з перефразуванням там, де авторів можна було б ідентифікувати всупереч їхнім очікуванням. Збір даних обмежується засобами, дозволеними умовами обслуговування платформ: проекти використовують публічно відображені лічильники та бібліографічні метадані й не застосовують скрейпінг, який би порушив умови використання платформи, і будь-який проект, що вимагає масових або непублічних даних, здійснюється через офіційний запит даних та юридичний огляд, а не через автоматичне вилучення. Цитування напівпублічного змісту форуму враховує згоду учасника та ризик переідентифікації, що є причиною перефразування такого матеріалу, а не його дослівного відтворення там, де автора можна було б ідентифікувати всупереч його очікуванням. Стаття не позначає конкретний журнал або видавця як «хижацький»; відбір майданчиків застосовує перевірені, прозорі критерії, які зберігають будь-яку класифікацію обґрунтованою та уникають наклепу.
Подяки. Автор дякує Stefanie Haustein за критичні коментарі, надіслані електронною поштою в серпні 2026 року, які привели до редакцій розділу 4.2, та Vincent Larivière, чиєї запитання у кореспонденції — який один норматив автор повинен наполягати в першу чергу, та його наполягання на даних, а не на аргументах — спонукали архівний зріз, про який повідомляється в додатку E.
Конкуруючі інтереси. Автор є розробником методів багатомодельної оркестрації, обговорюваних у розділі 8.10, які є відкритими та відтворюваними, інтерес, який читачі мають взважити. Автор є названим заявником у відкладених патентних заявках, але не виданих патентах, що стосуються систем оркестрації AI та мультимодельної валідації такого виду, як обговорюється в цьому розділі. Конструкція доставки оркестраційного шару, запропонована в розділі 8.10, є концептуальною специфікацією, на якій не ґрунтуються жодні висновки статті. Розділ 8.10 можна повністю видалити, не змінюючи жодного діагнозу, результату або рекомендації в іншому місці статті.
Інструменти та верифікація. Асистенти AI були використані як інструменти під керівництвом автора; ідеї, дослідження та висновки належать авторові. Усі кількісні твердження та цитування були перевірені автором за їхніми первинними джерелами або архівованими копіями; автор несе виключну відповідальність за зміст.
Посилання
Джерела, цитовані в тексті як [B-n] (сторінки платформ, гілки форумів, записи в блогах та інші допоміжні матеріали), перелічені окремо нижче в розділі «Додаткові джерела». Сторінки платформ з датою доступу нестійкі й мають бути повторно перевірені за архівованими копіями.
[1] AALL / ALL-SIS (2024, June 14). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, May 28). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; survey fielded May 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, November 16). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). Хижацькі видавці псують вільний доступ. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). Calling Bullshit: The Art of Skepticism in a Data-Driven World. Random House.
[16] Bessembinder, H. (2018). Чи перевищують акції казначейські цінні папери? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). Вільний доступ проти журналів за передплатою: порівняння наукового впливу. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). Рейтинг юридичних шкіл: використання SSRN для вимірювання наукових досягнень. Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). Коефіцієнт впливу використання: вплив характеристик вибірки на метрики впливу, засновані на використанні. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). Чи вказують альтметрики на ширший вплив досліджень? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). Як нормалізувати кількості твітів? Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). Використання перцентилів і класів рангів перцентилів у аналізі бібліометричних даних: можливості та обмеження. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). Нормалізація даних зі нульовою інфляцією: емпіричний аналіз нової сім'ї показників та їх використання з альтметричними даними. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). Десять простих правил щодо подання препринту. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). Раніша статистика використання Веб як предиктори пізнішого впливу цитування. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). Роль електронних препринтів у хімічній комунікації: аналіз цитування, використання та прийняття у журнальній літературі. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). Оцінка впливу планомірної соціальної зміни. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). Затори на інформаційній магістралі: неефективність у економічних робочих документах. Journal of Public Economics, 225, 104978 (also NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). Пом'якшення агресивного трафіку краулера в епоху генеративного AI: спільний підхід Бібліотек Університету Північної Кароліни в Чапел-Гіллі. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). Польові онлайн-експерименти. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). Завантаження проти цитувань в економіці: взаємозв'язки, сприяючі чинники та далі. In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informetrics), Madrid.
[32] Cobey, K. D., et al. (2019). Знання та мотивації дослідників, які публікуються у передбачуваних хижацьких журналах. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). "Showcase Your Scholarship, Part Three: Self-Publishing". https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). "Social Science Research Network (SSRN) Ending Commercial Products". https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. Документація REST API. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. Документація Similarity Check. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). Видання з вільним доступом, завантаження статей та цитування: рандомізоване контрольне випробування. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). Чи arXiv призводить до більш високих цитувань та зменшеного завантаження для математичних статей? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). Переглядання зв'язку між завантаженнями та цитуваннями: перспектива від статей з різними моделями цитування на прикладі журналу Lancet. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). Перевага вільного доступу для американських юридичних оглядів. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). Вплив фінансування на цитування та соціальну увагу: Цілі сталого розвитку ООН (ЦСР) як приклад дослідження. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). "How many reads does a typical academic article get?" https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Покращення фактичності та міркування в мовних моделях через багатоагентні дебати. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). Соціальні порівняння та обман у ієрархіях робочого місця: польові та експериментальні докази. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (circulated since 2009)
[45] Eisenberg, T. (2006). Оцінка рейтингів юридичних шкіл на основі SSRN. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). "Elsevier Acquires the Social Science Research Network (SSRN)…". PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (also LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. "SSRN Research Paper Series Sunset — DC Options". https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. "SSRN First Look" (сторінка продукту). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. "SSRN for Authors and Researchers" (сторінка продукту). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. "How can researchers gauge a paper's impact?" https://www.elsevier.support/ssrn/answer/gauge-impact (переглянуто 14.08.2026)
[51] Elsevier/SSRN Support. "What are RSS and Data Feeds on SSRN". https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. "What is SSRN?" https://www.elsevier.support/ssrn/answer/what-is-ssrn (переглянуто 14.08.2026)
[53] Elsevier/SSRN Support. Classification and distribution. https://www.elsevier.support/ssrn/answer/classification-distribution (переглянуто 14.08.2026)
[54] Elsevier/SSRN Support. Generative AI policy. https://www.elsevier.support/ssrn/answer/AI (переглянуто 14.08.2026)
[55] Elsevier/SSRN Support. Google / Google Scholar indexing. https://www.elsevier.support/ssrn/answer/google-scholar (переглянуто 14.08.2026)
[56] Elsevier/SSRN Support. Submission guidelines / Get started. https://www.elsevier.support/ssrn/answer/get-started (переглянуто 14.08.2026)
[57] Elsevier/SSRN Support. Subscriptions (eJournal mailings). https://www.elsevier.support/ssrn/answer/subscriptions ; також https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). Rankings and reactivity: How public measures recreate social worlds. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). Citation Advantage of Open Access Articles. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). Matthew effects in science and the serial diffusion of ideas. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). Identifying academic spam and recommendations for dealing with it: a literature review. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (опубліковано 8 травня 2026)
[62] Fraser, N., et al. (2020). The relationship between bioRxiv preprints, citations and altmetrics. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). Trust, but Verify: An Exploratory Audit of Predatory Journal and Publisher Solicitations. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). Impact of author characteristics on outcomes of single- versus double-blind peer review: a systematic review of comparative studies in scientific abstracts and publications. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv at 20. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. "SSRN and Download Statistics" (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; "Update on SSRN", https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). Problems of monetary management: The U.K. experience. У Papers in Monetary Economics, т. I. Sydney: Reserve Bank of Australia. Переопубліковано у C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (розд. 4). London: Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). The Digital Lawyer's Evolving Education in Scholarly Research. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). The Question of Data Integrity in Article-Level Metrics. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). Relationship between downloads and citations at journal and paper levels, and the influence of language. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). Positional effects on citation and readership in arXiv. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). Last but not least: Additional positional effects on citation and readership in arXiv. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). Characterizing social media metrics of scholarly papers. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). Tweets as impact indicators: Examining the implications of automated "bot" accounts on Twitter. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). Interpreting "altmetrics": viewing acts on social media through the lens of citation and social theories. У: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). Ranking the Academic Impact of 100 American Law Schools. Jurimetrics, 60(1), 1–39 (осінь 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). Bibliometrics: The Leiden Manifesto for research metrics. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). An index to quantify an individual's scientific research output. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). On the relationship between download and citation counts: An introduction of Granger-causality inference. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. Посібники: "Understanding the Similarity Report"; "Preprints". https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, 6 березня). AI search has a citation problem. Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). Чи може ШІ зменшити премію репутації в дифузії знань? Свідчення маркетингових робочих документів SSRN. Marketing Letters, 37, Article 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). Аналіз запитів від хижацьких журналів офтальмології. American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — джерело цифри "1813 emails"
[85] Kakushadze, Z. (2016). Індекс для завантажень SSRN. Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). Вплив відкритого доступу (AEA Conference 2014). https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). Скребки селективно дотримуються директив robots.txt: свідчення масштабного емпіричного дослідження. Праці конференції ACM Internet Measurement (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). Проблеми передбачення політики. American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). Спам у науковому видавництві: дослідження конкретного випадку. JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). Критичний погляд на ResearchGate Score як міру наукової репутації. Представлено на ASCW'15 (Кількісна оцінка та аналіз наукового спілкування в мережі), Конференція Web Science 2015, Оксфорд. http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (популярна версія: "The ResearchGate Score: a good example of a bad metric," LSE Impact Blog, 9 Dec 2015)
[91] Kurtz, M. J., et al. (2005). Бібліометричні властивості інформації про читання статей. JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). Бібліометрія використання. Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). Чи є реальною перевага відкритого доступу в цитуваннях? Систематичний огляд цитування статей відкритого доступу та передплачених статей. PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). Олігополія академічних видавців у цифрову епоху. PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. "Publishing Tips" (PDF). https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). Характеристики листів запитань від хижацьких журналів медсестринства та видавців. The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). Детектори GPT упереджені щодо неносіїв англійської мови. Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, 7 травня). Гостьовий пост — Love, Death & Robots: наукова версія. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. Про LogEc (методологія фільтрування трафіку). https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). Оптимізація видимості в генеративних двигунах: критичний огляд оптимізації генеративних двигунів (2023–2026). arXiv:2607.14035 (подано 15 липня 2026). https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, січня). "Maynooth University's School of Law and Criminology ranks first…". https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). Зв'язок між використанням та цитуванням у мега-журналі відкритого доступу. Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). Свідчення ефекту Матвія в Гарварді та Чикаго. Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). Ефект Матвія у науці. Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). Ефект Матвія у науці, II: Кумулятивна перевага та символіка інтелектуальної власності. Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. "Safe Links in Microsoft Defender for Office 365". https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ Microsoft Q&A щодо кліків у UrlClickEvents; + Suped щодо помилкових відкриттів)
[107] Milanovic, M. EJIL:Talk! "Academic Spam [UPDATED]". https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). Щодо розподілу завантажень повного тексту та цитування у наукових журналах. JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). Прикладна оціночна інформетрика. Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). Оцінювання науковців для найму, просування та виборності. PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). Престиж обумовлює епістемічну нерівність у поширенні наукових ідей. EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). Упередження соціального впливу: експеримент з рандомізацією. Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). Тиранія метрик. Princeton, NJ: Princeton University Press. ISBN 978-0-691-17495-2.
[114] Nature Neuroscience, Editorial (2008). https://www.nature.com/articles/nn0608-619
[115] Northwestern University LibGuides (оцінка дослідження/метрики). https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). Чи впливають блоги на завантаження SSRN? Емпіричне тестування ефектів Volokh та Slashdot. U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. "Get Published — Guide for Law Review Members". https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. "What is a good h-index?" https://paperpile.com/g/what-is-a-good-h-index/ (подібні посібники: Elsevier, Researcher.Life, Academia Insider)
[119] Perneger, T. V. (2004). Взаємозв'язок між онлайн "hit counts" та наступним цитуванням: проспективне дослідження робіт у BMJ. BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). Репутація та вплив у наукових кар'єрах. PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, June 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (archived copy at web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Published 30 June 2026 (Release 5.1 published 5 May 2023). https://www.countermetrics.org/ ; "Best Practice on AI Usage" (guidance for R5.1.1, updated 30 June 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "To what extent would you recommend or discourage publishing an academic working paper on SSRN…". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, August 10). Thread 15newc2 "Endless spam since I published a paper a few months ago". https://www.reddit.com/r/AskAcademia/comments/15newc2/ (confirmed via the pullpush.io archive)
[128] Remler, D. (2014, April 23). Are 90% of academic papers really never cited? Reviewing the literature on academic citations. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: "How RePEc counts views and downloads" (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; "AI issues in RePEc" (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; "RePEc in June 2026" (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, August). "Removing the RG Score". https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Experimental study of inequality and unpredictability in an artificial cultural market. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). The discipline of rankings: Tight coupling and organizational change. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Methods and metrics for cold-start recommendations. In Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. SSRN R package. https://github.com/enricoschumann/SSRN (also scrapers github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, June 3). The impact of AI bots and crawlers on open repositories: Results of a COAR survey, April 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). 'Predatory' open access: a longitudinal study of article volumes and market characteristics. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). The feasibility of developing and implementing journal usage factors: a research project sponsored by UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). How the scientific community reacts to newly submitted preprints. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Legal Research in Search of Attention: A Quantitative Assessment. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Working-paper version: "What Determines SSRN Downloads", SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Status, Quality, and Attention: What's in a (Missing) Name? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). Unexpected Emails to Submit Your Work: Spam or Legitimate Offers? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, April 13). eLibrary Stats announcement. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, June 5). What SSRN Means When We Talk About Data Integrity. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, December 16). 2025 Year in Review: How SSRN Enhanced Access to Preprints and Early-Stage Research. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, April 13). SSRN Strategic Update: Renewed Focus on Core Research Sharing Mission (post author: S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, June 4). SSRN's Ongoing Commitment to Legal Scholarship. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, June 12). SSRN to Sunset Rankings from July 1st 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, July 15). SSRN Ranking has sunsetted as of 15 July 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, July 20). SSRN will now allow you to choose the licence that's right for your work. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. Historical FAQ (PDF copy, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Subscription page. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Measuring Research: What Everyone Needs to Know. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). Чи зменшує подвійно сліпе експертне рецензування упередженість? Свідчення від провідної конференції з інформатики. JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (прізвище другого автора за Crossref: "Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). Хижацькі журнали та видавці: Характеристики та вплив академічного спаму на дослідників у освітніх науках. Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.): "SSRN e-Journal Rankings By Average Downloads Per Paper" (2018, травня), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; "SSRN Has Not Jumped the Shark" (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). Чи може штучний інтелект виявляти хижацькі журнали? Випадок журналів FT50. SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). 2025 Imperva Bad Bot Report. https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, лютого 4). "Is a journal interested in your preprint? Separating the wheat from the chaff in journal solicitations to submit". https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). Аналіз хижацьких листів у дослідників на початку кар'єри та спроби їх запобігання. Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library. LibGuide "SSRN Metrics" (оновлено 29 вересня 2025). https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ сторінка p=9061269 на eJournals)
[162] van de Rijt, A., et al. (2014). Польові експерименти динаміки «успіх породжує успіх». PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Center for Teaching / Office of Innovative Technologies) (2023). Рекомендації щодо виявлення штучного інтелекту та чому ми вимикаємо детектор ШІ Turnitin. Опубліковано 16 серпня 2023. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (доступ 15 серпня 2026).
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). Що цитується: Конкурентне GEO у рушіях відповідей AI. SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). Розширення журналу Drake з аграрного права: Зелений випуск. Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). Упередженість проти новизни у науці. Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, червня). Чи позбавляють боти AI культурну спадщину доступу до мережі? GLAM-E Lab (NYU Engelberg Center / University of Exeter). https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, травня 3). Е-журнали SSRN та завантаження. https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). Засоби для поліпшення розповсюдження, обговорення та завантаження… SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (опубліковано в U. Detroit Mercy Law Review)
[170] Wikipedia: "Social Science Research Network"; "List of academic journals by preprint policy"; "Preprint". https://en.wikipedia.org/wiki/Social_Science_Research_Network та відповідні сторінки.
[171] Willey, R., & Knapp, M. (2021). Як збільшити цитування юридичних досліджень. Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). Вплив SSRN на цитування юридичних досліджень та як його максимізувати. University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). Прилив метрик: Звіт незалежного огляду ролі метрик в оцінці та управлінні дослідженнями. HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). Нежадані звернення: визначення характеристик нежаданих листів від потенційно хижацьких журналів та роль бібліотекарів. Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016, вересня 21). "Which Legal Articles Generate the Most Attention on SSRN". https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). Чи надійно звіти про завантаження вимірюють використання журналів? College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). Користувачі, нарцисизм та контроль — відстеження впливу наукових публікацій у XXI столітті. SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). Доступи до статей: зв'язки з цитуванням, ефекти вихідних та сезонність. Scientometrics (опубліковано 23.07.2026). DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). Популярність на Mendeley як фільтруючий інструмент для визначення високоцитованих публікацій. Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). Нерівність уваги в соціальних медіа. arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). Кількісна оцінка еволюції індивідуального наукового впливу. Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). Універсальність розподілу цитувань: На шляху до об'єктивної міри наукового впливу. PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). Угода про реформування оцінювання досліджень. Coalition for Advancing Research Assessment. https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). Використання припливу метрик: Індикатори, інфраструктури та пріоритети для відповідального оцінювання досліджень у Великобританії. Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). Стандартизована, відповідна COUNTER, статистика використання для репозиторіїв. https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024). Резюме для досліджень та інновацій (R4RI): керівництво. https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton. Інструмент для розробки політики. https://www.overton.io
[188] CC-PLUS. Консорціуми, що співпрацюють на платформі для статистики використання у бібліотеках (з відкритим кодом збір SUSHI/COUNTER-5; фінансується IMLS, PALCI та ін.). https://www.cc-plus.org/
[189] HELIOS Open. Ініціатива керівництва вищої освіти за відкритою наукою. https://www.heliosopen.org/
Додаткові джерела
Додаткові джерела, цитовані в тексті як [B-n]: сторінки платформ, потоки форумів, дописи в блогах та інші матеріали, що підтримують конкретні моменти в тексті. Сторінки платформ нестабільні й мають бути перевірені проти архівних копій.
[B-1] Cabells Predatory Reports (активна служба скринінгу хижацьких журналів); Beall's List (лише архівована; не оновлювалась з січня 2017).
[B-2] Caron, P. TaxProf Blog (2026, January 25). "The SSRN Top Five New Tax Papers Ranking Is Broken". https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors (EJMR), потоки обговорення щодо завантажень SSRN та рейтингів авторів (напр., /topic/ssrn-downloads-and-views; /topic/top-10-of-authors-on-ssrn-by-downloads). Анонімний форум; цитується лише як доказ існування таких обговорень.
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, тема 1seeyq3 (6 Apr 2026, "I've uploaded a working paper to SSRN… honest advice"); Reddit r/academia, тема 13w6zjw (31 May 2023, "SSRN Approval Time is Absurd"). Існування підтверджено архівами Reddit третіх осіб.
[B-6] SSRN — шаблонні оголошення (напр., https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/) та оголошення з квітня 2018 (04132018ann002). Сторінки платформи; перевіряйте проти архівних копій. Архівна копія: https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/ (снімок 29 грудня 2025; доступно 15 серпня 2026).
[B-7] SSRN FAQ — версіонування та ORCID. https://www.ssrn.com/index.cfm/en/faq/ (доступно 2026; перевіряйте проти архівної копії).
[B-8] SSRN — цільова сторінка "SSRN has Sunset Rankings". https://www.ssrn.com/ssrn/rankings-sunset. Архівна копія: https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset (снімок 19 липня 2026; доступно 15 серпня 2026).
[B-9] SSRN — історичні сторінки рейтингів на hq.ssrn.com / papers.ssrn.com/topten: Top 10,000 Papers (TRN_gID=10), Top 30,000 Authors (TRN_gID=7), Top 3,000 Law Authors, Top 350 U.S. Law Schools, Top 500 International Law Schools, Eigenfactor, Recent Top Papers (60 днів), "Ranking Data Explained" (ranking_data_explain.cfm?id=6 / id=10). Історичні сторінки; з 15 липня 2026 ці URL-адреси повертають відповіді 403/placeholder — цитуйте через архівні копії. Архівна копія сторінки Top 10,000 Papers: https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10 (снімок 14 липня 2026, день перед припиненням; доступно 15 серпня 2026).
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints (year-long observation: 875 invitations from 256 journals, 76% from blocklists). DOI 10.1080/10875301.2025.2550600; ResearchGate publication 384286174.
[B-11] Caron, P. TaxProf Blog (2026, June 7). "SSRN Has Not Jumped the Shark". https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/ (відповідь на Bainbridge [12]; доступно вересня 2026).
Кореспонденція: [email protected].↩︎
Як цитувати
Chernets, V. (2026). What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}