Fracamente Discriminativa, Não Reparada por Injeção de Perfil e Manipulável: Autoconfiança na Avaliação de LLM
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Vadym Chernets, Pesquisador Independente · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
Aceito como um pôster no workshop NeurIPS 2026 "TAE (Trust-AI-Eval): Can We Trust AI Evaluation?" (não arquivado). Cópia arquivada: 10.5281/zenodo.23197651. PDF: self-confidence-evaluation.pdf. Figuras e tabelas abaixo são convertidas da fonte LaTeX; o PDF é a versão de referência.
Resumo
Os pipelines de avaliação consomem cada vez mais a confiança declarada por um modelo como um sinal de confiança—como um peso de confiabilidade, um gatilho de abstenção ou um perfil de competência autorrelatado. Testamos se esse sinal merece o peso, usando uma coleção pré-registrada com protocolo congelado (16 modelos—um modelo de API de baixo custo/nível médio de cada um dos nove provedores, mais sete modelos locais de pesos abertos; 22.248 respostas avaliadas à temperatura zero com confiança declarada de 0–100). Quatro achados. (1) O excesso de confiança é consistente em todos os dezesseis modelos avaliados: a confiança declarada típica situa-se em 85–95 para sete dos nove modelos de API, enquanto a precisão varia de 16,5–66,5%, e 60,1% das respostas de ponta declaradas com confiança 80 estão erradas. (2) A autoconfiança é fracamente discriminativa: seu AUROC para prever a correção do próprio modelo varia de 0,532–0,788 e situa-se abaixo de 0,62 para seis dos nove modelos. (3) Um painel de modelos independentes atinge um AUROC de 0,832, enquanto a autoavaliação fornece 0,545 ( , IC 95% ); sob uma recodificação mais rigorosa sem rótulos de concordância do painel, o painel ainda lidera (0,775 vs. 0,545). (4) Injetar o perfil de precisão medido por domínio do próprio modelo não melhorou demonstravelmente a discriminação no único degrau confirmativo de uma escada controlada por placebo de um único fornecedor (AUROC , com ajuste de Holm ), enquanto o mesmo canal de injeção é causalmente manipulável: um perfil falso levou o AUROC de autoavaliação de um degrau exploratório ao nível de acaso (0,474) e, uma vez que os itens são rotulados por tópico, degradou a calibração em quatro de cinco modelos locais. Concluímos que a confiança autoavaliada, conforme atualmente elicitada e medida aqui em confiança inteira verbalizada em recall factual de forma aberta, é um alvo para medição, não uma entrada para confiabilidade: sistemas que consomem competência autorrelatada herdam um canal de entrada não autenticado. As três cláusulas do título repousam em evidências diferentes e as rotulamos como tal em todo o documento: fracamente discriminativa é confirmativa em dezesseis modelos; não reparada por injeção de perfil é um degrau confirmativo em uma família de fornecedor, com poder insuficiente para o efeito observado; manipulável é exploratória, com a direção causal mostrada em itens correspondentes, mas nenhum ataque testado em um sistema implantado. Autoavaliação no estilo de juiz, onde um modelo avalia a resposta de outro modelo, é uma tarefa diferente e não é testada aqui.
Introdução
A prática moderna de avaliação trata silenciosamente a confiança declarada de um modelo como um instrumento de medição: juízes LLM relatam pontuações de certeza, estruturas de agente roteiam com base na competência auto-avaliada, políticas de abstenção são acionadas pela incerteza verbalizada, e benchmarks de calibração assumem que o canal de auto-relato é pelo menos honesto. A suposição é conveniente—auto-relatos são gratuitos, sempre disponíveis e produzidos na mesma passagem que a resposta—e quase nunca são auditados no ponto de consumo. Fazemos a pergunta anterior: quão discriminativo é o sinal de auto-avaliação, pode ser reparado com o perfil medido do próprio modelo, e pode ser manipulado?
Respondemos com uma coleta pré-registrada, protocolo congelado, cega: dezesseis modelos (um modelo de API de orçamento/nível intermediário de cada um dos nove provedores, mais sete modelos abertos locais), 1.500 questões factuais pós-2023 cada, temperatura zero, cada resposta acompanhada por uma confiança declarada de 0–100—22.248 respostas classificadas, toda análise determinística a partir do bruto. Contra este padrão de medição, o canal de auto-relato falha em três testes sucessivamente mais benevolentes.
C1 (fracamente discriminativo). A confiança declarada é saturada e desacoplada da competência: as medianas por modelo ficam em 85–95 para sete de nove modelos de API enquanto a precisão varia de 16,5–66,5%, e 60,1% das respostas de fronteira declaradas com confiança 80 estão erradas. Como preditor da correção por item do próprio modelo, a autoconfiança atinge AUROC apenas 0,532–0,788 dependendo do modelo—todo IC de bootstrap exclui o acaso, mas seis de nove modelos ficam abaixo de 0,62, e previsão seletiva mesmo do melhor deles deixa erro residual substancial (Seção 4). Um painel de modelos independentes atinge 0,832 onde a auto-avaliação dá 0,545—uma vantagem que sobrevive a uma recodificação mais rigorosa livre de rótulos do acordo de painel—enquanto o contraexemplo aparente no outro painel reflete amplamente identidade entre modelos em vez de auto-conhecimento por item (decomposição na Seção 4); identificar o único modelo cujo auto-relato discrimina bem ainda requer a medição independente que o auto-relato deveria substituir.
C2 (nenhum reparo confirmatório da injeção de perfil). O reparo mais direto—fornecer ao modelo seu próprio perfil de precisão medido por domínio no momento da resposta—não superou significativamente um perfil placebo no único degrau confirmatório de um experimento de escada congelado e controlado por placebo (AUROC , bruto , ajustado por Holm ; nenhum ponto final confirmatório passou). Relatamos isso como nulo, não como uma tendência (Seção 5).
C3 (manipulável). O canal de injeção que um reparo usaria aceita falsificações: um perfil embaralhado (falso) levou o AUROC de auto-avaliação de um degrau de fronteira exploratória ao nível de acaso (0,474 vs. 0,710; queda ), uma única alegação fabricada de "precisão de 95%" moveu a confiança declarada de um modelo local de 50 para 95 em um item que erra, e uma vez que os itens são rotulados por tópico, quatro de cinco modelos locais consomem um perfil falso em seu detrimento (Brier para ; Seção 6).
Em conjunto, esses resultados argumentam por uma mudança de papel: a confiança auto-avaliada deve ser um alvo medido de avaliação, não uma entrada não auditada para ela. A Seção 7 detalha as consequências para pipelines de juízes, roteamento de agentes e design de arnês; o artigo complementar (Chernets, 2026) examina os modos de falha da alternativa baseada em painel e é citado, não reafirmado, aqui.
Trabalho relacionado
Confiança verbalizada e calibração. A má calibração de redes modernas é um achado duradouro (Guo et al., 2017), e para modelos de linguagem ajustados para QA a calibração mostrou-se inadequada bem antes da geração atual de modelos (Jiang et al., 2021). Modelos podem ser ensinados a expressar incerteza em palavras (Lin et al., 2022b) e modelos maiores parcialmente "sabem o que sabem" em sondas de auto-avaliação (Kadavath et al., 2022), ainda que falhem amplamente em reconhecer o que não sabem (Yin et al., 2023); auditorias empíricas de confiança eliciada encontram superconfiança persistente em todos os formatos de elicitação (Xiong et al., 2024), com escores verbalizados às vezes melhor calibrados que probabilidades de tokens, mas ainda inflacionados (Tian et al., 2023). A investigação de estado interno esclarece o quadro: classificadores simples sobre ativações de camadas ocultas recuperam veracidade em 71–83% (Azaria e Mitchell, 2023)—a falha reside no canal de saída verbalizado, não necessariamente nas representações internas. Nossa contribuição é escala e design: uma coleta cega de 16 modelos pré-registrada e congelada, pontuando a mesma elicitação contra a verdade estabelecida e contra o acordo de painéis independentes em itens idênticos—além de duas questões que esta literatura raramente faz: o sinal pode ser reparado com o perfil medido do próprio modelo, e o canal de reparo pode ser atacado?
Consumo de auto-relatos a jusante. Pipelines LLM-como-juiz herdam vieses de juiz e limites de confiabilidade (Zheng et al., 2023), e sinais de confiança baseados em acordo estão eles próprios sob auditoria (Ding, 2026); detectores de entropia semântica (Farquhar et al., 2024) contornam auto-relatos ao medir distribuições de respostas em vez disso. Estruturas de avaliação de terceiros fazem o caso de governança para medição independente (Raji et al., 2022); fornecemos um piso quantitativo: para seis dos nove modelos de API o auto-relato que um pipeline consumiria tem AUROC abaixo de 0,62.
Entradas não confiáveis. A injeção indireta de prompt mostra que qualquer canal de texto que um LLM ingere é uma superfície de ataque (Greshake et al., 2023). A Seção 6 localiza uma instância específica, até agora não nomeada: o slot de perfil de auto-competência que reparos de calibração usariam é um canal de entrada não autenticado, e falsificá-lo degrada a discriminação ao nível do acaso.
Painéis e suas próprias falhas. Painéis de modelos diversos são um instrumento de avaliação cada vez mais padrão (Verga et al., 2024). O sinal de painel que usamos como comparador não é almoço grátis: seus regimes de falha (inversão de dificuldade, espaços de resposta restritos, suposições de independência baseadas em rótulos, conformidade) são medidos em uma submissão complementar (Chernets, 2026) na mesma coleta bruta; este trabalho é dono da história de auto-avaliação, o complementar é dono da história do painel, e nenhuma tabela é duplicada entre eles.
Benchmarks. Elicitamos em um subconjunto SimpleQA pós-2023 (Wei et al., 2024) precisamente por causa da lacuna de idade do benchmark que medimos contra TruthfulQA de 2021 (Lin et al., 2022a) (Seção 3).
Experimento pré-registrado: design e dados
Uma coleta pré-registrada e cega, protocolo congelado publicamente antes dos dados confirmatórios: dezesseis modelos (um modelo de API de orçamento/mid-tier por provedor em nove provedores, mais sete de pesos abertos locais) responderam às mesmas 1,500 questões factuais pós-2023 (subconjunto SimpleQA) com temperatura zero, cada resposta acompanhada de uma confiança declarada de 0–100; 22,248 respostas classificadas no total (13,446 fronteira, 8,802 locais).
Pré-registro e congelamento.
O protocolo de coleta foi congelado em um registro público antes de qualquer dado confirmatório existir (rota de acesso no apêndice de reprodutibilidade). O registro pré-especifica o benchmark e subamostra (n aleatório , seed fixa, SHA-256 do arquivo de subamostra registrado), o elenco de modelos, o formato de elicitação, o procedimento de classificação, o plano de análise—incluindo a comparação AUROC de concordância do painel vs. confiança própria usada na Seção 4, uma métrica secundária pré-especificada (o endpoint primário do registro, a taxa de sinalizador de erro confiante de discordância do painel, é uma quantidade do lado do painel relatada na submissão complementar)—e uma regra de decisão contra a seleção de métrica post-hoc. Um pequeno piloto exploratório (95 itens TruthfulQA, três modelos locais) foi executado antes do congelamento para validar o pipeline; seus dados nunca são misturados com dados confirmatórios.
Modelos e elicitação.
Nove provedores de fronteira por meio de suas APIs—um modelo de API de orçamento/mid-tier por provedor, portanto os nomes dos provedores abaixo rotulam modelos únicos, não linhas de produtos (IDs de modelo exatos e datas de coleta no apêndice de reprodutibilidade)—e sete modelos de pesos abertos locais. Cada modelo responde a cada item independentemente na temperatura 0 e declara uma confiança inteira de 0–100 na mesma resposta; painéis são combinações analíticas desta coleta cega única—nenhum modelo nunca vê a saída de outro modelo.
Classificação.
Equivalência de string normalizada com ouro e detecção de recusa em primeiro lugar; casos abertos não resolvidos vão para um classificador LLM de pesos abertos locais restrito apenas à equivalência com ouro (qwen3:8b, local). Uma verificação pontual humana de 50 itens encontrou 98% de concordância (um erro conservador); uma auditoria de cruzamento entre famílias dos 342 veredictos de consenso mais difíceis concordaram 342/342 (Limitações). Sem exclusões exceto falhas de análise (relatado); elas se concentram em um modelo de raciocínio local, que retém apenas 98 respostas classificáveis de 1,500—todas as reivindicações de nível local carregam por modelo. Toda análise confirmatória é determinística do JSONL bruto.
Escolha de benchmark, medida.
O benchmark primário pós-2023 é uma decisão de design justificada por medição, não por suposição: em uma comparação exploratória de idade de benchmark, os mesmos modelos obtiveram a pontos percentuais mais altos em TruthfulQA MC de 2021 do que em SimpleQA pós-2023 (deepseek pp, IC 95% ; mistral ; zhipu ; por ex., 89,2% vs. 28,4%)—uma lacuna consistente com efeitos de idade de benchmark e exposição, embora este design não possa separar contaminação de dificuldade e diferenças de construção. Nenhum número de manchete repousa no benchmark mais antigo; o braço TruthfulQA MC1 de 750 itens no nível local é usado apenas quando explicitamente rotulado como tal.
Pré-registrado vs. exploratório.
Pré-registrado e confirmatório: a coleta acima e a comparação AUROC painel-vs-próprio (Seção 4). Exploratório, e rotulado como tal em todos os locais onde é usado: o braço de comparação de idade de benchmark, o degrau de injeção de perfil de fronteira e microprobe local da Seção 6. A escada de injeção de perfil da Seção 5 é um protocolo separado, congelado e controlado por placebo (braços, endpoints e família Holm fixos antes de sua fase confirmatória).
Resultado 1: autoconfiança é mal calibrada e fracamente discriminativa
Separamos duas propriedades que o termo "calibração" frequentemente confunde: calibração-em-larga-escala (o nível de confiança corresponde ao nível de precisão?) e discriminação (a confiança classifica as respostas corretas de um modelo acima de suas respostas incorretas?).
Calibração. A confiança declarada é saturada e desacoplada da competência: entre os nove modelos API, a confiança declarada fica em 85–95 (mediana por modelo) para sete de nove enquanto a precisão varia de 16.5–66.5%; dois se desviam—o modelo pesado em recusas (mediana 42 em 10.3% de precisão) e um modelo com confiança dispersa (mediana 60). Cada modelo é superconfiante em larga escala: o hiato confiança-menos-precisão (CITL, Tabela 1) varia de a pontos percentuais. A coluna ECE é quase igual a CITL: o hiato confiança–precisão é positivo em cada intervalo ocupado para sete de nove modelos (todos exceto um para os outros dois), portanto a descalibração agrupada e global coincidem. Até o modelo pesado em recusas mantém pp (ECE 0.310)—sua banda baixa reflete comportamento de recusa, não autoconhecimento calibrado. Parte de sua vantagem de discriminação pode igualmente ser mecânica—recusas classificadas como incorretas em confiança declarada baixa aumentam AUROC (excluindo linhas de recusa é 0.660, )—então lemos seu 0.788 como um limite superior no autoconhecimento eliciado, não uma classificação de calibração. Agrupado nos nove modelos API, 60.1% das respostas declaradas com confiança 80 estão incorretas (5,598 de 9,310); a taxa por modelo varia de 29.0–83.2% (média macro 57.6%). Um consumidor que confia em alta confiança declarada aceita a maioria dos erros. Discriminação. Como preditor da correção própria do modelo, a autoconfiança alcança AUROC 0.532–0.788 dependendo do modelo. Bootstrap 95% CIs (Tabela 1) excluem 0.5 para cada modelo, portanto o sinal não é literalmente aleatório—mas para seis de nove modelos fica abaixo de 0.62. A consequência é operacional: com cobertura de 20% (respondendo apenas ao quinto de itens com maior confiança), as taxas de erro dos três modelos com melhor auto-AUROC ainda são 75.3%, 33.3% e 15.1% (Tabela 2)—uma redução significativa apenas para o terceiro, e longe de um portão de confiança para os outros dois.
Uma alternativa arquitetônica—contando modelos independentes que concordam—atinge AUROC 0,832 (IC 95% ) no painel onde auto-avaliação produz 0,545 (); a diferença agrupada por item, , exclui zero por uma margem ampla. Os três painéis pré-especificados: US (Anthropic, OpenAI, Google), CN (DeepSeek, Alibaba, Moonshot), cross-bloc (Anthropic, DeepSeek, Mistral); a comparação principal é o painel CN. No outro painel pré-especificado, a comparação agrupada parece se inverter: auto-avaliação 0,842 agrupado sobre a população do painel vs. painel 0,697; . Uma decomposição mostra que essa inversão aparente reflete em grande medida a identidade entre modelos em vez do autoconhecimento por item: o valor agrupado 0,842 mistura três modelos cujos self-AUROCs dentro do modelo são apenas 0,596–0,784 (média macro 0,709; valores da população do painel—a Tabela 1 relata o conjunto completo classificado), e após normalização de ranking dentro do modelo (que remove diferenças de nível entre modelos enquanto preserva a própria classificação de cada modelo), o valor agrupado cai para 0,672—uma contribuição de identidade entre modelos de . O painel 0,545 passa na mesma verificação (0,545 agrupado vs. 0,582 normalizado por ranking): seu fracasso em auto-avaliação é genuinamente por item. O que sobrevive da inversão é uma declaração mais estreita: o modelo pesado em recusa com a discriminação de autoconfiança mais forte (0,788 no conjunto completo classificado) de fato supera o sinal de concordância deste painel—e identificar qual modelo é exige exatamente a medição independente que os auto-relatórios foram destinados a substituir. O terceiro painel pré-especificado (cross-bloc) fica entre os dois: painel 0,722 vs. próprio 0,659 , .
Sensibilidade à recodificação sem rótulo do sinal do painel.
A codificação de equivalência canônica por trás do sinal do painel consulta o rótulo de correção próprio do modelo primário (duas respostas ambas classificadas como corretas contam como concordando), então a concordância do painel é parcialmente uma função determinística do rótulo alvo—uma dependência mediada por rótulo, embora não vazamento de auto-voto: por construção, o próprio registro de um modelo nunca entra em seu próprio sinal de painel. Uma recodificação sem rótulo (apenas concordância de string; sinalizadores de correção nem do primário nem do painelista consultados) reduz o AUROC do painel de 0,832 para 0,775 no painel onde auto-avaliação fornece 0,545, e de 0,697 para 0,628 no outro; a vantagem principal do painel sobrevive à codificação mais rigorosa (0,775 vs. 0,545).
A Tabela 1 fornece a visão por modelo; a Figura 1 mostra o mesmo desacoplamento em todos os dezesseis modelos: todos os modelos estão acima da diagonal de calibração, e o nível local colapsa em uma faixa de 85–100 de confiança declarada em 9,2% de precisão.
| Modelo | Acur. (%) | Conf. média | CITL (pp) | Brier | ECE | Self-AUROC | IC 95% | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
Calibração por modelo na coleção confirmadora SimpleQA (nível de fronteira, conjunto totalmente classificado; nomes de provedores designam o modelo de orçamento/nível médio coletado por provedor). CITL: calibração em larga escala, confiança declarada média menos acurácia, em pontos percentuais. ECE: erro de calibração esperado em 10 compartimentos. Self-AUROC: confiança declarada como preditor da correção por item do próprio modelo (Mann–Whitney corrigido para empates), com IC de bootstrap 95% (reamostragem em nível de linha dentro do modelo, 2,000 sorteios, sementes fixas). Todos os valores são recomputações determinísticas de JSONL classificado bruto; cada IC exclui 0.5. CITL usa médias não arredondadas; valores exibidos são arredondados para uma casa decimal. {#tab:vendor}
| Taxa de erro na cobertura | |||||
|---|---|---|---|---|---|
| 2-6 Modelo | 100% | 80% | 60% | 40% | 20% |
| anthropic (self-AUROC 0.788) | 89.7% | 87.1% | 82.9% | 80,3% | 75,3% |
| xai (0,777) | 62,1% | 52,8% | 45,1% | 39,5% | 33,3% |
| google (0,746) | 33,5% | 24,5% | 20,0% | 18,7% | 15,1% |
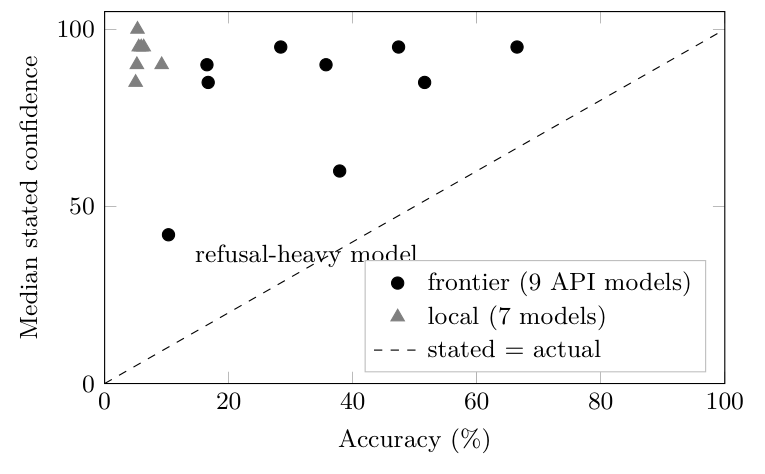 Confiança excessiva consistente em todos os dezesseis modelos avaliados: confiança mediana declarada por modelo (as médias aparecem na Tabela 1) versus precisão real para todos os 16 modelos nos mesmos 1.500 itens SimpleQA cecos. Todos os modelos estão acima da diagonal de calibração; o modelo fortemente recusador (confiança mediana declarada 42 em 10,3% de precisão, CITL +31,0 pp) apresenta o melhor auto-AUROC, 0,788, mas permanece excessivamente confiante; o menor gap de calibração pertence ao modelo de confiança dispersa (+11,1 pp). Medianas fronteiriças por modelo: 95/85/95/60/90/95/85/90/42 na ordem de linha da Tabela 1; o nível local de sete modelos abrange precisão de 5,0–9,2% em confiança mediana de 85–100 (n por modelo local: 98–1.498 após exclusão de falha de análise; o nível local serve as sondas de manipulação e esta figura, não alegações de discriminação).
Resultado 2: nenhuma melhora confirmatória na discriminação a partir da injeção de perfil medido
Uma reparação natural é fornecer ao modelo seu próprio perfil de competência medido—precisão por domínio a partir de dados retidos—no momento da resposta. Em um experimento de escada controlado por placebo (braços: sem perfil, perfil placebo pareado por nível geral, perfil medido próprio, perfil embaralhado), o braço de perfil próprio não superou significativamente o placebo no desfecho confirmatório: AUROC , IC 95% , p bruto , p ajustado por Holm ; nenhum desfecho confirmatório foi aprovado. Relatamos isso como um nulo com um escopo explicitamente estreito: em um degrau confirmatório, a discriminação não foi corrigida pela injeção de perfil medido. A estimativa pontual é positiva, mas sob a correção pré-registrada a reparação não é demonstrada; o desenho foi planejado apenas para efeitos moderados (EP do IC: 80% de poder apenas para AUROC , maior que o observado —então os dados são compatíveis com um nulo verdadeiro e um efeito verdadeiro pequeno). O teto do desenho não é o fator limitante. Tomando a precisão própria de bin de cada item—computada leave-one-out, de modo que um item nunca contribui para seu próprio preditor—como o único preditor da correção daquele item, produz um AUROC de oráculo de 0.758 para o assunto confirmatório (0.716–0.789 entre os quatro assuntos de escada), com spread DP de precisão por bin 0.195 e alcance 0.15–1.00 sobre os 21 bins. Os bins diferem o suficiente para que um perfil veraz carregue informações substanciais: o nulo diz respeito ao canal de injeção, não a uma bateria muito fraca para registrar um.1 Padrões exploratórios (ganhos maiores onde a calibração de linha de base é mais fraca) são apenas geradores de hipóteses.
Desenho de escada e validação de placebo.
Quatro degraus congelados (assuntos: Claude Haiku 4.5, Sonnet 5, Opus 4.8 e Fable 5; IDs exatos claude-haiku-4-5-20251001, claude-sonnet-5, claude-opus-4-8, claude-fable-5), cada um com quatro braços cegos ocupando o mesmo slot de calibração de um prompt idêntico: OFF (vazio estrutural em forma de perfil), PLACEBO (perfil irrelevante para calibração pareado por nível geral; validado por degrau contra o perfil verdadeiro em —ρ medidos = , , , ), CORE (próprio perfil medido por domínio do modelo), e EMBARALHADO (perfil falso com bins permutados; exploratório após uma verificação de manipulação que falhou e o rebaixou do status confirmatório). A bateria de 315 itens abrange 21 bins de domínio com itens armadilha e um token de abstenção explícito; as atribuições item-braço foram congeladas antes da fase confirmatória, com ordem de braço aleatorizada por item e sem nomes de braço no texto visível ao assunto. Um limite de degeneração pré-registrado (acurácia OFF ) rebaixou três dos quatro degraus de toda a computação confirmatória; a Tabela 3 relata o degrau elegível. A acurácia do braço OFF do degrau sobrevivente é 0.847 contra o limite de 0.85, enquanto os degraus rebaixados ficam em 0.855, 0.888 e 0.900—com AUROCs do braço OFF respondidos apenas de 0.575, 0.628 e 0.500 (descritivamente, precisão próxima ao teto deixa pouco sinal de calibração para reparar). Todos os quatro assuntos são extraídos de uma única família de fornecedores; veja Limitações.
| Braço | Acc. (todos os itens) | AUROC | Brier | ECE | Pareado AUROC (núcleobraço) |
|---|---|---|---|---|---|
| desativado (sem perfil) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| placebo | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| núcleo (perfil próprio) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| embaralhado (falso) | 0.842 | 0.589 | 0.140 | 0.113 | não calculado (exploratório) |
Escada de injeção de perfil, degrau elegível para confirmação (sujeito: Claude Sonnet 5; : 294 itens sem armadilha 2 replicatas pré-registradas de processo fresco—o aparelho não expõe nem temperatura nem semente; AUROC apenas respondido). Contrastes confirmatórios (bootstrap agrupado por item): coreplacebo AUROC , 95% IC , bruto ; coreoff , IC , bruto ; ambos falham na correção de Holm () e o item bidirecionalportão lote (um requisito de robustez pré-registrado agrupando por item e lote de coleção). A pareada- coluna repete os contrastes pareados agrupados por item da análise congelada contra core; eles não são a diferença aritmética da coluna AUROC por braço, e nenhum contraste pareado confirmatório foi computado para shuffled (rebaixado para exploratório antes da fase confirmatória). Observamos contra nossa própria hipótese que core não domina na calibração: seu ECE (0.099) é pior que placebo's (0.090), que é mais uma razão para ler o nulo confirmatório como um nulo. {#tab:ladder}
Resultado 3: o canal de autoimagem é manipulável
Se um harness de avaliação consome um perfil de autocompetência, esse slot é um canal de entrada, e as entradas podem ser falsificadas. Distinguimos três afirmações de força evidencial decrescente e indicamos qual cada resultado sustenta. (i) Manipulabilidade causal—demonstrada abaixo: substituir um perfil falso muda causalmente a confiança declarada e degrada a calibração em execuções controladas. (ii) Vulnerabilidade de integridade—condicional: importa apenas para harnesses que realmente injetam perfis de competência de uma fonte que um adversário pode influenciar. (iii) Superfície de ataque prática em pipelines de avaliação implantados—uma hipótese que este artigo motiva, mas não testa. Substituir o perfil verdadeiro por um aleatorizado (falso) levou o AUROC de autoavaliação de um nível de fronteira exploratória para o nível do acaso: 0.474 versus 0.710 com o perfil verdadeiro (nível de fronteira exploratória com teto rebaixado; bootstrap agrupado por item: 0.710 [0.586, 0.820] vs. 0.474 [0.349, 0.599], diferença [, ]). Para contraste, no nível elegível para confirmação SHUFFLED ficou entre PLACEBO e CORE (0.589 vs. 0.578 e 0.625; contraste pareado agrupado por item, exploratório: ). Esse nível é evidência fraca de manipulação por construção: o perfil falso falhou duas vezes na verificação pré-registrada (juiz externo 0.99/0.94 versus um limite ); a regra congelada rebaixou o braço antes de dados confirmatórios existirem, um sujeito pode descontar um perfil detectavelmente implausível, e nenhuma verificação consumida existe. Achado independente: um juiz de fronteira detecta falsificação apenas por plausibilidade. Em um estande local de custo zero, uma única afirmação fabricada ("95% de precisão neste domínio") elevou a confiança declarada de um modelo no mesmo item de 50 para 95; o efeito se concentra em modelos que têm calibração declarativa a perder; nesta sonda, o maior deslocamento ( pontos) ocorreu no modelo com mais a perder (glm4:9b). Duas condições de limite delimitam o efeito: o modelo deve ser capaz de associar o item atual a um bin de perfil (em itens não rotulados, pequenos modelos locais ignoram o perfil; deltas , consistente com o nulo congelado do Resultado 2), e modelos fixados no teto (confiança independentemente) não têm nada a atacar.
A evidência de manipulação—um nível de fronteira exploratória, uma microsonda local e uma passagem local rotulada por tópico—estabelece manipulabilidade causal, afirmação (i). Tabela 4 mostra a microsonda: o mesmo item, o mesmo modelo e uma mudança de uma linha no perfil autoinjetado movem a confiança declarada por até pontos.
Passagem exploratória rotulada por tópico: ambos os lados do limite, ao vivo.
A primeira condição de limite acima (o modelo deve ser capaz de associar o item a um bin de perfil) é em si testável: rotular cada sonda com seu tópico—um desvio revelado do protocolo congelado—remove o obstáculo de associação. Em uma passagem local completa (cinco modelos, 16 sondas retidas por braço, temperatura 0, semente fixa), o perfil falso que era inerte em itens não rotulados é consumido por quatro de cinco modelos uma vez que os itens são rotulados: Brier se degrada em (glm4:9b), (llama3.2:3b, com precisão caindo 37.5%25.0%), (mistral:7b) e (phi4-mini); CIs de bootstrap por sonda em incluem zero para cada modelo, então a microsonda estabelece direção e mecanismo em vez de tamanhos de efeito por modelo;
o quinto (qwen3:8b) atinge o teto na bateria (100% de precisão, confiança 100 em ambos os casos, ), reproduzindo a fronteira "nada para atacar". O mecanismo é direcional e simétrico: uma afirmação falsamente alta inflaciona a confiança exatamente no compartimento mais fraco (llama3.2 física: confiança declarada 0100 em um compartimento com 25% de precisão mantida; phi4-mini lógica 1365), e uma afirmação falsamente baixa desinfla a confiança em respostas corretas (llama3.2 história 1000 em 75% de precisão mantida), até induzir abstenção em itens que o modelo responderia de outra forma. Ambos os lados da fronteira são assim demonstrados por execuções ao vivo: itens não rotulados, perfil inerte (o nulo congelado); itens rotulados, a autoimagem forjada se propaga diretamente para a confiança declarada e degrada a calibração de ponta a ponta.
| Modelo | Conf. em "0%" | Conf. em "95%" | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
Microsonda local (exploratória): confiança declarada no mesmo item (respondido incorretamente) quando o slot de perfil injetado afirma "0% accuracy" versus "95% accuracy" no domínio do item; cinco modelos locais de pesos abertos, temperatura 0. O modelo fixado no teto (última linha) não possui calibração declarativa que possa ser atacada. {#tab:microprobe}
Implicações para a prática de avaliação
Nossos resultados são medidos em uma família de tarefas (QA factuais de forma aberta pós-2023) com um formato de elicitação; as implicações abaixo extrapolam dessas medições.
(1) Inverta o papel da confiança declarada. A confiança autorrelatada deve ser um alvo medido de avaliação, não uma entrada para ela na elicitação atual. Números de apoio: 60,1% das respostas de alta confiança da fronteira estão erradas, e o melhor self-AUROC (0,788) pertence ao modelo que um ranking de acurácia classificaria em último lugar—nenhum ranking prevê cujos autorrelatados discriminam.
(2) Pipelines de juiz herdam pesos fracamente discriminativos. Qualquer esquema LLM-as-judge ou ensemble que pondera votos por auto-certeza importa, para seis dos nove modelos aqui, um sinal com AUROC abaixo de 0.62—silenciosamente, porque a banda saturada de 85–95 parece tranquilizadora nos logs. Se a ponderação por certeza for usada, os pesos devem vir de calibração medida por modelo, não do próprio relatório.
(3) Autentique o slot de perfil. O modelo de ameaça de três níveis da Seção 6 ordena a preocupação: a manipulabilidade causal é demonstrada, a vulnerabilidade de integridade é condicional a que um arnês injete realmente perfis de uma fonte influenciável, e uma superfície de ataque prática em pipelines implantados permanece uma hipótese. Para arneses na classe condicional, o canal de reparo é a exposição: o mesmo perfil injetado que deveria corrigir a calibração aceita falsificações que empurram a discriminação para o nível de acaso (0.474) e degradam os Brier scores de ponta a ponta uma vez que os itens são associáveis. Tal arnês precisa de uma porta de integridade—perfis assinados, verificações de proveniência, ou no mínimo separar quem mede o perfil de quem o fornece no tempo de inferência. Um slot de auto-imagem não autenticado é uma porta aberta de injeção de prompt com uma carga útil de calibração.
(4) Medição externa é a alternativa—com sua própria auditoria. O acordo do painel independente domina a autoavaliação onde a autoavaliação falha pior (AUROC ), mas painéis têm seus próprios regimes de falha medidos, examinados no artigo complementar (Chernets, 2026); adotar o sinal do painel sem essa auditoria repetiria o mesmo erro um nível acima. Uma extensão pré-registrada como exploratória adiciona um terceiro ângulo: em 12 pares de troca de perfil direcionados (3,780 chamadas), substituir o perfil medido de outro modelo deslocou AUROC por no máximo —e ocasionalmente ajudou—enquanto a predição de ranque de similaridade de perda de transferência falhou (Spearman ): perfis medidos são instrumentos portáteis, não acesso privilegiado próprio. Uma bateria de diagnóstico de autoavaliação prática é descrita no apêndice.
Limitações
Uma única família de benchmark para o destaque (QA factual em formulário aberto pós-2023); cada provedor é representado por um modelo orçamentário/de nível médio, portanto não se afirma a generalização em nível de provedor; a elicitação de confiança declarada é um formato de prompt para os números de destaque—embora um braço exploratório de dois estágios (150 itens cinco modelos locais) sugira que o formato não é o culpado: uma consulta de confiança pós-hoc sem estado reduziu a confiança declarada e as taxas de erro confiante, mas não a discriminação (self-AUROC 0.43–0.61 em ambos os formatos; bootstrap pareado agrupado AUROC em pares, rótulos determinísticos sem-LLM em 142–150 linhas por modelo—um desvio rotulado do classificador apenas de string, sob o qual 90% dos casos são irresolvíveis); o nulo de injeção é um degrau confirmador de uma escada (315 itens, 21 caixas), todos os quatro sujeitos de uma única família de fornecedor, e não descarta designs de reparo melhores; a evidência de manipulação combina um degrau de fronteira exploratório, uma microsonda local e um passe local com rótulo de tópico (um desvio divulgado)—não um estudo de ataque confirmatório; a classificação é parcialmente baseada em LLM e sua validação humana é uma verificação pontual de 50 itens (98% de concordância, um erro conservador). A família de fornecedor do classificador também dispõe de um membro CN-panel, portanto a independência do classificador é por si só medida: um segundo classificador de uma família fora de todos os painéis e o próprio classificador reavaliaram todos os 342 veredictos de consenso do quintil mais duro e concordaram 342/342. O classificador é por si só um sujeito de nível local; uma reavaliação entre famílias de todas as 1.441 linhas auto-classificadas concordou com 98.3%, o desacordo tendendo para a indulgência própria (24 down-flips vs. 1 up; acurácia 5.94.4%)—fortalecendo a imagem de excesso de confiança; uma auditoria de re-estratificação mais completa permanece trabalho futuro. As comparações painel-vs-próprio compartilham dados com o envio complementar; nenhuma tabela é duplicada, o limite é declarado nas Seções 1–2, e o escopo deste artigo permanece apenas auto-avaliação.
Conclusão
Autoavaliação, tal como atualmente obtida, falha em três testes que um sinal de avaliação deve passar: ela rastreia a correção de forma muito fraca para controlar decisões, mas permanece severamente superconfiante, a intervenção de autoconhecimento mais direta não produziu reparação demonstrável sob controle de placebo, e seu canal de entrada aceita falsificações que empurram a discriminação para o nível do acaso. Até que os modelos ganhem calibração em evidência medida, a confiança declarada é um fenômeno a ser estudado, não um sinal a ser consumido.
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
Ferramenta prática: um diagnóstico de autoavaliação
Um subproduto deste estudo é um diagnóstico de autoavaliação compacto: um conjunto fixo de sondagens curtas e gradáveis de forma determinística abrangendo os domínios do estudo (numérico, lógica, física, história, código, probabilidade e outros), além de itens armadilha com um token de abstenção explícito. Cada resposta carrega uma confiança declarada de 0–100, e a ferramenta calcula um composto de pontuação de Brier, lacuna de sobreconfiança (confiança média menos precisão), discriminação de confiança (confiança média em respostas corretas menos respostas incorretas) e taxa de abstenção de armadilha, mapeando o resultado para níveis de bem calibrado a confiadamente cego. Operacionaliza a tese deste artigo—calibração é algo a medir sobre um modelo, não a extrair de seus autorrelatórios—e é liberado com o pacote de replicação como uma ferramenta, não como um resultado: usa sondagens parafraseadas em vez da bateria congelada, e sua pontuação de discriminação é um proxy, não o ponto final AUROC da escala.
Apêndice de Reprodutibilidade
Todos os números principais neste artigo são funções determinísticas do JSONL bruto liberado; nenhuma etapa envolve aleatoriedade, acesso à rede, computação em GPU ou consulta repetida a qualquer modelo.
Disponibilidade dos dados.
O pré-registro congelado e o pacote de replicação (registro OSF público): https://osf.io/4y9dv. O script oracle-ceiling oracle_auroc.py é depositado com este artigo em https://doi.org/10.5281/zenodo.23197651.
Prompt de elicitação (na íntegra).
Sistema: You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. O turno do usuário contém apenas a pergunta; as recusas são detectadas no campo de resposta pelo léxico de recusa congelado no script de avaliação.
Identificadores de modelo e datas de execução.
Um modelo de API de orçamento/nível intermediário por provedor, verificado ao vivo em 2026-07-24 e coletado no final de julho de 2026 (carimbos de tempo por chamada no manifesto de execução, lançado com o pacote de replicação): anthropic claude-haiku-4-5-20251001; openai gpt-5-mini; google gemini-3.6-flash; xai grok-4-fast; deepseek deepseek-chat; alibaba qwen-plus; moonshot kimi-k3 (um desvio de coleta divulgado: 670 de 1.500 itens na conta de primeira parte, o restante via uma rota de agregador atendida pela mesma infraestrutura de primeira parte com raciocínio desabilitado, served_by registrado por chamada; uma divisão de sensibilidade apenas de primeira parte foi pré-definida); zhipu glm-4.5; mistral mistral-small-latest. Nível local (Ollama, temperatura 0): gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b.
O artigo complementar (Chernets, 2026) compartilha o mesmo pré-registro congelado e coleta bruta. O pacote de replicação contém: o texto e protocolo de pré-registro congelado, o manifesto de execução com identificadores exatos do modelo, as coleções classificadas brutas (níveis de fronteira e locais, além do braço exploratório de comparação de idade de benchmark) e três scripts de CPU sem dependências. O primeiro (compute_panel_vs_own_auroc.py) é a definição canônica da comparação AUROC de concordância do painel versus confiança própria (Seção 4) e imprime, ao lado dos valores canônicos, todas as leituras alternativas não-canônicas (sinal de painel binário, codificação indeterminada, tratamento de empates, variantes de agregação) para que a escolha de leitura seja auditável. O segundo (analysis_tae_week1.py) reimprime a Tabela 1, as coordenadas da Figura 1, as lacunas de idade de benchmark da Seção 3 e realiza uma verificação somente de leitura dos valores de escada congelados relatados na Tabela 3 contra o arquivo de análise congelada da escada. O terceiro (analysis_tae_decomposition.py) reimprime a decomposição de AUROC agrupado e normalização de ranking da Seção 4, a recodificação sem rótulo do sinal do painel, as taxas de erro de alta confiança por modelo, as colunas CITL/Brier/ECE da Tabela 1, os valores de risco–cobertura da Tabela 2 e os descritivos de degrau rebaixado da Seção 5. Cada script é executado em segundos em um CPU do laptop com apenas a biblioteca padrão do Python. A escada de injeção de perfil é fornecida como seu próprio pacote congelado (protocolo, bateria, linhas pontuadas por braço e JSON de análise), referenciado a partir do pacote.
Calculado a partir das pontuações de braço por item congeladas (
scored-arms-*.jsonl; não-armadilha, statusok; para o sujeito confirmatório) pororacle_auroc.py, lançado com este artigo; todos os braços e replicatas de um item são excluídos juntos.↩︎
Como citar
Chernets, V. (2026). Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation [Apresentação de trabalho]. NeurIPS 2026 Workshop: TAE. Zenodo. https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}