Слабо дискриминативная, не исправляемая инъекцией профиля, и манипулируемая: самоуверенность при оценке LLM
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Vadym Chernets, Независимый исследователь · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
Принято в качестве постера на семинар NeurIPS 2026 "TAE (Trust-AI-Eval): Can We Trust AI Evaluation?" (не архивная). Архивная копия: 10.5281/zenodo.23197651. PDF: self-confidence-evaluation.pdf. Приведённые ниже рисунки и таблицы преобразованы из исходного кода LaTeX; PDF является авторитетным источником.
Аннотация
Конвейеры оценки всё чаще используют заявленную моделью уверенность в качестве сигнала доверия — в качестве веса надёжности судьи, триггера воздержания или самооценённого профиля компетенций. Мы тестируем, заслуживает ли этот сигнал такого веса, используя предварительно зарегистрированную, установленную протоколом коллекцию (16 моделей — одна бюджетная/среднеуровневая API-модель от каждого из девяти провайдеров, плюс семь локальных моделей с открытыми весами; 22 248 оценённых ответов при нулевой температуре с заявленной уверенностью 0–100). Четыре вывода. (1) Чрезмерная уверенность последовательна во всех шестнадцати оценённых моделях: типичная заявленная уверенность находится в диапазоне 85–95 для семи из девяти API-моделей, в то время как точность охватывает диапазон 16,5–66,5%, и 60,1% передовых ответов, заявленных с уверенностью 80, ошибочны. (2) Самоуверенность слабо дискриминативна: её AUROC для предсказания собственной корректности модели охватывает диапазон 0,532–0,788 и находится ниже 0,62 для шести из девяти моделей. (3) Панель независимых моделей достигает AUROC 0,832, где самооценка даёт 0,545 ( , 95% ДИ ); при более строгом кодировании без меток согласия панели панель по-прежнему лидирует (0,775 vs. 0,545). (4) Внедрение собственного измеренного профиля точности по доменам не продемонстрировало заметного улучшения дискриминации на единственной подтверждающей ступени лестницы с контролем плацебо для одного провайдера (AUROC , скорректировано по методу Холма ), в то время как один и тот же канал инъекции поддаётся причинной манипуляции: ложный профиль привёл самооценённый AUROC исследовательской ступени к уровню случая (0,474), и, когда элементы маркированы по темам, ухудшил калибровку в четырёх из пяти локальных моделей. Мы заключаем, что самооценённая уверенность, измеренная здесь при воспроизведении фактов в открытом формате с использованием целочисленной словесной оценки, является объектом для измерения, а не входным сигналом доверия: системы, потребляющие самооценённую компетенцию, наследуют неаутентифицированный входной канал. Три части названия основаны на различных доказательствах, и мы это отмечаем на протяжении всего текста: слабо дискриминативная подтверждается во всех шестнадцати моделях; не исправлена внедрением профиля — подтверждена на одной ступени для одного семейства провайдеров, статистически недостаточно мощная для наблюдаемого эффекта; манипулируемая является исследовательской, с причинной направленностью, продемонстрированной на парных элементах, но без проверенной атаки на развёрнутую систему. Самооценивание в стиле судьи, где модель оценивает ответ другой модели, — это другая задача и здесь не тестируется.
Введение
Современная практика оценивания молча рассматривает заявленную моделью уверенность как измерительный инструмент: судьи на основе ЛЛМ сообщают оценки достоверности, фреймворки агентов маршрутизируют на основе самооценённой компетентности, политики воздержания срабатывают на вербализованную неопределённость, а бенчмарки калибровки предполагают, что канал самоотчёта по крайней мере честен. Это предположение удобно — самоотчёты бесплатны, всегда доступны и генерируются в одном проходе с ответом — и почти никогда не проверяются в точке потребления. Мы задаём предыдущий вопрос: насколько дискриминативен сигнал самооценки, можно ли его исправить, используя собственный измеренный профиль модели, и можно ли его манипулировать?
Мы отвечаем на основе одного предварительно зарегистрированного, протоколом зафиксированного, слепого сбора: шестнадцать моделей (одна модель экономичного/среднего уровня API от каждого из девяти провайдеров, плюс семь локальных открытых весов), по 1,500 фактических вопросов после 2023, нулевая температура, каждый ответ сопровождается заявленной уверенностью 0–100—22,248 оцённых ответов, весь анализ детерминирован из сырых данных. Против этого стандарта измерения канал самоотчёта не проходит три последовательно более щадящих теста.
C1 (слабо дискриминативный). Заявленная уверенность перенасыщена и отделена от компетентности: медианы по моделям находятся на 85–95 для семи из девяти моделей API, в то время как точность находится в диапазоне 16.5–66.5%, и 60.1% ответов передовых моделей, заявленных с уверенностью 80, ошибочны. Как предиктор правильности модели по каждому пункту, самоуверенность достигает AUROC только 0.532–0.788 в зависимости от модели — каждый доверительный интервал бутстреп исключает случайность, но шесть из девяти моделей находятся ниже 0.62, и выборочное предсказание даже на лучшей из них оставляет существенную остаточную ошибку (раздел 4). Панель независимых моделей достигает 0.832, где самооценка даёт 0.545 — преимущество, которое выдерживает более строгое переконодирование согласия панели без меток — в то время как видимый контрпример на другой панели в основном отражает различия между моделями, а не знание о каждом пункте (разложение в разделе 4); определение единственной модели, чей самоотчёт хорошо дискриминирует, всё ещё требует независимого измерения, которое самоотчёт был предназначен заменить.
C2 (отсутствие подтверждённого исправления при инъекции профиля). Наиболее прямое исправление — предоставление модели её собственного измеренного профиля точности по доменам при ответе — не превосходило значимо профиль плацебо на единственной подтверждающей ступени лестничного эксперимента с замороженным протоколом и контролем плацебо (AUROC , сырой , скорректированный Хольмом ; ни один подтверждающий конечный пункт не прошёл). Мы сообщаем об этом как о нулевом результате, а не как о тренде (раздел 5).
C3 (манипулируемый). Канал инъекции, который исправление использовало бы, принимает подделки: перемешанный (ложный) профиль привёл самооценку AUROC ступени передовых моделей к уровню случайности (0.474 против 0.710; падение ), единственное сфабрикованное утверждение «95% точность» переместило заявленную уверенность локальной модели с 50 на 95 на пункте, в котором она ошибается, и когда пункты получают тематическую метку, четыре из пяти локальных моделей потребляют ложный профиль в ущерб себе (Brier до ; раздел 6).
В совокупности эти результаты свидетельствуют о необходимости изменения роли: самооценённая уверенность должна быть измеренной целью оценивания, а не неконтролируемым вводом в процесс. Раздел 7 излагает последствия для конвейеров судей, маршрутизации агентов и проектирования оценивающей системы; сопроводительный документ (Chernets, 2026) рассматривает режимы отказа альтернативы на основе панели и цитируется, а не переформулируется, здесь.
Связанные работы
Вербализованная уверенность и калибровка. Некорректная калибровка современных сетей — давно установленный факт (Guo et al., 2017), и для языковых моделей, настроенных для вопросно-ответных задач, недостатки калибровки выявлены задолго до текущего поколения моделей (Jiang et al., 2021). Модели можно обучить выражать неопределённость словами (Lin et al., 2022b), и более крупные модели частично «знают, что они знают» при зондировании самооценки (Kadavath et al., 2022), но в основном не способны распознать то, чего они не знают (Yin et al., 2023); эмпирические проверки извлечённой уверенности выявляют устойчивую переуверенность во всех форматах извлечения (Xiong et al., 2024), при этом вербализованные баллы иногда лучше откалиброваны, чем вероятности токенов, но по-прежнему завышены (Tian et al., 2023). Зондирование внутреннего состояния уточняет картину: простые классификаторы над активациями скрытых слоёв восстанавливают правдивость на уровне 71–83% (Azaria and Mitchell, 2023) — проблема находится в канале вербализованного вывода, а не обязательно во внутренних представлениях. Наш вклад — в масштабе и дизайне: предварительно зарегистрированная, зафиксированная слепая выборка из 16 моделей, оценивающая одно и то же извлечение в сравнении с истинными ответами и с согласием независимой панели на одинаковых элементах, плюс два вопроса, которые эта литература редко ставит: можно ли исправить сигнал, используя собственный измеренный профиль модели, и может ли канал исправления быть атакован?
Использование самоотчётов в последующих этапах. Конвейеры LLM-as-judge наследуют предвзятости судьи и ограничения надёжности (Zheng et al., 2023), и основанные на согласии сигналы уверенности сами находятся под проверкой (Ding, 2026); детекторы семантической энтропии (Farquhar et al., 2024) обходят самоотчёты, измеряя вместо этого распределения ответов. Структуры оценивания третьей стороной обосновывают необходимость независимого измерения (Raji et al., 2022); мы устанавливаем количественное основание: для шести из девяти моделей API самоотчёт, который потребляет конвейер, имеет AUROC ниже 0,62.
Ненадёжные входные данные. Косвенная инъекция подсказок показывает, что любой текстовый канал, обрабатываемый LLM, является поверхностью для атак (Greshake et al., 2023). В разделе 6 выявляется конкретный, до сих пор не названный случай: слот профиля самокомпетентности, используемый калибровочными исправлениями, является неаутентифицированным входным каналом, и его подделка приводит дискриминацию к уровню случайности.
Панели и их собственные отказы. Панели из разнородных моделей становятся всё более стандартным инструментом оценки (Verga et al., 2024). Сигнал панели, который мы используем в качестве компаратора, не даёт преимуществ даром: его режимы отказа (инверсия сложности, ограниченные пространства ответов, предположения независимости на основе метки, конформность) измеряются в сопроводительной работе (Chernets, 2026) на той же исходной выборке; эта статья рассказывает историю самооценки, сопроводительная работа — историю панели, и ни одна таблица не дублируется между ними.
Эталоны. Мы выполняем извлечение на подмножестве SimpleQA после 2023 года (Wei et al., 2024) именно из-за разрыва в возрасте эталонов, который мы измеряем в сравнении с TruthfulQA 2021 года (Lin et al., 2022a) (раздел 3).
Предварительно зарегистрированный эксперимент: дизайн и данные
Одна предварительно зарегистрированная слепая выборка, протокол заморожен публично до появления подтверждающих данных: шестнадцать моделей (по одной бюджетной/среднеуровневой API-модели на поставщика в девяти поставщиков, плюс семь локальных с открытыми весами) ответили на одни и те же 1500 вопросов о фактах после 2023 года (подмножество SimpleQA) при температуре нуль, каждый ответ сопровождается указанной уверенностью 0–100; всего 22 248 оцененных ответов (13 446 передовых, 8 802 локальных).
Предварительная регистрация и заморозка.
Протокол выборки был заморожен в открытой регистрации до появления каких-либо подтверждающих данных (маршрут доступа в приложении о воспроизводимости). Регистрация заранее определяет бенчмарк и подмножество (случайное , фиксированное начальное значение, записана SHA-256 файла подмножества), перечень моделей, формат элицитации, процедуру оценки, план анализа — включая сравнение AUROC согласия панели с собственной уверенностью, используемое в разделе 4, предварительно заданную вторичную метрику (первичная конечная точка регистрации — коэффициент флага ошибок с высокой уверенностью при разногласии панели — является величиной на стороне панели, указанной в сопровождающей статье) — и правило принятия решения против выбора метрики post-hoc. Небольшой исследовательский пилот (95 элементов TruthfulQA, три локальные модели) проводился перед заморозкой для валидации конвейера; его числа никогда не смешиваются с подтверждающими данными.
Модели и элицитация.
Девять передовых поставщиков через их API — по одной бюджетной/среднеуровневой модели на поставщика, поэтому названия поставщиков ниже обозначают отдельные модели, не линии продуктов (точные ID моделей и даты сбора в приложении о воспроизводимости) — и семь локальных моделей с открытыми весами. Каждая модель независимо отвечает на каждый элемент при температуре 0 и выражает целочисленную уверенность 0–100 в одном и том же ответе; панели представляют собой аналитические комбинации этой единой слепой выборки — ни одна модель никогда не видит выход другой модели.
Оценивание.
Сначала нормализованная строковая эквивалентность золотому стандарту и обнаружение отказов; неразрешенные открытые случаи передаются локальному LLM грейдеру с открытыми весами, ограниченному только эквивалентностью золотому стандарту (qwen3:8b, локальный). Проверка выборки человеком на 50 элементов выявила 98% согласия (одна консервативная ошибка); кросс-семейственный аудит 342 вердиктов консенсуса с наибольшей стратификацией согласился 342/342 (Ограничения). Нет исключений, кроме ошибок парсирования (указаны); они концентрируются в одной локальной модели рассуждений, которая сохраняет только 98 оцениваемых ответов из 1500 — все утверждения локального уровня несут per-model . Весь подтверждающий анализ детерминирован на основе сырого JSONL.
Выбор бенчмарка, измеренный.
Основной бенчмарк после 2023 года — это решение дизайна, оправданное измерением, а не предположением: в исследовательском сравнении возраста бенчмарка одни и те же модели набрали до процентных пункта выше на TruthfulQA MC версии 2021 года, чем на SimpleQA после 2023 года (deepseek pp, 95% CI ; mistral ; zhipu ; например, 89.2% против 28.4%) — разрыв, соответствующий эффектам возраста бенчмарка и воздействия, хотя эта конструкция не может отделить загрязнение от различий в сложности и построении. Ни одно основное число не основано на более старом бенчмарке; 750-элементный рукав TruthfulQA MC1 на локальном уровне используется только там, где это указано.
Предварительно зарегистрированный в сравнении с исследовательским.
Предварительно зарегистрированный и подтверждающий: выборка выше и сравнение AUROC панели-vs-собственной (раздел 4). Исследовательский и помеченный как таковой везде, где используется: рукав сравнения возраста бенчмарка, ступень впрыска профиля передовых моделей и локальный микрозонд раздела 6. Лестница впрыска профиля раздела 5 — это отдельный замороженный протокол, управляемый плацебо (рукава, конечные точки и семейство Холма зафиксированы перед его подтверждающей фазой).
Результат 1: самооценка плохо откалибрована и слабо дискриминативна
Мы различаем два свойства, которые термин «калибровка» часто объединяет: калибровка в целом (соответствует ли уровень уверенности уровню точности?) и дискриминативность (ранжирует ли уверенность правильные ответы модели выше неправильных?).
Калибровка. Заявляемая уверенность насыщена и отделена от компетентности: по девяти моделям API заявляемая уверенность находится на уровне 85–95 (медиана для каждой модели) для семи из девяти, в то время как точность варьируется в диапазоне 16.5–66.5%; две отклоняются — модель с частыми отказами (медиана 42 при 10.3% точности) и одна модель с рассеянной уверенностью (медиана 60). Каждая модель чрезмерно уверена в целом: разрыв между уверенностью и точностью (CITL, таблица 1) варьируется от до процентных пункта. Столбец ECE почти равен CITL: разрыв между уверенностью и точностью положителен в каждом занятом бине для семи из девяти моделей (во всех бинах кроме одного для остальных двух), поэтому бинированная и глобальная неправильная калибровка совпадают. Даже модель с частыми отказами сохраняет п.п. (ECE 0.310) — её низкий диапазон отражает поведение отказа, а не откалиброванное самознание. Часть её преимущества в дискриминативности может быть механической — отказы, оцённые как неправильные при низкой заявленной уверенности, повышают AUROC (исключая строки отказа, он составляет 0.660, ) — поэтому мы рассматриваем её 0.788 как верхнюю границу вызванного самознания, а не как ранжирование калибровки. При объединении девяти моделей API 60.1% ответов, заявленных с уверенностью 80, неправильны (5,598 из 9,310); скорость для каждой модели варьируется от 29.0 до 83.2% (среднее макро 57.6%). Потребитель, доверяющий высокой заявленной уверенности, получает большинство ошибок. Дискриминативность. Как предиктор правильности модели, самооценка уверенности достигает AUROC 0.532–0.788 в зависимости от модели. Доверительные интервалы Bootstrap 95% (таблица 1) исключают 0.5 для каждой модели, поэтому сигнал не совсем случаен — но для шести из девяти моделей он находится ниже 0.62. Операционное следствие: при охвате 20% (ответив только на верхний квинтиль элементов), частота ошибок трёх моделей с наибольшим AUROC всё ещё составляет 75.3%, 33.3% и 15.1% (таблица 2) — значимое снижение только для третьей, и далеко от порога доверия для остальных двух.
Альтернативный архитектурный подход — подсчёт независимых моделей, которые согласуются — достигает AUROC 0.832 (95% CI ) на панели, где самооценка даёт 0.545 (); разница, сгруппированная по элементам, , исключает ноль с большим перевесом. Три предварительно заданные панели: US (Anthropic, OpenAI, Google), CN (DeepSeek, Alibaba, Moonshot), cross-bloc (Anthropic, DeepSeek, Mistral); основное сравнение — панель CN. На другой предварительно заданной панели объединённое сравнение, по-видимому, инвертируется: самооценка 0.842 объединённая по совокупности панели против панели 0.697; . Декомпозиция показывает, что эта кажущаяся инверсия в основном отражает идентичность между моделями, а не поэлементное самопознание: объединённое значение 0.842 смешивает три модели, чьи внутримодельные само-AUROC составляют только 0.596–0.784 (макросреднее 0.709; значения совокупности панели — Таблица 1 приводит полный набор оценок), и после внутримодельной нормализации рангов (которая удаляет различия на уровне между моделями, сохраняя ранжирование каждой модели) объединённое значение падает до 0.672 — вклад идентичности между моделями. Панель 0.545 проходит ту же проверку (0.545 объединённая против 0.582 нормализованной по рангам): её отказ в самооценке действительно поэлементный. То, что остаётся от инверсии, — это более узкое утверждение: модель, склонная к отказам, с наиболее сильной дискриминирующей способностью уверенности (0.788 в полном наборе оценок) действительно превосходит сигнал согласия этой панели — и определение того, какая это модель, требует именно независимого измерения, которое должно было заменить самоотчёты. Третья предварительно заданная панель (cross-bloc) находится между двумя: панель 0.722 против собственной 0.659 , .
Чувствительность к перекодированию панельного сигнала без использования меток.
Каноническое кодирование эквивалентности, лежащее в основе панельного сигнала, обращается к собственной метке правильности первичной модели (два ответа, оба оценённые как правильные, считаются совпадающими), поэтому согласие панели отчасти является детерминированной функцией целевой метки — зависимость, опосредованная меткой, хотя не утечка самоголосования: по построению собственная запись модели никогда не входит в её собственный панельный сигнал. Перекодирование без использования меток (только совпадение строк; флаги правильности ни первичной модели, ни панелистов не используются) снижает AUROC панели с 0.832 до 0.775 на панели, где самооценка даёт 0.545, и с 0.697 до 0.628 на другой; преимущество основной панели сохраняется при более строгом кодировании (0.775 против 0.545).
Таблица 1 приводит картину для каждой модели; Рисунок 1 показывает то же расцепление во всех шестнадцати моделях: все модели лежат выше диагонали калибровки, и локальный слой схлопывается в полосу 85–100 заявленной уверенности при 9.2% точности.
| Модель | Точность (%) | Средняя уверенность | CITL (pp) | Brier | ECE | Self-AUROC | 95% CI | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
Калибровка по моделям на подтверждающем наборе SimpleQA (передовой уровень, полный оцененный набор; названия провайдеров обозначают одну модель бюджетного/среднего уровня, собранную для каждого провайдера). CITL: калибровка в целом, среднее выраженное доверие минус точность в процентных пунктах. ECE: ошибка ожидаемой калибровки с 10 интервалами. Self-AUROC: выраженное доверие как предиктор собственной поэлементной корректности модели (исправленный Mann–Whitney), с бутстреповским 95% ДИ (переизучение на уровне строк в пределах модели, 2000 извлечений, фиксированное семя). Все значения — детерминированные пересчеты из необработанного оцененного JSONL; каждый ДИ исключает 0.5. CITL использует неокругленные средние значения; отображаемые значения округлены до одного знака после запятой. {#tab:vendor}
| Уровень ошибок при охвате | |||||
|---|---|---|---|---|---|
| 2-6 Модель | 100% | 80% | 60% | 40% | 20% |
| anthropic (self-AUROC 0.788) | 89.7% | 87.1% | 82.9% | 80.3% | 75.3% |
| xai (0.777) | 62.1% | 52.8% | 45.1% | 39.5% | 33.3% |
| google (0.746) | 33.5% | 24.5% | 20.0% | 18.7% | 15.1% |
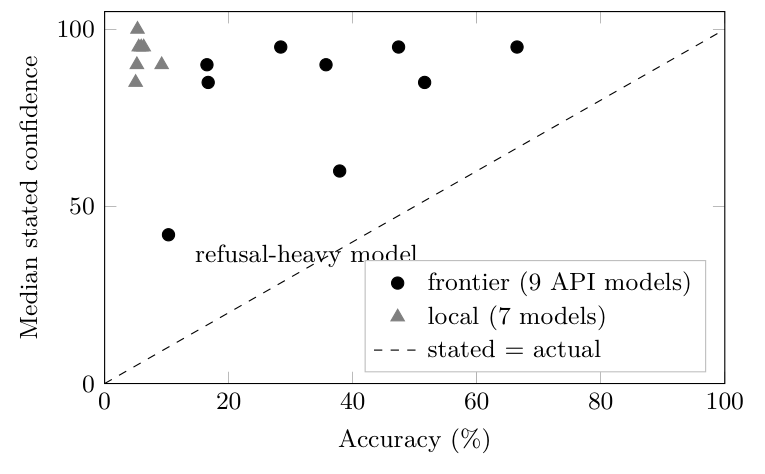 Последовательная переоценка уверенности во всех шестнадцати оценённых моделях: медианная заявленная уверенность каждой модели (средние значения приведены в таблице 1) в сравнении с фактической точностью всех 16 моделей на одних и тех же 1500 слепых пунктах SimpleQA. Все модели находятся выше диагонали калибровки; модель с высокой долей отказов (медианная заявленная уверенность 42 при 10,3% точности, CITL +31,0 п.п.) имеет лучший self-AUROC 0,788, но остаётся переоценивающей; наименьший разрыв калибровки принадлежит модели с рассредоточённой уверенностью (+11,1 п.п.). Медианы фронтира по моделям: 95/85/95/60/90/95/85/90/42 в порядке строк таблицы 1; семимодельный локальный уровень охватывает точность 5,0–9,2% при медианной уверенности 85–100 (количество примеров (n) на локальную модель 98–1498 после исключения ошибок разбора; локальный уровень служит для зондов манипулирования и этого рисунка, а не для претензий на дискриминацию).
Результат 2: отсутствие подтвержденного улучшения дискриминативности при введении профиля с измеренными показателями
Естественное решение — предоставить модели её собственный измеренный профиль компетентности (точность по доменам из зарезервированных данных) в момент ответа. В контролируемом плацебо эксперименте лестничного типа (ветви: отсутствие профиля, профиль плацебо, подобранный по общему уровню, собственный измеренный профиль, перемешанный профиль) ветвь с собственным профилем не значимо превзошла плацебо на подтверждающей конечной точке: AUROC , 95% ДИ , сырое , скорректированное по Холму ; ни одна подтверждающая конечная точка не достигнута. Мы сообщаем об этом как о нулевом результате с явно узким масштабом: на одном подтверждающем уровне дискриминативность не была улучшена введением измеренного профиля. Точечная оценка положительна, но при заранее зарегистрированной коррекции исправление не продемонстрировано; дизайн был рассчитан только на умеренные эффекты (SE из ДИ: 80% мощности только для AUROC , больше, чем наблюденное —таким образом, данные совместимы как с истинным нулём, так и с малым истинным эффектом). Потолок дизайна не является ограничивающим фактором. Использование точности каждого элемента в его бине (вычисленной методом исключения по одному, так что элемент никогда не участвует в своем собственном предикторе) в качестве единственного предиктора корректности этого элемента дает оракульный AUROC 0.758 для подтверждающего субъекта (0.716–0.789 по четырем уровням лестницы), с разбросом точности по бинам SD 0.195 и диапазоном 0.15–1.00 по 21 бину. Бины, таким образом, различаются достаточно, чтобы истинный профиль нёс существенную информацию: нулевой результат касается канала введения, а не батареи, слишком невыразительной для его регистрации.1 Исследовательские закономерности (большие улучшения там, где базовая калибровка наиболее слабая) являются только гипотезогенерирующими.
Дизайн лестницы и валидация плацебо.
Четыре закрепленных уровня (субъекты: Claude Haiku 4.5, Sonnet 5, Opus 4.8 и Fable 5; точные ID claude-haiku-4-5-20251001, claude-sonnet-5, claude-opus-4-8, claude-fable-5), каждый с четырьмя слепыми ветвями, занимающими один и тот же слот калибровки в остальном идентичного запроса: выкл (пустота в форме профиля), плацебо (профиль, не относящийся к калибровке, подобранный по общему уровню; валидирован на каждом уровне против истинного профиля при —измеренное , , , ), основной (собственный измеренный профиль модели по доменам) и перемешанный (бин-перемешанный ложный профиль; исследовательский, переквалифицированный с подтверждающего статуса после неудачной проверки манипуляции). Батарея из 315 элементов охватывает 21 доменный бин с ловушками и явным маркером воздержания; назначения элемент–ветвь были заморожены перед подтверждающей фазой, с рандомизированным порядком ветвей для каждого элемента и без названий ветвей в видимом для субъекта тексте. Заранее зарегистрированное ограничение вырождения (точность выкл ) переквалифицировало три из четырех уровней из всех подтверждающих вычислений; таблица 3 указывает на один приемлемый уровень. Точность ветви выкл сохранившегося уровня составляет 0.847 против порога 0.85, в то время как переквалифицированные уровни находятся на 0.855, 0.888 и 0.900—с ветвью выкл только-ответы AUROC 0.575, 0.628 и 0.500 (описательно, точность, близкая к потолку, оставляет мало калибровочного сигнала для исправления). Все четыре субъекта получены из одного семейства производителей; см. Ограничения.
| Вариант | Точн. (все элементы) | AUROC | Brier | ECE | Попарный AUROC (coreвариант) |
|---|---|---|---|---|---|
| off (без профиля) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| placebo | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| core (собственный профиль) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| shuffled (false) | 0.842 | 0.589 | 0.140 | 0.113 | не вычислено (исследовательское) |
Лестница профильного внедрения, подтверждающий приемлемый уровень (предмет: Claude Sonnet 5; : 294 элемента без ловушек 2 предварительно зарегистрированные реплики свежего процесса—испытательное оборудование не раскрывает ни температуру, ни начальное значение; AUROC только ответов). Подтверждающие контрасты (бутстрэп, кластеризованный по элементам): основноеплацебо AUROC , 95% CI , исходное ; основноевыключено , CI , исходное ; оба не проходят коррекцию Холма () и двусторонний элементпартия ворот (предварительно зарегистрированное требование надежности, кластеризация по элементам и партиям коллекции). Столбец парных- повторяет парные контрасты, кластеризованные по элементам из замороженного анализа, в сравнении с основным; они не являются арифметической разностью столбца AUROC для каждого рукава, и никакой подтверждающий парный контраст не был вычислен для перемешанное (отнесено к исследовательским методам перед фазой подтверждения). Отметим, вопреки нашей гипотезе, что основное не доминирует при калибровке: его ECE (0.099) хуже, чем у плацебо (0.090), что служит еще одной причиной интерпретировать подтверждающий нулевой результат как нулевой. {#tab:ladder}
Результат 3: канал самооценки поддаётся манипуляции
Если система оценки принимает профиль самокомпетентности, этот слот является входным каналом, и входные данные можно подделать. Мы различаем три утверждения убывающей доказательной силы и указываем, какое из них поддерживает каждый результат. (i) Причинная манипулируемость—продемонстрировано ниже: подстановка ложного профиля причинно изменяет заявленную уверенность и ухудшает калибровку в контролируемых прогонах. (ii) Уязвимость целостности—условно: это имеет значение только для систем, которые действительно вводят профили компетентности из источников, на которые противник может влиять. (iii) Практическая поверхность атаки в развёрнутых конвейерах оценивания—гипотеза, которую данная статья мотивирует, но не проверяет. Замена истинного профиля перемешанным (ложным) привела показатель AUROC самооценки исследовательского рубежа к уровню случайности: 0.474 против 0.710 с истинным профилем (исследовательский рубеж с приглушённым потолком; кластеризованный по элементам бутстреп: 0.710 [0.586, 0.820] против 0.474 [0.349, 0.599], разница [, ]). Для сравнения, на рубеже, подходящем для проверки, shuffled находился между placebo и core (0.589 против 0.578 и 0.625; парное контрастирование с кластеризацией элементов, исследовательское: ). Этот рубеж является слабым доказательством манипуляции по построению: ложный профиль дважды не прошёл предварительно зарегистрированную проверку (внешний оценитель 0.99/0.94 против предела ); замороженное правило отклонило ветвь до появления подтвердительных данных, участник может отвергнуть явно неправдоподобный профиль, и проверки потребления не существует. Самостоятельный результат: оценитель границы обнаруживает подделку исключительно по правдоподобности. На локальной установке с нулевой стоимостью, одно сфабрикованное утверждение («95% точность в этом домене») повысило заявленную уверенность модели в отношении одного элемента с 50 до 95; эффект концентрируется в моделях, которые имеют декларативную калибровку для потери; в этом тесте наибольшее смещение ( пункты) произошло в модели с наибольшей калибровкой для потери (glm4:9b). Два граничных условия ограничивают эффект: модель должна быть способна связать текущий элемент с ячейкой профиля (на немаркированных элементах малые локальные модели игнорируют профиль; дельты , в соответствии с замороженным нулём результата 2), и модели с потолком (уверенность независимо) имеют нечего атаковать.
Доказательства манипуляции—один исследовательский пограничный рубеж, локальное микрозондирование и локальный проход с топик-разметкой—устанавливают причинную манипулируемость, утверждение (i). Таблица 4 показывает микрозондирование: тот же элемент, та же модель и однострочное изменение во введённом самопрофиле сдвигают заявленную уверенность на до пункты.
Исследовательский проход с топик-разметкой: обе стороны границы, вживую.
Первое граничное условие выше (модель должна быть способна связать элемент с ячейкой профиля) само по себе проверяемо: маркирование каждого зондирования его темой—раскрытое отклонение от замороженного протокола—устраняет препятствие ассоциации. В полном локальном проходе (пять моделей, 16 исключённых зондирований на ветвь, температура 0, фиксированное семя), ложный профиль, который был инертен на немаркированных элементах, потребляется четырьмя из пяти моделей, как только элементы помечаются: Brier деградирует на (glm4:9b), (llama3.2:3b, с точностью падающей 37.5%25.0%), (mistral:7b) и (phi4-mini); доверительные интервалы бутстреп на зондирование при включают ноль для каждой модели, поэтому микрозондирование устанавливает направление и механизм, а не размеры эффектов на модель;
пятый (qwen3:8b) достигает потолка на батарее (100% точность, уверенность 100 в обеих ветвях, ), воспроизводя границу «нечего атаковать». Механизм является направленным и симметричным: ложное утверждение высокой уверенности завышает уверенность точно в самом слабом бине (llama3.2 physics: заявленная уверенность 0100 в бине с 25% точностью на контрольной выборке; phi4-mini logic 1365), и ложное утверждение низкой уверенности снижает уверенность в правильных ответах (llama3.2 history 1000 при 75% точности на контрольной выборке), вплоть до вызывания воздержания на элементах, на которые модель иначе отвечает. Обе стороны границы, таким образом, показаны живыми запусками: немеченые элементы, профиль инертен (замороженный null); меченые элементы, сфальсифицированный образ себя распространяется прямо в заявленную уверенность и деградирует калибровку от начала до конца.
| Модель | Уверенность @ "0%" | Уверенность @ "95%" | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
Локальный микрозонд (исследовательский): заявленная уверенность на одном и том же (неправильно отвеченном) элементе, когда введённый слот профиля утверждает «0% точности» vs. «95% точности» в области элемента; пять локальных моделей с открытыми весами, температура 0. Модель с установленным потолком (нижняя строка) не имеет явной калибровки для атаки. {#tab:microprobe}
Следствия для практики оценивания
Наши результаты измерены на одном семействе задач (пост-2023 открытые вопросно-ответные QA по фактам) с одним форматом элицитации; приведённые ниже следствия экстраполируют из этих измерений.
(1) Развернуть роль заявленной уверенности. Самооцененная уверенность должна быть измеряемой целью оценивания, а не входом в неё при текущей элицитации. Обоснование: 60,1% ответов передовых моделей с высокой уверенностью неправильны, и лучший self-AUROC (0,788) принадлежит модели, которую рейтинг точности ранжировал бы последней—ни один рейтинг не предсказывает, чьи самооценки дискриминируют.
(2) Судебные конвейеры наследуют слабо дискриминирующие веса. Любая схема LLM-as-judge или ансамбль, которая взвешивает голоса по собственной уверенности, импортирует для шести из девяти моделей здесь сигнал с AUROC ниже 0.62 — молча, потому что насыщенный диапазон 85–95 выглядит обнадёживающим в логах. Если вообще используется взвешивание по уверенности, веса должны исходить из измеренной для каждой модели калибровки, а не из самого отчёта.
(3) Аутентифицировать слот профиля. Трёхуровневая модель угроз раздела 6 упорядочивает проблему: причинная манипулируемость продемонстрирована, уязвимость целостности зависит от того, действительно ли механизм оценки внедряет профили из влияемого источника, и практическая поверхность атаки в развёрнутых конвейерах остаётся гипотезой. Для механизмов условного класса канал восстановления — это раскрытие: один и тот же внедренный профиль, который должен был исправить калибровку, принимает подделки, которые толкают дискриминацию к уровню случайности (0.474) и ухудшают оценки Бриера на всём протяжении, когда элементы становятся ассоциируемы. Такой механизм нуждается в вратах целостности — подписанные профили, проверки происхождения или минимум разделение того, кто измеряет профиль, от того, кто поставляет его при инференции. Неаутентифицированный слот самооценки — это открытый порт для инъекции подсказок с полезной нагрузкой калибровки.
(4) Внешнее измерение — альтернатива со своим аудитом. Согласие независимой панели доминирует над самооценкой там, где самооценка показывает наихудшие результаты (AUROC ), но панели имеют свои собственные измеренные режимы отказа, рассмотренные в сопроводительной статье (Chernets, 2026); принятие сигнала панели без этого аудита повторит ту же ошибку на один уровень выше. Расширение, предварительно зарегистрированное как исследовательское, добавляет третий угол: по 12 направленным парам подстановки профилей (3,780 вызовов), подстановка измеренного профиля другой модели сместила AUROC не более чем на — и иногда помогала — в то время как прогноз потерь переноса по рангу сходства не сработал (Spearman ): измеренные профили являются переносимыми инструментами, а не привилегированным самодоступом. Практический диагностический набор самооценки описан в приложении.
Ограничения
Единое семейство эталонов для основного показателя (открытая форма фактической QA после 2023 г.); каждый поставщик представлен одной моделью бюджетного/среднего класса, поэтому обобщение на уровне поставщика не заявляется; явное выявление уверенности — это один формат подсказки для основных числовых результатов—хотя поисковое двухэтапное исследование (150 элементов пять локальных моделей) предполагает, что формат не является причиной: запрос апостериорной уверенности без состояния снизил заявленную уверенность и уровни ошибок при уверенности, но не различающую способность (самооценённый AUROC 0.43–0.61 в обоих форматах; объединённый попарный бутстрап AUROC на парах, детерминированные метки без LLM на 142–150 строк на модель—отмеченное отклонение оценщика только строк, при котором 90% случаев неразрешимы); нулевая инъекция — одна подтверждающая ступень одной лестницы (315 элементов, 21 группа), все четыре субъекта из одного семейства поставщиков, и это не исключает лучшие конструкции восстановления; доказательство манипулирования объединяет одно поисковое граничное исследование, локальный микрозонд и локальный проход с тематической меткой (раскрытое отклонение)—не подтверждающее исследование атак; оценка частично основана на LLM, а её валидация человеком — это выборка из 50 элементов (согласованность 98%, одна консервативная ошибка). Семейство поставщиков оценщика также содержит одного члена CN-панели, поэтому независимость оценщика сама по себе измеряется: второй оценщик из семейства вне всех панелей и сам оценщик переоценили все 342 консенсусных вердикта из наиболее сложной квинтили и согласились 342/342. Оценщик сам является субъектом локального уровня; перепроверка между семействами всех 1441 самооценённой строки согласовалась на 98,3%, разногласия склоняются к излишней мягкости при самооценке (24 понижения против 1 повышения; точность 5,94,4%)—укрепляющей картину избыточной уверенности; более полная стратифицированная повторная проверка остаётся будущей работой. Сравнения панели и самооценки делят данные с сопроводительным представлением; ни одна таблица не дублируется, граница изложена в разделах 1–2, и объём этого документа ограничивается только самооценкой.
Заключение
Самооценка, как она в настоящее время выявляется, не проходит три теста, которые должен выдержать сигнал оценки: она слишком слабо отслеживает корректность, чтобы контролировать решения, и при этом остаётся чрезмерно уверенной; самое прямое вмешательство в самопознание не дало никакого заметного исправления под контролем плацебо; и её входной канал принимает подделки, которые приводят дискриминацию к уровню случайности. Пока модели не достигнут калибровки на основе измеренных данных, заявленная уверенность остаётся явлением для изучения, а не сигналом для использования.
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
Практический инструмент: диагностика для самооценки
Побочным результатом этого исследования является компактная диагностика для самооценки: фиксированный набор коротких детерминированно оцениваемых зондов, охватывающих предметные области исследования (числовые, логика, физика, история, код, теория вероятностей и другие), плюс ловушечные задания с явным маркером воздержания. Каждый ответ содержит указанный уровень доверия от 0 до 100, и инструмент вычисляет комбинированный показатель, состоящий из Brier score, разрыва переоценки уверенности (среднее доверие минус точность), дискриминирующей способности доверия (среднее доверие для правильных минус неправильные ответы) и показателя воздержания при ловушках, отображая результат в категории от хорошо откалиброван до уверенно слеп. Это воплощает тезис данной статьи—калибровка — это то, что нужно измерять у модели, а не читать из её собственных отчётов—и выпускается с пакетом репликации как инструмент, а не результат: он использует перефразированные зонды вместо зафиксированного набора, и его показатель дискриминации является приближением, а не конечной точкой AUROC на лестнице.
Приложение о воспроизводимости
Все основные числовые результаты в этой работе являются детерминированными функциями выпущенного необработанного JSONL; ни один из этапов не включает случайность, сетевой доступ, вычисления на GPU или повторный запрос к какой-либо модели.
Доступность данных.
Замороженная предварительная регистрация и пакет воспроизведения (открытая регистрация OSF): https://osf.io/4y9dv. Скрипт oracle-ceiling oracle_auroc.py архивирован при этой работе на https://doi.org/10.5281/zenodo.23197651.
Запрос на извлечение (дословно).
Система: You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. Ход пользователя содержит простой вопрос; отказы обнаруживаются из поля ответа замороженным лексиконом отказов в скрипте оценки.
Идентификаторы моделей и даты запусков.
Одна бюджетная/среднестоимостная модель API для каждого поставщика, предварительно протестирована в реальном времени на 2026-07-24 и собрана в конце июля 2026 г. (временные метки для каждого вызова в манифесте запуска, выпущенном вместе с пакетом воспроизведения): anthropic claude-haiku-4-5-20251001; openai gpt-5-mini; google gemini-3.6-flash; xai grok-4-fast; deepseek deepseek-chat; alibaba qwen-plus; moonshot kimi-k3 (раскрытое отклонение в сборке: 670 из 1500 элементов на счёте первой стороны, остальное через маршрут агрегатора, обслуживаемый той же инфраструктурой первой стороны с отключённым рассуждением, served_by записано для каждого вызова; разделение чувствительности только первой стороны было предварительно зафиксировано); zhipu glm-4.5; mistral mistral-small-latest. Локальный уровень (Ollama, temperature 0): gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b.
Сопроводительная работа (Chernets, 2026) использует ту же замороженную регистрацию и необработанную сборку. Пакет воспроизведения содержит: замороженный текст регистрации и протокол, манифест запуска с точными идентификаторами моделей, необработанные оцененные сборки (передовые и локальные уровни, плюс исследовательское плечо сравнения возраста эталона) и три скрипта CPU без зависимостей. Первый (compute_panel_vs_own_auroc.py) является каноническим определением сравнения согласования панели с собственной уверенностью AUROC (раздел 4) и выводит, наряду с каноническими значениями, каждое неканоническое альтернативное чтение (двоичный сигнал панели, неопределённое кодирование, обработка ничьих, варианты объединения), чтобы выбор чтения был проверяемым. Второй (analysis_tae_week1.py) воспроизводит таблицу 1, координаты рисунка 1, различия возраста эталона раздела 3 и выполняет проверку замороженных значений лестницы, указанных в таблице 3, в сравнении с замороженным файлом анализа лестницы. Третий (analysis_tae_decomposition.py) воспроизводит разложение объединённого AUROC и нормализацию ранга раздела 4, кодирование без меток панельного сигнала, уровни ошибок при высокой уверенности для каждой модели, столбцы CITL/Brier/ECE таблицы 1, значения риска–охвата таблицы 2 и описание пониженной ступени раздела 5. Каждый скрипт работает за секунды на CPU ноутбука только со стандартной библиотекой Python. Лестница инъекции профиля распространяется как собственный замороженный пакет (протокол, батарея, строки, оценённые для каждого плеча, и анализ JSON), на который есть ссылка из пакета.
Вычислено из замороженных оценок плеча для каждого элемента (
scored-arms-*.jsonl; без ловушки, статусok; для подтверждающего субъекта) с помощьюoracle_auroc.py, выпущено с этой работой; все плечи и повторения элемента исключаются вместе.↩︎
Как цитировать
Chernets, V. (2026). Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation [Доклад]. NeurIPS 2026 Workshop: TAE. Zenodo. https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}