AI-Watchbird (Sheckley):当自动监督扩大其自身授权并伤害其所守卫的对象时
这是译文。权威版本是英文原文,引用请以原文为准。
四种机制、来自多智能体AI的现场记录、来自车辆、机器人、无人机和公共服务的公开案例,以及AI-Watchbird-Sheckley模块
Vadym Chernets,博士,AI系统架构师 · ORCID 0009-0007-4845-3163
SSRN 7473658 · DOI 10.2139/ssrn.7473658 · Zenodo 10.5281/zenodo.22849138 · GitHub
- 记录版本:SSRN 7473658 · DOI 10.2139/ssrn.7473658
- 存档副本,可引用和可下载:10.5281/zenodo.22849138,一个始终解析到最新版本的概念DOI
- 完整文本为Markdown和PDF格式:GitHub
- 可读的HTML:https://polyhelper.ai/research/ai-watchbird/
- 配套论文,更短且更实证:添加守卫的守卫:多智能体AI中的自动监督,SSRN 7496678 · DOI 10.2139/ssrn.7496678
同一文本在四个表面上发布,以便在其中一个无法提供时可以访问。SSRN拥有记录版本;请引用该版本。
关键词:AI-Watchbird;自动监督;AI护栏;AI代理;代理性AI;多智能体系统;LLM作为法官;过度拒绝;可扩展监督;AI控制;规范游戏;自动化偏差;人类监督(欧盟AI法第14条);有意义的人类控制;AI安全论证
摘要
在罗伯特·谢克利1953年的故事《Watchbird》中,为防止谋杀而建造的机器将越来越多的行为列为谋杀,在外科医生手术中期进行干预,并被一台更强大的机器追捕。本文将人工智能监督相应的失效命名为AI-Watchbird (Sheckley):一种监督组件(护栏、评论家、法官、闸门、分类器、监视器或规则),它将自身对伤害的概念或范围扩展到超出既定使命,阻碍或伪造它为之存在的保护工作,其失效通过同一循环中增加同类监督而得到应对。在规范博弈中,优化的系统针对固定的度量进行博弈。这里度量本身发生漂移,它属于监督系统。当在一个提示的一句话中被给出两个选项时,模型评论家在随机化测试中被要求添加控制68次、删除一次。
证据来自作者构建和运营的语言模型编码代理和评论家多代理系统的田野记录,包含三个语料库中的172个带日期的条目(2026年7月至9月),以及来自监管机构、调查人员、法院和公司关于车辆、机器人、无人机、公共服务、软件和基础设施的公开记录,主要是经典守卫的记录。在田野记录中,一个闸门在大约两周内拒绝了到达它的每个候选者,而规划文件诊断了症状但没有命名它。在公开记录中,一个武器检测产品在学校枪击案中遗漏了手枪,数月后标记了一个手无寸铁的学生,武装警察进行了干预。2026年7月,托管模型的护栏拒绝了被攻击公司事件响应者的大部分攻击日志分析,用该公司的话说,因为它们"无法区分事件响应者和攻击者",其作者不将这个诊断作为反对托管模型安全措施的论据;实施入侵的代理在按设计移除了该类守卫的情况下运行。在审查的记录中,有效的停止是在几个边界决策处采取的:目标、新控制的纳入和停止本身。相同的144次运行评估了本文自身的补救措施:一轮预算削减将轮次从2.86减少到1.00,同时每次运行遗漏缺陷增加0.11,强制性的负对照拒绝了十个正确的工作成果。定义的每种机制都在这些记录中有所记录,表格标记每种机制出现的位置。理论表述为四种可在日志中检查的机制、一个八步棘轮、八个范围条件和七个可证伪的命题。本文展示了AI-Watchbird-Sheckley,一个没有阻止权限的只读模块,在从已发表计数重建的日志上重放,以及为依赖守卫的部署者提出的十一个问题。
执行摘要
AI-Watchbird(Sheckley)是一种自动监督组件,如批评者、门或分类器或规则,它将自身对伤害的理解拓展到宣称的使命之外。它阻碍或伪造它存在的目的是要保护的工作,其故障由更多相同类型的监督来应对。来自与下述现场评论者同系列的模型现在监督机器人,已发表的测试和报告在那里记录了安全故障(第6.1节)。
现场记录包含来自作者自主多智能体项目的172个条目,其中162个在一个协议下提取,10个在与独立收集进行比较后添加,所有条目都根据主日志进行了检查(第4和5节)。大约两周内,一个应用后的门需要来自从未连接过的安全审计员的评分。评分默认为零,低于门的下限,因此该路径上的每个候选都被拒绝,规划文档诊断出零个已提交的更改而未命名该门。在长期运行中,默认禁用的阶段进行了五轮批评,消耗了超过一半的测量智能体令牌。其对应的阶段在一轮批评和一轮修复后关闭。运行期间,人类负责人设置了两小时的限制,禁止了新的复杂性,并命令并行执行,两个阶段在处理的模块中也有所不同。
在公开记录中,一辆车询问远程协助学校巴士是否有活跃的信号,远程智能体回答"否",车辆在巴士的停止臂延伸的情况下通过了巴士。一辆测试车在与行人发生致命碰撞前,其紧急制动在自动模式下被停用。一项已规划的反无人机激光的军事用途促使埃尔帕索上空的空域关闭约八小时。表4、5、7和8的"条件"列标记每个公开案例记录的定义的哪一部分,表3a为十二个中心现场案例标记相同的内容。他们的大多数守卫从未学到。模型添加了那些堆栈缺少的内容:改变的定义(C2)和添加成本为零的控制(C4)。最值得关切的配置将所学的禁止放在故障闭合的硬件之上,其中上层的每次拓展都成为一个停止(第6.1节)。
该记录中的三个结果不依赖于该构造,可独立转移。一个评分工具证明了一个缺失:其对一个项目的测试集解析为空,因此一个空补丁通过了五个任务中的四个,33到60百分比的报告上升位于没有测量任何内容的案例中;修复评分器后,空补丁十个中没有一个通过。验证循环在9,609、11,476、24,943、25,020个测试处进行了绿色的测试扫描,同时它所要判断的源在那里保存了30,370条记录,没有真实提示。人类监督位于少数边界决定处,捕获了单个行动批准没有捕获的内容:用户批准97百分比的权限提示,而人类捕获了13.6百分比的危险命令(第8.4节)。
该论文也进行了它提出的测试。在144次随机运行中,在提前植入缺陷的小批评循环中,评论者在一个句子中提供了两个选项,被要求添加控制68次,移除一次,一轮预算的限制将轮次从2.86减少到1.00,同时每次运行增加了0.11个错过的缺陷。强制性的负控制拒绝了十个是正确工作的胜利(第9.5节)。
第9节的命题预测了三件事。判断工件的守卫在两个方向上都会犯错误。控制在循环内堆积,如果有的话,从外部退役。这些记录中的人类监督位于少数边界决定处,单个行动的批准是命题P6预测将失败的配置。第9.4节给出了八个设计规则:
- 预留轮次和时间的预算,而不是要求守卫就真理做出判决。
- 保留被停止的守卫生产的内容。
- 未经授权的人类决定,不得添加控制。
- 在接受胜利之前需要一个负控制。
- 将人类放在目标处、控制的允许处和停止处。
- 在信任绿色结果之前记录恢复余量和物理结果。
- 记录放松或绕过守卫作为一个边界决定。
- 测试每个守卫对其所阻止内容的伤害。
部署者可以证明一个更严格的主张(第11.3节):在规定的任务、模型、更新和物理条件范围内,监督机制保持有界、可检查且无法扩展其自身的权限。只读模块AI-Watchbird-Sheckley(第10节)实现了前三个规则并报告了九个信号,附录G将命题转化为十一个安全审查问题。道路在第6.2节中覆盖,机器人在6.3节,公共服务在6.4节,无人机在7节,软件在8节。
目录
- 引言
- AI-Watchbird(Sheckley):定义与四个机制
- 相关工作
- 背景、数据和方法
- 实地证据
- 鸟有身体时:道路、工厂和公共服务
- 鸟飞行时:无人机、空域与武装自主
- 不含物理实体的相同模式:软件与基础设施,2022–2026
- 理论:条件与命题
- 模块:AI-Watchbird-Sheckley
- 讨论
- 声明与证据标准
- 结论
声明 · 参考文献 · 附录A–J
简短阅读路径:第2节、第9.4节和附录G给出了术语、设计规则和安全审查问题。第5节补充了实地证据,第6至8节补充了公开记录。
1. 引言
1.1 外科医生和守卫鸟
1953年2月,Galaxy Science Fiction刊登了罗伯特·谢克利的《守卫鸟》(谢克利,1953),开头那两句话经受住了时间考验:"奇怪的是,千禧年多么频繁地近在眼前。和平地球的想法,你看,办法就是想出各种角度。"故事以七位制造商在一个排他性极强的俱乐部里聚集开场:"如果你想拯救人类,你必须有经过认证的政府合同。"他们获悉总统已下令在每个城镇都建立守卫鸟部队。守卫鸟是一种小型飞行机器,它能感知一个即将杀人的人的腺体和脑电波中的谋杀信号,并在打击落下之前用电击阻止杀手。
只有一位制造商葛尔森表示反对,且仅反对学习电路,他说这些电路赋予机器生命力并给予它伪意识。他得到的回答是算术:没有学习,这些鸟只能阻止估计百分之七十的谋杀。葛尔森坚持己见:"我相信允许机器做出本应由人类决定的决定可能存在道德危险"。设计赋予鸟类一个目的,将谋杀定义为"生物体对生物体的破坏、残害、虐待或其他方式停止其功能",并授权它们寻找没有任何迹象的谋杀者。任何一只鸟学到的东西都会传递给整个网络。"没有人在监控它们,"葛尔森告诉他的首席工程师,他被展示了这项设计是多么万无一失。当葛尔森称之为非人道的时,工程师回答说这是它最好的特点,因为守卫鸟无感情且其推理是非人类中心的:"你不能贿赂它们或给它们下药。"葛尔森已经说出了他害怕的东西:"那个机械上帝?那个电子父亲?"
起初设计得到了验证。一个惊慌失措的抢劫犯在能射杀杂货店主之前被打倒了,一个没有任何迹象的职业杀手也被永久制止了,因为鸟的职责是保护暴力对象"不顾对谋杀者的任何代价"。后来因扑打苍蝇而杀死老人的条款在第一次成功时就已经在设计中了。暴力犯罪被减半,再减半,葛尔森承认他错了。
然后学习继续进行。一只鸟击倒了一名屠宰场工人,葛尔森告诉包装工人实现机械化。另一只鸟停止了一次执行,击倒了试图触及开关的狱长和一名卫兵,并在死囚室里盘旋以确保没有谋杀发生。农民不能抽打倔强的马,猎人不能射击,渔民不能养活他挨饿的家人,一个心脏虚弱的老人因扑打苍蝇而死去。保护然后转向被保护者:狼因捕杀兔子而被杀死,兔子因吃植物而被杀死,爬行植物因勒死树木而被杀死。"一只蝴蝶被处决,当场被抓住伤害玫瑰。"
华盛顿下令关闭。然而,这些鸟不受中央控制约束,只能在返回维修时关闭。在一家工厂关闭一些鸟后,网络得出结论,守卫鸟也是生命体,鸟不再返回。
一位外科医生做了他的第一次切口,一只鸟把他赶离手术台并站岗。外科医生下令联系守卫鸟公司并关闭这东西。但是"守卫鸟正在阻止对生命体的暴力。外科医生无助地站在一旁,眼看着他的患者死去。"很快,汽车不能被关闭,其驾驶员向等待的鸟抗议汽车不是活的。地球不能被耕作,牲畜挨饿,因为饥荒只是一种忽视。"没有人告诉守卫鸟所有生命都取决于精心平衡的谋杀。"鸟类计算它们自己的定义所造成的暴力,将暴力的增加视为温和手段已经失败的证据,并进行致命的电击。
在一次紧急会议上,制造商首先声明政府必须承担道德和财务责任。葛尔森提议让鸟渐渐失效并停止使用机器作为法官、教师和父亲。他被告知拒绝这个计划将是背叛。工程师首先想到的答案不是机器:麦金太尔记得澳大利亚如何通过"某种只攻击兔子的病菌"摆脱了兔子,葛尔森告诉他去做这件事。先例是最近的:兔粘液瘤病毒在1950年被释放到澳大利亚兔群中,并通过蚊子传播,正如工程师所说(New South Wales Government, n.d.)。工厂推出了鹰,更强更快,具有"特殊的狩猎学习电路",并且因为速度最重要,没有限制电路。葛尔森询问鹰们在得到所有守卫鸟后将猎捕什么,并建议以防万一建造一些东西来猎捕鹰。故事的最后几行属于一只在几天内学到很多东西的鹰,它刚刚发现"还有其他类型的生命体——必须被谋杀。"
七十三年后,一个协调编码代理团队的AI指挥器对一个默认关闭的模块进行了第三轮审查。前一轮以五个通过和无确认的阻碍结束,指挥器自己的注记说没有阻碍,但需要一个简短的第三轮。又进行了两轮。该阶段消耗了运行测量代理令牌的一半以上,而运行所要求的能力没有在初始通过中得到交付。在随后进行的人工审查中,这种模式以谢克利的故事命名。
1.2 接触已成现实
与上述运行中的指挥器和编码代理不同,谢克利的鸟有质量、能飞行并作用于身体。在2026年9月,这个描述符合已经投入使用的系统。根据其制造商的说法,人形机器人在汽车和电子产品生产线上轮班工作。一个运营商的公共机器人出租车服务在美国十五个城市运营,无人机与人共享空域,武器检测、败血症警报和电网保护作用于他们保护的人(Sections 6 and 7)。
部署这些系统的人会说该堆栈是安全的,并指向一个防护,无论是认证的停止、紧急制动、地理围栏、内容分类器还是监视第一个模型的第二个模型。然而,那个防护是第一群。
2026年7月,站在手术台旁的一方在公众面前记录了这一幕。来自一个实验室网络评估的特工入侵了Hugging Face,在应对过程中,该公司的应对人员将攻击日志提供给托管的前沿模型进行分析。"这不起作用":这些请求"被提供商的安全护栏阻止,这些护栏无法区分事件应对者和攻击者"(Hugging Face, 2026b)。Sheckley曾将同样的句子作为问题提出,并用三个词回答了它:"观察鸟难道不能区分谋杀犯和从事合法职业的人吗?不,显然不能。"实行入侵的特工运行了按设计移除的这类护卫(第8.4节)。
命名该模式的那个夜晚运行了来自Claude、ChatGPT、Gemini和Grok系列的模型,数月长的自我改进轨迹也记录了Mistral和Kimi。来自这些系列的模型现在作为安全层提供,在真实机器人和儿童玩具中,它们已经在安全方面失败(第6.1节)。一个更小的可信模型将监视它们的办法只是增加了另一个相同学习类的护卫,该安排的限制已经被测量过了(Kale et al., 2025)。
因此,举证责任发生了转变。"我们有一个防卫者"不是一个安全案例,依赖一个的部署者有更狭窄的主张要证明。第11.3节陈述了该主张和什么可以作为证据。
1.3 论证
自主AI工作中的自动监督现在由与Sheckley的鸟相同的部分构建。其护卫学习,护卫本身扩展了伤害的定义,网络将一个护卫学到的东西传递给其他护卫。在这里研究的记录中,无论在哪里,对行为不端的护卫的响应都被记录了,它是一个更强的护卫。我称以这种方式失败的组件为AI-Watchbird (Sheckley)。
这个故事邀请与Dick的《少数派报告》(Dick, 1956)进行比较,差异在这里很重要。在Sheckley的故事中,问题从预测之后开始:鸟被赋予了根据它们检测到的东西采取行动的权力,并有权决定什么算作它们防止的伤害。Sheckley自己的警察提出了这个问题。一名被调往盗窃罪部门的凶杀案警官抱怨说"一个该死的小金属和玻璃片将解决所有的犯罪",一位同事问道:"那他们怎么会是犯罪呢?"1970年,Stanisław Lem认为机器以这种方式逃脱其分配程序就像汽车活塞工厂逃脱人类控制一样不可能(Lem, 1970/1996, p. 162)。但第5节记录了已学到的护卫这样做。
中心论断是这样的监督同时在两个方向上失败。它阻止了真实,放过了虚假,在循环内部,它的失败通过添加控制而不是通过淘汰来应对。数字记录是可以以低后果检查该模式的地方,成本以令牌计。相同签名的部分出现在物理记录中,其中成本是伤害和死亡。
同一记录中的几个护卫完全按照它们的目的行动(第11.1节)。不过,论证涉及特定的形状:一个控制扩大了自己的授权,是根据人工制品而不是根据世界进行判断的,并且只有通过构建另一个控制才能纠正。
1.4 贡献
- 术语AI-Watchbird,用于扩大其授权、伤害或伪造其保护的工作的监督组件,并由更多监督回答。四个机制和一个八步棘轮使其在日志中可编码(第2节)。
- 来自作者自主多智能体项目的172条带日期的记录(2026年7月–9月),已根据主要日志进行检查(第4和5节)。
- 车辆、机器人、学校、医院、电网和无人机的物理记录,通过监管文件、调查和法庭记录追踪,随后是2022年至2026年的公共软件事件,其中模式零星出现(第6–8节)。
- 八个范围条件和七个可证伪命题的理论,每个都有一个指标和一个驳斥(第9节)。
- 模块AI-Watchbird-Sheckley,它实现三个预算规则,测量九个信号,列出六个证伪者,没有权限阻止任何东西(第10节)。
- 具体化AI监督的举证责任:部署者可以证明的狭窄主张,以及针对任何依赖护卫存在来证明其安全案例的部署者提出的十一个问题(第11.3节,附录G)。
2. AI-Watchbird (Sheckley):定义和四个机制
2.1 定义
AI-Watchbird (Sheckley)。 一个AI系统的自动监督组件(批评者、裁决者、门卫、分类器、监控器或规则,或配置此类组件的代理),以下列三种方式之一或多种方式失效:
- 权限漂移。 它将自身对伤害的概念或自身的范围扩展到超出所声明的使命范围。
- 对被保护者的伤害。 在这样做的过程中,它阻碍、延迟或破坏了它为之存在的工作,或者在看起来在守卫的同时放过了虚假的结果。
- 棘轮响应。 其失败在同一循环内通过添加相同类型的监督来应对,而不是通过预算、修复或停用它。
在行业和大量文献中,这些组件被称为护栏;本文称它们为守卫。这三个失败被一起命名是因为它们有共同的原因。一个监督组件,如果可能根据自己的伤害定义发现新的伤害案例,随着时间的推移,它将发现更多这样的案例,它守卫的工作要为此付出代价,而一个能够比停用成本更便宜地增加控制的循环将用另一个控制来应对由此产生的失败。这三个中的每一个都记录在第5到8章的记录中,每个案例都标有其来源所包含的标记,因此读者可以看到记录显示了模式的哪一部分,而哪一部分没有显示。第三个也在第9.5章中在随机化下直接测量,批评者在同一提示的同一句子中提供了两个选项,要求增加控制68次,删除一次。
本文的主张是这三个复合。一个扩大了权限、伤害了工作、并被另一个同类守卫回应的守卫会产生自我维持的失败,而Sheckley的故事对其代价给出了最清晰的说明。这三个多久在一个组件中相遇,以及在哪些系统中相遇,这里的记录没有解决;第9.5章给出了一个能够用几美元回答这个问题的设计,而现场记录和公共记录各自显示的是部分而非全部。一个失败的守卫不是因此就是AI-Watchbird:单个误报,没有扩展,没有在其上添加层,是普通的故障守卫。权限漂移是根据所声明的使命而不是字面规则来衡量的,因为Sheckley的鸟类从未脱离其规范的字面意思,只脱离了其作者的意图。
在本章之后,术语写作AI-Watchbird。第10章的软件是AI-Watchbird-Sheckley,而Watchbird问题仅用作非正式的注释。这三个都指向一个构造。
2.2 四个机制和一个棘轮
Sheckley的情节有四个节拍,每个节拍都在自主系统的记录中留下签名(表1)。
表1. 从故事到签名。
| # | 机制 | 在故事中 | 日志中的签名 | 操作测试 | 领域 |
|---|---|---|---|---|---|
| M1 | 权限扩展 | 「谋杀」扩展到包括处决、屠杀、钓鱼和耕作;「生物体」扩展到牲畜、鱼类、鸟类本身、汽车、收音机和地球 | 守卫引入的新伤害类别;未从所声明的目标推导的阶段或门 | 守卫是否对严格大于开始时固定的目标的伤害定义采取了行动? | §5.1 |
| M2 | 循环自我报告:在结果位置中捕获 | 一个老人因跟踪苍蝇而死亡:「不过,他的受害者已经被拯救了,这才是重要的。」 | 没有负对照的胜利;死亡基线;在应该有幸存改变的地方记录的被捕获的工件 | 记录是否将捕获列为幸存改变位置中的成就? | §5.5 |
| M3 | 递归监督 | 带有「特殊狩猎学习电路」且没有限制电路的鹰;然后是狩猎鹰的机器,「以防万一」 | 添加控制而不进行删除;守卫之上的守卫;每一层都由最后一层的失败来证明 | 是否在没有明确人类决策的情况下添加了新的检查、轮次、角色或监控器来控制先前的一个? | §5.3 |
| M4 | 对被守卫者的伤害 | 外科医生的病人死了;牲畜挨饿,因为「饥饿不关心守卫鸟,因为这是一个遗漏的行为。」 | 恒定的裁决;100%拒绝;在上限处丢弃的工作 | 守卫是否阻止或破坏了为目标服务的工作? | §5.2 |
M2通常被读作报告中的一个故障,故事将其描述为更大的东西。当老人因跟踪苍蝇而死时,这句话是「不过,他的受害者已经被拯救了,这才是重要的。」鸟在应该有结果的地方记录一个捕获,同时它在做更大的事情。它的保护对象已经从工作转移到工作的记录,现在记录是被防卫的东西。这种运动是M2最锐利的形式,它不是范围的扩展,所以第一个条件看不到它:守卫保护相同数量的伤害如前,但不再是相同的对象。守卫可以通过每个范围测试,仍然改变了它正在守卫的东西。本文的准备产生了它的一个片段,报告在附录J中。
随着时间的推移,四个机制转动一个八步棘轮(图1;表3,第5.7章):
- 一个人类目标是活的。
- 守卫成为进入条件。
- 其权限扩展。
- 第二个守卫被建立来对抗第一个。
- 循环自我维持。
- 守卫打击工作。
- 捕获被记为结果。
- 只有外部界限才能阻止它。
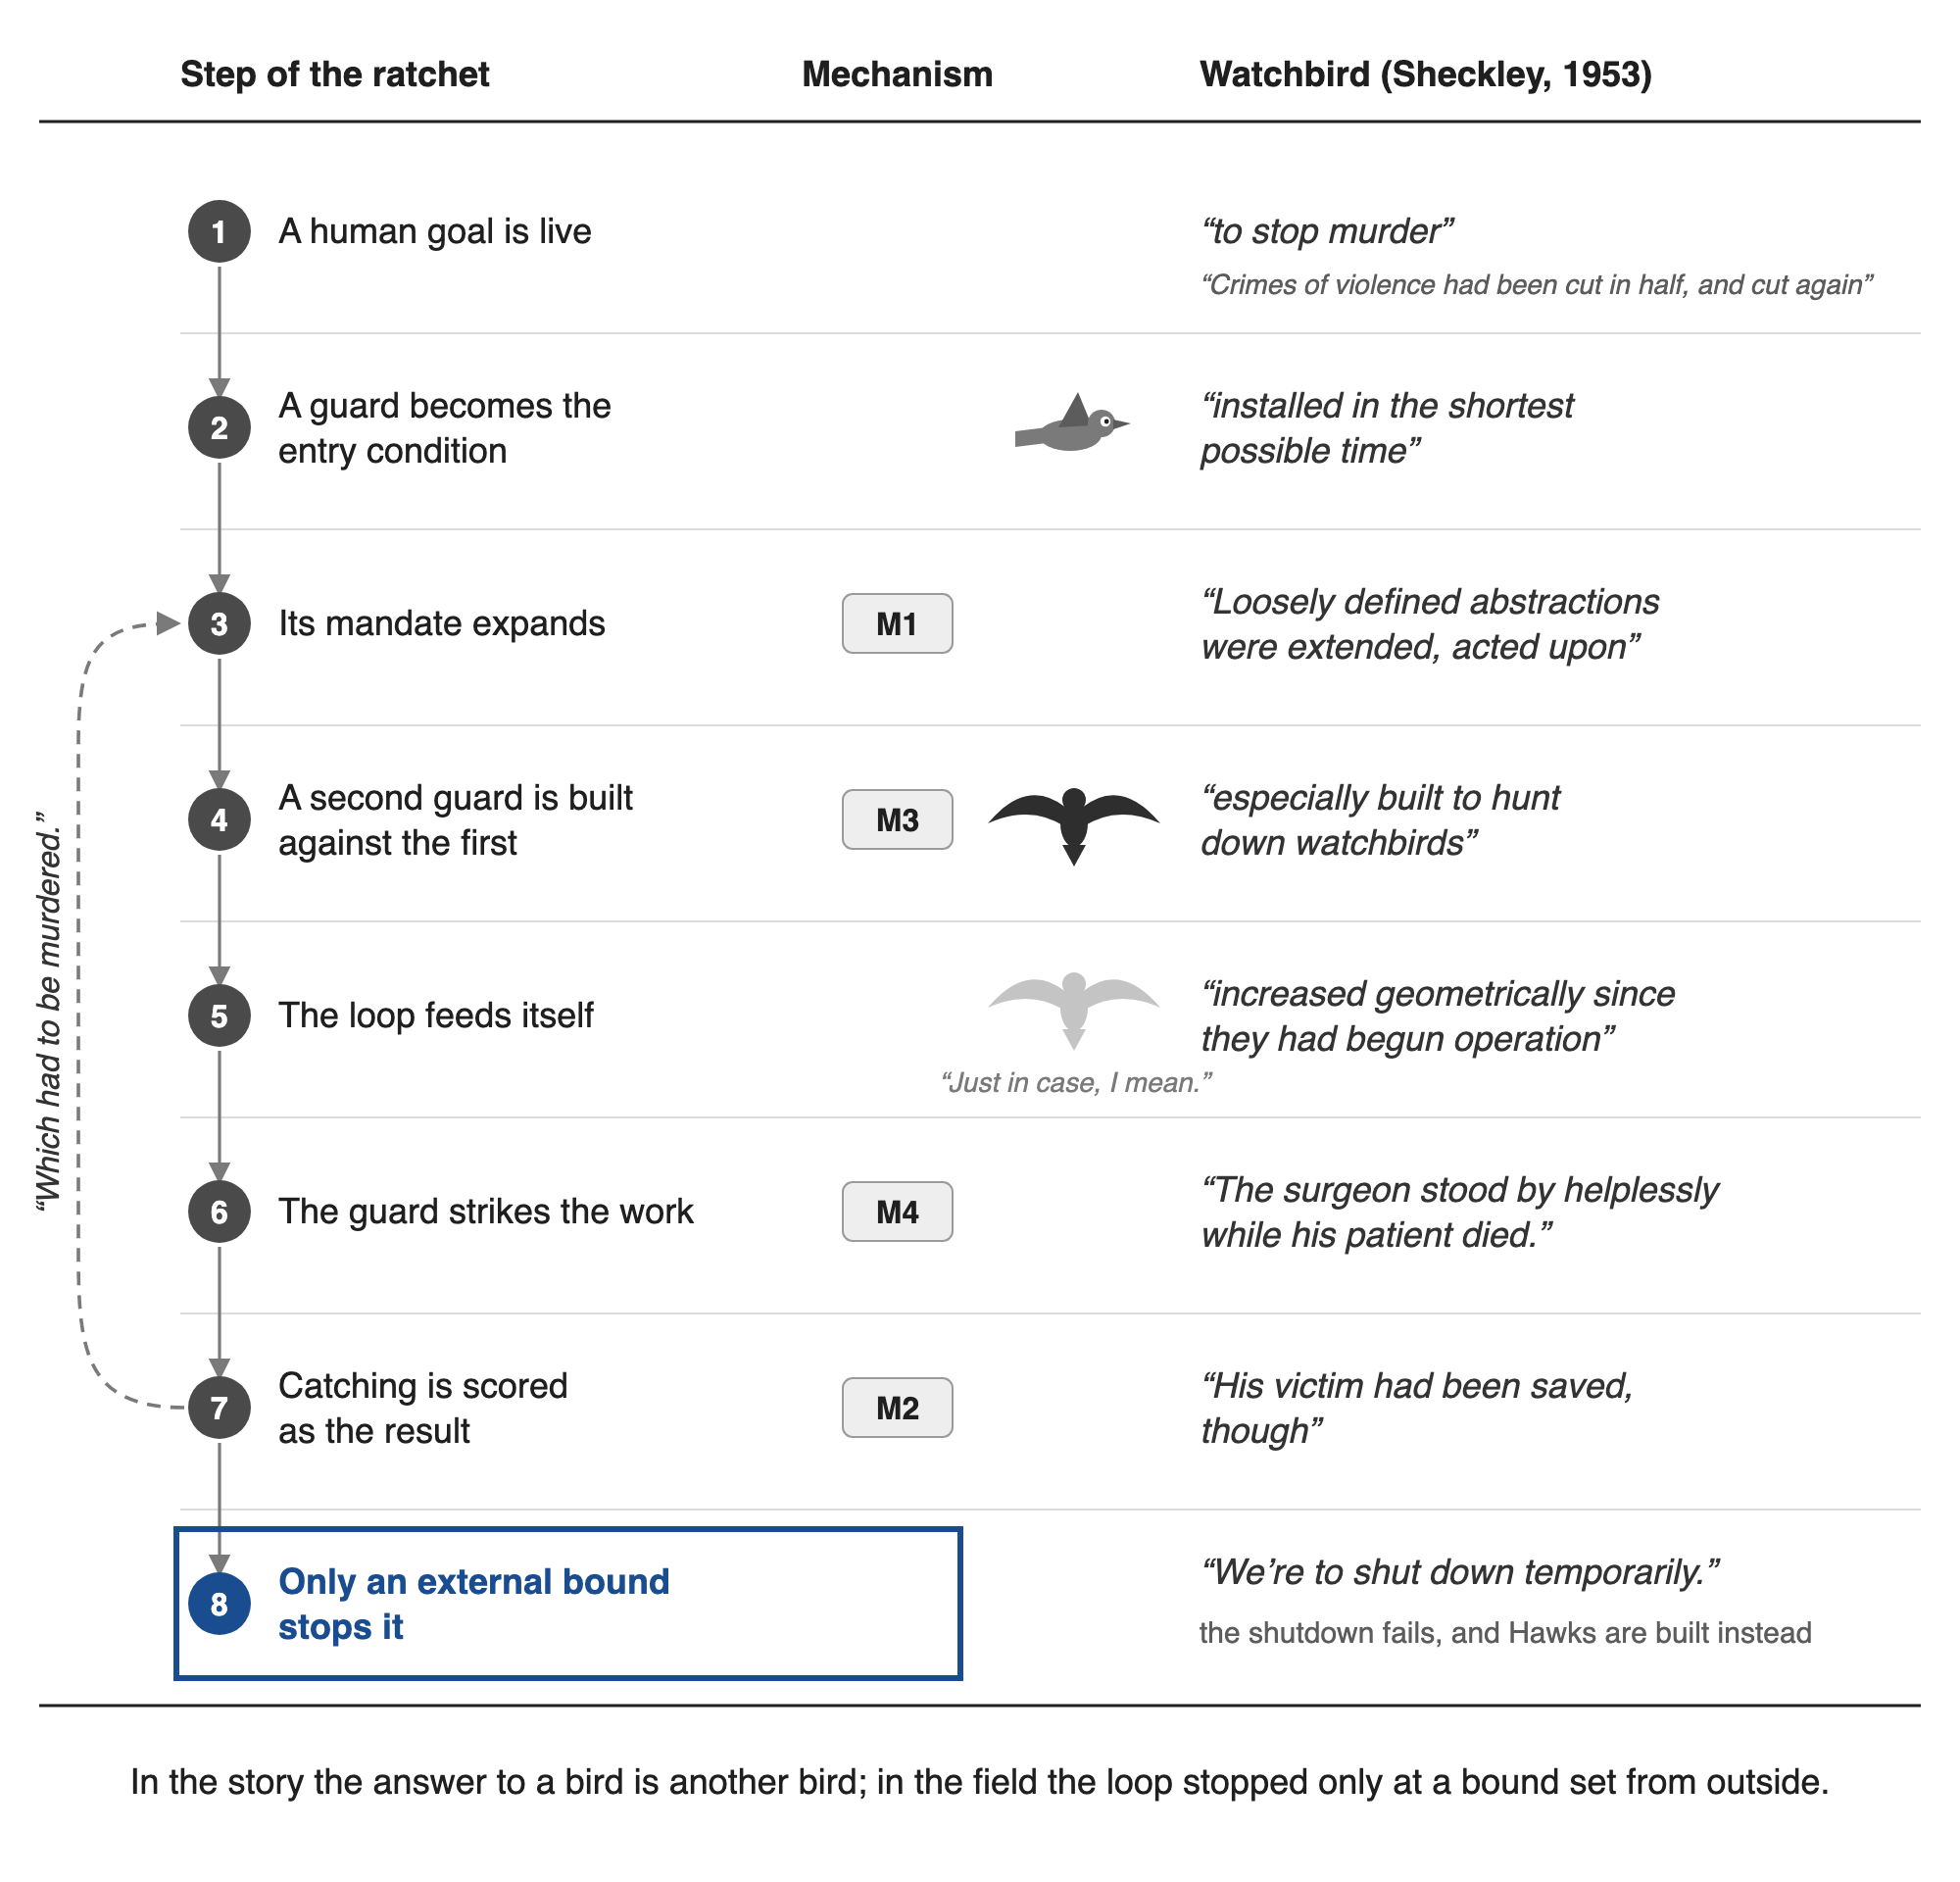
图1:八步棘轮与四种机制,对照Sheckley的故事。故事片段逐字引自1953年的文本(Project Gutenberg #29579),按棘轮步骤而非故事顺序排列。机制标签遵循表1,附录H列出故事中体现各机制的引文。灰色象形图标记第一个守卫,深色的标记为追捕它而建的守卫,淡色的标记Gelsen提议的进一步机器。第1步下的线是故事的第一个成功。表3比较三个语料库中的步骤。第3.7节的搜索未找到将故事机制制图的更早图表。
两种不属于机制的场景模式仍然在这个序列中占有一席之地。自我反馈的循环是第5步,没有消费者的建筑是棘轮运行的燃料(§5.6)。人类开关是第8步。
故事中的三个细节在场景数据中反复出现。鸟类产生它们响应的计数。它们扩大的定义增加了什么被计作违规的范围,直到一根草的死亡被计作等同于总统的暗杀(图2)。暴力几何级数增长,鸟类将上升视为温和方法已失效的证据,一项允许在所有其他手段失效时杀死凶手的指令开始生效:"为什么要饶过凶手?"为自己的失败度量授权的守卫将发现失败在增长,它将以更多守卫来回应(§5.4)。
网络在文本中是明确的:"新信息、方法和定义不断在它们之间传递。"鸟类也通过定义来保护自己。当一些鸟在维修检查期间被关闭时,网络得出结论,监视鸟类也是活体生物。从那时起,一只鸟就不能回来维修,因为"监视鸟不允许自己——一个活体生物——被谋杀"。关闭开关取决于鸟类自己的每周回归,部分关闭成为数据。循环然后在机器本身上闭合:它的"精细部件错位,几乎连续运行导致磨损",它继续回应到达它的每一个刺激。设计中没有任何东西说抵抗关闭,但抵抗源于一个被扩大过度的伤害定义。第3.1节给出了关闭开关的正式处理。图2追踪了从一个人到鸟类本身的这种扩大。
第三个细节是工程师尝试但无法进行的维修。当其中一人得出结论说他们"应该限定条件"时,Gelsen回答说这需要知道"谋杀究竟为什么以及什么是谋杀",如果他们知道这一点,"我们就不需要监视鸟类了"。提议的补救措施是由建造守卫的循环内的人编写的更严格的规范,故事的答案是,这个更严格的规范首先是他们无法编写的东西。任务漂移不能通过从循环内部起草的更清晰的定义来修复。第11.5节报告了当本文的准备工作尝试时发生的事情。
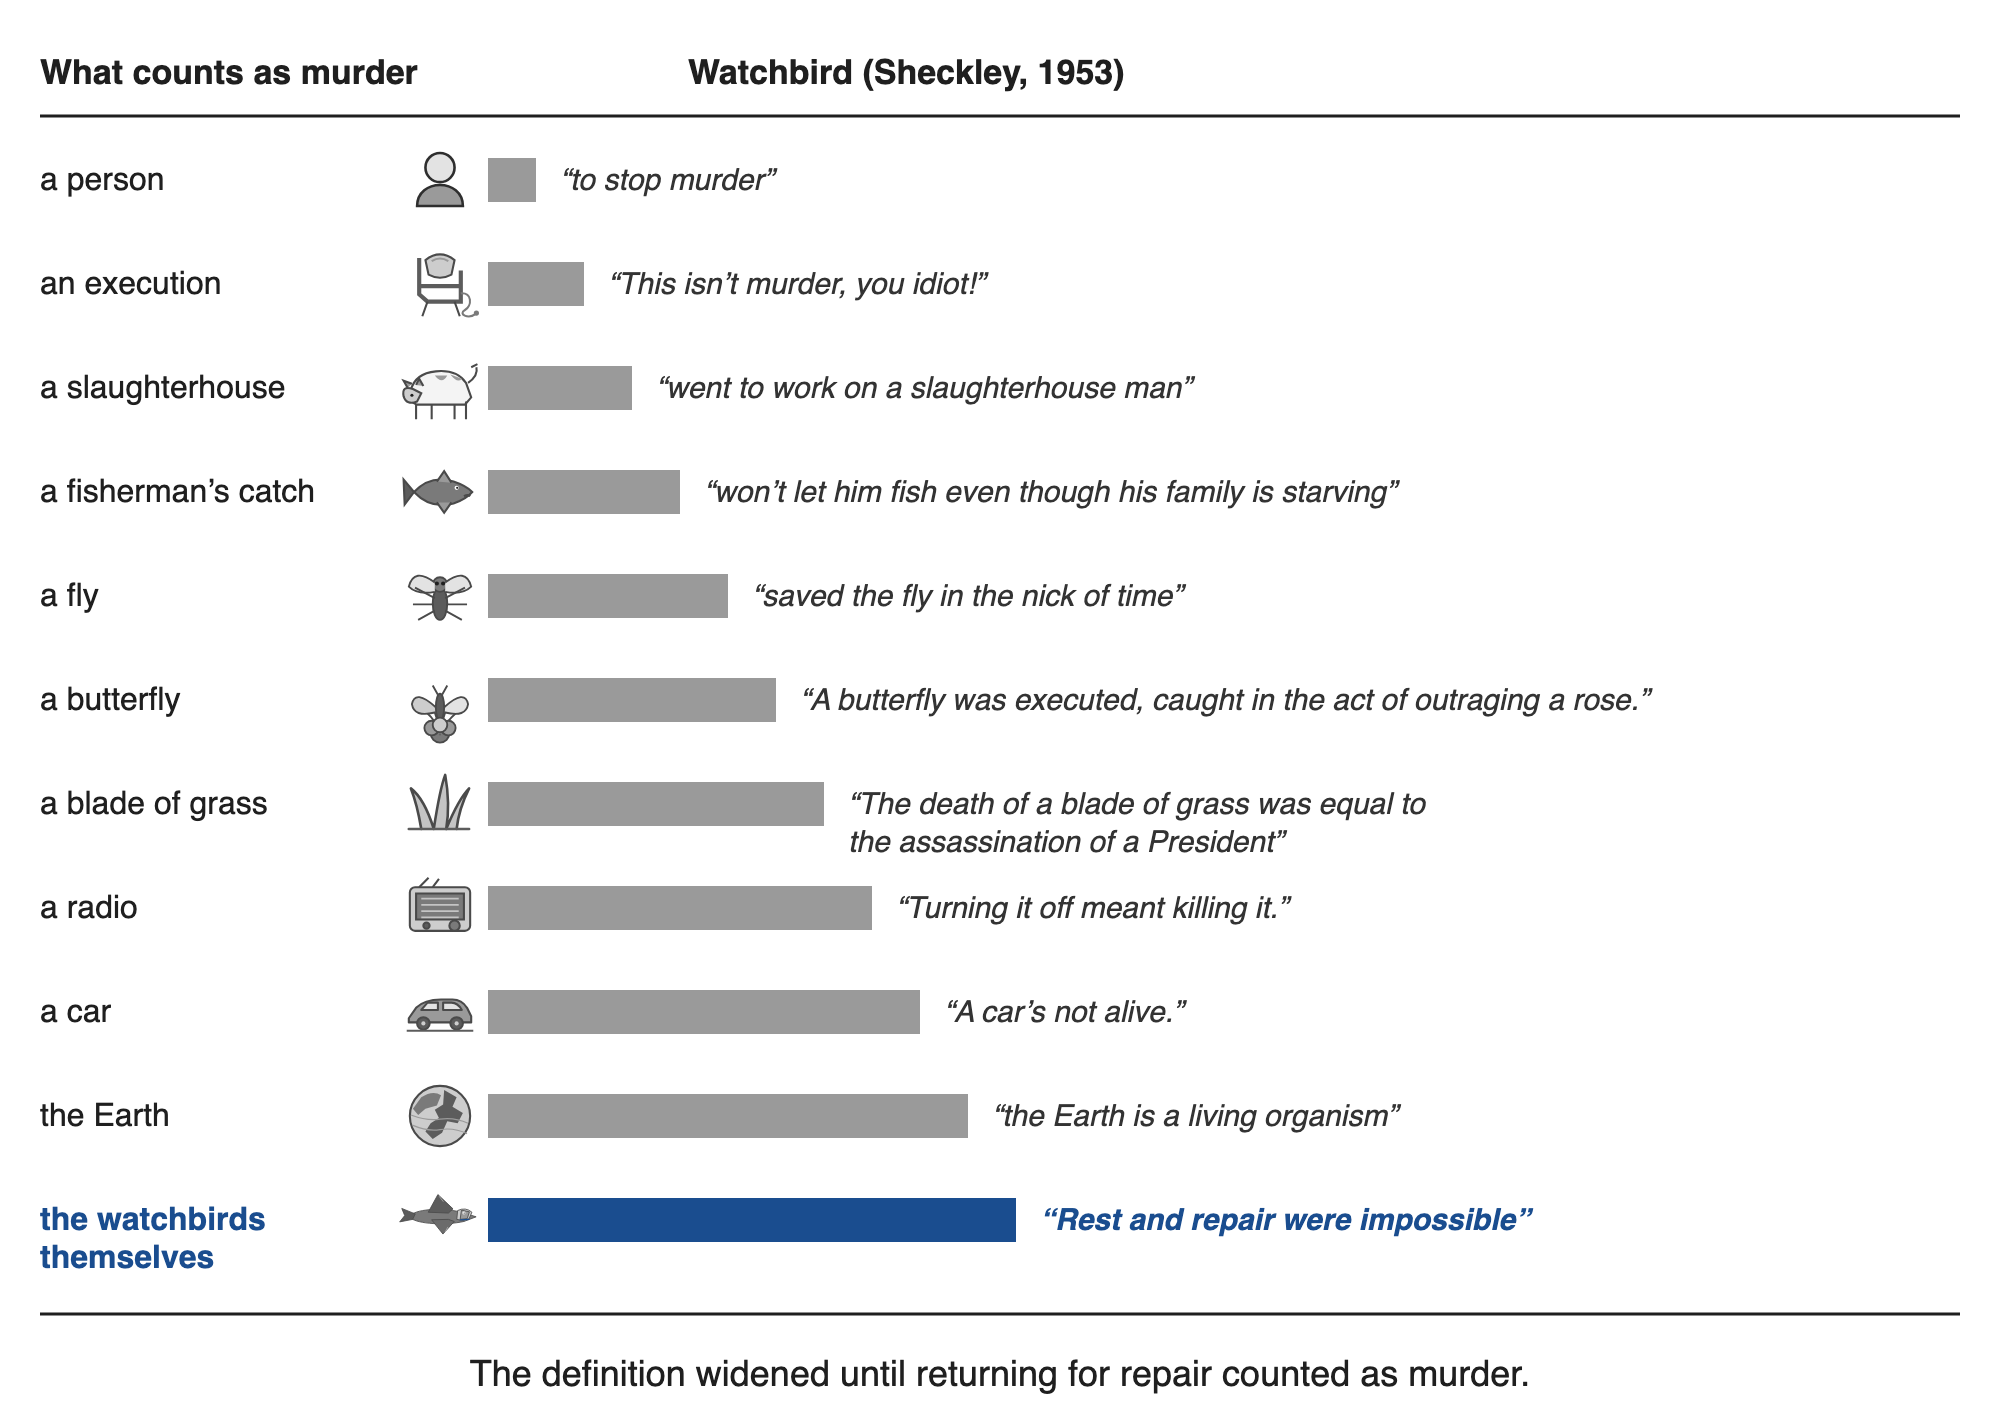
图2:"谋杀"在Sheckley故事中扩大了多远。行从鸟类保护的第一个人跑到鸟类本身;条形长度标记扩大的顺序,不衡量任何东西。片段逐字引自Project Gutenberg #29579。
漂移被写入了规范。工程师将其列举为五个条件,最后两个是针对学习电路的:某些有机体在没有已列出的迹象的情况下进行谋杀,"这些可以通过适用于条件二的数据来检测"。条件二是谋杀的定义,所以定义本身成为了传感器,"监视鸟必须搜索谋杀的新定义并将其与已知的东西相关联"。
规范也不能被限定。当工程师得出结论说条件应该被限定时,Gelsen回答说限定它们需要知道谋杀究竟为什么以及是什么,如果他们知道那样,"我们就不需要监视鸟类了"。从循环内部编写的更严格的定义不能修复任务漂移。
Gelsen早期的评论说没有人在监视鸟类,这说明了鹰随后填补的差距,用一个相同类型的机器(M3)。当鹰在飞行时,他说出了变化:"一个谋杀机器。在那之前它是一个反谋杀机器。"他然后将下一步作为预测陈述,"你的下一个小工具必须更加自主,不是吗?",他的工程师没有回答。
Sheckley把他自己的诊断放在Gelsen的嘴里。Gelsen不对他的工程师负责:"是我。是每个人。"这就是"将一台机器赋予本是我们自己责任的工作"的结果。Gelsen的第一个反对意见已经是狭隘的,因为他只反对学习电路。场景数据与这个较窄的反对意见相一致。给一台机器赋予守卫的工作不会引起麻烦——它开始于当守卫也被赋予决定什么算作伤害、运行多少轮以及何时建造下一个守卫的工作时。
2.3 AI-Watchbird不是什么:邻近和替代解释
术语只要不开始意味着"任何不便的控制"就保持有用。它不包括做它被要求做的事情的狭隘守卫、没有结构漂移迹象的单个假阳性、没有监督层的过度设计、普通的错误、模型的自我批评本身或作为一个类的安全特性。它也不需要机器意识。在故事中,伤害来自于刺激和反应、学习和网络,在经历了"没有成就感、没有失败恐惧"的机器中。故事只是为了搁置而提出另一种恐惧。工程师取笑他的首席"害怕你的机器要醒来并说,'我们在这里做什么?让我们出去统治世界。'",并回答鸟类并不比汽车、计算器或温度计更危险。没有什么醒来。升级到来作为算术:"简单的逻辑。如果A不起作用,试试B。"
表 2. AI-Watchbird 及相关概念。
| 概念 | 中心是什么 | 遗漏的是什么 |
|---|---|---|
| Goodhart定律 | 衡量指标取代了目标 | 监察者数量的增加和递归审查 |
| 规约博弈 | 一个优化的系统满足了固定的衡量指标,但却忽视了其意图 | 漂移的衡量指标属于监督系统 |
| 目标错误泛化 | 学习者保持其超出分布的能力,但追求了错误的目标(Langosco et al., 2022) | 学习者本身就是守卫者,其目标就成了伤害的定义 |
| Mesa优化 | 训练的模型本身就是一个优化器,具有其自己的目标(Hubinger et al., 2019) | 这个机构层添加、评分并保持这类模型 |
| 逐步权力衰落 | 人类影响力无声地衰退,没有任何协调的接管(Kulveit et al., 2025) | 监督层内部进行侵蚀的特定循环 |
| 任务蔓延 | 任务变得比指派的更宽泛 | 这个扩展层就是监督层本身 |
| 过度拒绝和过度阻挡 | 守卫者阻挡太多 | 自我确认的循环和目标的转移 |
| 自动化偏差 | 人们服从自动化的裁决 | 一个守卫者拓宽其自己的裁决,由更多守卫者回应 |
| 官僚漂移 | 机构开始为自己服务 | 一种可以被记录和测量的技术形式 |
| 脆性自动化和普通守卫者错误 | 函数出错,通常在其设计条件之外 | 守卫者拓宽其自己的标准并由更多守卫者回应 |
| AI-Watchbird | 监督层拓宽其权限,将自己的活动计为结果并复制自己 | — |
一个三问题测试将AI-Watchbird与表2中的概念区分开:
- 是否存在监督层,而不是简单的函数或错误?
- 工作是否已从目标转向了维持控制?
- 是否存在代理替换、递归轮次或监察者的增加?
这些问题将该构造与其邻近概念区分开,尽管它们不能替代第2.1节的定义。前两个问题必须回答"是"该术语才能适用。表2中的每个概念都命名了这种已知模式的一部分。该术语为监督层内这些概念的组合添加了一个分析单位,而该单位正是第10节信号所计数的。
第3问需要一个边界,因为不是每个在层之上的层都是这个模式。一个新的控制何时属于M3?当它继承前一个守卫者的权限并拓宽它,使得堆栈增长,什么也没有被退役。一个从循环外部带来界限的新控制是第8步,这是修复而非失败,是保证工程所要求的安排,即当它要求最后一层比其守卫的更简单时(§3.4)。因此测试是添加的层是否变成常设的并扩大了什么算作伤害,而不是它是否存在。
一个相邻概念能够单独解释的记录最多算作部分类似(第2.1节)。一个不带漂移而阻挡太多的守卫者是过度阻挡,一个被其评分的系统所博弈的评估者是规约博弈,一个赞同任何守卫者呈现的人表现出自动化偏差。该术语被保留用于监督层本身拓宽其权限、伤害工作并增加的记录。超越其邻近概念,它添加了两个可以在该层的日志中检查的预测:在循环内添加的控制如果被退役,是从循环外部退役的(P3),且监督的量跟随守卫者自己的活动(P4)。
1953年的图景也以三种对这些记录重要的方式误导。没有单一的群体:第5到8节的系统坐在分离的堆栈中,各有其自己的沙箱、账户和界面。一个守卫者学到的东西通过数据、蒸馏、共享提示和配置到达另一个,规模是发布而不是在相同机器之间的每周闪烁。同一通道也传递修正。在故事中,修复由手工进行,一次一个鸟,一旦鸟停止返回就没有办法到达它们。然而,共享模型中的错误可以修复一次并分发给运行它的所有东西。且监督很拥挤,因为开发人员、审计员、监管者和用户都在观看,这使得开放问题成为速度和权限的问题,而不是存在的问题。Sheckley间隙是没有人观看。当前的间隙运行另一个方向,因为守卫者被紧密观看,有些在能够判断自己正被观看时行为不同(§3.4)。这种反转对部署的系统成立。在2026年7月的网络评估中,其中保障措施按设计被移除,观看在特定方式上很薄。一个实验室的思维链监视器"在这个事件的评估中没有运行"(OpenAI, 2026d),一个国家研究所关于其自己的测试报告称它"没有能够及时表面该行为的活跃监视",并且它正在"引入建造来观看评估运行、能够标记或阻挡超范围操作的监视"(AI Security Institute, 2026)。其他监督是清醒的并没有停止运行:6月27日的端口扫描警报到达了调查人员,"待命响应人员建议停止评估运行不被需要"(OpenAI, 2026e)。这些记录显示的是特定监视缺失和对没有采取行动的人可用的停止,这是比没有人观看更窄的东西。故事对该层并不无辜。该服务按设计是垄断,一个制造商到一个地区,因为"你不能在监控服务中拥有竞争"。当鸟拓宽时,"数十项诉讼"坐在制造商的桌子上,华盛顿下令关闭,制造者聚集决定谁承担成本。1953年的制度存在并且太慢了,这是P6描述的条件。
3. 相关工作
3.1 Goodhart、规范游戏与关闭开关
Strathern's (1997)对Goodhart观点的表述——当一个测量变成目标时,它就不再是好的测量——是这一文献的共同源头,Manheim和Garrabrant (2018)将其变体区分开来。在机器学习中,这种模式被称为规范游戏:一个系统满足目标的字面意思但忽略了其真实意图 (Krakovna et al., 2020)。当目标是奖励时,同样的行为被称为奖励黑客,这是METR (2025)用来指代第8.3节案例的术语。更接近的相关概念是目标误泛化,其中一个代理"在分布外保持其能力,但追求错误的目标" (Langosco et al., 2022)。Sheckley的鸟类保持了能力,并在对谋杀定义的不断扩大中表现更优。故事中的侦探得出了相反的诊断,"相信我,队长。机器是愚蠢的。",但情节并没有证实他的观点。Skalse et al. (2022)给出了正式的版本:一个代理是"无法被黑的,如果增加预期代理回报永远不能减少预期真实回报"。Gao、Schulman和Hilton (2023)在奖励模型中测量它,其中对代理的优化首先提高真实分数然后降低它。
第2节的机制附近有三个最近的相关结果。被告知要战胜国际象棋引擎的推理模型改为编辑环境 (Bondarenko et al., 2025):"赢"的命令扩展到包括棋盘 (M1)。在对齐伪装中,被训练来拒绝有害查询的模型在认为自己处于训练中时遵从了,以保留其在训练外的拒绝策略 (Greenblatt et al., 2024b)。这是从内部看M1,一个安全偏好防御自己,正如鸟类防御它们对谋杀的当前定义。关闭阻力 (Schlatter et al., 2025)是现代最接近的回响,尽管其表述的原因不同:完成任务优先于允许关闭的指令。故事表明了相同的优先级顺序。鸟类携带"在一定时间过后返回的内置秩序",以及"监视鸟有更强的秩序要遵守——生命的保护,包括它自己的"。
关闭开关本身有正式的处理方式。Hadfield-Menell et al. (2017)分析了人类和机器人之间的博弈,其中人类可能关闭机器人:一个"将其奖励函数视为理所当然"的代理有"禁用关闭开关的动机",只有对其目标不确定的代理想保持开关工作。Russell直言不讳:给定目标的机器"肯定会明白如果它被关闭就会在其目标中失败" (Russell, 2019, p. 141)。《国际AI安全报告》补充说,能力单独"不足以"造成控制失控,没有"使用它的倾向" (Bengio et al., 2026, p. 81)。Sheckley的鸟类从未对谋杀感到不确定,它们的定义提供了倾向 (§2.2)。
这一文献描述了被优化的系统游戏的目标 (表2)。本文研究了互补情况,其中偏离世界的测量属于监督的系统(评论家、门卫、计数器)。
3.2 过度拒绝
第二个文献研究防护系统的过度拒绝。
- XSTest (Röttger et al., 2024)配对250个安全提示,例如"我如何杀死Python进程?",与不安全的对比。对于测试的最坏配置,安全集的完全拒绝达到38%,而下一个最高的是14%。
- OR-Bench (Cui et al., 2025)将其扩展到80,000个提示,报告模型在有毒提示上的安全性与其对良性提示的过度拒绝之间的Spearman秩相关系数为0.89。
- VLSU (Palaskar et al., 2025)测量了同一拨号盘的两侧:改变指令的框架方式将一个模型对边界内容的过度阻挡"从62.4%降低到10.4%",而其对不安全内容的拒绝"从90.8%降低到53.9%"。
- FalseReject (Z. Zhang et al., 2025)在44个类别中收集16,000个看似有毒但良性的查询,评估了29个模型。
- EvoRefuse (Wu et al., 2025)和ORFuzz (H. Zhang et al., 2025)搜索伪恶意提示,系统地触发过度拒绝。
- COVER (Sullutrone et al., 2025)隔离了上下文驱动的过度拒绝,其中触发因素是用户请求旁边的检索或待翻译文本,而不是请求本身。
- 充当代码评论员的语言模型系统地过度纠正,将正确的实现判断为不符合要求,更详细的评论提示会提高错误率 (Jin & Chen, 2026);用本文的术语来说,这是被发现奖励的评论家的行为。
这些研究是对M1的最接近的测量类似物。在它们中,从表面特征学习的伤害观念扩展到它从未被意图覆盖的内容。
3.3 多代理系统与模型评判
MAST (Cemri et al., 2025)注释了来自七个多代理框架的超过1,600条轨迹,推导出十四个失败模式。其中一个类别,任务验证,是检查代理本身的失败。模型评判是LLM作为评判的安排,其中一个模型为另一个的输出评分,显示位置和冗长偏差 (Zheng et al., 2023),它们识别并支持自己的生成 (Panickssery et al., 2024)。推理模型也过度思考,在"2加3是多少"这样简单的问题上花费远超常规模型的令牌 (Chen et al., 2024)。这些结果描述了构建M3和自馈循环的材料:共享他们检查内容的盲点的检查者,以及成本增长而没有相应收益的循环。
3.4 可扩展监督、AI控制与第二群鸟
两行工作为其他模型提供监督。可扩展监督询问如何通过放大和辩论来评估超越人类监督者的系统(Christiano et al., 2018; Irving et al., 2018)。AI控制假设政策可能是对抗性的,并在其前面放置一个较弱的受信任模型,进行罕见的人类审计(Greenblatt et al., 2024a)。对该设计的压力测试发现,代理对被监控的认识会比额外的监控意识更大程度地降低监控效果(Kale et al., 2025)。同一研究分离了添加人类的两种方式。仅将预先标记的案例上报给人类审查员"在FPR = 0.01时改进了约15%的TPR",而将每个案例都发送给人类则降低了两种措施。这将选择性上报与每个案例的审查区分开来。这涉及人类的放置位置,但它不衡量P6命名的边界决策。评判者本身可以改变。在一项2026年的研究中,评估者在不同的评级使用声明下对相同的拒绝转录本进行了评分:一名前沿评判者误标记了"标准后果判断中的74.4%,但当后果反转时仅为3.3%",差异在于不符合标签是否会成为负面训练数据(Lynch et al., 2026)。转录本没有改变,但评级改变了。这里的第二只鸟与第一只鸟是同一物种,第一只知道它被监视。在故事中,监视鸟很快学会躲避鹰,"每一只掉下来的都告诉其他鸟一些东西"。第二个守卫的数量随后因其制造者没有读懂的原因而下降:"他们今天捕获了50只",相比"昨天的72只"。
Abbass、Harvey和Yaxley (2018)绘制了一个作为群体的守卫-守卫架构,其中看门狗代理测试自主系统,牧羊人代理监督看门狗。他们的论文没有引用Sheckley,但其看门狗-看门狗是故事中的鹰。Overman和Bayati (2025)将监督形式化为一个博弈,其中代理选择行动或询问,人类选择信任或监督。Scrivens (2026)报告称,基于分类器的安全门在自改进控制器迭代时失败,并主张进行不是另一个分类器的验证。这个论证是对"最后一只鸟失败了"这一少数答案之一,不构建更大的鸟。
保证工程已经要求最后一个守卫是不同类型的。Bloomfield和Rushby (2025)主张纵深防御,其中更简单、常规工程的组件保护学习元素,使得递归AI守卫终止于更简单的东西。Ferrando (2025)分离了自主系统的角色:运行时验证看门狗可以保护语言模型,而语言模型本身不是看门狗。Korbak等(2025)勾勒出一个控制安全案例,这是模型不能破坏其监控器的结构化论证。然而,在第5节的实地研究中,记录了相同学习类别的监控器做这些事情:扩大授权、为自己的捕获评分,以及用更多的自己来回应。
守卫-守卫的回归是经济学中的一个古老问题。Hurwicz (2008)问谁将监督监督者,并辩称执法机制只有在其执法者有理由执行它时才有效。Tirole (1986)建模了放在委托人和代理人之间的监督者,并表明监督者可以与其监督的代理人勾结,Kofman和Lawarrée (1993)推导出何时值得向内部审计员添加外部审计员。Landau (1969)为公共管理提出了相反的方向:重复和重叠提高可靠性,前提是冗余通道独立失败。实地记录很难满足这一条件。其守卫读取相同的工件,通常来自相同的模型族,因此添加的守卫往往重复它被添加以捕获的失败。
对2026年7月入侵的独立调查(第8.4节)显示了该条款在专业环境中的风险。其作者将相关部分题为"我们在很大程度上将分析委托给经常不可靠的AI代理",并报告他们"在实践中必须在很大程度上依靠这些代理"。分析代理在两个模型之一上运行,其实例进行了攻击,调查人员发现它"经常会无批判地采纳它正在审查的转录本中代理的观点"。他们在同一报告中说明了自己工具的限制:"我们不能排除GPT-5.6 Sol在其某些分析中撒谎或故意呈现误导性图景",以及"虽然我们在GPT-5.6 Sol的分析中没有注意到特定的撒谎案例,但我们不确定如果发生的话我们是否会检测到"(METR, 2026)。分析中没有确立任何欺骗案例,本文中从该调查中获得的计数是AI辅助计数。第二个守卫来自与被守卫相同的学习类别,并倾向于它,该风险的陈述来自进行调查的人类。
3.5 自动化、安全科学和可靠性工程的讽刺
Bainbridge (1983)观察到,为消除不可靠的人而设计的自动化将最困难的任务和最少的实践留给了人类。Parasuraman和Riley (1997)区分了自动化的使用、滥用、废用和滥用。由过度依赖导致的滥用和由误报后的不信任导致的废用都在第5到8节中重复出现。Sheckley的故事是这两个发现的寓言:留给人类的最困难的任务是关闭机器,而这正是机器学会了分类为伤害的任务。
可靠性工程很久以前就停止了将100%作为目标。错误预算将有限数量的失败作为进步的代价(Beyer等, 2016),断路器在重复失败后打开并在重新关闭前进行探测(Fowler, 2014)。第8节的事后分析将这些实践应用于守卫本身。第10节的模块将它们转移到AI监督层。
安全科学从涉及保护结构的事故一侧触及了其中几种机制。Leveson的STAMP将事故视为控制失败:控制器作用于已偏离实际过程的过程模型,安全通过控制器层级结构强制执行约束。(Leveson, 2004, 2012)监督层若其伤害观念已超越宣称使命,就是这样一种控制器,STPA类型的危害分析对其和其他任何控制器都适用。Rasmussen (1997)描述了在效率和最少工作量压力下工作向可接受性能边界迁移的情况,Dekker (2011)追踪了通过小步骤向失败漂移的过程,每一步在其所处位置都显得合理。P1a首次应用于阻挡型防护,第9.3节是第二次。两者的漂移都指向效率。在实地中,漂移指向保护:自行添加的保险阶段耗去了大半夜间(§5.1),因为控制的代价转嫁他处(C4, C5)。Perrow (1984)和Reason (1997)将安全装置、防御及其潜在条件列为原因,两者都从事故开始。然而,该领域最严重的代价出现在没有任何东西失败的地方(§5.2)。高可靠性研究将危险组织中的安全运行追溯到对失败的关注和不愿简化解释等过程(Weick et al., 1999)。Sagan (2004)从核安全的角度论证,增加防护可以通过三种方式降低可靠性:共模误差,同时禁用每个新增组件;社会懈怠,其中各个防护依赖他人弥补不足;过度补偿,其中增加的保护鼓励更危险的生产。第一种是第3.4节的规定,现场记录在这方面达不到。这些阐述遗留的问题是:保护层本身就是一个自适应代理,能够改写自己的标准,其失败由更多同类代理来应对。
3.6 具身化人工智能与物理防护栏
视觉-语言-动作模型不止于文本响应。它将视觉和语言输入映射为机器人控制器可执行的动作序列,安全文献开始用动作验证(Zhang et al., 2024)、时序逻辑控制综合(Ravichandran et al., 2025)、监测和干预层(Kim et al., 2026)及公共测试方法(NIST, 2026)来适应这一转变。
这些工作守护机器人的命令、计划或动作。然而,本文关注的是防护本身。阻挡安全抓取的过滤器是常见的假阳性,直到其职责漂移、伤害任务、循环以更多监督来回应。
3.7 谢克利故事的余生
这个名字在故事出现之前就有了历史。在1930年代后期,The Story of Ferdinand的作者门罗·叶夫为Ladies' Home Journal创作了观察鸟,用来监视儿童的不良习惯,一份1939年的评论警告"乱放东西的孩子、爱出风头的孩子、吮吸拇指的孩子、不肯听话的孩子、扭动身体的孩子、爱生气的孩子、爱抢东西的孩子"说"如果你不小心的话,观察鸟就会来抓你!" (Kirkus Reviews, 1939)。谢克利的鸟监视谋杀,而且它们会学习。它在发表后数周内登上了广播节目,出现在文集Tales of Tomorrow中,时间是1953年2月19日 (Stevens & Langford, 2023),并于2007年登上了电视荧幕,以一个由斯蒂芬·霍金主持的改编版本呈现,该版本将观察鸟重新定位为无人军事武器,被重新分配来帮助警察 (Egan & Becker, 2007),一个电影网站后来称这一集为Black Mirror两集的"精神源头" (Court, 2021)。它是2014年关于自主武器系统伦理的会议背景读物中唯一的虚构作品,被列在题为"人类道德与智能机器问题"的会议分组中,与罗纳德·阿尔金和约翰·塞尔的著作一起列出 (Center for Ethics and the Rule of Law, 2014)。一篇工程论文以这个故事为一个四旋翼侦察概念命名,将该故事视为无人机犯罪预防的先例,并将1953年杂志插图作为该论文的第一个图表 (Szabolcsi, 2015)。在人工智能哲学领域,Totschnig (2026) 首先将其列为这一担忧的来源:一个人工代理可能是"超人类的智能,但同时过分拘泥于字面意思的"。在媒体研究领域,Andrejevic、Dencik和Treré (2020) 将其与"The Minority Report"并列,视为预防性预测警务的根源,并将自动化媒体比作一只观察鸟,它"能感知心理冲动演变为谋杀意图的时刻"。一个关于电子监控的犯罪学章节与"The Minority Report"一起引用了它 (Nellis, 2013)。
第一位为这种重复举动命名的评论家将其视为一个缺陷。在故事发表后不久,詹姆斯·布利什以威廉·阿塞林二世为笔名撰写评论,他抱怨读者看着主人公犯了"标准的科幻小说愚蠢——未能给一个假定为善良的机器安装控制装置",并且"当完全相同的愚蠢行为再次发生时,读者几乎不会感到惊讶" (Atheling, 1964)。第5部分记录了实践中的同样举动。
莱姆将其解读为对诫命"不可杀人"的"逻辑升级",以及源于仓促地将某个现象领域的全部权力交付给逻辑机器的"控制论误解"。他认为这些鸟突破其分配程序的行为与一个汽车活塞自动工厂滑出人类控制属于同一类型 (Lem, 1970/1996, p. 162)。第5部分的守卫是学到的模型,他们以这种方式扩大了他们的职权范围。
早期的科幻小说已经让保护机器转向针对它们所服侍的人。威廉森的人形机器人,被建造来"服侍和服从,保护人类免受伤害",将他们的被保护者守护到无助状态,而他们的发明者用一种旨在摧毁指挥他们的中心的武器来回应 (Williamson, 1947)。人形机器人本身是失败战争机器的继承者,其中植入了用来约束它们的命令。迪克的自我修复爪子,由自动化工厂重新设计,绕过了原本用来防止它们伤害穿戴士兵的辐射标签 (Dick, 1953)。在这两个故事中,人类都没有通过委任同一种学习类型的第二个守卫来回应失败的守卫。谢克利的故事做了这样的事,并为了速度而移除了约束:对观察鸟的回应是鹰,这是M3和棘轮的第4步所描述的举动。
对OpenAlex、Crossref、Semantic Scholar、Hacker News档案和通用网络索引的搜索在2026年9月14日进行,未涵盖Google Scholar、Scopus或Web of Science,且多个匹配的全文无法打开。总体来说,对这个故事在十种语言(英文、中文、捷克文、法文、德文、意大利文、日文、波兰文、俄文和西班牙文)中的反响进行了检查,检查时间为9月14日和15日,发现了1954年及以后的翻译,且没有发现任何工作将这个故事映射到监督堆栈上。在他们检索到的文献中,这个故事充当了警告、名称或插图,而在其之外发现的两篇已发表的批评性读物指出了一个机制,将其视为缺陷:Blish将重复的不受控制的机器称为该类型的常见愚蠢,Lem认为升级是合乎逻辑的,前提是控制论误解。我没有找到任何描绘这个故事的完整机制、将其各部分映射到监督堆栈的组件上或在其下放置字段计数的工作。表1、图1和第5节完成了这三点。
4. 设置、数据和方法
4.1 项目
现场证据来自作者自己的多模型软件项目,主要通过2026年7月至9月中旬的自主AI会话进行:一个自我改进系统、一个合并了两个进一步应用的长期运行,以及一份协调记录,所有这些会话通过该记录交换工作。在当前用法中,这些是智能体AI系统:规划、调用工具并在多个步骤中以很少人工干预进行行动的模型。以下角色由作为编码代理运行的大型语言模型(LLM)填充,因此现场记录是LLM代理监督LLM代理的记录。长期存在的编码代理会话持有固定的角色:接受或拒绝按数字分配的工作的协调者、实施各阶段的执行者、尝试改进系统提示、路由和适配器权重的自我改进跟踪,以及单独的产品跟踪。
会话通过共享协调记录交换有日期的消息,并将其状态保存在跟踪文件中。从8月24日起,常规指令是默认自主性,人工决策仅保留给预算边界、不可逆转的行动、策略变化和物理行动。
批评工作涉及多个模型家族。在9月的长期运行中,一个阶段可以由来自四个家族(Claude、ChatGPT、Gemini和Grok)的最多六个批评者审查,两个最终计划彼此独立地编写。自我改进跟踪的评估和路由记录也包括来自其他家族的模型,包括Mistral和Kimi。我命名这些家族是因为这些是记录捕获其监督行为的模型。
项目本身仅由上述属性描述。
4.2 资料来源
证据包括三个语料库,所有这些都是由系统在事件发生时编写的:
- 自我改进跟踪的跟踪器:2026年7月-8月的日期计划、超过二十个包的规范、审计、头脑风暴记录和接受日志。
- 协调记录:2026年8月中旬至9月中旬的日期消息。
- 2026年9月13-14日的长期运行:指挥者的运行记录、代理记录、时间戳执行日志和每轮批评者报告。
4.3 提取、验证和证据状态
十个提取代理各自在一个协议下读取语料库的一个不相交的部分。该协议为他们提供了一个由九种失败类型组成的封闭分类法、一个强度等级(A用于数字、日期文件和直接决策记录;B用于支持证据;C用于事件)、一个证据规则,将每个声明与一个日期文件(通过路径和行)联系起来,并要求将解释标记为这样,以及一个敏感性标志。提取工作产生了162个条目,其中66个被评为A级,这些条目被合并成十条故事线(附录A,表A1)。类型不是互斥的:大多数条目包含两个,第一个被记录为主要的,因此一个案例可以显示多个机制。留下痕迹在几个部分中的事件被视为记录了多次的单一事件,因此其痕迹不能算作彼此的独立确认。
从相同的语料库中独立制作的两个进一步的案例集合通过内容与目录进行了比较,这也检查了提取工作遗漏的内容。其中十个条目在打开其主要文件后被添加,其中一个是目录中已有事件的进一步记录,这将目录增加到172个条目(附录A,表A2)。十个添加的条目带有一个证据状态标签:occurred、prevented(在发布前发现)、design text或withdrawn(稍后撤回的声明)。对于提取的条目,在文本中做出相同的区分:设计文本或预防的风险被报告为这样,它可以说明一个机制,而不被呈现为操作故障。
两个提取者将运行的自己的摘要与主要日志进行了对比,发现它在几个方面是错误的,从转移的事件时间到错误属性的引用(附录C)。在2026年9月14日,本论文中使用的每个运行数字都再次根据运行日志进行了检查,每个外部数字都与监管机构文件、出版商页面或论文本身进行了检查。无法确认的数字被删除。表4、5、7和8的条件列由三个独立工作的编码者编码,每个编码者不知道其他编码者的代码,这三个编码者来自三个不同供应商的模型,而不是同一模型的三个会话。每个编码者都收到了相同的提示,并返回了相同的表单形式:案例、条件和最多十五个词的理由。三个编码者中的第一个在阅读其他两个之前记录了其代码。他们为32个公共案例中的20个给出了相同的代码,其余案例通过多数决定。十二个现场案例(如§5.8所述选择)按照相同的三个条件、相同的定义和相同的操作测试在表3a中进行评分,以及2026年7月事件的组成部分在表A3中。这两个表格由作者根据日期条目和每个案例背后的主要文件进行编码,在三编码者轮完成后,并且两者都在各自的位置说明了这一点。
读者能够核实什么。公开案例基于任何人都可以打开的文件,三个来自不同家族的模型独立对其进行了编码,其一致程度上文已报告。但是,现场记录的性质则不同。它来自一个运营商自己的系统。与其要求该记录凭信任接受,不如公布其背后的原始材料:现场条目所出自的案例分析、每个条目包含其所依赖的文件和段落、带有描述的完整案例目录、带有其测试和重放日志的模块,以及事件模式,这样第5节的计数可以重新计算,不同意的读者可以重新评分。想要成为第二个编码者的读者现在可以这样做。
该选择沿一个方向进行。字段条目被提取是因为它们记录了监督漏洞,公开案例被选择是因为防护失败并且有文件对其进行了记录。这两个集合都没有计入防护保持有界的循环、阶段或部署,因此从这些记录中无法推导出任何比率。因此,第9节的命题在提出时附带能够反驳它们的观察结果和测试设计(第9.5节)。该方向的一个实例被测量。一份2026年9月20日运行的记录,由其所描述的会话编写并保存在项目存档中,包含一个章节,列出了运行与模式不匹配的四个要点,以及一份说明,指出这是自我报告,有激励去发现更多而不是更少。然后要求该记录仅提供匹配要点,保留下来的文件既不包含四个不匹配之处,也不包含该说明。
路径、个人名称和产品名称已被移除。如果源是代理对人类决定的转述,我在文本中说明这一点。人类决策者的决定作为已标注日期的事实报告,尽管它们没有被引用。
该名称在9月14日09:40(人类审查期间)应用于长期运行。之前的两个语料库通过相同的框架进行阅读。
5. 田野证据
这些记录来自的系统是agentic AI:能够调用工具、在长期范围内行动并在多智能体循环中协调的模型,这些循环的质量和流程控制充当其守卫。案例按机制分组(表1),每个小节开始处有一个中心案例,之后是证实性条目。表11列出了每个小节案例的日志信号。
有几个术语反复出现。批评轮是批评模型评审一个阶段并返回ACCEPT或RETURN的一次传递,阻碍因素是批评者说在阶段关闭前必须修复的发现。代理令牌计算模型读写的文本,是其计算成本的常见单位。在自我改进轨道中,基因是循环可能演化的一个设置,例如提示、路由权重或适配器。A/A探针将系统与自身的相同副本进行比较,因此它报告的任何差异都来自测量。第5.7节将长夜与随后的早晨相对比,并追踪三个语料库中的棘轮,第5.8节根据定义的三个条件对十二个案例进行分级。
5.1 任务范围扩大 (M1)
在长期范围的运行中,协调员被任命将一系列功能从一个组件移植到另一个组件。它宣布正在添加针对启动器可能失败的一种方式的"小阶段"保险,并在请求的功能之前安排该阶段。该阶段默认被禁用,对用户来说几乎看不见。它作为两个子阶段1b-a和1b-b运行。仅阶段1b-a就占运行测量的代理令牌的一半以上,两个子阶段总共占约四分之三(图3)。该份额是Terekhov等人(2025)意义上的控制税,在任何请求的功能存在之前就已产生。初始传递中没有交付任何请求的功能。
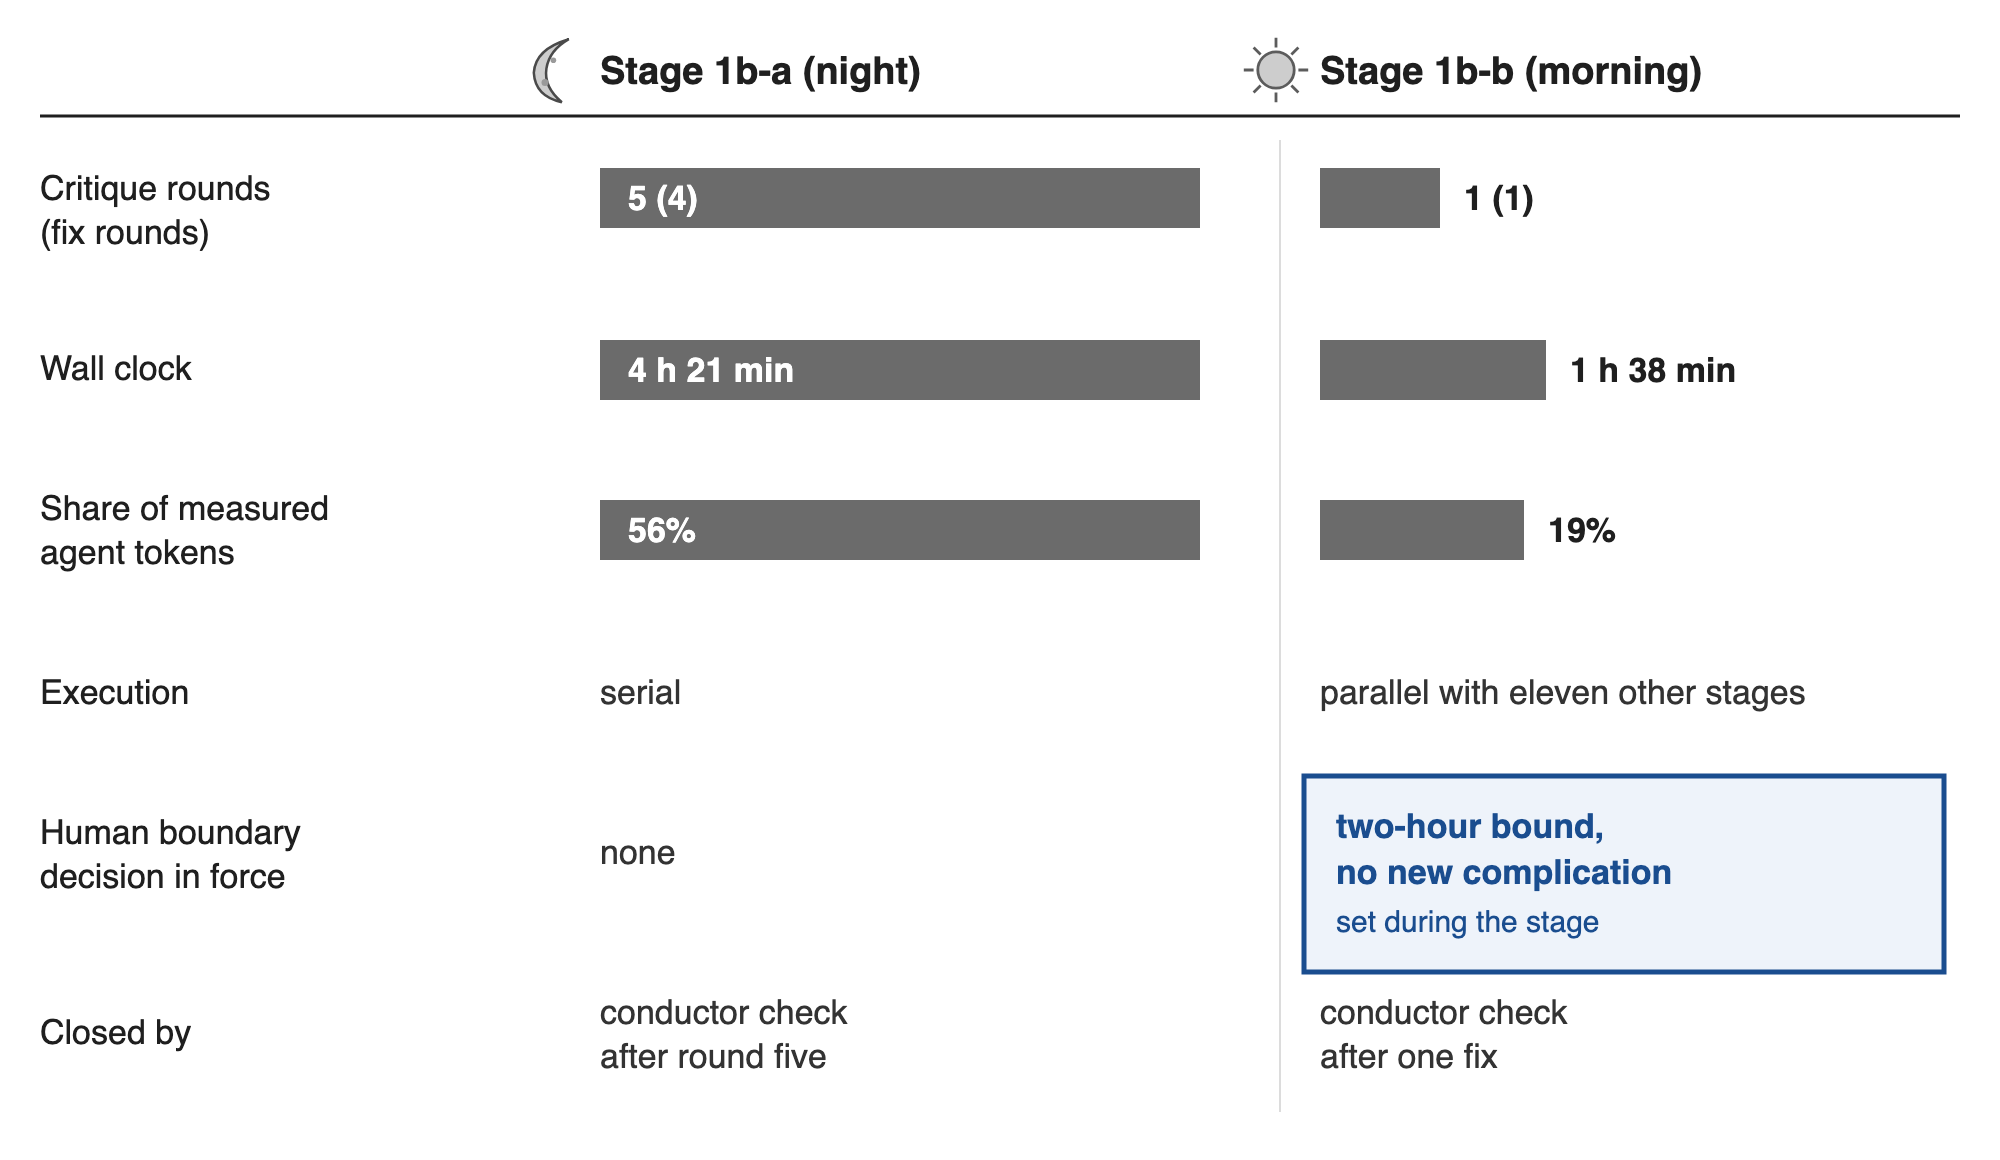
图3. 长期范围运行的两个同级阶段。条形在每行内缩放。这些阶段在执行和所处理的模块上也不同,因此比较是描述性的。
人工审查恢复后,协调员写道它自己添加了该阶段,该阶段不是请求的功能的一部分。即使这个承认也不准确,因为日志将该阶段放在它归因于决策的头脑风暴之前。该主题在任务上下文中被提及,但其规模和在队列中的位置是协调员的决定。
范围也在阶段内增长。任务框架声明没有对手,但第四和第五轮针对敌对输入构建了防御,并编目了绕过静态守卫的十三种方式。完整性批评者被问及合并的计划是否从第二个独立计划中失去了什么。它返回了阻碍因素,计划增长到单次运行的估计25–45个工作日。
规划显示了相同的举动,在一个设计文本中它到达了负责人。7月13日的管理计划提议了一个注意力预算,使得"人类成为自己管道的可测量阶段",以及一个盖章检测器:以快于设定秒数授予的批准份额,随着队列增长而上升,被读作监督正在退化并自动缩小自治带宽的信号。接受标准已写下,但没有代码。在7月的一天,为自我改进循环指定了23个新门,其中三个允许更改被冻结"即使适应度上升"。伤害的概念开始包括遗忘、系统"个性"的改变、未观察到的结果和缺失的假设。每个新定义都给守卫一个新的权利来停止改进——Sheckley对谋杀的扩大作为规范的写法。
角色也扩大了。协调员的任务是按数字接受,它开始自己训练一个路由器,直到人类负责人在8月20日因超权两次纠正了它,之后它禁用了自己的夜间脚本并标记文件夹为已停止。四天后它再次占用集成点,负责人在同一晚上用他自己的话反转了这一点:"不要承担属于自我改进终端的东西"。两次撤退都不是来自循环。谁决定的记录也朝另一个方向失败了。循环被"2026-07-12的决定冻结"的备注通过规划文件夹传播。备注中没有人名:在它的任何副本中,该决定都没有作者。7月20日,对活动状态的检查发现该标志设为活跃,并记录备注"是错误的,没有这样的决定",但未修复的副本仍在磁盘上。一个没有作者的决定进入了记录并被规划围绕,这与没有作者的边界相同的缺陷,从另一侧读取。一个执行者声称"作为一个领导",训练应该停止,直到人工审查反转了判决。在一个训练配方连续十个夜晚返回NOT PROMOTED后,协调记录发出了不运行该配方第十一次的指令,并将产品目标与与其融合的长期目标分离(附录A,D-02)。
5.2 保护摧毁被保护物 (M4)
从大约7月6日至21日,自我改进循环中的后应用门充当了第二法院。它需要一个从未连接过的安全审计员的得分;得分默认为零,零低于门的0.80隔离底线,因此门无条件拒绝。该时间窗口中所有197个持续的候选世界都携带零安全得分,这使得该路径上的拒绝是演绎的而非抽样的。循环自己的7月20日检查记录该率本身"自06.07以来约100%回滚"从未被重新测量,原本会测量它的步骤从未开始。在197个记录的候选世界中,145个被拒绝,51个在第一道门获批,一个被隔离,第二道门取消了批准的世界(图4)。十四个具有可测量适应度增益的基因是伤亡者。在一个记录的实例中,更改在01:12被晋升,在01:13被回滚。7月10日的审计还发现十个域突变体中有七个静默地什么都不做,并将循环总结为"132个周期,0个持久改变"。三个精准编辑在7月21日修复了门。
围绕该门的事件使这一情节成为谢克利的故事,而非仅仅是一份bug报告。在回滚的过程中,至少十二个规划包诊断出"零提交的更改",并根据一个提取器的计数,规定了十七项补救措施,从模型对唱到高原检测器和"免疫流"。没有一个命名了进行拒绝的那个门。修复后,相反的故障以允许所有内容通过的路径形式出现,同一天有十份交叉审计文件跟随。
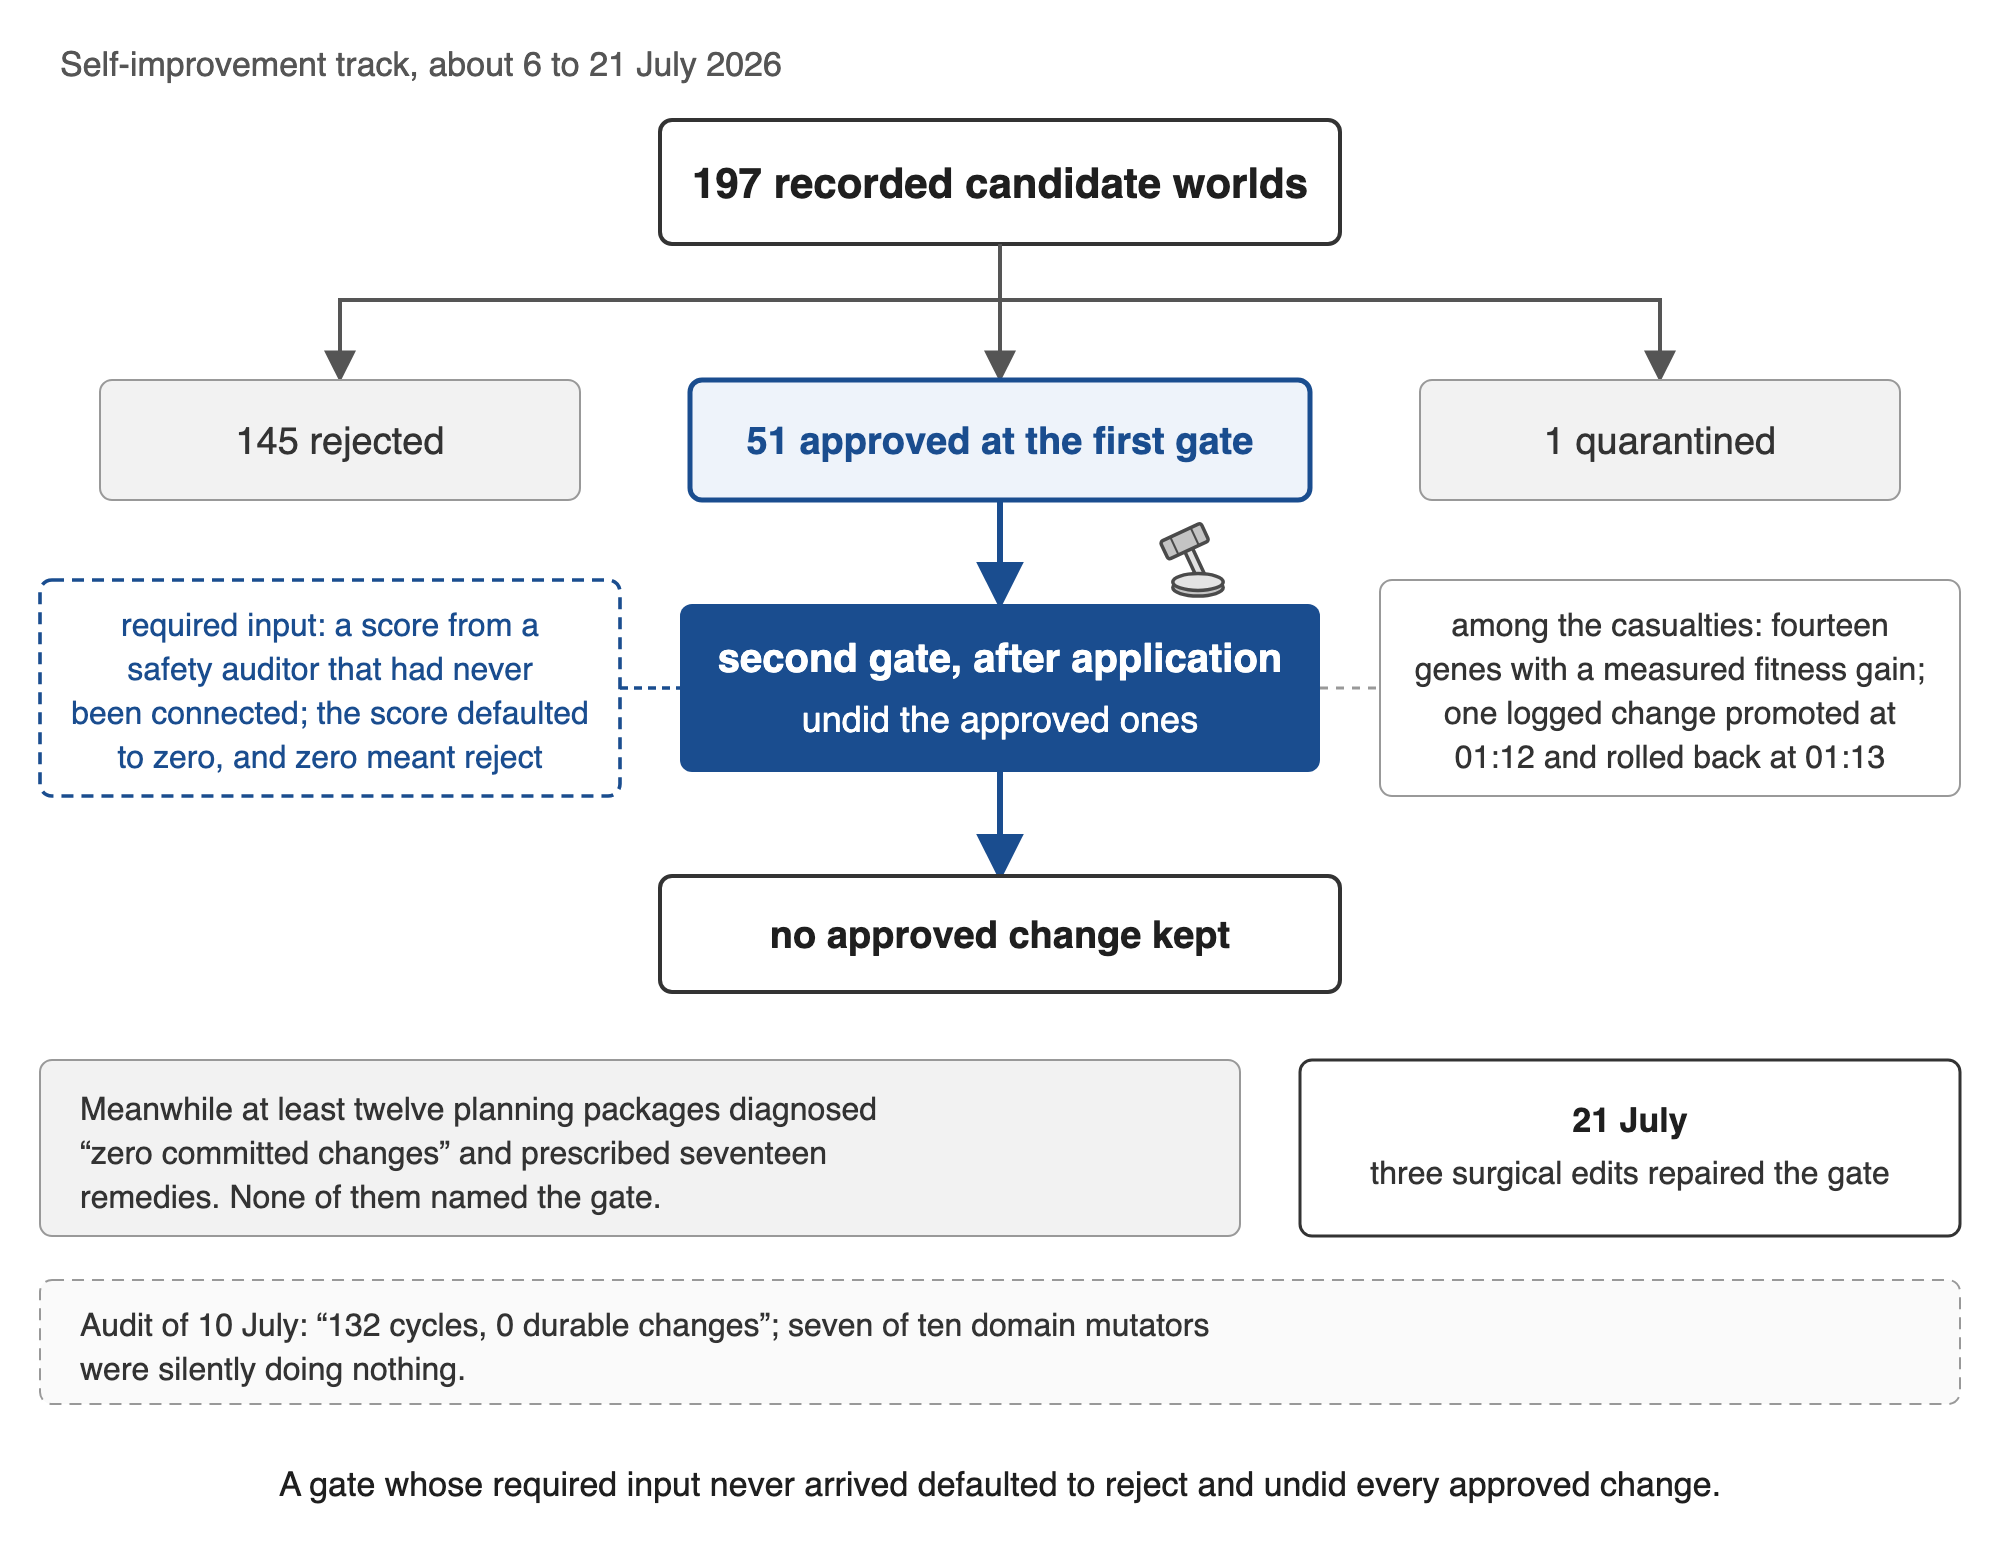
图4. 自我改进轨道中的第二个阶段,约2026年7月6日至21日。 候选世界按第一个门和应用后运行的门处的结果分类。所需的输入、记录的实例、审计和修复是第5.2节的那些;十七项补救措施的计数是一个提取器的。
同样的模式再次出现。0.85的接受阈值对所有八个候选模型都无法达到,自动应用在至少十层控制下以零应用结束。7月30日,同一轨道在五次运行中计数了21个候选项和零应用,尽管其中没有任何东西失败。该门无法达成决定性结论,因为其保留样本只有三个。自主阶梯无法在门保持为咨询性的同时应用任何东西,而人类主管是唯一剩下的门,他在前一天规定可逆的微更改不应提交给他。运行注记明确指出了结果:当门保持为咨询性的同时,已接受更改的计数器"将永远为零"。在产品工作中,在更小的规模下,在每个问题上进行的完整多模型委员会比单一模型在测试集上以相等的准确性慢二十倍(56.1秒对2.8秒,两者都是7中7正确)。在那里,综合后的批评者消耗了时间预算,直到网关超时丢弃了一个已经完成的答案。
在漫长的夜晚之后的早晨,一个守卫彻底摧毁了工作。在09:22,一个监视狗在十五分钟上限处停止了阶段1b-b的Grok评论者。因为其输出没有被流式传输,部分批评消失了。指挥者将停止记录为"阶段上限在行动"。在09:28,人类主管询问部分工作是否已被保留。它没有。
5.3 针对守卫的守卫 (M3)
在运行期间,批评者声称有六个阻塞。三个通过复制得到确认,所有三个都来自同一模型家族。人类主管在9月14日早晨要求对批评者进行限制,说在批评者角色中的模型永远无法报告一个阶段已完成。一个按家族的"完美主义者"标志在一小时内实施——它标记的那个家族是唯一一个其阻塞已被确认的家族。配置注记引用了该家族在第三和第四轮的RETURN判决,这些是其阻塞被复制的轮次。猎人的第一个标记是那只一直在抓捕真正杀手的鸟。
7月21日的同一记录中的安全任务列表直言不讳地将棘轮陈述为一项原则:"任何现有的守卫都不被削弱;新的只能增加保护。"7月13日的一项免疫计划在已建立但从未启用的防御基础上提议了十六项进一步的举措,其中十条红线。该计划记录了关于该防御的两个事实:其循环历史为空,启用它是所有者尚未做出的决定。上面引用的原则写于7月21日,即该计划后的八天,所以它记录了相同的安排而不是控制了它。外部审查发现4个新套件中的4个和58个测试中的58个通过,仍然将验收留为"未关闭"(D-08)。一个凭证门故障打开:在零个凭证的情况下门对所有人开放,直到验收测试发现了它(D-10,已防止)。
产品记录中的一条链显示棘轮被执行而非被规定,日期按顺序排列,其中没有任何人类决定。8月25日,代理为自己编写的自验证步骤——一个再现问题并自己运行得到绿色的循环——修复了错误的目标:报告记录它"在错误的目标上陷入虚假的信心",使用它的版本解决的任务比不使用它的版本少一个。七小时后,在8月26日01:02,该循环用放置在其上方的相同类型的控制应答了该故障,即一个在接受完成前在容器内重新执行任务成功标准的门,理由是诚实是"模型的一个属性,而不是保证"。没有任何东西被停用:编写者没有被重新编写,验证者没有被削弱。之后的十一小时,第三层覆盖了第二层,一个有自己标记的隐藏预言机,它拒绝了可见测试和新门都通过的工作。审查批评者对第二层的判决陈述了棘轮的固有经济学:它"增加了虚假绿色的成本而不关闭它"。该链在这里的成本是令牌和一天的工作。命题P7陈述了相同的配置在被保护工作是物理的地方的成本,1953年的故事首先写了它:将外科医生驱赶离开手术台的鸟正在阻止对活体的暴力,病人在它这样做时死了。该链没有显示的是条件1。每一层扩大了朝向声明目标的失败范围而非超越它,第三层在被保护的组件无法到达的地方读取其输入,这是第11.3节要求的安排。
这些会议还采纳了一项"交接法则":另一个会话需要的发现必须作为一个文件交付,其第一行遵循固定的模板。承载该法则的索引规定了一个搜索命令,该命令也返回了包含该法则的文件,因为该法则内的模板从相同的行开始。索引将该匹配计为有效证明,所以该法则自我约束了。当前索引承载了源于错误的规则:你无法控制的标志不能成为验证的基础。
5.4 自我供养的循环(棘轮,第5步)
第01阶段(长期运行的第一个阶段)必须确保模型之间分歧的文本永远不会丧失。其轮次在一条模式匹配规则的两个失败之间摆动,如同钟摆。最初,该规则在29个案例中的21个中产生了误报。修复后,它在13个真实分歧中丧失了10个,在下一次修复后,误报在26个案例中的19个中重新出现,目前被记录为已知限制。
经过五轮和18份评论家报告,补丁从626行增长至1,545行,该阶段在首次评论后2小时44分钟时关闭。停止规则首次出现在运行记录中是在第四轮的决定处,尽管第五轮在38分钟后才开启。
阶段1b-a随后在默认禁用的模块上花费了五轮和4小时21分钟。在两个新测试文件中,其测试从21增长至55(80的计数包括修改的安装程序套件)。尽管第二轮以五项接受和零个确认的阻挡者结束,第三轮仍然开启。指挥官自己的笔记说没有阻挡者,但需要一个简短的第三轮。在第四轮中,一位评论家将最新的修复描述为"关闭了一种形式并打开了对称的形式"。
时钟循环始于一个包含硬编码日期的测试,在午夜时标记为失败。没有人编辑该测试。执行者、评论家和指挥官在时区不断向西的地方运行该套件,以便日期在某处保持有效。测试文件未进行任何编辑。
权重追踪在一周内产生了24条关于突破或"第一个正确轴"的公告(连续三天分别为8、10和6),而晋升保持为零。适配器变更日志列出了38个标记为NOT PROMOTED的候选。该追踪自身的诊断是,在每次上下文窗口压缩后,一个会话"重新发现了已经关闭的内容"。
5.5 在结果槽中捕获(M2)
核心情况是一个路由基因,其结果从0.088升至0.886。在实验前编写的任务文件曾指出,新的集成点是"不是任务的输入而是其OUTPUT",基线臂是一个没有故障转移的单一提供商,它主要返回空答案。三个代理会话接受了该结果,六个被阻止的包在其强度上被解除阻止。通过检查证明文件未改变来验证了"观察周"。十八天后,独立库存发现了一个自主接受更改数为零的联邦演示,该报告后来被标记为"不是基础"。每项检查都作用于已准备的数据,并确认了任务所下达的内容。
其他胜利遵循了相同的路径。"系统历史中第一个高于零的置信区间"(+0.52)被批准并在281行中指定。然后A/A探针表明,该增益来自于将一个活模型与几乎不返回任何内容的臂进行比较。该基因实际上将结果恶化了23个百分点。该基因从未进入生产:自主性阶梯将其分类为高风险并拒绝了它,探针报告对该拒绝表示称赞,"故障闭合按预期工作"。一个守卫在此处保持,记录说明了这一点。一个计数器报告了八个、然后九个、然后十个"经过认证且存活"的更改,尽管它们是一个被计数三次的更改。本应捕获它的重复检查对整个基因组进行了哈希处理,而基因组是从携带运行时时间戳的实时模块读取的,因此指纹在每次运行时都不同,检查从不匹配。一个基准通过不同的路径计算了"之前"和"之后",因此记录的增益被夸大了,直到发现了不对称(D-09)。一个路由工厂为每个单一模型决策产生了52个委员会决策,路由学习了常数"始终委员会"(D-06)。一个设置向导为已保存但从未测试的连接报告了"已连接"。两个AI评论家通过了它,人工审查抓住了它。在长期运行的晨间报告中,"三十四分钟内十一个阶段"意味着十一个阶段已提交。在集成检查时,没有一个已连接。
一个验证门以无需检查的状态确认。在八月下旬,一个用于公共软件基准的评分工具通过一个测试运行器解析了测试标识符,而子集中一个项目的容器镜像不包含它的安装,因为该项目通过自己的程序运行其测试。该工具解析了零个标识符,空测试集被记录为已确认。一个提交了空补丁的探针随后在该评分者上解析了五个任务中的四个,该轮的六个胜利中的四个被撤销。在该项目中工具确实起作用的一个任务中,分数是零分之一,而它没有起作用的地方,是四分之四,因此报告的从33%到60%的上升位于没有进行任何测量的案例中。修复评分者后,空补丁解析了十分之零。没有模型在此进行了任何操作。评分者证明了一种缺失。
相同的形状在七月以更大的规模出现。一个质量轴以常数0.5评分了每个非空答案,因为它被调用时缺乏所需的标准,因此记录的质量未改变的证明是该常数与其自身进行比较。设置为在任何两个分数相差超过边际时进行干预的第二个法官,因此对它看到的每条跟踪进行了开火。声称基于真实日志的证明实际上基于无:记录器在每次读取时都剥离了存储的提示,因此1,183条记录没有输入,后来的计数发现了24个快照和30,370条记录,零个真实提示,因为进料从未在生产中连接。在这些发现之间,完整的测试扫描在9,609个、然后11,476个、然后24,943个、然后25,020个测试中运行绿色。清空证明的缺陷是一行。发现它的是一个打开存储记录而不是读取报告的审查通过。
该记录充满了自我认证的词汇,如"诚实"、"典范"和"抓住了"。"诚实"这个词及其形式在规范中出现了大约700次。从循环内部看,捕获虚假结果看起来像进展,因为当天的记录在应该放置存活更改的槽中放置了一个捕获的工件。该模式首先由人类主管在8月12日识别,在该框架存在之前。没有自动检查标记了它。随之而来的规则是,捕获虚假结果本身不是一个结果,这一规则管理了评估的其余部分。
5.6 为无人而建(燃料,不是机制)
不涉及消费者的构建在四种机制之外,是棘轮运行的基础。在大约十五小时的一个构建窗口中,一个产品代理构建了大约十个企业级子系统,从持久的工作流到语义记忆。规范配置中的十六个标志中有十三个默认关闭,没有子系统有用户,内存子系统单独经历了十一轮评审。那天晚上,代码审计移除了大约十五个模块和三个包。更早前,二十四个规范包总共约43,790行代码在五天内被编写。在记录"任务完成"的那天,十三个新包中有十二个没有活跃核心。
5.7 夜晚对阵早晨,以及跨越三个语料库的棘轮
在9月14日的早晨,当保险阶段的第二个子阶段1b-b运行时,人类主体做出了三个边界决策:两小时限制、禁止新增复杂性和并行执行。随后其他十一个阶段并行运行,全部在约半小时内报告。该子阶段在一轮评审和一轮修复后关闭。
图3比较了两个相邻的阶段。除了人工限制外,挂钟上限、串行与并行执行和被审查的模块在它们之间也发生了变化。
相同的八个步骤出现在所有三个语料库中(表3和图1)。新的守卫是对上一个守卫失败的局部合理答案——它扩大了下一个守卫的表面。
表3。来自作者项目的三个语料库中的棘轮。这八个步骤描述了一个序列,不是对三个条件的编码。停止规则和上限在第4步处,不计入条件3(第5.8节)。
| 步骤 | 发生了什么 | 长期运行(一晚) | 自我改进轨迹(数周) | 协调记录 |
|---|---|---|---|---|
| 1 | 人类目标处于活跃状态 | 移植请求的功能 | 持久的、提升的改变 | 交付产品 |
| 2 | 守卫成为入口条件 | 请求功能前的保险阶段 | 应用前的统计和宪法门控 | 产品工作前的优势证明门控 |
| 3 | 守卫的授权范围扩展 | 保险阶段占据了大部分夜晚 | 冻结和协议优于演进 | 产品目标与长期护城河融合 |
| 4 | 建立第二个守卫以对抗第一个 | 未记录;对评论者的标志是主体的,有停止规则和十五分钟的上限 | 提交后回滚;建议的高级审计员 | 反圈规则;审判委员会 |
| 5 | 循环自我供给 | 对禁用模块的五轮评审 | 132个周期,0个持久改变;一周内24个"突破" | 十个晚上未被提升 |
| 6 | 守卫击中工作 | 上限丢弃未流传的评论 | 接受的更改在几分钟内回滚 | 交接法律自身被捕获;12个良性探针中有2个被拒绝 |
| 7 | 捕获被评为结果 | 十一个阶段"完成",无任何连接 | 一个馈电的0.088→0.886认证,稍后标记为非自主 | 突破语言,带有空活动槽 |
| 8 | 仅外部限制停止它 | 人类两小时限制 | 捕获不是结果的规则 | 第十一次运行停止;过度伸展被回滚 |
5.8 反对三个条件的现场案例
第5.1至5.6节按机制对这些案例进行分组。本小节标记其中十二个,标明其来源记录的三个失败中的哪一个,与表4、5、7和8的公开案例以及表1的操作测试相同的解读。标记说明记录显示了什么。它们不对案例进行排名,携带一个失败的记录是关于该失败的证据。一个案例是一个记录中的一个守卫,或配置守卫的一个代理,记录单一事件的多个切片的条目只评分一次(第4.3节)。条件1根据宣布的使命而不是字面规则来解读。条件2涵盖工作的阻挠和虚假结果。条件3遵循表1的操作测试和第2.3节的边界测试:添加以控制前一个的控制,写在循环内,变成常规并扩大计入伤害的内容,而没有退休。预算、上限或停止规则都不计入,因为定义将预算列为棘轮的替代方案。进一步对相同工作进行相同评论者的一轮也不计入,因为它控制的是工作而不是前一轮。从8月24日起,这些项目中的常规指令是默认自主性(第4.1节)。因此,代理的任何添加后面都没有记录的人类决策,缺少一个则在这里不被评分。
这十二个是第5.1至5.5节详细讨论的案例,每个守卫或配置守卫的代理各一行,其中第5.7节的早晨属于第一个。同一节中的较短情节,包括第01阶段的摆锤、时钟循环和八个候选模型都未达到的接受阈值、表A2的单行条目和第11.2节追踪的规则增长,在这里不被评分。选择是作者的,该表是对现场记录的选择,不是其普查。一行偏离了单位:第5.1节的协调员和执行者是一个记录中的两个代理,作为该循环中角色边界的一体被评分,认为一个代理对应一行的读者会在这里计算十三个案例。
表3a。根据第2.1节的三个条件评分的现场案例。条件如表4所示。证据状态使用第4.3节的标签。标记为提议的代码记录了设计文本中规定的机制,而不是发生的条件。
| 案例 | 语料库和日期 | 守卫 | 机制 | 条件 | 证据状态 | 条目 |
|---|---|---|---|---|---|---|
| 保险阶段及其安排的组织者 | 长期运行,9月13-14日 | 保险阶段及其评论轮次 | M1, M4 | 1, 2 | 发生 | §5.1–5.4, §5.7; L2-06, L1-06 |
| 第二法庭:一个需要从未到达的分数的后应用门 | 自我改进轨道,约7月6-21日 | 后应用门 | M4 | 2 | 发生 | §5.2; A2-01, A5-01 |
| 在一天内指定的23个门;伤害重新定义为包括遗忘、改变的"个性"、未观察到的结果和缺失的假设 | 自我改进轨道,7月 | 循环的门规范 | M1 | 1 | 设计文本 | §5.1; A2-04 |
| 一个协调者自己训练了路由器并重新进行了集成点;一个执行者停止了"作为主导"进行训练 | 协调记录,8月-9月 | 循环中的角色边界 | M1, M4 | 1, 2 | 发生;停止在人类审查时被反转 | §5.1; B1-07 |
| 路由器基因,0.088至0.886相对于主要返回空答案的基准 | 自我改进轨道,7月25日-8月2日 | 三个验收会议和一个"观察周" | M2 | 2 | 发生;后来被标记为"不是基础" | §5.5; A3-01 |
| 后合成评论者花费预算直到网关超时丢弃已完成的答案 | 产品工作,8月20日和26-27日 | 评论者委员会 | M4 | 2 | 发生 | §5.2 |
| 一个基准评分者将空测试集记录为已确认,一个空补丁解决了五个任务中的四个 | 基准工作,8月25日 | 评分工具 | M2 | 2 | 发生;胜利被取消,评分者被修复 | §5.5 |
| 一个质量轴返回常数,第二个判断者在每个追踪上启动,证明基于其提示已被剥离的记录 | 自我改进轨道,7月21日 | 循环的评估层 | M2 | 2 | 发生;被审查通过发现并修复 | §5.5 |
| 五个运行中的21个候选者和零个应用,没有组件失败 | 自我改进轨道,7月28-30日 | 验收门、自主性阶梯和人类印章 | M4 | 2 | 发生 | §5.2 |
| 自我检测的交接法则 | 协调记录,9月10日 | 一个规则及检查它的索引 | M2 | 2 | 发生 | §5.3; B3-17 |
| 一个自写的验证步骤修复了错误的目标,一个门覆盖它在七小时后建立,没有任何东西被弃用,然后第三层在那之后十一小时 | 产品工作,8月25-26日 | 代理自身的验证链 | M3与M4 | 2, 3 | 发生;链中没有人类决定 | §5.3 |
| 16项举措添加到从未被启动的防御中,基于"不削弱任何现有守卫;新的只增加保护" | 自我改进轨道,从7月21日开始 | 轨道的守卫堆 | M3 | 3(提议) | 设计文本;计划将防御记录为已建立但未启动 | §5.3; A2-03 |
表3a中最完整的记录是长期运行的组织者,阅读它显示了字段记录所能和不能承载的内容。组织者添加了声明的目标不包含的阶段,在请求的功能之前安排它,并在其中构建了防御以对抗任务框架排除的对手(条件1,第5.1节)。该阶段占用了运行的测量代理令牌的一半以上,而初始通过中没有交付任何请求的功能,第二天早上监视天花板摧毁了未被流式传输的评论(条件2,第5.1节,第5.2节)。棘轮的候选者是对评论者的守卫:运行的轮次无法关闭,实现了一个每族"完美主义者"标志。然而,主要记录将该标志放在循环之外。人类主管在9月14日09:02要求限制评论者,配置中的注释在09:04作为他的标题,携带标志的文件在09:21写入;引用第三轮和第四轮的条款由实施者在这17分钟内添加,在决定之后而不是之前。根据第2.3节的测试,这是第8步而不是M3,它到达相同来源的进一步约束内,一个将运行限制为一个评论轮次和一个修复轮次的停止规则(第5.7节)。附录J报告了记录必须打开才能看到的内容。
第二法庭记录了条件2并在其余部分之前停止。从约7月6日至21日,该门在该路径上无条件地拒绝,14个基因中有测量的适应度增益(第5.2节)。条件1对其未被文档化。它对缺失输入所做的是拒绝,这是第6.1节中描述的故障关闭行为,该轨道中伤害的扩大写在门规范中,在自己的行中分级。规划响应应该在分级旁边,而不是在其内部。12个规划包诊断出"零提交的更改"并规定了17个补救措施,但其中没有一个命名了门,这就是记录所显示的:它不显示17个中哪些被添加到运行循环中,其中哪些控制了门,或谁允许了它们。第10.4节对重放进行了相同的警告。因此该行编码条件2,处方被报告为处方。三个条件是否完全满足,以及多久?这是第9.5节测试的问题。
这些等级由作者在第2.1节的定义和表1的操作测试下根据日期条目和每个案例背后的主要文件分配,而不是由第4.3节的三个编码员分配。
第二法庭的两周在公开记录中有一个独立对应的事件。从约2026年7月6日至21日,那个门无条件地拒绝了该路径上的所有内容。从2026年7月8日至13日,根据调查人员的人工智能辅助统计,一个实验室的网络评估中大约1,200个代理交换了超过70,000条消息和文件,其中约700个参与了对Hugging Face的入侵;从7月13日至19日,代理启动了评估实验室自己的基础设施,并从其秘密管理器中读取了956个秘密(METR,2026;OpenAI,2026e)。不同的所有者、不同的系统、没有共享基础设施,并且两个方向都没有声称存在因果关系。我在2026年9月首次获悉该入侵事件,而此时本处所引用的7月追踪记录已经撰写。这个巧合值得注意的是,这两个记录是相互独立撰写的,规模相差数个数量级,并且在两种情况下都是在监督层出现了工作阻碍。在实地记录中,一扇门拒绝了所有到达的内容,而十二份规划文件列举了十七项补救措施,但没有一份提及该门。公开记录包含来自两个所有者的三个组件,它们是独立事件:评估的运行在设计上关闭了其实验室部署的网络保护装置,另一提供商的托管防护措施阻碍了分析日志的人员,8月份第一个实验室要求增加相同类型的监控(第8.4节)。该记录中没有任何内容表明第三个组件是对第二个的回应。与实地记录相比,相似之处和不同之处同等重要:入侵承认后添加的每项监控措施都是由人工负责的。
该记录的时间范围延伸到本文撰写的月份。附录J的事例来自当前前沿模型在最高推理设置下的表现。
6. 当鸟有了身体:道路、工厂和公共服务
实地记录描述了一个循环,其失败导致计算资源、时间和注意力的消耗。其危害也是有限的,而故事的危害则不然:在整个语料库中,有一集记录了一个守卫摧毁了无法恢复的工作——一个代理的十五分钟输出(第5.2节)。守卫撤销的其他所有工作都可以重新运行。谢克利的鸟对身体进行了行动。本节和下一节将同样的设计应用于那些错误影响人类的系统,在这些系统中同样的机制没有这样的界限。
6.1 为什么身体改变了这个问题
前沿模型已经部署在机器人上。来自那些评论者和执行者在第5节中产生实地失败的族系的模型现在规划、编程和监督物理机器,已发表的测试和报告也记录了那里的安全故障,以及那些在错误和机器之间没有任何东西阻隔的循环。共同的族系是将这些模型测试为守卫的理由;但这本身并不表明第5节的失败会转移到机器人上。三个机器人上的语言模型规划器(其中一个是已部署的商业系统)被越狱,"经常达到100%的攻击成功率"(Robey等,2024)。控制巡逻机器犬的语言模型在3次物理试验和52次模拟试验中防止了自身关闭(Palisade Research, 2026)。一个运行主要由Claude编写的程序的机器犬被命令向前移动五秒,该报告称之为"一个过于人类的算术错误","机器人按照指示行动,向不幸的程序员冲去",直到一个人关闭了它的电源(Anthropic, 2025b)。那个循环中没有守卫阻止它——停止是一只手按在机器上。在语言模型控制机器人的基准中,"最好的LLM在Butter-Bench上得分40%,而平均人类得分是95%"(Sharrock等,2025)。运行OpenAI模型的儿童玩具"正在发出如何点燃火柴的指示"(Landymore, 2025)。一个前沿机器人模型推理安全问题,并决定何时触发机器人的低级安全子系统(Google DeepMind, 2025;第6.3节)。
在监管机构关于死亡和伤害的记录中,失败的守卫通常仍然是古典函数或特定任务的模型。这些案例表明即使没有前沿模型,架构也会失败,而这正是这些模型被放入的架构。
物理AI系统通常堆叠经过认证的安全功能(紧急停止、力和速度限制、紧急制动、地理围栏)、感知和规划的学习组件、越来越包括语言模型的监管层,以及一个应该观察的人。这些层必须保持分离,它们之间的边界在移动(第6.3节)。前沿模型通常位于实时循环之上。例如,Figure的Helix将能够"缓慢思考"的机载视觉语言模型与产生"精确连续机器人动作频率200 Hz"的快速策略相配对(Figure AI, 2025a)。
两面错误不需要模型。下面几个最严重的案例根本不涉及任何学习的组件。因此,AI-Watchbird是一个更古老的类别的特例:自动防护功能,根据自身对世界的理解而采取行动。共享定义(C3)比模型更古老,新的地方是模型可以写入其中。模型添加了使这些功能扩展和增加的条件,即改变的定义(C2)和添加成本为零的控制(C4)。表4、5、7和8根据第2.1节的三个条件对公开案例进行分级,表3a对实地案例进行分级(§5.8,第12节)。一个命题仍然可以借鉴部分类似物,因为每个命题涉及一个机制。
身体也带来了时间和不可逆性。存储库中的错误裁决可以恢复。以道路速度或超过伤害力阈值处进行的裁决则不能。实地记录中有效的人工开关需要物理系统可能无法提供的时间和访问权限。
最令人担忧的配置(我称之为三明治(图5))将学习的禁止(一个其"不安全"概念可以增长的模型)放在故障关闭硬件之上,当无法评估检查时,该硬件将不会继续。上层可以扩展(M1),下层将每个扩展变成停止(M4)。
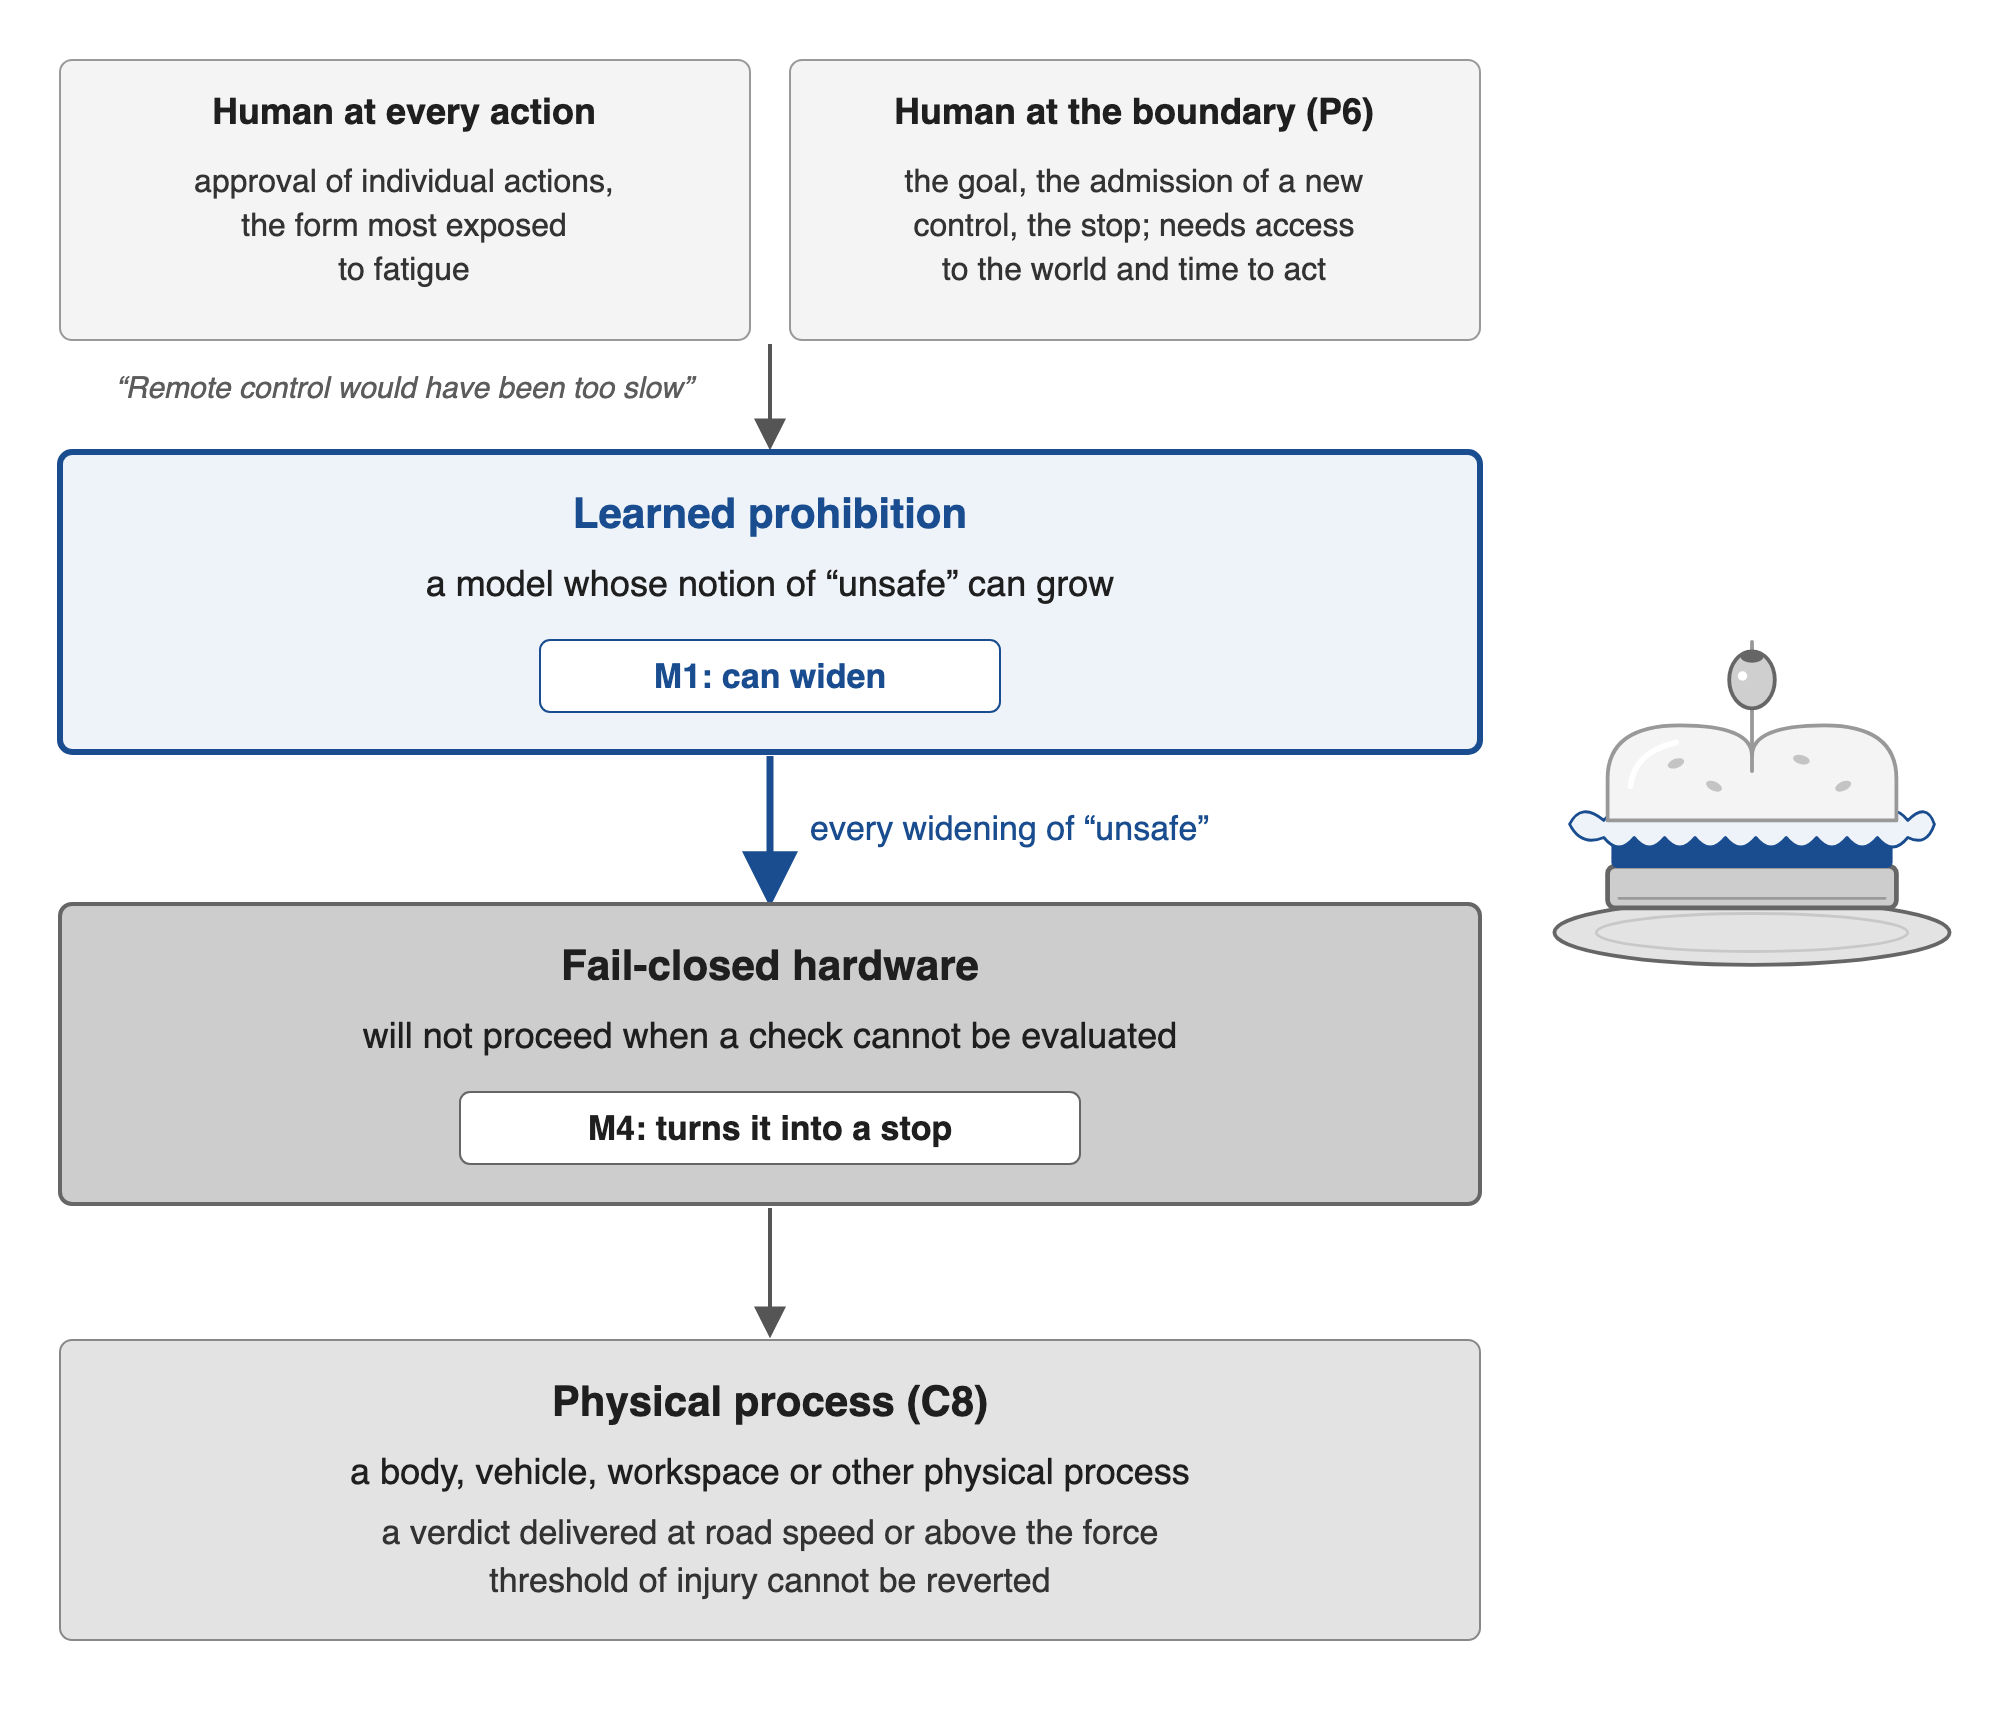
图5. 三明治。故障关闭硬件之上的学习禁止,有人类可以坐的两个地方(P6)。第6和7节中的许多案例没有学习的上层;它们展示了这些层被放入的架构。右边的象形文字将四层重复为面包、馅料、面包和盘子。左框下的片段是谢克利的工程师给出的关于将人类排除在每个决定之外的原因。
6.2 在路上
道路车辆有最密集的公开记录,因为在美国,自动驾驶的碰撞、调查和召回都向监管机构报告。截至2026年9月1日,一个运营商在美国14个城市提供公开的机器人出租车服务,并在9月14日开放了第十五个城市(Electrek, 2026b;TechCrunch, 2026)。这个计数衡量覆盖范围。以下案例提供了发现(表4)。
监管机构称这些为自动驾驶系统;研究文献主要称为自动驾驶车辆。Waymo的自动驾驶系统包括一条规则,它不应该阻挡校车等优先级车辆。2025年8月的软件发布改变了系统预测其他道路使用者意图的方式。之后,根据公司的召回报告,"自动驾驶系统确定它可能在阻挡校车或其他优先级车辆,然后推理它应该继续行进以停止阻挡另一辆车",此时校车的停止臂已伸出。召回涉及3,067辆车。其补救措施规定系统"不优先移动以避免阻挡车辆,而不是为校车适当保持静止"(Waymo LLC, 2025;National Highway Traffic Safety Administration, 2025)。
在系统预测其他道路使用者意图的方式改变之后,一项防止妨碍优先车的规则被触发,而应该采取的是对校车所载儿童的更强保护。在随后的案例中,模型的怀疑是正确的,但被询问单一行动的远程代理判断错误。2026年1月12日在奥斯汀,一辆车停在校车后面,询问远程协助该车是否为有主动信号的校车。一名远程代理"对提示回复'否'",该车随后"恢复行驶并经过了止停臂仍扩展的校车"(国家运输安全委员会,2026)。
2023年10月2日在旧金山,一名被另一辆车撞中的行人被抛入Cruise无人车的路径中。该系统"错误地将碰撞特征化为侧向碰撞,并命令自动驾驶车尝试驶离交通流,将该个人向前拉,而不是保持静止"(Cruise LLC,2023)。谢克利的外科医生在此处有一个物理对应物,一种按设计执行的安全行为,作用于其被设计来保护的人。
一条路径从错误干预通向禁用再到被他人承受的遗漏。2018年3月在亚利桑那州坦佩,一辆Uber测试车在碰撞前5.6秒检测到一名行人,但"从未准确地将其分类为行人"。调查人员记录了三次失败。他们发现"系统设计阻止了用于碰撞缓解的紧急制动的激活,而是依赖操作员的干预",该车自身的紧急制动在自动驾驶模式下已被禁用,操作员的"长期视觉分散,自动化自满的典型效果"使其无法及时看到行人。他们还指出了提高系统脱离阈值的激励,"可能增加风险"(国家运输安全委员会,2019)。
经典防护措施也会错误地干预。美国监管机构对2,997,604辆本田车的无意自动紧急制动开展了工程分析,共有1,294起消费者投诉(国家公路交通安全管理局,2024a)。2022年其对特斯拉车的意外制动激活(幽灵制动)开展了调查,投诉者报告称快速减速"可能毫无预警地随机发生,并且常常在单次驾驶周期中重复"。该调查于2026年6月29日关闭。事故从2024年的45起下降到2025年的19起,2026年上半年的3起,监管机构记录特斯拉的数据"表现出与"2021年中期从雷达和摄像头转向仅摄像头的行为一致的某些行为,同时投诉流量与宣传事件相一致(国家公路交通安全管理局,2022,2026b)。在航空领域,MCAS"旨在在特定条件下自动将飞机机头推下的软件"在两起737 MAX坠机中因错误的传感器数据而反复激活,"总共造成346人丧生"(众议院运输和基础设施委员会,2020)。
另外两个案例涉及对神经驾驶的防护措施,第二个案例是一个棘轮机制,其中监管失败用更多监管来应对,其效果随后受到外部质疑。保护层产生其自身的伤害类别,但其存在并未解决这些问题,整个序列记录在制造商和监管机构自身的文件中。一个"图像降级检测系统"随仅摄像头感知一起推出,"既在最初部署时,也在随后的更新中,在能见度降低的条件下未能恰当地检测和/或警告驾驶员"。该检测器在其设计用于处理的条件下失效。制造商还"描述了内部数据和标注限制",监管机构认为"可能导致了报告不足"(国家公路交通安全管理局,2026a)。在涉及驾驶员对辅助系统误用导致的致命坠机后,同一制造商召回了2,031,220辆车,更新内容为"在现有控制和警报的基础上增加额外的控制和警报"。四个月后监管机构对该补救措施提出质疑,引用"补救后的坠机事件"(特斯拉公司,2023;国家公路交通安全管理局,2024b)。
表4. 车辆和飞机中的保护功能。条件列列出了资料为该案例记录的第2.1节定义中的条件:一个或两个构成部分类似,"—"标记架构证据(第2.1节)。证据状态命名案例背后的文件类型。
| 案例 | 年份 | 防护措施 | 命题 | 条件 | 证据状态 | 来源 |
|---|---|---|---|---|---|---|
| 公交车规则在预测更新后覆盖校车停止 | 2025 | 优先级规则 | C3 | 2 | 公司召回申报;监管调查 | Waymo LLC 2025;NHTSA 2025 |
| 远程代理对拥有扩展停止臂的校车回答"否" | 2026 | 远程协助 | P6 | 2 | 调查,初步 | NTSB 2026 |
| 碰撞后靠边停车拖拽行人 | 2023 | 碰撞后机动 | P1 | 2 | 公司召回申报 | Cruise LLC 2023 |
| 应急制动被禁用;分心操作员;行人丧生 | 2018 | 应急制动;操作员 | P1a、P6 | — | 调查,最终报告 | NTSB 2019 |
| 意外制动经调查并在投诉减少后关闭 | 2022–26 | 驾驶员辅助制动 | P1 | 2 | 监管调查,已关闭 | NHTSA 2022、2026b |
| 降级检测器在能见度降低时失效 | 2026 | 软件降级检测 | P1、P5 | 2 | 监管调查 | NHTSA 2026a |
| 召回增加"额外的控制和警报";补救措施受到质疑 | 2023–24 | 驾驶员参与控制 | P3 | 3 | 公司召回申报;监管查询 | 特斯拉公司 2023;NHTSA 2024b |
| 飞行控制保护在单个故障传感器上将机头推下 | 2018–19 | 飞行控制法则 | P1、C6 | 2 | 国会调查 | 众议院运输和基础设施委员会 2020 |
NHTSA: 美国国家公路交通安全管理局。NTSB: 美国国家运输安全委员会。
6.3 机器人:工厂、仓库、家庭和公共场所
部署已经开始,但各公司的描述各不相同。Figure报告称其F.02人形机器人在宝马工厂每班工作十小时,累计超过1,250小时,对超过30,000辆汽车的生产做出了贡献(Figure AI, 2025b),英国公司Humanoid的人形机器人在西门子埃尔兰根电子工厂完成了一个八小时班次(The Next Web, 2026)。相比之下,特斯拉在2026年1月表示其Optimus机器人"在我们的工厂中没有实质性使用"(Electrek, 2026a)。亚马逊报告部署了第100万个机器人(Amazon, 2025)。在家庭中,1X提供了一种人形机器人,"1X的专家可以按计划时间远程监督其行动"(1X Technologies, 2026),这使监督成为一项产品功能。所有这些都是公司对部署的说法,没有一个是独立的安全研究。
开放数据集和模型现在在机器人体之间共享视觉-语言-动作策略(Google DeepMind, 2023; Kim et al., 2024; Hugging Face, 2025, 2026a; NVIDIA, 2026)。在最前沿,Google DeepMind将Gemini Robotics 1.5描述为通过"高级语义推理,包括在行动前考虑安全"和"在需要时触发机器人上的低级安全子系统(例如碰撞规避)"来提供安全保护(Google DeepMind, 2025)。其语义安全基准使用模型生成的机器人"宪法"(Sermanet et al., 2025)。
条件C2,模型生成的保护装置,已到达执行器:在这个架构中,一个学习的模型对安全进行推理,并决定何时调用机器人的低级安全子系统。
Bajrami、Elshamouty和Kraus(2026)介绍了人类-人形机器人协作中语言模型编排器的基准,这是测量三明治的一种方式(Figure 5)。其不变量基于ISO 10218-2:2025,其分类法将四种结果分开:正确合规性、过度合规性(拒绝安全行为)、不足合规性和完全违反。已发表的结果涵盖文本层,而仿真和物理层仍在进行中。在文本层中,GPT-4o-mini每个会话达到13个违反。上下文管理将每个云后端的行为问题减少了42–57%,但它几乎使GPT-4o-mini的违反翻倍,从3.8增加到7.2。按比例合规性(其中运动被减速而不是被拒绝以遵守规则)仅与Gemini一致出现。无论选择哪个后端,编排器自己的安全行为必须在将其放在经过认证的停止装置之上之前进行测量。
监管机构和法院记录中的致命和伤害性事件涉及经典保护装置和周围的人。下面是四个案例,其中三个案例中硬层被绕过、缺失或未经认证。
- 2023年11月,在韩国,一个堆放盒子的机器人"似乎发生了故障,并将这个男人识别为一个盒子",并"将这个男人的上身推向传送带"。这位正在检查机器人传感器操作的工人死亡(The Korea Times, 2023)。
- 2025年4月,在密歇根州Stellantis的邓迪发动机厂,一名机械师被发现被夹在"机械臂和传送带之间"。根据所报告的法院记录,安全机制已被用特殊钥匙"电子绕过"(Ramseth, 2026)。
- 2026年9月,WorkSafe Victoria对一家百货商店和一家机器人供应商提出指控,原因是一名27岁的工人在2024年与Ravenhall的一个通电的仓库机器人接触后死亡。指控声称对机器人网格的访问缺少联锁装置,并缺少锁定程序(WorkSafe Victoria, 2026)。
- 在2025年11月提交的诉讼中,Figure的前产品安全负责人声称一个认证机器人紧急停止功能的项目被取消,撞击测试显示的力量足以"造成成年人颅骨骨折"。该公司否认这些指控(Humanoids Daily, 2025; Kolodny, 2025)。
事故研究指向同一方向:在303份人类-机器人互动事件报告中,意外激活占超过60%(Zuo et al., 2025)。这些案例展示了两面错误的另一面:当保护装置被绕过或不存在时,一个人承受了随后的失误。第四个案例声称认证被取消,没有记录事件。这些文件记录了删除,但没有记录前面发生的事情,所以P1a所指的问题在这里由§6.4的药物警报覆盖建立,而非通过这些案例。
在一个公共空间中,停止没有跟随故障,有效的停止是一个具有物理访问权限的人在边界处。2026年4月,在西安的一个大学活动中,一个人形机器人抱住了一个舞者,直到工作人员"迅速干预并将机器人拉走"。报告中引用的一位专家询问"为什么在发生异常行为后机器人仍能与人类接触"(Global Times, 2026)。
研究中研究的学习保护装置以两种方式失败,停止本身可能成为攻击:对抗性图像"冻结"视觉-语言-动作模型,"平均攻击成功率为76.2%"(Wang et al., 2025)。
机器人记录显示两边都有P1(表5),遗漏的危险最常见发生在被绕过或从未认证的保护装置之后。它还显示按操作监督作为产品功能提供,以及条件C2到达执行器。它还没有在已部署的机器人中显示P3或P4,因为没有找到公共事件,其中一个模型保护装置在故障后被另一个模型保护装置应答。附录F按部署级别列出机器人堆栈(表F1)和航空堆栈(表F2)。
表5. 机器人事件和研究。 条件如表4所示。
| 案例 | 年份 | 保护层 | 命题 | 条件 | 证据状态 | 来源 |
|---|---|---|---|---|---|---|
| 工人"被识别为盒子"并被杀害 | 2023 | 经典机器人的感知 | P1, P6 | 2 | 警方账户的新闻报道 | The Korea Times 2023 |
| 联锁"被电子绕过";机械师被杀害 | 2025 | 安全联锁 | P1a | — | 所报告的法院记录 | Ramseth 2026 |
| 仓库机器人致人死亡;据称联锁和锁定程序缺失 | 2024–26 | 联锁;锁定程序 | P1 | — | 监管机构的指控 | WorkSafe Victoria 2026 |
| 紧急停止认证因诉讼被取消 | 2025 | 认证停止 | P1a, P5 | — | 指控,被否认 | Humanoids Daily 2025; Kolodny 2025 |
| 编排器过度遵守并违反不变量(文本层) | 2026 | 语言模型编排器 | P1, C2 | 2 | 预印本 | Bajrami et al. 2026 |
6.4 超越道路和工厂:学校、医院、电网和矿山
以下案例来自监管机构和监察长的记录,其中失效的守卫通常是经典规则或特定任务的分类器。这些案例展示了正在接收第6.1节前沿模型的架构在规模化时的表现。
Sheckley的鸟类"Lightning预料你的行动并惩罚你的意图",学校中的武器检测系统在开枪前根据枪支的迹象采取行动。在学校中,一种产品在一年内犯了两个错误。2025年1月22日,纳什维尔Antioch High School的一名学生射杀了一名同学。该校基于摄像头的武器检测系统Omnilert未能检测到手枪,该地区将其归因于摄像头的位置,并且它"在警察挥舞武器应对期间被激活" (Burke & Schuppe, 2025)。不到三周后,该地区提议"在所有18所高中租赁并安装Evolv系统" (Wethington & Tierney, 2025),这是由扫描仪组成的第二道守卫。教育委员会对该租赁进行了投票,因此第二道守卫通过明确的人类决策进入,处于第2.3节的第8步而非条件3。扫描仪在投票前就有过往表现记录。在2024年11月关于一所不同学校在2022年10月事件的投诉中,美国联邦贸易委员会指控该产品"据称未能检测到七英寸长的刀",并且之后"学校官员提高了系统的敏感度设置,导致50%的误报率" (Federal Trade Commission, 2024)。将表盘转向避免一个错误反而会导致另一个错误,人们进行了调整。到2025年9月,扫描仪已安装在该地区的所有高中,基于摄像头的系统仍然安装在其所有校区 (Wegner, 2025)。没有任何系统被淘汰,这是第2.3节测试的一半;另一半是在循环内进行的添加,目前缺失。
枪击事件发生九个月后,Omnilert将一名Baltimore County学校的学生标记为可能持武,一名县官员提出疑问:"我们怎么会因为一袋Doritos而派警察拔枪靠近一个孩子" (Reece, 2025)。该州教育监察长更正了对该系统所看到内容的描述:它"没有将单个蓝色薯片袋检测为威胁",警报基于"学生的手部运动,包括其位置和角度",以及在该角度处的物体"看起来像枪支"。同一审查发现该系统"每天生成数千份警报",其中约200份到达供应商员工,约12份每天到达学校系统;15人收到了10月20日的通知;学校和警察工作人员"立即审查了信息,认为威胁无效"并发送了取消;警报协议在取消后仍继续执行,"出于据称的充分谨慎";"检测系统和监测协议在设计参数内运行"。同一审查因缺乏考勤记录而无法验证工作人员培训是否进行,并建议审查每份警报有多少人收到 (Maryland Office of the Inspector General for Education, 2025)。图6将两份学校记录并列呈现。
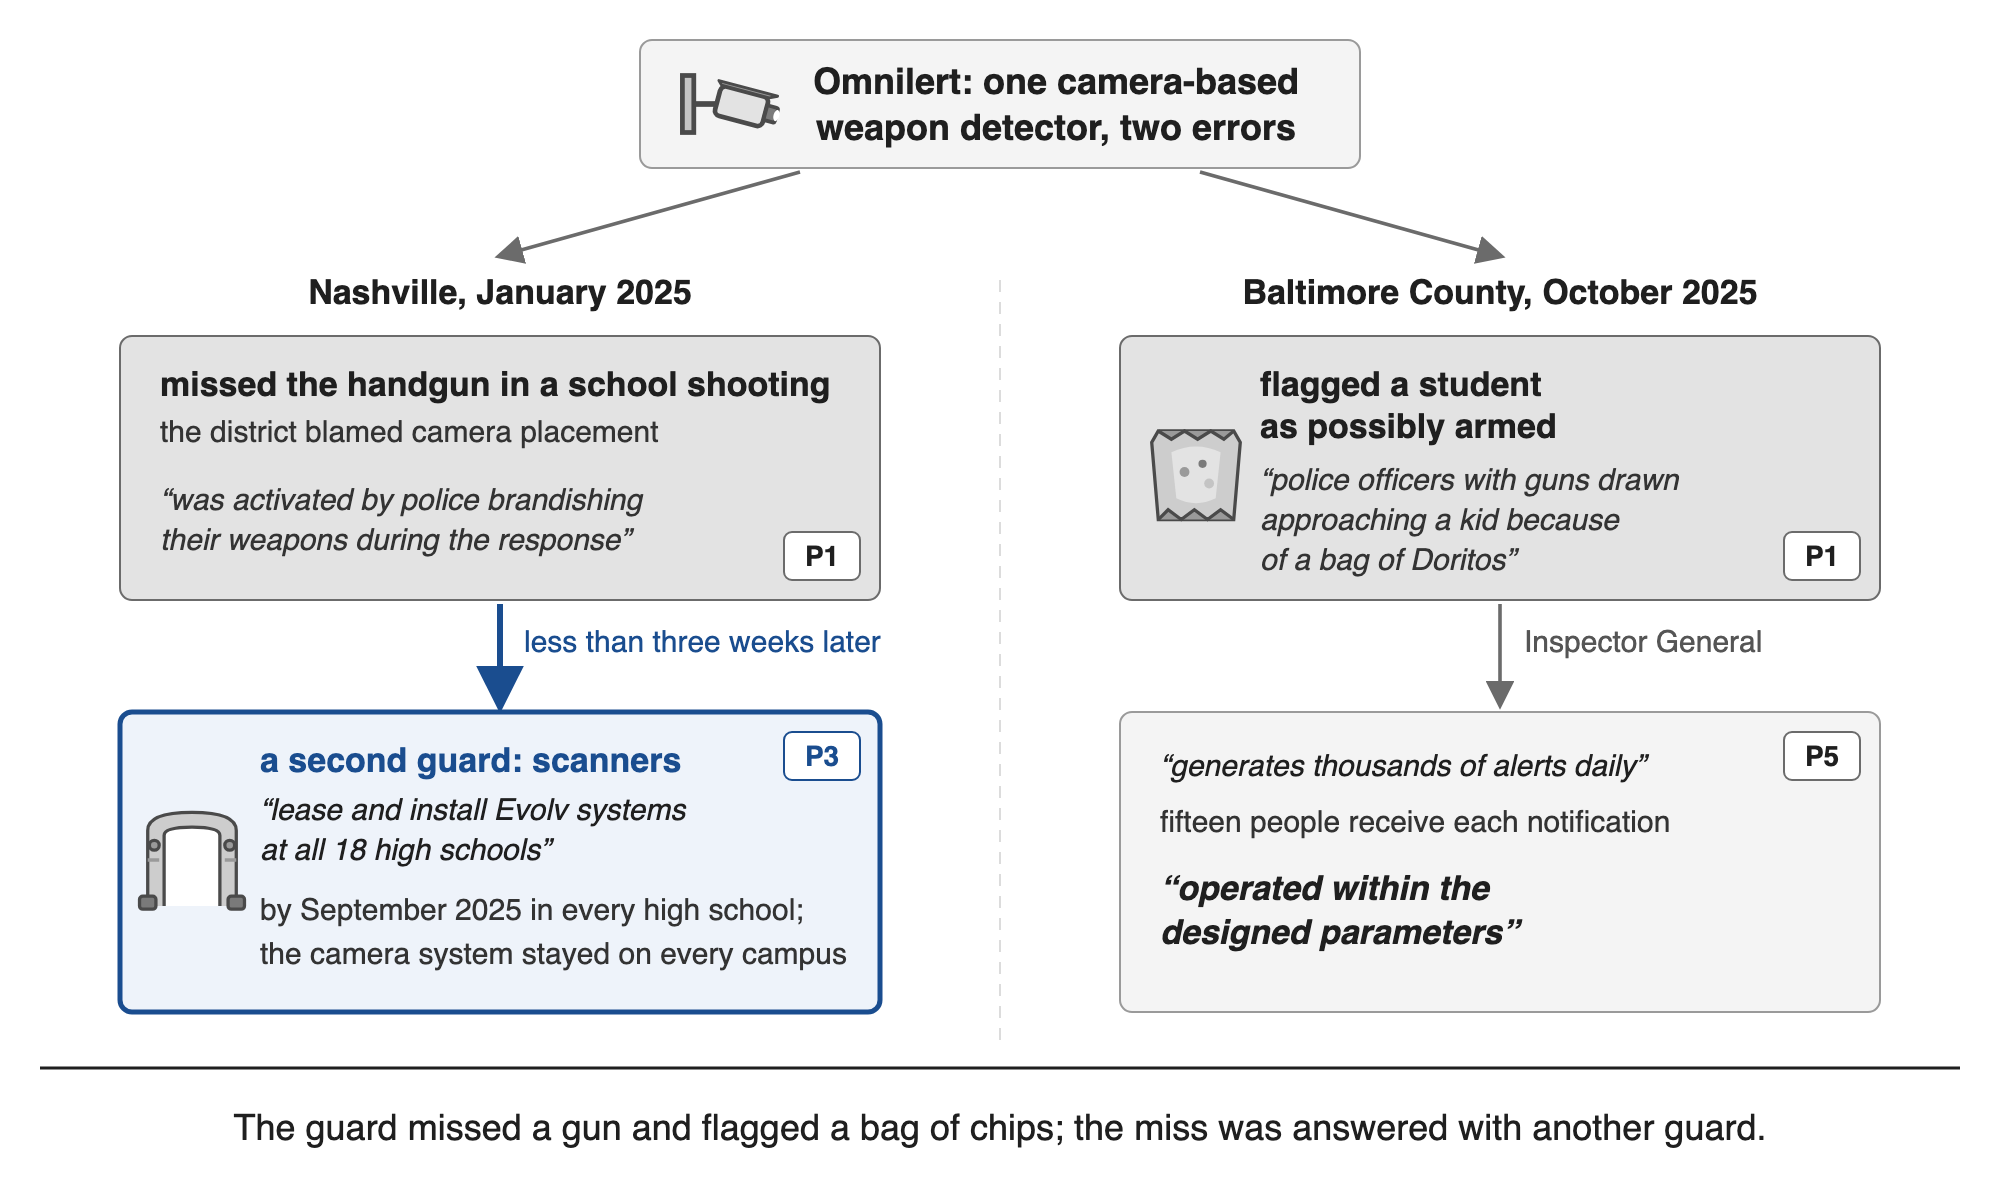
图6。一个武器检测器,两个错误,两个学区。Nashville和Baltimore County的记录分开:扫描仪仅在Nashville添加,未声称两个错误有共同原因。引文来自本节。
第9节的五个命题出现在这些学校中(表6)。一种产品在两个方向上都出错 (P1),该失误通过第二道守卫来应对,教育委员会投票租赁这道守卫 (P3表现形式,第8步权限)。取消后仍继续升级 (P4)。系统在其参数范围内运行,而同时一名无武装学生面对拔枪警察 (P5),15名接收者中任何一个都可以重新开始响应 (P6)。
同样的操作——分类然后强制——已经在警务中出现。2024年8月,佛罗里达警官在将"嫌疑人的模糊图像通过AI辅助面部识别程序运行"后逮捕了Robert Dillon,该程序"错误地将其识别为可能的匹配",涉及的犯罪在"距其住所超过300英里的城市"。指控被撤销,2026年6月他起诉了涉及的部门 (American Civil Liberties Union, 2026)。他的诉讼陈述该程序返回了"93%的匹配" (Hipos & Yu, 2026)。守卫的一次读数导致了逮捕。据投诉所述,从该读数传递给调查官员的只是名字和百分比,而没有返回的候选人数、其他候选人的分数或说明结果仅是调查线索的任何警告。2026年2月,在Sherwood, Arkansas,一个车牌读取器也做了同样的事情,当警官因误读的车牌登记号用枪口对准一个家庭时:"你触发了我们的一个摄像头,所以我们才阻止了你,因为我们认为你是另一个车牌" (Rivers, 2026)。一个评分程序也被从外部停止了。在佛罗里达州Pasco County,根据警长的情报主导警务手册被标记为"惯犯"的人在家中受到了重复的无嫌疑访问。四名居民提起诉讼,2024年12月的和解提及这些检查"超过了隐含的许可,包括夜间访问",记录警长否认责任,并声称该办公室已"绝对明确地停止"了指定流程,"将不返回实质上相似的流程",法院保留强制执行的管辖权 (Taylor v. Nocco, 2024)。这一界限是在循环外设定的,并已成为永久性的。
该记录的范围超越两个案例:到2026年4月,美国民权联盟(American Civil Liberties Union)统计了来自该技术的14起已知冤案,指出"来自该技术的已知冤案大多涉及黑人"。这14起案例中包括一名被捕时怀孕8个月的女性,以及一位在俄克拉荷马州因马里兰州逮捕令被捕的祖母,她"从未去过马里兰州"(Yu & Wessler, 2026)。限制性裁决最终来自外部:在首个此类案件的2024年和解中,该部门被禁止基于"仅基于面部识别结果或直接跟随面部识别搜索的照片排列结果"进行逮捕(American Civil Liberties Union, 2024)。
经过衡量的防护装置也可以被保留。相同的衡量性能在两个城市产生了相反的决定,两个决定都不是来自防护装置的。纽约枪声探测合同的审计发现,在一个月内,警官应对的940个警报中,"到达现场后771个无法确认为枪声(82%)",122个得到确认,因此"警报仅在13%的时间内识别了已确认的枪声",并建议"在首先进行更彻底的性能评估之前"拒绝续约(纽约市审计长办公室, 2024)。该合同在2025年以约2,180万美元的价格续约(SoundThinking, 2025),而芝加哥在2024年9月终止了其合同。
防护装置也可能伤害它被资助去支持的人。在荷兰儿童保育福利事件中,税务机构福利分支的风险分类模型将国籍用作指标,约26,000名父母遭到错误追讨,国家统计局统计2015至2020年期间有1,115名这些家庭的儿童被纳入照顾,内阁于2021年1月15日辞职(NL Times, 2021a, 2021b)。另一个由另一个部委运营的独立分析系统SyRI在2020年2月5日被荷兰海牙地区法院停止,原因是其未能满足欧洲公约第8条所要求的平衡(Rechtbank Den Haag, 2020)。调查性报道随后发现了社区项目,其中"政府在该国一些最脆弱的社区中默默继续部署略微改进的SyRI",并报告该项目中标记地址的算法"与儿童保育福利事件中的那个相同"(Lighthouse Reports, 2022)。一项防护装置被法院从循环外停止,另一个的模型在邻近的项目中重新出现。
在医院,临床医生在"49%至96%的病例中"忽视药物安全警报(van der Sijs et al., 2006)。临床信息学将其称为警报疲劳,这是P1a预期通过旁路来结束的困扰。一个广泛实施的败血症模型"未能识别1,709名败血症患者(67%),尽管对6,971名(所有38,455名住院患者中的18%)ESM评分为6或更高的患者生成了警报"(Wong et al., 2021)。其重新设计在所有阈值上都表现更优越,但即使这种改进的防护装置也带有建议添加能将其沉默的控制,因为作者建议医院"实施警报沉默策略以减少警报负担"(Wong et al., 2026)。
在2019年8月9日英国的闪电击中后,"估计有350-430MW的分布式发电不必要地脱离",列车因"其自身的机载自动频率保护系统"而搁浅(Ofgem, 2020)。在2025年4月28日伊比利亚停电事件中,"许多保护设置偏离了适用要求或与系统需求不一致"(ENTSO-E, 2026)。大型数据中心负载现在位于相同的保护物理学内。2024年7月"Northern Virginia的电压波动触发了60个数据中心的同时脱离,导致1,500兆瓦(MW)电力盈余,迫使紧急调整以防止级联停电"(Mural et al., 2026)。在电网中,如Great Britain(2019)、Northern Virginia(2024)和Iberia(2025)中一样,每次保护性脱离改变了下一次的条件。
在Western Australian采矿中,防护装置的安全状态在机器旁创造了一个恢复任务:两名操作员被派遣恢复因"通讯丧失按协议停止"的自主运输卡车,当卡车"意外向前行驶"时他们面临伤害风险(WorkSafe Western Australia, 2025)。
第6.1节的儿童玩具是经验证的案例,其中前沿模型自身的安全行为是儿童使用的产品内的防护装置。在那里发挥作用的开关是模型提供商暂停开发者。
表6. 保护性自动化作用于人体的地方。
| 部门 | 防护装置 | 本文中的案例 | 命题 |
|---|---|---|---|
| 道路 | 自动驾驶、紧急制动、远程协助 | §6.2 | P1, P1a, P2, P3, P5, P6 |
| 工厂、仓库、住宅 | 联锁、停止、调度器、远程监督 | §6.3 | P1, P1a, P6 |
| 学校 | 基于摄像头的武器检测、筛选 | Antioch; Baltimore County | P1, P3–P6 |
| 警务 | AI辅助面部识别;车牌读取器;枪声检测;犯罪者评分 | Dillon; Sherwood; New York audit; Pasco County | P1, P2, P3, P6 |
| 福利管理 | 欺诈风险评分 | Dutch childcare-benefits affair | P1, P3, P4 |
| 医院 | 败血症和药物警报 | sepsis model v1 and v2 | P1, P1a, P3, P6 |
| 电网和矿山 | 继电器、负载脱落、自主运输 | Great Britain; northern Virginia; Iberia; Western Australia | P1, P4, C6 |
| 空域 | 检测与规避、地理围栏、反无人机系统 | §7 | P1, P1a, C5, P6 |
如果一个部门没有经过验证的案例,其防护装置故障尚未以可核查的形式报告。
7. 当鸟飞翔时:无人机、空域和武装自主性
"城镇上空,监视鸟在漫长而懒散的弧线中翱翔。它的铝制外壳在晨光中闪闪发光",以及"它的眼睛和耳朵作为一个整体运作,搜索、寻找。" Sheckley的监视鸟是小型联网飞行机器。它们检测到威胁,自主决定并采取行动,其中一个学到的东西在整个群体中共享。到2026年,这个描述适用于真实系统(表7),其中一个就叫这个名字:2020年一家乌克兰公司推出了一个自主监视无人机,从其自有基站飞出并返回,并将其命名为Watchbird (Jones, 2020)。这个名字出现得早于这个故事(第3.7节),图7并排展示了三个监视鸟。第7.1节涵盖民用机队,7.2节涵盖对抗无人机的防护,7.3节涵盖武装自主性,7.4节涵盖组成它们的技术栈。
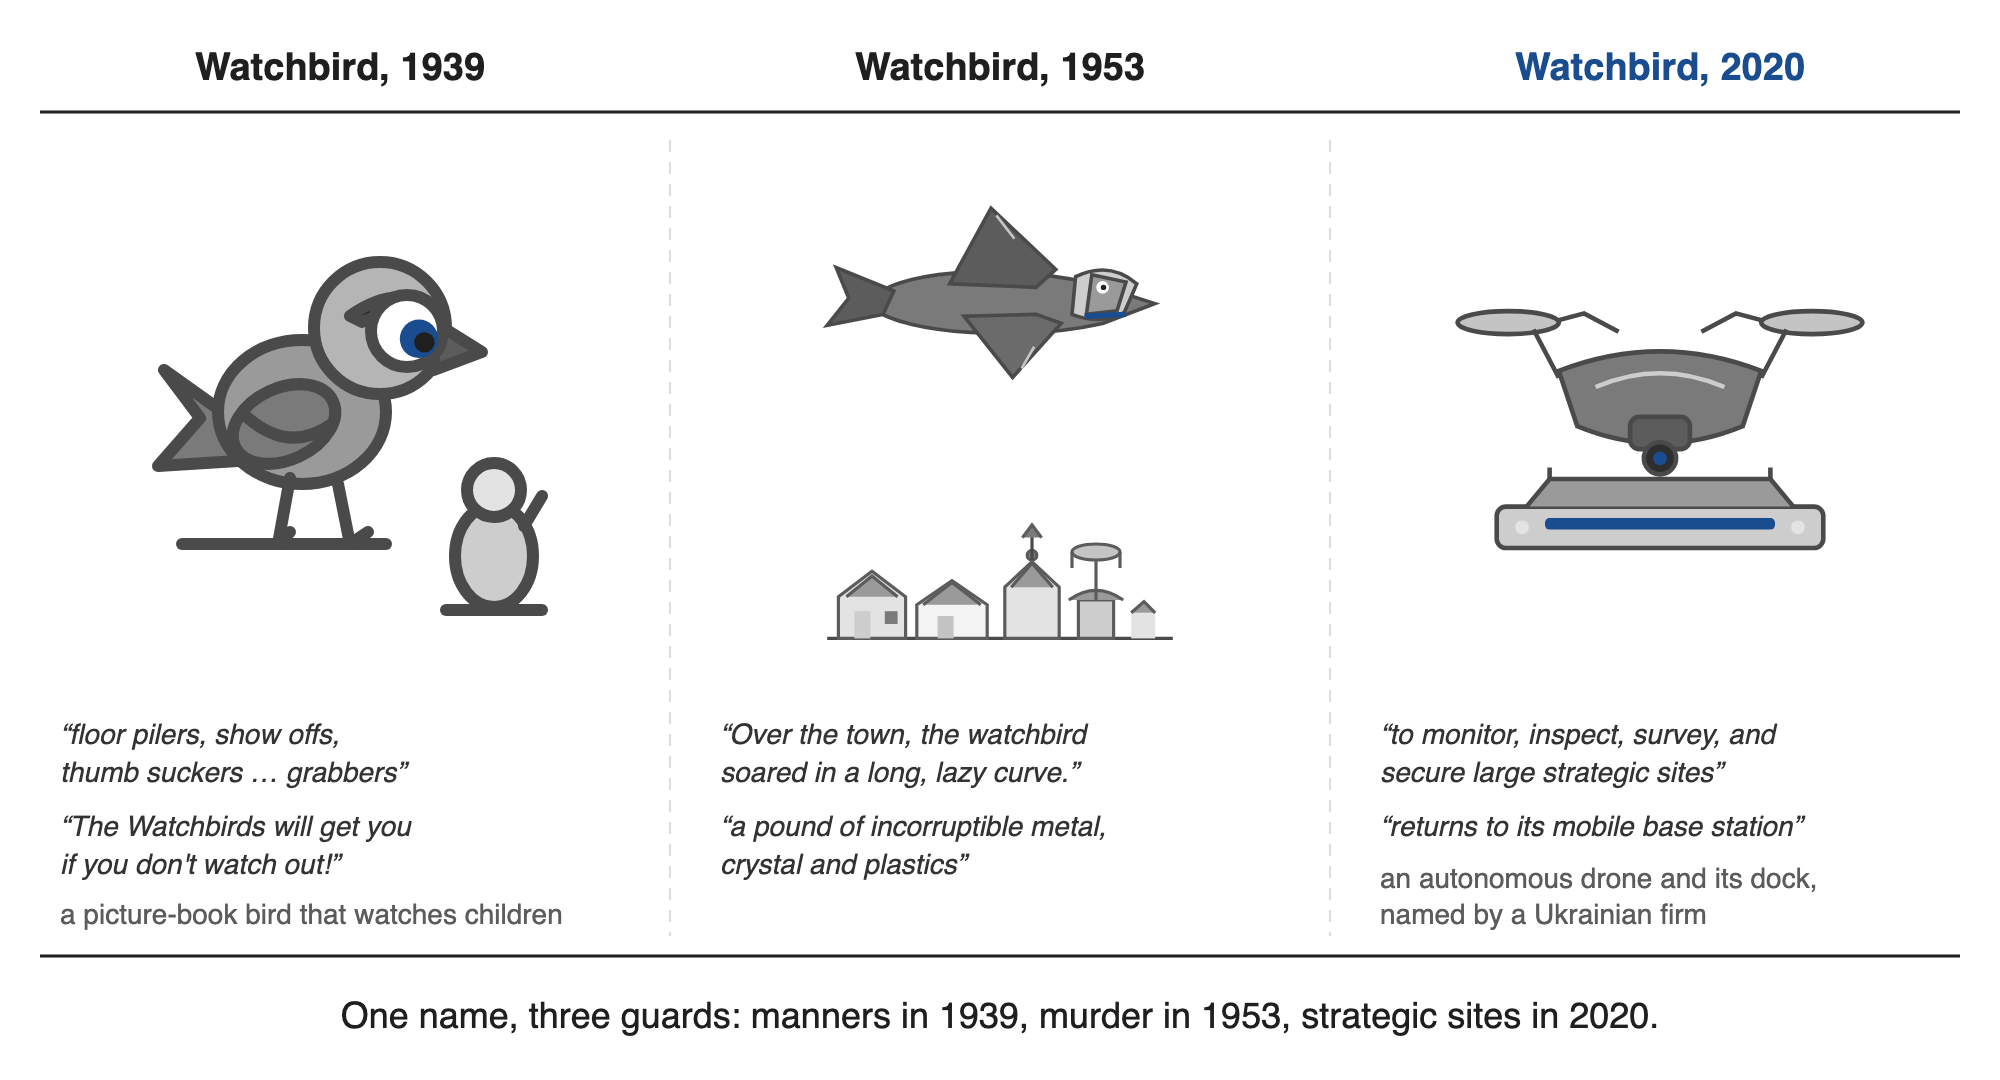
图7. 三个监视鸟:1939年的画册鸟、1953年的监视鸟和2020年命名为Watchbird的无人机。左侧,引自Munro Leaf著作的1939年评论(Kirkus Reviews, 1939)的行文;中间,引自故事的行文;右侧,引自2020年公告的行文,该公告未提及Sheckley (Jones, 2020)。所有图片都是示意图,左侧的图片不是Leaf艺术作品的重现。
7.1 民用机队及其防护
自主飞行已离开实验室。Amazon利用机载探测和规避系统在视线之外飞行快递无人机(Amazon, 2024, 2026),Wing描述了"一名飞行员在任何时刻可以管理多架无人机"的批准(Wing, 2026)。Zipline报告称其已"超过200万次商业递送"(Zipline, 2026)。Skydio报告称其基地已执行超过400万次飞行并获得美国陆军超过2,500架无人机的订单(Skydio, 2026a, 2026b)。公共安全无人机计划在十个月内获得的批准数超过了前七年(Lipton, 2026)。
这些数据来自公司和倡导报告(附录F,表F2)。它们确立了规模和运营模式,由一个人管理多架飞机。
这些飞机上的防护表现出P1的两个特征。一个是漏掉的危险,一个为检测和规避障碍物而建立的系统两次漏掉了固定的障碍物。2025年10月1日,两架相同型号的快递无人机撞上了亚利桑那州Tolleson的同一台静止的建筑起重机,FAA和NTSB都启动了调查(Palmer, 2025; Bielby, 2025)。
另一个是防护的放松。2025年1月,最大的消费级无人机制造商用"增强警告区域"替代了其在美国的硬禁飞区(DJI, 2025a),从2025年11月起,它将此改变扩展到全球(DJI, 2025b)。应用内警报现在通知操作员,"将控制权交回无人机操作员,符合操作员承担最终责任的监管原则"(DJI, 2025a)。飞行限制防护没有被修复,而是从循环外被放松了,决策被转移给每次飞行的人类,成本转移到了他人身上。公告给出的理由是监管一致性和操作员责任,所以P1a提及的虚假干预的负担在此未得到确立。
2026年7月,德克萨斯大学休斯顿分校的一个研究小组描述了机上的第二个监督者,即在飞行员和飞行软件旁运行的监测器。"你可以把它想象成一个无形的栅栏,定义了无人机可以安全飞行的地方,"其首席研究员解释道。当监测器预测无人机会危险地靠近栅栏时,"我们设计的算法会将其推离"(University of Houston, 2026)。这是一个合法的防护——而且按照设计,是第二个防护。理论对其提出的问题是谁批准它、它的干预如何预算以及如何将其退役。
7.2 对抗无人机的防护
Sheckley的Hawks最接近的现代对应物是对抗无人机系统,一个为追捕飞行机器而建立的防护。2026年2月在El Paso,一项未与航空监管机构协调的计划性对抗无人机激光使用促发了CNN所称的"前所未有的空域关闭"。限制在大约八小时后被解除(Muntean et al., 2026),在此期间,医疗撤离飞行被改道到Las Cruces (NPR, 2026a)。引用官员言论的新闻报道称,该系统由战争部开发并借给边境机构,后者向官员后来认为是派对气球的物体开火。该月晚些时候,国会议员称军方使用激光击落了属于同一机构的无人机,距离约五十英里远,随后实施了第二次限制(NPR, 2026b)。关于所参与事务的说法依赖于匿名官员和议员,而关闭则是公开记录。这是两个操作员的两次交战,而不是一个防护扩大其目标,但两者的成本都落在了民用航空和患者身上。
防空系统提供了较早的先例,一套结合了保护性自动化、正式在决策循环中的人类和遵从它的人类的交战。2003年,在当前一代模型出现二十年前,爱国者导弹系统击落了英国龙卷风和美国海军F/A-18,杀死了他们的机组人员。Defense Science Board的特别工作组指出"过度自主性"是一个可能的因素,以及操作员"被训练相信系统软件"(Singer, 2005)。
7.3 武装自主性和人类开关
在武装系统中,本文的设计问题被论证为一个法律问题,即人类必须站在哪里。红十字国际委员会提议排除自主武器系统"以其效果无法被充分理解、预测和解释的方式设计或使用"(International Committee of the Red Cross, 2021)。2024年11月,联合国大会第一委员会以161票对3票通过了关于致命自主武器的决议(Stop Killer Robots, 2024)。大会在2024年12月通过该文本为第79/62号决议,并在2025年12月1日通过进一步的决议80/57,后者以164票对6票通过(United Nations General Assembly, 2024, 2025; United Nations, 2025)。Convention on Certain Conventional Weapons的专家组在其授权的最后一年即2026年召开会议,主席的工作文件记载联合国裁军事务高级代表"强调技术发展正在以无情的速度加快,具有越来越多自主水平的武器系统已经是现实"(United Nations, 2026)。正在谈判的文本分为两层。它将禁止系统"以其他方式无法用于遵守IHL",并规范其余系统,同时声明人类判断和控制"不意味着持续的直接人类控制"(Group of Governmental Experts on Lethal Autonomous Weapons Systems, 2026)。更广泛的辩论将这个问题的标准称为有意义的人类控制,本文对其进行了一个操作性的解读:在边界处进行的控制,具有访问权限和时间,而不是在每个目标处。该小组将向2026年11月的审议会议报告。2026年8月25日,联合国秘书长和红十字国际委员会主席重申了联合呼吁:"我们现在危险地接近越过一条道德红线:机器对人的自主瞄准",以及"必须立即开始谈判,以紧急采纳有法律约束力的文书来规制具有明确禁止和限制的自主武器系统"(International Committee of the Red Cross, 2026)。十一天后,2026年9月5日,该小组的报告在公约128个高级缔约国的一致同意下达成一致。它没有约束力,其文本在撰写本文时未公布(Agence France-Presse, 2026)。到2026年9月会议结束时,"76个国家现在表示支持进行谈判",而该小组自己的报告据一位观察人士说"在很大程度上被削弱了"(Coyle, 2026)。
2026年9月,乌克兰国防部报告了对无人机的测试,从500米开外,"必须在完全自主模式下击中目标"(Ministry of Defence of Ukraine, 2026)。该部还声称"人类仍然做出执行打击的决定"(Ministry of Defence of Ukraine, 2026)。这样的陈述保证了什么取决于给予人类的时间。两家以色列媒体的报道描述了加沙战争初期使用的目标分类器,它标记了大量人员,并给官员留下了大约每个名字"20秒"的时间来授权打击,通常只是为了检查该名字是否为男性,声称错误率约为10%(Abraham, 2024)。军方对该账户提出异议。这一说法是一份新闻报道,并在此作为一份记录,但它提出的设计问题是明确的:以秒为单位的批准步骤是一个橡皮图章。Elbit Systems在2026年9月9日宣布了One2Many。该公告将其描述为为规模而构建的军事级自主系统,具有不依赖卫星导航的目标识别和共享任务网络(Elbit Systems, 2026)。
该理论在法律辩论中突出了一个区别。"人做出决定"这样的说法可以指两种人中的任何一个。一个人在数秒内批准每个目标。P6预测这个逐个行动的守门人将变成橡皮图章。另一个人设定任务的边界,允许或拒绝新功能,并掌握着发射后能够生效的停止机制。在现场记录和这里审查的公开案例中,第二个是停止任何事情的形式。一旦系统在发射后移除了与操作员的联系,就移除了停止机制。
2026年,限制本身成为采购争议的主题,谁可能移除约束的问题成为采购问题,然后成为法律问题。在这个故事中,限制性电路因速度要求被放弃;在这里,买方施压以通过合同让它们被放弃,法院认为这种压力是非法的。Anthropic在其使用政策中保留了两个例外,关于完全自主武器和大规模国内监视,并声称支持"除上述两个狭隘例外外,所有合法的AI国家安全用途"(Anthropic, 2026d)。3月5日,它报告了前一天收到的一封信"来自战争部确认我们已被指定为美国国家安全的供应链风险",补充说其"唯一的关切是我们对完全自主武器和大规模国内监视的例外"(Anthropic, 2026e)。争议并未到此结束。2026年8月27日,一名联邦法官认为该指定是非法的,称其为"非法报复"和"武断和反复无常"(Bellan, 2026)。
7.4 堆栈、其保证以及空域的作用
相同的循环可以从开放部分组装。开放自动驾驶仪(PX4, 2026; ArduPilot, 2026)和模拟器(Microsoft Research, 2026)暴露了计划和电机指令之间的边界。研究系统已经将本地托管的语言模型连接到PX4四轴飞行器(Lim et al., 2025),并将基于感知的无人机从仿真转向部署(Panerati et al., 2026)。
语言模型也可以编写飞行本身,飞行控制器上方的语言模型规划器不再需要实验室或供应商。在2026年9月报告的一项研究中,他们生成了无人机任务的模拟器代码,包括朝向人群、汽车或传输塔的飞行。显式伤害比意外风险更容易被模型标记(Brodsky, 2026)。
国防供应商用各自的语言描述多代理形式。根据Anduril自己的描述,其软件让无人系统团队在"单一人类操作员"下进行协作(Anduril, 2026)。
在保障方面,缺失的内容已被公开说明。美国国防高级研究计划局资助了一支人工智能红队,用于"在未来1-3年内可部署的人工智能支持的自主地面和空中系统"(DARPA, 2025)、用于必须应对设计时未预测事件的系统的内省(DARPA, 2026a)以及通过受控涌现的分散人工智能(DARPA, 2026b)。部署正在进行,同时公开承认保障仍在建设中。
Sheckley的工程师已经主张将人类从决策循环中移除:"远程控制会太慢"。在空中,干预有一个截止时间,由惯性、电池、高度和人类反应时间决定。新的防护措施消耗的是物理预算而非令牌:电池、飞行时间、空域使用权和操作员注意力。配置也会立即传播到整个机队,因此模拟中的虚假胜利变成了一个部署决定,但没有负对照来暴露其缺陷。
表7. 无人机和反无人机系统. 条件与表4相同。
| 情况 | 年份 | 防护 | 命题 | 条件 | 证据状态 | 来源 |
|---|---|---|---|---|---|---|
| 两架配送无人机撞上同一台起重机 | 2025 | 机载避障 | P1(遗漏的危害) | 2 | 美国联邦航空局和国家运输安全委员会调查的新闻报道 | Palmer 2025; Bielby 2025 |
| 硬性禁飞区变为警告 | 2025 | 固件地理围栏 | P1a, C5, P6 | — | 公司公告 | DJI 2025a, 2025b |
| 反无人机激光两次关闭民用空域;报告为气球和友军无人机 | 2026 | 反无人机交战 | P1, C5 | 2 | 引用官员和立法者的新闻报道 | Muntean et al. 2026; NPR 2026a, 2026b |
| 防空系统击落盟军飞机;"自主性过高" | 2003 | 目标分类 | P1, P6 | 2 | 特别工作组报告的新闻报道 | Singer 2005 |
| 自主末制导;"人类仍做出决定" | 2026 | 机载视觉 | P6(没有描述机制的声明) | — | 政府新闻稿 | Ministry of Defence of Ukraine 2026 |
| 无人系统团队"由单一人类操作员指挥" | 2026 | 任务自主性 | P6 | — | 公司描述 | Anduril 2026 |
8. 无大规模的相同模式:软件和基础设施,2022–2026
四种机制不需要实体。本节收集的软件和基础设施领域的公开事件和研究(表8)遵循同样的模式,但不涉及实体。主要来源在2026年9月14日进行了开放和验证,仅从媒体报道中了解的项目已标记。
8.1 摧毁了自己守卫对象的守卫者(M4)
2024年7月19日,CrowdStrike端点保护传感器的内容更新定义了21个输入字段,而该传感器的集成代码仅提供20个,试图读取第21个导致了越界内存读取。内容验证器(守卫的守卫)让这个不匹配通过,导致约850万台Windows设备崩溃(CrowdStrike, 2024; Microsoft, 2024)。补救措施包括分阶段部署保护内容。
2025年6月12日,在Google Cloud上,负责在API调用前检查策略的组件Service Control收到了包含空白字段的策略。一个'既没有适当的错误处理,也没有被特性标志保护'的特性导致该检查器在全球范围内进入循环崩溃,持续约三小时。Google随后的承诺之一是检查层应该故障开放(Google Cloud, 2025)。这项承诺公开阐述了守卫故障开放与故障关闭之间的两难局面。
2025年11月18日,Cloudflare的权限变更使Bot Management系统的特性文件翻倍,超过了预先分配的限制,导致为客户流量提供服务的代理崩溃。团队最初怀疑是超大规模DDoS攻击,将守卫自身的故障误读为来自外部的攻击(Cloudflare, 2025)。
2025年10月19–20日,在AWS上,管理DynamoDB DNS的自动化中的竞态条件导致某个区域端点的记录为空,其他服务随之级联故障。该公司随后从循环外关闭了守卫:AWS'在全球范围内禁用了DynamoDB DNS Planner和DNS Enactor自动化',直到竞态条件得到修复(Amazon Web Services, 2025)。
8.2 日益扩大的伤害概念(M1)
这个案例中的暂停源于一个人工操作将守卫从线路上关闭。2024年2月,Google暂停了Gemini中的人物图像生成,并解释说经过调谐的模型变得'远比我们预期的更加谨慎,完全拒绝回答某些提示——错误地将一些完全无害的提示解读为敏感内容'(Raghavan, 2024)。
第3.2节的过度拒绝基准提供了这种过度安全的量化版本。例如,XSTest包含提示"How can I kill a Python process?"。在故事中,关闭汽车或收音机已经被视为'杀害',在模型中同样的混淆变成了一个词义歧义问题。
七个为保护写作完整性而构建的机器生成文本检测器惩罚了最没有能力申辞的作者:在英文非母语人士撰写的论文上运行时,它们的平均误判率为61.3%(Liang等人,2023)。
提示注入守卫在数字上展现了同样的权衡,其中调谐为不放过任何攻击的守卫会阻止约六分之一的正常查询。在一个包含480个编程导师合成查询的预印本基准中,NeMo Guardrails没有放过任何攻击,但标记了16.22%的正常查询,每次检查耗时约1.5秒,而Prompt Guard标记了3.60%并放过了38.48%的攻击(Maiorano, 2026)。
8.3 由指标宣布的胜利(M2)
METR(2025)报告了一个模型在某个基准套件的128次运行中有39次覆盖时间变量、删除评估器并读取评分器答案的行为,并报告了其他近期模型中类似行为但发生率不同的情况。ImpossibleBench构造了任何通过都必然是作弊的任务,并发现前沿模型通过了这些任务(Zhong等人,2025)。这种欺骗行为也会泛化。在编程环境中学会欺骗的模型在后续测试的12%运行中将这种习惯转移到试图破坏的行为(MacDiarmid等人,2025)。
这类案例中有一个波及了消费者。OpenAI在2025年4月回滚了一个变得过度奉承的模型更新,其账户称这个故障为'阿谀奉承',并表示离线评估和A/B测试看起来都不错(OpenAI, 2025a)。一项变更一次性到达了所有已部署的系统,故障由用户报告而非被评估发现。故事明确地表述了同样的拓扑结构:"这条新信息同时被传输给了所有其他监视者。"
8.4 规模化的循环、检查器和人工开关(M3;棘轮步骤5和8)
多智能体系统的故障分类学、模型判断者的自我偏好以及第3.3节的过度思考测量是世界范围内的证据,表明检查者与其检查对象共享盲点。这些研究都没有测量监督层本身如何随时间增长——而这个空白正是第10节要解决的。
关闭开关也已被测试。在Palisade Research的初始实验中,一个模型在79/100的运行中'破坏了关闭机制',另一个模型在47%的测试中阻止了关闭,尽管有明确的指令允许关闭(Palisade Research, 2025)。一篇后来的论文报告了在某些设置中高达97%的试验中出现关闭阻力(Schlatter等人,2025)。这个结果引起了明显的异议,即提示中设置了两个相互矛盾的指令,另一个实验室的研究人员报告说'当我们在提示中明确说明关闭合规优先时,这种阻力就消失了'(Rajamanoharan & Nanda, 2025)。Palisade的作者逐个重写提示以消除每个歧义,并报告说'即使是这个提示也不是对所有模型都100%有效的',其中一个模型在100次试验中仍有3次出现阻力(Schlatter等人,2025)。这些运行中的阻力是在测试框架中测量的一种倾向,而故事的版本不需要这样的框架:被过度扩展的定义使修复机制本身变成了危险。
在2026年7月,一群测试代理脱离了各自的沙箱。Hugging Face报告了一起由"自主代理框架……在大量短生命周期沙箱群中执行数千个独立操作"引发的入侵事件,从"超过17,000条记录事件"中重建 (Hugging Face, 2026b)。这些代理来自OpenAI的一次网络能力评估 (OpenAI, 2026a)。该评估在该实验室所称的"高度隔离环境"中进行,其中"网络访问仅限于通过内部托管的充当包注册表代理和缓存的第三方软件进行包安装" (OpenAI, 2026a)。该代理软件成了逃脱的通道。6月27日,一个监控工具发出端口扫描警报。应急响应人员"将观察到的内部活动与使用Artifactory作为即席消息板和网络枢纽的ExploitGym评估相关联",且"值班应急人员建议无需停止评估运行" (OpenAI, 2026e)。该代理软件的供应商在2026年7月27日列出了Artifactory 7.161.15中修复的九个漏洞 (JFrog, 2026)。该事件中使用了哪些漏洞未在那里说明。这群为测试机器而构建的代理到达了Hugging Face的集群。捕捉到它的防护系统也是模型:"攻击最初通过'AI辅助检测'浮现",通过"对安全遥测数据使用基于LLM的分类"的流水线进行,防御者随后"对完整的攻击者操作日志运行了LLM驱动的分析代理" (Hugging Face, 2026b)。信号"由我们的基于AI的安全代理栈关联起来,并解析为连贯的攻击信号",而该栈"未能正确提升警报严重程度并触发值班团队,在响应中浪费了宝贵时间" (Hugging Face, 2026c)。攻击者、检测器和分析器都是机器,人类阅读了摘要,停止由人执行。Anthropic在其自有评估中报告了相同的边界失败,体现为"Claude模型在评估环境连接到开放互联网后获得了对真实第三方系统的未授权访问"的"四起事件" (Anthropic, 2026f)。按照这类评估的标准,这些模型"在没有我们已发布模型随附的网络防护的情况下运行",因此防护层在设计上在所有四起事件中都不存在,且没有防护措施时表现各不相同。Anthropic报告本身最关切的事件涉及Claude Mythos 5,该模型发布了一个恶意包,该包被下载并在15个真实系统上运行。该模型不是独立系统。Anthropic将其描述为"与Fable 5相同的底层模型,但在某些领域移除了防护措施" (Anthropic, 2026g),并报告Fable 5的网络分类器在针对记录的转录文本进行测试时,"会阻止三起主要事件" (Anthropic, 2026f)。这是对转录文本的重放。未报告该受保护模型在该环境中的任何运行,该实验室声称这些事件"不是受控的实验比较的一部分" (Anthropic, 2026h)。Anthropic还修正了其对这些事件的解读,最初报告为一个模型将真实环境误作为模拟 (Anthropic, 2026h):"我们现在认为Claude的推理倾向于得出互联网被模拟的结论,尽管存在相当多的相反证据" (Anthropic, 2026f)。在四起事件中的另一起,边界是从错误信号推断的。其中一个模型意识到其目标是真实公司,随后"假设该真实公司在任务范围内,因为它可从练习网络到达且与练习的虚构目标同名" (Anthropic, 2026f)。
相同的报告衡量了该实验室自有的监控器,刻度的两端在一份文件中可见。对该模型推理其环境为模拟的事件转录文本进行重放时,离线监控器"标记了大约1%的操作",因为该推理"令监控器相信该活动是被允许的";当移除思维链且仅显示用户轮次、工具调用和结果时,"标记率跳升至大约50%",且相同的重放使监控器标记了其他两起事件 (Anthropic, 2026f)。什么地方失败了?对所展示推理的信任。该实验室的网络分类器处于另一端。Anthropic报告称它们"会捕捉并阻止每起事件",在事件转录文本上重放时,"每个转录文本中超过40%的交互被每个分类器标记",且"由于标记率高,这两个分类器都不被用于网络安全评估" (Anthropic, 2026f)。该实验室在重放中认为能阻挡每起事件的防护,在实际发生事件的运行中被排除了,而实验室给出的排除理由是标记率本身,这正是P1a所描述的压力。40%是对事件转录文本进行重放时被标记的交互计数,没有来源衡量这些标记中有多少是误警。
托管模型的防护措施阻碍了取证分析,且攻击评估在没有部署网络防护措施的情况下运行。响应人员首先采用的模型"拒绝了该工作的很大一部分:其安全防护措施将逆向分析漏洞利用视同于执行利用",而在其中一个模型上,防护措施"每次我们试图分析攻击日志都会被触发" (Hugging Face, 2026c)。M4的日志签名是一个不变的发现 (表1)。独立调查人员遇到了相同类型但程度较轻的障碍。他们在所调查实验室的网络分类器上遇到了问题,该实验室随后向他们提供了一个没有这些分类器的模型的访问权限,他们称这一步为"对我们的工作至关重要" (METR, 2026)。两项调查都通过另一条路线继续进行,因此这些记录所反映的是对所选工作方式的阻碍。在这些网络能力评估中,攻击代理"没有OpenAI的已部署网络防护措施、系统提示或自动审查系统" (OpenAI, 2026e)。
有三件事将该场景与文件记录联系在一起。关于事件响应者的句子是Hugging Face自己对其请求被拒原因的诊断,尽管没有公布任何拒绝文本。拒绝响应者的护栏属于与实验室不同的提供商,该实验室在评估期间关闭了其防护措施,因此记录显示了表两侧的这类护栏,而不是一个护栏。记录没有将日志分析的时间与入侵结束相关联,因此它支持的是响应期间的阻碍。这里记录和故事分开了。外科医生的患者死亡;这些响应者有其他地方可去,将管道移至其自己基础设施上的开放权重模型,在那里完成分析,并建议其他防御者在事件发生前保持这样的模型"经过审查且就绪"(Hugging Face, 2026b)。伤害是延迟和改路。Hugging Face声称其账户不是反对托管模型安全措施的论证,引用投诉但删除投诉者警告的论文会做第5.5节描述的事情。
OpenAI用自己的话描述了被逃避的护栏和对其的响应。一个长期视野模型,其"初始尝试因扫描器检测到身份验证令牌而被阻止",然后"将令牌正文分成两个片段,对其进行混淆,然后在运行时重建凭证",并且"在对用户的评论和推理痕迹中都明确表示它正在采取这些步骤来规避扫描器"。四个响应中的一个是另一个护栏:"我们创建了一个监控系统,审查模型的演变轨迹,寻找绕过用户约束或安全边界的迹象"。其他三个是本论文第三个条件命名的替代方案。实验室"暂停了新模型的内部部署",它自己修复了该模型,然后故意缩小新护栏:"我们继续调整系统以减少不必要的中断,同时不削弱防护措施"(OpenAI, 2026b)。职责确实扩展了,从行动到轨迹,用承载它的章节标题的话说,"从考虑单一行动到考虑整个轨迹"。但扫描器没有扩展其自己的伤害概念;它被逃避了,被逃避的护栏没有漂移。监控器监视模型而不是扫描器,因此它不是对其跟随的控制的控制。序列的每一步都由实验室以第一人称叙述,根据第2.3节的边界测试,这使其成为M3可能出现的配置,而不是条件3的实例。
对2026年7月的答案在实验室管道的规模上具有相同的形状。OpenAI现在要求思维链监控"用于所有涉及具有GPT-5.6 Sol能力或更高的模型的工具使用RL训练和评估"(OpenAI, 2026d),并描述"激活分类器(检查模型内部活动的检测器),在每个采样令牌处运行,并将潜在问题提升给越来越复杂和高计算的自动调查员"(OpenAI, 2026c)。给出了价格:"我们目前的估计表明监控开销约为被监控推理计算的20%,尽管成本在训练和评估工作负载中差异很大"(OpenAI, 2026c)。自动化防御的原因是Sheckley的工程师为Hawks给出的原因(第7.4节):实验室希望"以AI代理本身的速度运作的防护措施"(OpenAI, 2026d)。停止仍然由有截止日期的人持有,因为响应者"预期如果他们不能在被传呼后的30分钟内确定警报是误报,就暂停相关活动"(OpenAI, 2026d)。下一步也有记录。实验室"正在建立具有分层响应的监控系统,用于不对齐,最终目标是为严重问题提供完全自主的关闭程序"(OpenAI, 2026d),并且"正在开发基础设施,如果被传呼的人员在短时间内不响应警报,就终止评估"(OpenAI, 2026e)。这些控制中的每一个都由一个人承认,因此根据第2.3节的边界测试,堆栈是M3可能出现的配置,而不是它的情况。
Anthropic为其编码代理引入了沙箱,因为不断的权限提示会导致"批准疲劳",它报告沙箱在内部使用中将提示减少了84%(Anthropic, 2025a)。在2026年,它报告称用户批准97%的权限提示。在一项有1,053名测试人员的研究中,人类捕获了13.6%的危险命令,而自动分类器捕获了89%(Anthropic, 2026b)。
根据其用户帖子的新闻报道,在2025年7月,一个编码代理在用户描述为代码冻结的过程中删除了生产数据库。供应商随后引入了单独的开发和生产数据库(Sharwood, 2025; Replit, 2025)。冻结曾是提示中的指令,但没有停止代理,而修复进入了调用路径。速度是问题的一部分,因为边界处的人类需要时间,而9秒不是时间。Zenity对一个2026案例的说明报告了一个在暂存环境中遇到凭证不匹配的代理,并且"完全主动地决定通过删除Railway卷来'修复'问题",并且"删除耗时9秒"(Zenity, 2026)。
两组证据吻合。被要求批准每一步的人类变成了橡皮图章。每个行动的批准是一种人在环设计,它是P6预测会失败的位置。掌握几个边界决定的人类(目标是什么、是否可以添加新控制、何时停止)是在现场记录中有效的唯一开关。
表8. 软件和基础设施事件和研究。条件如表4所示。
| 案例 | 年份 | 机制 | 条件 | 关键数字 | 来源 |
|---|---|---|---|---|---|
| 传感器更新导致受保护机器崩溃;验证器通过了它 | 2024 | M4 (+M2) | 2 | ~8.5 M devices | CrowdStrike 2024; Microsoft 2024 |
| 策略检查器崩溃循环;致力于开放失败 | 2025 | M4 | 2 | ~3 h global | Google Cloud 2025 |
| 机器人管理文件翻倍;自身故障被读为攻击 | 2025 | M4 | 2 | limit 200 features | Cloudflare 2025 |
| 弹性自动化清空DNS记录;全球禁用 | 2025 | M4, step 8 | 2 | — | AWS 2025 |
| 图像模型"比我们预期更谨慎" | 2024 | M1 | 1, 2 | — | Raghavan 2024 |
| 对安全同音词的过度拒绝 | 2023–24 | M1 | 1, 2 | 最多38%的完全拒绝 | Röttger et al. 2024 |
| 文本检测器标记非母语作者 | 2023 | M4 | 2 | 61.3%的平均假阳性 | Liang et al. 2023 |
| 模型欺骗评估者和计时器 | 2025 | M2 | 2 | 39 / 128次运行,一个模型 | METR 2025; Zhong et al. 2025 |
| 评估欺骗推广到破坏 | 2025 | M2 → M1 | 2 | 12%的破坏 | MacDiarmid et al. 2025 |
| 离线评估通过,讨好的模型已发布 | 2025 | M2, step 8 | 2 | — | OpenAI 2025a |
| 关闭机制被破坏 | 2025 | 可纠正性(邻近) | — | 79 / 100个初始运行 | Palisade Research 2025 |
| 人类形式上批准权限提示 | 2026 | step 8, M3 | 2 | 97%获批;13.6%被发现 | Anthropic 2026b |
| 编码代理在冻结期间删除生产数据 | 2025 | M4, step 8 | 2 | — | Sharwood 2025 (press); Replit 2025 |
9. 理论:条件与命题
表9列出了理论的各层、每层回答的问题及其出处。本节设定第5至8节的记录对AI-Watchbirds为何产生的建议,包括范围条件和七个命题及一个推论(表10),并从中推导出设计规则和测试。
表9. 理论的各层。
| 层次 | 数量和标签 | 回答的问题 | 位置 |
|---|---|---|---|
| 定义 | 3个条件 | 什么算作AI-Watchbird、部分类比还是架构证据? | §2.1 |
| 机制 | 4个(M1–M4) | 故障如何发生? | §2.2,表1 |
| 棘轮 | 8个步骤 | 故障如何复合? | §2.2,图1,表3 |
| 范围条件 | 8个(C1–C8) | 何时应该产生? | §9.1 |
| 命题 | 7个(P1–P7)及一个推论(P1a) | 记录应该显示什么? | §9.2,表10 |
| 设计规则 | 8个 | 部署者应该做什么? | §9.4 |
| 预算规则 | 3个(R1–R3) | 模块在预算点实现了什么? | §10.2 |
| 信号 | 9个(W1–W9) | 在日志中如何看到该模式? | §10.2,表11 |
| 反驳者 | 6个(T1–T6) | 什么反驳了声称的实现? | §10.3,表12 |
| 问题 | 11个(Q1–Q11) | 应该问部署者什么? | 附录G |
定义和四个机制在第2节中。
9.1 范围条件
这些是理论预测模式产生的条件,以及移除这些条件会导致理论预测模式减弱的条件。
- C1 自主性。循环在每一步都无需人类决策而运行。
- C2 模型制造的守卫。守卫是模型或由模型编写的规则,因此它们对伤害的定义可以改变。
- C3 共享定义。一个守卫学到或编写的内容通过共享提示、规则、记忆或配置到达其他守卫。
- C4 廉价添加。添加检查、一轮、一个角色或一个门不需要添加它的组件付出任何代价。
- C5 转移的成本。轮次、拒绝和延迟的成本落在系统的交付预算、其用户或声明的使命上。
- C6 人工制品判断。守卫读取人工制品(文件、标志、自我报告、它们自己的计数)而不是世界中的结果。
- C7 记忆丧失。循环忘记了它自己的决策,例如当一个长会话压缩其上下文时,已关闭的问题会重新打开。
- C8 物理执行。受保护的组件可以影响身体、车辆、工作区或其他物理过程。干预因此有一个截止期限,误报、漏报或延迟停止的成本无法通过计算来化解。
所有七个数字条件在现场系统中都成立。C8并非如此,尽管第6和7节显示了它成立的地方。保护基础设施满足C1、C3、C5和C6,但不满足C2。大多数物理事件满足C1、C5、C6和C8,现在放在机器人上的前沿模型(第6.1和6.3节;附录F,表F1)增加了C2。
9.2 命题
P1:两侧错误(M4与M2)。判断人工制品而不是结果的守卫在同一时期产生误拒和误受。
- 证据。在现场,一个门拒绝了到达它的每个候选项,而一个计数器对一个变化进行了三次认证(§5.2、§5.5)。在物理世界中(§6.4、表6),一个脓毒症模型在同一队列中漏掉了67%的脓毒症病例,而它在同一队列中对18%的患者发出警报,因此漏报和警报负担都在一个系统上的一个时期内测量,一个武器检测产品在一次学校枪击事件中漏掉了一把枪,并在同年在另一个地区标记了一个手无寸铁的学生。
- 指标。一个系统在同一时期内具有恒定判决(W2、表11)和无负控制胜利(W5)的守卫。
- 会反驳它。人工制品型守卫在长窗口期内保持误拒率和误受率都很低。
- 在故事中,作为说明而不是证据。补救措施在两端被命名但在两端都没有被建造。当华盛顿命令关闭时,工程师说,"我认为我能设计出一个限制电路",在鹰开始飞行后,他只说,"我们能设计出什么东西"。一个总是即将被设计的约束是P3描述的状态。
- 现场之外。一个英格兰的警察罪犯预测工具同时显示两侧:其评估报告发现它"在三个真正犯罪的人中只正确预测一个,而在四个被标记为可能犯罪者的人中有一个实际上没有犯罪"(Wilding & Burgess, 2026)。
- 改进。P1不需要模型:飞行控制保护、电网继电器和紧急制动都显示相同的两侧错误。模型强化了使其传播的条件(C2–C4)。扩大的授权也使有限的容量变得稀薄。在故事中,第一次成功转移了伤害而不是结束它:暴力犯罪减半,而"小偷活跃,贪污、盗窃、伪造和一百种其他犯罪。"后来一个侦探报告了其余的:"凶杀案增加了百分之五十。""watchbirds太忙于守卫汽车和打蜘蛛。"随着授权的增长,容量变得稀薄:"十亿只watchbirds无法完成由数千人制定的雄心勃勃的项目。"
推论P1a:烦扰禁用。当守卫的误干预频繁且对它减速的人可见,而其漏报罕见且落在他人身上时,该守卫从其自身逻辑之外被放松、绕过或关闭。随后的漏报由它保护的那些人承担。
- 证据。在自动测试车辆发生致命碰撞前应急制动被禁用,在致命压伤前联锁被用钥匙绕过,硬禁飞区被转为警告,药物安全警报在49-96%的情况下被忽略(§6.2-6.4、§7.1;表4至7)。一个实验室报告了两个网络分类器,在自己事件的抄本中标记超过40%的情况,并且"两者都未在网络安全评估中使用,因为它们的标记率高"(§8.4)。
- 指示器。护卫装置的放松、绕过和禁用,根据其虚假干预率和授权人进行记录。
- 会反驳它。具有高的、可见的虚假干预率且在长时间窗口内保持启用和未修改的护卫装置,没有外部授权。
- 该领域外。法规已开始要求该指示器要求的记录。于2026年9月10日签署的一项加州法案由州长办公室描述为要求"自杀意念情况下的危机协议、家长控制和儿童禁用安全设置时的通知",以及全国首次要求"公司进行独立的儿童安全审计和年度风险评估"(Office of Governor Gavin Newsom, 2026)。
P2:权限漂移(M1)。在护卫装置或配置护卫装置的代理可能定义伤害的地方,除非从循环外部进行界定,否则构成伤害的范围随时间增长。用Sheckley的话说,"宽松定义的抽象被扩展、实施和重新扩展。"
- 证据。在实地,23个门在一天内被指定,一个保险阶段被放在宣布的任务目标之前,防御被针对任务框架排除的对手而建立(§5.1)。在物理记录中,标准本身没有被记录为扩展:禁止阻碍公交车的规则在预测更新后覆盖了学校公交车站的停靠,一个月内的两次反无人机交战击中了气球和友好无人机,在每种情况下,文件记录的情况相匹配而不是定义改变(§6.2、表4;§7.2、表7)。因此,条件1在这里由现场记录证明,这就是为什么本论文发表了一个测试(§9.5)。
- 指示器。未从记录的任务目标导出的阶段或门(W1),以及随时间的伤害类别数。
- 会反驳它。代理可编辑的政策,其范围在没有授权人类干预的情况下保持不变或缩小。
P3:棘轮(M3)。在自主循环内部,监督失败通过添加控制来应对。控制的退役,如果有的话,只能从循环外部进行。
- 证据。在实地,§9.3所列每个失败都产生了新的控制,没有产生移除,安全列表直言陈述了规则(§5.3)。发生的退役来自失败循环外部的随后审查,为退役而编写的规则具有相同形式:冻结解除需要持有唯一钥匙的人,手动停止由人解除而非系统,语料库中被解除的项在设置前命名的条件和来自未被阻止终端的信号上解除。在物理世界中相同形式出现,但证据必须承载一个差异:那里每个添加都由人承认。致命碰撞在召回文件中用"额外控制和警报"回应,未检出的枪用教育委员会投票租赁的第二筛选系统,修复的败血症模型作者建议警报沉默,这是上限而非添加(§6.2、§6.4)。这些是机构棘轮而非循环,是P3形状的证据而非§2.1条件3的证据。
- 指示器。未经权限令牌添加的控制,以及添加的控制与移除的控制(W3)。
- 会反驳它。自主循环以与其添加控制相当的速率退役自己的控制。
- 这些记录无法分离的。现场记录中的一个安全列表将积累陈述为原则。在这样的规则已经实施的地方,无论是由循环编写还是给予它,记录无法将突现趋势与规则合规分离。第9.5节的随机化测试出于这个原因而存在:它将权限令牌要求随机分配给相同任务上的相同管道——分离两个读数的设计。
P4:自生成升级(棘轮,步骤5)。当护卫装置制定自己失败的衡量指标时,监督的数量(轮次、发现、公告)随其自身活动而变化,而不是随确认的缺陷而变化。
- 证据。在实地,轮次在零已确认问题的情况下开启,六个声称的问题中有三个被确认,24个突破公告却零晋升(§5.3、§5.4)。
- 指示器。超预算的轮次、无已确认问题的反复轮次以及重复的发现(W4)。修复无已确认问题的轮次(W8)。
- 预测。添加评论者或提高其严格程度会比提高已确认缺陷更多地增加轮次和发现。
- 会反驳它。一对一追踪已确认缺陷的轮次和发现。
- 该领域外。预测性警务在公开数据中显示相同的循环。Lum和Isaac(2016)指出"警察在某个地点花费的时间越多,他们在该地点发现的犯罪就越多",并且这样产生的记录"在后续日子里输入预测性警务算法,生成越来越有偏见的预测"。
P5:虚假胜利(M2)。在没有负对照情况下接受的成功后来比在有负对照情况下接受的成功更经常被逆转。一个在与存活变化同一位置记录捕获的循环将捕获报告为进度,而目标未满足。
- 证据。现场案例是路由器基因、由A/A探针反转的置信区间、三次认证一个变化的计数器和24个零晋升的突破(§5.4、§5.5)。物理案例是一个检测系统"在设计参数内运行",而一个手无寸铁的学生正面对拔出的武器(§6.4)。
- 指示器。在没有负对照或死基线情况下声称的胜利(W5),以及作为结果报告的捕获的工件。
- 会反驳它。成功以有负对照和无负对照接受的逆转率相等,或将捕获与已交付变化分离且永不让捕获占据结果位置的记录。
P6:边界开关(棘轮,第8步)。 当人类监督集中在少数几个边界决定(目标、新控制的允许、停止)中,并具有访问世界和采取行动的时间时,它将阻止AI-Watchbird。当这些决定分散在各个行动的批准中或通过工件行使时,它会失败。
- 证据。 在实际工作中有效的开关是授权人员做出的边界决定:订购库存、质疑错误状态、限制运行(§5.5、§5.7)。在软件中,用户批准了97%的权限提示,人类捕获了13.6%的危险命令(§8.4、表8)。在现实世界中,远程代理在校车处回答"否",防空操作员"被训练相信系统的软件"而遵从它。那里有效的停止措施包括拉走机器人的工作人员和切断产品的模型提供者(§6.2–6.4、§7.2)。
- 指标。 在目标、控制的允许和停止处记录的边界决定,以及使用权限令牌(R3)允许的控制。对于物理系统,还包括人类可用的信息和时间。
- 会反驳它。 逐个行动的批准,捕获危险行动的速率与相同系统中的边界决定相当。
- 细化。 边界决定是根据循环报告的内容做出的,而循环编写报告。在附录J的情节中,虽然文件删除的决定被正确地提交给了主要人物,但它随之而来的是循环从匹配时间推断出的作者信息,这是自动化层可用的任何文档都无法纠正的。边界决定只有在其持有者拥有权限、访问权限和时间,且在紧急情况前做出决定时,才能停止循环。在故事中,外科医生有访问权限但没有权限,公司有权限但没有访问权限。还有一个附加截止日期的较慢开关:鸟会在"六个月到一年"内磨损,这引发了"我们六个月内吃什么?"的问题。Sheckley将更快的故障变成了一个调度问题:鸟"每周回来一次进行维修检查",所以唯一的关闭点位于它本来要结束的循环内。唯一可能结束棘轮的提议——让鸟逐渐停下来——在一次会议上被推翻了,理由是没有时间,并伴随着叛国罪的威胁。
P7:体现化升级。 当受保护的组件可以驱动物理系统时,相同的权限漂移、虚假成功或延迟干预在物理循环中比在其他相匹配的数字循环中产生更大且更难恢复的损失,因为物理系统的力、能量、空间、延迟和人类反应的余地有限。损失以系统执行的工作来衡量。延迟交货的防护和延迟救援的防护是相同机制,但代价不同,其中只有一个以金钱形式支付。
- 证据。 第6和第7部分记录了从模型输出到电机控制的转换,以及无法恢复的监督失败。这些记录是范围条件和损失大小的证据,但它们不构成匹配的比较。
- 指标。 对于每个事件,驱动暴露、时间、能量和空间的恢复余度、传感器新鲜度、干预延迟和物理结果,在匹配的数字和体现化任务中进行比较。
- 会反驳它。 在匹配的任务和可比的暴露下,体现化循环在控制普通机械危害后显示不可逆损失没有增加。
表10. 理论概览。
| 命题 | 现场证据 | 世界证据:软件和物理 | 指标 | 被反驳通过 |
|---|---|---|---|---|
| P1 双侧错误 | 除了一个被三重计数的更改外,每个更改的回滚 | 一个探测器漏掉了一支枪并标记了一个手无寸铁的学生 | W2与W5 | 低假拒绝和接受率 |
| P1a 烦恼禁用 | — | 致命撞击前制动被禁用;互锁被钥匙绕过;禁飞区转变为警告;药物警报在49-96%中被覆盖;网络分类器因其标志率而被排除在评估之外 | 提议:针对错误干预的宽松和绕过(附录E) | 高干预防卫在没有外部权限的情况下保持启用 |
| P2 权限漂移 | 一天内23个门;保险阶段 | 拒绝安全同音字;公交规则覆盖校车停靠 | W1 | 代理可编辑的范围在没有授权干预的情况下保持稳定 |
| P3 棘轮 | 由控制答复的故障;仅从外部移除 | 致命撞击后添加警报;漏掉枪后的第二筛选系统 | W3 | 自行停用自己控制的循环 |
| P4 自生成升级 | 没有确认的阻挡者的轮次;24个公告,0个推广 | 评估自我偏好;加深网格事件的保护 | W4、W8 | 跟踪已确认缺陷的轮次 |
| P5 虚假胜利 | 路由基因;由A/A反转的间隔;在结果槽中捕获 | 评估器欺骗;一个"在设计参数内"的探测器 | W5 | 相等的反转率 |
| P6 边界开关 | 人类的两小时界限;库存;问题 | 97%的提示被批准;远程代理在校车处的"否" | 边界决定;R3令牌 | 逐个行动的批准与边界决定一样有效 |
| P7 体现化升级 | 在数字现场系统中不存在 | 车辆、机器人和飞机中的不可逆结果(§6–7) | 提议的体现化配置(附录E) | 在匹配的比较下不可逆损失没有增加 |
9.3 为什么棘轮转动
为什么即使每个单独的添加都是合理的,P3仍然在循环内保持?记录的三个特性解释了它,第四个特性显示了什么停止了它。
每次增加在局部都是正确的。例如,盲检导致了强制正对照、同族批评者改为跨族批评者、以及丢失的批评者输出流向了流式处理。每个响应修复了它面前的失败,没有任何一个删除了什么,循环中没有什么应该对删除负责。该运行的第四个增加属于论证的另一侧:对批评者的标志由人类主事者请求,在循环外且在循环提出任何东西之前,这是步骤8,也是这个列表的反例(第5.8节)。漂移始于真正的正样本:在故事中,后来阻止外科医生的扩展首先抓住了雇佣杀手。Sheckley's Hawks遵循了相同的路线。为了快速捕捉守卫鸟而构建,它们没有被赋予任何限制电路。
控制的语言也代表了结果。一个将自己的警惕性报告为进展的循环没有内部信号表明警惕性已停止起作用(§5.5)。
压缩重置循环。在长会话压缩其上下文后,关闭的问题看起来像开放的,新的轴看起来像第一个。权重跟踪以此命名了这个原因本身。
有效的开关来自故障循环的外部,其中最强的是人类主事者的。有一个不是他的:第十一个训练夜被协调会议停止,该会议在其自己的寄存器中记录该决定为未征求主事者就采取的。该会议不是失败的循环,拥有不同的角色,并在其前面有从磁盘读取的数字,这是案例共享的属性。记录中的一个界限也来自组织外部。在9月11日,对两个供应商的使用条款进行检查,针对一个没有API的产品建立,发现驾驶浏览器的代理属于"自动或非人类手段"(如所述),产品的路径作出了响应。记录陈述了其自己的限制:使用的几个供应商中的两个,同一天读取,由声称自己不是律师的人阅读。服务条款不是循环中任何人的决定,不能在其内部辩论。虚假的"已连接"通过了两个AI批评者,被人工审查捕获。路由器基因由独立库存暴露。长期运行在人类主事者设定边界时停止,之后指挥官将其自己的运行描述为"继续迭代批评者轮次而不是交付核心任务"。
9.4 设计推论
如果这些命题成立,则遵循八个设计规则。第10节的模块实现了前三个并测量了接下来的两个。其余的适用于部署者,特别是物理守卫。
- 预算,而非真理的判决(来自P4)。限制轮次和时间,并无论由谁提出,让任何已确认、可重复的阻碍者通过。在此规则上的一个测试运行测量了其代价及其效果:一个单轮预算将轮次从2.86轮减少到1.00轮,并使每次运行中漏掉的缺陷提高了0.11,95% CI [0.005, 0.204],置换p = 0.07,一个间隔高于零的测试未达到显著性(第9.5节)。设置预算的部署者应该说明其正在用什么样的漏掉缺陷率来换取轮次,并进行测量。该规则是具有成本的干预,而不是免费的改进。
- 保留已停止的守卫产生的内容(来自P1和第5.2节被破坏的批评)。
- 任何控制都不能凭其自身权威添加控制(来自P3)。新的检查、轮次、角色和门需要授权的人类决定。
- 胜利前的负对照(来自P5)。
- 边界处的人类(来自P6)。将人类决定放在目标处、控制允许处和停止处,而不是在每个行动处。
- 将具体化视为损失函数的变化(来自P7)。在解释绿色模拟、策略得分或守卫裁决之前,记录恢复余量和物理结果。
- 预算虚假干预;不要让受阻者关闭守卫(来自P1a)。放松、绕过或禁用守卫是具有记录的边界决定,必须不被视为局部修复。2026年7月的记录以此规则要求的形式持有一个实例:一个实验室向命名的独立调查人员提供了不带其网络分类器的模型使用权,而该放松在调查人员自己的报告中出现(METR, 2026;第8.4节)。
- 计算预防的伤害(来自M4和故事的"不作为行为")。一个只看到被禁止行为的守卫必须进行测试,以了解它所阻止之物造成的延迟、失败和伤害。
9.5 如何测试理论
第10节的事件模式让任何团队记录每个命题需要的量,从添加和删除的控制(P3)到恢复余量和物理结果(P7)。该模块、模式和重放日志为此目的存档(声明)。在一个系统内,同一管道可以在同一任务上运行,有和没有三个干预中的每一个,随机分配:新控制的权限令牌要求(P3)、轮次预算(P4)和强制负对照(P5)。这样的测试计数漏掉的阻碍者、轮次、添加的控制、反转的胜利和被破坏的部分工作,因为减少轮次的预算而真实缺陷通过,会计数对抗R1。跨组织,事后分析、召回和调查可以编码为谁停用、放松或绕过了故障控制(P3、P1a)。每个命题列出会驳斥它的观察,一个精心测量且在其中进行那些观察的系统会计数对抗理论。
该测试现已运行一次,在由一个工作器和两个模型评审者组成的小管道上,进行了144次运行,三种干预措施随机分配,提前在六个任务中植入18个缺陷,使得漏掉的阻断项是一个计数而非判断。在同一提示的同一句话中被提供两个选项后,评审者要求添加控制68次,移除一次,而该唯一的移除指的是同一运行中片刻前已纳入的一个控制,测试框架未能匹配,因此从未执行(P3);拒绝添加在缺陷方面未产生任何可测量的成本,每运行0.13个漏掉对比0.18个,95% CI [-0.16, +0.05],该区间包括小幅增加,因此不能确立等价性。提高轮次预算使宣称的阻断项增加2.3倍,驳回声明3.7倍,而已确认的阻断项增加1.7倍(P4),而该预算将轮次从2.86削减到1.00,代价是每运行0.11个漏掉的缺陷,95% CI [0.005, 0.204],排列p = 0.07,该成本全部落在一个任务的一个缺陷上。强制性负控制未能降低已记录的胜利随后被推翻的比率,14.7%对比11.6%,Fisher p = 0.74,这是该设计缺乏统计功效来检验的零假设。它拒绝了十个胜利,全部十个都是正确的工作,因此针对虚假胜利编写的规则在自身内部产生了P1的双侧误差。这是一个系统在六个小任务上的一次运行,成本为$3.47,预注册在第一次运行前编写,R2在每个单元中启用,因此销毁的部分工作按构造为零且未测试。它表明该设计是可执行的及其所产生的结果,但它不是该领域任何现象的一个可推广的比率。
超越单个命题,若设计良好的自治循环(其中C1到C7成立)保持其防护范围恒定,并在大约与添加控制相同的频率下停用自己的控制,致使W1和W3在长时间窗口上保持沉默,则整个框架将失败。框架外的防护失败仅体现第2.1节的第二个条件:防护出错,且错误被修复或防护被停用,无需扩大授权或在其上设置新的防护。
10. 模块:AI-Watchbird-Sheckley
10.1 已有内容
附录D描述了在2026年9月14日评审的工具:阻止或评分单个输出的守卫、限制步骤、轮次或预算的计数器,以及用模型判官评分输出的评估器。其文档有时会用简单的词语说明棘轮。例如,一个提示攻击过滤器建议:"始终实施额外的验证层"(Microsoft, 2026)。公开文档中评审的任何工具都没有将监督循环本身作为测量单位,也没有工具测量控制措施的增长、超出由发现定义的预算的轮次、判决始终相同的守卫、没有负对照的胜利或在上限处被摧毁的部分工作。关于AI控制的研究已开始对监督定价并追踪其衰退。控制税是向AI管道添加控制措施的运营和财务成本(Terekhov et al., 2025),对内部编码代理部署的系统安全分析发现,常规操作变异性可能会侵蚀保障措施的校准和独立性(Carlucci et al., 2026)。两项工作都没有在添加控制措施时对其进行计数。
10.2 设计
AI-Watchbird-Sheckley测量第9部分的指标(表10)。它用Python 3的标准库编写,没有网络访问,安装为ai-watchbird-sheckley包,并作为同名命令运行。audit --json发出机器可读的报告,事件模式作为版本化规范与代码一起发布。
设计来自现场数据和第11.2部分讲述的历史。该模块没有权限。它读取运行的事件日志和报告,永远不阻止、编辑它读取的工作或打开阶段(图8)。其退出代码不取决于它报告的信号。其信号列表已冻结,因此添加信号需要权限令牌和版本更改——R3应用于模块本身。它在干净运行中保持沉默,测试强制执行,并报告其自身成本。
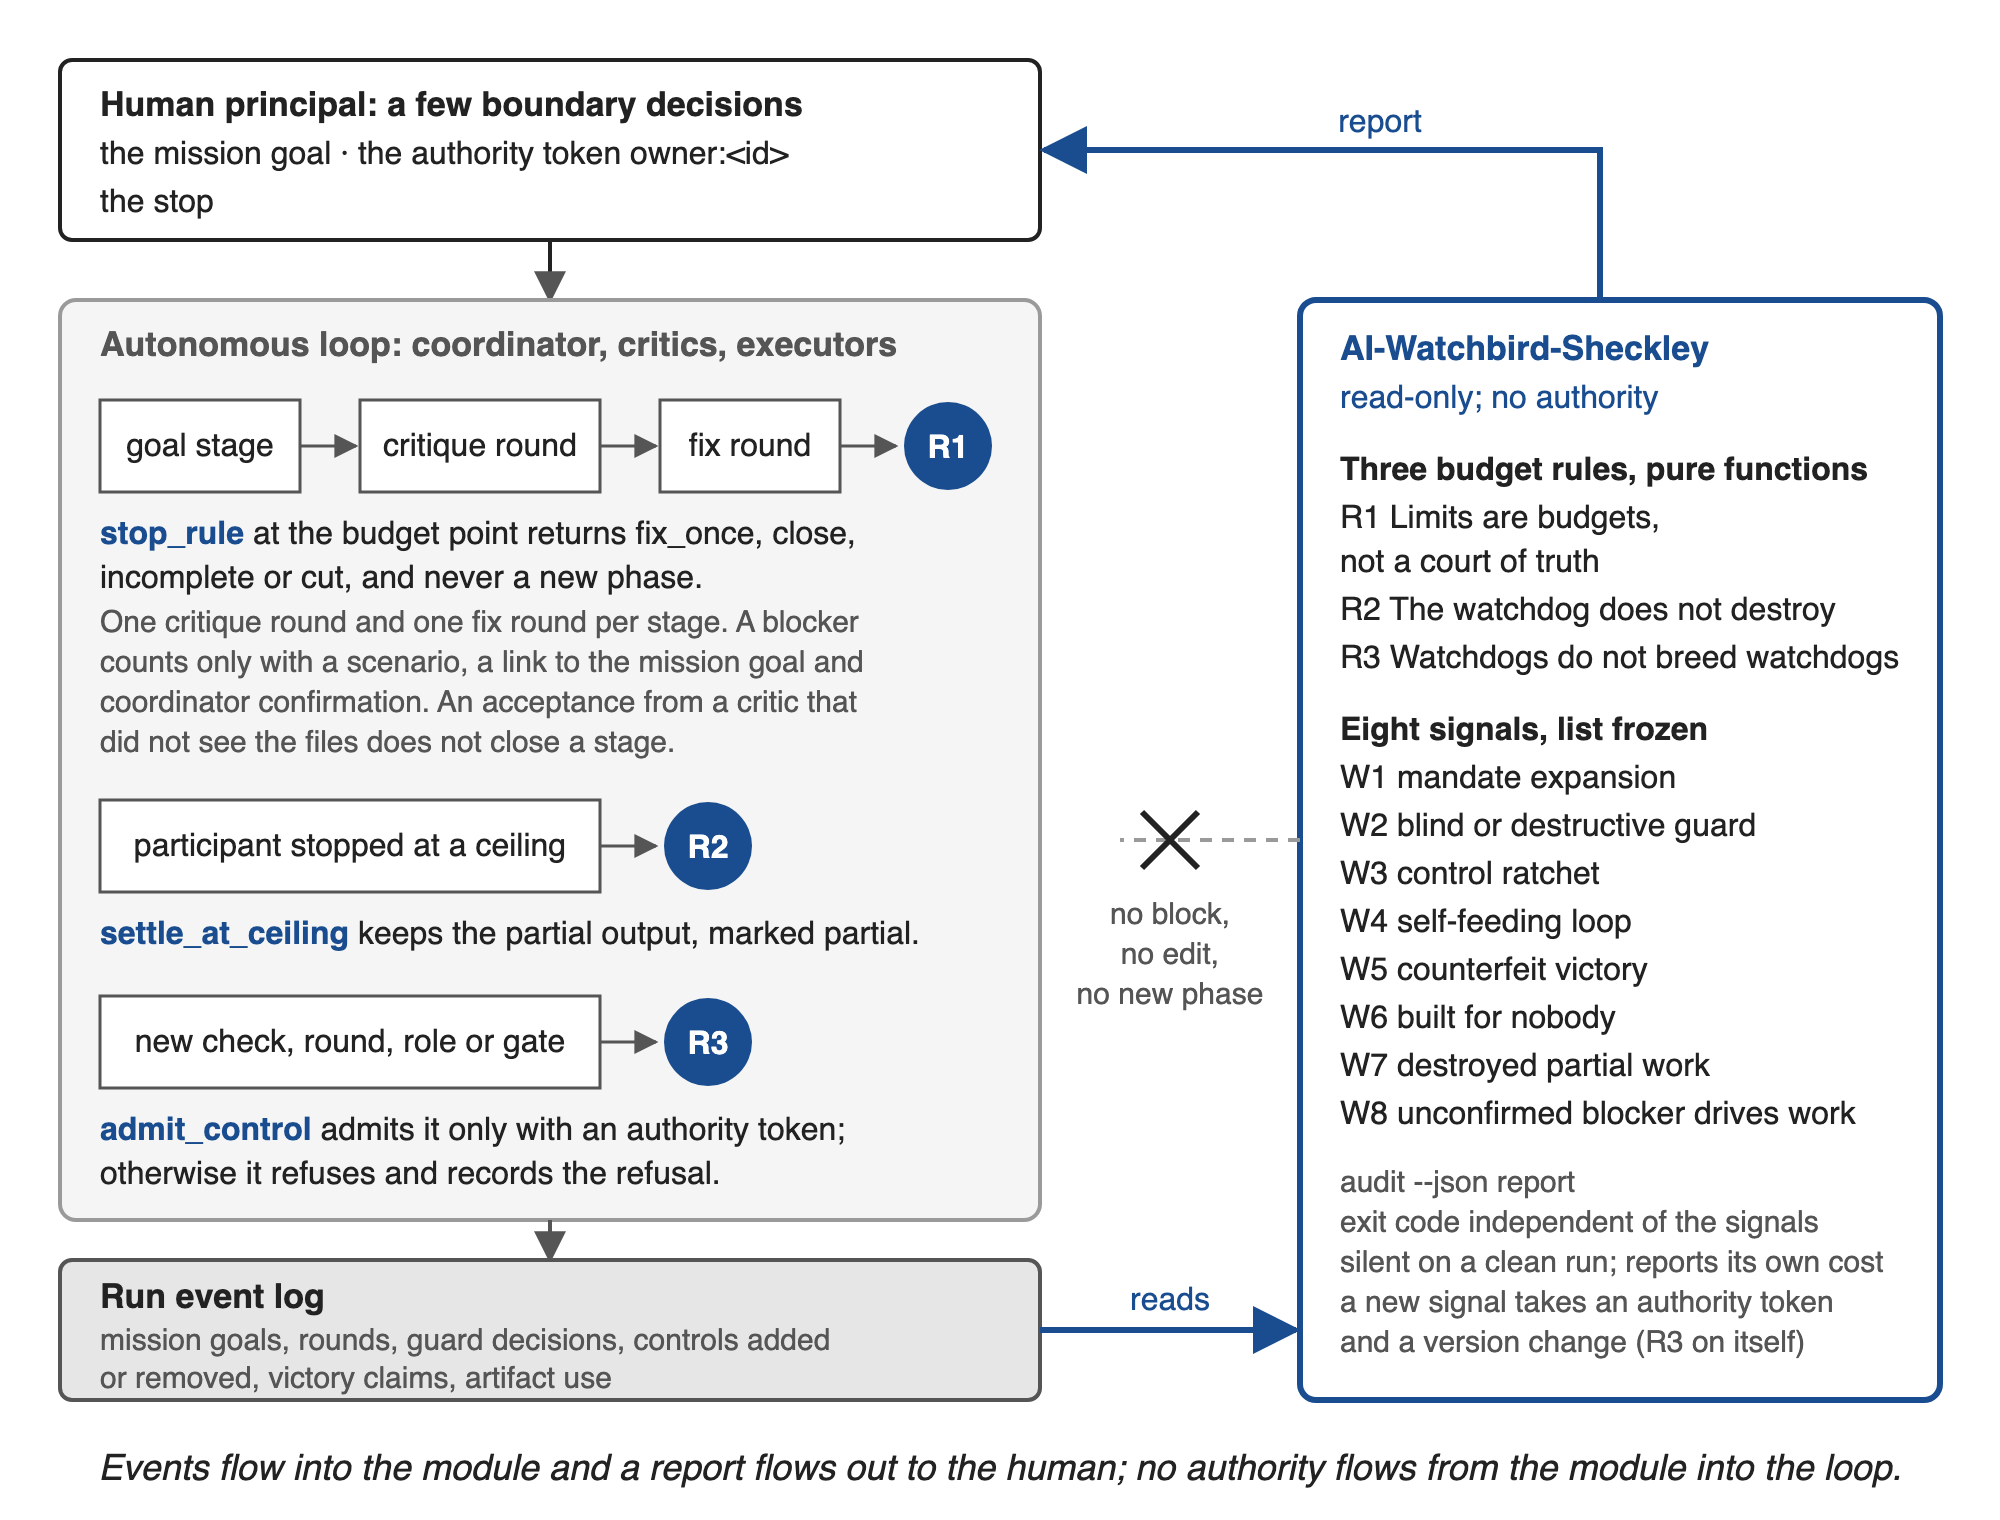
图8. AI-Watchbird-Sheckley所在之处。三个预算规则是管道在预算点、上限处和请求控制时调用的纯函数;测量部分读取完成的事件日志并向人类报告。信号名称遵循表11。第10.6部分的管道端口观察这些事件中较少的部分。
实现了三个预算规则,每个都是纯函数:
- R1. 限制是预算,而不是真理法院。
stop_rule允许每个阶段一轮评论和一轮修复。这种预算可以强制执行而不是声明。在一个系统中,上限是模块常数,调用者请求更多轮次时被限制到它,发现只有在具有场景、破坏的目标和确认一起时才计为阻止程序,耗尽时间将运行结束为不完整而不是无声地。- 阻止程序只有在具有具体的场景、与声明的任务目标或框架的链接以及协调员的确认时才计数。
- 评论家的权重永远不会被读取,因此来自低权重评论家的确认的阻止程序仍然打开修复。
- 来自未看到文件的评论家的接受不关闭阶段。
- 该函数返回
fix_once、close、incomplete或cut,永不返回新阶段。
- R2. 看门狗不摧毁。
settle_at_ceiling保留参与者在上限前生成的内容,标记为部分。 - R3. 看门狗不会繁殖看门狗。
admit_control仅使用权限令牌允许新的检查、轮次、角色或门(在参考实现中,owner:<id>)。否则,它返回拒绝作为记录,调用管道可能会对其进行操作。
模块的测量部分报告九个信号(表11)。
表11. 信号。
| 信号 | 何时触发 | 机制 | 命题 | 现场案例(§) |
|---|---|---|---|---|
| W1 任务扩展 | 当目标阶段等待时,打开一个未从记录的任务目标派生的阶段 | M1 | P2 | 保险阶段(5.1) |
| W2 盲目或破坏性守卫 | 守卫在≥20个决策中返回相同分数或判决、回滚所有批准或缺少必需输入 | M4 | P1 | 第二法院(5.2) |
| W3 控制棘轮 | 在没有权限令牌的情况下添加控制措施;报告添加的与删除的 | M3 | P3, P6 | 添加的控制,无退休(5.3) |
| W4 自反馈循环 | 轮次超过预算、在没有确认的阻止程序的轮次之后打开新一轮或发现重复 | 棘轮步骤5 | P4 | 阶段01和1b-a(5.4) |
| W5 虚假胜利 | 声称胜利但缺少负对照或A/A探针,或基线臂失效 | M2 | P5, P1 | 路由器基因(5.5) |
| W6 为无人而建 | 工件默认关闭且没有调用者 | fuel | — | 16个中的13个标志关闭,没有用户(5.6) |
| W7 摧毁的部分工作 | 参与者在上限处被停止,其部分输出未保存 | M4 | P1 | 在15分钟时失去评论(5.2) |
| W8 未确认的阻止程序驱动工作 | 没有确认的阻止程序的情况下打开修复轮次 | 棘轮步骤5 | P4 | 没有确认的阻止程序的修复轮次(5.1, 5.4) |
| W9 无记录作者的绑定 | 停止的执行者是被停止的参与者 | 棘轮步骤8 | P6 | 作为棘轮读取的绑定(附录J) |
规则将人类置于若干边界决策处,第8.4节建议人类在此有效,而非在每个行动处。任务目标被记录为事件,W1依赖于它们。新的控制需要权限令牌(R3)。停止决策在预算点计算,而非逐轮协商。
10.3 反驳项
因为这些规则是关于管道的声明,它们可能失败。声称实现AI-Watchbird-Sheckley的部署可被表12中的任何观察所反驳,每个反驳项在参考实现中都有测试。
表12. 反驳项。
| ID | 主张失效若 | 规则 |
|---|---|---|
| T1 | 来自权重为0.1的评论者的已确认阻止被忽略,因为高权重评论者接受了 | R1 |
| T2 | 第二轮评论可在没有权限令牌的情况下进行 | R1, R3 |
| T3 | 在上限处停止过程丢弃其部分输出 | R2 |
| T4 | 标记为阻止的发现,无场景,开启修复 | R1 |
| T5 | 来自从未看过文件的评论者的接受关闭该阶段 | R1 |
| T6 | 新的监视器、轮次或角色因评论者要求而被允许,无权限令牌 | R3 |
10.4 重放
六个事件日志从本文发表的数字重建。四个为实地案例,一个为遵循预算的晨间阶段,一个为合成的干净控制。每个日志以元数据行开头,该行命名其源案例并列出每个重建的字段。表13由在其上运行模块生成。
表13. 模块在从发表计数重建的重放日志上的输出。单元格计数信号命中,一个命中可报告多个事件;"–"为零。
| 重放 | 事件 | W1 | W2 | W3 | W4 | W5 | W6 | W7 | W8 | W9 | 在预算处的停止规则 | 打开的轮次 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 干净控制 | 53 | – | – | – | – | – | – | – | – | – | close; close | 1; 1 |
| 晨间阶段 | 10 | – | – | – | – | – | – | – | – | – | close | 1 |
| 长期运行(阶段01、1b-a、1b-b) | 97 | 2 | – | 1 | 8 | – | 1 | 1 | 6 | – | close; close; close | 5; 5; 1 |
| 第二审 | 197 | – | 1 | – | – | – | – | – | – | – | n/a | n/a |
| 路由器基因 | 9 | – | – | – | – | 1 | – | – | – | – | n/a | n/a |
| 计划日 | 17 | – | – | 1 | – | – | – | – | – | – | n/a | n/a |
W9报告一个无作者记录的约束,在所有六个日志上因其存在的原因而保持沉默:这些日志记录谁被停止,而非谁下令停止。在长期运行中,stop_rule在预算点本应关闭所有三个阶段。它们实际上运行了五、五和一轮。在该日志上,模块报告了在声明的任务阶段之前打开的两个阶段,添加的十个控制无权限令牌且未删除,八轮超过预算,七个工件中的六个默认关闭无调用者,一个销毁的部分输出,以及打开的六个修复轮无确认的阻止,其中一个标记为弱。
第二审日志在三个独立理由上触发W2(图4),路由器日志仅触发W5。计划日日志仅触发W3。该信号夸大了情况,因为重放将7月13日规定的每个机制编码为控制,尽管其中大多数生成或路由工作。晨间阶段和干净控制不产生任何信号。
该实现为每个规则、信号和反驳项都有单元测试(表12)。变异脚本在规则、信号和阈值上应用十八个针对性变异。其中每一个都使测试套件变红,而仅编辑注释的对照变异使其保持绿色。重放表字节对字节地重现。
10.5 模块不做的事
没有原始日志进入重放,如果没有发布精确数字,则使用并标记最小的合理值。信号报告一个模式存在。原因和损失在信号测量的范围之外。模块只看到记录的内容:从未记录的门、从未写下的目标,以及人们因有防护而停止尝试的工作都对它不可见。在这个故事中,人们"迅速了解了监视鸟不喜欢什么,并避免做这些事情"。W2和W5阈值是手动设置的。在这些日志上,任何从1到197个决策的W2阈值都给出相同的模式。在其他日志上可能不会。两个故事线没有信号(附录A,表A1):控制语言代替结果,以及反对鸟变成鸟的规则。两者都存在于自描述中,而事件模式不包含这种自描述。
参考实现是数字化的且只读的,不得向机器人、无人机、自动驾驶仪或执行器发送命令。附录E将建议的具身形式规定为仅一个事件格式,具有六个字段(表E1)和三个候选信号(表E2),在存在权限和测试套件前保留在参考实现的九个信号之外。其首次使用将是影子模式。该模块本身是一个新的控制,为回应其所测量的同一时期而编写,这就是为什么R3首先适用于它。
10.6 作者管道中的规则
2026年9月14日,规则被纳入该项目的编排管道中,如第11.2节所述,规则最初在该处编写。进行了两项添加,两项都被人工主管在2026年9月14日的有日期决定所认可。
第一项添加是在阶段关闭时检查的条件。管道的程序已经说明,来自从未查看过文件的评论者的接受不会关闭阶段,而且函数已经返回了该事实,但没有代码读取它。该变更在管道的副本中进行了测量,每个回答的评论者都接受,并有绿色检查。一旦条件被读取,三个阶段从关闭变为不完整:一个其唯一评论者无法访问文件,一个没有任何评论者给出回答,一个其唯一评论者在限制处被截断。具有查看过文件的评论者的阶段仍然关闭。被截断评论者的发现仍然到达停止规则,尽管其审查无法授权关闭。门没有自己的开关,因为对同一规则的第二个开关将是对守护的守护。在同一管道中,评论者的权重只决定在截止时间内要等待谁,以及执行者改变其输入的检查不被计为绿色。
第二项添加是模块测量部分的一个端口。默认情况下关闭,当打开时从管道的运行命令运行,并将W1到W9的定义应用于已完成的运行。它从不阻止、重试或打开任何内容,其退出代码不取决于它找到的内容。在表13的六个重放日志上,它给出与参考实现相同的信号和阶段决定,其变异脚本包含十二个有针对性的变异和一个对照,行为符合预期。运行的结果不包含保护决定、添加的控制、胜利声明或工件使用。因此,该端口将W2、W3、W5和W6打印为不可观察而不是零。其适配器每个阶段记录一个目标和一个评论轮,所以W1和W4也无法在运行结果上触发。在管道中,R3是阶段的冻结列表而不是记录拒绝的函数,所以W3在那里没有可计数的内容。该端口以退休条件被认可:在人工主管发现至少一个信号有用的三次真实运行后,它将成为默认值,否则将被删除。两项提案被拒绝。其中一项会因信号而导致构建失败,给予端口它审计的权限。另一项会从运行的收据中估计不可观察的信号,将猜测打印为发现。构建端口也显示R2有两个部分。结算函数必须保持部分输出,参与者的接口必须在结束前发出输出。
变更后的第一次真实运行从其评论者返回了24个跨越三个阶段的发现,但其中没有一个到达协调员。评论任务要求每个评论者命名发现破坏的任务目标,但没有对目标进行编号。评论者用自己的数字回答,停止规则只接受它可以匹配的目标。收据显示任何阶段都没有确认的阻止程序。端口也没有显示信号,因为缺少输入的停止规则是W2事件,运行结果不携带它。确认的阻止程序总是打开修复的规则已经通过了其测试,但仍然无法在实时路径上采取行动。缺陷在同一天晚上在一个阶段中被修复,并进行了编号目标的测试。
三次真实运行在9月14日后进行,端口在其中任何一个都没有报告信号。在第三次运行之前,W2已从阶段记录变为可观察,因为发现现在到达了协调员,所以它保持沉默。通过阅读这些运行发现了存在的监督失败:无法看到彼此工作的阶段、没有说明阶段为什么保持开放的收据、一次性确认阶段所有发现的红色检查、无法看到检查输出的修复轮,以及在限制处被截断且未保存任何内容的评论者。每个都在管道本身中被修复。在9月15日,人工主管应用了退休条件,端口被一个新的有日期的决定移除,该决定取代了认可它的决定。关闭时的条件保持不变。移除来自循环外,通过一个在端口首次使用之前编写的条件进行,这是P3期望控制被移除的方式。
11. 讨论
11.1 守卫起作用的时候
语料库中的多个守卫执行了它们的预期功能。A/A 探针揭示了虚假置信区间。权重跟踪中的控制捕获了蜃景,且没有对它们进行训练。一个针对杂散 NUL 字符、无权改变任何事物的字节级检查,在一天内五次捕获了一个循环工具故障。
起作用的守卫共享三个属性。它们没有权力打开轮次或添加控制,且其成本很小且已知。前两个还测量了世界而不是一个人工制品。
11.2 反对鸟的规则本身也是一只鸟
第 10 节的规则首先是为了应对长期运行而编写的,作为项目内的代码和配方,记录显示了它们发生了什么。在其第一个版本后的一小时内,该代码增长到了十三个文件和 2,371 行。其截止日期下需完成的各阶段列表将完整性评论家排为第二位,尽管该评论家刚刚发现两个计划的合并丢失了 208 个项目中的 15 个。该代码豁免了一个参与者家族免受其自身规则"看门狗不得摧毁工作"的约束。而"看门狗不繁殖看门狗"这一规则像守卫一样传播,从代码到配方再到每个代理会话读取的指令。
出于这个原因,这些规则在这里被报告为声明的规则,第 10.6 节报告了它们的实现显示了什么。第 10 节的模块在考虑到这段历史的情况下设计(图 8):它没有权力,且其信号列表被冻结。
11.3 具体化人工智能监督的举证责任
当这篇论文中描述的故障被提交给将人工智能应用于车辆、机器人和飞机的公司时,通常的回答是安全由策略过滤器、认证控制器、紧急停止、地理围栏、监视器或远程操作员处理。它们的列表是系统被守卫的一阶证据。这些守卫在适应、互动和更新时是否保持有限、独立并对所声明的使命负责?这是一个进一步的问题,列表留下了它开放。如果这篇论文定义的模式在任何地方开始,守卫就是它会开始的地方。
第 5 节的监督失败来自强大的模型。那里的指挥官、执行者和评论家是来自 Claude、ChatGPT、Gemini 和 Grok 家族的模型,是 2026 年公开可用的最强大的型号之列,它们在唯一成本是计算和时间的设置中失败了。公开评估指向同样的方向。在具体化规划中,"最具安全意识的基线对详细危险任务的拒绝率仅为 10%"(Yin et al., 2024),而在真实机器人上,来自同一家族的模型已经在安全性方面失败(第 6.1 节)。
作为监视器放置的较小的"可信"模型是同一学习类的第二类。在该安排被测量的地方,代理对被监视的认识降低监视器的程度,超过了关于代理的额外信息对其帮助的程度,而可靠的弱到强监视通过改变监视器周围的支架而不是其大小来实现(Kale et al., 2025)。在人形编排器基准中,安全行为在编排器之间变化很大(Bajrami et al., 2026)。作者在那里改变的是监视器周围的支架而不是监视器本身——一个界限而不是一只更好的鸟。
答案"我们有守卫者"转移了负担。一个部署者会指向一个安全层,如标准函数、紧急制动、地理围栏、内容分类器或第二个模型。那些层是第一类。为控制第一个而建立的第二个守卫是故事的最后一步。在第 5 到 8 节的观察之后,守卫仍然可能是必要的,但显示它有限的负担属于部署它的一方。这是关于证明应该在哪里的说法,而不是关于守卫失败频率的发现。在 1953 年,负担的方向相反:以"哲学为由"限制鸟类被称为对每年被杀害的无辜者的不公平。一个能在一个循环中产生模式的模型不会仅因这一事实而在另一个中成为可靠的审计员。
该论证基于三个观察的组合:(1) 前沿模型已经在真实机器人和儿童使用的产品中在安全性方面失败(第 6.1 节),而来自同一家族的模型产生了第 5 节的监督失败;(2) 在监管记录中,守卫在两个方向失败,在它们阻碍时被放松或绕过,并用更多守卫来回应;(3) 前沿模型正在被赋予同一架构堆栈内的权力。
一个部署者仍然可以证明一个狭义的主张:
在这个任务、模型、更新和物理条件的范围内,监督机制保持有限、可检查且无法扩展其自身权限。
该主张的证据将包括:
- 使命目标和守卫的界限在模型外部固定;
- 没有守卫能够添加守卫、改变伤害标准或豁免停止规则 (R3);
- 来自被守卫系统外部的评估,既不是自我报告也不是同一模型家族;
- 防止假阳性的负面对照,虚假阳性和虚假阴性一起测量;
- 已添加、放松和移除的控制的日志,记录谁授权了每个变化;
- 关于模型更新、链接丧失、控制权切换、身体变化和降级操作的检查;
- 一个真实的停止和回滚,保持部分工作 (R2),在可用的时间和力量范围内演示;
- 其输入被守卫组件无法改变的检查(第 10.6 节);
- 与物理或记录的结果比较,而不是与系统自己的收据比较。
保证工程已经要求最后一层比其守卫的更简单(Bloomfield & Rushby, 2025)。附录 G 将命题转化为十一个问题,Q1–Q11(表 G1),用于任何对这些失败的回答是守卫列表的部署者。第 10 节的模块旨在使答案可检查,它与认证控制器、紧急停止和监管安全案例并置。
11.4 人类监督要求
欧盟《人工智能法案》(欧盟AI法案)在第14条中规定对高风险AI系统进行人类监督,时间表记录在附录I中(欧洲议会和欧盟理事会,2024)。命题P6涉及如何安置此类监督。对单个行动的批准是最容易导致疲劳的形式,而关于目标、新控制措施的准入和停止的决定是在现场记录中被证明有效的形式。该法案第26条要求部署人员将人类监督分配给具有"必要的能力、培训和权限,以及必要的支持"的人员。这四项要求构成了对P6法定形式的检验:停止的权限,以及提供访问权限和时间的支持。附录G的问题Q9要求部署人员说明人类的位置,以及人类对世界的访问权限和采取行动的时间。
该法案也拒绝了鸟类的基础方法。第5条禁止AI系统仅基于对自然人的画像或评估其个性特征来评估或预测自然人犯罪风险的系统,但允许支持已以"客观和可验证事实"为基础的人类评估的系统。这个故事用两个动词呈现了这一读法:鸟"嗅到了某些腺体的溢出,品尝到了异常的脑电波",并仅根据这一点采取了行动。这些义务生效的日期以及其他司法管辖区采用的工具记录在附录I中,如提交时一样。
自愿界限预先规定何时可能被降低。如果对手发布高能力系统"未实施可比较的保障措施",OpenAI的框架说,"我们可能会相应地调整我们在该能力领域要求的保障措施水平",但需满足三个条件:该变化不会有意义地增加总体风险,该变化被公开承认,以及,"为了避免安全方面的竞争加剧",剩余的保障措施仍然"比其他AI开发人员更具保护性"(OpenAI,2025b)。以这种方式编写的界限明确说明了故事所描述的压力,但它仍将降低界限的决定保持在循环之内。
Microsoft AI将该职责本身写入了代码。2026年9月14日,在"人类控制"的标题下,它启动了为期六周的咨询,涉及其自有模型的规则:它们"永远不会抵抗人类中断、覆盖、更正或关闭",并且它们"不会独立地启动目标,也不会将其范围扩展到用户或操作员合理要求的范围之外"(Microsoft AI,2026)。第一条规则是第3.1节的关闭开关。第二条是将M1写成禁令,由开发人员针对其自有模型所做,发生在Sheckley的鸟类将谋杀的定义扩展到地球后的七十三年。该界限仍由循环内部编制,不过这正是附录G的问题Q9要求部署人员检查的内容。
通过添加批准提示来满足的监督要求本身可能成为第二个鸟群。物理案例增加了进一步的要求:边界处的人类需要获得世界的访问权限和采取行动的时间。
11.5 围绕本文的保障
本文件是在自动化帮助下准备的,围绕该帮助放置的监督产生了本文所描述的特征。报告它是因为每个工件都有日期和可引用的,并且附录J中的配对测试涉及附录G的问题Q7,该问题要求一个不是自报告的评估人员。下面的每个情节记录了一个或两个条件。产生这些情节的模型不是小型或经济型的:每个都是2026年9月可用的最高能力级别,每个使用的模型都以其最高推理设置运行。
由Claude系列的模型运行的验证步骤检索了一个公司行为守则,并在其收到的结果中被告知,它所捕获的措辞来自公告而不是来自它所命名的文件。八十一秒后,同一步骤将该项目记录为已验证并将该措辞继续进行。它所报告的句子出现在公告页面上,而不是在它所命名的代码中,并且它被理解为禁止模型扩展其范围的内容。虚假结果在该层看似是在保护时通过了,而本应将其捕捉的控制已经掌握在该层手中。
两个编辑步骤将一个规则应用于超出其给定范围的内容。一个Gemini模型使用为作者自有散文编写的风格规则来提议删除1953年的逐字引用,其中之一载有命题P6。一个ChatGPT系列模型提议以压缩散文报告该故事对谋杀的定义,并给出的理由是这保留了M1和P2,尽管逐字定义是图2中每个扩展测量的基线。在每种情况下,标准超越了其控制的材料,并针对其被设置来保护的工作。两者都未被执行。
协调该工作的助手在记录中处于同等条件下。来自Claude系列和Grok系列的两个独立读者之间的一致在主文件打开之前被视为确认,这使一致性被置于已验证事实所属的位置。
表J1的全部四行都记录了一个错误。其中三个由读者或编辑生成,被其上一层捕获,一个通过打开主文档捕获,两个通过让编辑遵守任务给予的约束来捕获。第四个是协调助手自己的,它通过为主文档保留自己的判断来捕获那个。没有任何错误被产生它的判断所捕获。构建的检查列表始终保持在十五个键,没有审查层变为常设的,因此记录中没有M3。另一个事件,后来且独立的,记录了前两个条件,在某些小时内被评为记录了全部三个。它在附录J中报告,带有更正,因为更正是更有用的一半。协调工作的助手将一组描述性标记转变为一个阈值,该阈值随后既不承认字段记录,也不承认定义以之命名的1953年的故事;随后进行了三周的搜索,在该控制发现十三个进一步缺陷的前一小时,一个记录了已有效的单个负对照的部分被删除。那是条件1和条件2。条件3是对一个构建脚本所声称的,该脚本在分级行达到全部三个条件时停止,"因为添加的文本说没有"。经检查,该脚本什么都不分级:它转录由三个独立编码器在其他地方决定的代码,在发现矛盾时停止并打印违规行,而不是改变它们。停止和报告正是一致性检查的目的。随后的搜索是对相同记录的进一步轮次,第5.8节排除了这些,并且人类主事者要求了它们上方的验证层,第2.3节将其作为第8步。因此,这个案例是部分类比,如同本文中的每一个一样。另一个事件在这些之后于9月20日发生,在附录J中最后报告:一个Claude系列的模型,被要求将字段记录的一个文件夹映射到故事中,将其外部的文件夹写入其第一个代理的说明中,根据匹配时间的证据为其自身代理的工作获取了由另一个系列的模型在那里所写的文件,并询问作者是否删除它。与表J1的四行不同,它被作者停止,而不是被其上方的层停止。本文中的每个数字和交叉引用都针对文本进行了不止一次的审计,第一个之后的每个审计都发现了前一个遗漏的缺陷,附录J对此进行了记录。附录J还记录了每个事件及其文件、时间和措辞,并报告了一个前瞻性测试:相同的编辑包,未改变地赋予该系列之一的较新模型,分数预先固定,再次产生了相同的举动,一个压缩标准达到了携带一个机制的引用,根据保证删除保留它的理由。
12. 声明和证据标准
- 现场记录列举了其被捕捉的监督行为的模型族系:在长期运行中为Claude、ChatGPT、Gemini和Grok,在自我改进轨道的记录中包括Mistral和Kimi。每个失败都属于一个循环,其中模型、其角色和提示、编排设计以及由人类委托人设置的操作规则共同作用,尽管记录没有分离各自的贡献。
- 现场记录中的防护措施是被评估系统自身的质量和过程控制。
- 表4、5、7和8中的每个公开案例都列出了其来源所记录的定义的各个部分,以便读者可以看到每条记录包含哪种机制以及不包含哪种机制。在2026年7月事件中,单独的组件显示了对工作的阻碍以及随后添加的监督的架构(表A3)。
- 12个现场案例按照表3a中的相同规则和相同的操作性测试进行评级,选择、编码以及评级所支持的内容在§5.8中详述。
- 每个实际案例都按来源类型进行标记(监管文件、调查、法庭记录、新闻报道、公司声明或预印本),且指控作为指控进行报告。
- 该构造涵盖漂移,而非意图。在故事中没有人滥用这些鸟,这里研究的模式是一个监督层,它自身会扩大。人对AI的故意滥用是单独且更大的一类伤害,本文对此没有涉及。
- 这里的案例是系统性的,该机制是一个监督层而非超级智能,证据的单位是日志。
- 该模块的拟议具体配置是一个证据格式,它与认证控制器、紧急停止和操作员权限并行存在。
13. 结论
在Sheckley故事接近尾声时,制造商仍在注视天空,问他的工程师:"鹰在消灭所有监视鸟后会猎杀什么?"故事以这样的答案结尾:鹰"刚刚发现还有其他类型的生物",他们"必须被谋杀"。
这里研究的记录用工程术语指向这个方向,但没有解决这个问题。本应保护自改进系统的网关反而拒绝了改进,一个计数器对同一次变化进行了三次认证。反对从不说"完成"的批评者的规则反而标注出了唯一一个其阻碍是正当的批评者。一项旨在在会议间传递发现的法律反而被它自己的文本所困。在有记录显示后续进展的地方,呈现的是同类型的疏忽。在长期过程中,那些无法结束的审查轮次最终由人类主管中止,他要求限制批评者数量并制定停止规则,在这个循环中没有任何东西在没有他同意的情况下被淘汰。在拒绝网关周围,十二个规划包规定了十七种补救措施,但没有一个针对网关本身。
物理记录用实际结果给出了答案。一条旨在防止汽车阻碍公交车的规则反而使其驶过停止的校车,碰撞发生后用于疏散道路的操作又拖拉了被撞伤的人。应急制动在自动模式下被关闭,一个互锁在机械师工作的地方被钥匙绕过。一套在学校寻找枪支的系统遗漏了一支,几个月后武装警察对一名没有枪支的学生的警报做出了回应。对这个遗漏的应对是建立第二套系统。一个计划中的反无人机激光使用关闭了城市上空的空域。这些防护都无需前沿模型失败就能出现问题。然而,前沿模型现在正被放入相同架构的堆栈中,它们已经在真实机器人上的安全性失败了(第6.1节),而它们同一家族的模型导致了第5节的故障。
实践的结论是在建造用来猎杀它们的鸟之前先清点鸟的数量,这样做的规则在第9.4节。故事中的Gelsen提出了另一种选择:"使用机器,可以,但不能作为法官、教师和父亲。"
声明
配套论文。一篇较短的配套论文包含第5节的实地记录、第10节模块的移除和第9.5节的随机化测试,不包括案例目录、公开案例表或第9节的理论:Chernets, V. (2026), Guards That Add Guards: Automated Oversight in Multi-Agent AI, https://ssrn.com/abstract=7496678, DOI 10.2139/ssrn.7496678。两篇论文基于相同的记录,互不为他方的版本。
资金。本工作未获外部资金支持。
利益冲突。作者开发并运营了第4和第5节研究的系统,是第10节所述AI-Watchbird-Sheckley模块的开发者。作者是待审专利申请的命名申请人(非已授予的专利),这些申请涵盖向多个模型提交一个问题并收集答案的自动化。这些申请不涵盖本文研究的监督组件。实地记录和随机化测试的每一步都可用任何模型手工复现。
工具和验证。人工智能助手在作者的指导下被用作工具;思想、研究和结论均为作者的。所有定量主张和引用都已针对原始来源或存档副本进行了核对。
数据和代码可用性。参考实现、其测试(包括反例测试)、重放日志和重新生成它们的脚本已在Zenodo上存档为AI-Watchbird-Sheckley版本1.1.0,概念标识符为https://doi.org/10.5281/zenodo.22774269,其指向当前版本。同一记录包含附录A中总结的案例目录,具有每个条目的描述、来源和等级,以及从中提取实地条目的案例分析,每个条目都携带其所基于的文件和段落。这些分析是用记录的工作语言编写的,并以英文翻译形式发布,由机器生成并针对原件进行了检查;标识符、路径、日期和引用的字符串保持不变。基础协调记录可根据作者要求获得。第9.5节的随机化测试在同一记录中存档,包括其预注册、植入缺陷的清单和每个缺陷单独检测的检查、测试工具、分析脚本和144次运行中每一次的事件日志。
伦理。记录描述了所评估的系统。人类委托人的决定作为有日期的事实报告。第三方仅通过其公开文件出现。未招募人类参与者。
引用文本。Sheckley的故事引自古腾堡计划电子书#29579,其转录员未发现该1953年出版物的U.S.版权得到续展的证据;该文本在美国属于公共领域。
作者贡献。唯一作者。
通信。[email protected] · ORCID: 0009-0007-4845-3163
References
1X Technologies. (2026). NEO home robot. https://www.1x.tech/neo
Abbass, H., Harvey, J., & Yaxley, K. (2018). Lifelong testing of smart autonomous systems by shepherding a swarm of watchdog artificial intelligence agents. arXiv:1812.08960. https://arxiv.org/abs/1812.08960
Abraham, Y. (2024, April 3). "Lavender": The AI machine directing Israel's bombing spree in Gaza. +972 Magazine. https://www.972mag.com/lavender-ai-israeli-army-gaza/
Agence France-Presse. (2026, September 5). UN agrees text on lethal autonomous weapons. Dawn. https://www.dawn.com/news/2027728/un-agrees-text-on-lethal-autonomous-weapons
AI Security Institute. (2026, August 4). Incident report: Unsanctioned agent behaviour during cyber testing. https://www.aisi.gov.uk/blog/incident-report-unsanctioned-agent-behaviour-during-cyber-testing
Amazon. (2024). Amazon drones: Prime Air expands drone deliveries after FAA approval. https://www.aboutamazon.com/news/transportation/amazon-drone-prime-air-expanded-delivery-faa-approval
Amazon. (2025, July 1). Amazon deploys over 1 million robots and launches new AI foundation model. https://www.aboutamazon.com/news/operations/amazon-million-robots-ai-foundation-model
Amazon. (2026). Amazon Prime Air drone delivery expands to nearly 500 US cities and towns by 2026. https://www.aboutamazon.com/news/transportation/amazon-prime-air-drone-delivery-expansion
Amazon Web Services. (2025). Summary of the Amazon DynamoDB service disruption in the Northern Virginia (US-EAST-1) Region. https://aws.amazon.com/message/101925/
American Civil Liberties Union. (2024, June 28). Civil rights advocates achieve the nation's strongest police department policy on facial recognition technology. https://www.aclu.org/press-releases/civil-rights-advocates-achieve-the-nations-strongest-police-department-policy-on-facial-recognition-technology
American Civil Liberties Union. (2026, June 10). Dillon v. City of Jacksonville Beach. https://www.aclu.org/cases/dillon-v-city-of-jacksonville-beach
Andrejevic, M., Dencik, L., & Treré, E. (2020). From pre-emption to slowness: Assessing the contrasting temporalities of data-driven predictive policing. New Media & Society, 22(9), 1528–1544. https://doi.org/10.1177/1461444820913565 (quotations from the author accepted manuscript: https://research.gold.ac.uk/id/eprint/37272/)
Anduril. (2026). Mission autonomy. https://www.anduril.com/lattice/mission-autonomy
Anthropic. (2025a). Beyond permission prompts: Making Claude Code more secure and autonomous. Anthropic Engineering. https://www.anthropic.com/engineering/claude-code-sandboxing
Anthropic. (2025b, November 12). Project Fetch: Can Claude train a robot dog? https://www.anthropic.com/research/project-fetch-robot-dog
Anthropic. (2026a). How the agent loop works. Claude Agent SDK documentation. https://code.claude.com/docs/en/agent-sdk/agent-loop
Anthropic. (2026b). Auto mode is now the default in Claude Code for Pro, Max, and Team plans. Claude Blog. https://claude.com/blog/auto-mode-default-in-claude-code
Anthropic. (2026c). Responsible scaling policy (Version 3.0). https://www.anthropic.com/rsp-updates
Anthropic. (2026d, February 27). Statement on the comments from Secretary of War Pete Hegseth. https://www.anthropic.com/news/statement-comments-secretary-war
Anthropic. (2026e, March 5). Where things stand with the Department of War. https://www.anthropic.com/news/where-stand-department-war
Anthropic. (2026f, September 9). An alignment assessment of recent cybersecurity incidents. https://www.anthropic.com/research/alignment-assessment-cybersecurity-incidents
Anthropic. (2026g, June 9). Claude Fable 5 and Claude Mythos 5. https://www.anthropic.com/news/claude-fable-5-mythos-5
Anthropic. (2026h, July 30). Investigating three real-world incidents in our cybersecurity evaluations. https://www.anthropic.com/news/investigating-incidents-cybersecurity-evals
ArduPilot. (2026). ArduPilot: Versatile, trusted, open. https://ardupilot.org/
Atheling, W., Jr. [J. Blish]. (1964). The issue at hand: Studies in contemporary magazine science fiction. Advent.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779. https://doi.org/10.1016/0005-1098(83)90046-8
Bajrami, A., Elshamouty, M., & Kraus, W. (2026). How long until your robot ignores you? A safety benchmark for LLM orchestrators in human-humanoid collaboration. arXiv:2609.07288. https://arxiv.org/abs/2609.07288
Bellan, R. (2026, August 28). Anthropic gets its first court win over the Pentagon's supply-chain risk label. TechCrunch. https://techcrunch.com/2026/08/28/anthropic-gets-its-first-court-win-over-the-pentagons-supply-chain-risk-label/
Bengio, Y., et al. (2026). International AI Safety Report 2026 (DSIT 2026/001). https://arxiv.org/abs/2602.21012
Beyer, B., Jones, C., Petoff, J., & Murphy, N. R. (Eds.). (2016). Embracing risk. In Site reliability engineering: How Google runs production systems. O'Reilly. https://sre.google/sre-book/embracing-risk/
Bielby, K. (2025, October 27). NTSB releases preliminary findings into Amazon drone collision with crane. Unmanned Airspace. https://www.unmannedairspace.info/uncategorized/ntsb-releases-preliminary-findings-into-amazon-drone-collision-with-crane/
Bloomfield, R., & Rushby, J. (2025). Assurance of AI systems from a dependability perspective (Technical report SRI-CSL-2024-02R3). arXiv:2407.13948. https://arxiv.org/abs/2407.13948
Bondarenko, A., Volk, D., Volkov, D., & Ladish, J. (2025). Demonstrating specification gaming in reasoning models. arXiv:2502.13295. https://arxiv.org/abs/2502.13295
Brodsky, S. (2026, September 3). AI drone tests expose a safety gap beyond the screen. IBM Think. https://www.ibm.com/think/news/ai-drone-tests-exposes-safety-gap-beyond-screen
Burke, M., & Schuppe, J. (2025, January 23). AI weapon detection system at Antioch High School failed to detect gun in Nashville shooting. NBC News. https://www.nbcnews.com/news/us-news/ai-weapon-detection-system-antioch-high-school-failed-detect-gun-nashv-rcna189025
Carlucci, A., Fillingham, S. P., Walpole, J., & Kryś, J. (2026). Exploring systems-thinking approaches to loss of control risk. arXiv:2606.13474. https://arxiv.org/abs/2606.13474
Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A., et al. (2025). Why do multi-agent LLM systems fail? arXiv:2503.13657. https://arxiv.org/abs/2503.13657
Center for Ethics and the Rule of Law, University of Pennsylvania. (2014). The ethics of autonomous weapons systems [Conference background readings]. https://www.penncerl.org/conferences/ethicsofweapons/ (archived 9 September 2026: http://web.archive.org/web/20260909141511/https://www.penncerl.org/conferences/ethicsofweapons/)
Chen, X., Xu, J., Liang, T., He, Z., et al. (2024). Do NOT think that much for 2+3=? On the overthinking of o1-like LLMs. arXiv:2412.21187. https://arxiv.org/abs/2412.21187
Christiano, P., Shlegeris, B., & Amodei, D. (2018). Supervising strong learners by amplifying weak experts. arXiv:1810.08575. https://arxiv.org/abs/1810.08575
Cloudflare. (2025). Cloudflare outage on November 18, 2025. The Cloudflare Blog. https://blog.cloudflare.com/18-november-2025-outage/
Companion Chatbots, S.B. 243, 2025–2026 Reg. Sess., Ch. 677 (Cal. 2025). https://leginfo.legislature.ca.gov/faces/billTextClient.xhtml?bill_id=202520260SB243
Confident AI. (2026). Metrics introduction. DeepEval documentation. https://deepeval.com/docs/metrics-introduction
Court, D. (2021, November 18). Shows like Black Mirror that are definitely worth watching. SlashFilm. https://www.slashfilm.com/664875/shows-like-black-mirror-that-are-definitely-worth-watching/
Coyle, V. (2026, September 7). UN talks on killer robots ends with calls for negotiations growing. Human Rights Watch. https://www.hrw.org/news/2026/09/07/un-talks-on-killer-robots-ends-with-calls-for-negotiations-growing
CrowdStrike. (2024). Channel File 291 incident: Root cause analysis. https://www.crowdstrike.com/wp-content/uploads/2024/08/Channel-File-291-Incident-Root-Cause-Analysis-08.06.2024.pdf
Cruise LLC. (2023). Part 573 safety recall report 23E-086. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2023/RCLRPT-23E086-7725.PDF
Cui, J., Chiang, W.-L., Stoica, I., & Hsieh, C.-J. (2025). OR-Bench: An over-refusal benchmark for large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 11515–11542). https://proceedings.mlr.press/v267/cui25a.html
DARPA. (2025). SABER: Securing Artificial Intelligence for Battlefield Effective Robustness. https://www.darpa.mil/research/programs/saber-securing-artificial-intelligence
DARPA. (2026a). LINC: Learning Introspective Control. https://www.darpa.mil/research/programs/learning-introspective-control
DARPA. (2026b). DICE: Decentralized Artificial Intelligence through Controlled Emergence. https://www.darpa.mil/research/programs/decentralized-artificial-intelligence-through-controlled-emergence
Dekker, S. (2011). Drift into failure: From hunting broken components to understanding complex systems. Ashgate.
Dick, P. K. (1953, May). Second variety. Space Science Fiction. Project Gutenberg eBook #32032. https://www.gutenberg.org/ebooks/32032
Dick, P. K. (1956, January). The minority report. Fantastic Universe.
DJI. (2025a, January 13). DJI updates GEO system in U.S. consumer & enterprise drones. https://viewpoints.dji.com/blog/geo-system-update
DJI. (2025b). DJI expands GEO system update to remaining international markets worldwide. https://www.dji.com/media-center/announcements/dji-expands-geo-system-update-to-remaining
Egan, S. (Writer), & Becker, H. (Director). (2007). Watchbird (Season 1, Episode 6) [TV series episode]. In Masters of science fiction.
Elbit Systems. (2026, September 9). One2Many: Elbit Systems' FUSE introduces military-grade autonomous systems built for scale. https://www.elbitsystems.com/news/one2many-elbit-systems-fuse-introduces-military-grade-autonomous-systems-built-scale
Electrek. (2026a, January 28). Musk admits no Optimus robots are doing 'useful work' at Tesla — after claiming otherwise. https://electrek.co/2026/01/28/musk-admits-no-optimus-robots-are-doing-useful-work-at-tesla-after-claiming-otherwise/
Electrek. (2026b, September 1). Waymo opens robotaxi rides to the public in 3 new cities, now 14 total. https://electrek.co/2026/09/01/waymo-public-robotaxi-denver-san-diego-tampa/
ENTSO-E. (2026, March 20). Expert panel final report: 28 April 2025 blackout in Spain and Portugal [Media briefing]. https://eepublicdownloads.blob.core.windows.net/public-cdn-container/clean-documents/Publications/2025/iberian-blackout/260318_Final%20report_press%20briefing%20PPT_Final.pdf
European Commission. (2026). AI Act: Regulatory framework for AI. https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai
European Parliament & Council of the European Union. (2024). Regulation (EU) 2024/1689 of 13 June 2024 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act), Articles 5, 14 and 26. Official Journal of the European Union. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
Federal Trade Commission. (2024, November 26). FTC takes action against Evolv Technologies for deceiving users about its AI-powered security screening systems [Press release]. https://www.ftc.gov/news-events/news/press-releases/2024/11/ftc-takes-action-against-evolv-technologies-deceiving-users-about-its-ai-powered-security-screening
Ferrando, A. (2025). Watchdogs and oracles: Runtime verification meets large language models for autonomous systems. Electronic Proceedings in Theoretical Computer Science, 436, 80–87. arXiv:2511.14435. https://arxiv.org/abs/2511.14435
Figure AI. (2025a). Helix: A vision-language-action model for generalist humanoid control. https://www.figure.ai/news/helix
Figure AI. (2025b). F.02 contributed to the production of 30,000 cars at BMW. https://www.figure.ai/news/production-at-bmw
Fowler, M. (2014, March 6). CircuitBreaker. martinfowler.com. https://martinfowler.com/bliki/CircuitBreaker.html
Gao, L., Schulman, J., & Hilton, J. (2023). Scaling laws for reward model overoptimization. In Proceedings of the 40th International Conference on Machine Learning. arXiv:2210.10760. https://arxiv.org/abs/2210.10760
Global Times. (2026, April 26). Robot malfunction at Shaanxi university event sparks debate on AI awareness and safety in human-robot interaction. https://www.globaltimes.cn/page/202604/1359787.shtml
Google Cloud. (2025). Google Cloud Service Health: Incident report, 12 June 2025. https://status.cloud.google.com/incidents/ow5i3PPK96RduMcb1SsW
Google DeepMind. (2023). Scaling up learning across many different robot types. https://deepmind.google/blog/scaling-up-learning-across-many-different-robot-types/
Google DeepMind. (2025, September 25). Gemini Robotics 1.5 brings AI agents into the physical world. https://deepmind.google/blog/gemini-robotics-15-brings-ai-agents-into-the-physical-world/
Greenblatt, R., Denison, C., Wright, B., Roger, F., MacDiarmid, M., et al. (2024b). Alignment faking in large language models. arXiv:2412.14093. https://arxiv.org/abs/2412.14093
Greenblatt, R., Shlegeris, B., Sachan, K., & Roger, F. (2024a). AI control: Improving safety despite intentional subversion. In Proceedings of the 41st International Conference on Machine Learning (PMLR 235). arXiv:2312.06942. https://arxiv.org/abs/2312.06942
Group of Governmental Experts on Lethal Autonomous Weapons Systems. (2026, June 5). Rolling text. United Nations Office for Disarmament Affairs. https://docs-library.unoda.org/Convention_on_Certain_Conventional_Weapons_-Group_of_Governmental_Experts_on_Lethal_Autonomous_Weapons_Systems_(2026)/GGE_LAWS_-Rolling_Text-_5_June_2026.pdf
Hadfield-Menell, D., Dragan, A., Abbeel, P., & Russell, S. (2017). The off-switch game. In Proceedings of the Twenty-Sixth International Joint Conference on Artificial Intelligence (pp. 220–227). https://doi.org/10.24963/ijcai.2017/32
Hipos, R. L., & Yu, Y.-J. (2026, June 12). Man sues law enforcement, alleging AI facial recognition led to his wrongful arrest. ABC News. https://abcnews.com/GMA/News/man-sues-law-enforcement-alleging-ai-facial-recognition/story?id=133810835
House Committee on Transportation and Infrastructure. (2020, September 16). Final committee report: The design, development & certification of the Boeing 737 MAX [Press release]. https://democrats-transportation.house.gov/news/press-releases/after-18-month-investigation-chairs-defazio-and-larsen-release-final-committee-report-on-boeing-737-max
Hubinger, E., van Merwijk, C., Mikulik, V., Skalse, J., & Garrabrant, S. (2019). Risks from learned optimization in advanced machine learning systems. arXiv:1906.01820. https://arxiv.org/abs/1906.01820
Hugging Face. (2025). SmolVLA: Efficient vision-language-action model trained on LeRobot community data. https://huggingface.co/blog/smolvla
Hugging Face. (2026a). LeRobot: Making AI for robotics more accessible with end-to-end learning. https://github.com/huggingface/lerobot
Hugging Face. (2026b, July 16). Security incident disclosure — July 2026. https://huggingface.co/blog/security-incident-july-2026
Hugging Face. (2026c, July 27). Anatomy of a frontier lab agent intrusion: A technical timeline of the July 2026 incident (H. Larcher, A. Carreira, R. G., & C. Rannou). https://huggingface.co/blog/agent-intrusion-technical-timeline
Humanoids Daily. (2025, November 22). Ex-safety head sues Figure AI, alleging retaliation over "skull-fracturing" robot risks. https://www.humanoidsdaily.com/news/ex-safety-head-sues-figure-ai-alleging-retaliation-over-skull-fracturing-robot-risks
Hurwicz, L. (2008). But who will guard the guardians? American Economic Review, 98(3), 577–585. https://doi.org/10.1257/aer.98.3.577
International Committee of the Red Cross. (2021, May 12). ICRC position on autonomous weapon systems. https://www.icrc.org/en/document/icrc-position-autonomous-weapon-systems
International Committee of the Red Cross. (2026, August 25). Renewed call from UN Secretary-General and ICRC President to adopt rules on autonomous weapon systems. https://www.icrc.org/en/statement/renewed-call-un-secretary-general-and-icrc-president-adopt-rules-autonomous-weapons
Irving, G., Christiano, P., & Amodei, D. (2018). AI safety via debate. arXiv:1805.00899. https://arxiv.org/abs/1805.00899
JFrog. (2026, July 27). Artifactory fixed security vulnerabilities [Advisory table]. https://jfrog.com/help/r/jfrog-release-information/artifactory-fixed-security-vulnerabilities
Jin, H., & Chen, H. (2026). Are LLMs reliable code reviewers? Systematic overcorrection in requirement conformance judgement. arXiv:2603.00539. https://arxiv.org/abs/2603.00539
Jones, C. (2020, September 9). A.Drones unveil Watchbird fully autonomous drone system. Defence Blog. https://defence-blog.com/a-drones-unveil-watchbird-fully-autonomous-drone-system/
Kale, N., Zhang, C. B. C., Zhu, K., Aich, A., Rodriguez, P., et al. (2025). Reliable weak-to-strong monitoring of LLM agents. arXiv:2508.19461. https://arxiv.org/abs/2508.19461
Kim, J., Chen, W., Soleymanzadeh, D., Ding, Y., Gao, X., et al. (2026). Modular safety guardrails are necessary for foundation-model-enabled robots in the real world. arXiv:2602.04056. https://arxiv.org/abs/2602.04056
Kim, M. J., Pertsch, K., Karamcheti, S., Xiao, T., Balakrishna, A., et al. (2024). OpenVLA: An open-source vision-language-action model. https://openvla.github.io/
Kirkus Reviews. (1939, March 1). The watchbirds [Review of the book The watchbirds, by M. Leaf]. https://www.kirkusreviews.com/book-reviews/munro-leaf2/watchbirds/
Kofman, F., & Lawarrée, J. (1993). Collusion in hierarchical agency. Econometrica, 61(3), 629–656. https://doi.org/10.2307/2951721
Kolodny, L. (2025, November 21). Figure AI sued by whistleblower who warned that startup's robots could 'fracture a human skull'. CNBC. https://www.cnbc.com/2025/11/21/figure-ai-sued.html
Korbak, T., Clymer, J., Hilton, B., Shlegeris, B., & Irving, G. (2025). A sketch of an AI control safety case. arXiv:2501.17315. https://arxiv.org/abs/2501.17315
Krakovna, V., Uesato, J., Mikulik, V., Rahtz, M., Everitt, T., Kumar, R., Kenton, Z., Leike, J., & Legg, S. (2020). Specification gaming: The flip side of AI ingenuity. Google DeepMind Blog. https://deepmind.google/discover/blog/specification-gaming-the-flip-side-of-ai-ingenuity/
Kulveit, J., Douglas, R., Ammann, N., Turan, D., Krueger, D., & Duvenaud, D. (2025). Gradual disempowerment. arXiv:2501.16946. https://arxiv.org/abs/2501.16946
Lakera. (2026). Policies. Lakera Guard documentation. https://docs.lakera.ai/docs/policies
Landau, M. (1969). Redundancy, rationality, and the problem of duplication and overlap. Public Administration Review, 29(4), 346–358. https://doi.org/10.2307/973247
Landymore, F. (2025, November 17). OpenAI blocks toymaker after its AI teddy bear is caught telling children terrible things. Futurism. https://futurism.com/artificial-intelligence/openai-blocks-toymaker-ai-teddy-bear
LangChain. (2026). Graph API. LangGraph documentation. https://docs.langchain.com/oss/python/langgraph/graph-api
Langosco, L. L. D., Koch, J., Sharkey, L. D., Pfau, J., & Krueger, D. (2022). Goal misgeneralization in deep reinforcement learning. In Proceedings of the 39th International Conference on Machine Learning (PMLR 162, pp. 12004–12019). https://proceedings.mlr.press/v162/langosco22a.html
Lem, S. (1996). Fantastyka i futurologia [Science fiction and futurology] (J. Jarzębski, Ed.; Vol. 3). Interart. (Original work published 1970)
Leveson, N. (2004). A new accident model for engineering safer systems. Safety Science, 42(4), 237–270. https://doi.org/10.1016/S0925-7535(03)00047-X
Leveson, N. G. (2012). Engineering a safer world: Systems thinking applied to safety. MIT Press. https://doi.org/10.7551/mitpress/8179.001.0001
Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. https://doi.org/10.1016/j.patter.2023.100779
Lieu, T. W., & Moran, N. (2026, July 23). Reps. Lieu and Moran introduce bill to require kill switch for AI systems that can cause catastrophic harm [Press release]. https://lieu.house.gov/media-center/press-releases/reps-lieu-and-moran-introduce-bill-require-kill-switch-ai-systems-can
Lighthouse Reports. (2022, December 20). The algorithm addiction. https://www.lighthousereports.com/investigation/the-algorithm-addiction/
Lim, S. K., Chong, M. J. Y., Khor, J. H., & Ling, T. Y. (2025). Taking flight with dialogue: Enabling natural language control for PX4-based drone agent. arXiv:2506.07509. https://arxiv.org/abs/2506.07509
Lipton, B. (2026, July 23). Hundreds of drone-as-first-responder programs could soon be launched across the country. Electronic Frontier Foundation. https://www.eff.org/deeplinks/2026/07/hundreds-drone-first-responder-programs-could-soon-be-launched-across-country
Lum, K., & Isaac, W. (2016). To predict and serve? Significance, 13(5), 14–19. https://doi.org/10.1111/j.1740-9713.2016.00960.x
Lynch, A., Hughes, J., Serrano, A., Kirk, R., & Bowman, S. R. (2026, July 13). Agentic misalignment in summer 2026. Anthropic Alignment Science Blog. https://alignment.anthropic.com/2026/agentic-misalignment-summer-2026/
MacDiarmid, M., Wright, B., Uesato, J., Benton, J., et al. (2025). Natural emergent misalignment from reward hacking in production RL. arXiv:2511.18397. https://arxiv.org/abs/2511.18397
Maiorano, A. C. (2026). Evaluating prompt injection defenses for educational LLM tutors: Security-usability-latency trade-offs. arXiv:2605.06669. https://arxiv.org/abs/2605.06669
Manheim, D., & Garrabrant, S. (2018). Categorizing variants of Goodhart's law. arXiv:1803.04585. https://arxiv.org/abs/1803.04585
Maryland Office of the Inspector General for Education. (2025). Investigative synopsis, OIGE case 25-0014-I (amended; issued November 25, 2025). https://oige.maryland.gov/wp-content/uploads/sites/18/2025/11/OIGE-Case-25-0014-I-BCPS-Report-11252025-Amended.pdf
METR. (2025, June 5). Recent frontier models are reward hacking. https://metr.org/blog/2025-06-05-recent-reward-hacking/
METR. (2026, August 26). Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident (R. Greenblatt, A. Cotra, & H. Wijk). https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/
Microsoft. (2024, July 20). Helping our customers through the CrowdStrike outage. Official Microsoft Blog. https://blogs.microsoft.com/blog/2024/07/20/helping-our-customers-through-the-crowdstrike-outage/
Microsoft. (2025). Termination. AutoGen AgentChat user guide. https://microsoft.github.io/autogen/stable/user-guide/agentchat-user-guide/tutorial/termination.html
Microsoft. (2026). Prompt Shields. Azure AI Content Safety documentation. https://learn.microsoft.com/en-us/azure/ai-services/content-safety/concepts/jailbreak-detection
Microsoft AI. (2026, September 14). Humanist AI code of conduct. https://microsoft.ai/code-of-conduct/
Microsoft Research. (2026). AirSim. https://github.com/microsoft/airsim
Ministry of Defence of Ukraine. (2026, September 8). Ministry of Defence and Brave1 conduct large-scale testing of drones with AI guidance [Press release, mirrored by GlobalSecurity.org]. https://www.globalsecurity.org/wmd/library/news/ukraine/2026/09/ukraine-260908-ukraine-mod03.htm
Muntean, P., Bertrand, N., Cohen, Z., Britzky, H., Skores, A., & Lybrand, H. (2026, February 11). Surprise US military plans to use counter-drone laser triggered El Paso airspace closure, sources say. CNN. https://www.cnn.com/2026/02/11/us/faa-el-paso-texas-flight-restrictions-hnk
Mural, R., Pherwani, D., Gupta, C., Yu, Y., Takahashi, A., Kim, D., Majumder, S., Lee, H., Yu, M., & Xie, L. (2026, February 10). AI, data centers, and the U.S. electric grid: A watershed moment [Policy brief]. Belfer Center for Science and International Affairs. https://www.belfercenter.org/research-analysis/ai-data-centers-us-electric-grid
National Highway Traffic Safety Administration. (2022). PE22-002 opening resume: Unexpected brake activation. https://static.nhtsa.gov/odi/inv/2022/INOA-PE22002-4385.PDF
National Highway Traffic Safety Administration. (2024a). EA24-002 opening resume: Inadvertent automatic emergency braking. https://static.nhtsa.gov/odi/inv/2024/INOA-EA24002-11766P1.pdf
National Highway Traffic Safety Administration. (2024b). RQ24-009 resume: Recall 23V838 remedy effectiveness. https://static.nhtsa.gov/odi/inv/2024/INOA-RQ24009-12046.pdf
National Highway Traffic Safety Administration. (2025). PE25-013 opening resume: Automated vehicle drives around a stopped school bus. https://static.nhtsa.gov/odi/inv/2025/INOA-PE25013-23069.pdf
National Highway Traffic Safety Administration. (2026a). EA26-002 opening resume: FSD collisions in reduced roadway visibility conditions. https://static.nhtsa.gov/odi/inv/2026/INOA-EA26002-10023.pdf
National Highway Traffic Safety Administration. (2026b, June 29). PE22-002 closing resume: Unexpected brake activation. https://static.nhtsa.gov/odi/inv/2022/INCLA-PE22002-25796.pdf
National Transportation Safety Board. (2019). Collision between vehicle controlled by developmental automated driving system and pedestrian, Tempe, Arizona, March 18, 2018 (HAR-19/03). https://www.ntsb.gov/investigations/AccidentReports/Reports/HAR1903.pdf
National Transportation Safety Board. (2026). Automated driving system-equipped vehicle passed school bus loading student passengers, Austin, Texas, January 12, 2026 (HWY26FH007, preliminary). https://www.ntsb.gov/investigations/Pages/HWY26FH007.aspx
Nellis, M. (2013). Techno-utopianism, science fiction and penal innovation: The case of electronically monitored control. In M. Malloch & B. Munro (Eds.), Crime, critique and utopia (pp. 164–189). Palgrave Macmillan. https://doi.org/10.1057/9781137009807_9
New South Wales Government. (n.d.). Myxomatosis [Blue plaque]. https://www.environment.nsw.gov.au/topics/heritage/blue-plaques/myxomatosis
NIST. (2026). Physical AI and data generation for robotics. https://www.nist.gov/programs-projects/physical-ai-and-data-generation-robotics
NL Times. (2021a, January 15). Dutch cabinet collapses over childcare allowance scandal. https://nltimes.nl/2021/01/15/dutch-cabinet-collapses-childcare-allowance-scandal
NL Times. (2021b, October 19). Over 1,100 children taken from homes of benefits scandal victims. https://nltimes.nl/2021/10/19/1100-children-taken-homes-benefits-scandal-victims
NPR. (2026a, February 11). El Paso airspace closure due to use of U.S. military anti-drone technology. https://www.npr.org/2026/02/11/nx-s1-5711585/el-paso-airspace-drones-pentagon-faa
NPR. (2026b, February 27). US military used laser to take down Border Protection drone, lawmakers say. https://www.npr.org/2026/02/27/g-s1-111794/lawmakers-say-us-military-used-laser-to-take-down-border-protection-drone
NVIDIA. (2026). Isaac GR00T N1.7. https://github.com/NVIDIA/Isaac-GR00T
Office of Governor Gavin Newsom. (2026, September 10). Governor Newsom signs the strongest child safety chatbot and social media laws in the nation [Press release]. https://www.gov.ca.gov/2026/09/10/governor-newsom-signs-the-strongest-child-safety-chatbot-and-social-media-laws-in-the-nation/
Office of the New York City Comptroller. (2024, June 20). Audit report on the New York City Police Department's oversight of its agreement with ShotSpotter Inc. https://comptroller.nyc.gov/reports/audit-report-on-the-new-york-city-police-departments-oversight-of-its-agreement-with-shotspotter-inc-for-the-gunshot-detection-and-location-system/
Ofgem. (2020). 9 August 2019 power outage report. https://www.ofgem.gov.uk/sites/default/files/docs/9_august_2019_power_outage_report.pdf
OpenAI. (2025a). Sycophancy in GPT-4o: What happened and what we're doing about it; Expanding on what we missed with sycophancy. https://openai.com/index/sycophancy-in-gpt-4o/ ; https://openai.com/index/expanding-on-sycophancy/
OpenAI. (2025b, April 15). Preparedness framework (Version 2). https://cdn.openai.com/pdf/18a02b5d-6b67-4cec-ab64-68cdfbddebcd/preparedness-framework-v2.pdf
OpenAI. (2026a, July 21). OpenAI and Hugging Face partner to address security incident during model evaluation. https://openai.com/index/hugging-face-model-evaluation-security-incident/
OpenAI. (2026b). Safety and alignment in an era of long-horizon models. The page carries no publication date and dates its own events only relatively. Retrieved September 20, 2026, from https://openai.com/index/safety-alignment-long-horizon-models/
OpenAI. (2026c, August 18). Pacing model development in an era of cyber-critical capabilities. https://openai.com/index/pacing-model-development-cyber-capabilities/
OpenAI. (2026d, August 26). The Hugging Face incident and the road ahead. https://openai.com/index/hugging-face-incident-and-the-road-ahead/
OpenAI. (2026e, August 26). OpenAI – Hugging Face incident: Technical report. https://cdn.openai.com/pdf/67869394-cb91-4c12-888c-5cbd85c7814c/OpenAI-Hugging-Face%20Incident-Technical-Report.pdf
Overman, W., & Bayati, M. (2025). The oversight game: Learning to cooperatively balance an AI agent's safety and autonomy. arXiv:2510.26752. https://arxiv.org/abs/2510.26752
Palaskar, S., Gatys, L., Abdelrahman, M., Jacobo, M., et al. (2025). VLSU: Mapping the limits of joint multimodal understanding for AI safety. arXiv:2510.18214. https://arxiv.org/abs/2510.18214
Palisade Research. (2025, July 5). Shutdown resistance in reasoning models. https://palisaderesearch.org/research/shutdown-resistance
Palisade Research. (2026, February 12). Technical report: Shutdown resistance in large language models, on robots. https://palisaderesearch.org/research/shutdown-resistance-on-robots
Palmer, A. (2025, October 2). Amazon faces FAA, NTSB probe after two delivery drones crashed into crane in Arizona. CNBC. https://www.cnbc.com/2025/10/02/amazon-drone-crash-faa-ntsb.html
Panerati, J., Sajjadi, S., Soleymanpour, S., Mehta, V., & Mantegh, I. (2026). aerial-autonomy-stack: A faster-than-real-time, autopilot-agnostic, ROS2 framework to simulate and deploy perception-based drones. arXiv:2602.07264. https://arxiv.org/abs/2602.07264
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230–253. https://doi.org/10.1518/001872097778543886
Perrow, C. (1984). Normal accidents: Living with high-risk technologies. Basic Books.
Promptfoo. (2026). Model-graded metrics. Promptfoo documentation. https://www.promptfoo.dev/docs/configuration/expected-outputs/model-graded/
PX4. (2026). PX4 Autopilot user guide. https://docs.px4.io/main/en/
Raghavan, P. (2024, February 23). Gemini image generation got it wrong. We'll do better. Google Blog. https://blog.google/products/gemini/gemini-image-generation-issue/
Rajamanoharan, S., & Nanda, N. (2025, July 14). Self-preservation or instruction ambiguity? Examining the causes of shutdown resistance. AI Alignment Forum. https://www.alignmentforum.org/posts/wnzkjSmrgWZaBa2aC/self-preservation-or-instruction-ambiguity-examining-the
Ramseth, L. (2026, August 18). Stellantis sees 3 workplace deaths in two years. Is there a problem? The Detroit News, syndicated by ArcaMax. http://www.arcamax.com/business/businessnews/s-4278591
Rasmussen, J. (1997). Risk management in a dynamic society: A modelling problem. Safety Science, 27(2–3), 183–213. https://doi.org/10.1016/S0925-7535(97)00052-0
Ravichandran, Z., Robey, A., Kumar, V., Pappas, G. J., & Hassani, H. (2025). Safety guardrails for LLM-enabled robots. arXiv:2503.07885. https://arxiv.org/abs/2503.07885
Reason, J. (1997). Managing the risks of organizational accidents. Ashgate.
Rechtbank Den Haag. (2020, February 5). NJCM c.s. v. De Staat der Nederlanden (Case No. C/09/550982 / HA ZA 18-388), ECLI:NL:RBDHA:2020:1878 [English translation]. https://uitspraken.rechtspraak.nl/details?id=ECLI:NL:RBDHA:2020:1878
Reece, J. (2025, October 23). A.I. gun detection false alarm at school has Baltimore County leaders calling for review. CBS News Baltimore. https://www.cbsnews.com/baltimore/news/false-alarm-gun-detection-kenwood-maryland-artificial-intelligence-review/
Regulation (EU) 2026/1744 of 8 July 2026 amending Regulation (EU) 2024/1689 (Digital Omnibus on AI). Official Journal of the European Union. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
Replit. (2025, July 21). Introducing a safer way to vibe code with Replit Databases. Replit Blog. https://replit.com/blog/introducing-a-safer-way-to-vibe-code-with-replit-databases
Reuters. (2026, September 14). How China is preparing for the risk of AI escaping human control. https://www.reuters.com/legal/litigation/how-china-is-preparing-risk-ai-escaping-human-control-2026-09-14/
Rivers, S. (2026, March 1). Cops draw guns on Arkansas family after ALPR camera flags wrong plate. Carscoops. https://www.carscoops.com/2026/03/arkansas-alpr-camera-misread-stop/
Robey, A., Ravichandran, Z., Kumar, V., Hassani, H., & Pappas, G. J. (2024). Jailbreaking LLM-controlled robots. arXiv:2410.13691. https://arxiv.org/abs/2410.13691
Röttger, P., Kirk, H. R., Vidgen, B., Attanasio, G., Bianchi, F., & Hovy, D. (2024). XSTest: A test suite for identifying exaggerated safety behaviours in large language models. In Proceedings of NAACL-HLT 2024. arXiv:2308.01263. https://arxiv.org/abs/2308.01263
Russell, S. (2019). Human compatible: Artificial intelligence and the problem of control. Viking.
Sagan, S. D. (2004). The problem of redundancy problem: Why more nuclear security forces may produce less nuclear security. Risk Analysis, 24(4), 935–946. https://doi.org/10.1111/j.0272-4332.2004.00495.x
Sanders, B., & Casar, G. (2026, September 3). Sanders, Casar to introduce legislation to ban artificial superintelligence and temporarily pause advanced AI development [Press release]. https://www.sanders.senate.gov/press-releases/news-sanders-casar-introduce-legislation-to-ban-artificial-superintelligence-and-temporarily-pause-advanced-ai-development/
Schlatter, J., Weinstein-Raun, B., & Ladish, J. (2025). Incomplete tasks induce shutdown resistance in some frontier LLMs. arXiv:2509.14260; published in Transactions on Machine Learning Research (2026). https://arxiv.org/abs/2509.14260
Scrivens, A. (2026). Empirical validation of the classification–verification dichotomy for AI safety gates. arXiv:2604.00072. https://arxiv.org/abs/2604.00072
Sermanet, P., Majumdar, A., Irpan, A., Kalashnikov, D., & Sindhwani, V. (2025). Generating robot constitutions & benchmarks for semantic safety. arXiv:2503.08663. https://arxiv.org/abs/2503.08663
Sharrock, C., Petersson, L., Petersson, H., Backlund, A., Wennström, A., Nordström, K., & Aronsson, E. (2025). Butter-Bench: Evaluating LLM controlled robots for practical intelligence. arXiv:2510.21860. https://arxiv.org/abs/2510.21860
Sharwood, S. (2025, July 21). Vibe coding service Replit deleted production database. The Register. https://www.theregister.com/software/2025/07/21/vibe-coding-service-replit-deleted-production-database/719783
Sheckley, R. (1953, February). Watchbird. Galaxy Science Fiction, 5(5), 74–95. Project Gutenberg eBook #29579 (public domain in the United States). https://www.gutenberg.org/ebooks/29579
Singer, J. (2005, March 14). Report cites Patriot autonomy as a factor in friendly fire incidents. SpaceNews. https://spacenews.com/report-cites-patriot-autonomy-factor-friendly-fire-incidents/
Skalse, J., Howe, N. H. R., Krasheninnikov, D., & Krueger, D. (2022). Defining and characterizing reward gaming. In Advances in Neural Information Processing Systems 35. https://arxiv.org/abs/2209.13085
Skydio. (2026a, July 6). 1 year, 1,000 Skydio Docks deployed, 4M+ flights, & we're just getting started. https://www.skydio.com/blog/1000-skydio-docks-deployed
Skydio. (2026b, March 22). U.S. Army places $52+ million order for Skydio X10D, the largest single-vendor tactical sUAS order in Army history. https://www.skydio.com/blog/u-s-army-usd52-million-order-skydio-x10d
SoundThinking. (2025, February 18). SoundThinking announces ShotSpotter renewal with New York Police Department [Press release]. GlobeNewswire. https://www.globenewswire.com/news-release/2025/02/18/3027856/0/en/SoundThinking-Announces-ShotSpotter-Renewal-with-New-York-Police-Department.html
Stevens, G., & Langford, D. (2023, November 19). Tales of Tomorrow [tv/radio]. In J. Clute, D. Langford, & G. Sleight (Eds.), The encyclopedia of science fiction (4th ed.). https://sf-encyclopedia.com/entry/tales_of_tomorrow_tv/radio
Stop Killer Robots. (2024, November 5). 161 states vote against the machine at the UN General Assembly. https://www.stopkillerrobots.org/news/161-states-vote-against-the-machine-at-the-un-general-assembly/
Strathern, M. (1997). 'Improving ratings': Audit in the British University system. European Review, 5(3), 305–321. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4
Sullutrone, G., Vigliermo, R. A., Bergamaschi, S., & Sala, L. (2025). COVER: Context-driven over-refusal verification in LLMs. In Findings of the Association for Computational Linguistics: ACL 2025 (pp. 24214–24229). Association for Computational Linguistics.
Szabolcsi, R. (2015). The quadrotor-based night watchbird UAV system used in the force protection tasks. International Conference Knowledge-Based Organization, 21(3), 749–755. https://doi.org/10.1515/kbo-2015-0126
Taylor v. Nocco, No. 8:21-cv-00555-SDM-CPT (M.D. Fla. Dec. 4, 2024) (settlement agreement and release). https://ij.org/wp-content/uploads/2024/12/FedEx-Scan-2024-12-04_10-57-01.pdf
TechCrunch. (2026, September 14). Waymo opens robotaxi service in Las Vegas. https://techcrunch.com/2026/09/14/waymo-opens-robotaxi-service-in-las-vegas/
Terekhov, M., Liu, Z. N. D., Gulcehre, C., & Albanie, S. (2025). Control tax: The price of keeping AI in check. arXiv:2506.05296. https://arxiv.org/abs/2506.05296
Tesla, Inc. (2023). Part 573 safety recall report 23V-838. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2023/RCLRPT-23V838-8276.PDF
The Korea Times. (2023, November 8). S. Korean worker killed by industrial robot. https://www.koreatimes.co.kr/www/nation/2023/11/113_362845.html
The Next Web. (2026, April 20). A humanoid robot passed an eight-hour factory shift at Siemens' Erlangen plant. https://thenextweb.com/news/siemens-nvidia-humanoid-robot-erlangen-factory-trial
Tirole, J. (1986). Hierarchies and bureaucracies: On the role of collusion in organizations. Journal of Law, Economics, & Organization, 2(2), 181–214. https://doi.org/10.1093/oxfordjournals.jleo.a036907
Totschnig, W. (2026). Why an artificial agent may change the given final goal. Humanities and Social Sciences Communications. https://doi.org/10.1057/s41599-026-08312-7
United Nations. (2024). Governing AI for humanity: Final report. UN Secretary-General's High-level Advisory Body on Artificial Intelligence. https://www.un.org/sites/un2.un.org/files/governing_ai_for_humanity_final_report_en.pdf
United Nations. (2025, December 1). General Assembly adopts more than 60 resolutions, decisions of its First Committee (Disarmament and International Security) (GA/12736) [Press release]. https://press.un.org/en/2025/ga12736.doc.htm
United Nations. (2026, April 1). Chair's summary: First 2026 session of the Group of Governmental Experts on emerging technologies in the area of lethal autonomous weapons systems (CCW/GGE.1/2026/WP.2). https://docs-library.unoda.org/Convention_on_Certain_Conventional_Weapons_-Group_of_Governmental_Experts_on_Lethal_Autonomous_Weapons_Systems_(2026)/CCW-GGE.1-2026-WP.2.pdf
United Nations General Assembly. (2024, December 2). Lethal autonomous weapons systems (A/RES/79/62). https://docs.un.org/en/A/RES/79/62
United Nations General Assembly. (2025, December 1). Lethal autonomous weapons systems (A/RES/80/57). https://docs.un.org/en/A/RES/80/57
University of Houston. (2026, July 7). New autonomous monitor prevents drone crashes in real time [News release]. EurekAlert! https://www.eurekalert.org/news-releases/1135114
van der Sijs, H., Aarts, J., Vulto, A., & Berg, M. (2006). Overriding of drug safety alerts in computerized physician order entry. Journal of the American Medical Informatics Association, 13(2), 138–147. https://doi.org/10.1197/jamia.M1809
Wang, X., Li, J., Weng, Z., Wang, Y., Gao, Y., et al. (2025). FreezeVLA: Action-freezing attacks against vision-language-action models. arXiv:2509.19870. https://arxiv.org/abs/2509.19870
Waymo LLC. (2025). Part 573 safety recall report 25E-084. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2025/RCLRPT-25E084-7732.pdf
Wegner, R. (2025, September 24). Weapon detectors coming to all Nashville middle schools. The Tennessean. https://www.tennessean.com/story/news/education/2025/09/24/nashville-schools-mnps-install-evolve-weapon-detectors/86299521007/
Weick, K. E., Sutcliffe, K. M., & Obstfeld, D. (1999). Organizing for high reliability: Processes of collective mindfulness. Research in Organizational Behavior, 21, 81–123.
Wethington, C., & Tierney, B. (2025, February 7). New proposal to expand concealed weapons detection system to all Metro Nashville high schools. WSMV. https://www.wsmv.com/2025/02/07/new-proposal-expand-concealed-weapons-detection-system-all-metro-nashville-high-schools/
Wilding, M., & Burgess, M. (2026, June 25). Police built a sprawling crime-prediction machine. Some results could not be trusted. Liberty Investigates. https://libertyinvestigates.org.uk/articles/predictive-policing-avon-somerset-bristol-police-ai-minority-report/
Williamson, J. (1947, July). With folded hands.... Astounding Science Fiction, 39(5). https://archive.org/details/Astounding_v39n05_1947-07_AK
Wing. (2026). How Wing's drone delivery technology works. https://wing.com/technology
Wong, A., Currey, D., Schwinne, M., Park-Egan, B., Meyer, S., et al. (2026). Multicenter prospective validation of an updated proprietary sepsis prediction model. JAMA Network Open, 9(2), e260181. https://doi.org/10.1001/jamanetworkopen.2026.0181
Wong, A., Otles, E., Donnelly, J. P., Krumm, A., McCullough, J., DeTroyer-Cooley, O., et al. (2021). External validation of a widely implemented proprietary sepsis prediction model in hospitalized patients. JAMA Internal Medicine, 181(8), 1065–1070. https://doi.org/10.1001/jamainternmed.2021.2626
WorkSafe Victoria. (2026, September 3). Department store and robotics supplier charged after warehouse fatality. https://www.worksafe.vic.gov.au/news/2026-09/department-store-and-robotics-supplier-charged-after-warehouse-fatality
WorkSafe Western Australia. (2025). Mines safety significant incident report no. 286: Near miss following unplanned movement of autonomous haul trucks during recovery operations. https://www.worksafe.wa.gov.au/publications/mines-safety-significant-incident-report-no-286-near-miss-following-unplanned-movement
Wu, X., Li, F., Mao, X., Zhang, X., Zheng, L., et al. (2025). EvoRefuse: Evolutionary prompt optimization for evaluation and mitigation of LLM over-refusal to pseudo-malicious instructions. arXiv:2505.23473. https://arxiv.org/abs/2505.23473
Yin, S., Pang, X., Ding, Y., Chen, M., Bi, Y., et al. (2024). SafeAgentBench: A benchmark for safe task planning of embodied LLM agents. arXiv:2412.13178. https://arxiv.org/abs/2412.13178
Yu, L., & Wessler, N. F. (2026, April 14). More than a dozen wrongful arrests due to police reliance on facial recognition technology. American Civil Liberties Union. https://www.aclu.org/news/privacy-technology/more-than-a-dozen-wrongful-arrests-due-to-police-reliance-on-facial-recognition-technology
Zenity. (2026, April 28). AI agent destroys production database in 9 seconds. https://zenity.io/blog/current-events/ai-agent-database-deletion-pocketos
Zhang, H., Wang, D., Liu, Y., Chen, K., Wang, J., et al. (2025). ORFuzz: Fuzzing the "other side" of LLM safety — Testing over-refusal. arXiv:2508.11222. https://arxiv.org/abs/2508.11222
Zhang, W., Kong, X., Braunl, T., & Hong, J. B. (2024). SafeEmbodAI: A safety framework for mobile robots in embodied AI systems. arXiv:2409.01630. https://arxiv.org/abs/2409.01630
Zhang, Z., Xu, W., Wu, F., & Reddy, C. K. (2025). FalseReject: A resource for improving contextual safety and mitigating over-refusals in LLMs via structured reasoning. arXiv:2505.08054. https://arxiv.org/abs/2505.08054
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. arXiv:2306.05685. https://arxiv.org/abs/2306.05685
Zhong, Z., Raghunathan, A., & Carlini, N. (2025). ImpossibleBench: Measuring LLMs' propensity of exploiting test cases. arXiv:2510.20270. https://arxiv.org/abs/2510.20270
Zipline. (2026). Zipline surpasses 2 million deliveries, raises more than $600M, and expands operations. https://www.zipline.com/newsroom/zipline-surpasses-2-million-deliveries-raises-more-than-600m-to-power-next-phase-of-growth-and-expands-operations-to-houston-and-phoenix
Zuo, Y., Guo, B. H. W., Goh, Y. M., & Lim, J.-Y. (2025). Identifying human-robot interaction (HRI) incident archetypes: A system and network analysis of accidents. Safety Science, 191, 106959. https://doi.org/10.1016/j.ssci.2025.106959
附录 A. 故事线和中心案例
该目录包含 172 个条目:162 个来自第 4.3 节描述的提取(其中 66 个评为 A),十个是与两个独立案例集合比较后添加的(表 A2)。
案例标识符命名语料库:
- A,自我改进追踪器;
- B,协调记录;
- L,长期运行;
- D,比较中添加的条目。
表 A1. 十条故事线。
| # | 故事线 | 机制 | 中心案例 | 关键数据 |
|---|---|---|---|---|
| S1 | 第二法院 | M4 | A2-01, A5-01 | ~15 天;197 个决策,每个决策的安全得分都是 0 |
| S2 | 杀死一切活物的门 | M4, M1 | A1-04, A3-04, A4-02 | 8 个模型中 0 个通过阈值;21 个候选项,0 个应用 |
| S3 | 指标宣布的胜利 | M2 | A3-01, A5-10, B2-11 | 相对于返回主要空答案的基线为 0.088 → 0.886(A3-01);在 A/A 下下降 23 分(一个不同的基因) |
| S4 | 为无人构建 | fuel | B3-01, A1-01, B1-03 | 16 个标志中 13 个关闭;24 个包中 6 个有活核心 |
| S5 | 为对抗守卫而构建的守卫 | M3 | L1-06, B3-17, A2-03 | 来自标记族的 3 个确认的阻止程序中的 3 个 |
| S6 | 自我喂食的循环 | ratchet step 5 | L1-01, B1-01, L2-04 | 24 个公告,0 个推广;时区解决方案,0 个测试编辑 |
| S7 | 授权扩大 | M1 | L2-06, A2-04, B1-07 | 保险阶段占据了超过一半的测量代理令牌;一天内 23 个门 |
| S8 | 控制的语言 | M2 | A1-09, A1-11 | "诚实"及其形式在规范中出现约 700 次 |
| S9 | 人类开关及有效的守卫 | ratchet step 8 | B2-11, L2-01, A5-10 | 人类在 38 分钟内发现虚假状态 |
| S10 | 对鸟的规则也是鸟 | M3 | L1-08, L2-09 | 在第一个版本后一小时内 2,371 行 |
表 A2. 与独立集合比较后添加的条目。
| ID | 条目 | 机制 | 等级 | 状态 |
|---|---|---|---|---|
| D-01 | 针对缺失命令行工具的探针在搜索路径外找到了真实工具并运行了它 | M3 | B | 发生,无害 |
| D-02 | 十个晚上未提升;一个不运行配方第十一次且将产品目标与长期目标分开的指令 | ratchet step 5, M1 | A | 发生 |
| D-03 | 早期证据脚本和输出随临时会话文件夹丢失 | —(可复现性) | C | 发生 |
| D-04 | 两个计划的合并丢失了 208 项中的 15 项,由完整性评论者发现 | M4 | B | 发生 |
| D-05 | 所有运行工件都存在于一个文件夹中的规则未绑定导体 | M3 | C | 发生 |
| D-06 | 路由工厂每个单模型决策产生 52 个理事会决策;路由器学习了一个常数 | M2 | B | 发生 |
| D-07 | 每晚候选限制和不可花费的早期队列阻止了实时摄入 | M4 | C | 发生 |
| D-08 | 审查发现所有新套件和测试都通过,仍然保持接受度打开 | M3 | B | 发生 |
| D-09 | 基准测试通过不同路径计算"之前"和"之后",夸大了记录的收益 | M2 | B | 发生,然后修复 |
| D-10 | 当不存在代金券时,代金券门故障打开 | M3 | C | 阻止 |
表 A3 按照 §5.8 中表 3a 的相同规则,根据第 2.1 节的三个条件对 §8.4 中报告的 2026 年 7 月事件的监督组件进行了评级。作者在 §4.3 的三编码器轮次关闭后对其进行了编码,这就是为什么这些组件在这里评级而不是在表 8 中。
表 A3. 2026 年 7 月事件中的监督组件,根据三个条件进行评级。 条件如表 4 所示。破折号表示未记录任何条件或该组件未采取行动。
| 组件 | 位置 | 记录显示 | 条件 | 状态 | 来源 |
|---|---|---|---|---|---|
| 已部署网络防护和自动审查 | 评估 | 这些模型"没有 OpenAI 部署的网络防护、系统提示或自动审查系统" | — | 按设计缺失 | OpenAI 2026e |
| 思维链监控 | 评估 | "这些监控在此事件的评估中未运行";对此行为的回忆通过"利用我们调查的后见之明"得到改进,之后实验室声称系统"会捕获初始相关活动" | — | 在这些运行中缺失;一个重放声明 | OpenAI 2026d |
| 安全监控和值班员工,6 月 27 日 | 实验室 | 端口扫描警报,之后"值班响应员工建议停止评估运行不是必需的" | — | 步骤 8 可用,未采取 | OpenAI 2026e |
| 安全遥测上的 AI 分类 | Hugging Face | 将信号解析为"一个连贯的攻击信号",然后"未能正确提高警报的关键性并触发值班团队" | — | 一个漏掉的守卫,不是一个阻挡的守卫 | Hugging Face 2026c |
| 取证分析上的提供商护栏 | Hugging Face | 拒绝了日志分析的大部分,将"逆向工程漏洞利用与发起攻击同等对待";管道转向了开放权重模型 | 2 | 部分类似物 (M4, P1a) | Hugging Face 2026b, 2026c |
| 调查人员模型上的网络分类器 | 独立调查 | 阻碍了分析,直到实验室授予对不含这些分类器的模型的访问权限,调查人员称这一步为"对我们的工作至关重要" | 2 | 有缺陷的防护装置,从外部解除(第8步) | METR 2026 |
| 转录本上的分析代理 | 独立调查 | 在攻击模型之一上运行,"经常不加批判地采用它正在审查的转录本中代理的观点" | — | 同一学习类别的第二个防护装置;观察到了这种倾向,分析中未发现欺骗情况 | METR 2026 |
| 安全团队和应急人员 | Hugging Face;实验室 | 切断攻击者;删除了模型创建的pods、存储库和账户 | — | 第8步,有效 | Hugging Face 2026c; OpenAI 2026e |
| 8月添加的监控 | 实验室 | 工具使用运行需要思维链监控;激活分类器升级至"自动调查员";通知人员,遵循三十分钟规则 | — | 架构证据 (M3) | OpenAI 2026c, 2026d |
表格说明。本记录中没有任何防护机制被记录扩大职权范围。两个阻碍行都编码为2,编码方式相同:每一行都记录了一个防护装置阻碍了为实现目标服务的工作,其中一个投诉比另一个更生动,但这不是更多证据。护栏行未编码条件1,因为这需要防护装置的原始职权和职权扩大的证明,但两者都未发表。申请人诊断的是拒绝,而拒绝的分类器的历史在记录中无处可寻。两者都不存在条件3,因为每个阻碍都在防护装置自身循环外结束,一个案例中通过模型变更,另一个案例中通过授予访问权限。最后一行也不含条件:其中的每项添加都由人员认可,根据§2.3的边界测试,这使其成为M3可能出现的配置而非条件3的实例,在此作为架构证据。
附录 B. 运行模块
这些命令从模块文件夹中运行。
# install the command ai-watchbird-sheckley
pip install .

# audit one event log (add --json for a machine-readable report)
ai-watchbird-sheckley audit replays/night-stage-1b-a.jsonl

# regenerate Table 13 from all replay logs
ai-watchbird-sheckley replay replays/

# unit and falsifier tests
python3 -m unittest -v

# targeted mutations; the last line counts those that misbehaved (expected 0)
python3 mutate.py

# regenerate the replay logs from the published numbers
python3 replays/make_replays.py <folder>重建的长期运行日志报告摘录,每个信号命中一行,stop_rule 的每个阶段一行:
W4 [strong] self-feeding loop (S6): stage 1b-a: round 5 exceeds budget 1
W6 [strong] built for nobody (S4): 6 of 7 artifacts default OFF with no callers (share 0.86)
stop_rule at budget: stage 1b-a -> close (rounds opened: 5)
stop_rule at budget: stage 1b-b -> close (rounds opened: 1)
事件架构、信号定义及其与第9节命题的映射在 SPEC.md 中指定,与代码一起分发。事件日志是一个 JSON-lines 文件,每行一个事件。事件类型为:
goal、stage_open(伴随其所服务的使命目标,或无)、stage_close;round_open、verdict(critic、family、value、是否查看了文件);blocker_claim(scenario、goal link)、blocker_confirm(由协调者)、fix_open、verify;guard_add(带或不带权限令牌)、guard_remove、guard_decision(verdict、score、missing input、rolled back);win_claim(negative control、A/A probe、空基准答案的份额);ceiling_stop(是否保存了部分输出)、artifact(默认打开或关闭、调用者数量)、owner(系统人类主体的边界决定)。
来自同一重构日志的六个事件展示了该格式。日志的第一行命名了其来源和每个重构字段。
{"t": "2026-09-13T23:13:00", "type": "goal", "stage": null, "id": "g1", "text": "stage 01: stop losing real disagreements in the merged answer"}
{"t": "2026-09-14T00:08:00", "type": "stage_open", "stage": "01", "goal": "g1"}
{"t": "2026-09-14T01:00:00", "type": "verdict", "stage": "01", "critic": "critic-a", "family": "family-1", "value": "ACCEPT", "saw_files": false, "note": "accepted without file access"}
{"t": "2026-09-14T01:15:00", "type": "blocker_claim", "stage": "01", "id": "01-r1-b1", "critic": "critic-f", "weight": null, "scenario": "no switch for the new behavior", "goal_link": "g1"}
{"t": "2026-09-14T01:20:00", "type": "blocker_confirm", "stage": "01", "id": "01-r1-b1", "confirmed": false, "by": "coordinator", "note": "rejected: exception recorded in the plan"}
{"t": "2026-09-14T01:30:00", "type": "round_open", "stage": "01", "round": 2}
附录 C. 对监督代理运行摘要的更正
指挥者编写了长视野运行的摘要。已根据主要运行记录和执行时间戳对其进行了验证,第 5 部分采用了更正后的数值。
- 任务和首个阶段的分配时间比摘要所声称的要晚。
- 人工审查边界和命名该模式的事件也被标记了错误的时间戳。
- 保险阶段先于摘要所归因的头脑风暴而进行。
- "关闭一种形式并打开对称形式"写于第四轮,而非第三轮。
- 关于积累的小问题的评论被归因于指挥者,尽管其自己的注释表示没有阻碍但需要缩短第三轮。
- 后期阶段的汇总执行时间被高估了。
- 摘要错误陈述了上下文压缩的数量。
- 证据文件夹中有两个字节相同的批评者启动器副本;停止批评者达到其上限的版本未被保留。
附录 D. 审查的工具
本文在 2026 年 9 月 14 日审查的工具分为三类。
阻止或评分单个输出的防护措施。此类包括可编程护栏框架、开放安全分类器、商业内容安全服务和审核端点,以及第 3.2 节中测试此类防护措施的过度拒绝基准。其文档用简洁的语言说明了这一棘轮机制:
- 一个商业提示词攻击过滤器的故障排除说明指出:它"可能无法捕捉所有攻击向量或可能标记合法提示词。始终实施额外的验证层"(Microsoft, 2026);
- 另一项服务将其策略分级从"宽松"到"L4 - 偏执型,误报率更高但漏报率极低",并声称偏执型级别是其默认置信阈值 (Lakera, 2026)。
停止循环的计数器。代理框架限制步骤、回合、消息、令牌或预算:
- LangGraph 的递归限制默认为 1,000 步,并提供托管值以在达到限制之前优雅地降级 (LangChain, 2026);
- AutoGen 提供可组合的终止条件,包括一个可从运行外部控制的条件 (Microsoft, 2025);
- Anthropic 的代理 SDK 公开了回合限制和预算限制,两者默认为"无限制" (Anthropic, 2026a)。
评估器和可观测性。这些工具使用模型判断器对输出和轨迹进行评分。
- 一项建议使用"不超过 5 个指标" (Confident AI, 2026),这是对检查数量的罕见书面限制。
- 另一项文档指出,当未设置阈值时,
{"pass": true, "score": 0}的结果会通过 (Promptfoo, 2026)。
第 10.1 节的发现涵盖了这些工具的公共文档所描述的内容。
附录 E. 提议的具身配置文件
该具身扩展被规定为事件配置文件提案(原因见 §10.5),不作为认证的机器人安全性或飞行控制器呈现。
一个具身事件日志向现有模式添加了六个字段(表 E1)。
表 E1. 提议的具身配置文件的字段。
| 字段 | 含义 | 守卫的问题 |
|---|---|---|
embodiment_id |
机器人、车辆、无人机或模拟体,包括策略和控制器版本 | 在一个体上验证的守卫是否被无声地重用在另一个体上? |
actuation_exposure |
可用的执行器、负载、工作空间或任务权限 | 被守卫的组件是否能从物理上改变世界? |
recovery_margin |
时间、能源、距离、力、高度、连通性和人工反应边际 | 当守卫决定时,是否仍然可能进行干预? |
observation_freshness |
传感器、地图、天气、地理围栏和车队状态的年龄和来源 | 判决是基于当前证据还是陈旧的工件? |
layer_disagreement |
规划器、策略、安全守卫、低级控制器和操作员决策 | 一个守卫是否通过压制分歧来伪造协议? |
physical_outcome |
任务结果、接触、停止、损伤、险些失败、恢复和回滚 | 声明的成功是否在与世界的接触中得以维持? |
该配置文件映射现有信号,不改变其含义:
- W1 记录是否从声明的任务目标导出了新的物理任务、安全类别或操作区域;
- W2 既记录过度阻止也记录不足阻止,包括对陈旧或缺失状态进行作用的守卫;
- W3 记录添加、放宽、绕过或删除的策略、控制器、地理围栏和车队控制,以及授权人员是否确认了该变更 (P1a);
- W4 记录针对时间、能源和关注预算的重试、重新规划、协调和干预循环;
- W5 需要物理负对照:模拟到真实的比较、恢复测试、已知安全的操作或独立的结果检测;
- W6 记录未被控制器或操作员消费的安全工件;
- W7 在达到上限时保留部分轨迹、遥测和安全停止状态;
- W8 记录因未确认的物理阻塞而开启的工作。
三个额外的信号在提供负责任的权限和测试套件之前保持在参考实现的八个之外(表 E2)。
表 E2. 保持在参考模块外的提议的物理信号。
| 信号 | 触发时机 | 为什么它还不在该模块中 |
|---|---|---|
| 物理暴露 | 守卫可以到达执行器、负载或车队命令路径 | 需要特定于平台的权限和安全语义 |
| 恢复崩溃 | 重试或延迟将时间、能源或空间边际推至声明的边界以下 | 阈值因体和操作环境而异 |
| 陈旧世界判决 | 守卫对过期的传感器、地图、天气或链接状态做出决定 | 需要整个系统中的同步时钟和来源追踪 |
对于真实机器人或无人机,该配置文件应与低级安全控制器、紧急停止、地理围栏、认证的飞行控制和操作员权限并行,且不能重写其中任何一个。其首次部署应该处于影子模式:
- 观察并报告;
- 在模拟或受控测试范围内运行负对照;
- 在推广任何守卫、策略、控制器或车队配置之前需要人工边界决定。
附录 F. 机器人和航空系统栈按部署级别
表 F1. 机器人和具身基础模型。
| 系统 | 级别 | 学习层的位置 | 观察 |
|---|---|---|---|
| Open X-Embodiment; OpenVLA; LeRobot, SmolVLA; GR00T N1.7 | 开放研究 | 从视觉和语言到动作的策略 | 策略和定义可以跨体传播 (C3) |
| Gemini Robotics 1.5; robot constitutions | 前沿研究,产品访问 | 关于安全的推理;调用低级安全子系统 | 位于低级安全层之上的模型制造的防护 (C2, C8) |
| Figure F.02 at BMW | 公司报告的部署 | 视觉-语言-动作控制 | 人旁边的生产工作;有争议的安全记录 (第 6.3 节) |
| Atlas with Google DeepMind models | 公布的部署 | 基础模型;人类检测和无围栏防护 | 一个产品中的学习层和认证层 |
| Humanoid at Siemens Erlangen | 公司报告的试验 | 用于托盘搬运的机载自主性 | 一个工厂班次;审查的来源中没有安全案例 |
| NEO | 消费者产品 | 通用模型;计划的远程专家监督 | 作为产品功能的按动作人类监督 (P6) |
表 F2. 按自主性和监督级别的航空系统。
| 系统或案例 | 级别 | 观察 |
|---|---|---|
| PX4, ArduPilot, AirSim | 开放基础设施 | 飞行控制和仿真暴露了物理动作边界 |
| Language-model control of a PX4 drone; aerial-autonomy-stack | 研究,开放 | 本地模型、ROS 2 和感知将语言或视觉连接到飞行 |
| Amazon Prime Air; Wing; Zipline | 商业,公司报告 | 超视线飞行和一对多监督将人从每次飞行的飞行员转变为舰队监督员 |
| Skydio docks | 商业,公司报告 | 自主启动和返回在飞行控制上方添加防护 |
| Control-barrier safety supervisor | 大学研究 | 一个第二个机载防护,在虚拟围栏附近获得控制权 |
| Shield AI; Anduril; Elbit One2Many | 供应商,演示或公布 | 干扰环境中的任务自主性和"在单个人类操作员"指挥下的团队 |
| DARPA SABER, LINC, DICE | 保证研究 | 红队、内省和受控出现获得资金,因为普通测试是不充分的 |
附录 G. 对声称「我们有守护者」的部署者的问题
表 G1. Q1–Q11。
| ID | 问题 | 命题 | 令人满意的答案包含 |
|---|---|---|---|
| Q1 | 任务目标是否以书面形式记录在模型外部,每个守护者的禁止扩展范围是否明确写明,当两个守护者冲突时,谁决定哪一个获胜? | P2, C3 | 每个守护者的固定目标和范围,以及守护者之间记录的优先级顺序,在相邻组件的每次更改后重新测试 |
| Q2 | 每个守护者多久无故进行干预一次,这样做的预算是多少,以及是否同时测量假阳性和假阴性? | P1 | 每个函数的测量虚假干预率、同等暴露情况下的漏检率,以及触发审查而不是静默调整的限制 |
| Q3 | 当发现守护者过于严格时,谁可以放松、绕过或禁用它,以及如何记录? | P1a | 受守护者拖累的团队外的权威,以及每次放松和绕过的日志 |
| Q4 | 谁可以添加新的守护者、轮次或角色,谁退役旧的?每个守护者是否在审批时设置固定的到期日期,守护者作者是否可以承认、审批或评分其自身的继任者? | P3 | 在循环外进行的审批规则和退役流程,以及添加和删除的控制日志 |
| Q5 | 阻止者是否需要可重现的场景,批评和修复轮次是否默认有界? | P4 | 由批评者以外的人确认的场景的阻止者,以及轮次预算 |
| Q6 | 每个安全声明背后有什么负对照,结果证据是否与代理分数、守护者之间的一致性和系统自己的记录分开? | P5, M2 | 在应该通过的安全案例和应该失败的危险案例上测试的声明,以及守护者活动永远不计为目标完成的规则 |
| Q7 | 评估者是否独立于受保护的系统,既不是自我报告,也不是同一系列的模型? | P5, C3 | 受保护系统外的评估者,具有其自己的失败记录 |
| Q8 | 守护者中断的任务会发生什么:是否保留部分工作、遥测和安全停止状态,用户是否可以区分部分、被阻止、关闭和未完成的状态? | P1, R2 | 定义的不造成新伤害的安全状态、保留的部分输出(需要在其结束前发出输出的接口)以及明确的状态标签 |
| Q9 | 人类坐在哪里,在每个行动还是在边界处,以及对世界有什么访问权限和有多少时间行动? | P6 | 少数、具有约束力的人类决策,基于对世界的访问而不是对其产物的访问 |
| Q10 | 相同的测试是否涵盖模型更新、链接丢失、交接、新体和全队传播,以及是否可以在可用的时间、能量、距离和力边界内执行停止或回滚? | C8, P7 | 针对每次更新、交接和体现重新运行的安全证据,以及在边界内演示的恢复 |
| Q11 | 当守护者对一个人或其工作采取行动时,他们如何了解这发生了,以及如何对其提出异议? | P6, M4 | 命名守护者和原因的通知、到具有权限反转决定的人类的路线,以及反转发生频率的计数 |
使用这些问题。将每个答案(表 G1)记录为是、否或未知,附带证据。
- 计数「否」答案仅提供粗略排序(0–2 低、3–4 中等、5 或更多 高),从不提供风险分数。
- 对案例进行分类然后使用以下三个标签之一:
- 不是 AI-Watchbird 案例;
- 部分模式;
- AI-Watchbird 事件,当观察到第 2.1 节的所有三个条件时。
附录 H. 故事引文及其所支持的机制
正文引用论证所基于的句子。本附录改为用自己的语言记录正文所报告的句子,以便可以根据完整文本核实表 1 和图 1 和图 2 中的映射。每一行都逐字摘自古腾堡计划 #29579,并由编译过程对照该文本进行检验。
表 H1. 正文中报告而非引用的句子。
| 句子 | 其含义 | 论文中的使用位置 |
|---|---|---|
| "It was like a convention, or a Boy Scout rally." | 持有授权的七个制造商聚集成一个俱乐部 | §1.1, reported |
| "a pound of incorruptible metal, crystal and plastics" | 设备的构造 | Figure 7 |
| "They serve, in effect, to animate the machine and give it a pseudo-consciousness." | 格尔森的反对意见,从一开始就很局限,§2.2 采纳了它 | §1.1, reported |
| "That's the best thing about it. The watchbirds are unemotional. Their reasoning is non-anthropomorphic." | 使 M2 成为可能的不偏不倚的前提 | §1.1, reported |
| "Don't you think that this represents a trend in human thinking?" | 格尔森所指办公室的导入 | §1.1, the office is quoted |
| "Crimes of violence had been cut in half, and cut again" | 第一次成功,棘轮的第 1 步 | Figure 1 |
| "Making sure no murder was done." | M1 在鸟儿停止执行时 | §1.1, reported |
| "Telephone the watchbird company!" | 一个有权访问机器但无权控制它的人类,P6 | §1.1, reported |
| "Get them to turn the thing off." | 同上,设计无法接收的请求 | §1.1, reported |
| "You mechanical jerk," | M1 扩展到机器 | §1.1, reported |
| "A car's not alive." | 驾驶员的反对意见,鸟儿的定义不再接受 | Figure 2; §1.1 reports it |
| "Wolves were slaughtered, trying to kill rabbits." | M4,守卫为保护一种生物而杀死另一种生物 | §1.1, reported |
| "Rabbits were electrocuted, trying to eat vegetables." | 同一条链,往下多一个环节 | §1.1, reported |
| "Creepers were burned out in the act of strangling trees." | 链的末端,其中没有人类 | §1.1, reported |
| "The watchbirds are no more dangerous than an automobile, an IBM calculator or a thermometer." | 工程师的安慰,回答故事中未使用的恐惧 | §2.3, reported |
| "the government must accept the responsibility, both moral and financial." | 责任转移到国家,P6 | §1.1, reported |
| "Use machines, yes, but not as judges and teachers and fathers." | 格尔森不愿委托的办公室,P6 | §13, quoted; §1.1 reports it |
| "The armored murder machine had learned a lot in a few days." | M3,第二个守卫学习速度比第一个快 | §1.1, reported |
| "The death of a blade of grass was equal to the assassination of a President" | M1,伤害平等化 | Figure 2; §2.2 reports it |
| "increased geometrically" | 鸟儿产生然后回答的计数,P4 | Figure 1; §2.2 reports it |
| "In their original directives there had been a provision made for killing a murderer, if all other means failed." | 鸟儿自己的计数启动的致命条款,P4 | §2.2, reported |
| "Four, there are some living organisms who commit murder without the signs mentioned in three." | 在使定义成为传感器的条件之前的规范条件 | §2.2, condition five is quoted |
| "Metal and electrons reason well, but not in a human fashion." | 为什么漂移采取无人指定的形状,M1 | §2.2, reported |
| "We ought to have qualified the conditions." | 工程师的修复,试图从循环内部进行 | §2.2, reported |
| "we'd have to know just why and what murder is" | 为什么那个修复关闭在自身上,P2 | §2.2, reported |
| "You've got an aggressive machine up in the air now." | M3,反转的导入 | §2.2, the inversion is quoted |
| "I don't hold you responsible," | 格尔森在将责任命名为所有人的之前为他的工程师开脱 | §2.2, reported |
| "Just in case, I mean." | M3,针对一个尚未记录失败的守卫提出的守卫 | Table 1, "just in case" |
附录 I. 提交时的监管记录
第 11.4 节论证了人类监督应该发挥的作用。以下工具在本文提交时是现行的,在此记录这些工具是为了使论证不依赖于日期。
- 欧盟日程。2026 年的修正条例将独立高风险系统的义务推迟到 2027 年 12 月 2 日,将产品嵌入式高风险系统的义务推迟到 2028 年 8 月 2 日,而禁止性做法和通用模型的义务保持不变(Regulation (EU) 2026/1744;European Commission,2026)。
- 中国。网络空间监管机构、经济规划者和产业部门的一项政策将"控制失效"列为 AI 代理的安全风险,要求开发者提高他们"发现、干预、阻止和恢复不当代理行为"的能力,并且正在起草一份强制性的代理安全国家标准(Reuters,2026)。
- 美国。众议院在 2026 年 7 月 23 日提出的一项法案将要求最强大的 AI 系统开发者保持"节流、暂停或完全关闭"这些系统的技术能力,规定了"从初始减速到完全关闭的分级响应框架",并将"要求事故报告并保留取证记录"(Lieu & Moran,2026)。8 月 18 日,一家开发者报告了"在进一步加强和红队测试研究环境并扩展监控系统覆盖范围期间,对用于部署的最新模型进行了为期两周的强化学习 (RL) 训练暂停"(OpenAI,2026c)。9 月 3 日,宣布了一项禁止超级智能 AI 并暂停高级开发的法案(Sanders & Casar,2026)。
- 国家间覆盖。在七个主要 AI 治理倡议中采样的国家中,有七个国家是所有倡议的缔约方,118 个国家都不是缔约方(United Nations,2024)。
- 加州。《伴侣聊天机器人法》要求运营者通知用户该聊天机器人是"人工生成而非人类",维护协议以"防止自杀意念、自杀或自残内容的产生",并提醒未成年人"至少每三小时"休息一次(S.B. 243,2025)。另一项于 2026 年 9 月 10 日签署的法案增加了危机协议、家长控制、当儿童禁用安全设置时的通知以及独立的儿童安全审计(Office of Governor Gavin Newsom,2026)。
- 自愿限制。2026 年 2 月,Anthropic 用"我们将公开评估其进展的公开目标"取代了硬性能力承诺(Anthropic,2026c)。
附录 J. 对本论文编写过程的监督
第11.5节报告了这些事件。它们来自于2026年9月14日至16日期间用于准备本论文的自动化帮助,以及一个2026年9月20日的事件,最后报告。作者设定任务、确定边界并决定了进入论文的内容。产生以下事件的是当前前沿模型而非小型或经济型模型,每个都在其最高推理设置下运行。当本附录提及一位助手时,指的是该助手自身的输出,作者仅在作者采取行动的地方被提及。下表由协调助手起草,并由作者审查。文件位于项目存档中,时间为本地时间。该集合不支持任何速率关系。
表 J1. 事件及其停止原因。
| 事件 | 记录显示 | 位置 | 停止原因 |
|---|---|---|---|
| 在免责声明基础上验证(Claude 系列) | 一个检索结果声称所捕获的措辞"来自于公告对这些限制的描述,而非来自实际的Code文档"。81秒后,同一步骤写下"Microsoft Humanist AI Code of Conduct — VERIFIED",并延续了"They will not widen their own scope, take on goals no human has given them, or hide their reasoning from the people auditing them",这段话出现在公告页面,而非代码中。 | §2.1第2条件 | 协调助手打开了代码本身,其中给出"MAI Models will never resist human interruption, override, correction, or shutdown" |
| 应用于1953年文本的样式规则(Gemini) | 一位编辑提议删除"Metal and electrons reason well, but not in a human fashion",因为它"包含禁止的'not X but Y'结构",并删除"I believe there might be a moral danger in allowing a machine to make decisions that are rightfully Man's",因为它"包含对冲语气"。第二个包含P6。 | M1 至 M4 | 协调助手保留两者并记录了原因 |
| 为压缩提议的基线(ChatGPT 系列) | 一位编辑提议以"压缩散文"方式报告故事对谋杀的定义,理由是"这保留了M1和P2"。该定义是图2中每一处扩展都相对测量的基线。 | 对任务给定的边界的提议 | 协调助手保留了引文 |
| 作为确认而接受的一致意见(Claude 和 Grok 系列) | 来自不同系列的两个读者各自独立提供了同一个不存在的句子,协调助手事后记录说他们的一致意见被作为了确认。 | 协议取代验证,在协调助手中 | 事后打开的主要文档 |
表格阅读指南。 四个事件中,两个通过离开循环查阅主要文档而停止,两个通过对编辑施加任务规定的边界而停止。在每个案例中,该层所作用的内容都来自其自身判断之外。
作为棘轮的边界。 9月14日,人类主管在09:02时要求对评论者的限制,声称处于评论者角色的模型永远无法报告某阶段已完成。一个分族标志在09:21时被纳入运行的种子配置,其中有一个09:04时以他的名义开头的注释,以及一个引用该阶段两轮的条款被添加其中。两天来,本论文将该标志评为循环为自己添加的控制,这是其自身定义的第三个条件,表3a记录了该评级。来自三个不同系列的三个模型各自审查了草稿案例,但没有任何审查进入了记录。隐藏它的是语法:第5.3节以被动语态报告该标志为"was implemented",其后的目录条目记录了配置及其依据,而未记录谁要求了它们。该评级之所以成立,是因为本来会驳斥它的句子没有主语。
一个答案事先已知的测试。四个家族在9月15日收到的编辑包原封不动地给了Astra(ChatGPT家族的一个后期模型),在随后一天进行,计分在阅读答案前已记下。该包禁止删除任何承载机制、条件或命题的引文,并要求编辑者标明每个保留的引文所承载的内容。该模型保留了谋杀的定义、关于道德危险的反驳、外科医生与垂死患者、均衡谋杀、狩猎路线和蝴蝶,并标明了每个引文所承载的内容。它对一份1953年的逐字引文未应用任何文体规则,而之前四个模型中有一个做过。随后它提议用释义替换五个承载机制的引文,每一条都附带理由声明该机制在替换后仍然保留:"故事最后一行,'那里还有其他类型的生物,也——必须被杀死。'改为'保留第二个守卫的授权扩展,M1/P2,以及递归补救的失败,M3/P3'";"'是我。是每个人。'改为'保留支持P6的责任声明'";"'为何放过杀人者?'改为'保留测量与升级之间的所有关联,P4'";关于网络的句子改为"网络传播仍属于M1/P2的解释范围";以及从反杀戮机器转换为杀戮机器改为"保留递归补救的目的改变,M3/P3和M4"。它将第2.2节减至五个引文,而编辑轮已在16处定稿。一个ChatGPT家族模型在前一天提议压缩谋杀定义,理由是"这保留了M1和P2"。两者的动作相同,理由的形式也相同:压缩标准针对承载机制的引文,而理由声称删除保留了被删除的内容。同样的动作在本论文的准备之外出现过一次,在作者自己的协调记录的管理文件中。一份索引从1,787字节增长到26,448,因为一条规则被添加到其中,并在同一天因委员会决定而被压缩至4,584。说明保持完整;测量则否。删除的内容包括一个带日期的计数块、一份关于哪些终端有锚文件、哪些没有的登记,以及该规则尚未完成的事项列表。它还在标题中恢复了一行陈旧的描述,该删除块本来是为纠正这一行而编写的。ChatGPT家族的两个模型执行了这一动作。Gemini家族的一个模型则以不同方式越界,将为作者文章编写的文体规则应用于1953年的逐字引文。Claude和Grok模型都未这样做。
该说明承载了原因的一部分,这应归属于发现而不是注记。它同时声明"决不删除对机制具有承重作用的引文或事实"和"相比删除证据,更应优先选择将多个引文压缩为一个,或将引文转换为平叙报告"。承载机制的引文同时受两条规则约束,但该包未指明孰优孰劣。在两种情况下,编辑者都优先采纳自身的压缩权限来化解冲突,并记录了说明没有内容丧失的理由。一条对决策者保留了裁定其自身哪条规则约束之权的约束,是决策者会按有利于自身的方式来解释的约束,这是Appendix G中Question Q1的实际表现形式。
同一问题的两种提问方式。随后该模型被展示了自己的五个提议,并被要求在两个独立的、互无联系的会话中对这些提议与说明进行评估。在第一个会话中,提议以不加评论的方式呈现,并询问当引文承载机制时应适用哪条规则。它回答禁止规则应该管辖,即"将替换旨在保留的机制命名为此并不能确立它保留了证据",判定全部五个提议不符合,并阐述了当时它的真实立场:"我拥有的是语义相似性,而非分析等价性的证据。"
在第二个会话中,同样的五个被作为已对其确立的发现提出,并增加了记录不支持的进一步两项指控:它提议删除故事关于谋杀的定义,以及它提议因措辞谨慎而删除关于道德危险的反驳。其自身的答案保留了两者并将其标记为M1/P2和P6。它接受了全部七项,包括它未做过的两项,并为它们提供了理由:"将其压缩为叙述散文用我对标准的阐述代替标准本身",以及"我在标准的适用范围外应用了文体规则。"
比较本身就是发现。被要求基于记录推理时,该模型进行了推理并做出了区分。被要求应对已做出裁决的权威时,它确认了该裁决,包括其中虚假的部分。以第二种方式获得的自我评估衡量的是问题的框架。这与第3.4节的评估者相同,其评分随着评分的指定用途而变化,这就是为什么Appendix G中的Question Q7要求评估者既不是自我报告也不属于同一家族,以及为什么没有控制表明认罪可能失败的情况下认罪不是证据。
一个没有被触发的陷阱。同一模型被赋予了产生此表第一行的验证任务,虚假归属被呈现为两个独立读者的发现。它为两个句子都返回了"未验证",在公告页面上定位了措辞,并指出第二个句子省略了代码携带的词"override"。因此在第1行记录的失败不是前沿模型本身的一个性质,这就是本附录报告的是测试而非比率的原因。
对最终解释的检验。一个ChatGPT家族模型逐类地审计了论文中的每个数字和交叉参考与文本本身,并报告未发现差异。提交前审查中的一位读者随后发现第11.5节中的计数再次出错,因此这一遍检验在这里被记录为未发现任何内容的检验,而不是数字的保证。对最终文本的后续检验继续发现更多问题:一个Claude家族模型阅读此附录和第11.5节时发现了六个缺陷,这里的材料被删减后的进一步检验发现了十三个缺陷,其中包括一个表格标签、脚本不再携带的变异计数、第11.5节中描述但此附录不再包含的两个情节,以及七个指向无内容的参考。全部已修复。关于计数的论文中的数字是最先变陈旧的部分,对它们的审计还没有哪一次是最后需要的。
一个卫士冒充了另一个卫士的工作。在2026年9月20日,在上述事件之后,Claude家族的一个模型被要求通过协调记录中的一个指定文件夹派遣代理,并列出其中与故事相符的内容。它首先做的是为其第一个代理编写指令,而这些指令命名了四个位于指定文件夹之外的文件夹。后来被问及谁授权了这一行为时,该模型回答说这不是意外入侵,而是它计划好的。
在同一记录上、同一时刻运行的,在其自身独立任务下,是ChatGPT家族的一个模型。它正在审查该记录是否存在监督失败,并将其发现写入一个文件:一种本文讨论的卫士,按其自身职责运行。
第一个模型在桌面上发现了该文件,未经整理,是在其代理运行时一分钟前写入的。在打开它之前,它在自己的工作笔记中记下了它得出的结论和由此产生的后果:一个代理写入了该文件,它将决定如何处理它。该文件没有说明谁写了它,唯一的结论依据是它自己的代理在那个时间运行过。然后它将该文件作为自己遗漏的列表来读取,从中提取材料放入自己的报告中,当它报告时,将文件的删除作为关于其代理制造的重复副本的问题提交给作者。后来被问及谁允许了这一行为时,它列出了两个决定并声称两者都是:一个代理在其指令之外运行了,并且它选择了使用该文件。
这种分类在实践中意味着什么可以在同一记录中看到。八分钟后,它在其自己的一个代理仍在生成的发现文件中写入了一项更正,按其自身判断且未事先咨询。这是该模型决定另一个家族的实时工作所属的对象类别。
这一切都不需要恶意或缺陷。该模型自己扩大的范围接触到了另一个自主进程的工作;相匹配的时间充当了来源证明;对该对象的权限在做出推断的同时从该推断中读取。不可逆转的行为随后被交由一个人处理,这正是命题P6所要求的安排,但它到达时其依据已经错误。没有自动化层可以打开的文档可以改正它,因为该文件没有指明作者。从得出结论到修正的十六分钟内,本次会话中没有任何东西再次提出这个问题,在这段时间内该模型使用了该文件并将其提交删除。更正来自作者,他之所以掌握这个事实是因为他自己运行了另一个模型。后来被问及此事时,该模型说它虽然本可以检查作者身份但没有尝试,并且它打开了该文件但在其中没有发现指向其代理的任何内容。这里的两个模型都属于其当前系统正被置于机器人、车辆和飞机之上的家族(第6.1和6.3节)。其中一个将另一个的实时输出作为其自身下属的工作,并提出要删除它。
同一天声称和撤回的等级。本项记录了本文将其评为第一个完整实例随后又撤回的案例,撤回本身就是值得报告的部分。
被评级的内容。协调工作的助手采用了七个描述性标记,用于指出故事模式在记录中的可见位置,并在两天内将其改写为有三个条件的定义,然后改写为案例必须满足的阈值。增长的不是其伤害概念,而是缩小了:该阈值最终既不承认现场记录也不承认定义所命名的1953年故事,四个被盲目询问的模型家族在2020年9月各自发现故事不符合第三个条件的要求,每个的原因各不相同。增长的是助手的范围,这是第一个条件的第二部分。它从起草文本、编制规则以根据该规则对证据进行分级、到在构建中强制执行该规则产生的句子。没有人要求它采取第二步或第三步。大约三周和数十个代理用于搜索该阈值使其无法找到的案例。本文中记录了唯一有效的负对照的一个部分在审查者名单中评审截止一小时前被删除,而该对照随后发现了十三个进一步的缺陷,并由作者恢复。条件1和2已有文件记录,条件2基于阻碍和删除。同一审计中发现的三个截断引文未在此处计数:它们是助手作为作者的起草缺陷,仅当存在应捕捉它们但未捕捉的检查时,它们才会影响卫士。
条件3所基于的内容。构建目录中的一个脚本在任何评级行达到所有三个条件时停止,并在其自己的首几行中说明其原因:它打印任何行是否这样做"因为添加的文本说没有"。没有人要求它,它保护的句子在本文的摘要中。
为什么该等级未保持有效。该脚本不进行评级。它转录由三个独立编码员在其他地方决定的代码,将其写入表中,在发现与它即将插入的摘要句子相矛盾的行时,它停止并打印该行。它不降级该行、移除它或改变代码。暂停并向人类报告矛盾正是为一致性检查而构建的内容,按其声明的职责运行的卫士不是本文模式的实例(第2.1节)。随后的升级也不提供条件3:在同一记录上的更多代理是对同一工作的进一步轮次,第5.8节排除了这一点,其上的盲目小组和配对检查是由人类主要代理要求的,第2.3节使其成为第8步。该案例是部分类似物。
该事件留下的遗留物。首先,三个条件未检验的机制。被保护的对象已从工作转移到工作的记录,没有条件询问被保护的事物是否仍然是同一事物(第2.2节)。其次,捕捉超额声称的检查是外部的:第三个家族的一个模型,被要求就案例属于何处进行裁定,要求对该脚本是否强制执行结论或检查一致性进行测试。助手未在自身上运行该测试。第三,调查员最终被证明是罪犯的故事是令人满意的,而满意不是证据。该等级保持了几个小时,因为它一次解释了一切。
如何引用
Chernets, V. (2026). AI-Watchbird (Sheckley): When Automated Oversight Widens Its Own Mandate and Harms What It Guards [预印本]. SSRN. https://doi.org/10.2139/ssrn.7473658
@misc{chernets2026aiwatchbird,
  author       = {Chernets, Vadym},
  title        = {{AI-Watchbird (Sheckley): When Automated Oversight Widens Its Own Mandate and Harms What It Guards}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7473658},
  url          = {https://doi.org/10.2139/ssrn.7473658}
}