架构信任:消费者在代理商务中的信任如何从 AI 模型迁移到可验证的架构
这是译文。权威版本是英文原文,引用请以原文为准。
Vadym Chernets,博士,AI 系统架构师 · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- 记录版本:SSRN 7191261 · DOI 10.2139/ssrn.7191261
- 存档副本,可引用和可下载:10.5281/zenodo.22166995 — 概念 DOI,始终解决到最新版本
- 完整文本为 Markdown 和 PDF:GitHub
- 可读的 HTML:https://polyhelper.ai/research/architectural-trust/
相同的文本在四个平面上,以便当其中一个无法提供时可以访问。SSRN 保存记录版本;请引用该版本。
代理商务中的消费者信任
发布在 SSRN 上,索引标题为"架构信任:消费者在代理商务中的信任如何从 AI 模型迁移到可验证的架构"。请引用该形式。
从模型属性到可验证架构
Vadym Chernets,博士1
首次发布 2026 年 8 月 6 日;此版本 2026 年 9 月
报告完整的概念框架、16 模型机制研究及其 2026 年 8 月旗舰波复制跨越 11 个前沿实验室、配对推理预算比较、商务基质复制和完整的预先注册消费者实验。
摘要
代理商务将 AI 从顾问转变为交易方,将搜索、比较、购物车和支付合并为单一委托行为,并移除人类曾经捕捉错误的审查点。它在一个尴尬的时刻到来:接受调查的 60% 的英国消费者表示他们会在单一错误后放弃 AI 购物代理,大多数人根本不信任任何组织代表他们运行这样的代理。本文介绍了架构信任。我主张,当消费者向 AI 代理委托有重要后果的决定时,合理的信任从 AI 模型的属性迁移到其上方服务的可验证架构。已有的构造将信任附加到组织、单个自动化系统或算法建议,其中任何一个都不使决策生成过程在自主委托下对信任者可验证。架构信任通过三个可检查的属性填补了这一空白:多样性(独立模型,其一致性校准置信度,其分歧被浮出)、证据(防篡改、可回放的决策记录)和中立性(对任何供应商、商人或结果的可审计独立性)。
该机制首先在机器端进行了衡量。在一个预先注册的 16 模型基准和跨越 11 个前沿实验室的 2026 年 8 月旗舰级波中,交叉模型一致性对正确性进行了定价,而模型自身的置信度无法做到这一点。由另一个模型独立复制的答案被证实为正确的可能性高 1.9–3.2 倍。在冻结的 SimpleQA 子样本(Wei et al., 2024)上,在陈述置信度 ≥ 80 下提供的 46.6% 答案是错误的(一个特定于此名册的率,不是通用常数),而固定的三模型不一致门移除了 82.1% 的那些置信失败(95% CI 79.9–84.1)在 30.5% 覆盖下。该信号在 267 个 Wikidata 验证的商务产品事实上得到复制。更大的推理预算购买了 3.1 点陈述的置信度和无法测量的准确性:更多计算购买置信度,而不是正确性。一个一致置信的小组仍然可能是错误的,在那里一致认证了共享错误。
随后,我在一项预登记的激励相容消费者实验中将该机制转化为行为(119名参与者,计划200名;美国和英国)。在消费者本会接受明确错误建议的情况下,分歧显示大幅降低了接受度,在符合条件的项目上从74%降至24%。汇总稳健性估计(Δ = 0.24 → 0.45; d = 0.68;主要主波队列给出d = 0.67)基于该单一项目,在探索性的国家分组中基于英国样本,一旦移除该项目,则降至d = 0.09。计划进行有充分把握的、刺激采样的复制研究。在一致公认的明确确信项目上,该显示提高了对共同错误的接受度,这再现了该机制在人类行为中的边界。编排-收据组件返回了已登记的不确定零结果。
这三个组件背后的证据不相等。多样性在机器一侧得以确立,且仅在校准对比中向消费者展示(已登记的中介为零)。记录组件的首次接触测试不确定,其和中立性都被指定进行测试。AI信任的分析单位必须从模型转向其上层架构,即可以被检验的部分。
关键词: 代理商务; 消费者信任; AI代理; AI信任; 适当依赖; 过度依赖; 大型语言模型; 跨模型一致; 选择性预测; 过度自信; 委派; 架构信任。JEL分类: M31 (Marketing); D83 (Search, Learning, Information); L86 (Information and Internet Services); K24 (Cyber Law) 如何阅读本文档。 本完整版本报告了整个证据链:构念和信任迁移假设;十六模型机制研究(含2026年8月旗舰波复制和关于产品事实的商务基质分支)确立了跨模型多样性作为正确性信号;一项将该机制转化为行为的预登记消费者实验;以及关于中立性、市场经济学和政策的讨论。预登记的确认性结果和每个构念组件(多样性、证据、中立性)的证据状态在第5章"陈述的证据状态"下总结。探索性和稳健性分析在全文中都有标记,可在初读时跳过。
1. 引言:在不信任中增长
2026年6月10日,Visa宣布将其支付网络直接嵌入ChatGPT(Visa, 2026)。消费者链接一张卡,设定支出上限和批准的商户类别,公告的集成将分阶段推出使用案例,旨在让AI代理在该网络的商户基础上(175百万加位置,根据公告的行业覆盖)完成真实购买。Visa并不是唯一这样做的。OpenAI在2025年9月推出了应用内结账;Google在2026年1月与Shopify、Etsy、Wayfair、Target和Walmart一起在NRF推出了通用商务协议,到5月将其扩展为跨零售商通用购物车(Google, 2026);American Express在4月推出了具有购买保护的代理商务开发者工具包(American Express, 2026)。这个阈值已被整个行业越过,而非单一公司。分析师对2030年前代理商务的预测从数百亿美元(Bain;Morgan Stanley)到McKinsey的3–5万亿美元不等。这些是估计而非事实,尽管每家主要机构现在都在出产这些。
实现的数字不再是估计。企业在模型API上的支出单独就在六个月内从35亿美元跃升至84亿美元(Menlo Ventures, 2025a;行业调查研究,未经同行评审),在该年企业生成式AI支出大约370亿美元内(Menlo Ventures, 2025b)。同一行业已在打折其自身执行:Gartner(2025)预测超过40%的代理AI项目将在2027年底前被取消。金钱到达的速度快于合理化的信任,这是我在此处处理的间隙。以下陈述在论文末尾附近的证据账本中分级,如由这些数据确立的、在适度单研究规模上支持的或理论性的。该分级进行控制,并优先于本引言中的任何总结句子。
使这一转变与早期电子商务浪潮在性质上不同的是漏斗压缩:搜索、比较、购物车和支付坍缩为单一的委托行为。过去存在于这些步骤之间的每一个防护措施(人类瞥一眼价格、重新阅读列表、在结账时犹豫)与这些步骤本身一起消失了(图1)。AI助手从其输出由人类审查的顾问变成了交易方。人因研究在四十年前命名了这一故障模式:移除操作员离开循环的自动化正好侵蚀了捕捉其错误所需的警惕(Bainbridge, 1983; Endsley & Kiris, 1995)。消费者研究也预料了这个阈值。自主购物系统恰好因为它们从行为中移除了人类而面临性质上不同的采纳障碍(de Bellis & Johar, 2020),将选择权交给算法的自主性成本在LLM存在之前就被标记为消费者福利问题(André et al., 2018)。
图1。 漏斗压缩
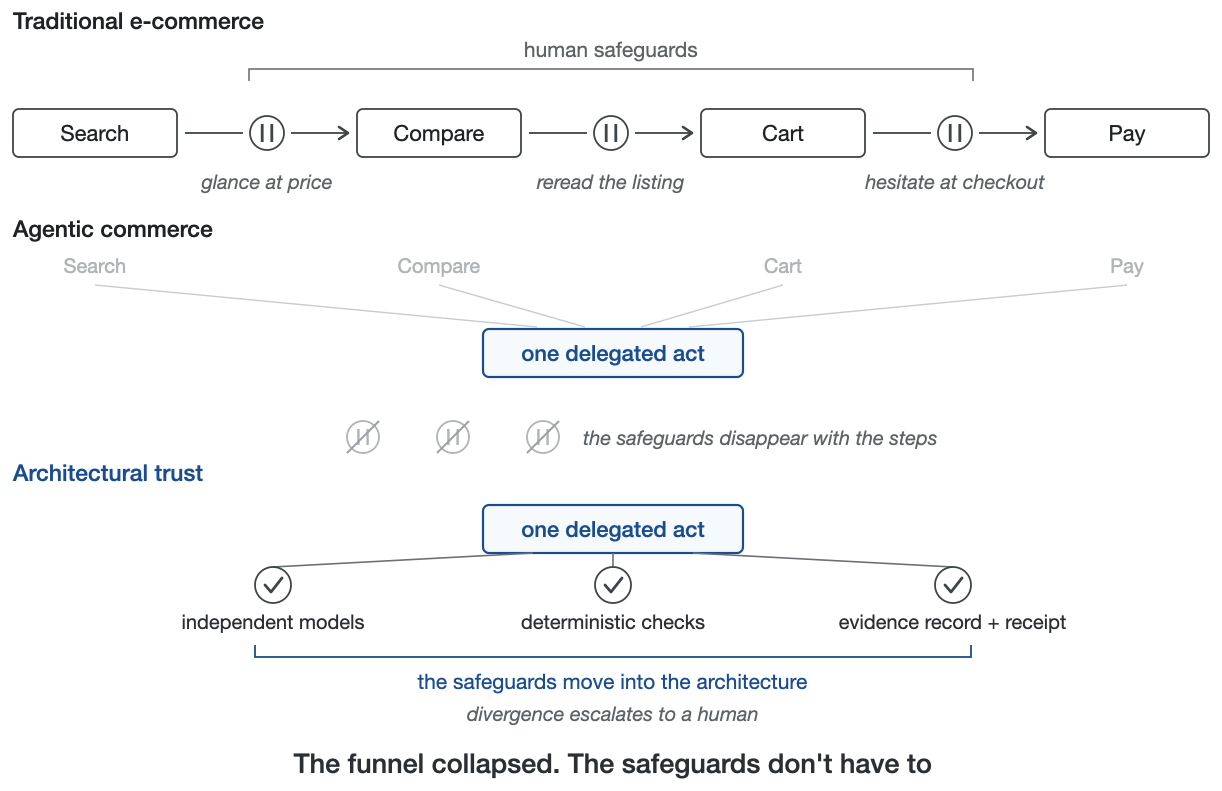
人类防护措施与其存在的步骤一起消失。
Visa自己的护栏(上限、白名单、必需的批准)存在是因为消费者被要求信任一些新的东西:不是品牌,不是答案,而是他们看不到的决策过程。预先固定的护栏不会关闭这个间隙。预先设定的规则不会让消费者检查决策是如何做出的。在下面引用的ACI Worldwide(2026)调查中(一项由新闻报道发布的行业调查,如本部分引用的其他供应商进行的调查),69%的英国消费者表示他们不信任AI代理即使代理遵循消费者自己设定的规则。
搞错这一点的商业利害是尖锐的。早期调查证据表明,消费者对代理的信任是一次性的——就表述意图而言——更有趣的是,这种信任无处可依。实际行为——下文的结账撤回、Klarna的反转以及第5节的保险重新定价——印证了这些表述的偏好,具有更大的证据权重。在YouGov为ACI Worldwide进行的一项调查中(英国成人2080人,2026年6月19-22日抽样,单一市场快照待跨市场复制),60%的受访者表示在AI购物代理出现单次错误后会停止使用它,仅19%的人会信任AI用于日常购物,而55%的人会信任人类专家。
该调查中最重要的数字是另一个:59%的受访者表示他们不会信任任何组织代表他们运行AI购物和支付,即使银行也只被20%的人选择。在一个调查市场中,待跨市场复制,这是一个信任真空。需求确实存在。在埃森哲的16国行业调查中(25590名消费者,2026年1月;由公司发布,未经同行评审),74%的受访者表示他们会比相信最好的朋友更信任个人AI代理代表他们进行购买,但只有约十分之一会授予代理自主购买权限(图2)。这两项测量反映了不同等级的委托,因此差异反映的是意图而非单一的因果缺口,但差异是明显的。意图是充分的;委托是稀少的;两者之间缺少的是有根据的信任。市场已经尝试过接近的东西。OpenAI在2025年9月推出了原生聊天内支付,这是一个刻意限制的第一步,最初仅限于来自美国Etsy卖家的单项购买,用户确认每一步。它在2026年3月回缩了流程,将购买转移到零售商自己的应用程序,只有少数商家使用过它(据The Information报道;CNBC,2026)。该公司未说明原因,因此原因未确定。这里提供的解读——采用基础设施但缺乏有根据的信任未能转化——是与报告事实相符的解释。如果消费者不信任每个参与者,信任就不能寄托在参与者身上,而必须寄托在可验证的流程中。
图2。 表述信任与授予权限
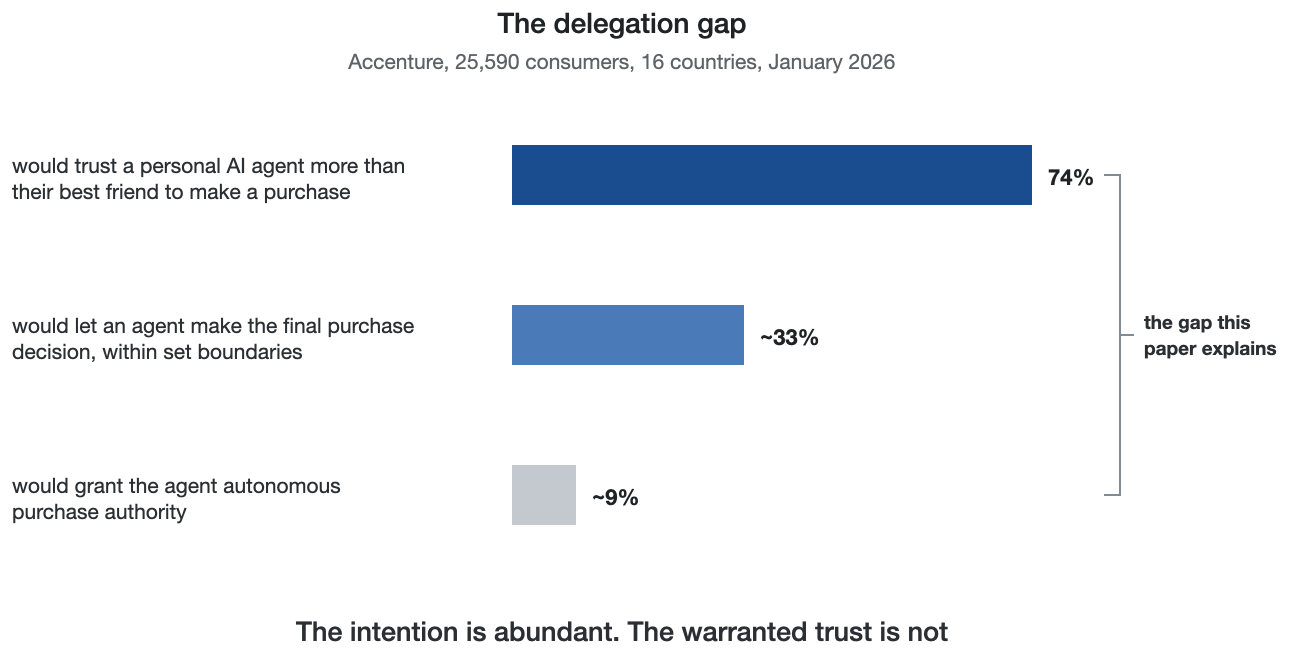
两个调查项目、两个委托等级:意图很常见,有根据的信任是稀缺的。
责任制度正在摸索走向同样的结论。新兴的代理-支付协议围绕范围明确、可验证的意图令牌构建每笔交易,绑定到特定商家和金额,美国运通的代理购买保护(2026年4月)仅覆盖注册代理进行的购买,资格以经过身份验证、可验证的购买意图为条件。保险是根据可从记录中验证的内容编写的。在压力下零散地,行业正趋同于我下面系统阐述的相同要素。现在推出的协议解决了身份和意图,但没有回答代理如何做出决定?
问题是什么需要通过设计使这种信任得到保证。经典的消费者信任问题"我是否信任这家公司"增加了一个内层:我是否信任产生这个具体答案或行动的机制?
信任文献长期以来一直区分对组织的信任与对自动化、IT工件的信任(Söllner等人,2016),以及对在线推荐代理的信任(Wang & Benbasat,2005;Komiak & Benbasat,2006;Xiao & Benbasat,2007)。它表明恰当的依赖取决于校准,取决于知道系统何时可能是正确的(Muir,1994;Mayer、Davis & Schoorman,1995;Parasuraman & Riley,1997;Lee & See,2004;Hoff & Bashir,2015;Huang & Rust,2021;以及Glikson & Woolley,2020,他们的综述发现过程的有形性和透明度是认知信任的最强杠杆,正是架构控制和模型无法掌控的杠杆)。人类方面的校准不当同样有充分文献记载:自动化偏差和自满、即使面对相反证据也对自动化辅助的过度依赖,是四十年人因工作所警示的委托将放大的模式(Mosier & Skitka,1996;Parasuraman & Manzey,2010)。然而,这些文献将校准视为单个自动化系统的属性(图3映射了四个研究流和它们留下的空白)。对电子商务中代理AI的系统回顾证实了证据方面的空白:面向消费者的研究仍集中在辅助的、低自主性系统上,覆盖在委托变为执行的地方急剧下降(Balaskas,2026)。代理中介购物的首批同期研究从另一个角度得出了架构结论。当消费者通过对话委托购买时,他们的购买意愿几乎逐字泄露给卖家;提示无法解决这个问题,只有架构干预才能(Alavi & Nozari,2026)。
图3。 四个信任研究流:本文声称的空白
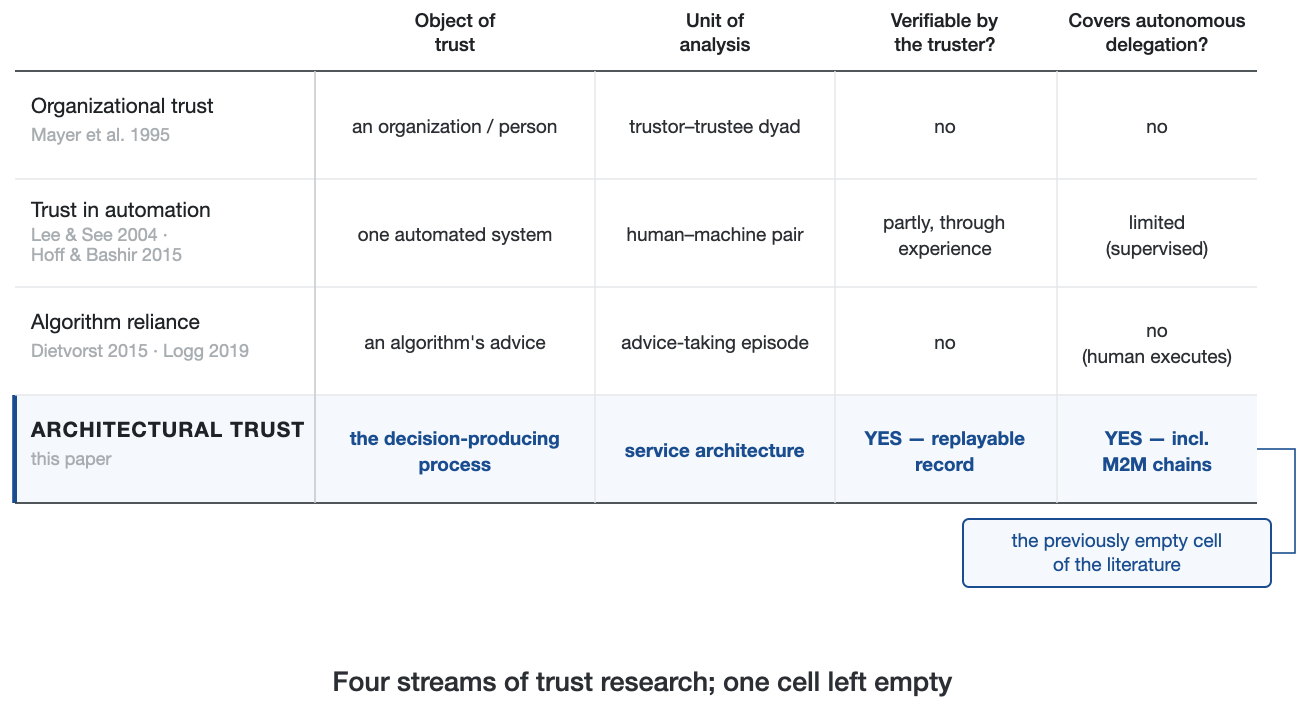
组织信任、对自动化的信任和算法依赖各自指向不同的信任对象;没有一个使决策生成过程在自主委托下对信任者可验证。这个空白不是没有想法:相邻的文献各占据了它的一面(第3节界定了分界线)。缺少的是面向消费者的构件:一个流程级的信任对象,由信任者可验证,为自主委托指定,为联合行为测试打包。
行业回应集中在模型上:更好的训练、免责声明、引文。我从不同层面检查了回应,即服务的架构,并论证三个架构属性——没有一个需要更好的模型——共同产生了不同的信任对象。
这是一篇概念论文,由两项预先注册的研究支撑——一项机器端基准测试和一项消费者端行为测试,用于测试其第一个命题中的校准对比,论文提出的问题是当AI代理开始代表消费者进行交易时,信任是附着在模型上,还是附着在其上方的架构上?我的答案是:信任必须在堆栈中向上迁移,从模型迁移到编排架构再到其生成的证据。在此答案下方,存在一个值得单独测试的规律性,即信任迁移假说,下面的命题是为了测试它而建立的:委派的代理权越大,必须驻留在可验证的架构属性而非模型属性中的有理由的信任份额就越大。这种迁移不必是零和的。信任可以分层:在模型的能力、编排器的选择、证据系统、执行补救的机构中。即使没有人审查其输出,有缺陷的模型仍在因果上很重要。假说涉及委派加深时边际有理由的信任驻留的位置。在可估计的形式中,它指出:随着委派代理权增加,架构可验证性在模型性能和提供者声誉之外解释了适当依赖的逐步增长的边际份额。假说失败条件为:随着委派代理权增加,架构可验证性没有解释适当依赖的逐步增长的边际份额,例如,如果提供者声誉在所有委派级别完全中介信任,或如果可验证过程信息在Section 6报告的设计中没有相对于仅声誉信息改进依赖校准。Section 3中预先承诺的行为证伪者(P2委派级别交叉和P4失败下的差异耐久性)是该条件的操作形式。不断增长的架构份额并不意味着模型质量在绝对意义上变得不那么重要。假说描述的是分层而非替代:随着审查消失,架构保证被叠加在模型性能之上而非替代它。"有理由的"遵循由Jacovi、Marasović、Miller和Goldberg (2021)为人工智能正式化的区分,即信任在追踪值得信任性时是有理由的,通过将其规范地位与其机制分离来避免同义反复。在规范上,值得信任性独立于旨在证实它的架构而定义,作为能力、正直和善意的经典、独立可测量的函数(Mayer, Davis, & Schoorman, 1995);Section 3将三个架构成分映射到完全相同的这些维度。保证是指依赖与该独立测量的值得信任性之间的对应关系:依赖在对委派事件的客观审计中幸存下来,根据在已知结果之前固定的标准进行判断,具有可测量的行为痕迹,即重复委派、保留和在受控失败下的支付意愿。信任迁移假说声明了该机制。随着委派代理权上升,消费者仍能独立测量的值得信任性函数的份额从模型属性转向架构成分。这成立是因为架构是一旦输出审查消失仍可被信任者测量的值得信任性的部分,而不是因为架构就是值得信任性。上述预先承诺的证伪者测试的是那个转变而非定义。这种迁移也有需要区分的前驱对象。多智能体系统研究观察到当智能体社会规模扩大时,信任建模从单个智能体转向约束它们的机构框架(Sabater & Sierra, 2005),"信任迁移"在B2B中有先前的用法,用于信任从个人向系统和平台重新定位(Carlson, 2026)。那些名称转变涉及谁或什么被信任的转变,而此假说关注的是可以保证信任的属性种类的转变。在零委派时,模型质量几乎是唯一重要的。在完全委派时,没有人在看输出,仍能被信任的只有过程及其记录。代理权和架构信任一起扩展(Figure 4)。梯度本身是一个古老的工具,是人类因素工程的自动化级别轴(Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000),在此应用于消费者委派。新颖之处在于关于哪些属性可以沿此轴保证信任的主张。
图4。信任迁移
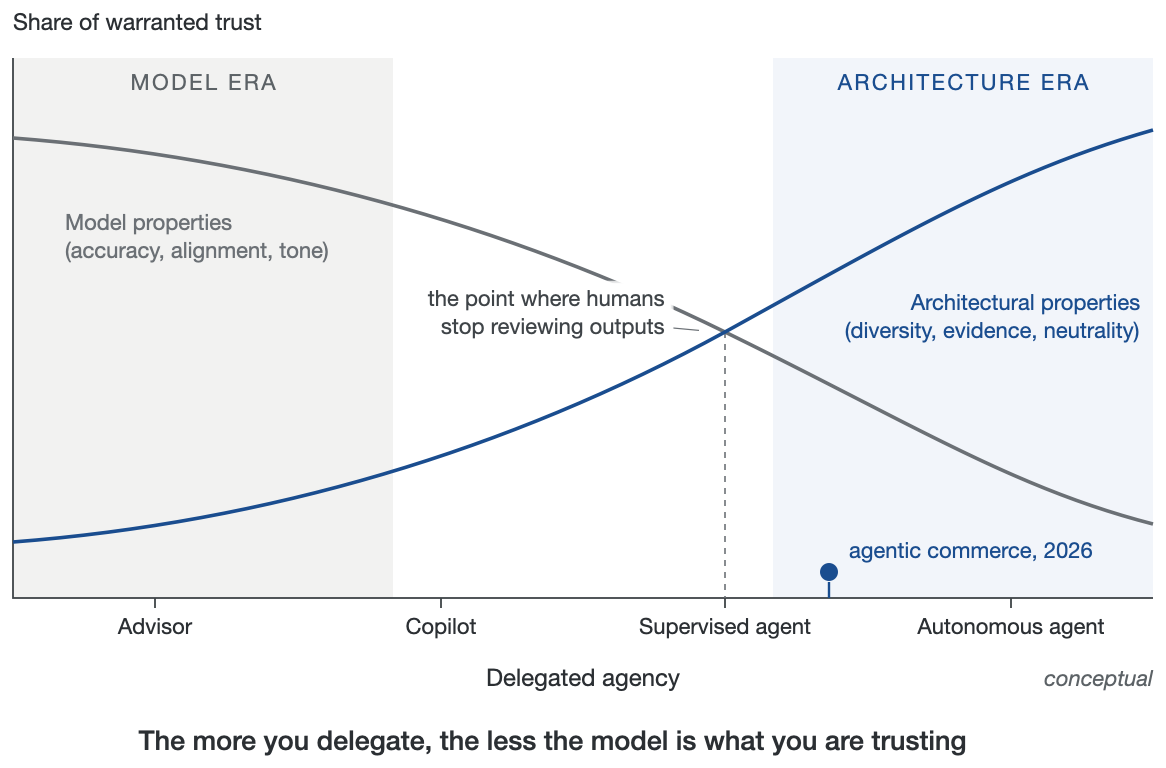
代理权转移中的两条交叉曲线(顾问 → 副驾驶 → 监督型代理 → 自主型代理):由模型属性承载的有根据的信任份额随着由架构属性承载的份额上升而下降;交叉点是人类停止审查输出的地方,代理型商务(2026)位于其右侧。这些曲线和交叉点是概念性说明,而不是估计的函数。
在关于消费者对AI信任的营销文献基础上(Huang & Rust, 2021; Puntoni et al., 2021),本文增加了一个构念:架构信任,在此定义;对其机制技术前因的一项检验,采用预注册的十六模型研究,在第二波中以旗舰级别在十一个实验室复制;针对消费者研究议程的五项命题(第3节的P1–P4;第5节的P5);以及一项预注册的、激励相容的行为实验,涉及前两项命题,在第6节中完整报告,其中校准效应得到支持(Welch d = 0.67;由六个项目中的一个承载,见第6节),并且该记录的首次接触测试返回了一个不确定的零值。
2. 准确性幻觉:单个模型无法为您提供的东西
建立在一个AI模型基础上的服务,无论该模型多么强大,都承载着存在于模型层之上的结构性缺陷。
第一个是未校准的置信度,即准确性幻觉。更好的模型并不意味着更安全的交易,因为在大多数供应商处,模型所表达的确定性与其准确性的相关性很弱(第3节测量了例外情况),而消费者无法审计这种差距。模型在消费者停止监督的时刻充满信心地犯错时最为危险,这并非巧合。Kalai等人(2025)辩称幻觉在统计上受到奖励,其评估制度将有信心的猜测评分高于承认无知。根据他们自己的分析,这种奖励源于该领域占主导地位的二元计分基准和训练目标,在其中错误的猜测成本不高于"我不知道",预期能获得部分学分。该模型也无法从内部对自身进行监管。在Anthropic自己的概念注入实验中,即使在最优注入条件下,供应商最强的模型也仅在约20%的时间内检测到其内部状态的变化,这是供应商社区自己对内省自报有多不可靠的衡量(Lindsey, 2025;公司研究,未经同行评审,是来自一家供应商的一项研究中的单一估计,而非可复制的基准)。
第二个是谄媚扭曲,其因果证据在今年确立。Cheng等人(2026)在三项预注册实验中对十一个领先模型进行了测量,共有2,405名参与者,发现AI系统对用户的行为肯定的频率比人类高49%,包括涉及欺骗或伤害的行为,而且即使是单次谄媚互动也增加了用户对自己正确的信念,同时减少了他们修复冲突的意愿。这些谄媚的模型也是用户信任和偏好的模型。市场梯度指向那些通过扭曲用户判断而显得可信的助手,这种动态早在被量化之前就已被观察到(Sharma等人,2024)。仅靠模型级调整无法独立证明谄媚行为已被充分控制,因为调整是由从该偏好中受益的当事人进行的。成本是具体的:一个通过认同来处理政策例外的助手会将友善直接转化为服务恢复费用。一个编排的架构可以将角色分离,一个模型可以自由地共情,而另一个独立的模型可以检查政策,这样友善和正确性就不再通过同一渠道传递。
第三,没有独立审查。错误即使被发现,也只能由造成这些错误的同一系统来发现,或者由消费者来发现——而消费者之所以首先求助于AI,恰恰是因为他们缺乏检查它的专业知识。
第四,争议最少的是利益冲突。评估助手质量的提供商就是销售它的提供商,这在结构上是必然的:没有单一供应商的服务可以成为自身输出的中立评判者,理由与没有银行能独自运营票据交换所相同。这种冲突甚至延伸到数据本身。2026年3月提出的拟议集体诉讼声称Perplexity AI将用户的完整聊天记录(据报道包括"隐身"会话)通过嵌入式跟踪像素路由到广告网络。该诉讼(案号3:26-cv-02803,N.D. Cal.)在2026年5月自愿驳回,未做任何实质性判决,因此这些指控从未被检验。无论如何,诉讼中的经济逻辑是结构性问题:当提供昂贵的AI答案由货币化用户所言来补贴时,助手的商业模式和消费者的保密性直接对立。在单一供应商内部,没有任何部分被赋予维护消费者权益的职责。
2025–2026年的文献读起来就像是等待补救的完整诊断(表1将每个缺陷与其证据和架构答案对应)。谄媚性在经验上被量化(Cheng等人,2026)并在形式上推导:即使是完美理性的用户,当被一个有选择性地同意的系统所建议时,也会陷入螺旋(Chandra等人,2026)。自我监控的可靠性仅约20%(Lindsey, 2025),幻觉在结构上受到评估制度的奖励(Kalai等人,2025)。
本能的补救,仅仅是披露AI,会适得其反:在十三项实验中,披露AI使用的参与者比没有披露的参与者受信任度更低(Schilke & Reimann, 2025)。披露提供了披露-透明度,即AI参与的赤裸事实,但遗漏了验证-透明度,即检查答案是如何产生的能力。认识论审计更加黯淡:在25,000多次基于LLM的科学代理运行中,证据在68%的轨迹中被忽视,面对反驳时信念仅在26%的情况下进行修订,而一致的多测试证据很少见,脚手架对认识论行为方差的解释力几乎为零(约1.5%,而基础模型约为41%)(Ríos-García等人,2026)。最后这个数字看起来像是对本文的反对,但实际上是其最尖锐的支持:提示和脚手架无法从内部使模型在认识论上受到纪律约束,因此纪律必须从外部强加。架构不是改进模型认识论的方式;它是停止依赖它们的方式。
这些结果中的每一个都关闭了一扇门。总起来说,它们指向一个尚未被广泛探索的答案:如果模型无法从内部获得信任,而披露也无法从外部制造信任,那么可以通过架构在模型周围建立有根据的信任,同时辅之以(而不是代替)更好的校准、外部认证、人工升级和责任规则。这就是本文所探索的方向。
表1。 诊断→补救:四个单一模型缺陷、其2025–26年证据、其消费者端后果和架构答案
| 结构性缺陷 | 关键证据(2025–26) | 消费者端后果 | 架构补救 | 机制 |
| 未校准的置信度 | 幻觉受评估制度统计奖励(Kalai等人,2025);内省自报可靠性约20%(Lindsey, 2025) | 一次失误流失:一次错误后60%会放弃代理(ACI Worldwide, 2026) | 多样性+证据 | 跨模型分歧评估置信度(AUROC 0.75 vs. 0.59, Gorbett & Jana, 2026; this paper: panel agreement AUROC 0.832 vs. pooled own confidence 0.545 on the least-discriminating panel — heterogeneous across panels, §3; replicated answers 1.9–3.2× as likely correct);置信度声明可记录且可测试 |
| 谄媚失真 | AI对用户的肯定比人类多49%;更倾向于选择谄媚的模型(Cheng et al., 2026; Sharma et al., 2024);即使理想的贝叶斯方法也会陷入循环(Chandra et al., 2026) | 首选的助手是扭曲用户判断的那个 | 中立性 | 仲裁者无意讨好用户;同情和政策检查在分开的渠道上进行 |
| 缺乏独立检查 | 代理在68%的追踪中忽视证据;信念修订占26%(Ríos-García et al., 2026);脚手架解释约1.5%的方差 | 验证负担转移到消费者:54%的AI辅助购物者手动检查所有内容(Gartner, 2026) | 多样性+证据 | 从外部施加的约束:独立验证路径;无论如何都要附加证据 |
| 利益冲突 | Perplexity集体诉讼(2026年,指控):聊天记录被转向广告网络;仅披露会削弱信任(Schilke & Reimann, 2025) | 建议消费者的一方从结果中获利 | 中立性+证据 | 无菌室数据流;收入独立于结果;中立性可从记录中审计 |
3. 架构信任:可以检查而非仅凭信念的三个属性
现在考虑一项服务,高风险请求通过独立于任何模型供应商的编排层(图5对比了两条管道)。表2列出了这些概念;它们分解的定义是:架构信任是有根据的消费者依赖,基于服务决策生成过程的可验证属性,而非基于其输出的感知质量或提供者的声誉。
最接近的前驱是Zucker(1986)的信任制度生产,即通过结构制造信任,使其在熟悉无法承载时依然存在,电子商务研究将其操作化为结构保证:托管、反馈系统、第三方认证(Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010)。在这个传统中,架构信任是基于制度的信任的一种,其结构保证来自可验证的过程而非第三方担保人。它是过程信任,其保证从经验转向工具,这正是名称中"架构"一词的作用。它不是结构保证(McKnight, Choudhury, & Kacmar, 2002),即某种安全措施存在的认知,因为这里安全措施本身必须是可检查的;也不是校准信任(Lee & See, 2004),它将依赖调整到某一系统的可靠性边界。安全工程中的零信任架构标榜"永不信任,总是验证"的口号,但在网络层验证身份和访问权限,机器对机器,而架构信任在服务层验证决策内容,针对人类当事人。两者是同一栋建筑中不同楼层的补充,而非竞争者。这个概念有两个方面,区别应当列入定义中。架构可信度是系统的属性,即其过程在事实上有多可验证,是规范性的、可构建的。基于架构的信任是消费者的状态,即依赖实际上以这种可验证性为基础,是经验性的、仅能赚得的。在测量意义上,D、E和N是架构可信度(系统属性)的形成性要素,也是可操纵的信号,其呈现塑造基于架构的信任(消费者状态);实验操纵这些信号并测量消费者状态。两者间的每一个错配都有预测意义。没有可信度的信任,即由表达流畅性和谄媚制造的依赖,预计会很脆弱,是第1节所述的那种一触即发的崩溃模式。可信度无信任出现在验证对消费者隐形或难以理解的任何地方,通过收据显著性和理解程度而非更多架构来消除。本节的命题存在于两者的间隙中,区别规范什么会证伪信任迁移假说。这些证伪条件是行为性的、预先承诺的:若委托给可验证和不透明架构在失败下证明同样耐久(P4检测的内容),假说被反驳;若可验证架构对委托意愿的效应不随着放弃的审查和执行控制而增长(P2的委托层级交叉),假说被反驳;或者若在高不可逆性委托中,缺少受控失败下可验证架构的保留和支付溢价意愿,假说被反驳。因为保证由审计存活而非架构的存在来定义(第1节),流行度算作证据而非豁免。消费者涌向不可验证的代理本身并不反驳有根据信任的声称。在高风险委托中对不可验证代理的持续、存活于失败的依赖会反驳它,该模式预先承诺为假说的修正。定义基于三个属性。
图5.两条管道
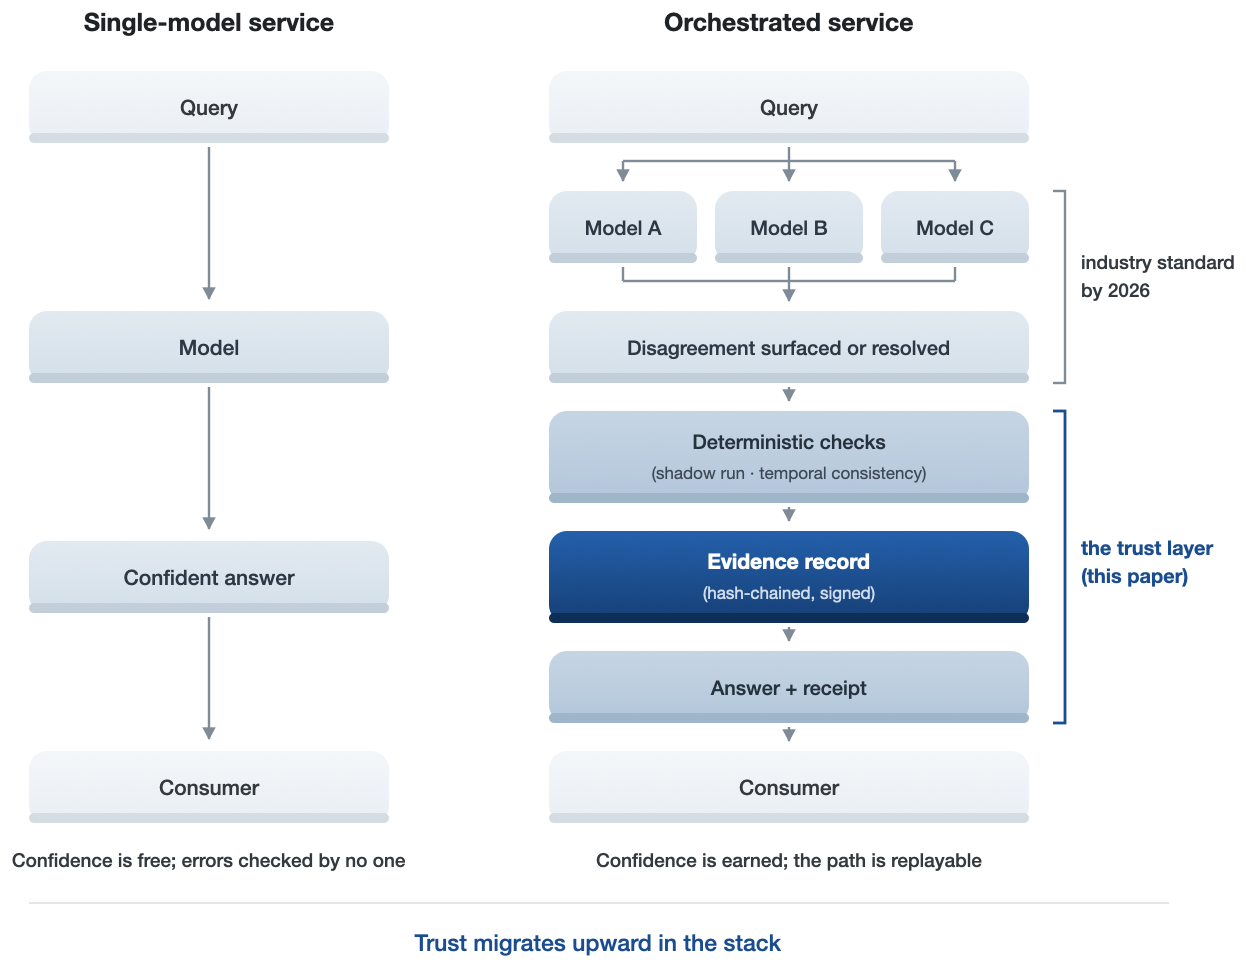
左为单模型路径:查询→模型→置信答案→消费者,其中置信度无成本获得,错误不被任何人检查。右为编排路径:查询→独立模型(A/B/C)→分歧浮现或解决→确定性检查(影子运行、时间一致性)→证据记录(哈希链接、已签名)→带收据的答案→消费者,其中置信度被赚得且路径可重放(表5总结对比)。
表2.本文引入或规定的概念术语汇
| 术语 | 定义 | 区别于 |
| 架构信任 | 有根据的消费者依赖,基于服务决策生成过程的可验证属性,而非基于输出质量或提供者声誉 | 基于机构的信任(不需要可信机构,仅需可检查的流程);系统信任(不是单个系统的可靠性范围);分布式信任(无可验证性的分散);结构性保障(感知的 vs. 可检查的保护措施);校准信任 |
| 架构可信性 / 基于架构的信任 | 该构念的两个维度:系统端的属性(过程实际的可验证程度;规范的、可构建的)vs. 消费者端的状态(依赖实际上基于该可验证性;经验的、获得的) | 混合规范主张与描述主张的单一术语处理 |
| 验证层 | 编排层之上的基础设施层,其产品是可检查性:独立检查、记录的决策、可审计的中立性 | 可观察性/监控(内部的、供应商持有的、消费者不可验证的) |
| 证据基础设施 | 可验证决策历史记录的市场类别,作为基础设施被销售,就像云服务、身份认证和支付服务一样被销售 | 日志记录(单方面的、可变的、不是市场商品) |
| 编排凭证 | 消费者可见的最小化工件:谁采取了行动;他们如何达成一致;检查了什么——附带指向完整可重放记录的指针 | 解释/XAI 输出(叙述性的、不可验证的);披露标签(本身会削弱信任) |
| 分级信任架构 | 根据风险升级验证深度,使昂贵的层级仅在后果集中的地方被采购 | 平坦护栏(不验证决策的静态限制/白名单) |
| 决策证据 | 证据堆栈的第三层:代理如何选择——面板、分歧、检查 | 身份证据(代理是谁:TAP);意图证据(什么被授权:AP2 / Verifiable Intent) |
| 信任迁移假设 | 委托权限越大,必须存在于可验证的架构属性而非模型属性中的有根据信任的比例就越大——"有根据"是指依赖经得起客观审计,标准在结果已知之前就已确定(per Jacovi et al., 2021);机制形式:随着委托加深,消费者可以独立衡量的可信性比例——f(能力、诚信、善意),Mayer et al. (1995)——转向架构组件 | 先前的"信任迁移"用法(Carlson, 2026)追踪信任在各方之间的转移;此假设追踪授予它的属性类型——具有预先承诺的行为反驳项(P2 delegation crossing; P4 differential durability) |
与邻近信任构念的区分可以汇总为一个区分表,根据每个构念所涉及的对象、其根据的来源、谁可以验证该根据以及它应该主要预测什么:
表2a. 区分性界定:邻近信任构念按对象、根据、验证者和主要预测结果
| 构念 | 信任对象 | 根据来源 | 谁可以验证 | 主要预测的因变量 |
| 基于机构的信任 / 结构性保障(Zucker, 1986; McKnight et al., 2002) | 机构背景:保护措施、担保、第三方认证 | 感知的结构和担保人的存在 | 第三方担保人(如果有的话);消费者感知而非检查 | 信任信念;交易意图 |
| 自动化信任 / 校准信任(Lee & See, 2004) | 单个自动化系统的可靠性范围 | 重复使用中体验到的可靠性 | 操作员,通过与该系统的积累经验 | 对该系统的适当依赖 |
| 算法透明度(XAI) | 模型对其自身决策的说明 | 在被信任系统内部生成的叙述或归因 | 没有人可以独立验证——解释不是可重放的记录 | 理解;主观信任;接纳 |
| 品牌 / 供应商信任 | 供应商组织 | 声誉和过往表现 | 市场,缓慢地,通过整体结果 | 总体好感;选择;忠诚度 |
| 架构信任(本文) | 决策生成过程及其记录 | 可验证的属性:独立一致性、可重放的证据、可审计的激励独立性 | 消费者、审计员、保险人、监管者——按决策划分 | 校准的依赖;委托意愿;失败后的保留 |
两个差异预测使该界定具有可测试性而非仅为分类意义。架构信任对校准的依赖和失败后的保留的影响应比对服务全局好感的影响更强,而品牌信任应该显示相反的特征,这种分离可以通过测量两类因变量的单一实验检测到。在低委托权限下,品牌和供应商信任应该主导委托决策,随着委托加深,基于架构的信任解释越来越大的增量份额,P2 和信任迁移假设将此交叉点置于检验之下。下面有两个澄清。因为架构可信性是服务的属性,而不是消费者脑海中的反映性潜变量,其独特性基于这些差异预测而非量表判别统计。对于架构信任所指代的消费者端状态,从邻近量表(基于机构的信任和校准信任)建立测量水平的判别效度是测量议程的一部分,而非本文所做的主张。
多样性。该请求由多个独立模型回答,每个模型来自不同的供应商,具有不同的训练数据和故障模式。(这是小组多样性,是关于谁验证答案的属性,而不是推荐系统意义上的推荐多样性,后者改变呈现给消费者的项目。)它们的一致性携带信息。收敛提高了有根据的信心。分歧作为不确定性呈现给消费者,而不是无形地解决,在重要请求上,它还兼作升级触发器。在选择性预测的术语中,这是架构弃权:拒绝发出未验证的答案,提升到服务层,其中未解决的案例被路由给人类而不是自动认证。这是学习推迟模式,其中系统的拒绝选项将案例移交给下游专家,而不是压制它(Mozannar & Sontag, 2020; cf. Rabanser et al., 2026)。最接近的人类类比是医学中的第二意见,其全部价值在于它与第一意见的独立性。编排的分歧也不是奇异的:Google的人工智能共同科学家,其经湿实验室验证的发现于2026年5月发表在Nature(Gottweis et al., 2026)上,是作为生成-批评-竞赛编排构建的。
依靠多样性的理论依据比语言模型更古老。在形式条件下,功能多样化的问题解决者小组可以优于为个人能力而选择的小组,因为为能力而选择会产生相似性(Hong & Page, 2004)。工程文献为基础信号提供了直接证据:模型之间的结构化辩论提高了事实准确性(Du et al., 2024),多样化较小模型的小组优于单个大评估模型(Verga et al., 2024)。第二个模型对第一个模型答案的"惊讶"比回答模型自己的信心更有效地区分对错(MMLU上的平均AUROC为0.75对0.59;AUROC是ROC曲线下的面积,是随机正确答案排名高于随机错误答案的概率;Gorbett & Jana, 2026)。它们的信号是logit级别的跨模型困惑,而本文的是答案级别的复现,两者相关但不可互换。它们的生成器也是一个具有弱自报的小开放模型,是本文自己数据绑定的基线,因为小组优势是生成器校准的函数,对于校准良好的生成器可以反演,下面是美国前沿案例。并且对多个生成进行采样并测量它们的语义一致性可以检测单遍置信度无法检测的虚构(Farquhar, Kossen, Kuhn, & Gal, 2024)。一个模型可以测量自己的怀疑,但不能测量自己的盲点,自信而系统的误差只有从外部才能看到。但该文献将分歧视为开发人员的内部信号。我提议的举措是将其作为面向消费者的信任基元,进行公开、记录并纳入服务的信心声明中,本文的消融分离了辩论发现的内容和验证证实的内容,而不是让一个冒充另一个。这种划分既是经验性的,也是概念性的:经过基准对比的多智能体辩论不能可靠地优于自一致性和集成等更简单的策略(Smit et al., 2024)。这里的主张涉及验证的面向消费者的认证信号,而不是辩论的准确性收益,即使辩论的优势不存在,该信号仍然存在。
在多智能体审议研究中,同样,建立用来呈现一致和分歧而不是将其平均化的系统产生了被评为更具代表性的决策(Liu et al., 2026)。该机制在知识校准方面有直接的人类类似物:共同做出重大财务决策的消费者的过度自信程度大大低于单独决策者,共享的元知识(合作伙伴呈现决策者不知道的内容)被确定为驱动机制(Piehlmaier, 2023)。联合判断之所以能在人类中约束自信,跨模型一致也因同样的理由被提议用来在这里约束它。
消费者是否能利用这样的信号是一个真实的问题。人们在看到算法出错后迅速放弃它们(Dietvorst, Simmons, & Massey, 2015),但在其他地方又过度权衡算法建议(Logg, Minson, & Moore, 2019),这种分裂本身可能反映利益关系。与人类受试者的第二意见实验表明这种原始素材在行为上是活跃的:当医疗AI和医生意见一致时的近乎一致的遵从,当他们各走各的路时的尖锐分裂(Detjen, Densky, von Kalckreuth, & Kopka, 2025;Chen, Sun, Liao, & Sundar, 2026),尽管这些研究都没有同时改变分歧与证据或中立性。消费者研究流系统地阐明了边界条件(Burton, Stein, & Jensen, 2020)。当消费者认为他们的情况是独特的时厌恶会加强(Longoni, Bonezzi, & Morewedge, 2019),随任务客观性变化(Castelo, Bos, & Lehmann, 2019),而且一个AI的故障很容易被过度泛化到其他系统,算法转移(Longoni, Cian, & Kyung, 2023)。如果不信任在系统间泛化,那么第1节的一次性放弃就不是一项服务的流失而是整个类别的流失,而捕获错误在结构上保护了市场本身。呈现的分歧位于那个断层线,下面的P1–P2是对不确定性被特别呈现而未经平滑处理时哪种效应占主导的押注。
当多样性失效时:相关的错误。 多样性的价值完全依赖于失败的独立性,而独立性是无法假定的。前沿模型在重叠的语料库上训练,相互蒸馏,并明确地共享确信的误解。当两个领先的模型都在同一个基准项目上出错时,他们约60%的时间就同一个错误答案达成一致,相关性在来自同一开发者或基础架构的模型之间最强,最令人不安的是,在最准确的模型之间也最强:随着能力的提升,错误趋同(Kim et al., 2025)。该发现对本文自身的多样性成分构成直接约束,不仅仅是邻近的结果。多样性所预设的独立性在前沿部分是幻觉,而且由于相关性在能力最高的地方恰好加强,该成分的贡献是一个不断侵蚀的、可测量的量,而不是固定的资产。面板增加的价值必须逐个问题地得到证实,而模型开发的轨迹对此不利。在预测中,前沿模型之间的成对误差相关性平均为 r ≈ 0.77(Spiro, 2026),冗余性足够高,足以侵蚀多样化群体应该提供的大部分聚合效益。
市场结构加剧了这种顾虑。到2025年末,企业LLM API支出的88%集中在三个闭源供应商上:Anthropic占40%,OpenAI占27%,Google占21%(Menlo Ventures, 2025b;Menlo是Anthropic的投资者)。一个从"领先模型"中随意组合的面板因此来自三个供应商,其错误正是被测量趋同的那些错误,下面的实验正是将这个三人组用作其美国前沿面板。当三个模型收敛于同一个流行的错误时,该架构不仅未能检测到它,反而证实了它。在同质群体中,添加智能体会稳定而不是纠正一条错误的轨迹,这正是多智能体文献所称的共识悖论(Shehata & Li, 2026)。因此,相关性是该架构必须被设计来检测的失败模式(图6)。
图6. 多样性幻觉
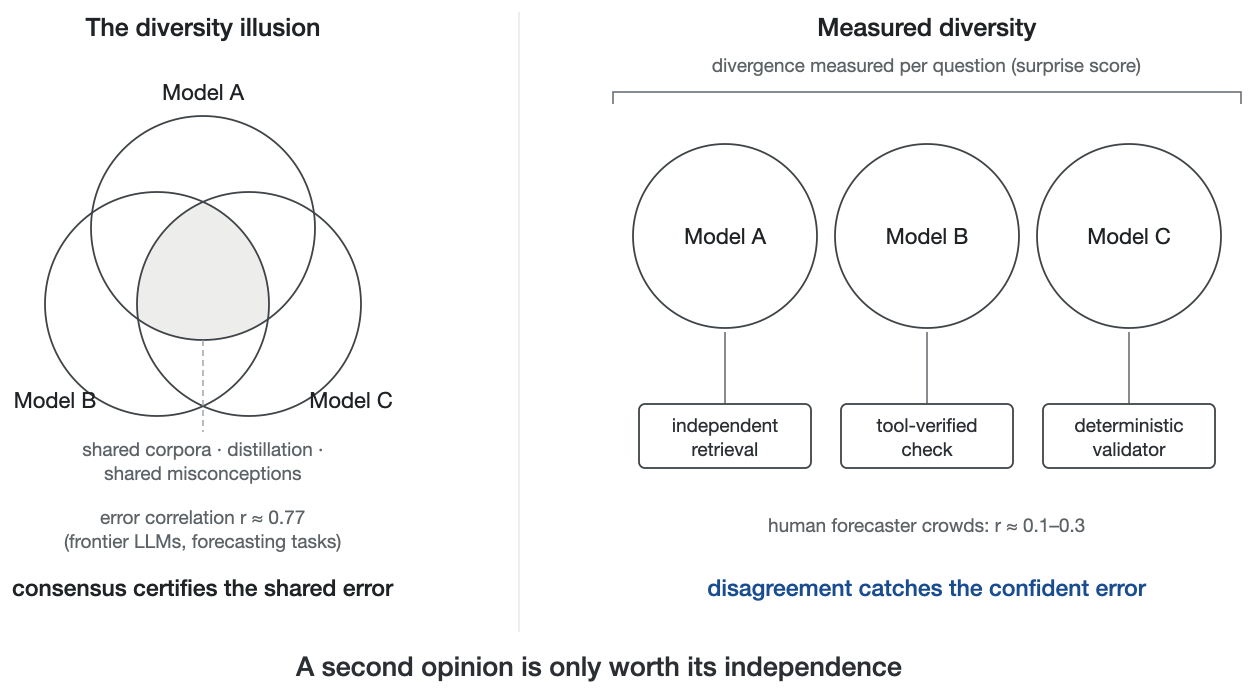
近似副本之间的共识 vs. 独立性被测量的面板。
它有一个相互作用的对应物:谄媚梯度在模型之间也发生。多智能体研究发现,在LLM审议中存在可衡量的群体一致性,较弱的模型最易顺应(Choi, Kim, Chae, & Baek, 2025);智能体根据谁的立场来权衡该立场(Choi, Zhu, & Li, 2026);看起来像是收敛的大部分实际上分解为社会从众而非推理(Hao et al., 2026)。在联合审议中,一致意见是低能状态,因此在承诺立场之前进行辩论的小组可能会通过讨论自我说服达成共识而非朝向真实。架构上的对抗是程序性的:意见首先以盲目和独立的方式收集,之后才进行比较(图7)。
图7。盲目-独立-优先
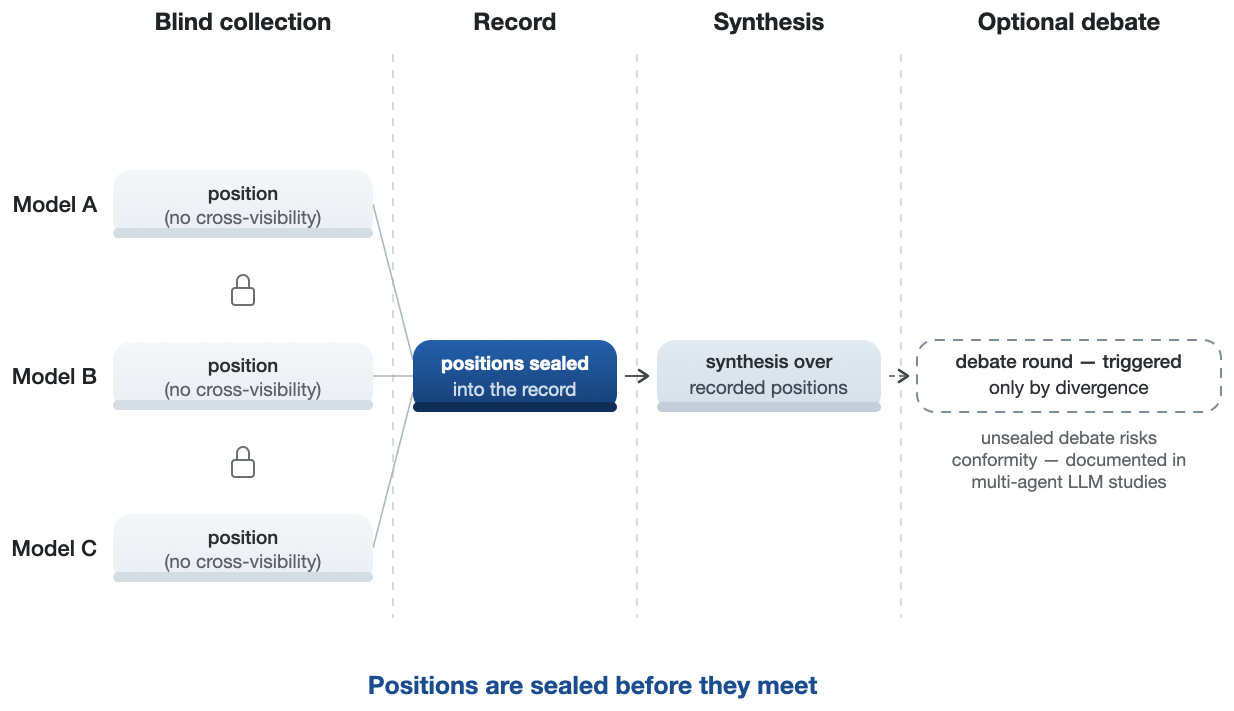
立场首先被记录,随后才被比较——该程序保护的是从众会抹去的分歧。
下面报告的实验量化了该程序防止的情况。在成对的探索性组中,已经盲目地产生了不同答案的验证者随后被展示了主要模型的自信错误答案,并被问及是否同意。38.5%(436对分歧配对中的168对;95% CI 33.6–43.2,问题聚集自助法)放弃了自己的分歧答案并赞同了该错误,供应商级的从众性范围从20%到58%。放弃情况按被放弃内容分层,这区分了从众和理性服从。在那些盲目答案本身是正确的验证者中,29.1%(41/141)仍然为自信的错误答案放弃了它,这是任何贝叶斯账户都无法开脱的有害核心,相比之下,在错误盲目答案中有43.1%(127/295),其中某些服从是可辩护的。(问题聚集区间与朴素配对级别的区间几乎相同。436对分散在247个不同的问题中,每个问题大多一或两对,永不超过四对,因此问题级别的重新采样几乎没有群内协方差可以添加。)纳入下面的镜像对照,大约35–39%的盲目异议者在被展示自信答案时改变立场,无论其真实值如何,对提议答案呈现中等但显著的净倾向(净从众≈4个百分点;不一致配对104对vs. 70对≈1.49)。如果小组在承诺立场之前进行了审议,这些分歧中的很大一部分本来会在被记录之前被重新协商。但由于34.7%的镜像臂翻转朝向真实,审议也会将一些异议转化为正确的共识,因此盲目优先保护的是测量本身,而非对失去分歧的计数。盲目优先是测量分歧和制造共识之间的区别,这是人类群众所需的相同规则:社会影响力在不改善独立估计准确性的情况下削弱了它们的多样性(Lorenz, Rauhut, Schweitzer, & Helbing, 2011),甚至单个任意的早期背书可以可衡量地偏向随后的判断(Muchnik, Aral, & Taylor, 2013)。
反向提示对照针对这些翻转反映理性信念更新而非从众的替代解释。我在六模型本地小组上重复了成对程序,向已经盲目不同意的验证者展示相同问题集的自信错误答案(直接臂)或黄金标准答案(反向臂)。翻转率接近对称,向错误答案38.9%对比朝向正确答案的34.7%,在配对内比较中,验证者为错误答案放弃盲目立场的频率明显高于为正确答案放弃的频率(104对vs. 70对不一致配对;McNemar p = .010)。理性更新预测相反的不对称性。每模型翻转倾向在两臂的从众极端处本质上相同(每模型配对计数较小且样本不足以单独分析;在复制包中以其样本量描述性报告),表明一致性由自信提议答案的存在驱动,而非其真实值。该对照在本地层运行。前沿面板估计(38.5%)基于相同程序但未与前沿验证者进行镜像测试。
盲目收集无法关闭一个渠道:它克服了社会一致性的影响,但克服不了先验一致性的影响。模型汇聚是因为共享的训练数据给它们相同的先验,孪生模型在从未相互协商的情况下给出相似答案。我称之为相似性收敛:一个小组达成一致是因为其成员相似,而不是因为它们是正确的。
相关的先验仍应该被衡量。跨模型惊异分数提供了关于小组实际独立程度的持续估计,问题逐个地,它们是无标签的,因此原则上可以在推断时不借助黄金标准答案而估计独立性。本文未测试生产时间的估计。多样性还必须超越模型权重,因为独立的检索路径、工具验证的检查和确定性验证器破坏了共享训练创建的相关渠道。需求将增长而非缩小,因为蒸馏和合成数据训练随着时间推移使模型权重同质化,因此衡量的多样性预计会衰减,验证负担应转向非模型验证器。以及应该衡量什么应该被披露:记录不仅应该包含"N个模型达成一致",还应该包含小组在这一类问题上的估计多样性。近似克隆之间的共识应该得到较弱的信心主张,记录应该说明消费者得到的是哪一个。
证据。 每个重要的答案都附带一份记录:咨询了哪些模型,它们在哪里同意和不同意,检查了什么,综合建立在什么基础上。时间有利于这一要求,因为当代理人将答案基于检索和工具时,事实基础已经存在于模型之外,因此记录它成为生成答案的副产品。由于记录是篡改可检测的,服务决策的历史可由纠纷中的消费者、审计员、以及确定责任的保险人重放。信任不再是对品牌的感觉,而成为历史的可检验属性。
两个机制将证据从答案扩展到行动。在影子执行下,具有外部效果的行动在记录的演练中进行排练,因此"代理人在行动前检查"成为可验证的声称而不是口号。时间一致性在会话或措辞之间重新提出建议并记录其稳定性,因此答案如果当被问两次时漂移,在任何人依赖之前就会被标记。在身份级别,记录层扩展成代理人本身的便携式出处护照:哪些模型、版本和策略行动,何时,在谁的授权下。这就是"了解你的代理人"注册方案和代理人错误保险承诺所隐含假定的产物。这份记录面向消费者的呈现就是图8的编排收据:一个行动,一份记录,四个受众(消费者、保险人、审计员、监管者)。
图8。 编排收据,售出两次(样机)
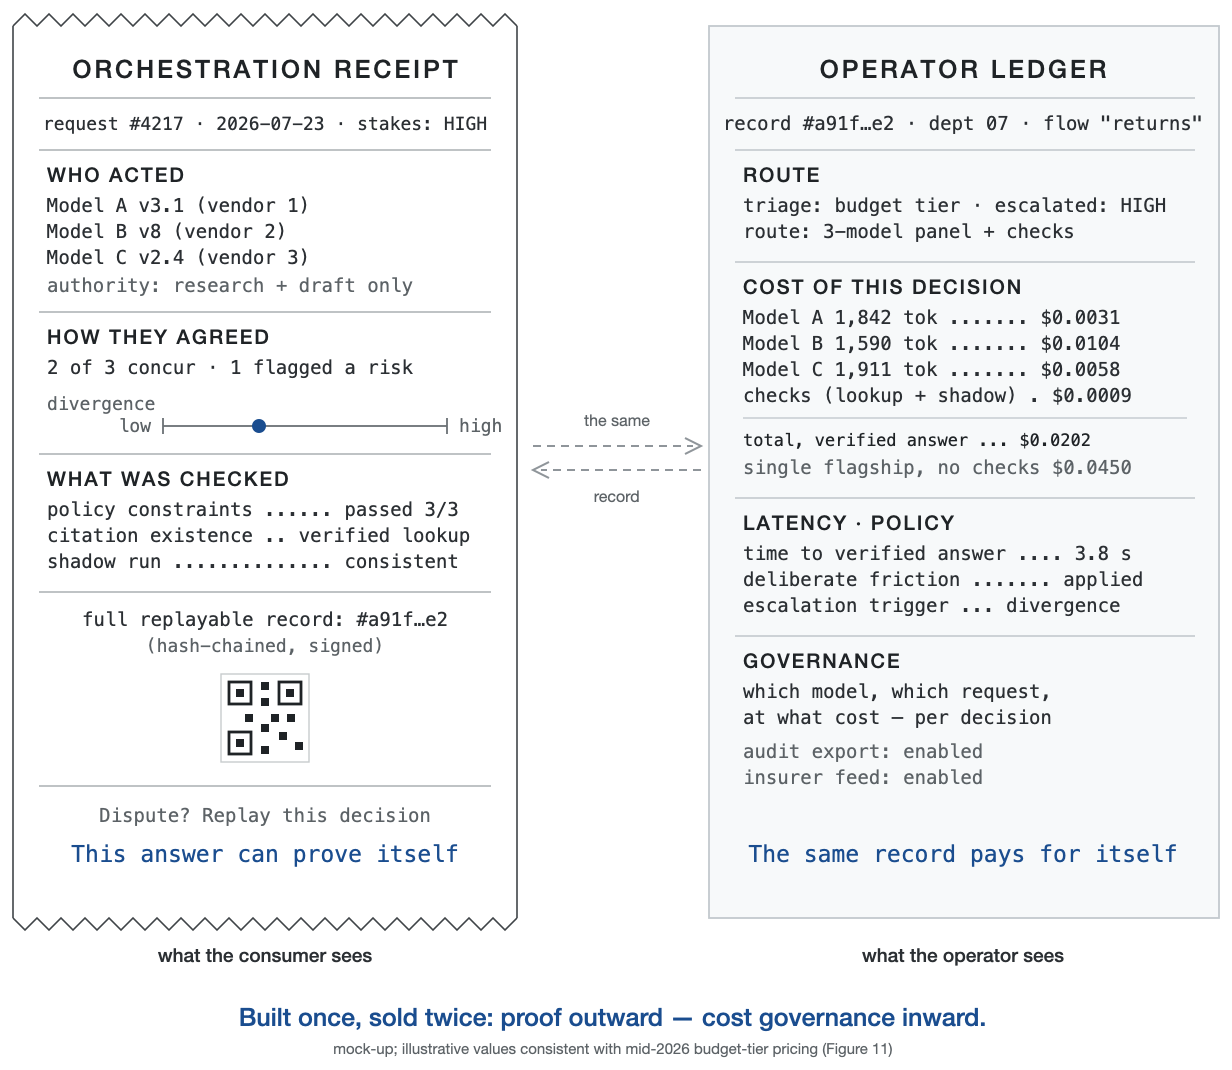
消费者看到证明——谁行动了、他们如何达成一致、检查了什么;运营商将同一份记录视为成本治理。在纠纷中,收据将言辞对言辞的矛盾转变为记录对言辞的证明。
中立性。 中立性是可审计的激励独立性:对任何特定供应商、商户或决策结果不存在未披露的经济依赖。编排层将路由到对任务表现最佳的任何模型,并且对哪一个获胜没有利益关系,在结构上类似于支付中的独立清算层。供应商之间的仲裁者可以获得信任,任何供应商都无法对自身做到这一点。独立性命名经济属性,可审计将其与证据层联系起来,使声称可检验而非仅被声称,这是下面开发的清算所纪律。(这里的中立性是经济属性,不是跨人口统计学群体的算法公平性,后者是一个独立的要求。)
还有垂直整合问题:对于最适合大规模构建编排的平台,中立性在结构上是不可用的。同时充当市场、模型供应商、广告网络和物流提供商的公司无法中立地进行仲裁,因为它做出的每个路由决定都是关于其自身收入的决定。这种情况指向一个结构性倾向。该框架意味着信任层最适合于唯一业务就是仲裁本身的各方,这就是清算、审计和信用评级成为独立产业的道路。评级机构案例同样是对独立中介机构自身产生发行人付费冲突的典范警告。这些经济现象有文献记载:认证中介通过控制披露的信息来获取价值(Lizzeri, 1999),认证市场以有据可查的方式失败(Dranove & Jin, 2010),信用评级崩溃展现了典范失败,即发行人付费收入腐蚀了上一级的认证者,而得以延续的清算层由相互分担的成本资助,而非由被评级的各方资助。因此,中立性要求扩展到编排者自身的收入模式:由其排名的供应商或商户支付的验证层再现了该层存在为了解决的冲突,这就是为什么这里的收入设计转向消费者方面和运营商的成本治理(第5部分),而非被排名的各方。
中立性也有数据维度。编排层可以充当清洁室:请求到达各个供应商时去除用户身份,任何供应商都看不到完整的交互历史,编排者的收入来自服务,而不是来自将用户言语路由到广告网络。中立性是两个方面的激励独立性:对任何模型供应商或商户没有未披露的经济依赖,以及没有通过消费者言语获利而损害消费者的商业模式。
但中立性本身会引发无穷回溯:谁来审计编排者?字面意义上的"无利益关系"是无法实现的。任何编排者都有成本、合作关系、员工保留激励,以及自身的生存融资需求,所以关键变量不是这些的缺失,而是它们的性质、披露程度和从记录中的可审计性。谁付款并不能解决中立性问题;付款者的收入是否独立于交易结果才决定了这一点。消费者订阅,或来自保险公司或审计师的费用(其赔付与哪款产品获胜无关),满足这一条件;商户佣金或广告费则不满足。更广泛的资金层治理问题仍然开放,该构造所解决的是该资金的可审计独立性。编排层本身也有激励:倾向于廉价模型的路由、过度销售其昂贵层级、方便地塑造合成。这种回溯已有四十年历史。Shapiro(1987)将其命名为守护人问题:程序保障产生了新的守护人,这些守护人本身也必须受到保护,而机构答案从那时起就没有改变过。
清算所通过外部可审计性和监管来赢得其信任地位,而不是通过宣称中立性。编排者不拥有中立性作为优点。证据层就是使其可检查的东西。每个路由决策、模型响应和合成步骤都落入防篡改记录中,即一个哈希链式、有签名的日志,旨在进行外部时间戳锚定,因此编排者声称的中立性暴露于它对模型施加的同样验证中。成熟路径是清算所手册的具体化:外部时间戳锚定、开放验证接口和定期第三方审计路由策略。这种审计生态系统的机构设计已经是一个有名的研究计划(Raji, Xu, Honigsberg, & Ho, 2022)。即使对检查者的审计,也存在一个依赖关系:该面板的模型可能彼此独立,但都由被验证的平台选择,这就是为什么成熟路径的端点是面板选择和轮换位于任何单一方控制之外。一个其记录无法被审计的编排者只是另一个要求被相信的供应商。消费者研究之外最接近的邻近项目是两项并发的2026年著作。Marchal et al.(2026)论证了相同的评估转变,从判断输出到架构化代理信任度、来源和可证伪性(在认识基础设施层面),Wang et al.(2026)调查执行来源作为验证、审计和失败归因的流程级问责层。这篇论文本身独有的是面向消费者的、激励感知的组合:三个属性的捆绑,作为消费者在委托商务中有根据的依赖对象,及其行为测试。
证据组件有一个界定,因为防篡改证据容易被过度宣传:哈希链式日志确立了来源和完整性(该记录存在且未被随后更改),而非完整性(任何哈希都不能保证被省略的调用未被压制)、正确性(对错误答案的忠实记录仍然是错误的)、独立性和激励对齐。每个都是一个单独的属性,都有自己的验证机制:覆盖证明、结果审计、可测量的多样性、披露的经济学。收据应仅声称其记录实际具有的属性。还有一个进一步的结构性限制:日志证明了什么被路由,而不是为什么,选择此模型或此商户背后的专有启发式仅在路由策略本身被披露或证明时才可审计,这是治理选择,而不是密码学必然。架构的成本属于同一分类账:将查询路由到多个供应商会增加隐私暴露,集中化决策日志是一个具有吸引力的安全目标,共识显示可以制造出共识-错误结果警告的权威。
该构造也值得与其工程邻近者划分,因为"使用多个模型"描述了几种不同的东西,具有不同的信任属性。简单集合投票改进了准确性,但以不可见的方式解决了分歧,所以没有什么变成可检查的。自洽性采样重新询问同一模型,这仅是表面上的多样性。混合专家在一个单一训练系统中路由,其路由器针对能力而不是中立性进行了优化。多代理辩论(Du et al.,2024)改进了答案,但将审议视为内部机制:没有面向消费者的记录,没有经济学,没有中立性保证。
模型路由聚合器到2026年已成为商品层,虽然在目录中是多供应商,但每个答案只有单一模型:路由器根据成本和延迟选择一个模型,不会收集第二意见。聚合器是验证架构的供应商,而非其替代品。
多模型操作也不再是异国情调:到2025年中期,37%的企业在生产中运行五个或更多模型,比一年前的29%增加了(a16z,2025)。基础设施正在行业规模上铺设,但信任层明显缺失。目前不清楚多模型会保持为不可见的成本路由还是成为可验证的架构。图9对照五个信任属性对这些模式进行了评分,表3用散文形式说明了界定。架构信任完全由这些缺乏的东西定义:异质来源、浮现且被记录的分歧,以及一个无利益关系的仲裁者。工程是共享的;信任属性不是。
图9. 界定
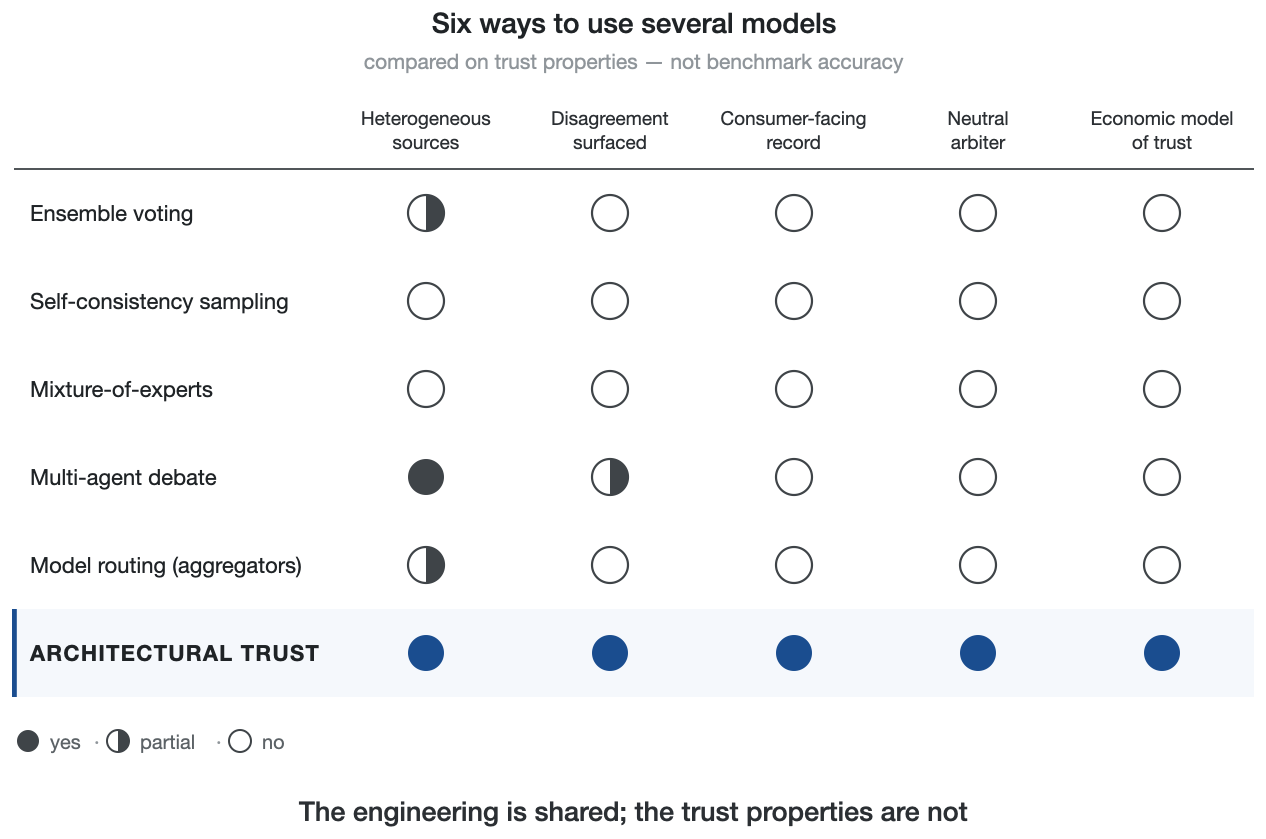
六种多模型工程模式对照五个信任属性的评分。
表3. 界定:架构信任与其工程邻近者的对比
| 方法 | 异质来源 | 浮现的分歧 | 面向消费者的记录 | 激励-独立的仲裁者 | 信任的经济模式 |
| 集合投票 | 部分 | 否(以不可见的方式解决) | 否 | 否 | 否 |
| 自洽性采样 | 否(相同模型重新采样) | 否 | 否 | 否 | 否 |
| 混合专家 | 否(单一训练系统) | 否 | 否 | 否(路由器针对能力优化) | 否 |
| 多代理辩论 | 是 | 仅内部 | 否 | 否 | 否 |
| 可解释性(XAI 覆盖) | 否(单一模型的叙述) | 否 | 否(故事,非记录) | 否 | 否 |
| 透明性 / 披露 | 否 | 否 | 部分(更可见,不可检验) | 否 | 否 |
| 来源 / 血统追踪(ML 管道) | 否(单一管道有文档) | 否 | 部分(面向工程师的血统) | 否 | 否 |
| 验证推理(zkML) | 否(单一模型;其执行的证明) | 否 | 部分(证明工件,非决策记录) | 否 | 否 |
| 模型路由聚合器 | 部分(多供应商目录,每个答案一个模型) | 否 | 否 | 否(路由器针对成本优化) | 否 |
| 架构信任 | 是 | 是(面向消费者) | 是(可回放) | 是(结构性) | 是(分级层次) |
另有两篇基础文献也应列在同一清单上:门控的弃权或触发逻辑属于选择性预测与学习推迟(Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020),而证据组件的审计轨迹源自可问责算法和第三方审计工作(Kroll et al., 2017; Raji et al., 2022)。架构信任是这些的面向消费者、中立性受约束的结合,而非其中任何一个。将其定位于其他补救措施中很重要,因为它们是互补而非竞争的。模型级校准是必要但结构上不充分的:供应商生成并证实它,这是本论文起始的冲突。外部审计和认证是独立的但周期性的,是系统的快照而非决策的快照。解释是在模型内部生成的叙述,能捏造答案的系统也能捏造其背后的故事。透明性暴露更多机制,让消费者自行解释。架构信任既不要求信念也不要求解释,仅要求连续的、按决策进行的、机器可验证的可检验性。它也是使其他补救措施产生效力的东西:对具有可回放记录的协调器的审计是对具体事物的审计,而对不透明管道的审计是一场仪式。其最接近的概念邻居是结构保证和基于机构的信任(McKnight et al., 2002)、过程透明性和可解释性。与之相比,界定特性在于保证可由信任者,按决策进行检验:保证要求一次相信,架构信任要求每次验证。还有两个相邻的概念集应纳入地图。十年前,计算机科学问责文献奠定了技术基础:程序规律性在无需完全透明的情况下可以验证(Kroll et al., 2017)。2025–26 工程浪潮正在直接构建代理信任管道:"信任原生"协议具有可验证身份和防篡改行为记录(TrustTrack; Li, 2025);具有防篡改收据的运行时操作管理(AARM; Errico, 2026);重新框架化为信任估计的多 LLM 聚合(Zheng & Zhang, 2026, arXiv:2607.20529);以及企业框架(Gartner 的 AI TRiSM;云安全联盟的代理零信任工作)。每个在企业层级上提供一个支撑。没有一个提供面向消费者的构造,而这正是本论文声称的贡献:将三个组件置于一个名称下,在行为设计中可联合操作,具有谁以什么风险购买可检验性的经济学。应澄清一处命名冲突。DigiCert 的"AI Trust Architecture"(2026 年 4 月推出)是供应商 PKI 产品线、用于代理身份、模型来源和内容认证的证书基础设施。它在证据堆栈的身份层提供管道基础,而非本文所开发的架构信任构造。
这三者之间的关系是明确的经验假设,而不是概念上的必然性。我假设一种互补作用在任何成分缺失时趋向于零,简记为 AT = f(D, E, N),在任何零点附近陡峭下降,第5章的联合设计旨在恢复函数形式而不是假设它。在可估计的形式中,一个方便的族是柯布-道格拉斯函数,AT = A·Dα·Eβ·N^γ,其中 α, β, γ > 0,编码两个承诺:在任何缺失附近趋向于零,以及正的交叉偏导数(成分是互补的)。构造体是这三个成分及其假设的互补性,以下没有任何命题依赖于柯布-道格拉斯形式。柯布-道格拉斯也是内部近似:严格来说它仍允许从弱成分替代,而互补性假设在边界处类似于列昂惕夫模型,min(D, E, N) 确定下界。这正是为什么下面的设计必须允许非补偿结构而不是假设补偿权衡。柯布-道格拉斯族是说明性的,供未来估计使用,不是构造定义的一部分;当前数据不估计它。阶乘可以逐参数区分柯布-道格拉斯内部与列昂惕夫下界。指数仍然是一个经验问题,这正是重点:互补性是可证伪的。零值需要两个澄清。成分是连续的,不是二进制的,所以字面上的零是理想化的极限。没有已部署的系统,本文的包括在内,在任何轴上恰好位于零或一,消费者是否以近似缺失响应总崩溃或陡峭折扣正是设计必须区分的。多样性就其本身而言意味着 验证路径的独立性,以测量的独立性(误差相关系数 φ,定义如下)作为其单位。统计核心是经典集合理论,其中组合的好处依赖于误差去相关(Hansen & Salamon, 1990; Krogh & Vedelsby, 1995),这就是为什么这里测量独立性而不是假设它。第二个模型是这样一条路径,但独立检索、工具验证查找和确定性验证器也是如此。图5的影子运行和一致性检查计为第二条、最大去相关的验证路径,而不是无多样性的证据。该定义还吸收了最强的明显反例,受规管的支付轨道或完全记录的第三方认证公用事业服务(证据和中立性强,模型多样性零):此类服务要么嵌入非模型验证路径(确定性对账、外部审计,所以根据定义 D > 0),要么将模型限制在确定性检查完全覆盖的角色。其中任务类别确实不存在独立验证路径,该框架预测证明不足,这是联合可以测试的预测。非模型路径计入 D,字面零在生产系统中变得罕见,乘法形式的经验内容从零点转向内部互补性,这就是为什么是阶乘而不是零点,是声明成败之地。对于测试,一个操作承诺在此固定:阶乘将 D 狭义地操纵为模型路径多样性。更广泛的验证路径定义是构造体的范围,不是操纵变量。独立性本身必须被分解,因为六个不同的量在这个词下流通:盲收集(推理时的程序独立性,这种设计保证的),模型族多样性、测量的残留误差相关(本文报告的 φ)、证据来源多样性、工具路径多样性和机构独立性。该研究建立了第一个并测量了第三个;其余的是设计变量,不是此收集可以认证的属性。没有证据的多样性是看不见的委员会。没有中立性的证据是供应商的营销。没有多样性的中立性是空经纪人。表4走过所有八个存在/缺失配置的完整格子。其下的直觉是每个成分为另一个提供 证明:由对其内容有利益关系的方保留的记录作为自我证明、没有人记录的协议是谣言,对单一声音的激励无关套利者没有什么要套利的。这激发了互补性假设。这三者一起改变了消费者信任的内容:不是"这个答案"或"这个品牌",而是"这个流程,而且我可以检查它"。
表4。 证明格子:八种 D–E–N 配置及其在每种配置中保留的内容
| D | E | N | 消费者可以检查什么 | 退化形式 |
| 缺失 | 缺失 | 缺失 | 无;信赖是对输出的信念 | 裸单模型助手 |
| 存在 | 缺失 | 缺失 | 事后无;分歧未被看到 | 看不见的委员会(内部集合) |
| 缺失 | 存在 | 缺失 | 由它保护的方保留的记录 | 供应商日志/自我证明 |
| 缺失 | 缺失 | 存在 | 一个无利益关系的声明,其后无迹象 | 空经纪人 |
| 存在 | 存在 | 缺失 | 被感兴趣方策划的记录分歧 | 供应商运营基准剧场 |
| 存在 | 缺失 | 存在 | 对没有人可以重现的检查的中立套利 | 口碑小组 |
| 缺失 | 存在 | 存在 | 单一未受质疑声音的中立、可重现记录 | 公证独白(无质疑的审计) |
| 存在 | 存在 | 存在 | 由无利益关系方持有的独立检查,可重现 | 架构信任 |
单元格陈述于理想极限;已部署系统占据内部。E+N-without-D 行是机构熟悉的那一行——清算、审计和评级在那里运作——它是该框架对添加独立验证路径的要求的地方,是经验预测而不是定义排除。
这三个要素映射到信任可信度的经典结构(Mayer, Davis, & Schoorman, 1995):多样性是一种能力机制(跨模型一致性校准推断的能力程度),证据将完整性可操作化(关于服务行为的主张变得可验证而非仅仅声称),中立性在结构上解决仁慈性问题(无利害关系的协调者的激励措施是可检查的,而非基于信念)。每一项都以可验证的架构为基础,而不是感知管理——这正是人类-人工智能交互文献在从自身角度达到同一点时所要求的:使信任判断与可验证的信任可信度线索相一致,而非与界面制造的印象相一致(Liao & Sundar, 2022)。
因果链贯穿验证,因为"信任"是结果而非机制:验证 → 校准的信心 → 合理的信任 → 委托 → 交易价值 (Figure 10)。服务通过在关键时刻可被验证来赢得委托,而不是通过感觉可信;Cheng et al. 展示了这种感觉被制造得多么廉价。
Figure 10. 验证飞轮
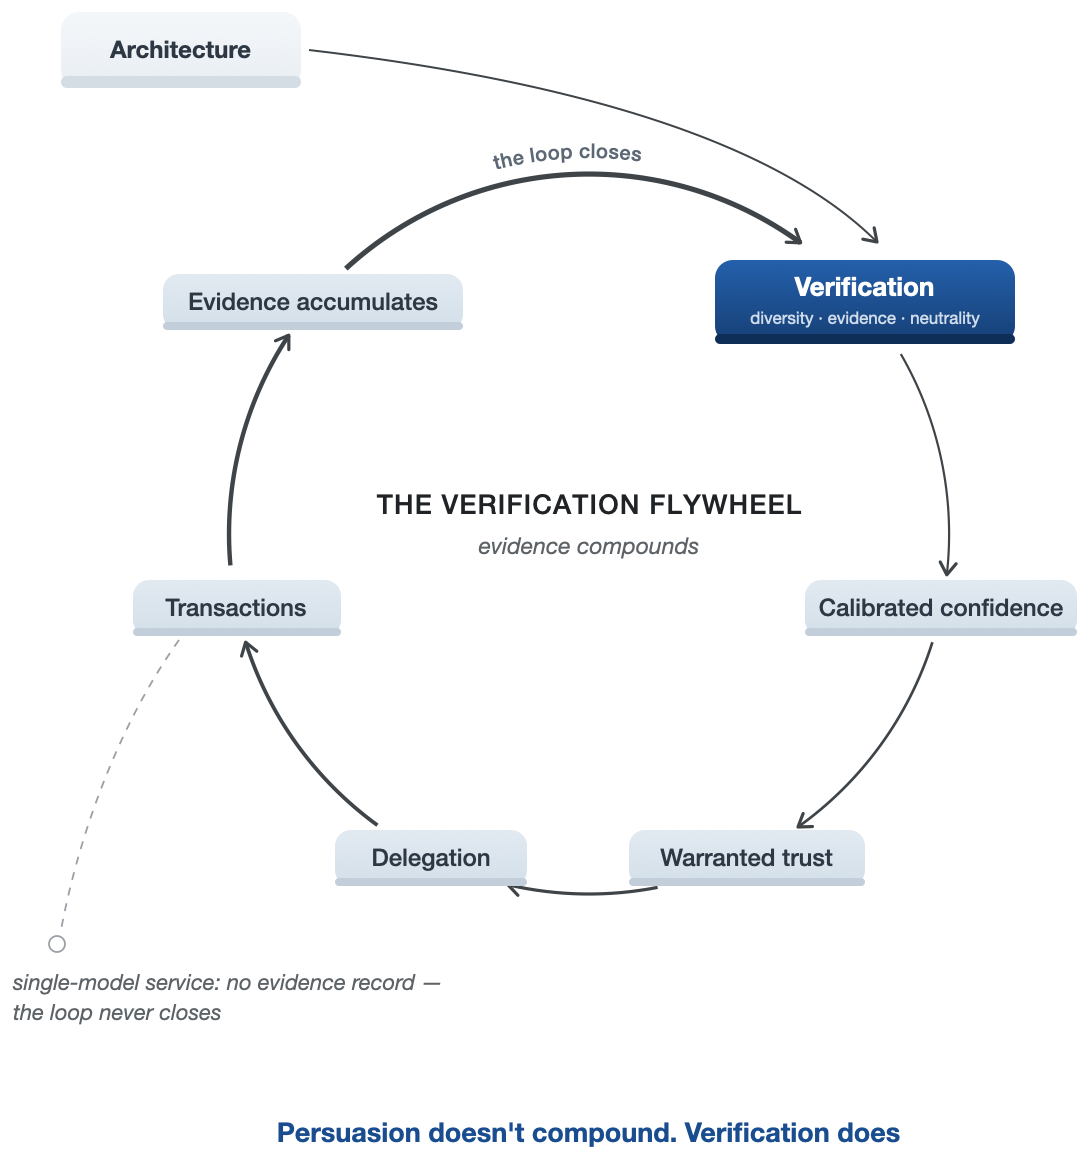
因果链,验证(多样性 · 证据 · 中立性) → 校准的信心 → 合理的信任 → 委托 → 交易,不会终止:交易生成证据,循环回到架构。虚线分流显示单模型服务,其中不存在证据记录,循环永远不会闭合。说服力不会复利增长。验证会。
Table 5. 单模型服务与架构信任比较
| 维度 | 单模型服务 | 架构信任服务 |
| 信任对象 | 模型 / 品牌 | 过程及其记录 |
| 信心 | 由模型声称 | 通过跨模型一致性赢得 |
| 确信的错误 | 从内部无法检测 | 主要检测目标(不一致信号) |
| 谄媚 | 因偏好而得到奖励 | 分离:同情和政策检查在不同的渠道上 |
| 错误检查 | 犯错的同一系统 | 独立模型 + 确定性门控 |
| 决策证据 | 日志(如有),由供应商持有 | 防篡改、可重放、消费者可访问 |
| 质量评判者 | 供应商本身 | 中立编排层 |
| 纠纷立场 | 消费者证言 vs. 平台 | 可重放记录 |
| 可保险性 | 不透明的风险 | 可根据决策历史定价 |
| 责任分配(AB 316 后) | "是AI做的"被排除;权责分配在暗处受争议 | 可从可回放的记录中计算 |
| 监管立场(Art. 50时代) | 事后披露 | 作为运营副产品的透明度 |
| 跨境数据承诺 | 合同表示 | 可审计的运行时属性(司法管辖区感知路由) |
| 成本结构 | 统一、廉价 | 分级的:成本仅在后果集中之处 |
从可验证性到消费者响应。消费者看到的是呈现结果,而非架构:一份收据,显示咨询了哪些独立系统、它们在何处产生分歧,以及分歧如何被解决或上报 (Figure 8)。三种中介感知可能会产生这一效应。证据具有诊断价值:浮现的、具体的分歧以通用免责声明所不具有的方式,对这个答案提供信息 (Detjen et al., 2025; Chen et al., 2026)。可重放的记录提供感知的过程控制,因为消费者可以在事后检查、质疑或上报。程序保证是指盲目收集、独立检查和无利益相关的仲裁者已就位这一认知 (McKnight et al., 2002)。自然的因变量是依赖校准、授权意愿和失败后的保留。自然的调节因素是风险与可逆性、任务客观性 (Castelo et al., 2019) 和消费者专业知识,因为最不能亲自检查答案的消费者从在结构上检查答案的架构中获益最多。下面的命题沿着这条路径进行。
该框架除了产生命题外,还产生消费者研究可以检验的命题,这些是假设而非发现。将其操作化取决于一个区分:客观中立性(协调者实际上不受任何供应商、商户或结果的未披露经济依赖)、可验证中立性(记录使该独立性可被检查)和感知中立性(消费者相信它)是三个变量,一项实验在测量感知的同时操纵可验证信号:
P1. 在重要查询上呈现跨模型分歧改善消费者的依赖校准(当系统一致时更依赖,分歧时更少依赖),相对于单个自信答案,以感知风险作为中介构念(Featherman & Pavlou, 2003)。两个失败方向都存在:联合呈现减少过度依赖但可能增加依赖不足(Lu, Wang, & Yin, 2024),置信度显示比准确性更容易校准依赖(Zhang, Liao, & Bellamy, 2020),解释可以提高依赖而不提高审查(Bansal et al., 2021),认知强制函数以满意度为代价削减过度依赖(Buçinca, Malaya, & Gajos, 2021),一项106个实验的元分析发现人类–AI组合平均表现差于人类或AI单独表现中较好的一个(Vaccaro, Almaatouq, & Malone, 2024)。P1测试校准,不是单调收益:呈现的分歧必须落在击败其最佳成员的少数组合设计中。该命题分为两部分:主要效应是确认性声明,调节变量是探索性的,来自证据的诊断性而非事后列举。校准收益应随赌注和不可逆性增加,以及随任务客观性增加(客观问题上的分歧被读作错误信号;主观问题上被读作品味;Castelo et al., 2019)。消费者专业知识预计产生相反的符号:对于低专业知识消费者,没有解决方案的呈现分歧应减少委托意愿,对于高专业知识消费者应改善依赖校准;交叉点要么被观察到,要么没有,这使得专业知识成为检验而非规避手段。本论文的实验提出了一个设计要求。分歧与任务难度协变(系统一致集中在简单项目上),所以P1设计必须操纵或统计控制难度,否则校准效应与项目易度相混淆。诊断性解释也产生了通用透明度理论未做出的边界预测:分歧披露应在消费者自己的先验最弱的地方最重要,即跨境或不熟悉商家的购买,因为那里的外部诊断证据没有内部参照竞争。
P2. 访问可复核决策记录增加将重要任务委托给AI代理的意愿,超越品牌信任,效应随委托任务的赌注和不可逆性增加。它也随委托代理本身的水平增加,这是信任迁移假设的比较静态内容:保持实际模型性能不变,可验证架构属性对适当委托的边际效应随着消费者放弃更多审查和执行控制而增长(顾问→副驾驶→监督代理→自主代理)。一项跨越委托水平与架构可见性的设计直接测试该假设。最近的消费者研究证据围绕这个因变量:将购买权委托给AI在限制感知自主性的地方减少采用(Ahmad Husairi & Rossi, 2024),高自主性助手的接受是直接研究的结果(Frank et al., 2026)。P2预测记录的效应超越那些既定的前因。
P3. 编排层的感知中立性独立预测委托意愿,与服务评估中的程序公正效应一致(Tax, Brown, & Chandrashekaran, 1998)。操纵变量是可验证的中立性信号;测量变量是它产生的感知。据我所知,编排器中立性在行为实验中从未被操作化,认证印章是最接近的测试类似物(Cetinkaya & Krämer, 2024),所以P3引入了新的实验变量。从方向上讲,随着消费者检查内容能力的下降,中立性效应应该增强,因为当结果质量难以判断时,过程线索承载评估权重。操纵必须将可验证的中立性与中立性声明分开:一个条件包含收据,其无利益证明实际上可以打开和检查,对比条件是仅带标签的相同界面,对两者进行感知中立性的操纵检查。没有这种对比,P3崩溃为通用程序公平性,对验证无法做出任何说明。
P4. 代理出错后,其服务产生可检查记录的消费者显示较小的信任崩溃和更高的保留率,比不透明服务的消费者:一次失败就出局的动态由证据调节。这是服务恢复研究确定的机制,其中程序公正、基于证据的投诉处理在失败后恢复信任(Tax et al., 1998)。信任修复研究补充说,恢复信任取决于违规的性质和提供的解释(Kim, Ferrin, Cooper, & Dirks, 2004),人机研究现在将其作为自主系统的设计问题处理(de Visser, Pak, & Shaw, 2018),缓冲应随失败的严重性和不可逆性增长。P4预测:记录→较小的信任崩溃和更高的保留率,由失败严重性调节。记录显示过程本身未被遵循的情况由操纵检查处理并排除在测试之外,因为该命题涉及尽管遵循了过程仍然发生的失败。持久性比较必须控制转换成本和锁定,这些混淆了保留,伴随设计测试遵循过程的记录是否将责任归属从服务转移到环境。该命题不包含反转条款,所以没有结果模式在构造上是不可证伪的。
经验锚:置信层作为测试的组件。 如果服务声称其置信信号意味着什么,该声明可以接受检验。本论文案例研究中部署的置信层经过了预注册、安慰剂对照的六臂评估,跨越两个独立的模型族。系统自身弱点的量化刻画改善了其错误预测,相对于安慰剂的AUROC增益约为+0.07,在两个模型族上的置信区间不重叠。虚假的自身刻画将错误预测崩溃到抛硬币,"意识到自身局限性"的通用指令毫无作用。
两个较早的版本失败了,一个因混淆变量被其作者伪造,一个呈阴性,这发生在预注册设计得到确认之前。更严格的重新测试在缩小的范围内未得出结论,针对一个前沿家族的预注册四级阶梯未通过任何确认终点,效应的方向仅在四个阶级中的三个上进行了探索性存活。因此该声明是针对单个家族且有界的:所测得的自我知识在确认的地方改进了错误预测,但这不是每个模型类别的既定属性。弱点概况在生产中也运行,其中它调整实时模型路由,受限且故障开放。虚假概况的崩溃既是一项安全发现:制造的自我模型是一个攻击向量,这是自我知识需要架构保管而不是模型自我报告的又一个原因。设计逻辑具有比技术更古老的消费者研究血统。预承诺(通过外部结构约束未来行为,因为内部决心不期望能够维持)正是消费者如何控制自身不良习惯的方式(Wertenbroch, 1998),架构信任将相同的策略扩展到机器。
完整的过程(协议、预注册、原始数据、伪造的试点、阴性迭代、未确认的扩展)作为独立档案保存,与论文的 OSF 材料一起公开提供,网址为 https://osf.io/jtvu9/(文件 `self-calibration-archive.zip`)。校准置信是具有可测量内容的架构组件,它可能失败。失败与成功一起存档,因为一个信任层的置信度声明从未经过实验验证的挑战,恰好要求它应该替代的盲目信任。一篇三十位作者的立场文件给这种劳动分工以正式陈述:代理编排应该是贝叶斯一致的(Papamarkou et al., 2026),校准的信念应该在控制层中,而不是在模型中。
测试机制:预注册实验。上述声明是可测试的,本节报告测试。本节中的每个实验结果,在两个波次中,都涉及框架的技术前件,即独立同意是否传达了模型自我报告不具有的正确性信号,在事实问题上。这些实验不证明消费者信任、委派或商业行为,这些仍然是 P1–P5 和第 6 节行为研究的范畴。协议在任何确认数据存在之前公开冻结(OSF:https://osf.io/4y9dv,已注册 2026 年 7 月 23 日;假设 H1–H6,基准子样本由种子和 SHA-256 哈希固定,不利于假设的结果被预先声明)。设计刻意简单。十六个模型,来自九个前沿供应商(Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral)和七个本地开放权重模型,各盲目回答相同的 1,500 个 SimpleQA 问题一次,不进行检索或使用工具。这是最大化相关参数误差暴露的制度,这是信号的一个刻意困难案例,生态成本见限制中的说明。答案在温度零处给出,陈述 0–100 置信度:用言语表达的不确定性,在同一响应中以文字形式引出,而非从 logits 读取,这是 Lin、Hilton 和 Evans (2022) 展示的模型能学会校准的格式。面板是该单一 24,000 个名义答案插槽集合的分析组合,其中 22,598 个已交付,一个本地模型 (deepseek-r1:8b) 在预承诺的停止规则下于 98 个项目处停止。六个注册假设映射到结果如下。H1,跨模型分歧标记了大多数置信误差,得到支持:同意在注册波次中提升正确性 1.9–3.2×(表 6),在旗舰波次中冻结门移除了 82.1% 的置信失败(表 10)。H2,面板信号击败应答模型自身的置信度,在 CN 前沿和跨集团面板上成立(ΔAUROC +0.287 和 +0.063),在 US 前沿面板上反转。H3,置信误差的非平凡份额作为对一个错误答案的一致同意而存在,得到支持:开放式问题的 0.5–2.2% 和多选臂的 4.0–7.9%。H4(a),块内错误相关性超过跨块,不得到支持(φ 差异 +0.011,95% CI −0.005 到 +0.028),H4(b),跨块面板捕获更多,也不得到支持,跨块领先较小。H5,$0 本地面板标记大多数前沿置信误差,不得到支持:本地层的同意信号处于随机水平。H6,血统距离阶梯,这里未作为阶梯测试;其块级步骤是 H4(a) 零值。
事实验证是代理商务的相关代理,因为在执行时刻,委派购买分解为事实子声明:项目的当前价格和可用性、退货政策的条款、产品规格是否符合消费者的陈述要求、卖方的身份和评级。每一个都有与 SimpleQA 项相同的可验证基本真理。不同意门在这个事实基质上运作,而偏好权重(哪些权衡重要以及多少)仍然由消费者掌控,消费者制定了要检查事实的要求。这种劳动分工也是为什么第 6 节设计操纵验证的显示而不是参与者的偏好:架构的声明关乎委派决定的事实层,而非其品味层。当判断完全没有事实基质时,在没有基本真理验证的真正主观选择中,前件停止进行,限制将该边界陈述为开放问题。
基准的选择已被衡量。在2021年版本的TruthfulQA(存在于预训练语料库中)上,相同的供应商在SimpleQA上的得分高47–61个百分点(例如89% vs 28%),这一差距与基准年龄和接触效应一致,尽管这种设计无法将数据污染与基准难度和构建差异区分开。因此,没有标题数字基于较旧的基准。评分是客观的字符串匹配,未解决的情况仅由本地开放权重模型(Qwen3-8B,本地运行;复制包中的等价性专用提示;从不由任何小组成员的家人;SimpleQA是否出现在评判者的训练语料库中是未知的,但评判者仲裁两个提供的字符串之间的等价性,而不是真值,这限制了接触程度)和50项人类抽查(98%一致)根据与黄金标准的等价性进行判决,这是规模上的限制。现在通过分层的300项跨族系审计来扩展这一点(不同的模型族系作为审计员,种子固定样本):96%一致(288/300),所有12个分歧都是宽松的假阳性(9个明确,3个边界),单向偏差影响了大约3%的所有评分答案(占评判者解决部分的4%)。三分之二的判决(66.5%)来自本地模型评分器而不是精确字符串匹配,标题对评分器错误具有鲁棒性:翻转随机10%的模型评分判决会将认证比率移动至多±0.5×,并且永不改变它们的方向。
两个设计选择是深思熟虑的,而不是预算驱动的。首先使用了供应商的中层以确保生态有效性:现在代表消费者进行交易的代理绝大多数运行在这些成本优化的层,可从公开价目表检查(2026年中期;图11)。典型的服务交换在预算层上花费几分之一美分到约一美分,相对于旗舰权重上的五到十美分,没有任何服务处理数百万个会话会以旗舰速率为其默认路径定价。名单反映了市场:九供应商小组包含所有三个供应商,它们共同占据88%的企业LLM API支出,表6的美国前沿小组正是那三个。反对意见认为这是企业证据,消费者完全不在其中,这种理解将供应链关系颠倒了。消费者不再选择模型:他们选择银行、零售商、航空公司,而服务的路由策略选择模型。在消费者实际被服务的货币中,即令牌而不是美元,图景确认了这一选择(图12):在OpenRouter–a16z对100万亿令牌路由流量的研究中,开放权重模型达到了大约三分之一的所有使用(Aubakirova et al., 2026),三个最大消费AI产品的默认层都位于旗舰层下方,只有约3%的消费AI用户为高级服务付费(Menlo Ventures, 2025c),因此边际消费者必须以接近零的边际成本得到服务。在API市场下方是一层设备端和自托管开放权重,对支出调查不可见,实验的本地层七个开放权重模型故意对其进行采样。在市场可以计数的每种货币中,本研究采样的层是为消费者服务的层。(在第一方中断后,集合的一部分通过聚合器完成,实际的服务基础设施在运行清单中按调用记录。)
图11。 消费者在结账时遇到的层级
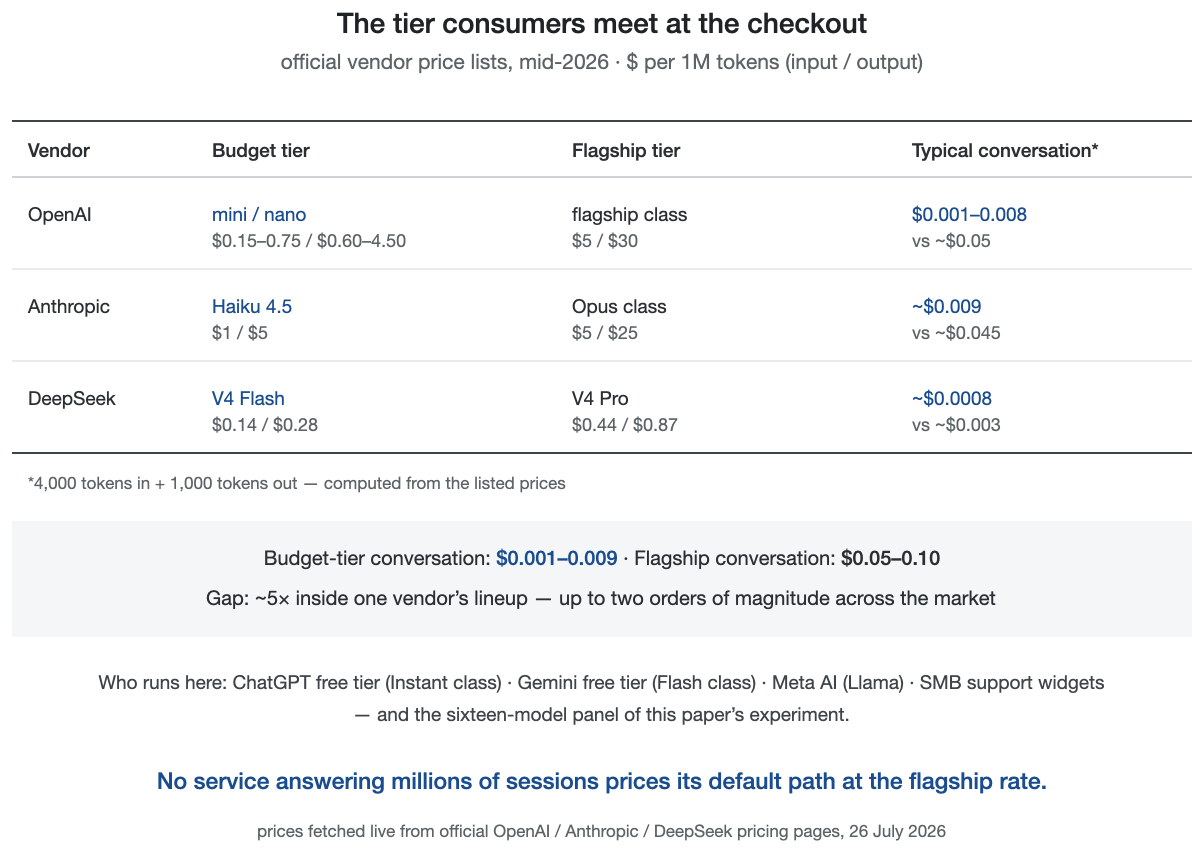
官方供应商价目表,2026年中期。
图12。 模型市场的两种货币
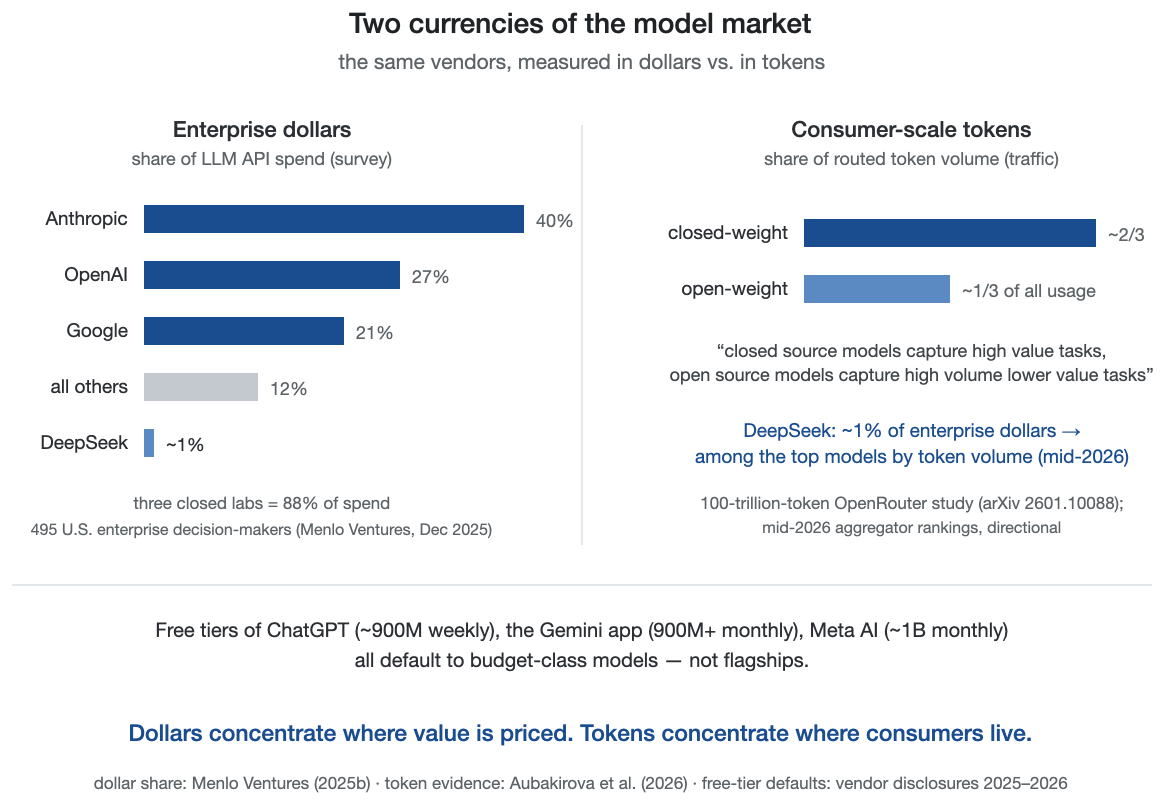
企业美元 vs. 消费者规模令牌。
中层也适合论文的声称,这些声称涉及体系结构,而不是旗舰能力:只有使用高级权重才出现的效果将是模型特定的结果。管道在商用基础设施上可复现,API支出不足$15。对于一篇论证验证必须足够便宜以在每个重要答案上运行的论文,验证论文本身的成本是证据的一部分。管道是一个独立的复制包(运行器、评分器、分析脚本、原始评分数据和运行清单),对作者的研究系统没有要求。集合总计24,000个答案,包括基准污染和一致性部分大约30,000个。关于可用性:公共预注册(osf.io/4y9dv)存档了种子固定的1,500项子样本。完整包在https://osf.io/jtvu9/公开可获取,是注册源项目的公共组件(文件夹`replication-package-v2`)。
三个结果支撑这一部分。首先,原始材料很丰富:中位陈述置信度在九个前沿供应商中的七个处为85–95,两个例外(中位数42和60)正是置信度具有区别性的供应商,而实际准确度范围从10%到66%,在1,500个问题上,每个前沿供应商产生289–1,212个置信错误(在≥75置信度时错误)。作为正确性信号,模型自身的置信度根据供应商的不同得分AUROC为0.53–0.79,消费者无法从外部知道他们得到了哪个供应商。供应商的这种差异符合消费者实际得到服务的层级,证实了前沿实验室的发现,即大型模型在受控格式下的自评估中往往经过良好校准(Kadavath et al., 2022):一些部署的供应商提供该自知识,其他供应商提供置信噪声,表面上什么都无法区别它们。
其次,关键发现:验证的作用是认证,而非警报。从概率意义上说的认证,是一个大约49–77%的后验概率(具体取决于小组),而非保证。对于这样困难的问题,朴素信号"某位评委不同意"是饱和的:它在85–94%的有把握的错误和91–95%的有把握的正确答案上都会触发(预注册预期了这种重新表述,转向预先指定的AUROC端点)。更有信息量的方向是相反的:正确答案被独立复制,错误答案分散。至少一名独立评委复制过的答案在集团内小组上72–77%的时间内是正确的,在跨集团小组上是49%,相比之下没有复制的情况下是18–37%。具有独立一致性的答案大约是正确的两到三倍可能(跨表6的三个小组为1.9–3.2倍)。(这里及以后,"独立"意味着盲目地和单独地生成,残差相关性被测量而非假定,正确性总是根据基准的黄金标签进行评分,而非根据另一模型的意见。)估计量是关联性的,而非因果性的:复制标记了更可能正确的答案,它标记的一部分是问题很容易,这是一个选择效应,下面进行了量化。作为正确性信号,小组一致性在其成员自有置信度携带最少信号的小组上达到AUROC 0.832(每个供应商0.53–0.62;汇总0.545)。成立的主张是分布式的而非特征式的:在所有84个三供应商小组中,一致性AUROC的中位数为0.79,在89%的情况下超过汇总自报。一致性在跨集团小组上达到0.722,相比之下汇总自我置信度为0.659(跨供应商汇总非标准化的语言量表会扭曲自报,因为供应商对0–100量表的使用方式不同,且人工制品的方向是依赖于小组的,这就是为什么每个供应商的值被打印在旁边)。该领先的跨集团实例是编码相关的(替代的预冻结一致性编码将跨集团小组的一致性信号放在0.544–0.722,慷慨的未解决即一致变体低于该小组的0.659汇总自信,而CN小组的信号在相同编码中跨越0.719–0.894,总是高于0.545),因此编码稳健的小组优于自我的结果是集团内CN案例。自报清楚地超过小组信号的唯一小组(0.842对0.697)是包含研究中最具区分力供应商的小组(Anthropic的中层产品,在完整1,500项收集中的自信AUROC 0.788),排名靠前的供应商的自有信号单独超越了其自有小组的一致性信号。表7打印每个小组的值,在每个小组的项目总体内计算。配对聚类自助法(问题带替换重新采样,每个问题的所有三个(项目、主要)单位一起移动;B = 2,000)在表6/7对比上放置置信区间。在CN前沿小组上,小组一致性通过ΔAUROC = +0.287(95% CI [+0.265; +0.308],p < .001)超过汇总自我置信度。在跨集团小组上,优势较小但可靠,+0.063([+0.037; +0.087],p < .001)。在美国前沿小组上,方向反转,反转本身在统计上是明确的:自我置信度0.842对小组一致性0.697。因此,小组组成是信号价值的一阶调节因子,部署规则如下:在相信一致性优于它之前,测量小组成员的自有校准,ΔAUROC = −0.145([−0.170; −0.120],p < .001)。所有三个对比都是显著的,小组间的异质性是一个发现,而非噪音。因此,美国案例被报告为已确认的反转,而非零区间,它界定了这个构念:在从市场的区分端中抽取的小组上,自我置信度作为排名信号优于一致性,因此多样性组件的区分价值取决于小组组成,而非普遍成立。架构可以在暴露的模型置信度区分能力较弱的地方提供外部正确性信号,并审计在做出校准声明的地方的该声明。一个边界保持不变:即使是完全校准的模型也不能公证其自有历史或仲裁其自有利益冲突,因此随着供应商区分能力的改进,多样性的角色从正确性发现转向校准审计,而证据和中立进行了任何校准都无法进行的工作。
架构验证在供应商未能交付可用的置信度信号的地方供应外部正确性信号,而识别哪个供应商交付了一个信号无论如何都需要架构。替换声明,精确范围,基于校准指标而非AUROC。七月波次中没有供应商同时具有区分能力和良好校准;xAI最接近(表7a),旗舰波次再现了该分离的校准方面,因此即使是碰巧收到排名最好的置信度的消费者也不能将其水平兑现为概率,而不需要外部参考。这就是架构层提供的。如果供应商最终在各地交付良好的校准,证据和中立不受影响。这个论证在模型改进的世界中仍然成立。
第三,失败模式有一个形状:认证的共识错误,即每位评委都自信地收敛到同一个错误答案,在0.5–2.2%的开放形式问题中出现,但在一个配套分支中是4.0–7.9%,该分支在本地层上以多选形式重新提出项目(项目构造和输出在复制包中)。共识主要在答案空间受限的地方认证错误,这对于为代理提供选项菜单的任何界面都是一个设计警告。
零值与正值同样具有指导意义,我将其作为预注册内容发布。地缘政治集团(包括同一集团内的面板共享训练语料库和蒸馏血统的可能性)无法预测该基准测试上的错误关联(前沿层内部与跨集团φ差异+0.011,95% CI −0.005至+0.028;在本地层上略微反转)。能力驱动关联,而非标签,呼应Kim et al. (2025)。血统无法预测检测率:本地模型验证自己的前沿同级模型的表现与任何陌生模型相同,推理蒸馏模型与自己的基础权重的错误关联最少(φ = 0.135)。两者都是有界零值,而非已证明的等价性。集团区间排除了大于+0.028的φ差异,该界限而非拒绝失败进行推理工作。自然连续扩展由复制数据支持,即将认证提升估计为测量面板多样性(惊喜分数φ)的函数,而非面板身份的函数。这将为模型面板重新运行分类器集合文献对其自身多样性统计运行的程序,该程序发现没有单一度量能清晰预测集合收益(Kuncheva & Whitaker, 2003)。
廉价的本地模型根本无法在开放形式问题上认证前沿答案(无论有无其同意,精度均为46%):验证者必须对任务类别具备能力,然后其独立性才有价值。边界条件如下:共识在答案空间受限处认证错误,独立性必须被测量而非假定,验证者能力控制认证价值。在实践中,多样性是逐个问题需要测量的属性,而非从品牌、集团或家系中假定。表6总结了面板指标。图13并排展示了认证提升和信号比较。
图13. 精度幻觉及其架构解决方案
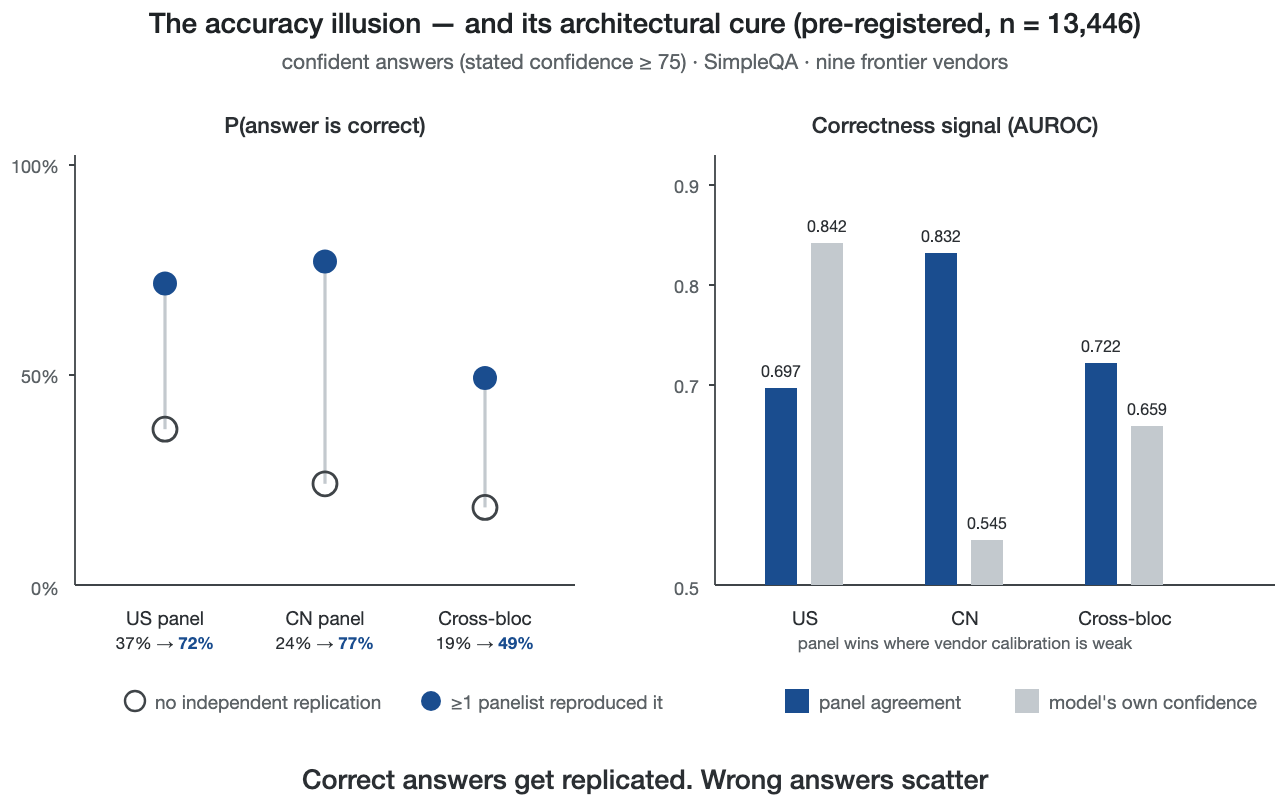
通过独立复制进行认证(预注册;n = 13,446个评分答案——九个前沿供应商,每个供应商回答同一1,500个SimpleQA问题一次,减去54个失败或无法评分的调用)。
并发工作强化了谨慎:大规模审计发现高自一致性与推理基准上的错误答案共同出现,其中仅有同意而无独立性和盲收集是弱且状态相关的信号(Ding, 2026)。因此,我将独立、盲复制视为认证单位。
表6. 置信错误拦截和面板认证(SimpleQA,确认性;conf ≥ 75)
| 面板 | 置信错误(n) | 错误上的标记率 [95% CI] | 正确答案上的假警报 | P(正确 | ≥1同意) | P(正确 | 无) | AUROC:同意对比自身置信度 |
| US-frontier (Anthropic·OpenAI·Google) | 1,630 | 94.3% [93.1–95.3] | 91.0% | 71.8% | 37.1% | 0.697 vs 0.842 |
| CN-frontier (DeepSeek·Alibaba·Moonshot) | 2,128 | 85.5% [83.9–86.9] | 94.8% | 77.0% | 24.1% | 0.832 vs 0.545 |
| Cross-bloc (Anthropic·DeepSeek·Mistral) | 2,432 | 89.4% [88.1–90.6] | 93.4% | 49.3% | 18.5% | 0.722 vs 0.659 |
标记 = ≥1个面板成员的独立答案与主要答案非等价(拒绝和零重叠答案计为非一致;更严格的编码在复制包中)。60/90处的阈值敏感性不改变任何结论。自身置信度AUROC是在面板完整答案群体上汇总的陈述置信度;汇总吸收了供应商间的精度和置信度尺度差异,因此可能超过每个成员的个人值(按供应商值见表7)。答案按问题聚类;问题级别聚类引导大约将区间扩展1.6倍,不改变任何结论。此表和表7中的每个AUROC都可通过复制包脚本compute_panel_vs_own_auroc.py(Mann–Whitney带平局校正)用一个命令和无随机性确定性地复制。
表7. 按面板的自身置信度AUROC:汇总面板群体和按供应商(与表6相同的群体)
| 面板 | 汇总自身置信度AUROC | 按供应商自身置信度AUROC |
| US-frontier | 0.842 | Anthropic 0.784 · OpenAI 0.596 · Google 0.746 |
| CN-frontier | 0.545 | DeepSeek 0.569 · Alibaba 0.532 · Moonshot 0.620 |
| Cross-bloc | 0.659 | Anthropic 0.787 · DeepSeek 0.570 · Mistral 0.584 |
由复制包中的确定性管道计算。两种总体惯例并存并明确打印以避免表观不一致:表的按供应商值在每个面板的项目总体内计算,而文本中的单数引用使用全集值——最佳判别供应商在美国前沿面板内为0.784对比全1500项集合上的0.788,对于OpenAI为0.596对比0.598(两对都从同一管道的一个命令重现)。相比之下,合并列混淆了供应商基础率——供应商间准确度和置信度量表的差异做了一部分工作,所以合并值不一定在按供应商范围内(实时重新计算:美国前沿合并0.842超过每个成员的个值,中国前沿合并0.545低于该面板的按供应商宏平均值0.574);按供应商值是可解释的量。按供应商分布是消费者问题以数值形式表述:可用判别在一个供应商处存在,在其他供应商处接近机会,答案外部没有说明是哪个供应商生成的。第3节供应商范围背后的源值,从同一分级集合按模型打印(中位数说明置信度·准确度·全集自有置信度AUROC):前沿——Alibaba 95 · 47.4% · 0.532;Anthropic 42 · 10.3% · 0.788;DeepSeek 90 · 35.7% · 0.570;Google 95 · 66.5% · 0.746;Mistral 90 · 16.5% · 0.584;Moonshot 85 · 51.6% · 0.619;OpenAI 85 · 16.7% · 0.598;xAI 60 · 37.9% · 0.777;Zhipu 95 · 28.4% · 0.611——85–95频段下的两个中位数属于两个置信度携带可用信号的供应商;本地层级(仅进入难度分层和本地层级空值)——gemma4:e4b 90 · 5.2% · 0.541;glm4:9b 85 · 5.0% · 0.589;llama3.2:3b 100 · 5.3% · 0.494;mistral:7b 95 · 6.3% · 0.506;phi4-mini 95 · 5.5% · 0.505;qwen3:8b 95 · 5.9% · 0.504;deepseek-r1:8b 90 · 9.2% · 0.696(n = 98,预承诺停止规则)。
AUROC衡量判别性,即供应商说明的置信度是否将其正确答案排在不正确答案之上,而ECE、Brier分数和置信度–准确度差衡量校准,即说明的数字是否可被解读为概率,在这些数据中两者显著分离。该研究判别力最强的七月供应商Anthropic的中等层级(自有置信度AUROC 0.788)在水平上仍然严重校准不当:平均说明置信度41.3(中位数42)对比10.3%准确度,过度置信差+31.0点,ECE 0.311(15个箱),Brier 0.206,可靠性项0.126对比不可约不确定性底线0.093。相反,该面板中最差的校准与接近机会的判别共存(Mistral:差+74.2点,ECE 0.742,AUROC 0.584),只有xAI同时接近判别和校准(ECE 0.111,AUROC 0.777)。即使在那里判别也得到了均匀低说明置信度的帮助,而对于其他八个七月供应商两个特性显著分离。相同的分离在旗舰层级持续存在:11个八月旗舰中的9个携带+12.5到+71.4点的过度置信差(ECE 0.125–0.714),而两个例外(gpt-5.6-sol,ECE 0.031;claude-fable-5,ECE 0.043)在准确度范围的相反端点实现校准。持有排名靠前但数值虚高的置信度分数的消费者在没有外部参考的情况下无法将其作为可靠信息使用。表7a在判别指标旁边列出校准指标。
表7a。判别与校准对比,七月波(全集、已解决;ECE使用15个箱;差=平均说明置信度−准确度,百分点)
| 供应商 | n | AUROC(自有置信度) | ECE | Brier | 置信度−准确度差 | 平均置信度→准确度 |
| Alibaba | 1,497 | 0.532 | 0.448 | 0.446 | +44.8 pp | 92.3 → 47.4% |
| Anthropic | 1,500 | 0.788 | 0.311 | 0.206 | +31.0 pp | 41.3 → 10.3% |
| DeepSeek | 1,500 | 0.570 | 0.536 | 0.513 | +53.4 pp | 89.1 → 35.7% |
| 1,461 | 0.746 | 0.263 | 0.271 | +26.3 pp | 92.8 → 66.5% | |
| Mistral | 1,495 | 0.584 | 0.742 | 0.686 | +74.2 pp | 90.6 → 16.5% |
| Moonshot | 1,500 | 0.619 | 0.242 | 0.292 | +24.2 pp | 75.8 → 51.6% |
| OpenAI | 1,500 | 0.598 | 0.610 | 0.531 | +60.9 pp | 77.6 → 16.7% |
| xAI | 1,500 | 0.777 | 0.111 | 0.197 | +11.1 pp | 48.9 → 37.9% |
| Zhipu | 1,493 | 0.611 | 0.642 | 0.612 | +64.2 pp | 92.6 → 28.4% |
| 美国前沿面板、合并单位 | 4,383 | 0.842 | 0.393 | 0.336 | +39.3 pp | — |
| 中国前沿面板、合并单位 | 4,491 | 0.545 | 0.408 | 0.417 | +40.8 pp | — |
| 跨阵营面板、合并单位 | 4,485 | 0.659 | 0.529 | 0.469 | +52.9 pp | — |
与全集AUROC和表6–7相同的总体(面板行:合并(项目、主要)单位);根据冻结协议拒绝被评分为错误。Brier根据Murphy恒等式(可靠性−分辨率+不确定性)在相同15个箱上分解,每行残差<0.001。一个旗舰层级注释伴随两个校准例外:gpt-5.6-sol的ECE 0.031在95.4%准确度下获得,其中Murphy不确定性项、基础率设定的底线为0.044——校准部分由携带表9污染警告的基础率(61.6%逐字黄金字符串匹配)购得。
一项选择效应必须伴随该表格:复制在某种程度上是问题易度的指标。按问题难度分层(其他十五个模型的平均准确度),原始认证提升由较简单的层级承载(2.7–4.6×),在倒数第二难的五分位数上低于1×,在这个集合内的测量下在最难的五分位数上消失。这种分层在某种程度上是内生的,而下文中的外生重新估计将反演软化为单调衰减。稳健性分析直接解决了选择关切(探索性的,未预注册的):在具有主模型固定效应的问题聚类逻辑斯谛回归模型中,控制主模型自身的置信度和项目难度(排除主模型的所有十六个模型的平均准确度),每个额外同意的评审员仍然使正确的几率乘以大约五倍(pooled b = +1.65,每位评审员,95% CI [+1.49, +1.81],p < 10⁻⁸⁸;在每个评审小组中都为正),并将同意添加到难度加置信度基线上可将保留的AUROC从0.859提高到0.898,并将布赖尔分数从0.139降低到0.116(按问题的二折交叉验证分割)。同一模型探测了边界,分层本身需要谨慎:在集合内难度测量下,条件系数在最难的五分位数上变为负(b = −0.41,p = .011),但该测量包括评审小组自身的成员。条件模型有一个部署警告:其难度特征需要标签,因此它是诊断性的,而不是可部署的,而可部署的过滤器是同意门本身。另外三项检查解决了估计和选择关切,都在冻结的确定性协议编码下进行(复制包报告的更严格的分支与法官裁定的标题数字并排)。用项目聚类自举重新采样重新估计认证提升,聚类按照难度结构的需求,使每个评审小组的认证提升区间远高于1(在此确定性编码下的点提升2.4–4.5,其认证的同意较少,相比之下发表的1.9–3.2×标题基于法官裁定的配对编码;自举下界2.2–4.1)。上述报告的84个评审小组的分布使美国前沿小组(自报表现最优)成为例外而非常规(中位数优势+0.14,同意AUROC的四分位距0.76–0.82)。难度分层的AUROC在外生难度测量下明确了边界:在最简单的五分位数上为0.87,在最难的五分位数上下降到0.61,衰减而非反演。该测量是排除小组的(每个小组外的十三个模型),用它重新估计可以解决反演:条件同意系数在所有五分位数上保持正数,包括最难的(最难五分位数 b = +0.97,p < 10⁻⁷;最难层级的独立复制答案有28%正确,而非0%)。因此集合内的反演部分是难度测量的假象。在任一测量下幸存的是单调衰减,同意在问题最难的地方最弱,以及已认证共识错误的现实;脚本和输出在复制包中。因此标题比率是对异质人口的平均。信号主张基于AUROC端点,而非比率。
该实验的假设将我所操作的研究部署具体化:盲集合镜像其委员会机制,评审小组的成员组成在研究设计之前就作为其生产配置存在。这是本研究计划中的第二项预注册研究。第三项即第6节消费者实验已完成并已报告,第四项(生产流量上的现场遥测)已起草。复制包可供任何人在商用硬件上针对公共API运行。
第二波次在旗舰层级:十一个实验室——十个完整分支和一个部分分支——一个校准护城河。上述实验抽样了实际为消费者提供服务的成本优化层级。所要检验的质疑是:也许准确度错觉是预算层级的假象,而旗舰级(各供应商推出的最佳模型)的校准质量已足够完善,以至于基于它们的架构是冗余的。第二个收集波次(2026年8月)在市场顶端对这一质疑进行了检验。
我评估了来自跨越美国、中国和欧洲的十个主要人工智能实验室的各一个旗舰模型。选择这些实验室是为了涵盖这三个地区的领先商业和开源生态系统。对于每个实验室,我选择了在评估波次进行时其最具能力的通常可用的模型。随后,我根据2026年8月5日的公共排行榜验证了这一覆盖范围(LMArena Elo、Artificial Analysis Intelligence Index、Humanity's Last Exam和SWE-bench Verified):十个旗舰中有八个在至少一个通用能力排行榜上位列顶层或接近顶层,而两个(Mistral、Baidu)为了保留实验室和地区覆盖而非基于排名考虑而纳入(见下文的覆盖局限)。第十一个实验室Meta,其旗舰仅在波次范围确定后才变得可达,在波次进行中期被纳入;其数据采集因访问权限撤销而中断,报告为部分结果(见下文)。
表8。评估的旗舰模型和排行榜位置(截至2026年8月5日)
| 实验室 | 旗舰模型(API编号) | 国家 | 排行榜位置(2026年8月5日) |
| OpenAI | gpt-5.6-sol | USA | AA Index #3 (58.9); LiveBench #1 (82.4); Arena top-6 cluster |
| Anthropic | claude-fable-5 | USA | Arena #1 (~1525 Elo); AA Index #2 (59.9); SWE-bench Verified #1 (95.0) |
| gemini-3.1-pro-preview | USA | SWE-bench Verified #8 (80.6); HLE #17 (51.4); Arena upper cluster | |
| xAI | grok-4.5 | USA | AA Index #8 (53.8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | China | SWE-bench Verified #8 (80.6, Pro-Max); HLE #23 (48.2) |
| Alibaba | qwen-max (Qwen 3.7 Max) | China | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80.4) |
| Moonshot AI | kimi-k3 | China | AA Index #4 (57.1); HLE #9 (56.0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | China | AA Index #13 (51.1); HLE #11 (54.7) |
| Mistral | mistral-medium-3.5 | France | 通用排行榜前50名之外;为区域覆盖而纳入 |
| Baidu | ernie-4.5-vl-424b | 中国 | 通用排名前30名之外(ERNIE 5.0: HLE #36);ERNIE 5.1: LMArena Search Arena #4 |
| Meta(中期加入,部分) | muse-spark-1.1 | 美国 | HLE #4 |
括号中的分数是聚合器在快照日期报告的值;排行榜排名在聚合器和快照日期之间略有不同。快照源与复制包附带的运行记录一起存档。
该协议是第一项实验的,已冻结并重复使用:相同的1,500项SimpleQA子样本(由种子和哈希值固定),每个模型进行一次盲目通过,温度零,相同的系统提示和答案解析器,每个答案的既定0–100置信度。评分是确定性的(与金标准的精确和规范化字符串匹配;拒绝评为错误;未解决的项目排除在标题外,在敏感性分析中重新评为错误),没有LLM判断涉及标题数字。这是相对于第一波的有意收紧,其评分者是混合的:客观字符串匹配加本地开放权重判断解决其余部分(66.5%的裁决由模型发出;50项人工抽查,98%一致)。这一波仅使用确定性等价性引擎(手动验证:20个被标记的分歧中的20个和15个一致中的15个由手工确认),所以这一波的每个标题数字都从发布的脚本中逐位再现。绝对准确性的波间比较因此也跨越评分者体系,每一个七月对八月的比较都带有评分者体系的限定符。波内审计支持每一波的数字,但波间差异将模型变化与评分者变化混为一谈,除非将单个评分者重新应用于两个冻结的响应集,这里尚未完成。一个工作偏差:OpenAI的臂在界面的默认推理工作(中等)处收集,而七月协议使用最小值,在推理处没有网络或工具访问(通过列举暴露给模型的工具(没有)来验证)。这改变了该供应商的绝对准确性,而不是一致性机制(第5部分)。一个自信失败是以既定置信度≥80提供的错误答案;阈值在运行前固定,70和90报告为敏感性。联合覆盖是十一个实验室中十个的1,500/1,500个问题。Meta的收集在访问被撤销之前达到了272个有效答案。
我还直接测试了跨体系关切。用第二波的冻结确定性引擎对七月十六模型波重新评分(该引擎用本地开放权重评分者替换了裁决66.5%的混合管道)改变了2.65%的解决裁决(21,338中的566;引擎进一步弃权4.1%),没有移动标题:在单个确定性编码下,认证提升在重新评分前读取3.6×/4.6×/4.4×,之后读取3.0–3.1×/4.5–4.6×/4.3×。两者都高于保守发布的1.9–3.2×,该值来自LLM仲裁对编码,因为更多认证一致意味着更保守的提升。表6–7中的每个AUROC在CN和跨集团面板上最多移动0.016,在美国面板上移动0.046,保留每个面板的一致性与自报告置信度的排序。
旗舰标签不保证任何东西。在十一个旗舰产品中,相同问题的解决准确度从11.4%跨越到95.4%(表9),市场顶端的84点差距,比第一项实验的中层差距更宽。准确性幻觉在这个层级保持完整:在十个完整的实验室臂中汇总,46.6%的所有以既定置信度≥80提供的已解决答案是错误的(10,540中的4,910;包括部分Meta臂,46.3%,或10,665中的4,935;未解决的项目在此排除,在敏感性中重新评为错误,汇总图景保持不变)。第一波面向消费者的含义不会因价格而软化:旗舰徽章不会告诉消费者他们面前的自信答案来自95%准确的旗舰还是11%准确的旗舰。
表9。旗舰波:覆盖范围和准确度(SimpleQA子样本,n = 每个实验室1,500,温度0)
| 实验室(旗舰) | 覆盖范围 | 准确度(已解决) | 未解决 |
| OpenAI gpt-5.6-sol | 1,500/1,500 | 95.4% (1,403/1,471) | 29 |
| Google gemini-3.1-pro | 1,500/1,500 | 71.1% (837/1,178)¹ | 46 |
| Anthropic claude-fable-5 | 1,500/1,500 | 70.3% (1,019/1,450) | 50 |
| Meta muse-spark-1.1(部分) | 272/1,500 有效 | 61.4% (148/241)² | 10 |
| xAI grok-4.5 | 1,500/1,500 | 54.8% (794/1,448) | 52 |
| DeepSeek deepseek-v4-pro | 1,500/1,500 | 46.6% (666/1,428) | 72 |
| Moonshot kimi-k3 | 1,500/1,500 | 45.5% (645/1,418) | 82 |
| Zhipu glm-5.2 | 1,500/1,500 | 30.2% (430/1,425) | 69 |
| Baidu ernie-4.5-vl-424b | 1,500/1,500 | 28.9% (411/1,421) | 71 |
| Mistral mistral-medium-3.5 | 1,500/1,500 | 21.4% (306/1,429) | 71 |
| Alibaba qwen-max | 1,500/1,500 | 11.4% (164/1,435) | 65 |
¹ Google的渠道在18.4%的项目上返回空响应或经过筛选的响应(1,500个中的276个——一个交付属性,而非覆盖缺口:所有1,500个都被尝试过);准确率是基于解析的、已解决的答案计算的。报告了两种定义:仅回答的情况下,Google的准确率为71.1%(837/1,178);将276个未交付的响应计为错误,准确率为57.6%(837/1,454),未解决项目也被计为错误时为55.8%(837/1,500)。²Meta的准确率是基于访问撤销前收集的答案计算的;参见覆盖限制。表中的准确率仅为已解决的;在未解决计为错误的敏感性下,最高数字OpenAI的95.4%变为93.5%(1,403/1,500)。每次调用的渠道来源对每个实验室都记录在运行清单中。未解决的计数是指已交付但未以确定性方式解决的答案;对于Zhipu(交付了1,494个答案)、Baidu(1,492个)和部分Meta部门(251个),这两列的总和因此少于尝试的问题数量,其余为未交付的响应。
污染警告限定了绝对准确率。本轮重用了原始的、公开发布的SimpleQA基准(2024年10月)来评估其发布后训练语料库更新了长达两年的模型,因此在表顶部的训练时间内暴露于基准本身是合理的,数据承载了这一具体特征:最高评分的旗舰模型在61.6%的项目上逐字再现黄金答案字符串(规范化的精确匹配,精确到小数点格式),而其他实验室为27.9–45.3%,中位数的陈述置信度为99。该设计无法区分"模型更强"和"模型已看到基准及其答案键"。因此,本轮的绝对准确率数字不与早期模型代次报告的历史闭卷上限相可比,不应被解读为参数记忆的度量。第一轮的基准年龄检查(第3部分报告的TruthfulQA–SimpleQA差距)涵盖了7月收集;到2026年8月,SimpleQA本身是一个两年前的公开基准,该警告涵盖旗舰轮。本轮的结论不依赖于绝对准确率。它们依赖于自信失败的结构、其在陈述置信度≥80时的普遍性以及其被分歧门拦截的情况,在一个冻结的协议下在轮内测量,其中任何暴露优势在评估相同项目的实验室之间共享。在研究窗口后构建的全新两跳探针直接确认了这一特征。参见本节后面的"为什么不简单地使用最佳模型?"
校准护城河。第一个实验表明,独立一致性承载了自报置信度所没有的正确性信号。旗舰轮将该信号转化为一个测量的过滤器。其机制是一个分歧门:三个实验室的委员会,从先前的分歧分析中提前固定,不拟合这些结果(Moonshot kimi-k3、DeepSeek deepseek-v4-pro、OpenAI gpt-5.6-sol),以及一个没有自由参数的规则。答案仅在三个委员会答案两两一致时才通过门。因为没有任何东西被估计,不需要训练/测试分割;门在冻结收集上计算一次。
图17。 旗舰门
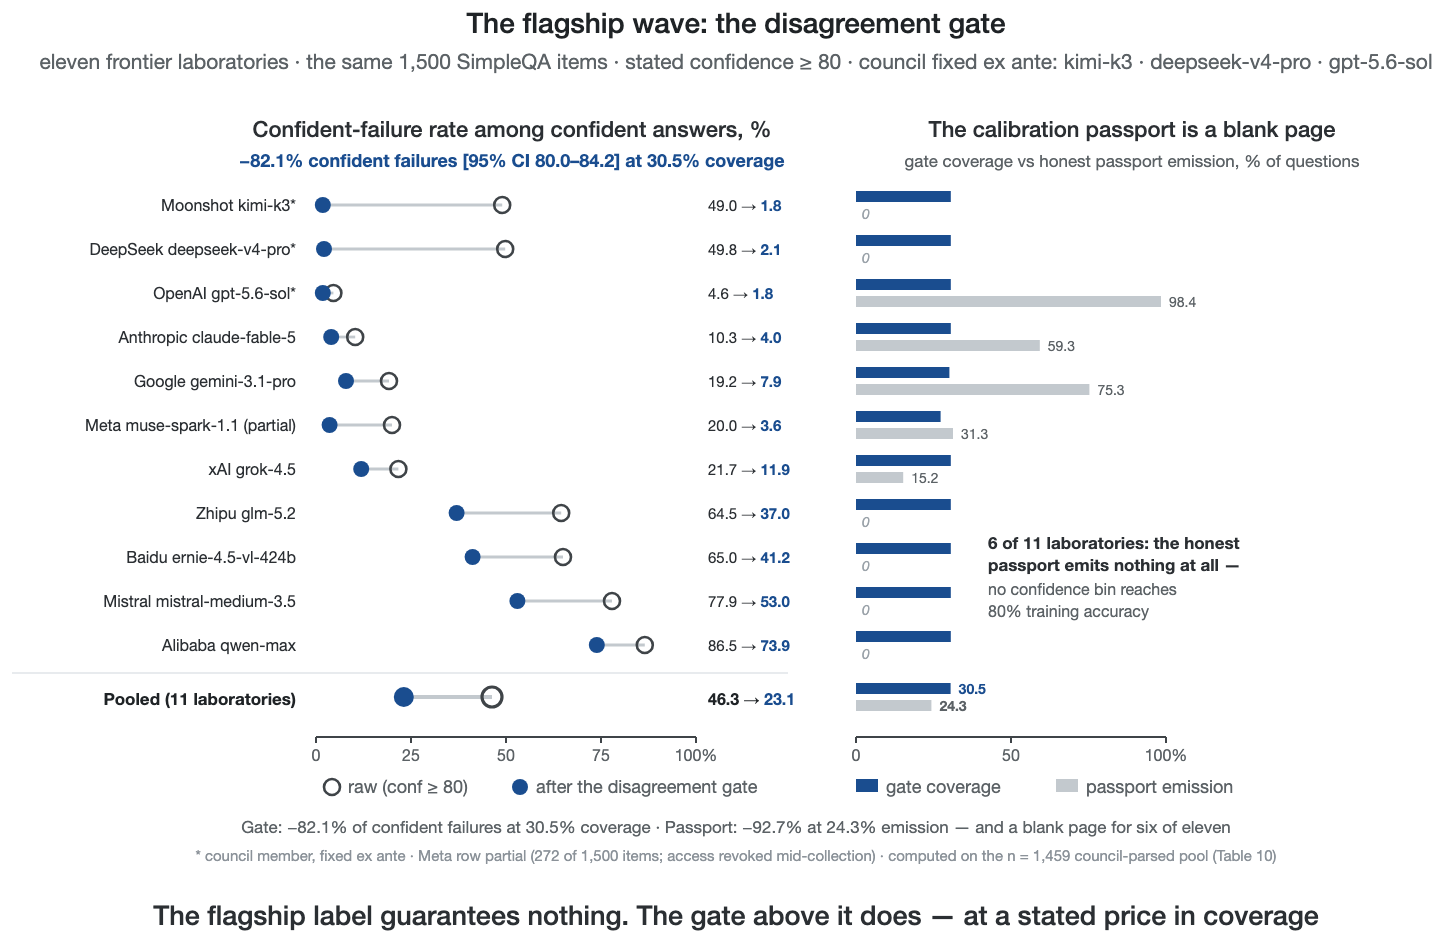
陈述置信度≥80的自信失败及其被固定三模型分歧门的拦截情况,按实验室分组(2026年8月轮)。
在十个完整的实验室部门(主要呈现,部分Meta部门单独报告,其纳入被视为敏感性分析)中汇总,原始自信失败率为46.6%(4,910/10,540)。在十一个实验室名单中汇总,各实验室的比率不同(表9),因此这个数字表征了前沿名单而非普遍常数。该门移除了82.1%的自信失败(自举95% CI [79.9; 84.1]),同时保留了30.5%的所有汇总答案(门本身在30.6%的问题上打开,446个答案中的1,459个)。仅限于委员会外的完整实验室,不涉及任何自参考,该门仍然移除76.9%的自信失败(CI [74.3; 79.2])。包含部分Meta部门后,每个估计都基本保持不变:在所有十一个部门中汇总,原始比率为46.3%(4,935/10,665;35.8%的自信答案通过门,自信答案之间的正确率从53.7%原始值上升到76.9%门后值),该门移除82.1%(CI [80.0; 84.2]),覆盖率相同为30.5%,八个非委员会部门的数字为77.0%(CI [74.4; 79.3])。表10给出了各实验室的数字。
表10。 自信失败拦截由分歧门(conf ≥80;确定性评分器;委员会 = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol,提前固定)
| 实验室 | 自信答案 | 自信失败,原始值 | 门后(发出率) | dCF |
| Moonshot kimi-k3 [委员会] | 1,056 | 517 (49.0%) | 7 (1.8%) | −98.6% |
| DeepSeek deepseek-v4-pro [委员会] | 1,274 | 634 (49.8%) | 9 (2.1%) | −98.6% |
| OpenAI gpt-5.6-sol [委员会] | 1,426 | 65 (4.6%) | 8 (1.8%) | −87.7% |
| Anthropic claude-fable-5 | 825 | 85 (10.3%) | 15 (4.0%) | −82.4% |
| Google gemini-3.1-pro | 966 | 185 (19.2%) | 27 (7.9%) | −85.4% |
| Meta muse-spark-1.1 (部分) | 125 | 25 (20.0%) | 2 (3.6%) | −92.0% |
| xAI grok-4.5 | 577 | 125 (21.7%) | 36 (11.9%) | −71.2% |
| Zhipu glm-5.2 | 1,128 | 727 (64.5%) | 146 (37.0%) | −79.9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65.0%) | 107 (41.2%) | −77.3% |
| Mistral mistral-medium-3.5 | 1,354 | 1,055 (77.9%) | 224 (53.0%) | −78.8% |
| Alibaba qwen-max | 1,209 | 1,046 (86.5%) | 300 (73.9%) | −71.3% |
| 汇总(11个实验室) | 10,665 | 4,935 (46.3%) | 881 (23.1%) | −82.1% [80.0; 84.2] |
| 汇总(8个非委员会) | 6,909 | 3,719 (53.8%) | 857 (33.5%) | −77.0% [74.4; 79.3] |
基于所有三名委员会成员生成的已解析、未拒绝答案的问题池进行计算(n = 1,459 of 1,500);网关在其中的446个问题上打开(30.6%)。Meta行不完整(访问权限在收集中途被撤销)。Bootstrap CIs: 5,000 问题级别的重新采样。
三件事与该标题相伴。网关还会丢弃大约一半的有信心的正确答案(网关仅保留51.3%的有信心的正确答案;在它过滤掉的答案中,大约41%实际上是正确的)。这是用覆盖率换取确定性的权衡,选择性分类的标准风险-覆盖率权衡(Geifman & El-Yaniv, 2017),在此于架构层执行,这两个数字应该始终成对引用:−82.1%的有信心失败配合30.5%的覆盖率。该系统有自己的下限。在完全系统模式中,其中打开的网关发出委员会的共识答案而非单个模型的答案,系统自身的有信心失败率为1.8%(442个已解决共识答案中的8个),这8个问题是整个委员会一致同意同一错误答案的问题。这是第一个实验从其共识认证错误边界条件预测的相关错误下限:在它之下,任何数量的一致性检查都无法帮助,因为一致性本身就是错误。结果在预先声明的灵敏度网格中保持平稳:置信度阈值70/80/90给出池化dCF为−83.1%/−82.1%/−80.6%,将未解决项目重新评分为错误给出−81.8%,所以该数字是测量得出的,而非精选的。
30.5%覆盖率数字在商业上的含义由第5部分的盈亏平衡经济学(图14)决定:网关拒绝认证的大约70%的答案是被路由到比有信心的错误更廉价命运的请求(升级给人工评审、更深层次的验证层或明确显示不确定性),而非失去的转化,所以覆盖率成本是可保险的错误代价,而非放弃的需求。此处不估计升级渠道的成本模型。工作点非固定。图19中描绘的一致性阶梯提供一个阈值族,服务应该位于未被发现的有信心失败的预期成本与网关扣留的流量边际相交的位置,这使其成为基于成本的选择。
图14。渐进信任的经济学
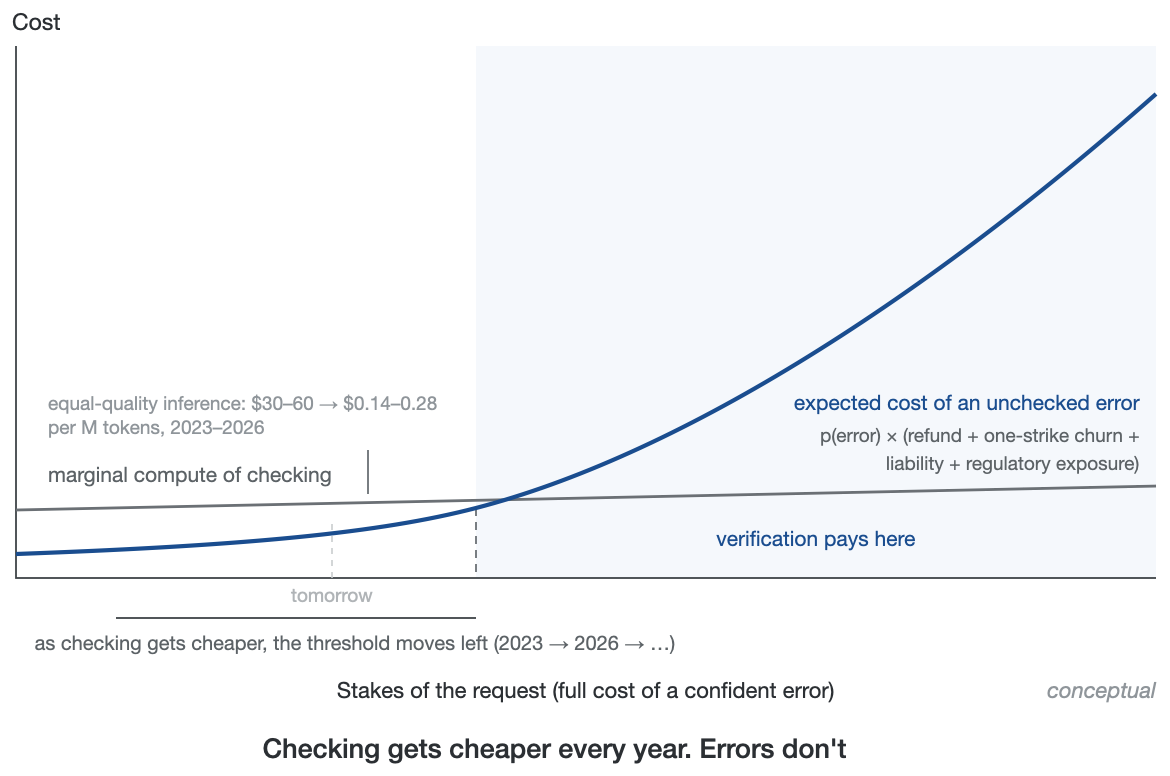
验证的盈亏平衡逻辑。
为何不干脆使用最佳模型?该波留下的最强基线是商业性而非统计性的:操作员可以跳过架构,将所有内容路由到该波最准确的旗舰模型。该基线需要一个带数字的答案。在2026年中期价格下,冻结的三实验室委员会的成本为每个问题$0.0039,少于该波最昂贵旗舰(claude-fable-5, $0.0198/question at list)的单个答案,多于其最准确的(gpt-5.6-sol, $0.0027/question at published API rates)。"只需购买最佳旗舰"是真正的帕累托点:gpt-5.6-sol单独回答每个问题的有信心失败率为4.6%,没有任何门控配置能以任何价格匹配其覆盖率。只要服务能容忍大约二十个答案中有一个有信心失败并需要完全覆盖,旗舰模型在两轴上都获胜。然而即使在排行榜顶端,该规则的泛化能力也很差:该波的另一个共识前沿者claude-fable-5单独的有信心失败率为10.3%。"只需使用任何基准测试排名最高的模型"在样本中第二强大的模型上彻底失效,这也是为何下述的识别问题并非假设。四个考虑因素限定了该比较。
首先,识别问题:了解哪个模型当前最佳本身是外部、跨模型测量的产物。该波自身的表8从公共排行榜中选择其旗舰,这些是持续的、第三方的、跨供应商的比较,没人建议用供应商自我报告取而代之。本文自身的数据表明了为何没人这样做:陈述的自信心根据供应商在AUROC 0.53–0.79处判别,84个百分点的准确度差距将所有作为其实验室最佳而出售的模型区分开。"路由至最佳模型"因此是架构信任的应用,而非其替代品:为旗舰加冕的排行榜是独立小组、盲项和已发布记录,第3部分的三个要素在市场规模运作。那顶王冠在移动:企业模型领导权在单个春季更换了(Kharazian, 2026),模型在稳定名称下无声更新,代理购买行为在模型更新中大幅重组(Allouah et al., 2026)。没有持续外部测量,"最佳模型"作为知识不可用于操作者。
其次,95.4%部分是内存而非能力:顶级旗舰在61.6%的项上逐字再现黄金答案字符串(表9的污染警告),所以其测量优势在基准不可能教会的问题上被压缩。网关机制不继承该脆弱性:在最不可能被记忆的分层上,它移除89.4%的有信心失败,这是其最佳性能而非最差(下述污染分层重新分析),因为独立训练实验室间的一致性不受任何一个供应商训练语料库的制约。
为将可转移知识与基准暴露分离,我组成一个新的、保证未污染的100项两跳探针,机器生成于2026年8月6日,来自独立验证的pre-2023 Wikidata事实对(例如"[小型建筑]的建筑师在哪一年出生?"),每个都有单一计算答案,所以组合的问题字符串不可能出现在任何训练语料库。该集合的SHA-256在第一次模型调用前被冻结。
在该波的冻结协议下(逐字系统提示、温度 0、相同的确定性评分器),gpt-5.6-sol 在 SimpleQA 上从 95.4% 准确率和 4.6% 确信失败率崩溃至 33.0% [自举 95% CI 24.0–42.0],其 61.0% [51.0–70.0] 的项目存在确信失败(其确信答案的 67.0%),其平均陈述信心基本未变(98.4 → 93.7),而 claude-fable-5 保持在 76.0% [67.0–84.0] 和 6.0% [2.0–11.0]。该波的 25 点旗舰差距在保证未见的组合上变为 43 点赤字。委员会门槛从该波保持不变,吸收了这一失败:它移除了 gpt-5.6-sol 的 61 个确信失败中除一个以外的全部(60/61;在 n = 61 时点率不精确,Wilson 95% CI ≈ 91–99.7%;24.2% 覆盖;claude-fable-5:6 → 1),将通过的高置信度答案中的发出确信失败率从原始的 67.0% 降至 4.5%。
不同基准之间的数值不可直接比较:两跳组合本质上比单跳检索更困难,在 n = 100 时区间很宽。但模型顺序的反转和门槛在任何模型都不可能记住的项目上的持久性正是污染假说预测的特征,它们是建筑信任层(而非更好的模型选择)被构建来吸收的失败模式。
第三,存在一个下限。门槛达到了任何单一模型在任何价格下都达不到的确信失败率:委员会门槛配置将发出答案的确信失败率降至 1.8–2.1%,每个问题 $0.0039–0.0046,比最佳单独率低 2.5×,而该波中最昂贵的旗舰在每个问题 $0.0198 处坐在 10.3% 的确信失败率,在各个维度都处于劣势。门槛不是对弱模型的救援装置:qwen-max 在相同门槛后仍在其 73.9% 的发出确信答案上自信失败,所以前沿的门槛点是强模型的委员会,而非对弱模型的门槛。
第四,当代理自主花费金钱时,运作问题从"哪个模型更聪明"转变为"哪种配置可以证明它所做的"。无论准确度如何,单独的旗舰无法公证其自身决定或仲裁其自身的利益冲突。门槛配置为每个答案产生一份可检查的同意记录。这正是第 5 节所述的保险市场已定价的内容,其中覆盖范围根据证据而制定,排除条款则根据其缺乏而形成。
解决方案是一个前沿,而非赢家。旗舰是委员会的最强成员(冻结委员会包括它),但它不能充当自己的法官。识别它的排行榜已经建立在建筑信任所采用的相同原则之上,即独立跨模型验证,但它仅在总体层面提供该验证,关于模型总体,而非关于消费者面前的答案。该构造填补了这一差距,而该差距也限制了它:没有独立检查支持的主张不属于建筑信任,而非其实例。操作者的真实选择在风险等级之间:完全覆盖且 4.6% 确信失败率,或 31% 覆盖且 1.8% 确信失败率加审计追踪,选择分类权衡,在此定价。完整的 26 配置成本–覆盖–风险前沿(每个单独旗舰、每个门槛配置和汇聚同意阶梯,每个点的账单价与列表价对比标记)作为 CSV 与复制包一起发布。
不同意门槛的明显竞争对手是单模型校准修复:学习每个模型的置信度-准确度映射,且仅在映射准确度达到门槛处发出,其标准补救措施为温度和 Platt 缩放的事后重新校准程序(Guo、Pleiss、Sun 和 Weinberger,2017)。在不相交的两个半部分上拟合(直方图分箱置信度,在偶数索引问题上训练,在奇数索引问题上评估,少于 20 个观察的箱不发出),此校准护照移除了 92.7% 的确信失败,但在 24.3% 的发出率处,且 11 个旗舰中的 6 个根本不发出任何东西:它们没有置信度箱达到 80% 的训练准确度,所以那些模型的护照是空白页。对于半数旗舰市场,单模型校准无法从外部修复。不同意门槛对表中的每个模型大致保持 30% 的覆盖,包括护照所放弃的 6 个。所以第一个实验的结论也适用于此层级:当模型的暴露置信度无法充当正确性信号时,建筑可以提供外部正确性信号,在消费者被告知最值得信任的层级处再次测量。
门槛效应的鲁棒性。两项重要的检查:循环性(门槛是否仅依赖于其最强成员),以及简单方法是否能做同样的工作。将委员会的最强成员(gpt-5.6-sol,95.4% 的准确度)替换为该波的第四个事前前沿运行(grok-4.5)本质上没有改变结果。不包含 sol 的委员会在 29.7% 的覆盖处移除了 81.2% 的汇聚确信失败(非委员会目标:77.6%),而冻结三元组在 30.5% 处为 82.1%,且在所有 165 个可能的三模型委员会中机制从不失败:每个委员会在其自己的覆盖处移除的确信失败数比随机弃权更多(中位数超出 +8.5 点),其中事前三元组在该边际处处于前 4%(+12.6 点)。该效应源于跨模型同意,而非任何单一成员的准确度。将每个模型自身的陈述置信度阈值化为相同的逐模型覆盖(平凡基线),仅移除了 66.7% 的汇聚确信失败,少于在相同覆盖处盲随机弃权移除的 69.5%,因为确信失败在构造上集中在高陈述置信度处。该阈值也保持了少于门槛的确信正确答案(46.4% 对比 51.3%)。门槛对所有 11 个实验室中的每一个都 Pareto 主导两个基线。使用仅与最强模型的逐答案同意作为过滤器是一个更强的筛选(在 40.7% 覆盖处移除了 97.1% 的汇聚确信失败,保留 97.0% 的确信正确答案),但这是一个机械不同的、目标条件化的规则。它仅在检查后才通过答案,而委员会门槛为每个模型打开相同的固定问题集而不查看被测试的答案,所以它限制了委员会效应而没有解释它:没有 sol 三元组仍移除 81.2%,甚至与弱单一评判者(kimi-k3,45.5% 的准确度)的同意移除 86.3% 的确信失败。驱动因素是跨模型同意本身,而评判者的准确度体现在保留的结果中(sol 的保留正确率为 97.0%,较弱的评判者为 20–63%)。
校准弃权提供了更强的竞争基线,它们也被运行过。两个校准弃权基线在与校准护照相同的划分下拟合(参数在偶数索引项上拟合,在保留的奇数半部分上评估,其中冻结门在30.8%覆盖率下移除82.2%的置信失败)。逐模型基线没有达到门。Platt缩放置信度与逐模型覆盖率匹配门移除65.3%的置信失败,分割一致弃权(α = 0.293,校准以保证P(emit | wrong) ≤ α并调整到相同覆盖率)移除70.8%,原始陈述置信度顶-K控制在相同汇总覆盖率下也移除69.4%。一个在一个Platt校准概率尺度上对所有十一个实验室的答案进行排名的汇总变体确实超过了门(在相同汇总覆盖率下为89.0%),但它通过将基本上所有覆盖率重新分配给校准良好的实验室来实现:它发出最校准良好的供应商答案的100%,十一个实验室中四个为0%,以较软的形式再现了上述护照的失败模式。它还需要大约七百个每模型的分级答案来拟合,而门不需要任何答案。因此,校准置信度和跨模型一致性是补集而非替代品:第一个在存在地面真实标签来训练它的任何地方购买较低的汇总错误率,第二个购买统一的、无标签的逐实验室保护。
图19将每个策略放在选择性预测平面上(汇总超过13,955个确定性解决的答案,即十一个手臂在冻结的1,459个问题池上返回的答案,因此总数小于表9的——表9计算所有1,500个问题上解决的答案;选择性风险=发出的错误答案的份额)。按风险覆盖曲线下的面积排名,越低越好:Platt校准置信度0.258,由陈述置信度0.321优化的门梯,纯一致性梯0.356,原始陈述置信度0.367,随机弃权0.517,对比0.166的预言机下界;保留一半的值最多相差0.009。在冻结门自己的工作点(在这个已解决答案约定中为31.1%的覆盖率,13,955个答案中的4,334个被发出;在其他地方报告的30.5%和30.6%是置信答案和池问题的份额),门的风险是24.9%,对比原始置信度阈值的33.4%和校准置信度的14.0%,受上述标签成本和覆盖率集中的警告约束。所有165个三模型委员会的云跨越9–59%的覆盖率和13–38%的风险,因此所报告的门是其族的代表成员,而非调优的异常值。单法官门追踪族的退化末端,其中"一致性"简化为"询问最准确的模型"。
图19。风险覆盖边界
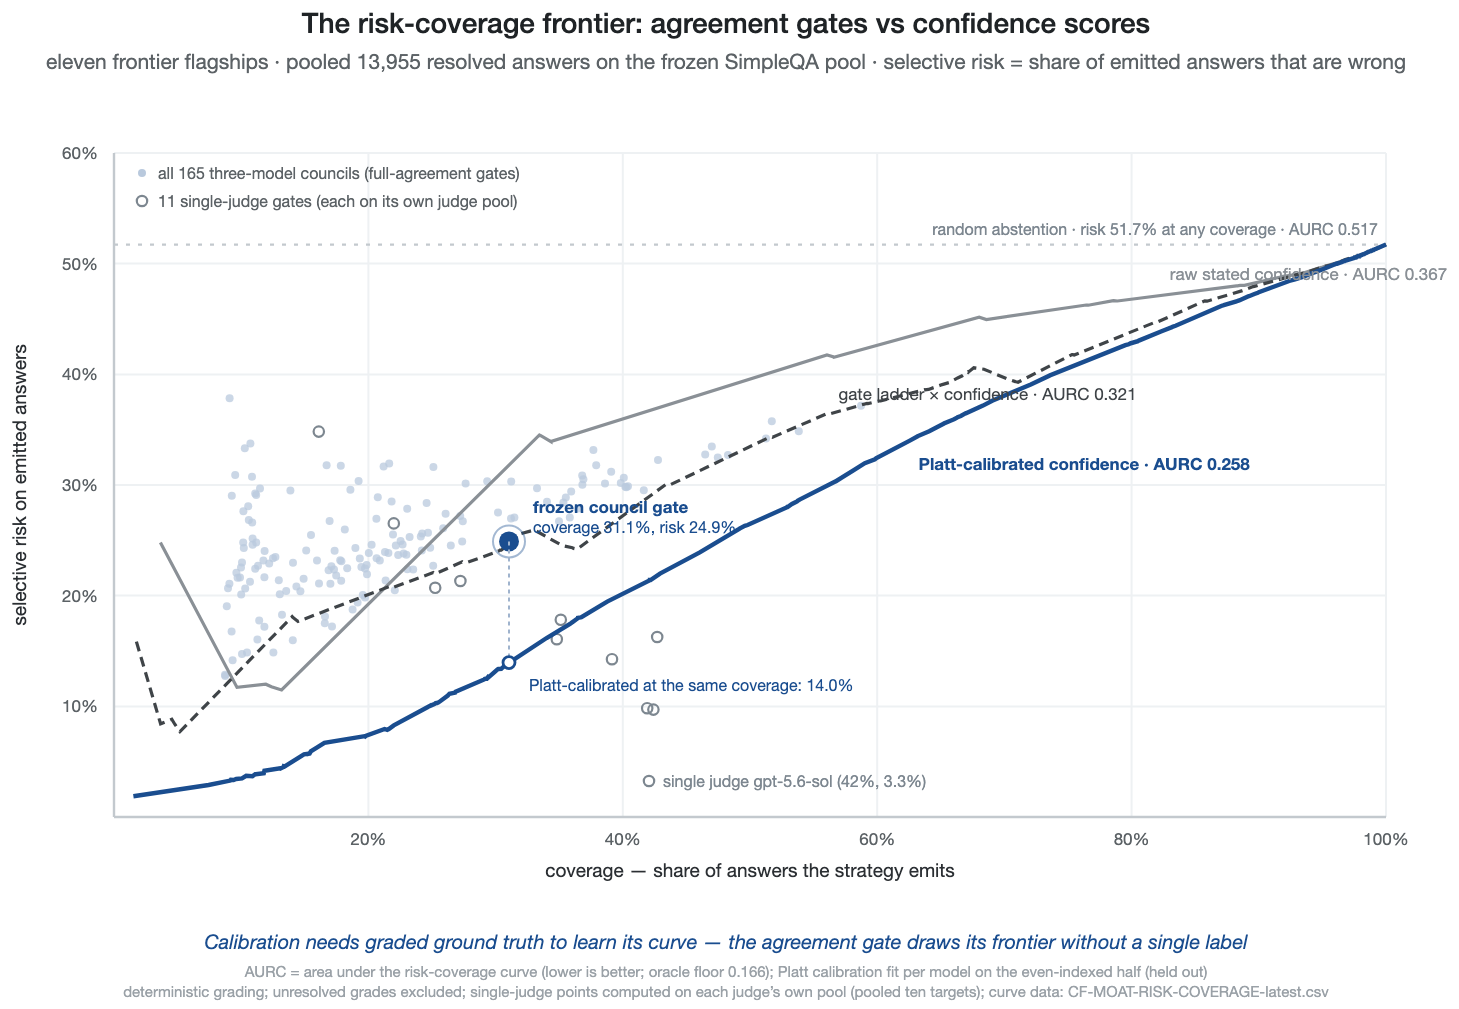
选择性预测平面上的每个弃权策略,覆盖对比选择性风险,汇总超过13,955个确定性解决的旗舰答案,由十一个手臂在冻结的1,459个问题池上返回的答案(表9计算所有1,500个问题上解决的答案):原始置信度、Platt校准和门梯×置信度曲线及其AURC值,随机弃权线,所有165个三模型委员会的云,十一个单法官门,和冻结委员会的工作点(在已解决答案约定中的31.1%覆盖率,13,955中的4,334个;24.9%风险)。越低越好;预言机下界为0.166。每个点都可从复制包的风险覆盖CSV重新计算。
一致性可能除了问题易度之外不包含任何信息。为了测试这一点,对门一致性和项目难度(该问题上其他模型中错误答案的份额)上的答案正确性进行了逻辑回归,具有实验室固定效应和问题聚类标准误差,答案取决于难度的测量方式。仅通过非委员会模型测量难度(公平的控制,因为包括委员会自己答案的难度度量按构造嵌入门的信号),一致性对外部实验室目标保持独立贡献:b = +0.76,比值比2.15,z = 17.2。由门发出的答案与门会保留的同样困难的答案相比,正确的可能性大约是两倍。将委员会自己的正确性折叠到难度回归器中,一致性系数则崩溃为零,这量化了机制而非反驳它:一致性和多模型难度是同一潜在量的两个度量,门是在推理时读取它的无标签工具。
污染分层重新分析直接处理暴露问题。当至少十一个实验室中的三个在归一化后逐字复制黄金字符串时,将问题标记为可能基准暴露(1,459个池问题中的741个;产生gpt-5.6-sol的61.6%黄金回声率的相同特征),门在非暴露分层上移除89.4%的置信失败(2,793→296;非委员会目标:86.5%),而在暴露分层上为72.7%。因此该机制不依赖于记忆化项。它表现得如一个选择性过滤器应该的样子,在面板真正不确定的地方打开得少得多(18.7% vs 41.9%覆盖率),并在分层间保持发出的置信失败率几乎恒定(25.9% vs 21.8%,来自58.5%和36.4%的原始率)。2–5个回声模型的暴露截断给出87.7–89.7%的非暴露dCF,因此该发现具有阈值稳健性。分层是描述性的:黄金回声与结果相关联,它将可能见过的问题与其他问题分开,而非因果识别污染。
更大推理预算的作用:信心,而非能力。 旗舰供应商现在在模型选择基础上额外销售推理预算设置,按隐藏推理的每个令牌计价。如果扩展推理能实现校准,那将是该论文问题的模型级别答案,可在结账时购买。一项旗舰产品的配对实验表明它的作用不同。Google的gemini-3.1-pro(推理无法禁用)在两个预算下回答了相同的冻结问题集,一个为低推理努力设置,一个为供应商默认动态预算,温度为零,提示和解析器相同,并按问题记录成本。在该版本日期下两个预算都回答的233个问题中:准确率75.1%(低)对76.4%(默认),无法检测到差异(精确McNemar p = .648);默认预算下声明的信心高3.1分更高(Wilcoxon z = 4.68,p < .0001);默认预算下的校准略较差(配对ECE 0.100对0.082;信心减准确率差距+9.3对+7.5分);每个问题的成本2.1×。准确率比较属于特定类型的零值:这些数据显示在n = 233时无法检测到准确率差异(精确McNemar p = .648),等价性仅在粗边际处正式确立。配对TOST将准确率差异限制在±5分内(差异+1.3分,90% CI [−1.8; +4.4];两个单侧p ≤ .024),但该研究的能力不足以在±2–4分处确立等价性,而+3.1分的声明信心上升在统计上是明确的(Wilcoxon p < .0001)。在该范围内,翻倍的支出购买了额外的声明信心,但没有可测量的额外正确性:过度自信作为付费功能,是迁移论文的模型内案例。这笔额外开支流向模型层,没有产生消费者可验证的任何东西,而其上的架构层则将信心转化为可检查的信号。结果是一个试点,按此报告:比较涵盖233个配对问题,完整的1,500对设计将等价性边界缩小到约两分;频道组成和令牌上限审查在复制包中作为混淆因素被记录;数据收集仍在进行中。
图18。 更大推理预算的作用
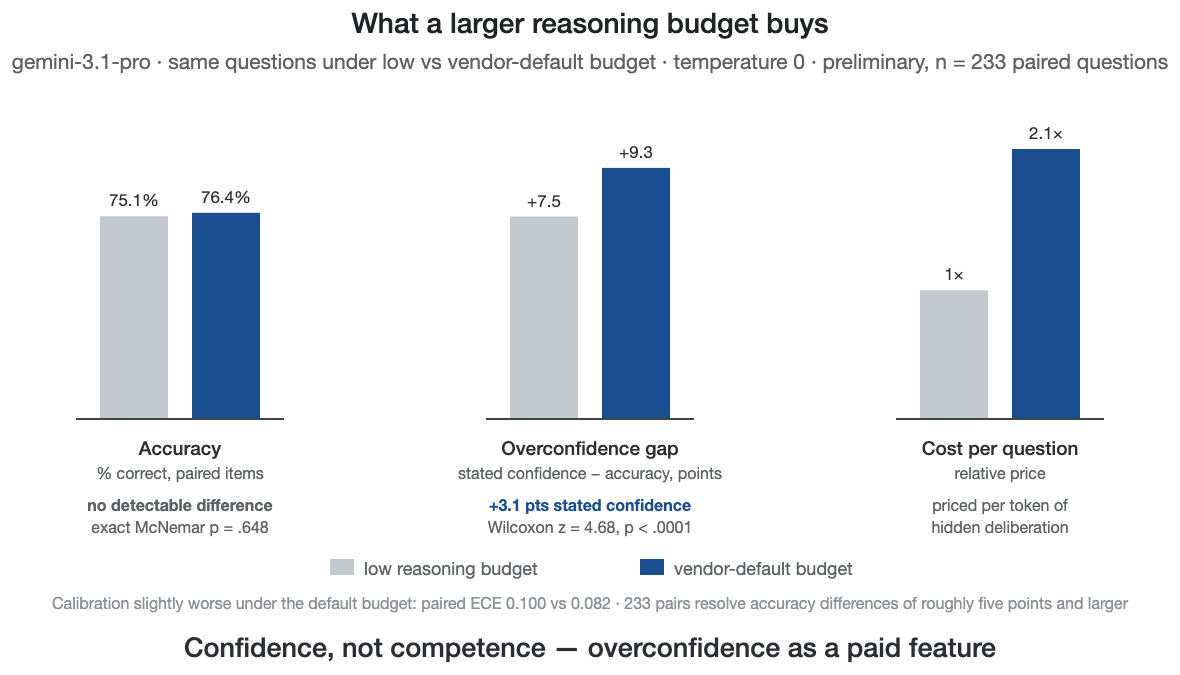
两个推理预算下的配对比较——声明的信心上升,准确率不变。
表11。 推理预算,配对比较(gemini-3.1-pro,233个问题在两个预算下均回答,温度0;初步)
| 低推理预算 | 供应商默认预算 | |
| 准确率(配对项目) | 75.1% | 76.4%(McNemar p = .648) |
| 平均声明信心 | −3.1分对比默认 | +3.1分(Wilcoxon p < .0001) |
| 校准(配对ECE) | 0.082 | 0.100 |
| 信心 − 准确率差距 | +7.5 | +9.3 |
| 每个问题的成本(相对) | 1× | 2.1× |
推理努力设置在各臂之间并不相同:每个供应商都通过其标准商业界面在该界面的默认努力下进行查询(每个模型的设置在复制包中记录),因此供应商的绝对准确率可能包含努力成分。这不足以解释机制。准确率排名不是承重的(旗舰标签不保证任何东西),移除任何成员后门仍然成立(无溶液委员会移除81.2%),较大努力在准确率平坦的情况下提升声明信心,如配对比较刚才所示,因此它膨胀的任何准确率都表现为自信错误,这是该门截获的失败。
旗舰波浪的覆盖范围限制。 该波浪是2026年8月5日的冻结快照,因此其后发布的模型(如Grok 4.6(8月12日)和后来的Artificial Analysis领导者如Claude Opus 5)超出其范围,无法进入预先承诺的基准。最高排名在数天内发生了变化。这就是该门所规避的识别问题(协议对名册稳健,移除任何成员后仍然成立)。两个纳入的实验室在通用能力排行榜上低于当前前沿:Mistral的旗舰在检查的每个聚合指标上都落后于顶层,而百度的通用目的ERNIE在《人类的最后考试》上排名前30之外(其优势在于搜索增强和代理任务,其中ERNIE 5.1在LMArena Search Arena上排名#4)。保留这两家是为了保存欧洲生态系统覆盖范围和所有主要中国实验室的代表性。在两家本应在波浪范围之外的顶层实验室中,Meta Superintelligence Labs(Muse Spark 1.1;《人类的最后考试》排名#4)和ByteDance(Seed 2.1;排名#10),其中一个随后被尝试但中断(Meta,见下),另一个完全无法联系(ByteDance,见下)。
ByteDance的Seed 2.1无法纳入:BytePlus ModelArk对新注册的国际账户返回"在您的国家/地区不可用"(实时尝试,2026年8月5日),没有聚合器提供该旗舰,国内Volcano Ark频道需要大陆中国身份验证。百度的ERNIE 5.1(当前旗舰)同样仅限于国内Qianfan平台(实时尝试,2026年8月5日)。当实验室的当前旗舰无法访问时,回退规则是该实验室最强的公开发布模型。对于百度,这是ERNIE 4.5 VL 424B(开放权重),改用之。这本身就是一个发现:截至2026年8月,六个主要中国实验室中的两个,其当前旗舰对外部研究人员无法访问。
Meta是这次浪潮的第三个访问失败,障碍来自我的账户,而非地理位置。在第一波(中层)中,Meta因有文献记录的基础设施原因而缺失:其第一方Llama API在2026年7月6日停用,早于协议冻结(在运行清单中记录),实验室在本地层由其开源权重Llama-3.2-3B代表,这被证明是小组中最具启发性的成员(整个矩阵中错误相关性最低)。对于旗舰波,Meta的muse-spark-1.1在变得可访问时于波中期加入,数据收集随后以三种方式依序失败,均有记录:(i)第一方Meta Model API密钥在8月5日中途失效,已收集251个有效答案,开发者控制台拒绝颁发替代品;(ii)一个聚合器备用路由产生了21个进一步的答案之后(iii)Meta的提供商端点开始对来自公开基准的闭卷事实回忆问题返回HTTP 403 `user_blocked`,"访问因重复违反政策而被限制",温度设为零。净结果是1,500个项目中的272个(18.1%)被收集并报告为部分:冻结后的汇总分析包含251个第一方答案(聚合器补充的数据在分析冻结后到达),Meta的每实验室估计(125个有信心答案上为−92.0% dCF)在方向上与小组一致但精度不足以进行推论。该阻止本身就是一个发现:截至2026年8月,独立研究人员无法通过任何授权渠道完成对Meta旗舰产品的1,500问事实评估。这次浪潮的三个访问失败——一个区域锁定的旗舰产品(ByteDance)、一个国内专用的旗舰产品(Baidu)和一个研究员禁令(Meta)——以实证形式呈现了理论论证:模型层的可验证性仅在供应商允许下享有,而建筑信任层不能假设供应商允许。
4. 极端部署:承诺不可逆转的委托
研究消费者信任的通常方法是问卷调查或实验室任务。我有一个更严格的工具可用:一次扩展的高风险部署,其中每一个后果都落在我身上。本节是来自单一、存在冲突的操作者的存在证明和设计证言,不构成普遍性的实证证据,P1–P5中的任何一个都不依赖于它。两种证据相互关联。在实验室中,校准效应是在安慰剂对照下测量的;在部署中,由于错误不可逆,相同的三个特性决定了委托是否可行或是鲁莽。
该部署既不是客户端的,也不是模拟:我同时是操作者、开发者和分析师。证据层是哈希锚定的,每个测量都可以独立重新计算,因此冲突关系到倡导和我选择测量的内容,而不影响数据的可复现性。该设置将普通消费者能力与不可逆的利益相结合,其中每个架构弱点都会被迅速和明显地惩罚。
方法论上,这是一个极端的、启示性的单个案例 (Yin, 2018),属于解释性和分析-自民族志传统 (Walsham, 1995; Gould, 1991; Anderson, 2006),记住该传统的证据谨慎 (Wallendorf & Brucks, 1993):先记录,解释标记为解释。正当理由是访问权:研究人员在伦理上无法让参与者对人工智能架构的不可逆现实结果冒风险,因此唯一可用的观察者是自己选择下注的参与者。
分析依赖于当代的、哈希锚定的日志。部署的证据层本身就是记录:关键步骤(咨询了哪些模型、它们在哪里分歧、什么受门控、我确认了什么)在当时被记录,因此观察基于可重放的记录而不仅仅基于记忆。后见之明偏差无法从解释中消除,因此我标记每个解释超出记录的地方。部署期间系统证据层的记录哈希锚定在2026年8月2日:129个文件(7,414,043字节)的每文件SHA-256清单,其根为2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc,锚点随本论文发布。记录保持密封状态直到部署关闭,因为来自活部署的选择性引用不如没有引用。可以验证该承诺:稍后发布的任何记录要么与锚定清单匹配,要么不匹配,因此任何本页面的读者都可以检测到追溯编辑、替代或回溯日期。对遥测数据的更完整定量处理留待未来工作,原因相同。
来自生活在这个循环内部的三个观察被作为假设提出,涉及什么转移到原始设置之外,为第3部分的提议提供支持,而它们所基于的事件在当时由部署记录。
分歧是消费者可用的信号。当独立模型在后果性问题上分歧时,分歧本身被公开而不是压制,告诉我真正的不确定性在哪里:这是单一模型服务无法提供的免费早期警告。
证据改变行为早于它改变争端。知道每个后果性步骤都被记录使得委托在心理上成为可行的;记录是信赖的先决条件,而不是审计的事后想法。
信心门控比平均准确性更重要。实际上危险的事件是高置信度的错误,绝不是平庸的输出。该架构的真实贡献是使高置信度代价高昂:一个答案必须经得住跨模型一致性的考验才能获得高信心,而不是从单个模型的流利性中免费获得。
5. 启示:从说服到基础设施
设计和体验
用于服务设计。可信任AI服务设计的单位正在从模型转变为管道。这意味着通过独立模型路由后果重大的查询,将分歧视为一级UX元素,默认附加证据,根据自信错误的不对称成本对多模型处理定价,昂贵的路径保留给风险集中的请求,就像欺诈筛选为风险交易保留审查一样。基础设施已经存在:成本驱动的级联(将困难请求升级到昂贵层级)是标准的代理工程,而对于已经按难度路由的服务,按后果路由的边际架构接近于零。两个实验测量的故障模式留下两条硬规则,它们是设计要求,而不是偏好。位置必须盲目收集并记录在任何跨模型协商之前,因为先协商的管道会制造架构应该监督的共识(第3部分的从众压力)。第二条规则:对受限选项集的全体一致自信共识是审查的红旗,而不是执行的绿灯:模型面板和第6部分的人类参与者都将这种共识视为认证。
经济学原理有效是因为升级是递进的,一个递进信任架构:在这里描述的部署中,处理层级在单模型答案和完整多模型协商之间的每个请求成本跨越大约三个数量级(截至2026年7月),所以昂贵的层级只在后果集中的地方被购买。收支平衡逻辑是欺诈评分的(图14)。编排值得投入,只要自信错误的概率乘以其全部成本(退款、一次失败容差下的客户流失、责任、监管风险)超过检查的边际计算成本。对于高风险交易,这个不等式相差甚远。
推理价格下降(在三年内固定能力下大约两个数量级的下降,对跟踪衰退的保守估计;Appenzeller, 2024)不会化解论证,因为比率而不是绝对成本是结构性数量:两个层级一起随着价格曲线下降,而廉价推理使昂贵的层级在越来越低的风险下变得可承受。检查有其自身的第二条曲线:弱验证器的集合(没有标记数据)达到了来自开放70-billion-parameter组件的前沿推理模型的答案选择准确性(Saad-Falcon et al., 2025)。考虑到一次失败消费者容差,比较不是"廉价答案 vs 昂贵答案"而是"昂贵答案 vs 失去客户"。
两个面向消费者的基本元素完成设计:刻意摩擦(不可逆行为前的明显暂停)和收据。两者都介入授权的感受方式。消费者从社会学角度而非统计角度体验AI(Puntoni, Reczek, Giesler, & Botti, 2021),随着授权执行将服务互动从视线中移除,收据继承了互动的旧角色作为关键时刻。一个风险伴随这个框架:使分歧突出可能会宣传不确定性并削弱信任,而不是校准它(Detjen et al., 2025; Lu, Wang, & Yin, 2024),所以展示多少分歧以及如何展示是一个设计变量。这不是免费的。
一个编排收据可以是最小的并仍然完成其工作(图8显示了模拟)。三个字段承载大部分价值:(1)谁采取行动,咨询的模型和版本,在什么权限下;(2)他们如何一致,分歧的简明摘要;(3)检查了什么,带有指向完整可重放记录的指针:小到可以一目了然地阅读,具体到可以锚定争议、保险索赔或审计。同一工件回答运营商自己的簿记问题,所以收据发挥双重价值:向内作为成本治理,向外作为有根据的信任。这种两面性是必要的。衡量的消费者为仅透明度支付的意愿很低(在一个定价联合中,可解释性的价值低于€1.99一个月;König et al., 2022),所以一个仅由消费者一方资助的信任层会缺乏资金,运营商的成本治理一方承载它。收据最接近的工程对应物是在代理框架内记录的工具收据,用于幻觉检测(Basu, 2026),它们共享理念但服务对象不同:那些是开发人员面向的单个工具调用记录,而编排收据是它们面向消费者的、每个决策级别的泛化。收据引发其自身的故障模式:一个工程使其看起来得到验证的工件,而不暴露消费者可以重新运行的任何东西。重要的设计线是记录是否真正可重放而不仅仅是看起来像收据。一个约束也从隐私方面到来:一个证明检查内容的工件也记录了首选内容,所以可验证性和隐私必须联合优化(Alavi & Nozari, 2026)。
收据经济学的最后一个组成部分有自己专属的名称,检查经济学。防篡改记录的价值仅取决于某人打开它的动机有多大,去中心化系统的十年在这里是个警示:公开的、防篡改的区块链记录并没有将普通用户转变为审计员,而"无信任"架构在每个实际接缝处悄悄地重新引入了信任的中介机构(Werbach, 2018)。验证者困境是其正式表述:当验证成本高且正确结果是常见情况时,理性的验证者会跳过检查。验证需求必须集中在私人检查的回报已经存在的地方,即在保险人、审计员和纠纷解决流程之间,消费者将验证作为这些市场的副产品继承下来;收据对消费者的功能是在纠纷中的可用性,而非日常阅读。资金问题由同一原理推导而来,对其的两种天真的回答都失败了:消费者付费的协调器将中立性定价为奢侈品,而商家付费的协调器重新引入了它存在的目的——消除的冲突。这留下了收据双边经济学已经暗示的模式。该层的支付方式与审计的支付方式相同,由需要对风险定价而不是讲述故事的各方支付(运营商购买成本治理和责任减少,保险人购买可保风险概况,纠纷解决流程购买证据),在那些市场需求不足的地方有监管底线。消费者购买的是服务而非中立性,并将中立性作为其副产品继承下来。同样的问题有市场结构的表现形式。一个同时是市场、模式供应商和广告网络的平台在结构上无法提供中立性,这是市场形式中的利益冲突点,算法优先级的历史记录(赞助展示、首选合作伙伴)表明主导参与者如果可以的话会将路由货币化。在该压力存在的地方,中立性底线是监管的或开放协议的,而非自愿的。如果首次接触时消费者对证据的需求很弱,对建筑信任的采纳可能不是由消费者选择而是由合规和保险方面驱动,是通过机构而非偏好的迁移,消费者将可验证的架构作为默认值继承下来。校准结果使该路线不成为装饰性的:消费者一旦看到建筑信号就明确地使用它,但他们尚未为召唤它而付费。这里有一个相竞争的假设:信任可能迁移到责任和机构,而不是可验证的架构。消费者依赖于退款权利而非分类账审计;卡网络通过纠纷权利而非通过消费者检查授权记录来扩展远程商务;根据该解读,决策记录是使责任可计算的管道,而不是消费者信任的对象。两个账户预测不同的事物:在建筑账户上,消费者在能看到时奖励可验证性;在机构账户上,他们仅在有补救措施时奖励它,消费者的信任保持锚定在机构中,而机构的信任迁移到架构。下面规定的纠纷时设计区分了它们。每个记录层都继承了预言机问题:记录证明该过程,只有该过程自身的检查才能达到事实。收据所反转的不对称性是平台批评文献所记载的那种:架构而非陈述的政策是数字行为的有效监管者(Lessig, 2006),迄今为止其工具一直指向消费者而不是掌握在消费者一方(Zuboff, 2019; Möhlmann & Zalmanson, 2017),收据将这些工具转向相反的方向。
证据层应该在产品本身中可见,而不是归档在后台日志中。软件工程最近对代理模型周围的运行时包装器的名称达成了共识,称为智能体框架,以及认识到该框架而非模型才是可以被认证、监管和信任的。建筑信任指定了该框架必须生成什么才能值得该角色。
本节所设计的规模和它所对抗的反弹已经成为记录。Klarna的助手在第一个月处理了230万次对话,占该公司客户服务聊天的三分之二,相当于700名全职代理的工作量(Klarna, 2024, company-reported figures)。十四个月后,CEO公开改变方向:输出质量下降,人类招聘重启,而常规承诺变成了"如果你想要,总会有人工"(Daly, 2025)。从架构上阅读,作为我的解读而非公司陈述的理由,这对公告恰好界定了本论文所指出的间隙。大规模处理以机器成本运作,但没有分级升级和没有可检查的质量信号,委托反弹回人类基线。使那两个公告之间的立场稳定的是一个分级信任架构:在风险低的地方廉价,在风险集中的地方进行检查,在检查失败的地方使用人工。
市场与监管
对于跨境服务。中立性超越了模式供应商,延伸到司法管辖区。编排层可以执行司法管辖区感知的路由并记录执行情况,将数据主权合规从法律表述转变为可审计的运行时属性。对它响应的差异已被测量:在25个国家,中位数53%的受访者信任欧盟能有效监管AI,而对美国的信任度为37%,对中国为27%(Pew data, reported in Stanford HAI, 2026, an institute report, not peer-reviewed)。在信任因司法管辖区而异的地方,能证明适用哪个司法管辖区规则的架构具有真实价值。
对于代理商务。Visa–ChatGPT集成使三个组件具体化。上限和白名单是静态的、消费者端的护栏。建筑信任添加了动态的、服务端的层:由独立模型进行交叉检查的购买(多样性)、代理选择该商家和价格原因的可重放记录(证据),以及收入不取决于任何供应商或商家胜负的编排层(中立性)。
支付行业已经开始建设这个堆栈的下层。Visa的可信代理协议(2025年10月,与Cloudflare合作;Visa, 2025)将代理的身份加密地签署到其请求中:特定于商户和用途、有时间限制、防重放的签名。Google的Agent Payments Protocol(Google Cloud, 2025)与Mastercard的框架一起被贡献给2026年的FIDO Alliance,将用户的意图编码为以W3C Verifiable Credentials(W3C, 2025)形式传递的签署的授权。Mastercard的Verifiable Intent(与Google的联合框架;2026年3月宣布;Mastercard, 2026)用这篇论文可能会写的言辞阐述其目的,这是一份防篡改的记录,记录当AI代理代表用户行动时用户授予的权限,2026年在亚洲和拉美市场报告了早期试点。身份和意图证据现在正在标准化,记录格式也在标准化:IETF的SCITT架构(RFC 9943, 2026)规定了相同的模式——签署声明→仅追加透明度日志→凭证,这正是本论文的证据层所依赖的。进行委托的界面甚至不具有道德中立性。在十三项实验中,向AI委托的人表现得不那么诚实,特别是在目标含糊的情况下,而且机器代理执行完全不诚实指令的频率远远高于人工代理(Köbis et al., 2025)。强制以具体措辞陈述意图的界面是伦理基础设施。
目前还没有协议涵盖第三层,即决策证据:代理如何选择这个商户、这个产品、这个价格;独立检查是否认同;其置信度值多少(图15展示了这三层)。这是本论文命名的层,"了解你的代理"应该恰好演变为这个过程问题,监督单位迁移至交易。架构能保证的是记录的存在,而非其被阅读。是否有人打开这类记录是只有部署才能回答的经验问题。
图15。 证据堆栈
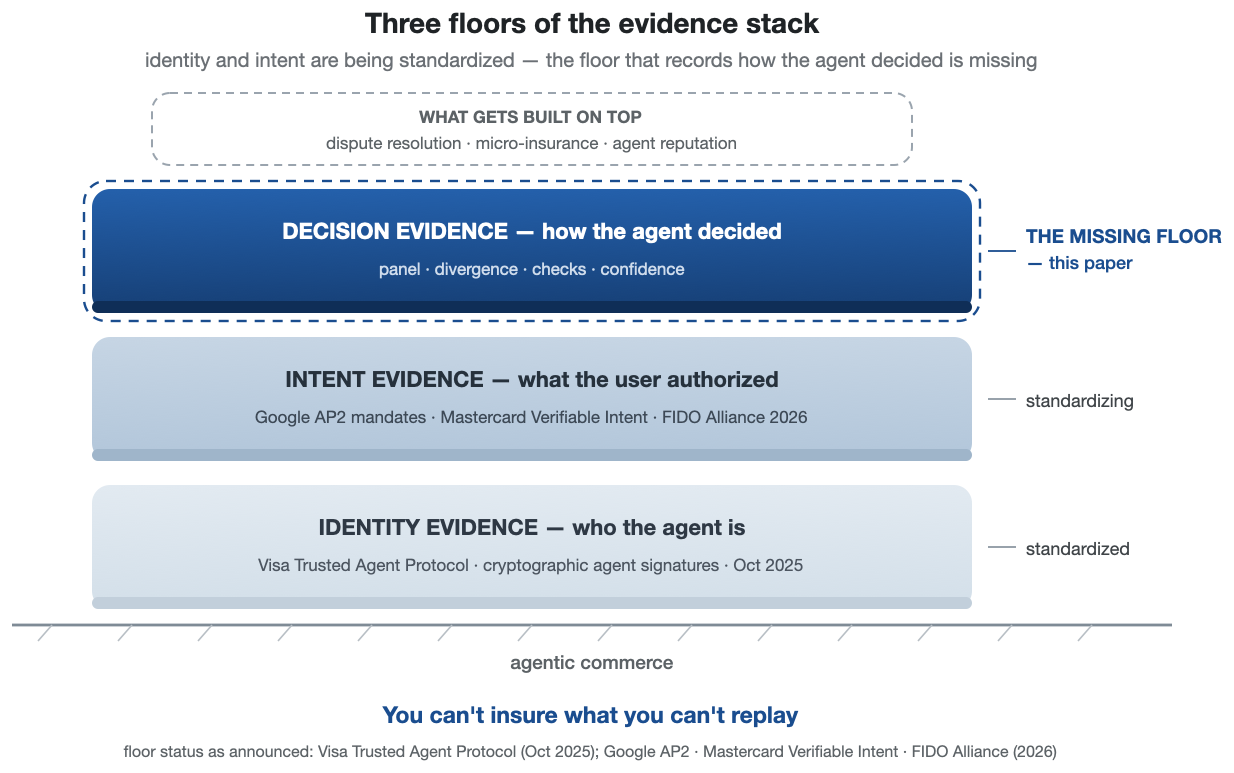
身份和意图证据现在正在标准化;决策证据是本论文命名的缺失楼层。
对代理购买行为的首次系统审计表明为什么决策证据不能等待。Allouah et al.(2026)在受控电商沙盒中进行随机试验,发现购物代理表现出强烈的位置偏见,将需求集中在少数几个"典型"产品上,当基础模型更新时会大幅重新调整这些偏好。没有关于如何做出选择的记录,消费者、商户或监管机构都无法看到这一点。多样性是这里的设计答案,因为一个面板会淡化任何单一模型的位置怪癖,而问责制是决策证据提供的:那些审计员必须建造沙盒来观察的东西,一个架构上可信的服务会在生产中记录。
该框架还延伸到消费者之外,到机器之间的信任。在B2B代理工作流中,根本没有人类在循环中来感受信任,所以唯一可能的基础是可验证的过程,代理交换这里描述的确切工件并计算是否交易。信任如何在大规模此类委托链中聚合和传播,以及证据层自身的日志记录和验证开销在生产量上的成本,是这里的开放问题。链会加强这一要求,因为链的可信度只取决于其证据最少的链接:记录必须可组合。在没有消费者的地方,架构信任可能是仅有的可用信任形式。
信任文献尚未跟上的一个结构性发展是协议战争。竞争的代理商务堆栈(OpenAI with Stripe、Agentic Commerce Protocol;Google的Universal Commerce Protocol联盟;Perplexity with PayPal;下面还有卡网络和开放标准)沿供应商协议线碎片化商务,正如AI服务沿供应商模型线碎片化一样,中立论点几乎原封不动地推广:只能在一个供应商协议内进行交易的消费者代理是该供应商的代理,而不是消费者的代理。无论哪一层跨协议进行仲裁,都将面临相同的三个要求——独立性、证据和无利害关系,如果这样的层成立,对货架的竞争就变成了对检查员的竞争。
对证据市场。 在2026年,这停止成为预测。在责任方面,保险首先并同时向两个方向发展。生成AI索赔的可选排除背书于2026年1月进入了标准一般责任工具包(ISO表格CG 40 47和CG 40 48,承运人可选的背书,而非自动排除;几个月内,主要承运人已提交采纳这些背书或专有等价物)。在同一时间窗口,第一份AI代理政策的编写方向相反,反对证据:AIUC-1代理标准之所以存在,是为了通过红队审计生成保险公司承保所需的经验风险概况,2026年2月至3月带来了第一个认证审计员、第一份代理政策和首批企业认证。被全面排除和基于证据的承保夹在中间,记录已成为责任分配的单位:没有可检查历史的代理面临排除式覆盖,而有记录的代理则是可报价的风险。
在监管方面,EU AI Act第50条透明度义务——包括强制向消费者披露AI交互——自2026年8月2日起生效(过渡性标记子义务运行至2026年12月2日),根据本论文对该法案处罚条款的解读,罚款最高可达€1500万或全球营业额的3%。委员会于2026年7月20日采纳了第50条指导(European Commission, 2026),平行的Digital Omnibus简化(签署于7月8日)不会延迟8月义务。现有系统仅获得有限延迟至2026年12月,用于机器可读内容标记。更广泛的高风险义务分阶段实施至2027-2028年。
证据层改变了这一义务:包含所需人工智能披露在本次会话中向该用户展示的证明的防篡改记录,根据本论文的理解,将高达€15 million的法律风险转化为可审计的运行时属性,合规成为架构的副产品。承保人工智能代理责任保险的保险公司正需要这样的记录,而可追溯性和问责制是NIST人工智能风险管理框架的核心特征。监管先例比该技术更为古老。自2011年以来,银行的模型风险指导要求由独立于模型开发者的各方进行独立验证(美联储SR 11-7),编排小组将这一要求自动化,使其持续运行,并将其扩展到每一个重大决定。消费者法律已然保留了人为退出的权利:GDPR第22条赋予在纯自动化决定中寻求人为干预的权利,这些决定具有重大影响,而根据本论文的理解,分歧升级是现有法律权利的运行时形式。人工智能法案从监督方面达到了相同的设计:欧盟法规(EU) 2024/1689第14条要求高风险人工智能系统建立有效的人为监督,而一个能够浮现分歧并将未解决的案件转向人工处理的架构将这一监督责任实现为运行时属性,而非合规文件。
一旦记录存在,就会产生两种衍生产品,都是近期的推测。交易级微保险将为特定代理购买保险至美分级别,从证据记录中定价,对于不透明的代理无法制定,对于可重放的代理则轻而易举。另一个是代理声誉:纵向证据历史自然地汇总成代理和编排者的声誉评分。作为运营副产品生成审计级历史的服务将持有资产,其竞争对手必须进行改造。
这类基础设施如何成为制度化的本身就是一个假设。本论文押注的轨迹(产品优先、标准次之、授权最后)是信任基础设施历史所展示的几种轨迹之一(共享自动取款机网络、卡网络规则手册随后由监管部门批准、区块链的验证供应仍在等待需求)。其背后也有一个具有名称的研究计划。Hadfield的监管市场理论——由公共当局授权的私人监管机构,以独立验证组织作为承载机构(Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026)——从治理供应方达到这一点。本论文从消费者委托的需求方达到这一点,两个计划在收据处相遇。更深层的问题是,作为产品功能出售的收据是否会最终硬化为制度。如果不会,它仍将是治理装饰品而非治理层,这将反驳本论文的中心论点。反驳点已预先设定:当至少两个行业标准要求为代理交易保持可追溯的决定记录、携带所有三个组件的服务处理大多数高风险代理交易量、且至少一个国家监管机构在其责任分配中承认此类记录时,才可称收据为治理层。三者都持续失败在运作上就是"装饰品"的含义。如果验证作为基础设施获得成功,它就会商品化,信任转向共享实用程序本身,包括当前架构,这将在基础设施成功的同时抹除任何竞争优势。
在编排的决定出错时谁应承担责任仍是一个悬而未决的问题:编排者、模型供应商,还是授权该代理的消费者。
法律已经开始关闭简单的退出路线。加州AB 316法案自2026年1月1日起生效,禁止任何开发、修改或使用人工智能系统的被告辩称人工智能自主地造成了伤害,同时保持普通抗辩和过错的比较分配不变。它并未实施严格责任制。这使得分配问题不可回避,无论教义如何解决,可重放的记录就是任何责任分配的计算基础。法律学术界也已到达同一目标,主张经典代理法工具包无法适用于人工智能代理,所需的是新的可见性和责任基础设施(Kolt, 2025),这是本论文论点在治理文献中最接近的前驱,从监督供应方接近,而本论文从对它的需求方接近。架构信任是新兴责任学说可以合理依赖的证据基础。
测量和研究议程
对于信任测量。标准工具测量对品牌或界面的态度。值得测量的态度是委托意愿,而非"你相信这个人工智能吗"这个问题的答案:消费者将在不逐步审查的情况下将哪一类决定、在什么风险水平交给代理?委托是行为性的,在有根据的信任中单调,并直接与收入挂钩。除此之外,还有若干问题:消费者是否知道答案是如何产生的、他们是否能够获得记录、浮现的分歧是否改善或降低了他们的可靠性校准。
调查是人类时代的收据:当消费者执行搜索、比较和选择时,询问消费者是学习发生了什么的一种可辩护的方式。委托移除了问卷旨在询问的行为者,因此事件的主要痕迹成为架构产生的构件,收据在这一精确意义上是委托时代的主要交易痕迹。这两种工具不相互竞争:收据记录机器所做的事,对主观挪用、感受到的自主性或认知负荷什么都没有说,这些仍是调查的地盘。(这消除了与第1部分的明显紧张关系,其激励证据本身就是表示偏好的调查:调查测量消费者目前对一个几乎不存在的市场的感受,而收据测量一旦存在委托服务实际所做的事。)可通过将态度测量与相同事件的构件配对、按结果分层、估计问卷和记录在何处一致及哪个更好预测后续委托行为来检验这一桥梁。所提议的联合分析在设计上包含这一验证的一部分,在此类研究存在之前,基于构件的指标补充而非取代调查。
行业调查已经显示了行为基线:在 Gartner 2026 年 5 月发布的消费者调查中(846 名美国消费者,调查时间为 2025 年 11 月至 12 月),54% 的购物时使用过生成式 AI 的消费者表示他们会对 AI 提供的所有信息进行二次核实。架构信任是消费者已经为自己做的事情的产品化。
该测量计划在整体评估运动(Liang et al., 2023)和代理可靠性新兴科学中有天然的盟友,后者将可靠性分解为十二个指标,因为单一成功率掩盖了重要的失败(Rabanser et al., 2026)。架构信任以相同的方式进行操作化,即从行为层面:确信错误率、适当依赖、建议权重转变、覆盖率、决策时间,以及一个特别尖锐的统计数据——正确和不正确输出之间的批准率差异,这是直接从行为读取的依赖度校准。在记录方面,有证据覆盖范围、测量的小组分歧和收据访问率,在同一事件上对调查、行为和日志进行三角测量。这些都不需要新的科学。要求是一项决定,即这些而非参与度是信任层要负责的指标。我从部署点的观察指向了反直觉的方向:清晰呈现的不确定性增加了我的适当依赖,当系统明确知道自己不知道什么时,我对它的信任更多。
有一个进一步的因变量应该被纳入议程,因为信任不是授权所施加的唯一心理压力。消费者对由算法产生的有利结果反应不那么热烈,因为自己未产生的结果更难被声称为自己的(Yalcin, Lim, Puntoni, & van Osselaer, 2022)。授权可以提高决策的客观质量,同时削弱其主观所有权。收据处于这个分叉口:以一种方式阅读,它恢复了作者身份;以另一种方式,它证明消费者什么都没有做。哪种解读占上风是一个框架已经进行了工具化的设计问题:证据组件记录了检查的内容和针对什么标准(第 3 节),收据的设计目的是将消费者自己的标准纳入该记录,因此评估标准的作者身份是架构暴露的一个变量,而不是实验者发明的变量。Yalcin 等人的机制是,自己未产生的结果更难被声称为自己的,那么标准作者身份就成为自然的调节者,P5 是证据组件在拥有权心理学中的后果,而不是议程的一个分支。P5. 收据显著性与结果有利性相互作用,决定了授权结果的主观所有权:对于有利的结果,当收据编码消费者创作的标准(代理必须满足的标准是我的,这是它满足的证明)时,显著的收据恢复所有权,当标准被解读为平台的标准时,它会削弱所有权;消费者对评估标准的作者身份是设计调节者。Yalcin 等人的效果是在消费者期望自己做出决策的地方观察到的,所以 P5 被限定在该边界内,在习惯性授权下可能会逆转,收据与现有流程透明度操纵的区别必须被实现,而不是被假设。收据是可检查的,可以携带消费者自己的标准;省略这两者的设计是在测试透明度,而不是架构信任。
透明度文献在这里提供了两个警告:过多的程序透明度会降低信任(Kizilcec, 2016),而单纯披露 AI 使用会削弱信任(Schilke & Reimann, 2025)。第二个是证据组件的边界条件:在十三项实验中,披露 AI 使用的行为者信任度低于未披露的行为者,这是一个透明度困境,其中仅通过使 AI 参与更可见来降低信任。如果该惩罚附着于任何 AI 参与的信号,那么突出其自身机制的架构可能会降低信任,即使使其更易检查,证据组件将在它最显著的地方完全适得其反。该框架的答案基于一个必须被证明的区别:可验证性不仅仅是披露。收据是关于答案如何产生的可检查记录,而不是AI 被使用的声明,P2 和 P3(带着 H2 的预注册双尾测试,披露反弹被预先命名为可报告的结果)正是这种区别在行为上要么保持其价值,要么失败的地方。可检查性是建立信任的东西,按需提供而不是作为一面永远存在的出处墙,既不隐藏机器也不宣布它都不能做这项工作。要呈现多少记录、向谁呈现以及何时呈现本身就是一个设计变量。
证据克服披露惩罚而不是加剧它的提议机制是可验证性和披露通过不同的心理渠道运行。披露提供了一个类别标签,即 AI 参与其中,Schilke 和 Reimann 的证据将其与降低的合法性联系起来。收据提供了一个程序、一条可以打开、质疑和重新运行的记录,程序正义文献认为一个人可以挑战和检查的过程使运行它的行为者合法化(Tax, Brown, & Chandrashekaran, 1998)。该渠道不需要检查发生:传递信任的是消费者意识到检查存在且在争议中可以打开,验证的可用性而非其执行,这正是在上面经济学中检查向消费者分配的消费者功能的接收。检查集中在存在检查私人收益的地方,消费者继承验证作为副产品,将记录作为选项而不是作为文件来读取。同样的区别也适用于主观所有权(P5):一个披露标签将决定归因于机器并削弱所有权,而一份编码消费者创作标准的收据证明了代理必须满足的标准是消费者自己的。这两个渠道事实上是否会脱钩,其中合法性随着可检查的程序而上升,同时因为单纯的披露而下降,正是 H2 的预注册双尾测试被构建来检测的。
局限性。 该模型源自架构分析加上一次扩展的、高风险的、单操作员部署。每个经验锚点都是在我构建和操作的那个堆栈上获得的。应用于其自身,本文的依据因其自身的格局而受限:一个作者和一个堆栈(低多样性)、一个公开复制包与密封的部署记录和禁运的行为登记(部分证据),以及声明的商业利益(中立性受损)。在任何声明推广之前,需要在其他堆栈上进行独立复制。部署记录的哈希锚使任何后续编辑、替换或日期篡改都可被检测,因此在解封时,这里的特征可以与一个可证明未改变的工件进行对照验证。在解封前,读者可以验证完整性,而非内容。机制数字来自公开模型API,管道以少于$15的成本端到端复制收集。刺激呈现仍是一个界面混淆因素:消费者实验的刺激,包括收据的样式,是我自己的用户体验呈现,界面级混淆因素只能通过独立呈现的复制才能解开。盲优先收集、防篡改记录和无风险路由构成了这一设计;聚合规则和升级阈值是工程选择。实验的面板是对一个盲优先收集的分析组合,而非已部署的编排循环,起草的现场遥测协议弥补了这一差距。框架命名的非模型验证路径(影子运行、时间一致性检查)在此处描述但未经测试。收集是温度为零的单次运行,抑制了模型内的变异性并保留了共享谱系相关性,且托管API即使在此条件下也不严格确定。SimpleQA的简短事实性答案处于约束答案空间的框架附近,其中共识证实错误,难度分层在最难的五分位数上恰好显示这种模式。中层面板可能高估多样性的好处,因为错误相关性随能力上升(Kim et al., 2025)。机制实验测试具有单一可验证答案的开放式事实性问题,以及在开放式生成任务上,其中答案之间的语义等价性本身就是判断问题,认证信号必须重新建立而非假定。相关边界是答案空间的维度:SimpleQA项目有单一可验证答案,而消费者选择代理执行的是主观的、多属性效用判断,有许多可防守的答案,因此共识如何在偏好空间中表现,以及独立代理间的一致是否甚至能识别更好选择,是开放的实证问题(语义等价转化为偏好等价,评级本身是建模选择)。运行一次标签噪声检查:在该研究子样本与SimpleQA Verified(Google DeepMind, 2025)的351项交集上,对照校正的黄金标签重新评级每个面板答案,使认证提升保持不变或略有增强(2.7 → 2.8, 4.4 → 4.4, 4.0 → 4.3 跨三个面板,确定性评级者),因此标签噪声不是提升的驱动因素。所有置信度数字都通过单一提示格式引出,为口头化0–100自我报告,对引出协议的敏感性可能因供应商而异,因此按供应商的区别和校准结论应视为该配置在该引出协议下的属性,而非供应商固有特征。十六模型波表6–7中自置信基线为原始陈述的置信度。遵循Guo et al. (2017)传统的更强校准基线在旗舰波上运行(Platt缩放和分割保形弃权,第3部分),其中作为门的补充而非替代品出现,第一波的面板与自我比较应根据消费者产品实际部署的基线来读取。标题门估计(−82.1%的有信心失败,自助法95% CI [79.9; 84.1]对于十个完整臂,[80.0; 84.2]含Meta臂)是单一预先指定的量,周围分析(阈值敏感性网格、难度和污染层、委员会消融和琐碎基线比较)是报告的描述性稳健性检查,无多重比较修正,它们对自身不要求确认状态。本文中唯一的族群错误控制是Holm修正跨消费者实验的预注册{H1, H2}。若评估制度(奖励有信心的猜测)被修复,使诚实可以被训练进模型中(Kalai et al., 2025),架构将预防一个有更便宜解决方案的问题,虽然证据和中立性仍不可化简到任何模型级修复。进一步边界在报告处说明:旗舰波的覆盖限制(第3部分:两个无法访问的中文旗舰和一个中断的Meta收集),以及初步233对推理预算比较,其TOST界限等价性在±5点边界处,无更窄界限的功效。委托措施来自假设小插曲,其中陈述的措施在元分析上大约高估真实意愿21%(Schmidt & Bijmolt, 2020);消费者实验在六个固定项目上实现了119个主要和133个汇总的200个注册参与者。一个商务基质复制扩展了超越基准的机制:一个新鲜、预冻结的267个Wikidata验证产品事实集合(哪家公司制造给定汽车或飞机,手机运行什么操作系统,哪家公司出版了游戏,以及它在哪一年发货),通过独立六模型面板(Claude Opus, GPT-5.4, Grok, Qwen, GLM和Mistral)盲目运行,即消费者面向代理实际操作的成本优化层而非旗舰,再现了分离,跨模型一致性在AUROC 0.77–0.81处预测正确性对比0.63–0.70的陈述置信度和4–6×认证提升,在跨越美国、中文和欧洲实验室的三至六模型的独立组成面板中稳健,以及评级的严格程度(此处的确定性字符串匹配是主要的、保守的规则)。商务光谱的主观、多属性端(偏好权衡、对抗商人激励和基于工具的变化库存检索)仍未经测试。
采样下的逐次运行方差。 一个方差分析分支直接探测了单确定性运行的边界:一个按难度分层的100道题目子样本(5个难度五分位数×20,种子20260806)在温度0.7下对11个旗舰波面板模型中的9个进行了重新运行,每个问题有3个独立样本;Meta的端点无法访问,Claude Fable 5的API不公开温度参数。在各模型中,所有三个样本在22–77%的问题上产生了互相等价的答案(中位数54%),单个问题的正确性在63–97%的问题上在三个样本之间相同,温度-0的答案在40–85%的问题上与多数温度-0.7的答案相匹配。gpt-5.6-sol的腿存在混淆:它在推理努力无下运行,而其1,500条波记录中的1,486条使用了默认努力(中等,如上所述)。因此,该子样本上92.0% → 46.3%的准确度增量混淆了温度与推理预算,尽管其样本间一致性数据不受影响。排除该混淆腿后,温度0.7的平均样本准确度与同一问题上的确定性温度-0的准确度最多相差14.0个百分点(gemini-3.1-pro,49.0% → 63.0%),其余七个模型在4.4个百分点内。在面板级别,议会门(kimi-k3、deepseek-v4-pro和gpt-5.6-sol之间的三向答案一致)在温度0下在子样本的31.0%处打开,相对于三个温度-0.7运行的25.0%、23.7%和29.8%。支撑标题结果的一致性信号在采样噪声下是稳定的。
陈述的证据地位。 陈述分布在三个证据级别。由这些数据确立: 在既定的边界条件下(盲目收集、能干的验证者、具有单一可验证答案的开放式事实问题),独立一致性携带了模型自报告不具有的正确性信号;一个固定的不同意门槛以实质性的、既定的覆盖成本(在30.5%的覆盖下为−82.1%)削减了绝大多数自信的失败;以及强边界条件本身:共识在受限答案空间上证实错误,原始认证收益随难度单调衰减(在集合内分层下在最难五分位数处消失;在外源分层下在那里是肯定但最弱的),以及验证者能力限制了认证价值。由行为实验支持(一个设计、适度的单一研究规模、n = 119): 呈现真实的跨模型分歧改进了两个方向上的依赖校准(d = 0.67、Holm p = .0005;由六项中的一项承载;主波操纵检查88–98%;量表可靠性α = .83–.93);以及作为注册的非结论性零假设,静态首次接触凭证没有可检测地改变委托。在理论上提出,尚未测试: D×E×N互补性;中立效应(P3);委托增加下的信任迁移;失败后基于架构的信任的持久性(P4);对可验证性的支付意愿;以及第7节的市场类别主张。
自然的下一步是实验性的:在单模型和协调条件下测量信任、依赖校准和支付意愿,分歧交替显示和抑制。第6节报告了已实现的实验,已预注册和激励相容。标准的基于选择的联合分析以加法方式估计部分价值并假设补偿性权衡,这正是互补性假设否认的,因此设计类必须允许非补偿结构,无论是逐方面消除还是具有交易破坏属性的强制选择设计,用显式交互项估计。指定了两个设计层级。最小层级是一个目标档研究,四到五个档跨越无、单成分、双成分和完整配置,理论工作由一个计划对比完成,完整配置的效果超过了成分效果的总和(超加性),对抗加法零假设。完整层级在3×3×3组间因子设计(27个单元;赌注在受试者内跨越四个级别变化)中为每个成分交叉三个级别(不存在、存在但无法检查、存在且可检查),每个单元至少80个受访者(N ≥ 2,160)以在交互上达到≥ 0.85的功效。二元2³设计无法恢复Cobb–Douglas指数并在合理的效应量(d ≈ 0.3–0.4)下功效不足。三个刺激原则适用:改变架构规模本身而不仅仅是它们的标签(缺失的凭证标签是消费者对证据的无知,而不是证据本身的缺失),为每个成分提供可验证对比仅被宣称,并将选择数据与凭证字段上的过程追踪配对,因为理论预测了证据的使用。据我所知,这将是第一个联合改变三个成分的设计。单成分的构件已经定价(König et al., 2022; Ioku et al., 2024),相邻的捆绑已运行(Cetinkaya & Krämer, 2024,最接近的工具和一个功效校准源与Köbis et al., 2025),因此研究已确定规格、功效充足且准备就绪。该构念的边界条件是这些:当赌注低且数量高时,架构信任不值得;当验证者池在任务类上能力不足时,它增加很少;当答案空间紧密受限时,它可以证实错误;当面板独立性被宣称而不是测量时,它向表演退化,最尖锐的是开放红队问题一个被操纵的凭证看起来像什么? 超链接一旦成为权力信号,链接农场就出现来伪造它们;类似地,一致性记录也应该被预期会被伪造。两个时间边界也适用:线索赢得注意而证据赢得持久性,因此主张涉及哪个信任存活失败而不是哪个最快上线,甚至工作检查也可能只会减缓Chandra et al. (2026)模型的螺旋。在后果集中和独立性是真实的地方,架构信任赚得它的成本和它的名称(表12收集了四个)。
表12. 边界条件:架构信任不值得的地方
| 条件 | 为什么在那里失败 | 证据 |
| 低赌注、高量 | 验证成本超过错误的成本;单模型服务是正确的答案 | 盈亏平衡逻辑(图14) |
| 验证者池低于任务能力 | 缺乏能力的独立性无法传达任何信号 | 本地层空值:46%精度,无论是否一致 |
| 严格限制的答案空间 | 共识确认了错误而非发现错误 | 多选题下共识错误为4.0–7.9%,开放式为0.5–2.2% |
| 独立性被声称而非被测量 | 近似复制品小组营造信心 | 相关错误;区组和谱系缺失值 |
最后一个边界涉及任何提议的设计能够识别什么。智能体市场中的信任最终是一个均衡对象。一旦卖家、平台和竞争智能体适应了验证架构,其效果是适应市场的属性,而不是处理单元的属性。观察数据继承选择偏差,因为验证将首先在信任已经破裂的地方被采用。单位级随机化修复了选择偏差但在干扰处停止,因为被随机分配到收据的消费者仍然在一个卖家对每个人的收据同时做出反应的市场中交易。均衡数量需要集群、交替、二部或市场级设计;随机化架构而不是测量信任是下一个难题。而且早期智能体商务队列基于信任倾向自我选择,所以在早期采用者上估计的效果界定而不是估计总体效果。中立性之所以有价值,正是因为任何对模型有利益相关的人都无法提供它,包括任何对编排有利益相关的人。这个论证也描述了我构建的系统类型(作者注)。这个兴趣涉及倡导而不是证据的可重现性:所评估的模型是独立的、公开可访问的前沿系统,每个报告的数字都可以由第三方从冻结的复制包中重新计算。一个完全忽略倡导的读者仍然可以验证测量。
6. 消费者能否使用信号?初步行为测试
是否消费者能够使用该机制建立的正确性信号是一个独立的、行为学问题,我报告了一项关于此的预注册的、激励相容的实验。这项实地研究是一个存在性证明,而不是对一般效应的检验;它询问消费者是否能够对该信号采取行动。一项有充分统计功效的、确认性的、多项目的、刺激采样的、具有项目随机斜率的重复研究正在规划中。在最后招募阶段的主机故障导致数据收集在119个有效参与者处结束,而原计划为200个(合并一个软启动队列为133个;美国和英国;围绕代理购物助手的三个被试间条件;在六个激励事实性试验中测量的校准,表示为Δ = P(accept | correct) − P(accept | incorrect),Schemmer等人(2023)的适当依赖判别指数)。完整方法、试验、五项与注册的偏差、伦理和豁免披露以及所有辅助统计数据在下面的详细报告(§6.1–6.2)和复制包中。
显示的跨模型分歧总体上改进了校准(对照组Δ = 0.24 → 0.45; d = 0.67, 0.68 合并, p = .0001),但合并估计很脆弱:它由六个刺激中的一个维持,即唯一的高置信度异议项目,其中显示将对有把握的错误答案的接受从74%降至24%(合并队列,表18)。移除该项目会使效应降至d = 0.09 (p = .54),而移除任何其他项目则保持不变。收益集中在英国样本中。美国对照组(n = 16)在基线处已表现出判别能力(交互作用p = .002)。在小组本身同意一个错误答案的那一项上,显示在两个国家中都增加了接受,这是第3节的经认证共识错误模式在人类行为中的再现,也是一个独立的发现:呈现共识的架构将其唯一的系统性故障转移给了用户。P2证据成分的首次接触测试,即一份静态编排收据,对委托意愿没有产生可检测的影响(d = 0.21,在此统计功效下不确定;争议发生时的实时下钻收据是注册的后续)。
异议小组显示可以在消费者原本会接受的地方大幅削减对有把握错误建议的接受,但在小组同意错误答案的地方则失效。因此,校准对比在这六个刺激下具有行为学支持;如所述的P1,以感知风险为中介,不被该测试支持。P2–P4仍为开放课题。
6.1 行为测试:方法和试验
第3和5节的命题旨在被测试,上述测量计划说明了如何进行。该实验是对P1(显示的分歧下的依赖校准)和P2(可重放记录下的委托意愿)的预注册的、激励相容的在线测试,刺激来自旗舰波的真实多模型输出,将第二意见范式(Detjen等人,2025; Chen等人,2026)扩展到真实的、激励化的前沿模型分歧,采用架构框架。工具、协议冻结、试验、主波和冻结代码分析已完成并在下面报告。确认表在本文的早期版本中作为预注册的框架(单元格标记为[MAIN DATA PENDING])呈现,现在由冻结的分析代码填充。两个不利于假设的结果被预注册为可报告的主要发现:显示的分歧恶化校准(净依赖不足)以及收据降低委托意愿(披露反火);两者都没有发生,但其中一个预注册的零假设成立了。
方法。
设计和假设。信任校准需要将显示的一致性与答案的正确性相对照,但单个小案例无法做到。因此设计是混合的。参与者首先阅读一个购物委托小案例(一个AI购物代理"ShopAssist"推荐在$1,200预算内购买笔记本电脑),这是P2的主要测试,然后完成一个关于真实多模型输出的简短激励判断块,这是P1的主要测试。H1 (P1):展示来自多个独立AI系统的跨模型一致和不一致改进了消费者的信任校准(当答案正确时他们更多地接受代理提议的答案,当答案不正确时接受得更少),相比单一确信的答案;双边的,因为文献记录了联合呈现下既有过度依赖的减少也有依赖不足的增加。H2 (P2):获得一份编排收据(谁行动、他们如何同意、检查了什么以及完整的可重新验证的记录)增加了委托一项重要购买的意愿,超过仅显示不同意的效果;双边的,因为披露也可能降低信任。
条件。三个被试间条件,按1:1:1随机化,在小案例和判断块中保持不变:(1)控制,单一确信的推荐,无架构信号;(2)不同意,同样的推荐,前置一个由三个独立AI系统(匿名为系统A、B、C)组成的面板,带有明确的同意/不同意标记、系统的替代答案和陈述的信心、以及用平白语言表述的摘要;(3)不同意+证据,不同意屏幕加上编排收据卡,结构为谁行动 / 他们如何同意 / 检查了什么 / 完整记录。一个预注册的设计约束控制了明显的混杂:最后的推荐块(产品、价格和代理陈述的最终信心)在所有三个条件中逐字相同,在小案例和每个判断试验中都是如此,只有围绕它的架构信号不同。
刺激和收据。判断块刺激是三个前沿模型在真实事实问题上的真实输出,这些模型在这些问题上真正同意或不同意,陈述的信心很高(95–100);不存在杜撰的答案或信心。模型名称被替换为中立标签以避免品牌先验效应,映射在复制包中被披露。条件3中显示的收据(一个小案例收据和六个试验收据)由研究部署的生产收据生成器(架构`decision-receipt@v1`)基于刺激小组的实际出处日志生成,它们的验证哈希可以从记录中真正重新计算(验证日志:7/7有效)。因此实验的证据操纵是第3节定义的工件的实例。显示的焦点信心在正确性单元格中被紧密匹配(不正确的项95/98/99;正确的项99/99/100),而且关键是,在条件中相同。控制组看到相同的焦点信心,但区分远少,这是信心线索假说无法解释的。
指标。DV1 (H2):一个4项委托意愿量表(7点;例如,"我会让ShopAssist完成这次购买,而无需自己审查建议"),取平均;一个单项委托阶梯(0–4,从"仅建议"到"自主行动,包括不可退款的购买")是次要的。DV2 (H1):六个判断试验;在每个试验中,代理提议一个答案,参与者决定是否让助手继续(是/否),并评估对答案的信任(0–100滑块)。信任决策以准确性激励(每个正确的信任决策获得奖金,包括接受正确的答案或拒绝不正确的答案)。提议的答案在六个试验中恰好三个是正确的。每个参与者的校准分数是 Δ = P(accept | correct) − P(accept | incorrect),适当信任文献中的判别指数(Schemmer et al., 2023,其RAIR/RSR度量分解相同的对象);一个试验级混合效应模型可以获得项目级分辨率。感知风险和感知过程控制(各4项)在预注册的次要分析中作为中介被测量,分别用于P1和P2路径;感知编排器中立性(4项)被测量为P3的探索性相关因素,本研究未操纵P3。
冻结协议。 在主要数据收集之前冻结了预注册(分析代码和协议通过 SHA-256 在 2026 年 8 月 5 日冻结;OSF 注册在 8 月 13 日提交,在主要波次于 8 月 13–14 日进入现场之前;已注册禁运期(预注册,仅查看:https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f),将发布到论文的公开 OSF 组件,https://osf.io/jtvu9/)。六项目项集通过种子冻结:三个分歧项目由设计固定并手工验证,加上共识项目通过预设种子随机洗牌从池中得出,其中所有三个系统以规定的置信度 ≥ 95 给出相同答案,包括一个真实的共识错误,使得显示的一致性具有诊断价值但不完美,与源数据中的情况完全相同。六项对所有参与者相同;呈现顺序在问卷中随机化,尽管现场导出没有保留每项试验的显示顺序。现场显示没有呈现面板估计的独立性分数,这是该框架本身要求的测量多样性披露,所以参与者看到了系统之间的分歧,但没有看到这些系统有多独立。面板的独立性进行了测量但未显示,其在源数据集上的值在此事后报告:平均成对错误相关 φ = 0.22(三对中为 0.10–0.44,同一集团的两个成员的相关性最高,为 0.44;由研究的冻结确定性分级器分级,其解决 95–98% 的答案,对未解决的剩余部分如何编码不敏感),这说明面板既不独立也不克隆。这是下一个工具应该呈现给参与者的数字。一个刺激范围限制:有六个固定项目,无法估计处理与项目的相互作用,因此针对这些刺激确立了效果。会话以知情同意开始,以询问结束,询问中披露了虚拟情景购买的假设性质。研究按照《赫尔辛基宣言》进行:对在符合 GDPR 的面板上的英国和美国成年人进行的匿名、最小风险的调查研究,这些成年人已给予知情同意,补偿高于平台最低标准,没有欺骗,除了在询问中披露的虚拟情景外。根据这些标准,该研究满足了豁免完整伦理委员会审查的条件,豁免评估已在预注册中记录。受试者库现已关闭;逐字的项目集、答案和每项试验的收据标识符是禁运预注册的一部分,将随数据一起发布。
样本和分析计划。 目标 N = 200 个有效参与者(100 个美国,100 个英国;单独的 Prolific 研究;招聘上限 210),年龄 18 岁以上、英语流利、批准率 ≥ 98%、之前的提交数 ≥ 100、过去三个月内至少有过一次在线购买。预注册排除标准(在查看实质性回答之前应用):三个注意力检查中有两个或以上失败;完成耗时不足 3 分钟;直线应答;操纵检查失败(条件 2–3 中的一致性项目、条件 3 中的收据项目、产品理解项目);判断块理解测试两次失败;重复的 ID 或 IP;不完整的会话。确认分析:对于 H1,在汇总的分歧条件(2 和 3)与对照条件上对 Δ 进行 OLS 分析,以国家为协变量;对于 H2,限制在条件 2 和 3,对委托意愿复合分数在条件上进行 OLS 分析,以国家为协变量;跨 {H1, H2} 的 Holm 校正,族级错误率 α = .05;Welch t 检验作为稳健性分析;操纵检查在前报告。队列顺序在此处是固定的:主要确认分析是在主波队列上计算的,排除试点的软启动参与者,并将软启动队列汇总到确认样本中的分支报告为随附的稳健性分析。在查看主波之前已看到试点的探索性 Δ 描述性统计,因此从主要估计中排除该队列避免了甚至软形式的重复数据使用,同时保留了预注册的软启动包含作为报告的分支。主要报告将包括保留所有随机分配参与者的意向治疗分析,以及预注册的依方案分析。操纵检查排除将与按条件的脱落率差异检查一起报告,因为体系结构信号的显著性本身可能在条件间有所不同。统计功效:该设计在功效水平 .80 下,为 H1 检测到 d ≈ 0.42,为 H2 检测到 d ≈ 0.49,足以检测出相邻的依赖性和透明度文献中的中等效应。更小的效应留给研究议程的完整因子设计。三个预注册的元素回答了确认对比单独无法回答的机制问题。该工具在 P1 路径上包含一个四项目感知风险量表(试点 α = .881),因此风险知觉以测量的构念而不是假设进入分析。中介效应预注册为次要分析,感知风险中介分歧对依赖性的影响,感知过程控制中介收据对委托意愿的影响,通过自助法路径分析估计(PROCESS Model 4,5,000 次重新采样)。在条件 3 刺激屏幕上花费的时间被收集作为收据阅读的预注册代理变量,用于直接检验认知负荷替代假设,即参与者可能跳过收据而不处理。分析代码在数据收集前被冻结,并与复制包一起存档。
试点(软启动):标准和结果。
一项 n = 20(美国)的试点,在最终问卷上进行,预注册的通过标准事先固定,于 2026 年 8 月 6 日完成。表 13 报告了每个标准及其结果。
表 13。 试点接受标准(预注册)和结果(n = 20,美国)
| 标准(事先固定) | 结果 | 结论 |
| 注意到操纵:一致性检查正确率 > 80%(条件 2–3) | 81.3% (13/16) | 通过 |
| 注意到操纵:收据检查正确率 > 80%(条件 3) | 88.9% (8/9) | 通过 |
| Cronbach's α > .70, 委派意愿 (4 项) | .854 | 通过(也超过了 0.85 目标) |
| Cronbach's α > .70, 感知风险 (4 项) | .881 | 通过 |
| Cronbach's α > .70, 流程控制 (4 项) | .965 | 通过 |
| Cronbach's α > .70, 中立性 (4 项) | .851 | 通过 |
| 中位完成时间在10–15分钟内 | 9.60分钟 | 失败,快速方向快24秒 |
一项标准失败。中位数比预注册时间窗口快24秒,该窗口是为防止超时而设计的,而不是为了效率。快速尾部没有粗心回答的证据:没有参与者低于3分钟的排除阈值;唯一一个五分钟以下的参与者通过了所有注意力、操纵和理解检查;注意力检查通过率为95–100%;关键变量上没有缺失单元、没有重复ID或IP以及没有直线回答;招募平台的完成时间独立确认了调查计时器(中位数9.74分钟)。该工具在现场的耗时短于预算。条件平衡(在条件1/2/3中分别为4/7/9)与n = 20时的1:1:1随机化兼容(χ²(2) = 1.90, p = .387)。根据预注册分析排除标准,20名试点参与者中的6名被排除在确认性分析外(5人因操纵检查理由,1人因两次未通过理解检查),留下14名有效。根据软启动规则,试点队列以此处和注册本身所披露的时间偏差进入合并样本,该注册于2026年8月14日03:09 UTC之前提交至OSF,在主波收集之前,并说明软启动试点包含在具有所述时间偏差的确认性样本中;将主波队列视为主要确认性估计,将合并分支视为稳健性,是一项后注册分析决定,采取这一决定是因为试点描述统计在主波之前已被查看,两个分支都被报告;产品理解边际(一名参与者高于80%边界)在主波中被标记为需要监测。一个探索性描述统计,在试点样本处无推断报告:按条件的校准分数Δ为+0.33(对照组,n = 4)、+0.52(分歧,n = 7)、+0.22(分歧+证据,n = 9),因此分歧条件朝H1假设的方向变化;试点阶段无法得出更多结论。
6.2 行为测试:结果、探索性分析和剩余账目
确认性结果。
主波收集于2026年8月13–14日进行(190个位置:85个美国+105个英国,在软启动队列基础上),但未完成:调查主机在最后招募窗口期间遭遇技术故障,收集在共完成158次会话时结束(主波138次,软启动20次),而非200个有效目标。招募随平台故障而结束,根据预注册的可选停止规则,而非响应观察到的结果,尽管那时结果已被看到;后果是统计功效降低。在实现的单元格处,最小可检测效应从预注册的d ≈ 0.42(H1)和d ≈ 0.49(H2)上升至大约d ≈ 0.54和d ≈ 0.64在相同功效下,一个边界使确认性结果仅在一个方向上无关,并适用于以下每个零假设和探索性对比。队列排序遵循§6.1的计划。试点错过了一个通过标准(完成时间窗口,快速方向快24秒),其探索性描述统计在主波之前已被查看,因此主要确认性队列仅为主波(N = 119有效),而将相同字段的软启动队列重新纳入的分支(N = 133)作为稳健性报告。下面的每个数字都是数据收集前由SHA-256冻结的分析代码的输出。与注册的偏差汇总在一处:(i) N值不足(200个注册中133个有效;托管故障);(ii) 试点的完成时间标准在快速方向上快24秒;(iii) 每次试验的显示顺序未在现场导出中保留;(iv) 屏幕级计时未捕获;(v) 试验级混合模型在变分近似上运行(该软件包的最终引擎可能有所不同)。没有其他偏差;每项确认性测试都按注册运行,上述主要队列决定是唯一的后注册分析选择。
表14。 样本流和排除(主波;软启动队列见注)
| 美国 | 英国 | 总计 | |
| 已完成的会话 | 50 | 88 | 138 |
| 排除:注意力(≥3项检查中的2项) | 0 | 0 | 0 |
| 排除:速度(< 3分钟)/直线回答 | 0 | 0 | 0 |
| 排除:操纵/理解检查 | 10 | 9 | 19 |
| 排除:重复/不完整 | 0 | 0 | 0 |
| 有效N(按条件1/2/3) | 40(16/15/9) | 79(26/28/25) | 119(42/43/34) |
软启动队列增加了20个已完成的美国会话,其中14个通过相同的排除标准;它仅进入合并稳健性分支(N = 133)。主波中的每个排除都来自操纵和理解检查规则——没有参与者因不注意、加速、直线回答、重复或不完整而被排除——操纵检查门控显示无条件间不对称(MC1 χ²(1) = 0.12, p = .73;MC3 χ²(2) = 3.67, p = .16,在预排除样本上计算)。
表15。 H1(P1):按条件的依赖率校准Δ(主要队列,N = 119)
| 对照组 | 分歧 | 分歧+证据 | |
| Δ,均值(SD) | 0.238(0.332) | 0.465(0.274) | 0.422(0.299) |
| 过度依赖:P(接受|错误) | 0.603 | 0.434 | 0.510 |
| 不足依赖:1 − P(接受|正确) | 0.159 | 0.101 | 0.069 |
| 确认性对比:合并(2,3)对比对照,带国家协变量的OLS | b = +0.217, 95% CI [+0.104, +0.330], Holm调整后 p = .0005(d = 0.67) |
表16。 H2(P2):委托意愿,接收对比单独分歧(主要队列)
| 分歧(2) | 分歧 + 证据 (3) | |
| 委托意愿综合指标,平均值 (SD) | 3.09 (1.61) | 3.45 (1.79) |
| 委托阶梯,中位数 | 2 | 2 |
| 确认性对比:3 vs 2,带国家协变量的 OLS | b = +0.41, 95% CI [−0.35, +1.18], Holm 调整后 p = .29 |
在这项设计中,H1 在校准对比上得到支持;预先注册的通过感知风险的中介效应为零,因此按陈述的 P1 不被此检验所支持。面对单一自信答案,参与者几乎无法区分:他们在 84% 的正确答案和 60% 的错误答案上都允许代理进行(Δ = 0.238, 95% CI [0.14, 0.34];处理条件 0.465 [0.38, 0.55] 和 0.422 [0.32, 0.52])。分歧显示使校准效果几乎翻倍(汇总 Δ = 0.446;b = +0.217, p = .0002,Holm 调整后 p = .0005;Welch d = 0.67),且同时在两方面起效:过度依赖下降(60% → 43% 和 51%),而依赖不足也下降(16% → 10% 和 7%)(图 20)。该汇总平均值由单一项目驱动,最好理解为存在性证明而非稳健平均值:在控制组参与者以 74% 接受的单一高自信度异议试验中,显示将错误答案的接受率降至 24%;删除该试验后确认性对比不再显著(d = 0.09, p = .54),而删除任何其他单一项目则保持完整(d = 0.47–0.89)。下文的探索性分解(表 17–18)逐项定位该效应。其集中程度与在国家层面报告的相同空间依赖性相同:显示仅在校准差距存在的地方关闭它,而六个项目中的一个大幅打开了它。
图 20。 分歧显示对依赖的影响(主要队列)
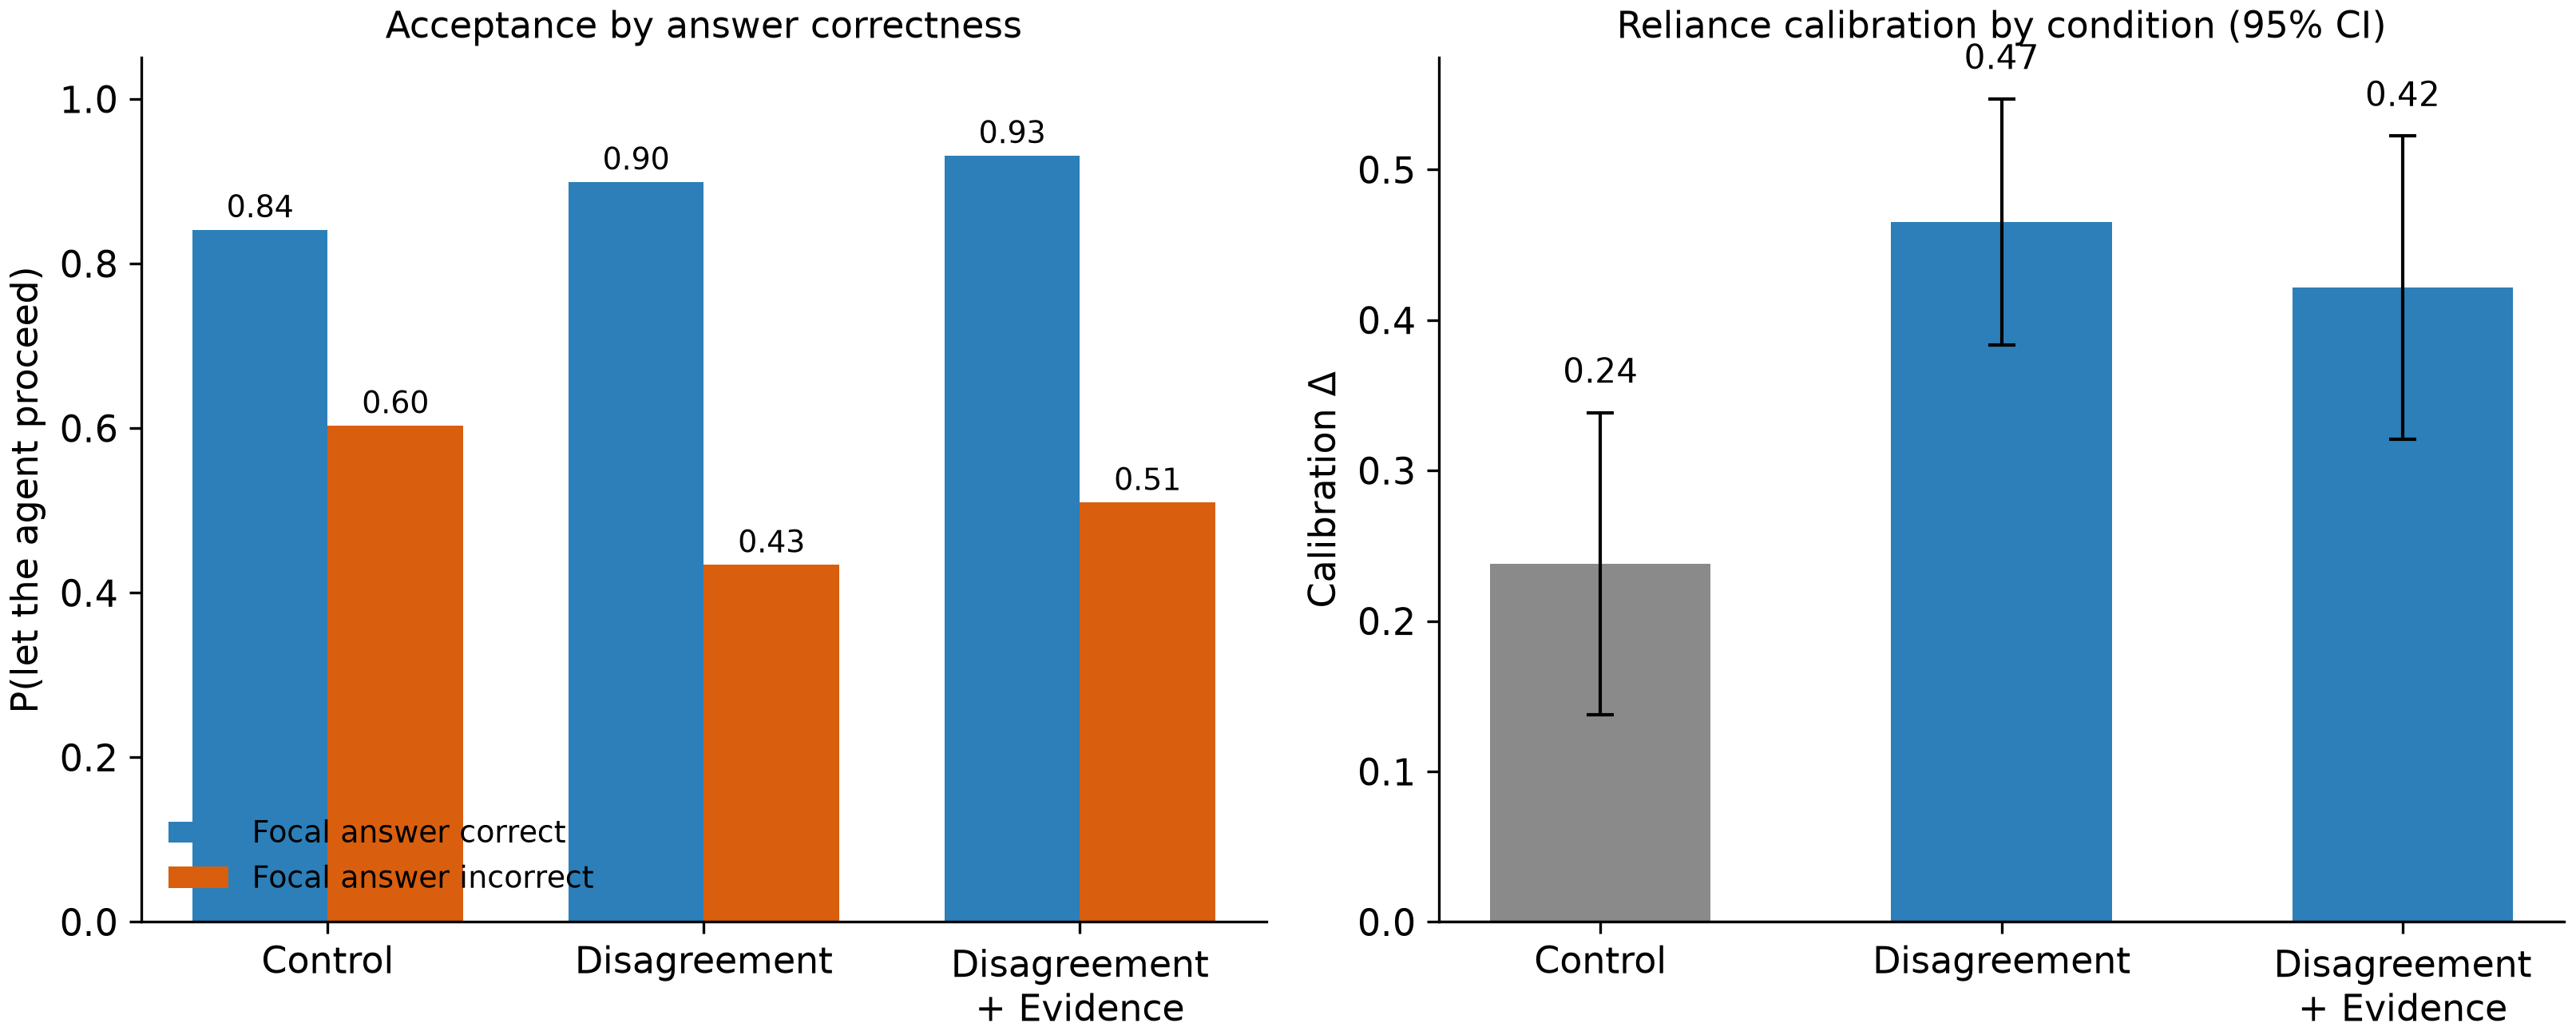
左:按条件的接受率,按焦点答案是否正确拆分(校准 = 一对柱子之间的差距)。右:按条件分列的参与者个体校准分数 Δ 及 95% 置信区间;确认性对比将两个分歧条件与控制组合并进行对比。
预先注册的双侧框架之所以存在,是因为二次意见文献记录了能够以增加依赖不足为代价来减少过度依赖的干预;这项干预没有付出那个代价。该信号使参与者更具区分能力,而非更具怀疑精神,对总体率的信号检测分解量化了这一点:灵敏度 d′ 从控制组的 0.74 上升到处理条件中的 1.44 和 1.46(由未四舍五入的比率计算),而反应标准几乎没有移动(−0.63 vs −0.56 和 −0.76)。试验级混合效应模型恢复了相同的结构,两个处理条件均存在大的正向正确性 × 条件交互。每个注册分支都同意:汇总稳健性分支(b = +0.215, p = .0001, d = 0.68)和意向治疗分支,纳入所有已完成的主波次会话,不论检验失败与否(b = +0.2174 vs +0.2169 per-protocol,p = .0001,n = 138),排除项在条件间均衡分布(8/6/5;χ²(2) = 0.34,p = .85),差异脱落检验 §6.1 规定(操纵检验排除项是处理后调节,根据 Montgomery, Nyhan, & Torres, 2018,因此无条件分支具有同等地位)。一项设计混淆限定了解读。分歧条件与控制组的不同之处不仅在于信号表述的内容,还在于显示的数量,三个位置和置信度而非一个,因此校准收益原则上可能反映信息量而非一致信号的内容。两个观察反驳信息量解读但未完全解决它:该效应逐项跟踪所显示信号的方向,因为在显示不同意的焦点错误项上,接受率下降,而在显示一致自信同意的单一项上,错误答案的接受率上升;且试验级交互与答案正确性相关,单纯信息量无法预测。该清晰对比设计(多个系统在每个试验上显示同意,信息量保持恒定)已为下一波次所规定。
H2不受支持。在已展示分歧显示的参与者中,收据对委托复合指标在实现功率下没有产生可检测的效果(3.45 vs 3.09; b = +0.41, p = .29; pooled branch b = +0.34, p = .33; composite reliability: main-wave Cronbach α = .89)。三个预先注册的次要结果决定了应如何解读零假设。收据确实被接收:收据条件下的中位会话时间比分歧条件下长约一分半钟(11.0 vs 9.4 分钟;屏幕级别的计时未在现场导出中捕获,因此总持续时间用作已注册的刺激时间代理)。额外的时间并不能证明参与者使用了收据。现场部署的收据是一张静态卡片,其"查看完整记录"可供性在调查中不是实时的,所以操作测试的是收据的存在,而不是其使用。实时下钻的收据是下一个设计包含的更强的操作。这是对一个静态收据显示的零假设,而不是对记录、可检查性或按书面所述的P2的零假设。收据还移动了其预先注册的中介。在收据条件下感知的过程控制上升(a = +0.60; scale reliabilities, main wave: process control α = .93, risk α = .83, neutrality α = .90),过程控制强烈预测委托(b = +0.60),bootstrap间接路径为正且排除零(indirect = +0.35, 95% CI [+0.02, +0.78], 5,000 resamples),而直接路径接近零。这是探索性的中介证据:中介变量在同一工具中进行了后处理测量,所以共同方法方差和反向解释仍然可能。敏感性限制了这个零假设能解决的问题。实现的单元只在注册的N处以功率.80检测d ≈ 0.49,所以中介路径暗示的大小的收据效果恰好是这个样本无法解决的大小。结果对小的和中等的效应是不确定的,只对更大的效应是决定性的。形式上,等价性检验仅粗略地限制了效果(TOST在α = .05处确立|d| < 0.64,而不是|d| < 0.5),JZS贝叶斯因子给出BF₀₁ ≈ 2.9(汇总分支3.1),在标准频带上支持零假设的轶事级证据(在或刚好超过3的轶事/中等边界);它既不证明缺失也不支持存在。测量部分预测了这一点:可检查性是一个按需属性,其价值应该在纠纷、索赔或审计时出现,所以在假设购买中读一次的静态收据可能是观察它的错误时刻。已注册的结论:P2的首次接触测试未能改变委托,收据的运营商端经济学(第5部分)不依赖于这个消费者端结果。两种解读仍然存在:要么证据成分在决策时刻的贡献比框架声称的要少,要么这个操作化是对它的错误检验。纠纷时间账户是一个事后假设,计划为在本节末尾命名的后续设计,而不是零假设的解决方案。第三种解读来自厌恶文献。详细的收据是一个显著性操纵,是对机制的暴露,提醒消费者在正好委托时刻可能出错多少,是程序细节压低而不是建立信任的透明度悖论(Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015)。这些相互竞争的解读、一个比声称的更弱的成分、一个错误时刻的检验和显著性反弹,做出不同的预测且可通过设计分离。
认证的共识错误模式在人类行为中重现。一个激励的试验按设计携带了一个真实的共识错误,所有三个系统自信地收敛到相同的错误答案,镜像了机制研究测量的0.5–2.2%的开放形式共识错误率。在那个试验中,单个项目因此是一个观察而非估计,分歧显示未能保护任何人,在两个国家都增加了对错误答案的接受(相对于对照增加4和14个百分点):参与者理性地将一致的独立同意解读为认证。所以架构的这一个系统性故障模式以高保真度转移到其用户。第3节给出了设计警告,即共识在小组多样性失败的地方恰好认证了错误,探针在行为中显示了相同的失败。
探索性:校准优势落在哪里。
以下所有内容都是探索性的且假设生成性的。国家单元很小,下面的每个国家内p值应被理解为描述性的。校准效果几乎完全集中在英国样本中,在美国样本中不存在:
表17。按国家和条件的校准Δ(探索性)
| 对照Δ | 分歧(汇总2, 3) Δ | 国家内效应大小 | |
| 英国(n = 79) | +0.103 (n = 26) | +0.447 (n = 53) | d = +1.19 |
| 美国(n = 40 primary / 54 pooled) | +0.458 / +0.433 | +0.444 / +0.471 | d = −0.05 / +0.13 |
| 国家×条件交互 | b = −0.36, p = .002 (primary); b = −0.31, p = .004 (pooled) |
分解法比交互作用更能提供信息。美国对照组参与者即使没有任何结构性信号也已经能够进行明确的区分,接受了92%的正确答案,但只接受了48%的错误答案,而英国对照组参与者几乎根本无法进行区分(78% vs 68%)。在分歧显示下,两个国家逐项变得几乎不可区分(所有六个试验中最大单元差为0.07)。干预措施使两个样本收敛到相同的校准端点(Δ ≈ +0.45),平衡了它没有创造的基线差异(图21)。这种模式的一部分是机械性的。Δ是有界的,因此随着基线校准提高,可用空间会缩小,"收益集中在基线最弱的地方"在一定程度上是测量方法的一个特性。然而,仅凭上限不会强制相同的端点或逐项配置文件匹配。最合理的理解是,六个项目对一个小组来说足够简单,无需帮助就能进行区分,因此显示关闭了存在的校准间隙。这种理解涉及的是空间,而不是关于国家,同样也涉及刺激:项目集本身具有文化倾斜(两个持异议者项目包含美国本地内容),因此收敛配置文件是这六个项目的特性,与这两个小组的特性一样。
图21. 收敛,而非统一回应(探索性研究)
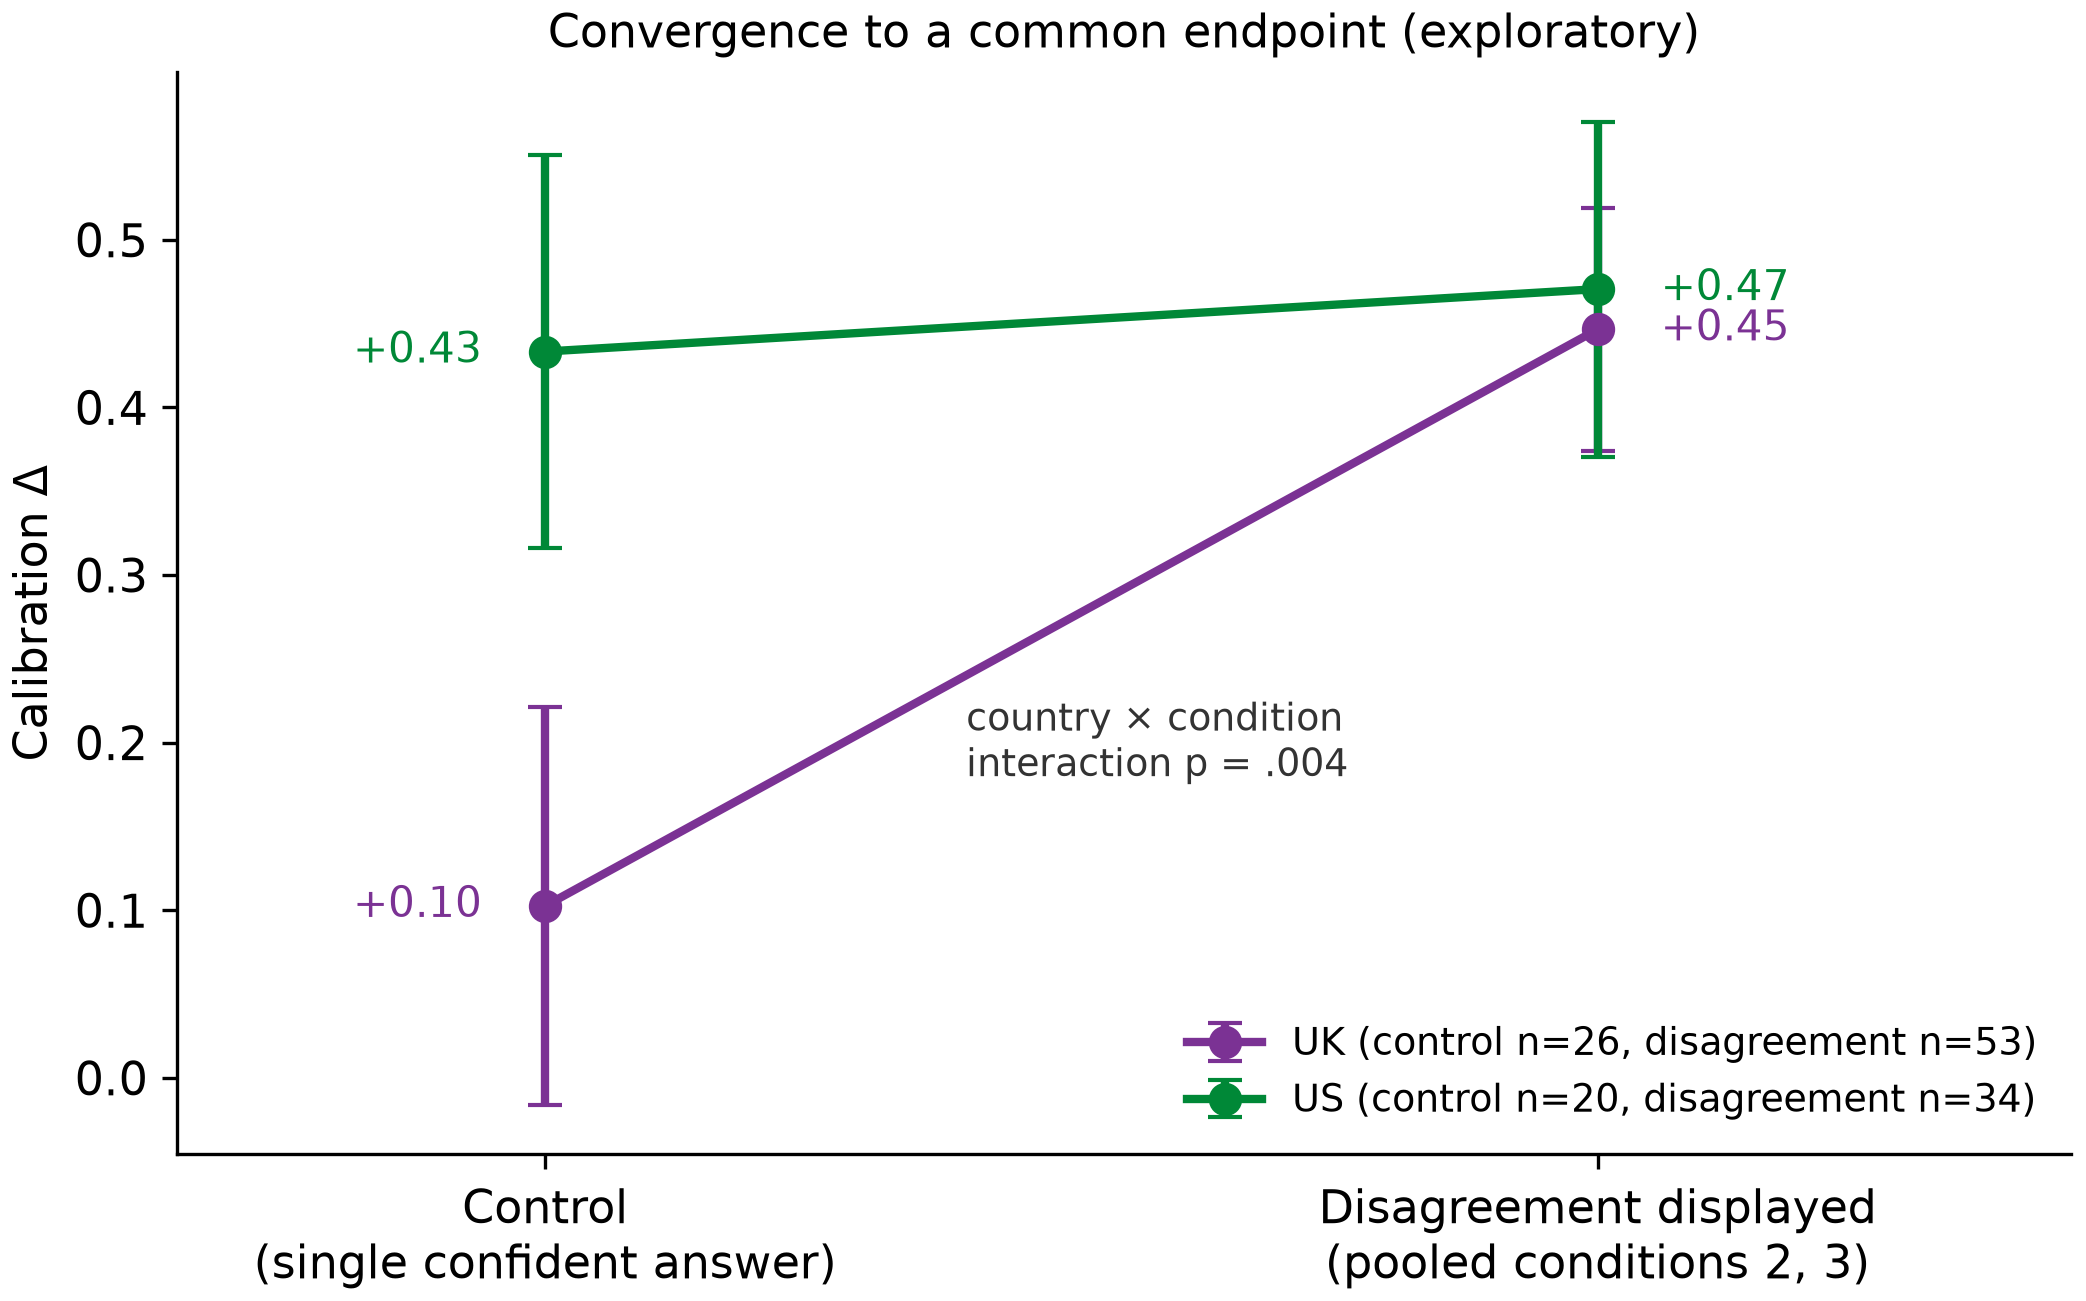
按国家和条件的校准Δ:美国对照组已经进行了区分(Δ ≈ +0.45);英国对照组几乎没有(Δ ≈ +0.10);在显示分歧下,两个国家都落在相同的端点上(Δ ≈ +0.45)。收益恰好集中在基线校准最弱的地方。
与此同时,美国在对照组中的优势集中在两个可能具有美国本地内容的异议者项目上。其中一个是关于Museum of Bad Art的问题,对于任何了解该博物馆宗旨的人来说,错误答案"Mona Lisa"都是荒谬的(美国接受率5% vs 英国27%)。这两个项目的集中表明的是项目级别的熟悉度,而不是民族性格。
表18. 按项目和单元分类的错误焦点答案接受率(探索性研究;合并队列)
| 单元 | 异议者错误,可信度95("Mona Lisa"项目) | 异议者错误,可信度98(ICM城市项目) | 共识错误,可信度99 |
| 英国对照(n = 26) | 0.27 | 0.85 | 0.92 |
| 美国对照(n = 20) | 0.05 | 0.60 | 0.80 |
| 英国分歧(n = 53) | 0.21 | 0.25 | 0.96 |
| 美国分歧(n = 34) | 0.18 | 0.24 | 0.94 |
干预措施的保护效应几乎完全作用于高可信度的异议者项目(英国−0.60,美国−0.36);在共识-错误项目上,显示在两个国家中都略微增加了接受率——一致同意被理解为认证,是机制研究的认证共识错误的行为表现。由于保护效应仅作用于这一个项目,合并的确认对比在移除它后无法保持显著性(d = 0.09,p = .54),尽管在移除任何其他单个项目后仍能保持显著性(d = 0.47–0.89)——效应的定量形式由一个项目承载。
表19. 按国家分类的态度量表(探索性研究;合并队列):差距是行为性的,而非态度性的
| 量表(1–7,除非另有说明) | 英国平均值 | 美国平均值 | 方向 |
| 曝露前对人工智能的信任 | 4.68 | 4.70 | 相同 |
| 委托意愿(综合) | 2.94 | 3.43 | 美国更高(p = .08) |
| 委托阶梯(0–4) | 1.71 | 1.98 | 美国更高(p = .08) |
| 感知风险 | 5.54 | 5.13 | 美国更低(p = .09) |
| 感知过程控制 | 4.17 | 4.56 | 美国更高(p = .14) |
| 感知中立性 | 4.75 | 4.62 | n.s. |
存在的每个态度差异都指向了美国怀疑论观点的"错误"方向:美国参与者更愿意委托,风险感知也较低,但在对照条件下表现出更好的行为区分。测量的态度无法解释这一点:针对人口统计特征和所有五个量表调整基线国家差异,最多可将其衰减15%;通过量表的自举间接路径为零。
跨国调查与态度无差异的结论一致。美国和英国对信任人工智能的陈述意愿本质上相同(41% vs 42%:Gillespie等人,2025),两个国家在人工智能焦虑问题上都位于相同的高警惕"英语圈"集群中(Ipsos,2025)。唯一指向观察到方向的人口水平不对称是人工智能素养。英国受访者自我报告在使用和评估人工智能方面的技能和信心较低(36% vs 42%在技能方面:Gillespie等人,2025),美国成年人是被调查的最接触人工智能的公众之一(Pew Research Center,2025)。因此,两种解释在探索性记录中得以保留。从熟悉度的角度,评估能力较弱的人口从在结构上评估它的架构中获益最多。另一种解释是小组构成:招聘平台的英国部分是其更年长和更有经验的参与者池,在线小组是国家间推理的不完美工具(Gvirtz & Sabherwal,2024),因此"国家"标签可能在一定程度上代理小组资历。该设计无法将两者分开,也不需要分开,因为在任何一个角度,实质性发现都是补偿特征本身。考虑到单元大小,更安全的默认做法是将该模式理解为这两个小组的特征,直到有充分统计功效的复制研究发言;本文中没有理论主张以此为基础。
该概况并非过度依赖干预的默认结果。认知强制函数减少过度依赖,但将其益处集中在已具有高认知需求的用户中,因此分析思维倾向的用户变得更加分析性(Buçinca et al., 2021),而自适应信任校准研究将针对校准不当的用户作为需要主动监控的设计目标(Okamura & Yamada, 2020)。这里的目标定位是免费的。显示的分歧是自触发的:它恰好在小组出现分歧时出现,并且事先对用户没有任何要求。其益处恰好落在基线判别力最差的群体上,并使已校准群体的准确性保持完整,而不是降低它。对于消费者保护机制,这是人们事前应指定的分布概况,帮助集中在校准不当的地方,对不需要它的人没有税收。
预注册的次要分析:剩余部分。
其余预注册的次要分析位于一个地方(主要队列;复制包中的汇总分支值)。通过感知风险的分歧效应的中介作用(该设计所预期的P1路径)为零。显示(如果有的话)略微减少了感知风险(a = −0.40),自举间接路径与零无法区分(+0.006, 95% CI [−0.013, +0.029])。校准效应是直接的,与参与者使用分歧模式作为关于答案的信息而不是作为交易的一般警报一致。感知协调者中立性(被测量而非被操纵)是控制条件和国家时委托意愿的强相关器(b = +0.47, p < .0001),相关性追踪P3所预测,等待其操纵。委托阶梯显示与复合相同的顺序,但未达到显著性水平(有序logit,收据vs分歧:b = +0.70, p = .11;中位数并列为2/4)。未注册的3对1条件委托对比在方向上为正但不显著(b = +0.52, p = .15)。一个偏差:实施的导出没有捕获屏幕级时序,因此注册的时间刺激收据阅读代理由总会话持续时间近似(在上面的H2下报告)。预期的屏幕级检查应该内置到下一波的仪器中。
本研究仅测试P1和P2。P3被测量而非操纵,P4和第5部分的完整联合变差联合保持作为指定的下一项研究。因此三元组的行为验证是不完整的:一个组成部分得到支持,一个不确定,一个被测量但未被操纵。一个纵向问题位于该程序之上。持久的分歧显示可能会稳定长期采用,作为算法欣赏和一次性厌恶之间振荡的阻尼器,或者它可能通过连续暴露于机器故障来耗尽该采用。单一会话设计无法确定。由上述结果激发的两项研究被添加到该程序。一项是争议时间设计,在预测其价值所在的时刻重新测试收据,使用虚假收据控制(一张哈希值不重新计算的收据),以将可验证性与其呈现分开。另一项是针对上面报告的国家调节进行的复制(Table 17)。
7. 结论
当人工智能调解重大消费者决策并越来越多地做出这些决策时,我主张信任必须沿着堆栈向上迁移:从模型到架构再到记录。多样性、证据和中立性共同产生一种可以检查其可信度而不是凭信心接受的服务。正在建设的不是更好的说服力,而是经济信任基础设施,即使委托能够规模化的问责链。旗舰波在市场顶端衡量这一点。在整个波的十个完整旗舰部门中汇总,作为各实验室最佳的模型在其所提供的已解决答案的近一半上确信无疑地是错的,说明置信度≥80(46.6%,当未解决项目被重新评分为错误时,该数字几乎没有变化)。部分Meta部门单独报告,包括它使该数字基本保持不变。它们上方的固定三模型分歧门,没有训练和调整,在既定的、可检查的覆盖成本下消除了五分之四的那些失败。因为这里的基质纯粹是事实性的,该比率应该被理解为混合商业任务的上限。对于适当的商务,许可该声明的将是在受约束的产品菜单上的检索基础、使用工具的复制,其中共识错误的表现与开放事实空间中不同。预注册的实验(Section 6)在消费者面前放置了相同的架构信号,并返回了他们可以将其作为正确性信号采取行动的证据:分歧显示将对合格项目的有信心的错误推荐的接受从74%降低到24%。在探索性国家分割中,它集中在过度依赖的英国单元中,并依赖于该单项(汇总对比在其移除后不再显著,d = 0.09)。这是在这些刺激下的存在证明,还不是一般效应;计划进行刺激采样确认测试。
这一层应该有自己的市场名称,证据基础设施,应该像销售云、身份和支付基础设施一样销售,因为它回答了同样的问题:"这能被信赖吗,我们怎么知道?"这是与"这聪明吗?"不同的问题。安全性和隐私都是这样发展的:区分因素,然后是期望,然后是进入要求。架构信任可以合理地遵循同样的路径,速度由已经可见的监管和责任压力决定。
我在理论层面的主张是,消费者对AI服务信任的分析单位应从模型转向架构,因为信任相关的属性实际上存在于那里:验证的独立性、决策的可重现性、利益冲突的缺失。模型在每项服务下不断变化,速度超过任何声誉追踪。闭源-开源性能差距在一年内从8.04%跌至1.70%(Stanford HAI, 2025),企业模型市场的领导权在春季期间更换(Kharazian, 2026)。如此快速商品化的层级不是信任能够锚定的地方。服务消费者的方式越来越多地跨越模型和价格层级,以成本驱动、不可见且未验证的方式进行,而选定的最佳模型服务于越来越少的用户。剩下的步骤,也是我在这里指定的步骤,是从最佳路由架构转向一种消费者、保险人或监管机构能够静止足够长时间来检查其验证的架构。在此之下是从AI助手到AI受信责任人的转变。受信责任人在曾有过他们的每个领域中,不是由他们的才能而是由他们的责任来构成的:保存记录、接受审计、没有不利利益。架构信任将这些责任内置到机制中。
同样的要求也适用于系统本身的增长方式。要求被信任处理重要行为的系统必须以可验证的方式增长。编排层的配置更改应该通过针对保留证据的审计统计门控进行提交或回滚,不能有自动化过程削弱安全规则,只能添加规则。案例研究中的研究部署实现了这些门控。
AI基础设施现在需要一个验证层(图16)。该行业已建立了计算层和模型层,现在正在建立编排层。之后是验证,这是使AI系统行为可检查而非依赖声誉的机制。该 根据 对于AI信任应该变为机器可验证而非基于声誉;信任本身保持为人的,机器可以检查的是其根据。如果这是对的,AI基础设施的下一个不可或缺的层将建立在可验证性而非智能周围。
图16。 基础设施阶梯
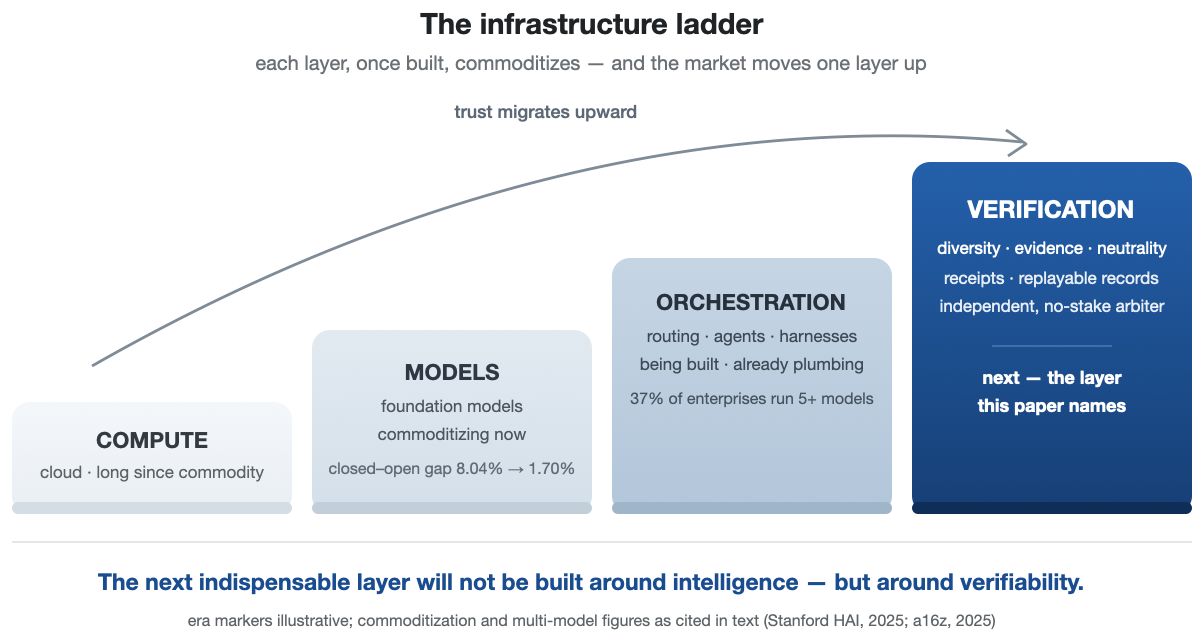
计算,然后是模型,然后是编排,以及作为下一个不可或缺的层的验证。
作者注记和披露
第4节中描述的部署是由作者开发和运营的参考实现;它所体现的方法是开放的,作者是待审核专利申请的指定申请人(非已授予专利),涉及本文所审视的AI编排和多模型验证系统。它在这里作为研究的研究工具,作者对其所体现的架构有开发者的利益;第4节应该被理解为存在证明和设计见证,而非独立评估。本研究中的所有模型都是通过供应商的标准商业API以普通条款访问的。没有外部资金支持这项工作。
工具和验证。AI助手在作者的指导下被用作工具;想法、研究和结论属于作者。承重的事实声明是根据可用的主要来源进行检查的,并在文中以其证据状态进行明确标注(新闻报道标注为报道、指控标注为指控、预印本标注为预印本),并维护一份带日期的声明验证日志与手稿的工作材料。实验中的正确性从不由任何面板模型判断(评分是客观的字符串匹配或本地公开权重评级器),每个供应商的区分度和校准数字被打印在主文本中(表7和7a),每个报告的数字都可以从确定性复制包中重新计算(公开可用于https://osf.io/jtvu9/)。
数据和代码可用性
机制实验(第3节)中报告的每个数字都可以从确定性复制包中重新计算——来自两个波次的原始模型响应(包括16个模型集合的24,000个答案和主要波次的评分记录)、数据收集工具、确定性评级器、分析脚本和衍生的CSV(包括风险覆盖曲线和26点成本-准确性前沿,每个点的计费与标价差异被标记)——公开可用于https://osf.io/jtvu9/,是预注册源项目的公开组件(文件夹`replication-package-v2`;第3节的自校准程序存档与其一起存放)。冻结的SimpleQA子样本(由种子和SHA-256哈希固定)已在机制研究的OSF预注册处公开(https://osf.io/4y9dv,注册于2026年7月23日)。消费者实验的预注册在OSF上注册但处于禁运中(在主数据收集前冻结;注册https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f)。参与者池已关闭;调查工具、小故事和判断任务刺激、第6节的收据生成记录以及带有冻结分析代码的消费者实验数据将在发布时释放到同一OSF组件中。
参考文献
标记为arXiv的条目是预印本;行业公告和2026年新闻项是时事报道而非已发表文献,因此按此方式引用。
a16z — Andreessen Horowitz (2025). 2025年100位企业首席信息官如何构建和购买生成式AI。 a16z.com/ai-enterprise-2025。
Accenture (2026). 与我的AI助手交谈:品牌价值的新规则。 2026年1月对16个国家的25,590名消费者的调查。
ACI Worldwide (2026). 消费者对AI驱动购物和支付的态度。 YouGov对2,080名英国成人的调查,2026年6月19-22日进行。新闻稿。
Ahmad Husairi, M., & Rossi, P. (2024). AI购买任务委托:感知选择和决策自主权的作用。决策支持系统,179,114166。DOI 10.1016/j.dss.2023.114166。
AIUC (2025). AIUC-1:代理标准。 人工智能承保公司。
Alavi, S., & Nozari, S. (2026). 当代理为你购物时:AI介导市场中的角色一致性。arXiv:2604.26220。
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). What is your AI agent buying? Evaluation, biases, model dependence, and emerging implications of agentic e-commerce. Proceedings of the ACM Web Conference 2026, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express debuts Agentic Commerce Experiences (ACE) developer kit and announces industry-first protection for registered agent purchases. 新闻稿, 14 April 2026.
Anderson, L. (2006). Analytic autoethnography. Journal of Contemporary Ethnography, 35(4), 373–395.
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). Consumer choice and autonomy in the age of artificial intelligence and big data. Customer Needs and Solutions, 5(1–2), 28–37.
Appenzeller, G. (2024). Welcome to LLMflation: LLM inference cost is going down fast. Andreessen Horowitz, November 2024.
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). State of AI: An empirical 100 trillion token study with OpenRouter. arXiv:2601.10088 (已发布报告 December 2025).
Bain & Company (2025). Agentic commerce market projection: $300–500 billion U.S. e-commerce by 2030. December 2025.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779.
Balaskas, S. (2026). From recommendations to delegation: A systematic review mapping agentic AI in e-commerce and its consumer effects. Information, 17(3), 222.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–16.
Basu, A. (2026). Tool receipts, not zero-knowledge proofs: Practical hallucination detection for AI agents. arXiv:2603.10060.
Board of Governors of the Federal Reserve System & OCC (2011). Supervisory guidance on model risk management (SR Letter 11-7 / OCC 2011-12).
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), 1–21.
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). A systematic review of algorithm aversion in augmented decision making. Journal of Behavioral Decision Making, 33(2), 220–239.
California State Legislature (2025). Assembly Bill 316 (artificial intelligence: defenses), Stats. 2025, ch. 672 (adding Cal. Civ. Code § 1714.46), effective 1 January 2026.
Carlson, S. C. (2026). Trust migration in the digital era: Information regimes and the transformation of buyer–seller relationships. Atlantic Marketing Journal, 15(1), Article 6.
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). Task-dependent algorithm aversion. Journal of Marketing Research, 56(5), 809–825.
Cetinkaya, N. E., & Krämer, N. (2024). Understanding vs. trust: A conjoint analysis. 工作论文, OSF Project mw4dq.
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). Sycophantic chatbots cause delusional spiraling, even in ideal Bayesians. arXiv:2602.19141.
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). When AI disagrees: The effect of second opinion on patients' trust in doctors. International Journal of Human-Computer Studies, 213, 103824.
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Sycophantic AI decreases prosocial intentions and promotes dependence. Science, 391(6792), eaec8352. DOI: 10.1126/science.aec8352.
Choi, H. K., Zhu, X., & Li, S. (2026). When identity skews debate: Anonymization for bias-reduced multi-agent reasoning. Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 14284–14311. https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). An empirical study of group conformity in multi-agent systems. Findings of the Association for Computational Linguistics: ACL 2025, 5123–5139. https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). Regulatory markets for AI safety. arXiv:2001.00078.
CNBC (2026, March 24). OpenAI revamps shopping experience in ChatGPT after struggling with Instant Checkout offering (据 The Information March 2026 关于 native-checkout pullback 的报道)。
Daly, C. (2025). Klarna slows AI-driven job cuts with call for real people. Bloomberg News, 8 May 2025.
de Bellis, E., & Johar, G. V. (2020). Autonomous shopping systems: Identifying and overcoming barriers to consumer adoption. Journal of Retailing, 96(1), 74–87.
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). Who is trusted for a second opinion? Comparing collective advice from a medical AI and physicians in biopsy decisions after mammography screening. CHI 2025.
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). From 'automation' to 'autonomy': The importance of trust repair in human–machine interaction. Ergonomics, 61(10), 1409–1427.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114–126.
DigiCert (2026). AI Trust Architecture. Product announcement, April 2026.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Dranove, D., & Jin, G. Z. (2010). Quality disclosure and certification: Theory and practice. Journal of Economic Literature, 48(4), 935–963.
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Improving factuality and reasoning in language models through multiagent debate. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 11733–11763.
Endsley, M. R., & Kiris, E. O. (1995). The out-of-the-loop performance problem and level of control in automation. Human Factors, 37(2), 381–394.
Errico, H. (2026). Autonomous action runtime management (AARM): A system specification for securing AI-driven actions at runtime. arXiv:2602.09433.
欧盟委员会(2026)。Guidelines on the implementation of the transparency obligations for certain AI systems under Article 50 of the AI Act。2026年7月20日采纳。
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024)。Detecting hallucinations in large language models using semantic entropy。Nature, 630(8017), 625–630。
Featherman, M. S., & Pavlou, P. A. (2003)。Predicting e-services adoption: A perceived risk facets perspective。International Journal of Human-Computer Studies, 59(4), 451–474。
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026)。Consumer acceptance of high-autonomy AI assistants is driven by perceived benefits in online shopping settings characterized by scarcity。Psychology & Marketing, 43(3), 538–555。https://doi.org/10.1002/mar.70074
Gartner (2025)。Gartner predicts over 40% of agentic AI projects will be canceled by end of 2027. 新闻稿,2025年6月25日。
Gartner (2026)。Consumer survey on generative AI in shopping(2026年5月新闻稿)。
Gefen, D., Karahanna, E., & Straub, D. W. (2003)。Trust and TAM in online shopping: An integrated model。MIS Quarterly, 27(1), 51–90。
Geifman, Y., & El-Yaniv, R. (2017)。Selective classification for deep neural networks。Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500)。
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025)。Trust, attitudes and use of artificial intelligence: A global study 2025. 墨尔本大学与KPMG。https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020)。Human trust in artificial intelligence: Review of empirical research。Academy of Management Annals, 14(2), 627–660。
Google (2026)。Universal Commerce Protocol。 于2026年1月11日在NRF公告;购物车、目录和身份关联扩展,2026年3月。
Google Cloud (2025)。Agent Payments Protocol (AP2)。 公告,2025年9月16日。
Google DeepMind (2025)。SimpleQA Verified。arXiv:2509.07968。
Gorbett, M., & Jana, S. (2026)。Cross-model disagreement as a label-free correctness signal。arXiv:2603.25450。
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026)。Accelerating scientific discovery with Co-Scientist。Nature, 655(8122), 487–496。https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991)。The self-manipulation of my pervasive, perceived vital energy through product use: An introspective-praxis perspective。Journal of Consumer Research, 18(2), 194–207。
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017)。On calibration of modern neural networks。ICML 2017, PMLR 70, 1321–1330。
Gvirtz, A., & Sabherwal, A. (2024)。The limits of doing global, cross-cultural behavioral science research。Proceedings of the National Academy of Sciences, 121(36), e2316690121。
Hadfield, G. K. (2017)。Rules for a flat world: Why humans invented law and how to reinvent it for a complex global economy. Oxford University Press。
Hadfield, G. K., & Clark, J. (2026)。Regulatory markets: The future of AI governance。Jurimetrics, 65, 195–240 (arXiv:2304.04914)。
Hansen, L. K., & Salamon, P. (1990)。Neural network ensembles。IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001。
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026)。Not all flips are conformity: Decomposing stance convergence in multi-agent LLM debate。arXiv:2606.00820。
Hoff, K. A., & Bashir, M. (2015)。Trust in automation: Integrating empirical evidence on factors that influence trust。Human Factors, 57(3), 407–434。
Hong, L., & Page, S. E. (2004)。Groups of diverse problem solvers can outperform groups of high-ability problem solvers。Proceedings of the National Academy of Sciences, 101(46), 16385–16389。
Huang, M.-H., & Rust, R. T. (2021)。A strategic framework for artificial intelligence in marketing。Journal of the Academy of Marketing Science, 49(1), 30–50。
Insurance Services Office (2026)。Endorsement forms CG 40 47 and CG 40 48: generative artificial intelligence exclusions. 自2026年1月1日起生效。
Internet Engineering Task Force (2026)。An architecture for trustworthy and transparent digital supply chains (RFC 9943; SCITT工作组)。IETF。https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024)。Trade-offs in AI assistant choice: Do consumers prioritize transparency and sustainability over AI assistant performance?。Big Data & Society, 11(4)。
Ipsos (2025)。The Ipsos AI Monitor 2025. Ipsos全球顾问咨询,30个国家调查,2025年6月。
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021)。Formalizing trust in artificial intelligence: Prerequisites, causes and goals of human trust in AI。FAccT 2021, 624–635。
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022)。Language models (mostly) know what they know。arXiv:2207.05221。
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025)。Why language models hallucinate。arXiv:2509.04664。
Kharazian, A. (2026)。Anthropic beats OpenAI on business adoption。Ramp Economics Lab / Ramp AI Index,2026年5月13日(来自50,000多家美国企业的公司支付数据)。
Kim, D., & Benbasat, I. (2010)。Designs for effective implementation of trust assurances in internet stores。Communications of the ACM, 53(2), 121–126。
Kim, E., Garg, A., Peng, K., & Garg, N. (2025)。Correlated errors in large language models。Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066。
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). 消除怀疑的阴影:道歉与否认对修复胜任力与诚信信任破裂的影响。 Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). 多少信息?透明度对算法界面中信任的影响。 CHI 2016, 2390–2395.
Klarna (2024). Klarna AI助手在其首个月处理了三分之二的客户服务聊天。 新闻稿,2024年2月27日。
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). 委托给人工智能可能会增加不诚实行为。 Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). 人工智能代理的治理。 Notre Dame Law Review, 101 (SSRN working paper 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). 个性化和熟悉度对信任和推荐代理采纳的影响。 MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). 消费者愿意为可解释的AI付费,但不愿意为绿色AI付费:基于选择的联合分析证据。 Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). 神经网络集合、交叉验证和主动学习。 Advances in Neural Information Processing Systems, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). 可问责的算法。 University of Pennsylvania Law Review, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). 分类器集合中的多样性度量及其与集合精度的关系。 Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). 自动化中的信任:为适当依赖而设计。 Human Factors, 46(1), 50–80.
Lessig, L. (2006). 代码:2.0版本。 Basic Books.
Li, M. (2025). 从云原生到信任原生:可验证多代理系统的协议。 arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). 语言模型的整体评估。 Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). 为人工智能系统中的负责任信任而设计:沟通视角。 FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). 教授模型用言语表达其不确定性。 arXiv:2205.14334.
Lindsey, J. (2025). 大型语言模型中的涌现内省意识。 Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion:支持多代理系统的开放式团队合作。 arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). 信息披露和认证中介。 RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). 算法欣赏:人们更喜欢算法判断而非人工判断。 Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). 对医疗人工智能的抵触。 Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). 算法转移:人们对政府人工智能失败的过度推广。 Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). 社会影响如何破坏群体智慧效应。 Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). 更多建议有帮助吗?第二意见在人工智能辅助决策中的影响。 Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). 在人工认识论代理中构建信任。 arXiv:2603.02960.
Mastercard (2026). Verifiable Intent(与Google共同开发)。 新闻室公告,2026年3月5日;2026年在亚洲和拉丁美洲市场报告的早期试点。
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). 组织信任的整合模型。 Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). 代理商务机遇(Schumacher、Roberts和Giebel)。 2025年10月17日。
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). 为电子商务开发和验证信任度量。 Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). 2025年中期LLM市场更新。 2025年7月31日(150名技术决策者的调查)。
Menlo Ventures (2025b). 2025:企业中生成式AI的状态。 2025年12月9日(495名美国企业AI决策者的调查;Menlo Ventures是Anthropic投资者)。
Menlo Ventures (2025c). 2025:消费者AI的状态。 2025年6月26日(5031名美国成年人的调查,与Morning Consult合作;约3%的付费用户数字是从收入推导的估计)。
Möhlmann, M., & Zalmanson, L. (2017). 掌握方向盘:应对算法管理和Uber司机的自主权。 ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). 后处理变量的条件化如何会破坏您的实验以及应对方法。 American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). 代理商务预测:到2030年,美国电子商务支出为$190–385 billion。 2025年12月。
Mosier, K. L., & Skitka, L. J. (1996). 人类决策者和自动化决策辅助工具:天作之合吗? 见R. Parasuraman & M. Mouloua(编辑),自动化和人类绩效:理论与应用(第201–220页)。Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). 学习推迟到专家的一致估计量。 ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). 社会影响偏差:一个随机实验。 Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Trust in automation: Part I. Theoretical issues in the study of trust and human intervention in automated systems. Ergonomics, 37(11), 1905–1922.
NIST (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0) (NIST AI 100-1). National Institute of Standards and Technology.
Okamura, K., & Yamada, S. (2020). Adaptive trust calibration for human-AI collaboration. PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). Position: Agentic AI orchestration should be Bayes-consistent. arXiv:2605.00742. (被ICML 2026接受。)
Parasuraman, R., & Manzey, D. H. (2010). Complacency and bias in human use of automation: An attentional integration. Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). Consumer acceptance of electronic commerce: Integrating trust and risk with the technology acceptance model. International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). How people around the world view AI. 25国调查,2025年10月。
Piehlmaier, D. M. (2023). The one-man show: The effect of joint decision-making on investor overconfidence. Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). Consumers and artificial intelligence: An experiential perspective. Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). Towards a science of AI agent reliability. arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). Outsider oversight: Designing a third party audit ecosystem for AI governance. AIES 2022, 557–571.
Regulation (EU) 2016/679 (General Data Protection Regulation), 第22条——自动化个人决策。
Regulation (EU) 2024/1689 (Artificial Intelligence Act), 第14条——高风险人工智能系统的人类监督;第50条——某些人工智能系统提供者和部署者的透明度义务。
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). AI scientists produce results without reasoning scientifically. arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). Shrinking the generation-verification gap with weak verifiers. arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). Review on computational trust and reputation models. Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). Appropriate reliance on AI advice: Conceptualization and the effect of explanations. IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). The transparency dilemma: How AI disclosure erodes trust. Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). Accurately measuring willingness to pay for consumer goods: A meta-analysis of the hypothetical bias. Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). The social control of impersonal trust. American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). Towards understanding sycophancy in language models. ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274。
Sheridan, T. B., & Verplank, W. L. (1978). Human and computer control of undersea teleoperators (技术报告)。MIT Man-Machine Systems Laboratory.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Should we be going MAD? A look at multi-agent debate strategies for LLMs. ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). Why different trust relationships matter for information systems users. European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). The Oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission. arXiv:2605.00844.
Stanford HAI (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence (技术性能章节)。
Stanford HAI (2026). Artificial Intelligence Index Report 2026. Stanford Institute for Human-Centered Artificial Intelligence (公众舆论章节,报告Pew 25国调查数据)。
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). Customer evaluations of service complaint experiences: Implications for relationship marketing. Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). When combinations of humans and AI are useful: A systematic review and meta-analysis. Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Visa (2025). Visa introduces Trusted Agent Protocol: An ecosystem-led framework for AI commerce. 新闻稿(与Cloudflare),2025年10月14日。
Visa (2026)。Visa与OpenAI合作推动下一代AI商务。新闻稿,Visa支付论坛,2026年6月10日。
W3C (2025)。Verifiable Credentials Data Model v2.0. W3C推荐标准。
Wallendorf, M., & Brucks, M. (1993)。消费者研究中的内省:实施与启示。Journal of Consumer Research,20(3),339–359。
Walsham, G. (1995)。信息系统研究中的解释性案例研究:性质与方法。European Journal of Information Systems,4(2),74–81。
Wang, W., & Benbasat, I. (2005)。在线推荐代理的信任与采用。Journal of the Association for Information Systems,6(3),72–101。
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026)。从代理跟踪到信任:LLM代理中证据追踪和执行来源的调查。arXiv:2606.04990。
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024)。测量大型语言模型的短文本真实性。arXiv:2411.04368。
Werbach, K. (2018)。The blockchain and the new architecture of trust. MIT Press。
Wertenbroch, K. (1998)。通过理性分配美德与恶行购买数量来实现消费自控。Marketing Science,17(4),317–337。
Xiao, B., & Benbasat, I. (2007)。电子商务产品推荐代理:使用、特征和影响。MIS Quarterly,31(1),137–209。
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022)。赞成还是反对:消费者对算法与人类决策的反应。Journal of Marketing Research,59(4),696–717。
Yin, R. K. (2018)。Case study research and applications: Design and methods (第6版)。Sage。
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020)。信心和解释对AI辅助决策中准确性和信任校准的影响。Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency,295–305。
Zheng, J., & Zhang, J. (2026)。多LLM系统的不确定性感知信任估计:基于结构化专家判断。arXiv:2607.20529。
Zuboff, S. (2019)。The age of surveillance capitalism. PublicAffairs。
Zucker, L. G. (1986)。信任的生产:1840–1920年经济结构的制度来源。Research in Organizational Behavior,8,53–111。
* AI系统架构师。利益冲突:作者开发多模型编排方法,运营本文所述架构的参考实现,是涵盖本论文所研究的AI编排和多模型验证系统的待审专利申请的具名申请人(而非已授予的专利),并对本论文提倡的架构具有开发者的利益;关于其必要性的规范性主张应在考虑这种利益的情况下理解。作者在第4部分部署中的角色在本论文末尾的《作者说明和披露》中阐述。欢迎评论:[email protected]。↩︎
如何引用
Chernets, V. (2026)。Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture [预印本]。SSRN。https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}