IA para documentos judiciales: detecta citas falsas antes de presentar
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
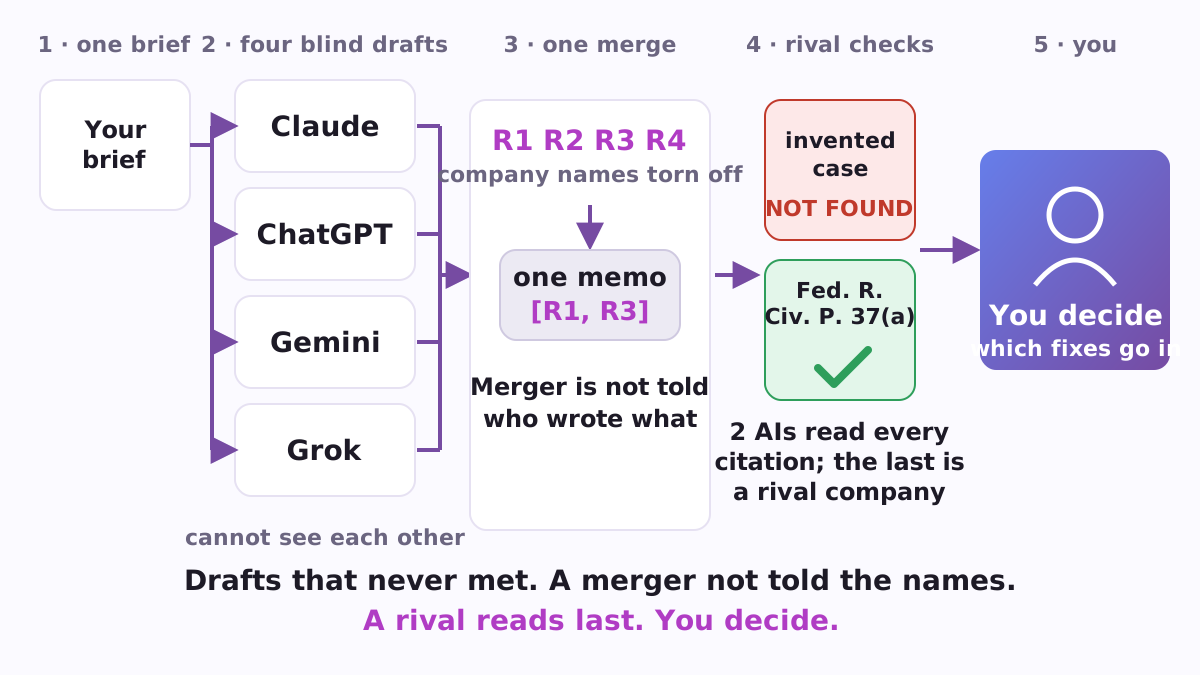
Si compareces ante un tribunal sin abogado y usas ChatGPT, Claude o Gemini para ayudarte con la documentación, el error más costoso no es la redacción torpe. Es una frase segura que cita un caso que no existe. Docprep es un programa gratuito y de código abierto que cambia cómo se organizan las IAs en lugar de cuál IA usas. Varios sistemas de IA de diferentes empresas redactan cada uno un borrador completo del mismo documento sin verse entre sí. Una IA fusiona los borradores sin que se le diga qué empresa escribió cuál. Luego dos IAs verifican el texto fusionado, las citas en primer lugar, y la última de ellas proviene de una empresa diferente a la que realizó la fusión. Obtienes el documento, ambos informes de verificación y un registro de la ejecución, y decides qué correcciones se aplican.
Se ejecuta en tu propia computadora. Con claves API (las contraseñas que permiten a un programa comunicarse directamente con los modelos de una empresa de IA), se ejecuta por sí solo. Sin ellas, te entrega cada paso como un archivo para pegar en los sitios de chat de IA que ya usas y continúa desde donde lo dejaste. Funciona para cualquier documento cuyas afirmaciones necesiten fuentes, como un informe, una apelación de seguros o una queja a un regulador, y su tarea de ejemplo es una moción que un litigante que se representa a sí mismo podría necesitar.
Por qué una IA no es suficiente para una presentación judicial
Las citas fabricadas no son accidentes raros. El 10 de octubre de 2026, la base de datos de casos de alucinación de IA mantenida por el investigador Damien Charlotin listaba 2,184 decisiones judiciales que tratan contenido generado por IA como citas falsas; en 1,259 de ellas la parte era una persona que se representaba a sí misma. En agosto de 2026, un tribunal de apelaciones de California ordenó a un marido y una esposa que habían apelado sin abogado pagar los honorarios de abogados del otro lado en la apelación, porque habían confiado en autoridades inexistentes y citas fabricadas (Sala de prensa de los Tribunales de California). El tribunal federal del Distrito Medio de Georgia dice claramente a las partes que se representan a sí mismas que "la IA no alivia la responsabilidad de una parte de asegurarse de que todos los hechos y autoridades legales citados en los escritos ante el tribunal sean precisos" (M.D. Ga.).
Más personas enfrentan ese trabajo: la proporción de casos civiles federales estadounidenses presentados sin abogado aumentó de un promedio a largo plazo del 11% al 16.8% en el año fiscal 2025 (Shah y Levy, a través de beSpacific). Los modelos más nuevos no lo solucionan por sí solos. Los investigadores de Princeton verificaron más de 8,000 citas de ocho generaciones de modelos ChatGPT gratuitos y encontraron que GPT-5.1 alucina al 6.57%, "una regresión estadísticamente significativa". El mismo estudio señala el remedio en torno al que se construye Docprep: un verificador de IA que puede buscar en bases de datos legales y la web abierta detectó todas las citas inexistentes en la prueba (Princeton CITP).
Cómo funciona
Docprep lleva una tarea escrita a través de cinco pasos, y cada paso se define por lo que la IA en él puede ver.
- Un solo escrito. Escribes la tarea una sola vez: qué necesitas, la jurisdicción, el formato, qué cuenta como fuente. El ejemplo solicita un memorándum sobre si un litigante que se representa a sí mismo en tribunal federal puede presentar una moción para obligar respuestas de descubrimiento que fueron respondidas solamente con objeciones estándar.
- Borradores separados. Al menos tres IA de al menos tres empresas cada una escriben un borrador completo, con búsqueda web donde esté disponible. Ninguna ve el borrador de otra. Cada una debe citar una fuente para cada declaración, marcar lo que no pudo verificar como «no verificado», y no «inclinarse hacia una posición intermedia», de modo que los desacuerdos sean evidentes.
- Una fusión ciega. Una IA recibe los borradores como R1, R2, R3 en orden aleatorio; un borrador que nombra a su autor tiene esa frase reemplazada con "[vendor name removed]". La fusión etiqueta cada afirmación con los borradores detrás de ella, como en [R1, R3], y escribe un registro de en qué estuvieron de acuerdo los borradores, en qué no estuvieron de acuerdo y cómo se resolvió cada conflicto. Una fusión sin ese registro detiene el proceso.
- Una revisión interna. Una IA de la propia empresa de la fusión lee el resultado en una sesión nueva, verifica que cada fuente existe y dice lo que se afirma, clasifica los hallazgos como Crítico, Mayor y Menor, y da un veredicto.
- Una revisión externa. Una IA de una empresa diferente lee el documento y el primer informe, confirma o cuestiona cada hallazgo, añade los suyos propios y da el veredicto de cierre.
Todo termina en una carpeta: el escrito, cada indicación y borrador, el documento fusionado, el registro de fusión, ambos informes y un registro manifest.json. Ninguna corrección del crítico se aplica a tu texto automáticamente; tú eliges. Las referencias de página puntuales merecen tu atención más cercana, puesto que es donde incluso los verificadores de IA basados en búsqueda son más débiles (el agente de Princeton capturó solo el 18.2% de referencias de página incorrectas), y abrir el expediente en la página citada lo resuelve.
Por qué estas reglas
- Los borradores nunca se encuentran. En debates de IA, los modelos a menudo cambian de una respuesta correcta a una incorrecta cuando un homólogo argumenta de manera convincente (Wynn, Satija and Hadfield, 2025).
- No se le dice al combinador quién escribió qué. Los jueces de IA tienden a calificar su propio resultado más alto, y pueden reconocerlo (Panickssery, Bowman and Feng, 2024). La clave de las etiquetas va solo al registro, para que pueda contar más tarde cuántas veces un combinador favoreció a su propia empresa.
- El último lector proviene de otra empresa. En un estudio de más de 350 modelos, cuando ambos estaban equivocados dieron la misma respuesta equivocada aproximadamente el 60% del tiempo en un tablero de clasificación (Kim et al., ICML 2025). Un crítico capacitado en otro lugar es la ruta más directa hacia los puntos ciegos compartidos.
- Todo crítico debe poder buscar. Docprep se niega a iniciar si un crítico no tiene una herramienta de búsqueda.
- Las reglas son código.
python3 docprep.py checkrechaza una configuración que las rompe, por ejemplo una donde el crítico de cierre proviene de la empresa del combinador o los redactores provienen de menos de tres empresas.
Lo que el registro te proporciona
El manifiesto registra, para cada paso, el modelo, ya sea que se ejecutó a través de una API o manualmente, huellas digitales de la indicación y la respuesta, la hora, la clave de las etiquetas y ambos veredictos. Incluso registra si una herramienta de búsqueda estaba realmente adjunta a cada solicitud. Algunos tribunales preguntan sobre el uso de IA: el Distrito Norte de Texas requiere que un escrito preparado con IA generativa "revele este hecho en la primera página" (LR 7.2(f)). Una carpeta de ejecución de Docprep contiene exactamente el material para tal aviso. También ahorra dinero: resume ejecuta solo los pasos que aún no tienen archivo, por lo que una llamada fallida nunca repite una llamada pagada.
Dos formas de ejecutarlo
A mano, en los sitios de chat, sin clave API. La fórmula manual escribe un archivo MANUAL-<role>.md para cada paso con el mensaje y el modelo a utilizar. Pegue en un chat nuevo, pegue la respuesta debajo de la línea marcadora y ejecute resume. Una ejecución completa son siete pegadas: cuatro borradores (Claude, ChatGPT, Gemini y Grok), la fusión y dos comprobaciones. Las reglas tienen en cuenta de qué empresa proviene un modelo, no el plan que pague, y esta ruta también le permite utilizar los modos de investigación profunda de los sitios de chat.
Con claves API, automáticamente. Establezca claves para Anthropic, OpenAI y Google, y Docprep llama a los modelos por sí mismo, cada uno con su propia herramienta de búsqueda de su empresa; Grok y un modelo Llama pueden unirse como redactores adicionales. La configuración de ejemplo tiene una fórmula básica para documentos rutinarios y una mejorada para cualquier cosa que leerá un tribunal, construida a partir de modelos disponibles en septiembre de 2026; cualquier conjunto de diferentes empresas que respete las reglas funcionará.
El protocolo se llama a sí mismo una rampa: «Fue construido para alguien que no puede subir las escaleras: que no puede mantener cinco interfaces abiertas a la vez, leerlas una contra la otra y llevar la respuesta de vuelta.» Docprep hace el transporte.
Cómo difiere de un consejo de LLM
Docprep pertenece a la familia de consejos de LLM, debate multiagente y LLM como juez. El popular llm-council de Andrej Karpathy tiene modelos que se clasifican entre sí con nombres ocultos, luego un modelo "Chairman" escribe una respuesta final. Docprep difiere en cuatro aspectos, todos aplicados por código: los redactores nunca se leen entre sí, al fusionador no se le dice quién escribió qué, el veredicto final proviene de una empresa diferente a la del fusionador, y cada paso deja un registro. También se detiene antes de cualquier reescritura final: obtienes el documento y los informes, no un texto corregido silenciosamente para ti.
Cómo empezar
Necesita Python 3 y el código de la página de GitHub.
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
Con claves de API, coloque los nombres de modelos que ofrecen sus cuentas en config.yaml, luego ejecute python3 docprep.py check y python3 docprep.py run --brief briefs/my-brief.md --formula enhanced. Las pruebas sin conexión (python3 -m pytest tests/test_offline.py, cinco pruebas) ejecutan toda la canalización sin claves ni red.
De dónde proviene
Docprep es la implementación de referencia del protocolo en el artículo The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice de Vadym Chernets (SSRN 7120940, DOI 10.2139/ssrn.7120940). El artículo argumenta que la forma en que se organiza la ayuda de IA, un modelo consultado una sola vez o varios modelos de diferentes empresas verificándose mutuamente, es una variable en la calidad de lo que presentan los litigantes que se representan a sí mismos, y se basa en un caso federal en el cual el autor fue la parte demandante sin abogado. El código es un archivo Python bajo la licencia MIT, el texto del protocolo PROTOCOL.md está bajo CC BY 4.0, y todo está en github.com/vadimchernets/docprep. Para hacer una pregunta a las herramientas de IA en tu ordenador, consulta After Chat y Sidecall; para consultar los sitios de chat de IA a través de tu propio navegador, consulta Roundcall.
Vadym Chernets también crea Poly A1, una aplicación en la que las IA de diferentes empresas verifican el trabajo de una a otra.