IA para Documentos Judiciais: Identifique Citações Falsas Antes de Protocolar
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
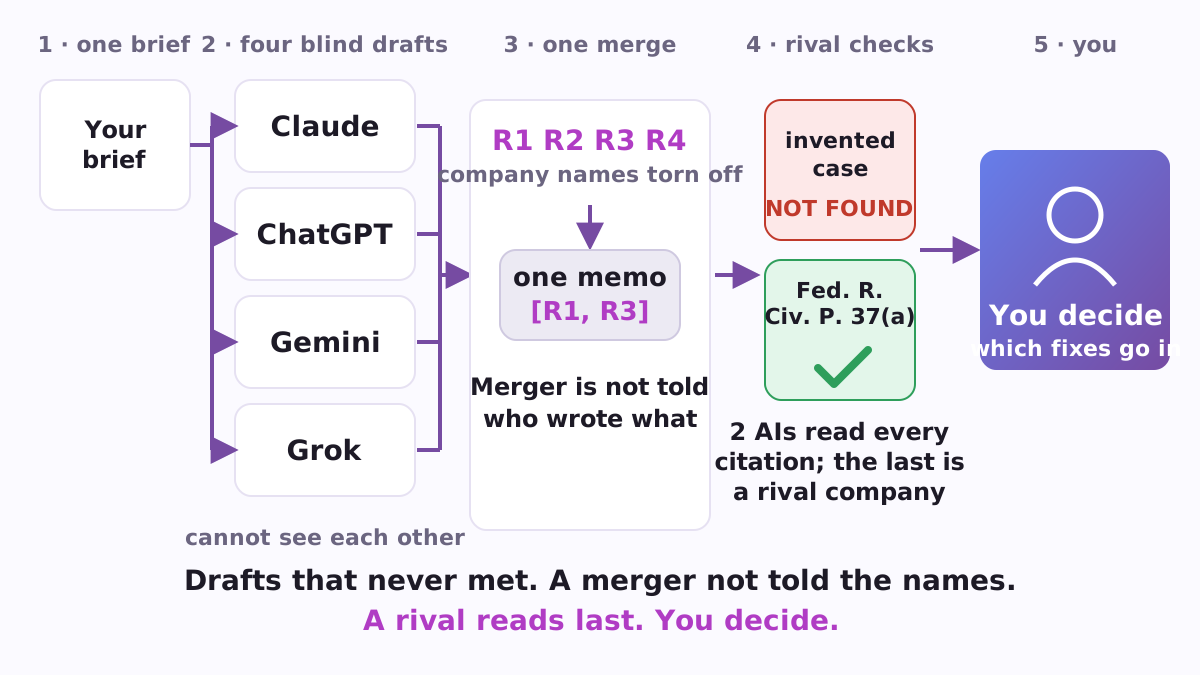
Se você vai aos tribunais sem um advogado e usa ChatGPT, Claude ou Gemini para ajudar com a documentação, o erro mais caro não é uma redação desajeitada. É uma frase segura que cita um caso que não existe. Docprep é um programa gratuito de código aberto que altera como as IAs estão dispostas, e não qual IA você usa. Várias IAs de empresas diferentes escrevem cada uma um rascunho completo do mesmo documento sem se verem uma à outra. Uma IA funde os rascunhos sem ser informada qual empresa escreveu qual. Duas IAs então verificam o texto fundido, citações primeiro, e a última delas vem de uma empresa diferente daquela que o fundiu. Você obtém o documento, ambos os relatórios de verificação e um registro da execução, e você decide quais correções incluir.
Ele roda no seu próprio computador. Com chaves de API (as senhas que permitem que um programa converse diretamente com os modelos de uma empresa de IA) ele funciona sozinho. Sem elas, ele fornece a você cada etapa como um arquivo para colar nos sites de chat de IA que você já usa, e continua de onde você parou. Funciona para qualquer documento cujas alegações precisam de fontes, como um relatório, um recurso de seguros ou uma reclamação a um regulador, e sua tarefa de exemplo é uma moção que um litigante que se representa a si mesmo poderia precisar.
Por que uma IA não é suficiente para uma petição judicial
Citações fabricadas não são acidentes raros. Em 10 de outubro de 2026, o banco de dados de Casos de Alucinação de IA mantido pelo pesquisador Damien Charlotin listava 2.184 decisões judiciais que tratam de conteúdo produzido por IA, como citações falsas; em 1.259 delas, a parte era uma pessoa se representando. Em agosto de 2026, um tribunal de apelações da Califórnia ordenou a um casal que havia apelado sem advogado que pagasse as custas advocatícias da outra parte em apelação, porque tinham se baseado em autoridades inexistentes e citações fabricadas (California Courts Newsroom). O tribunal federal do Distrito Médio da Geórgia informa claramente às partes que se representam que "IA não alivia a responsabilidade de uma parte de assegurar que todos os fatos e autoridades legais citados em petições judiciais sejam precisos" (M.D. Ga.).
Mais pessoas enfrentam essa tarefa: a parcela de casos civis federais dos EUA apresentados sem advogado aumentou de uma média de longo prazo de 11% para 16,8% no ano fiscal de 2025 (Shah and Levy, via beSpacific). Modelos mais recentes não resolvem o problema isoladamente. Pesquisadores de Princeton verificaram mais de 8.000 citações provenientes de oito gerações de modelos gratuitos do ChatGPT e encontraram o GPT-5.1 alucinando em 6,57%, "uma regressão estatisticamente significativa". O mesmo estudo aponta a solução em torno da qual o Docprep foi desenvolvido: um verificador de IA capaz de pesquisar bancos de dados jurídicos e a web aberta detectou todas as citações inexistentes no teste (Princeton CITP).
Como funciona
Docprep leva uma tarefa escrita por cinco etapas, e cada etapa é definida pelo que a IA nela pode ver.
- Uma instrução única. Você escreve a tarefa uma única vez: o que você precisa, a jurisdição, o formato, o que conta como fonte. O exemplo pede um memorando sobre se um litigante autônomo em tribunal federal pode requerer a compelição de respostas de descoberta respondidas apenas com objeções padronizadas.
- Rascunhos separados. Pelo menos três AIs de pelo menos três empresas diferentes redigem, cada uma, um rascunho completo, com busca na web quando disponível. Nenhuma delas vê o rascunho da outra. Cada uma deve citar uma fonte para cada afirmação, marcar o que não conseguiu verificar como "não verificado" e não buscar uma posição intermediária, para que as discordâncias apareçam.
- Uma fusão cega. Uma IA recebe os rascunhos como R1, R2, R3 em ordem aleatória; um rascunho que nomeia seu criador tem essa frase substituída por "[nome do fornecedor removido]". O mesclador marca cada afirmação com os rascunhos atrás dela, como em [R1, R3], e escreve um registro do que os rascunhos concordaram, onde discordaram e como cada conflito foi resolvido. Uma mesclagem sem esse registro interrompe a execução.
- Uma verificação interna. Uma IA da própria empresa do mesclador lê o resultado em uma nova sessão, verifica que cada fonte existe e diz o que é afirmado, classifica os achados como Crítico, Maior e Menor, e emite um veredicto.
- Uma verificação externa. Uma IA de uma empresa diferente lê o documento e o primeiro relatório, confirma ou contesta cada descoberta, adiciona as suas próprias e emite o veredicto final.
Tudo desemboca em uma pasta: a instrução, cada prompt e rascunho, o documento mesclado, o registro de mesclagem, ambos os relatórios e um arquivo manifest.json. Nenhuma correção do crítico é aplicada automaticamente ao seu texto; você escolhe. Números de página precisos merecem seu escrutínio mais rigoroso, pois é onde até os verificadores de IA com busca na web são mais fracos (o agente de Princeton capturou apenas 18,2% das citações de página incorretas), e abrir o caso na página citada resolve.
Por que essas regras
- Os rascunhos nunca se encontram. Em debates de IA, modelos frequentemente passam de uma resposta correta para uma errada quando um colega argumenta de forma persuasiva (Wynn, Satija and Hadfield, 2025).
- O consolidador não é informado sobre quem escreveu o quê. Juízes de IA tendem a pontuar seu próprio resultado mais alto e conseguem reconhecê-lo (Panickssery, Bowman and Feng, 2024). A chave dos rótulos fica apenas no registro, para que você possa depois contar com que frequência um consolidador favoreceu sua própria empresa.
- O último leitor vem de outra empresa. Em um estudo com mais de 350 modelos, quando dois estavam ambos errados, eles deram a mesma resposta errada cerca de 60% das vezes em um ranking (Kim et al., ICML 2025). Um crítico treinado em outro lugar é o caminho mais direto para os pontos cegos compartilhados.
- Todo crítico deve ser capaz de pesquisar. Docprep recusa-se a iniciar se um crítico não tiver uma ferramenta de pesquisa.
- As regras são código.
python3 docprep.py checkrecusa uma configuração que as quebre, por exemplo uma em que o crítico final vem da empresa do consolidador ou os rascunhadores vêm de menos de três empresas.
O que o registro oferece
O manifesto registra, para cada etapa, o modelo, se foi executado por meio de uma API ou manualmente, as impressões digitais da instrução e da resposta, o horário, a chave para os rótulos e ambos os vereditos. Ele até registra se uma ferramenta de busca foi realmente anexada a cada solicitação. Alguns tribunais perguntam sobre o uso de IA generativa: o Distrito Norte do Texas exige que um parecer preparado com IA generativa "divulgue esse fato na primeira página" (LR 7.2(f)). Uma pasta de execução do Docprep contém exatamente o material para tal aviso. Também economiza dinheiro: resume executa apenas as etapas que ainda não têm arquivo, então uma chamada que falhou nunca repete uma já paga.
Duas maneiras de executá-lo
Manualmente, nos sites de chat, sem chave de API. A fórmula manual escreve um arquivo MANUAL-<role>.md para cada etapa com o prompt e o modelo a usar. Você cola em um chat novo, cola a resposta de volta sob a linha de marcação e executa resume. Uma execução completa consiste em sete colagens: quatro rascunhos (Claude, ChatGPT, Gemini e Grok), a mesclagem e duas verificações. As regras se importam com qual empresa um modelo vem, não com qual plano você paga, e este caminho também permite que você use os modos de pesquisa profunda dos sites de chat.
Com chaves de API, automaticamente. Defina chaves para Anthropic, OpenAI e Google, e Docprep chama os modelos por si próprio, cada um com sua própria ferramenta de busca da empresa; Grok e um modelo Llama podem se juntar como rascunhadores extras. A configuração do exemplo tem uma fórmula básica para documentos rotineiros e uma aprimorada para qualquer coisa que um tribunal lerá, construída a partir de modelos disponíveis em setembro de 2026; qualquer conjunto de diferentes empresas que mantenha as regras servirá.
O protocolo se chama uma rampa: "Foi construído para alguém que não consegue subir as escadas: que não consegue manter cinco interfaces abertas ao mesmo tempo, compará-las entre si e levar a resposta de volta." Docprep realiza esse transporte.
Como difere de um conselho de LLM
Docprep pertence à família de conselhos de LLM, debate multi-agente e LLM como juiz. O popular llm-council de Andrej Karpathy tem modelos que se classificam mutuamente com nomes ocultos, então um modelo "Chairman" escreve uma resposta final. Docprep difere de quatro maneiras, todas impostas por código: os redatores nunca leem uns aos outros, o mesclador não é informado sobre quem escreveu o quê, o veredicto final vem de uma empresa diferente daquela que realiza a mesclagem, e cada etapa deixa um registro. Ele também para antes de qualquer reescrita final: você obtém o documento e os relatórios, não um texto silenciosamente corrigido para você.
Como começar
Você precisa de Python 3 e do código de a página do GitHub.
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
Com chaves de API, coloque os nomes de modelos que suas contas oferecem em config.yaml, depois execute python3 docprep.py check e python3 docprep.py run --brief briefs/my-brief.md --formula enhanced. Os testes offline (python3 -m pytest tests/test_offline.py, cinco testes) executam todo o pipeline sem chaves ou rede.
De onde vem
Docprep é a implementação de referência do protocolo no artigo The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice de Vadym Chernets (SSRN 7120940, DOI 10.2139/ssrn.7120940). O artigo argumenta que a forma como a ajuda de IA é organizada, um modelo consultado uma vez ou vários modelos de diferentes empresas verificando uns aos outros, é uma variável na qualidade do que litigantes em causa própria arquivam, e se baseia em um caso federal no qual o autor era a parte sem advogado. O código é um arquivo Python sob a licença MIT, o texto do protocolo PROTOCOL.md está sob CC BY 4.0, e tudo está em github.com/vadimchernets/docprep. Para fazer uma pergunta às ferramentas de IA no seu computador, veja After Chat e Sidecall; para consultar os sites de chat de IA através do seu próprio navegador, veja Roundcall.
Vadym Chernets também desenvolve Poly A1, um aplicativo em que IAs de diferentes empresas verificam o trabalho umas das outras.