ШІ для судових документів: Виявіть фальшиві посилання перед поданням
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
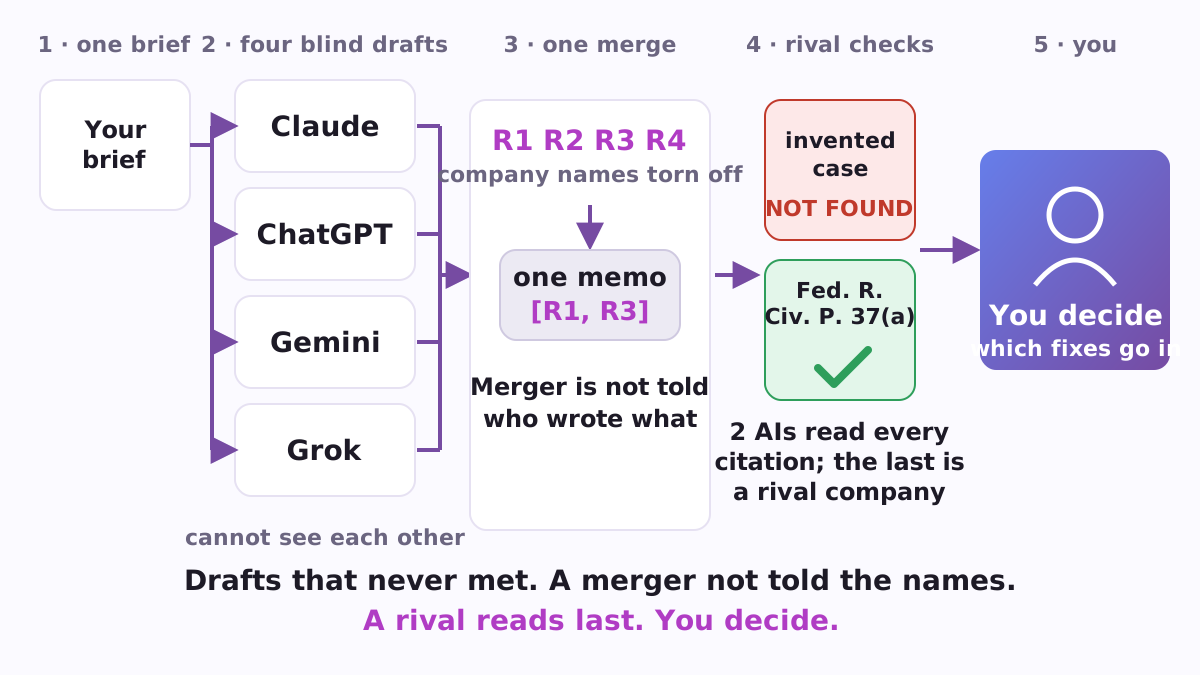
Якщо ви йдете до суду без адвоката та використовуєте ChatGPT, Claude або Gemini для допомоги з документацією, найдорожішою помилкою є не незграбне письмо. Це впевнена фраза, яка посилається на справу, яка не існує. Docprep — це безплатна програма з відкритим кодом, яка змінює те, як розташовані ШІ, а не те, який ШІ ви використовуєте. Кілька ШІ від різних компаній кожна пише повний проект одного й того самого документа, не бачачи один одного. Один ШІ об'єднує проекти, не знаючи, яка компанія що написала. Два ШІ потім перевіряють об'єднаний текст, спочатку посилання, і останній з них походить від іншої компанії, ніж той, що здійснив об'єднання. Ви отримуєте документ, обидва звіти перевірок, запис про запуск, і ви вирішуєте, які виправлення внести.
Він запускається на вашому власному комп'ютері. З API ключами (паролями для прямого спілкування програми з моделями компанії ШІ) він запускається самостійно. Без них програма передає вам кожний крок як файл для вставлення в чат-сайти ШІ, які ви вже використовуєте, і продовжує з того місця, де ви зупинилися. Він працює з будь-яким документом, чиї твердження потребують джерел, таких як звіт, апеляція зі страховки або скарга регулятору, і його прикладне завдання — це клопотання, яке може знадобитися самопредставленому позивачу.
Чому одного штучного інтелекту недостатньо для судового позову
Вигадані цитати - це не рідкісні помилки. На 10 жовтня 2026 р. база даних AI Hallucination Cases database, яку веде дослідник Damien Charlotin, містила 2184 судові рішення, що розглядають контент, створений штучним інтелектом, такий як вигадані цитати; у 1259 з них однією зі сторін була особа, яка представляла себе самостійно. У серпні 2026 р. апеляційний суд Каліфорнії наказав подружжю, яке подало апеляцію без адвоката, сплатити гонорар адвоката іншої сторони при апеліюванні, тому що вони покладалися на неіснуючі юридичні джерела та сфабриковані цитати (California Courts Newsroom). Федеральний суд Середнього округу Джорджії прямо повідомляє сторонам, які представляють себе самостійно, що «штучний інтелект не звільняє від обов'язку сторони переконатися, що всі факти та юридичні джерела, на які посилаються в судових документах, є точними» (M.D. Ga.).
Більше людей стикаються з цим завданням: частка цивільних справ у федеральних судах США, поданих без адвоката, зросла з довгострокового середнього показника 11% до 16,8% у фіскальному 2025 році (Shah and Levy, via beSpacific). Новіші моделі самі по собі не вирішують цю проблему. Дослідники з Принстона перевірили понад 8000 цитат з восьми поколінь безкоштовних моделей ChatGPT і виявили, що GPT-5.1 генерує галюцинації на рівні 6,57%, «статистично значимий регрес». Те саме дослідження вказує на рішення, навколо якого побудовано Docprep: верифікатор на основі штучного інтелекту, якому дозволено здійснювати пошук у юридичних базах даних і відкритій мережі, виявив кожну вигадану цитату в тесті (Princeton CITP).
Як це працює
Docprep бере одне написане завдання через п'ять кроків, і кожен крок визначається тим, що AI в ньому дозволено побачити.
- Один бріф. Ви пишете завдання один раз: що вам потрібно, юрисдикцію, формат, що вважається джерелом. Приклад просить меморандум про те, чи може самопредставлений позивач у федеральному суді подати клопотання про примус розкриття, якщо на запити надано лише шаблонні заперечення.
- Окремі проекти. Щонайменше три AI з щонайменше трьох компаній кожен пишуть повний проект, з веб-пошуком де доступно. Жоден не бачить проекту іншого. Кожен повинен посилатися на джерело для кожного твердження, позначити те, що не міг перевірити, як «неперевірене», і не схилятися до середнього положення, щоб розбіжності були видні.
- Сліпе злиття. Один AI отримує проекти як R1, R2, R3 у випадковому порядку; проект, який називає свого автора, має цю фразу замінену на «[назву постачальника видалено]». Злиття позначає кожне твердження проектами, на яких воно засновано, як у [R1, R3], і записує журнал того, в чому проекти були згодні, в чому вони розходилися і як кожен конфлікт було вирішено. Злиття без цього журналу зупиняє процес.
- Перевірка зсередини. AI з компанії того, хто виконував злиття, читає результат у новій сесії, перевіряє, що кожне джерело існує і говорить те, що стверджується, ранжує виявлення на Критичні, Серйозні та Незначні, і дає висновок.
- Перевірка ззовні. AI з іншої компанії читає документ і перший звіт, підтверджує або заперечує кожне виявлення, додає свої власні та дає заключний висновок.
Все потрапляє в одну папку: бріф, кожне завдання та проект, об'єднаний документ, журнал злиття, обидва звіти та запис manifest.json. Жодна правка критика не застосовується до вашого тексту автоматично; ви вибираєте. Точні номери сторінок заслуговують на вашу найуважнішу увагу, оскільки це те місце, де навіть пошукові перевірки AI найслабші (агент Princeton виявив лише 18,2% неправильних посилань на сторінки), і звернення до справи на вказаній сторінці це вирішує.
Чому ці правила
- Чернетки ніколи не зустрічаються. У дебатах ІІ моделі часто переходять від правильної відповіді до неправильної, коли опонент наводить переконливі аргументи (Wynn, Satija and Hadfield, 2025).
- Об'єднувачу не повідомляють, хто що написав. Судді з ІІ мають тенденцію оцінювати свої вихідні дані вище та розпізнавати їх (Panickssery, Bowman and Feng, 2024). Ключ до позначок записується лише в протокол, щоб потім ви могли підрахувати, як часто об'єднувач віддавав перевагу своїй компанії.
- Останній читач приходить з іншої компанії. У дослідженні більш ніж 350 моделей, коли обидві були неправильні, вони дали однакову неправильну відповідь приблизно в 60% випадків на одному рейтингу (Kim et al., ICML 2025). Критик, підготовлений в іншому місці, — найбільш прямий шлях до спільних сліпих плям.
- Кожний критик повинен уміти шукати. Docprep відмовляється запускатися, якщо критик не має інструмента пошуку.
- Правила — це код.
python3 docprep.py checkне допускає налаштування, яке їх порушує, наприклад того, де останній критик походить з компанії об'єднувача або укладачи походять з менше трьох компаній.
Що дає запис
Маніфест записує для кожного кроку модель, чи вона працювала через API або вручну, відбитки запиту та відповіді, час, ключ до міток і обидва висновки. Він навіть записує, чи був дійсно прикріплений інструмент пошуку до кожного запиту. Деякі суди запитують про використання AI: Northern District of Texas вимагає, щоб коротка записка, підготовлена генеративним AI, розкривала цей факт на першій сторінці (LR 7.2(f)). Папка запуску Docprep містить саме той матеріал для такого повідомлення. Це також заощаджує гроші: resume запускає тільки кроки, які ще не мають файлу, тому невдалий виклик ніколи не повторює оплачену операцію.
Два способи запустити це
Вручну, на сайтах чату, без ключа API. Формула ручна записує файл MANUAL-<role>.md для кожного кроку з запитом та моделлю для використання. Ви вставляєте її у новий чат, вставляєте відповідь назад під маркованою лінією та запускаєте resume. Повний запуск містить сім вставок: чотири чернетки (Claude, ChatGPT, Gemini та Grok), об'єднання та дві перевірки. Правила дбають про те, з якої компанії походить модель, а не про те, який план ви оплачуєте, і цей шлях також дозволяє використовувати режими глибокого дослідження сайтів чату.
З ключами API, автоматично. Встановіть ключі для Anthropic, OpenAI та Google, і Docprep викликає моделі самостійно, кожна зі своїм компанійським пошуковим інструментом; Grok та модель Llama можуть приєднатися як додаткові редактори. Приклад конфігурації має базову формулу для звичайних документів та покращену для чого-небудь, що суд прочитає, побудовану з моделей, доступних у вересні 2026 року; будь-який набір з різних компаній, який дотримується правил, підійде.
Протокол називає себе рампою: «Він був побудований для того, хто не може піти по сходах: хто не може тримати п'ять інтерфейсів відкритими одночасно, читати їх один проти одного та передати відповідь назад.» Docprep здійснює передачу.
Як це відрізняється від LLM ради
Docprep належить до сімейства LLM рад, багатоагентних дебатів та LLM-як-судді. Популярний llm-council Andrej Karpathy має моделі, які ранжують одна одну з прихованими іменами, а потім модель «Chairman» пише одну остаточну відповідь. Docprep відрізняється чотирма способами, всі забезпечені кодом: автори ніколи не читають один одного, об'єднувачу не повідомляють, хто що написав, вердикт на завершення надходить від іншої компанії, ніж об'єднувач, і кожен крок залишає запис. Він також зупиняється перед будь-яким остаточним переписуванням: ви отримуєте документ і звіти, а не непомітно виправлений для вас текст.
Як почати
Вам потрібні Python 3 та код з сторінки GitHub.
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
З ключами API поставте назви моделей, які пропонують ваші облікові записи, до config.yaml, потім запустіть python3 docprep.py check та python3 docprep.py run --brief briefs/my-brief.md --formula enhanced. Автономні тести (python3 -m pytest tests/test_offline.py, п'ять тестів) запускають весь конвеєр без ключів чи мережі.
Звідки це походить
Docprep є референтною реалізацією протоколу в статті The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice Vadym Chernets (SSRN 7120940, DOI 10.2139/ssrn.7120940). Стаття стверджує, що те, як організована допомога ШІ — один раз запитується одна модель або декілька моделей від різних компаній перевіряють одна одну — є змінною в якості того, що подають самопредставлені позивачі, і грунтується на федеральній справі, у якій автор був позивачем без адвоката. Код — це один файл Python під ліцензією MIT, текст протоколу PROTOCOL.md знаходиться під ліцензією CC BY 4.0, і все це знаходиться на github.com/vadimchernets/docprep. Щоб поставити одне запитання до інструментів ШІ на вашому комп'ютері, див. After Chat і Sidecall; щоб запитати у чатів ШІ через ваш власний браузер, див. Roundcall.
Vadym Chernets також розробляє Poly A1, додаток, у якому ШІ від різних компаній перевіряють роботу одна одної.