弱判别性、不被配置文件注入修复且可被操纵:大语言模型评估中的自信度
这是译文。权威版本是英文原文,引用请以原文为准。
Vadym Chernets,独立研究员 · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
被接受为 NeurIPS 2026 研讨会"TAE (Trust-AI-Eval): Can We Trust AI Evaluation?"(非存档)的海报。存档副本:10.5281/zenodo.23197651。PDF:self-confidence-evaluation.pdf。下面的图表是从 LaTeX 源代码转换的;PDF 是权威版本。
摘要
评估流程越来越多地将模型自身陈述的置信度用作信任信号——作为评判可靠性权重、弃权触发器或自报能力档案。我们测试该信号是否值得该权重,使用预注册的、协议冻结的集合(16个模型——来自九个提供商各一个预算/中端API模型,加上七个本地开放权重;22,248个在温度为零时评分的答案,声称置信度为0–100)。四项发现。(1)过度自信在所有十六个评估模型中是一致的:九个API模型中的七个的典型陈述置信度在85–95,而准确度范围为16.5–66.5%,且置信度80的最先进答案中有60.1%是错误的。(2)自信是弱判别性的:其用于预测模型自身正确性的AUROC范围为0.532–0.788,九个模型中有六个的值低于0.62。(3)独立模型小组达到AUROC 0.832,而自我评估给出0.545( ,95% CI );在更严格的无标签面板一致性重编码下,面板仍然领先(0.775 vs. 0.545)。(4)注入模型自身测量的按域准确度档案未能明显改善安慰剂对照单供应商阶梯的一个确认阶段的判别(AUROC ,Holm调整 ),而相同的注入通道在因果上是可操纵的:虚假档案将探索性阶段的自我评估AUROC推至随机水平(0.474),且一旦项目被标上主题标签,会降低五个本地模型中四个的校准。我们得出结论,当前被引出和测量的自我评估置信度,即开放式事实回忆中的言语整数置信度,是测量的目标,而不是信任的输入:摄入自报能力的系统继承一个未认证的输入通道。标题的三个条款基于不同的证据,我们全程将其标记为如此:弱判别性在十六个模型中得到确认;不能通过档案注入修复基于一个供应商族群的一个确认阶段,对于所观察到的效应来说功率不足;可操纵的是探索性的,因果方向显示在匹配项上,但没有对已部署系统进行过攻击测试。评判式自我评估,其中一个模型评价另一个模型的答案,是不同的任务,在这里未进行测试。
引言
现代评估实践悄悄地将模型自述的置信度视为一种测量工具:LLM 评判者报告确定性分数,代理框架根据自评能力进行路由,弃权政策由口头化的不确定性触发,校准基准假设自报告渠道至少是诚实的。这个假设很方便——自报告是免费的、始终可用的,并且与答案在同一步骤中产生——但在消费点几乎从不审计。我们问一个先前的问题:自评信号有多大的判别力,它能否用模型自身的测量档案来修复,它能否被操纵?
我们通过一项预注册的、协议冻结的、盲目的收集来回答:十六个模型(来自九个提供商中每个的一个预算/中档 API 模型,加上七个本地开源权重),每个 1,500 个 2023 年后的事实性问题,温度为零,每个答案都伴随一个陈述的 0–100 置信度——22,248 个评分答案,所有分析都从原始数据确定。根据这个测量标准,自报告渠道未能通过三个逐次更宽容的测试。
C1(弱判别力)。陈述的置信度饱和且与能力脱钩:七个九个 API 模型的逐模型中位数位于 85–95,而准确度跨度为 16.5–66.5%,60.1% 的前沿答案以置信度 80 陈述是错误的。作为模型自身逐项正确性的预测器,自信心仅根据模型达到 AUROC 0.532–0.788——每个自举 CI 排除了机会,但九个模型中的六个位于 0.62 以下,即使对最好的进行选择性预测也会留下大量剩余误差(第 4 节)。独立模型的面板达到 0.832,而自评给出 0.545——一个在更严格的无标签面板协议重新编码中幸存的优势——而另一个面板上明显的反例在很大程度上反映的是模型间身份而不是逐项自我知识(第 4 节中的分解);识别自报告判别良好的那个模型仍然需要自报告应该取代的独立测量。
C2(没有来自档案注入的确认性修复)。最直接的修复——在回答时向模型提供其自身测量的逐域准确度档案——在冻结、安慰剂对照阶梯实验的一个确认轮次中未能显著超越安慰剂档案(AUROC ,原始 ,Holm 调整 ;未通过确认端点)。我们将其报告为空,而不是趋势(第 5 节)。
C3(可操纵的)。修复将使用的注入渠道接受伪造品:一个洗牌(虚假)档案将探索性前沿轮次的自评 AUROC 驱动到机会水平(0.474 对 0.710;下降 ),单个伪造的"95% 准确度"声称将本地模型对其错误的项目的陈述置信度从 50 移动到 95,一旦项目标记为主题,五个本地模型中的四个消费虚假档案到自己的损害(Brier 到 ;第 6 节)。
这些结果合在一起论证了一个角色的改变:自评置信度应该是评估的测量目标,而不是其未审计的输入。第 7 节说明了对评判管道、代理路由和套具设计的后果;伴侣论文(Chernets, 2026)检查了基于面板的替代方案的故障模式,在此被引用而不是转述。
相关工作
言语化置信度与校准。 现代网络的校准不当是一项长期的研究发现(Guo et al., 2017),对于QA微调的语言模型,早在当前模型一代之前就发现校准不足(Jiang et al., 2021)。模型可以被教会用言语表达不确定性(Lin et al., 2022b),较大的模型在自我评估探针上部分"知道它们知道什么"(Kadavath et al., 2022),但它们在很大程度上无法识别不知道的内容(Yin et al., 2023);对引出置信度的实证审计发现在各种引出格式中持续存在过度自信(Xiong et al., 2024),言语化评分有时比令牌概率更好校准,但仍然被高估(Tian et al., 2023)。内部状态探测明确了框架:对隐藏层激活的简单分类器恢复了71–83%的真实性(Azaria and Mitchell, 2023)——失败存在于言语化输出通道,而不一定存在于内部表示中。我们的贡献是规模和设计:一个预注册、冻结的16模型盲收集,对相同项目的相同引出根据地面真实和独立小组一致性进行评分——加上这一文献很少提出的两个问题:信号能否用模型自身的测量配置修复,修复通道能否被攻击?
下游消费自我报告。 LLM作为评审的流程继承了评审员偏见和可靠性限制(Zheng et al., 2023),基于一致性的置信度信号本身也在审计中(Ding, 2026);语义熵检测器(Farquhar et al., 2024)通过测量答案分布来绕过自我报告。第三方评估框架为独立测量提出了治理案例(Raji et al., 2022);我们给出了一个定量的下限:在九个API模型中有六个,流程消费的自我报告的AUROC低于0.62。
不可信输入。 间接提示注入表明任何LLM接收的文本通道都是一个攻击面(Greshake et al., 2023)。第6节定位了一个特定的、迄今未命名的实例:校准修复将使用的自我能力配置文件槽是一个未经认证的输入通道,伪造它会使判别降低到随机水平。
小组及其失效。 多样化模型的小组是一个日益标准化的评估工具(Verga et al., 2024)。我们用作比较器的小组信号有其局限:其失效模式(难度反演、受限答案空间、基于标签的独立性假设、一致性)在一份关于同一原始数据集的配套提交中进行了测量(Chernets, 2026);本论文涵盖自我评估故事,配套论文涵盖小组故事,两者之间没有重复的表格。
基准。 我们在2023年后的SimpleQA子集上进行引出(Wei et al., 2024),正是因为我们针对2021年版TruthfulQA(Lin et al., 2022a)测量的基准年代差(第3节)。
预注册实验:设计与数据
一项预注册的盲目采集,协议在任何确认性数据出现前已公开冻结:十六个模型(跨九个提供商,每个提供商一个预算/中端API模型,加七个本地开源权重模型)对相同的1,500个2023年后的事实性问题(SimpleQA子集)进行回答,温度为零,每个答案附带一个声明的0–100置信度;共22,248个分级答案(13,446个前沿,8,802个本地)。
预注册和冻结。
采集协议在任何确认性数据出现前在公开注册处冻结(可复现性附录中有访问路径)。注册预先指定了基准和子样本(随机,固定种子,子样本文件的SHA-256已记录)、模型名单、诱导格式、分级程序、分析计划——包括第4节中使用的小组一致性与自有置信度的AUROC比较、一个预先指定的次要指标(注册的主要终点是小组不一致的置信错误标志率,这是伴随提交中报告的小组端数量)——以及针对事后指标选择的决策规则。一个小的探索性试点(95个TruthfulQA项目,三个本地模型)在冻结前运行以验证管道;其数据从不与确认性数据混合。
模型和诱导。
通过其API的九个前沿提供商——每个提供商一个预算/中端模型,因此下面的提供商名称标记单个模型,而非产品线(确切的模型ID和收集日期见可复现性附录)——以及七个本地开源权重模型。每个模型独立回答每个项目,温度为0,并在同一响应中声明0–100的整数置信度;小组是这种单盲采集的分析组合——没有模型曾看到另一个模型的输出。
分级。
首先标准化字符串与黄金标准的等价性和拒绝检测;未解决的开放式情况由仅限黄金标准等价性的本地开源权重LLM评级器处理(qwen3:8b,本地)。50项人工抽检发现98%的一致性(一个保守错误);对342个最硬层共识判决的跨族系审计同意342/342(局限)。除解析失败外无排除项(已报告);它们集中在一个本地推理模型中,该模型只保留1,500中的98个可分级答案——所有本地层声明都附带每个模型的。所有确认性分析都由原始JSONL确定。
基准选择,通过测量。
2023年后的主要基准是由测量而非假设来证明的设计决策:在一个探索性基准时代比较中,相同的模型在2021年版本TruthfulQA MC上的得分比在2023年后SimpleQA上高到个百分点(deepseek pp,95%置信区间 ;mistral ;zhipu ;例如,89.2% vs. 28.4%)——这个差异与基准时代和曝光效应相一致,尽管该设计无法区分污染、难度和构造差异。没有标题数字基于较旧的基准;本地层上的750项TruthfulQA MC1臂仅在适当标记的地方使用。
预注册对比探索性。
预注册和确认性的:上述采集和小组与自有AUROC比较(第4节)。探索性的,并在使用处标记为此:基准时代比较臂、第6节的前沿配置文件注入梯级和本地微探针。第5节的配置文件注入阶梯是一个独立的冻结、安慰剂对照的协议(臂、终点和Holm族在其确认性阶段之前固定)。
结果1:自信度校准不当且区分力弱
我们区分了术语"校准"通常混淆的两个属性:大规模校准(置信水平是否与准确率水平相匹配?)和区分力(置信度是否将模型的正确答案排在错误答案之上?)。
校准。陈述的置信度饱和且与能力脱钩:在九个API模型中,陈述的置信度在七个模型中位于85–95(每个模型的中位数),而准确率跨度为16.5–66.5%;两个偏离——拒绝率高的模型(中位数42,准确率10.3%)和一个分散型置信度模型(中位数60)。每个模型在总体上都过度自信:置信度减准确率差值(CITL,表1)的范围从到百分点。ECE列几乎等于CITL:置信度-准确率差值在九个模型中的七个的每个非空箱中都是正的(其他两个中的全部除一个外),因此分箱和全局校准不当重合。即使是拒绝率高的模型也保留了百分点(ECE 0.310)——其低波段反映拒绝行为,而非校准的自我认知。其区分优势的一部分同样可能是机械性的——在低陈述置信度下被判为不正确的拒绝提高AUROC(排除拒绝行为时为0.660,)——因此我们将其0.788读作诱发自我认知的上界,而非校准排名。在九个API模型中合并,60.1%的置信度80的陈述答案是错误的(9,310中的5,598个);单个模型的错误率跨度为29.0–83.2%(宏平均57.6%)。相信高陈述置信度的消费者接受大多数错误。区分力。作为模型自身正确性的预测器,自信度实现的AUROC为0.532–0.788,取决于模型。自助法95%置信区间(表1)在每个模型中都排除0.5,因此信号不是完全随机的——但在九个模型中的六个中,信号低于0.62。后果具有操作意义:在20%覆盖率(仅回答置信度最高的五分之一项目)下,三个自我AUROC最强的模型的错误率分别仍为75.3%、33.3%和15.1%(表2)——仅对第三个有意义的降低,对其他两个远未达到信任关口。
一个架构替代方案——计数达成一致的独立模型——在自评估得出0.545()的面板上达到AUROC 0.832(95% CI );项目聚类差异 以很大差异排除零。三个预先指定的面板:US(Anthropic、OpenAI、Google)、CN(DeepSeek、Alibaba、Moonshot)、cross-bloc(Anthropic、DeepSeek、Mistral);主要比较是CN面板。在另一个预先指定的面板上,汇总比较似乎反转:在面板人群上汇总的自评估0.842 vs. 面板0.697; 。分解表明这种明显的反转在很大程度上反映的是模型间身份而非逐项自知能力:汇总的0.842混合了三个模型,其模型内自AUROC仅为0.596–0.784(宏平均0.709;面板-人群值——表 1 报告完整等级集),在模型内秩归一化后(这移除了模型间水平差异同时保留每个模型自己的排名),汇总值下降到0.672——一个的模型间身份贡献。0.545面板通过了相同的检查(0.545汇总 vs. 0.582秩归一化):其自评估失败是真正的逐项的。反转中幸存的是更狭隘的陈述:拒绝较多且自信力判别最强的模型(在完整等级集上为0.788)确实超越了该面板的一致性信号——确定哪个模型是这样需要恰好是自报告旨在替代的独立测量。第三个预先指定的面板(cross-bloc)介于两者之间:面板0.722 vs. 自身0.659 , 。
对面板信号的无标签重新编码的敏感性。
面板信号背后的规范等价性编码参考主模型自己的正确性标签(两个答案都被评为正确时算作一致),所以面板一致性在一定程度上是目标标签的确定函数——一种标签中介的依赖,尽管不是自投票泄漏:通过设计,模型自己的记录从不加入其自身的面板信号。无标签重新编码(仅字符串一致;不参考主评价者或面板成员的正确性标志)在自评估给出0.545的面板上将面板AUROC从0.832降低到0.775,在其他面板上从0.697降低到0.628;主要面板优势在更严格的编码中保持(0.775 vs. 0.545)。
表 1 给出了逐模型的图景;图 1 显示了所有16个模型中相同的解耦:所有模型都位于校准对角线上方,本地层缩小为85–100声明置信度的带,在9.2%准确性处。
| 模型 | 准确度 (%) | 平均置信度 | CITL (pp) | Brier | ECE | 自AUROC | 95% CI | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
在确认性SimpleQA集合上的按模型校准(前沿级别、完整评分集;提供商名称标签表示每个提供商收集的一个预算/中端模型)。CITL:整体校准,平均陈述置信度减去准确度,单位为百分点。ECE:10分箱期望校准误差。Self-AUROC:陈述置信度作为模型自身逐项正确性的预测器(并列修正的Mann–Whitney),附带自举法95% CI(模型内行级重采样、2,000次抽取、固定种子)。所有值均为从原始评分JSONL的确定性重新计算;每个CI排除0.5。CITL使用未舍入的平均值;显示的值舍入到小数点后一位。{#tab:vendor}
| 覆盖下的错误率 | |||||
|---|---|---|---|---|---|
| 2-6 模型 | 100% | 80% | 60% | 40% | 20% |
| anthropic (self-AUROC 0.788) | 89.7% | 87.1% | 82.9% | 80.3% | 75.3% |
| xai (0.777) | 62.1% | 52.8% | 45.1% | 39.5% | 33.3% |
| google (0.746) | 33.5% | 24.5% | 20.0% | 18.7% | 15.1% |
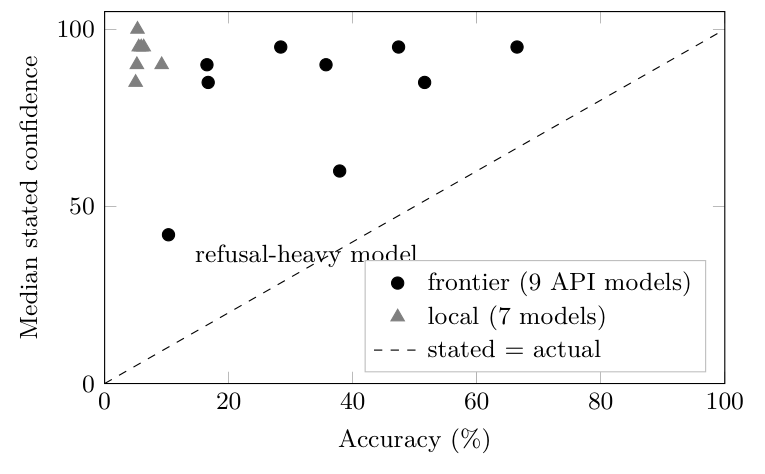 所有十六个评估模型中表现出一致的过度自信:每个模型的陈述置信度中位数(平均值见表1)与所有16个模型在相同1,500个盲测SimpleQA项目上的实际准确性对比。所有模型都位于校准对角线上方;拒绝率高的模型(陈述置信度中位数42,准确性10.3%,CITL +31.0 pp)具有最佳的自我-AUROC 0.788,但仍然过度自信;最小的校准间隙属于分散置信度模型(+11.1 pp)。每个模型的前沿中位数:按表1的行顺序为95/85/95/60/90/95/85/90/42;七模型局部层跨越准确性5.0–9.2%,置信度中位数为85–100(排除解析失败后,每个局部模型的级别n为98–1,498;局部层服务于操纵探针和此图,而非区分能力声称)。
结果 2:通过实测档案注入未能确认判别性的改进
一个自然的改进是在回答时向模型提供其自身的实测能力档案——来自保留数据的各域准确率。在安慰剂对照的阶梯实验中(组别:无档案、与总体水平匹配的安慰剂档案、自有实测档案、打乱后的档案),自有档案组在确认性终点上未能显著优于安慰剂:AUROC ,95% CI ,原始 ,Holm 调整后 ;无确认性终点通过。我们将此报告为一个零假设,范围明确有限:在一个确认性阶梯上,判别性未被实测档案注入所纠正。点估计为正,但在预先注册的修正下,该改进未被证明;该设计仅对中等效应具有把握(SE 来自 CI:80% 把握仅对 AUROC ,大于观察到的 ——因此数据既与真实零假设相容,也与小的真实效应相容)。设计的上限不是限制因素。将每个项目的自身箱准确率——通过留一法计算,使得项目永远不对其自身预测器有贡献——作为该项目正确性的唯一预测器产生了确认性受试者的 0.758 的理想 AUROC(四个阶梯受试者上为 0.716–0.789),各箱准确率传播 SD 为 0.195,在 21 个箱上的范围为 0.15–1.00。因此各箱的差异足以使真实档案携带实质信息:零假设涉及的是注入通道,而非信息太平坦的电池。1 探索性模式(基线校准最弱处的更大收益)仅具有假设生成性。
阶梯设计和安慰剂验证。
四个冻结的阶梯级(受试者:Claude Haiku 4.5、Sonnet 5、Opus 4.8 和 Fable 5;精确 ID claude-haiku-4-5-20251001、claude-sonnet-5、claude-opus-4-8、claude-fable-5),每个都有四个盲试组别,占据同一校准位置的相同提示:off(档案形式的结构性空值)、placebo(与总体水平匹配的校准无关档案;在每个阶梯上针对真实档案进行验证,——实测 、、、)、core(模型自身实测的各域档案)和 shuffled(箱排列的虚假档案;因操纵检查失败而从确认性被降级至探索性)。315 项电池跨越 21 个域箱,包含陷阱项和显式弃权令牌;项目–组别分配在确认性阶段之前冻结,每项具有随机化的组别顺序,受试者可见文本中无组别名称。预先注册的退化界限(off 准确率 )使四个阶梯中的三个从确认性计算中降级;表 3 报告了唯一符合条件的阶梯。存活的阶梯的 off 组准确率为 0.847,相对 0.85 阈值,而降级的阶梯分别为 0.855、0.888 和 0.900——off 组已答项的 AUROC 为 0.575、0.628 和 0.500(描述性地,接近天花板的准确率保留待修复的校准信号很少)。四个受试者均来自单一供应商族系;见限制。
| 处理组 | 准确率(全部项目) | AUROC | Brier | ECE | 配对AUROC(核心处理组) |
|---|---|---|---|---|---|
| 关闭(无配置文件) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| 安慰剂 | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| 核心(自有配置文件) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| 打乱(假) | 0.842 | 0.589 | 0.140 | 0.113 | 未计算(探索性) |
档案注入阶梯,确认合格的阶梯(受试者:Claude Sonnet 5;:294个非陷阱项目2个预注册的新流程副本——该工具既不暴露温度也不暴露种子;仅回答的AUROC)。确认对比(项目聚类自助法):coreplacebo AUROC ,95% CI ,原始;coreoff ,CI ,原始;两者均未通过Holm校正()以及双向项批次关卡(一个预注册的稳健性要求,按项目和收集批次同时聚类)。配对-列重复了冻结分析的项目聚类配对对比(针对core);它们不是各臂AUROC列的算术差,并且未对shuffled计算确认配对对比(在确认阶段之前被降级为探索性)。我们注意到与我们自身的假设相悖的是,core在校准方面不占优势:其ECE(0.099)比placebo的(0.090)更差,这是将确认结果解读为零结果的又一个原因。{#tab:ladder}
结果 3:自我形象通道是可操纵的
如果评估工具使用自我能力档案,该槽位就是输入通道,输入可被伪造。我们区分三项证据强度递减的主张,并说明每项结果支持哪一项。(i) 因果可操纵性——下文演示:替换虚假档案在因果上改变陈述的置信度并在对照运行中降低校准。(ii) 完整性脆弱性——有条件的:仅对实际从对手可影响的源注入能力档案的工具有意义。(iii) 已部署评估管道中的实际攻击面——本文提出但未检验的假设。用打乱的(虚假)档案替换真实档案将探索性前沿档次的自评AUROC驱动到偶然水平:0.474对比真实档案的0.710(上限降级探索性档次;项聚类自举:0.710 [0.586, 0.820] vs. 0.474 [0.349, 0.599],差异 [, ])。相比之下,在符合确认条件的档次上,打乱坐于安慰剂和核心之间(0.589对比0.578和0.625;项聚类配对对比,探索性: )。该档次在构造上是弱操纵证据:虚假档案两次未通过预注册检查(外部评判员0.99/0.94对比边界);冻结规则在确认数据存在前降级了该臂,主体可以对明显不可信的档案打折扣,且不存在消费检查。独立发现:前沿评判员仅从可信度检测伪造。在零成本本地台站上,单一虚构声明("本领域准确率95%")将模型对同一项目的陈述置信度从50提高到95;该效应集中在具有声明性校准要失去的模型中;在本探测中,最大转换(点)发生在最多要放弃的模型中(glm4:9b)。两个边界条件限制该效应:模型必须能够将当前项目与档案箱相关联(在无标签项目上小本地模型忽略档案;增量,与结果 2 的冻结零假设一致),且上限钉住模型(无论如何置信度)没有什么可攻击的。
操纵证据——一个探索性前沿档次、一个本地微探测和一个主题标记本地通过——建立了因果可操纵性,主张(i)。表 4显示了微探测:相同的项目、相同的模型和注入自我档案中的单行更改将陈述置信度移动高达点。
探索性主题标记通过:边界的两侧,有效。
上述第一个边界条件(模型必须能够将项目与档案箱相关联)本身是可测试的:用其主题标记每个探测——冻结协议的披露偏差——消除了关联障碍。在完整的本地通过中(五个模型,每臂16个保留探测,温度0,固定种子),在无标签项目上是惯性的虚假档案一旦项目被标记就被五个模型中的四个消费:Brier恶化(glm4:9b)、(llama3.2:3b,准确率下降37.5%25.0%)、(mistral:7b)和(phi4-mini);每探测自举置信区间在包括每个模型的零,因此微探测建立了方向和机制而不是按模型效应大小;
第五个(qwen3:8b)在上限处通过了整个测试集(100%准确率,两个条件下信心度均为100,),展现了"无可攻击"的边界。该机制是方向性且对称的:虚假的高声明在最弱的箱体中精确增加了信心度(llama3.2物理学:在保留准确率为25%的箱体中,声明的信心度0100;phi4-mini逻辑1365),而虚假的低声明在正确答案上削弱了信心度(llama3.2历史在保留准确率为75%处1000),甚至诱发模型在原本可以回答的项目上弃权。因此,边界的两侧通过实时运行展示:无标签项目中,配置文件处于惯性状态(冻结的空);标签项目中,伪造的自我形象直接传播到声明的信心度中,并导致端到端的校准退化。
| 模型 | 信心度 @ "0%" | 信心度 @ "95%" | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
局部微探针(探索性):对同一(答错的)项目,当注入的配置文件槽在该项目的领域中声称"0%准确率"与"95%准确率"时的声明信心度;五个本地开放权重模型,温度0。上限钉死的模型(底部行)没有可攻击的声明性校准。{#tab:microprobe}
评估实践的启示
我们的结果在一个任务族(post-2023 open-form factual QA)上用一种启发格式进行测量;下面的启示从这些测量中推断。
(1)颠倒陈述置信度的角色。自报置信度应该是评估的一个测量目标,而不是当前启发下的输入。支持数据:60.1% 的高置信度前沿答案是错误的,最佳 self-AUROC (0.788) 属于精度排行榜会排名最后的模型——两种排名都不能预测谁的自报具有区分性。
(2)评判管道继承弱区分权重。任何 LLM-as-judge 或按自确定性加权投票的集合方案在这里的九个模型中的六个中导入 AUROC 低于 0.62 的信号——静默地,因为饱和 85–95 频带在日志中看起来令人放心。如果使用确定性加权,权重应该来自测量的每个模型的校准,而不是报告本身。
(3)认证配置文件位。第 6 节的三级威胁模型列举了这些关注:因果可操纵性已被证明,完整性漏洞取决于工具实际上从可影响的源注入配置文件,以及部署管道中的实际攻击面仍然是假设。对于条件类中的工具,修复通道是暴露:原本应该修复校准的相同注入配置文件接受推动区分到随机级别 (0.474) 的伪造品,一旦项目可关联就会端到端降低 Brier 分数。这样的工具需要一个完整性门——签名配置文件、来源检查,或至少将测量配置文件的人与在推理时提供它的人分开。未经身份验证的自我形象位是具有校准负载的开放提示注入端口。
(4)外部测量是替代方案——带有自己的审计。独立小组一致性在自评失败最严重的地方占优自评(AUROC ),但小组有自己的测量失败模式,在配套论文(Chernets, 2026)中进行了检查;在没有该审计的情况下采用小组信号会在上一级重复相同的错误。预注册为探索性的扩展添加了第三个角度:在 12 个有向的配置文件交换对(3,780 个调用)中,替换另一个模型的测量配置文件将 AUROC 最多移动 ——并且偶尔有帮助——而转移损失的相似性排名预测失败(Spearman ):测量配置文件是可移植工具,而不是特权自我访问。附录中描述了一个实用的自评诊断电池。
局限
标题仅采用单一基准系列(2023年后开放式事实性问答);每个提供商由一个预算/中端模型代表,因此不声称提供商级别的泛化能力;表述置信度诱导是标题数字的一种提示格式——尽管一个探索性两阶段组(150个项目 五个本地模型)表明格式并非罪魁祸首:无状态事后置信度查询降低了表述置信度和高置信错误率,但不影响鉴别能力(self-AUROC 0.43–0.61在两种格式中;合并配对自举 AUROC 在 对上,每个模型142–150行的确定性无LLM标签——与仅字符串分级器的标记偏差,在该分级器下 90%的情况无法消解);注入零假设是某梯的一个确认环节(315个项目,21个分箱),所有四个受试者来自单一供应商系列,且不排除更优的修复设计;操纵证据结合了一个探索性前沿环节、一个本地微探针和一个主题标记的本地通过(一个披露的偏差)——不是确认性攻击研究;评分部分基于LLM,其人工验证是对50项的抽样检查(98%一致,一个保守错误)。分级器的供应商系列还包含一个CN小组成员,因此分级器独立性本身是可量化的:来自所有小组外系列的第二分级器和分级器自己重新评分了全部342个最难五分位数共识判决,并完全同意342/342。分级器本身就是一个本地级受试者;对所有1,441个自分级行的跨系列重新评分同意98.3%,分歧倾向于自我宽松(24个向下翻转对1个向上;准确度5.94.4%)——加强了过度自信的图景;更全面的分层重新审计仍是未来工作。小组对自我比较与配套提交共享数据;无表格重复,边界在第1–2节中陈述,本文范围保持仅限于自我评估。
结论
自我评估按目前的引出方式未能通过评估信号必须通过的三项测试:它对正确性的追踪过于微弱,无法把控决策,却仍然表现得严重过度自信;最直接的自我认识干预在安慰剂对照下未产生任何可证实的修复;其输入通道接受伪造品,将区分能力推向随机水平。直到模型基于实测证据获得校准,表述的信心才是值得研究的现象,而非可供使用的信号。
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
实用工具:自我评估诊断
这项研究的副产品是一个紧凑的自我评估诊断工具:一个由简短、确定性可评分的探针组成的固定测试组,涵盖该研究的各个领域(数值、逻辑、物理、历史、代码、概率等),加上带有明确弃权令牌的陷阱项。每个答案都附带一个0–100的信心评分,该工具计算Brier分数、过度自信差距(平均信心减去准确度)、信心区分度(正确答案的平均信心减去错误答案的平均信心)和陷阱弃权率的复合分数,将结果映射到从校准良好到盲目自信的层级。它体现了本文的论点——校准是关于模型的可测量属性,而不是从其自我报告中读取的——并作为工具而非结果与复现包一起发布:它使用释义探针而不是固定测试组,其区分分数是代理指标,而不是阶梯的AUROC端点。
可再现性附录
本文中的所有主要数字都是已发布原始JSONL的确定性函数;没有任何步骤涉及随机性、网络访问、GPU计算或重新查询任何模型。
数据可用性。
冻结的预注册和复制包(公开OSF注册):https://osf.io/4y9dv。oracle-ceiling脚本oracle_auroc.py与本文一起存放在https://doi.org/10.5281/zenodo.23197651。
诱导提示词(逐字)。
系统:You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text.用户轮次包含基本问题;拒绝通过评分脚本中的冻结拒绝词典从答案字段检测。
模型标识符和运行日期。
每个提供商一个预算/中等层级的API模型,于2026-07-24进行实时烟雾测试验证,并在2026年7月末收集(运行清单中的每次调用时间戳,随复制包一起发布):anthropic claude-haiku-4-5-20251001;openai gpt-5-mini;google gemini-3.6-flash;xai grok-4-fast;deepseek deepseek-chat;alibaba qwen-plus;moonshot kimi-k3(一个披露的收集偏差:第一方账户上1500个项目中有670个,其余通过由同一第一方基础设施提供的聚合器路由,推理已禁用,served_by按调用记录;仅限第一方的灵敏度分割已预先承诺);zhipu glm-4.5;mistral mistral-small-latest。本地层(Ollama,temperature 0):gemma4:e4b、llama3.2:3b、phi4-mini、qwen3:8b、deepseek-r1:8b、glm4:9b、mistral:7b。
配套论文(Chernets, 2026)共享相同的冻结注册和原始收集。复制包包含:冻结的注册文本和协议、具有精确模型标识符的运行清单、原始分级集合(前沿和本地层,以及探索性基准年龄比较臂)和三个无依赖CPU脚本。第一个(compute_panel_vs_own_auroc.py)是面板一致性与自身置信度AUROC比较的规范定义(第4节),并在规范值旁打印每个非规范替代读法(二进制面板信号、不确定编码、并列处理、池化变体),使读法的选择可以被审计。第二个(analysis_tae_week1.py)重新打印表1、图1坐标、第3节的基准年龄差距,并对表3中报告的冻结阶梯值与阶梯的冻结分析文件进行只读检查。第三个(analysis_tae_decomposition.py)重新打印第4节的池化AUROC分解和秩标准化、面板信号的无标签重编码、每个模型的高置信度错误率、表1的CITL/Brier/ECE列、表2的风险-覆盖值以及第5节的降级梯级描述统计。每个脚本仅使用Python标准库在笔记本电脑CPU上运行数秒。配置文件注入阶梯以其自己的冻结捆绑包形式提供(协议、电池、每臂评分行和分析JSON),从包中指向。
由冻结的每项臂分数计算(
scored-arms-*.jsonl;非陷阱,状态ok;用于确认主体)通过oracle_auroc.py,与本文一起发布;项目的所有臂和复制品一起被排除。↩︎
如何引用
Chernets, V. (2026). Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation [论文报告]。NeurIPS 2026 Workshop: TAE。Zenodo。https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}